一、引言
当企业完成数据资产盘点后,治理重心会自然转向存储、计算与成本的长期控制。数据表是否持续增长、分区是否合理、小文件是否拖慢查询、历史数据是否还占用高性能存储、压缩格式是否合适、成本是否能分摊到业务方,这些问题共同决定了数据平台能否从"可见"走向"可控"。
资产治理回答"有哪些数据、谁负责、从哪来、到哪去",存储治理回答"数据应该留多久、放哪里、怎么组织、怎么压缩、成本由谁承担"。
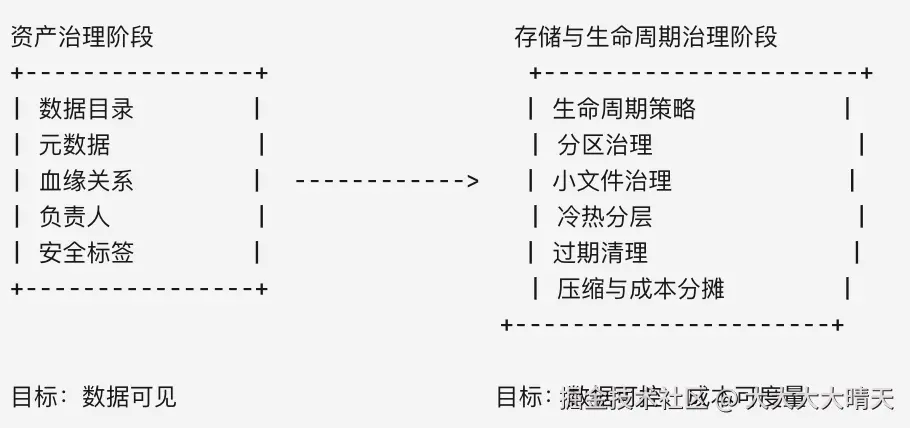
二、数据生命周期策略
数据生命周期治理的第一步,不是立刻删除历史数据,而是先定义数据在不同阶段的价值、访问频率、合规要求和恢复要求。典型生命周期可以分为"生成、活跃使用、低频访问、归档、过期清理"五个阶段。
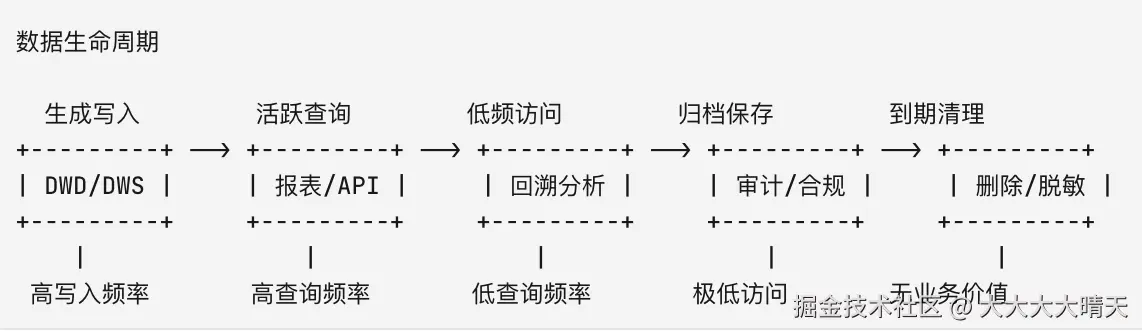
生命周期策略通常要回答四个问题:
| 问题 | 工程含义 |
|---|---|
| 数据保留多久 | 决定分区保留、快照保留、归档周期 |
| 数据多久被访问一次 | 决定热存储、温存储、冷存储 |
| 数据是否需要回滚或时间旅行 | 决定快照、事务日志、历史版本保留周期 |
| 数据是否受合规约束 | 决定是否可删、是否要脱敏、是否必须归档 |
在 Hive 体系中,表和分区的生命周期更多依赖元数据和调度任务控制。Hive 的分区表可以设置partition.retention.period ,由 Hive Metastore 后台线程检查分区创建时间,超过保留周期后删除分区,同时删除分区数据;生命周期可以被纳入元数据层,而不是完全依赖外部脚本。
在湖仓表格式中,生命周期治理还要关注快照。例如Iceberg 每次写入都会产生新的 snapshot,snapshot 可用于 time travel 或 rollback;旧 snapshot 会持续累积,官方建议定期执行expireSnapshots ,以删除不再需要的数据文件并控制元数据规模。
因此,生命周期策略不能简单写成"ODS 保留 180 天,DWD 保留 365 天"。更合理的方式是把数据分为业务热度、合规等级、恢复等级和成本等级。
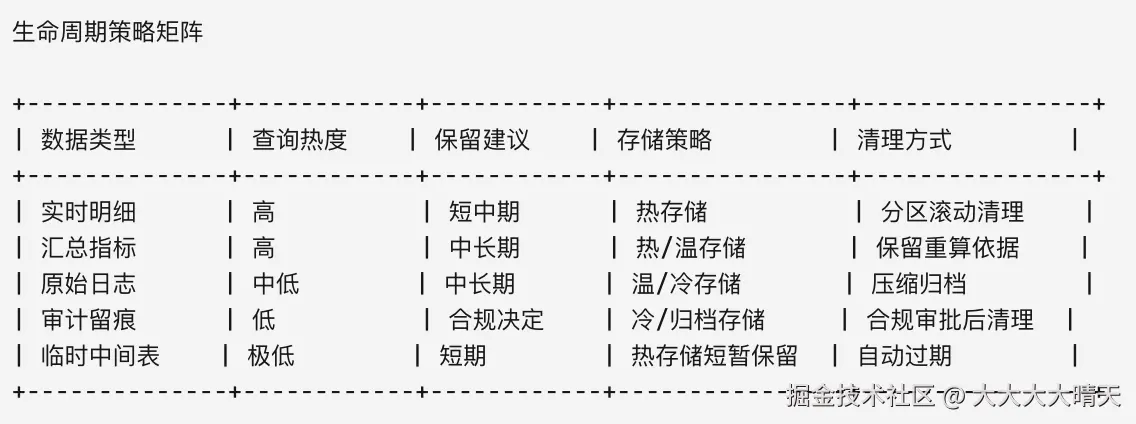
三、分区治理
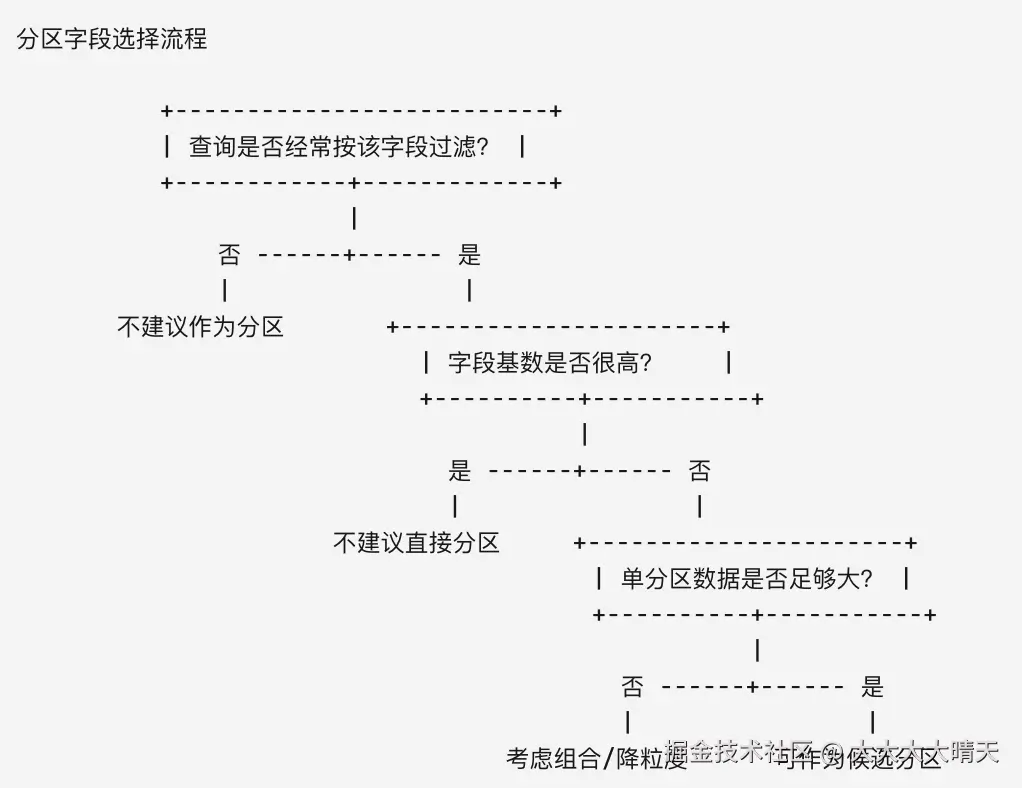
分区治理的目标是让查询尽量少扫描无关数据。在Spark中,Hive 风格的分区表通常把分区列编码在目录路径中,例如gender=male/country=US ,Spark 可以从路径中自动发现分区列并进行类型推断。这类机制带来的收益很直接:当查询条件命中分区列时,引擎可以跳过大量无关目录和文件。
分区设计的常见误区是"越细越好",高基数分区会制造大量目录、小文件和元数据压力。我们不应使用基数很高的列做分区,例如userId 这类可能有百万级取值的字段;同时建议当单个分区预期至少有 1GB 数据时,再考虑按该列分区。
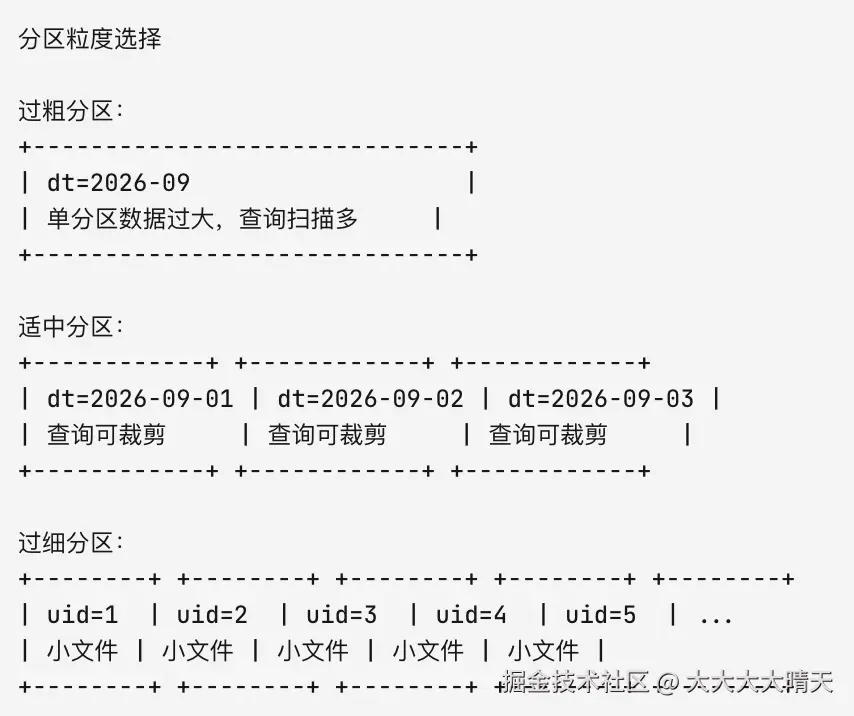
Iceberg 在分区治理上提供了更强的抽象。Iceberg 支持 hidden partitioning,可以基于day(event_time) 等转换生成分区值,并自动利用分区关系跳过无关文件;用户查询不必显式维护event_date 这样的物理分区列,分区方案也可以随数据规模演进。这对于治理非常重要,因为它降低了"写错分区值"和"查询忘写分区条件"的风险。
分区治理可以用下面的判断路径来做:
四、小文件治理
小文件问题的本质,是存储系统和计算引擎为每个文件付出的固定成本过高。每个文件都可能带来元数据记录、文件打开、任务调度、对象存储请求、NameNode 或 catalog 压力。文件越小,这些固定成本占比越高。
Iceberg 小文件问题的解释很直接:Iceberg 会跟踪表中的每个数据文件,更多数据文件会带来更多 manifest 元数据;小数据文件会增加不必要的元数据和文件打开成本,降低查询效率;官方建议使用rewriteDataFiles 将小文件合并为更大的文件。
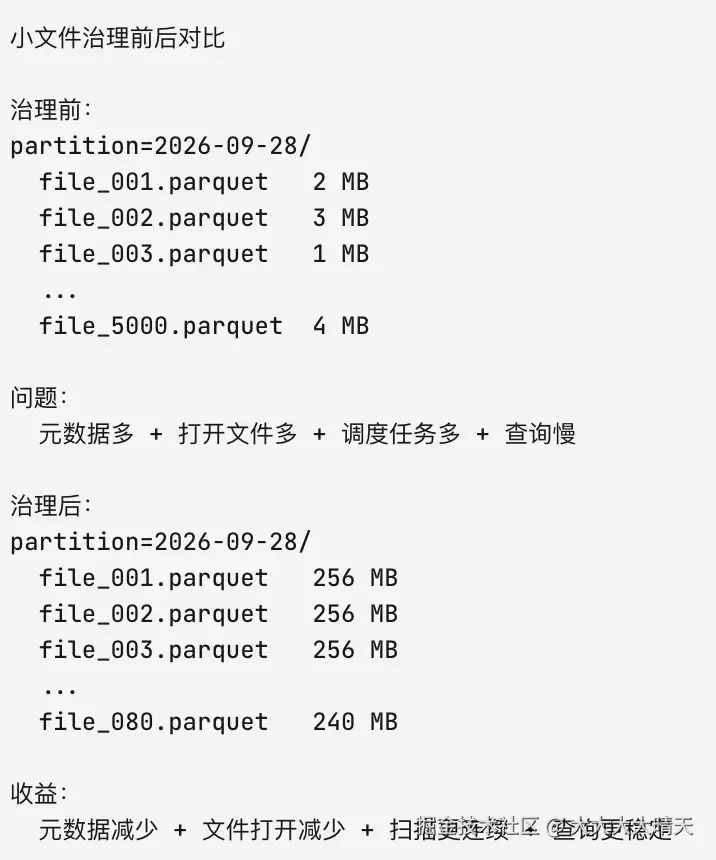
小文件治理一般有三类入口:
| 入口 | 场景 | 治理方式 |
|---|---|---|
| 写入前 | 批任务、流任务输出过碎 | 控制并发、合理设置 shuffle 分区、批量写入 |
| 写入中 | 湖仓表支持自动优化 | 使用表格式或平台提供的 optimize/compaction 能力 |
| 写入后 | 历史分区已产生大量小文件 | 定期按分区合并,合并后清理旧文件或快照 |
需要注意的是,小文件合并不等于无脑把文件变得越大越好。文件过大可能影响并行度、单任务耗时和失败重试成本。更稳妥的做法是结合查询模式、存储介质和引擎建议,选择一个目标文件大小区间,例如 128MB、256MB、512MB 或 1GB。
五、冷热分层
冷热分层的目标是把高频访问数据留在高性能存储,把低频访问数据移动到更低成本的存储,把极低频但需要保留的数据归档。这个策略背后的假设是:数据价值和访问频率会随时间下降,但下降速度因业务而异。
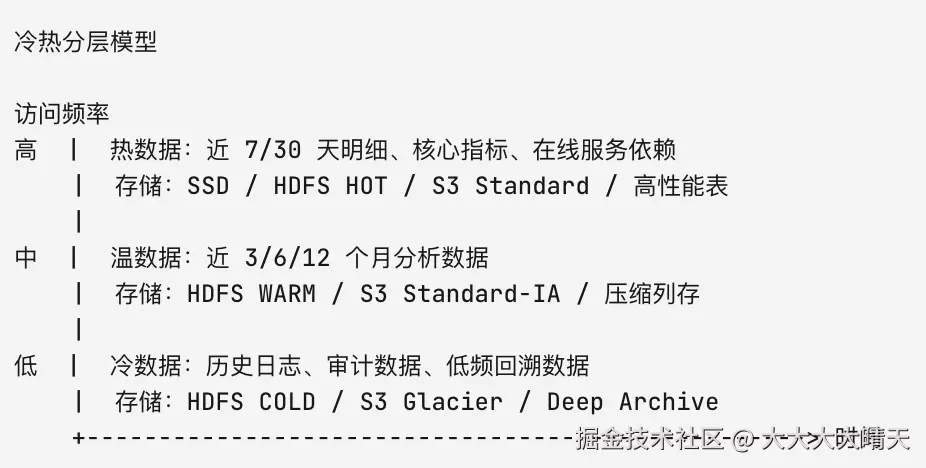
HDFS 定义了 Hot、Warm、Cold 等存储策略:Hot 适合仍被计算频繁使用的数据,副本存放在 DISK;Cold 适合不再使用或需要归档的数据,副本存放在 ARCHIVE;Warm 则把部分副本放在 DISK、部分放在 ARCHIVE。这为本地 Hadoop 集群提供了明确的冷热分层基础。
在对象存储中,S3 Lifecycle 可以把对象从一种存储类别转换到另一种存储类别以节省成本;当访问模式未知或变化时,建议可以转到 S3 Intelligent-Tiering,由系统根据访问模式自动移动到更低成本的访问层。Intelligent-Tiering 会把 30 天未访问对象移动到 Infrequent Access 层,把 90 天未访问对象移动到 Archive Instant Access 层;可选归档层则可在 90 天或 180 天后进入更深层归档。
冷热分层治理要特别关注"小对象"和"恢复时间"。S3在默认情况下小于 128KB 的对象不会通过生命周期规则转换到任何存储类别,因为每个对象都会产生转换请求成本,小对象的转换成本可能超过存储节省;另外,大数据冷归档前,常常要先解决小文件合并问题。
六、过期数据清理
过期数据清理不是"删目录",而是"基于元数据、事务日志、快照和合规规则删除"。如果绕过表格式和元数据系统直接删除文件,很容易造成元数据与物理文件不一致,甚至导致查询失败。
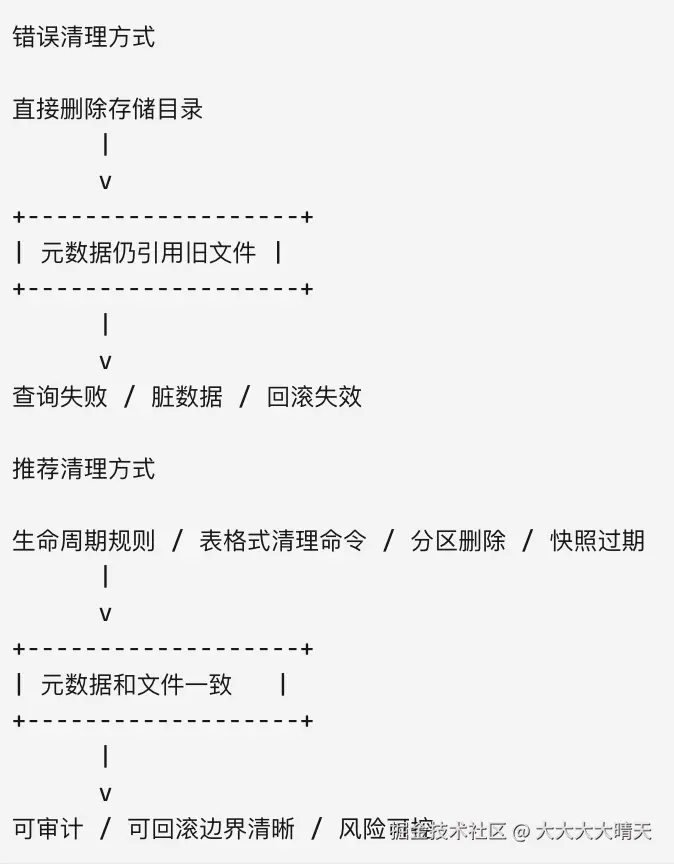
在 Hive 表中,分区清理通常可以通过ALTER TABLE DROP PARTITION 或分区保留策略完成。前面提到的partition.retention.period 属于元数据层生命周期配置,能在分区达到保留周期后删除分区及其数据。
在 Iceberg 中,过期数据清理至少包括三类动作:过期 snapshot、删除 orphan files、必要时清理旧 metadata files。删除 orphan files 时,如果保留间隔短于任何写入完成所需时间,可能把正在写入的文件误判为孤儿文件并删除,从而破坏表,默认间隔是 3 天,清理策略必须考虑最长写入时间和任务失败重试窗口。
因此,过期清理可以按下表设计:
| 数据类型 | 清理动作 | 风险点 |
|---|---|---|
| Hive 分区表 | 删除过期分区 | 外部表路径是否被其他表共享 |
| Iceberg 表 | expireSnapshots、deleteOrphanFiles | 影响 time travel,孤儿文件误删风险 |
| Delta 表 | VACUUM | 影响历史版本查询,并发读写窗口不足可能出错 |
| 对象存储归档 | Lifecycle expiration | 合规保留期、恢复需求、最短计费周期 |
| 临时表 | 定时删除 | 是否被下游任务隐式依赖 |
七、存储压缩
存储压缩不是单纯追求压缩率,而是在存储成本、读取性能、CPU 开销和兼容性之间做取舍。列式格式如 Parquet、ORC 通常比行式文本更适合分析型负载,因为它们支持列裁剪、谓词下推、编码和压缩。
Parquet 是一种列式格式,Spark SQL 支持读写 Parquet 并保留 schema;写入 Parquet 时的compression 选项支持none 、uncompressed 、snappy 、gzip 、lzo 、brotli 、lz4 、zstd 等 codec,默认会覆盖spark.sql.parquet.compression.codec 配置;ORC 写入压缩支持none 、snappy 、zlib 、lzo 、zstd 、lz4 、brotli 等,ORC 的compression 默认值为zstd 。
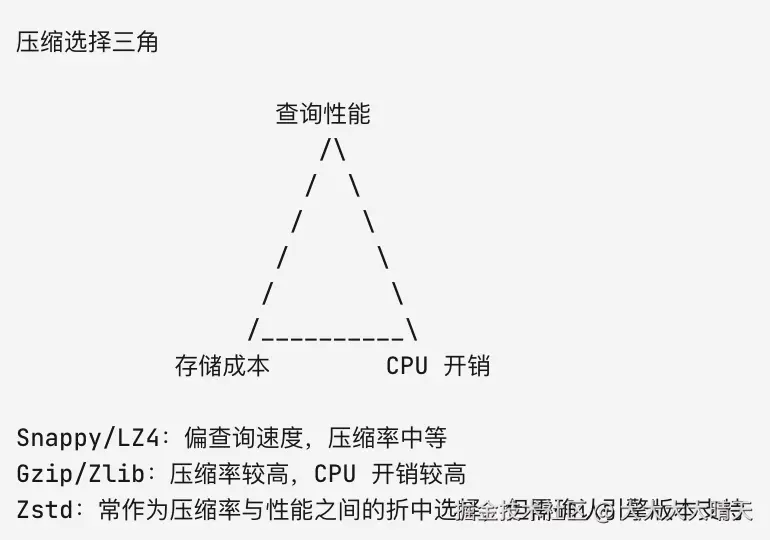
一个常见策略是:
| 数据层 | 推荐倾向 | 原因 |
|---|---|---|
| ODS 原始层 | Parquet/ORC + 通用压缩 | 保留明细,兼顾成本与可读性 |
| DWD 明细层 | Parquet/ORC + Snappy/Zstd | 查询频繁,需要读取性能 |
| DWS/ADS 汇总层 | Parquet/ORC + Snappy/Zstd | 多用于报表和服务,延迟敏感 |
| 冷归档层 | 更高压缩率格式或对象归档 | 查询少,优先成本 |
八、成本分摊
数据治理要让成本可度量,核心是把"存储费用"和"计算费用"映射到资产、团队、业务线或产品。否则平台团队只能看到总账单,却无法解释哪些业务在制造成本、哪些数据长期无人访问、哪些任务在重复产出无价值数据。
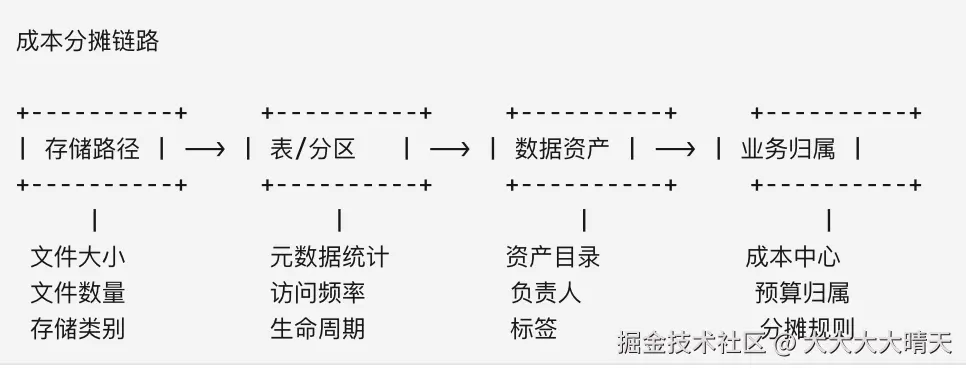
成本分摊一般可以从四类指标入手:
| 指标 | 说明 |
|---|---|
| 存储量 | 表大小、分区大小、历史增长趋势 |
| 文件数 | 小文件数量、平均文件大小、文件增长速度 |
| 访问热度 | 查询次数、最近访问时间、下游依赖数量 |
| 存储类别 | 热存储、温存储、冷存储、归档存储占比 |
在湖仓表中,成本分摊还可以利用表格式的元数据。Iceberg 中的files metadata table 可用于检查数据文件大小并判断何时 compact 分区;Delta Lake 的DESCRIBE DETAIL 可返回表的文件数量、数据大小等明细,DESCRIBE HISTORY 还可以看到写入、删除、合并、优化等操作及其指标,这些都可以作为成本归因的基础。
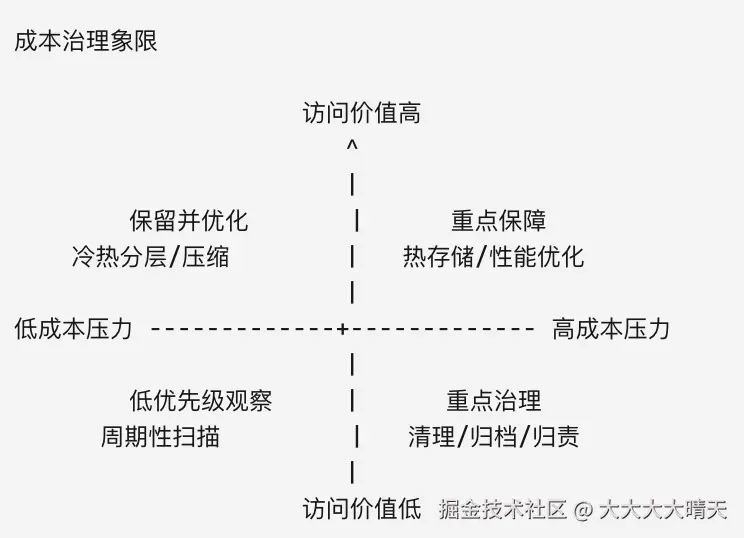
更进一步,成本分摊不应只看"当前占用多少 TB",还要看"是否值得继续占用"。例如,一张 20TB 的审计表如果有明确合规要求,成本是合理的;一张 2TB 的临时中间表如果 90 天无人访问且无下游依赖,就可能是治理对象。
九、实践落地路径
将上述内容落地,可以按"盘点、分级、策略、执行、度量"五步推进。
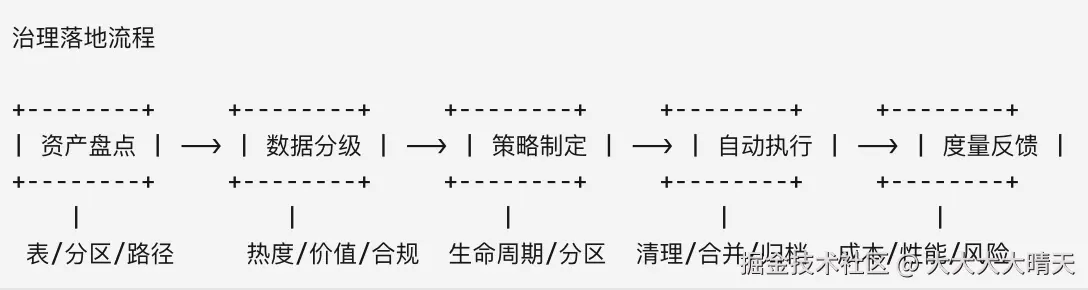
第一步是建立存储画像,包括表大小、分区数、文件数、平均文件大小、最近访问时间、负责人和下游依赖。
第二步是对数据分级,把高价值高热度数据、低价值低热度数据、合规保留数据、临时过程数据区分开。
第三步是制定策略,比如哪些表按天分区、哪些分区保留 180 天、哪些表每周 compact、哪些数据 90 天后转冷。
第四步是通过调度、表格式过程、对象存储生命周期规则执行。
第五步是看结果,包括存储下降多少、小文件减少多少、查询是否变快、历史回滚窗口是否仍满足要求。
治理效果可以用下面这些指标衡量:
| 指标 | 含义 |
|---|---|
| 存储总量增长率 | 判断治理是否抑制无序增长 |
| 小文件数量下降率 | 判断 compaction 是否有效 |
| 平均文件大小 | 判断文件布局是否健康 |
| 冷数据占比 | 判断冷热分层是否生效 |
| 无访问表数量 | 识别可清理或归档对象 |
| 单业务线存储成本 | 支撑成本分摊和预算管理 |
| 清理后故障数 | 衡量治理是否引入风险 |