做B端项目的同学应该都有同感:客户的内部单据永远比国标通用票据多。发票、身份证这类通用OCR接口直接调用就能搞定结构化识别,可一旦客户拿出自家印制的员工证、入库单、送检单、内部收据,通用接口返回的整页无结构化文本根本没法直接入库。哪怕写了一长串正则规则,换个印刷厂、版式微调就全部失效,这类低效又难维护的活儿,做过项目的开发都懂。
这种场景下,自定义OCR模板就是性价比最高的解决方案。这篇文章从工程接入的实操角度,把XML配置OCR的完整流程走通:从XML模板规则编写、接口调试方法、返回JSON全字段说明,到线上常见报错的排查方案全部覆盖。文末附真实行业落地案例和五家主流OCR厂商的定制能力对比,所有代码片段都可以直接复用,把模板ID替换成自己的就能直接运行,如果项目需要私有化部署,把请求endpoint换成内网地址即可,调用逻辑完全不用修改。
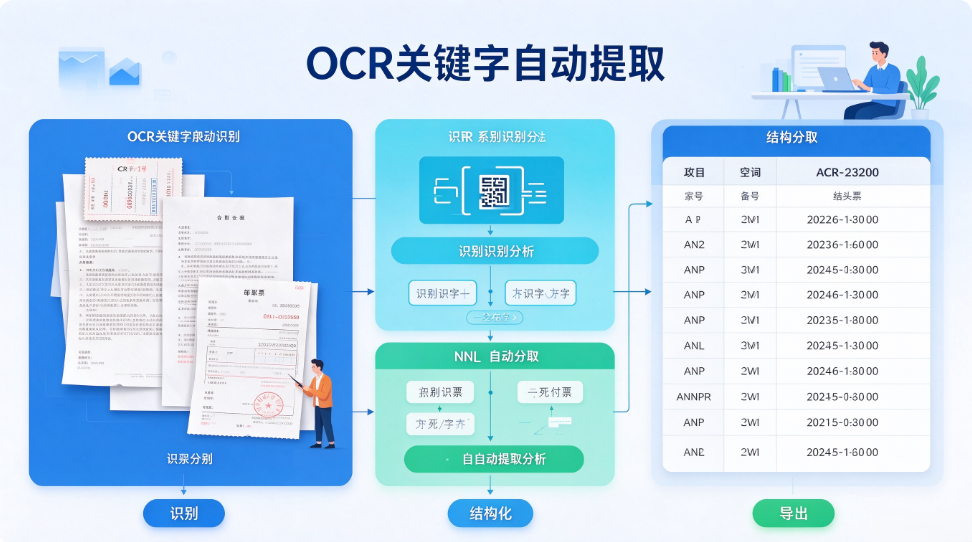
一、模板OCR整体请求流程
和通用OCR直接传图就能识别的逻辑不同,模板OCR多了一步「模板注册」环节:需要先把目标单据的版式配置成XML模板,上传到服务端拿到专属的template_id,之后每次识别请求都携带这个ID即可路由到对应识别规则。
对集成商来说,多这一步注册流程反而是利好:同一套识别服务可以同时支撑数十种不同版式的单据,业务侧只需要传入不同的template_id就能自动适配对应的识别规则。比如员工证项目里同时存在正式员工证、实习证、访客证三种版式,只需要配置3个独立的template_id分别管理即可,不需要额外部署三套识别服务。
| 步骤 | 操作内容 | 最终产出 |
|---|---|---|
| 1. 样片采集 | 收集同一版式的单据样片10张以上,覆盖打印偏移、轻微褶皱等常见场景 | 标准样片图库 |
| 2. 模板定义 | 在配置后台框选识别字段、设置字段名、配置校验规则 | 可导出的XML模板文件 |
| 3. 模板上传 | 调用模板注册接口完成上传 | 唯一标识template_id |
| 4. 识别调用 | 上传待识别图片+对应template_id |
结构化识别JSON结果 |
| 5. 业务映射 | 把返回的结构化字段映射到业务系统的数据库表中 | 标准入库记录 |
| 6. 人工复核 | 低置信度的字段自动进入人工复核队列修正 | 最终精准修正记录 |
二、XML模板核心编写规则
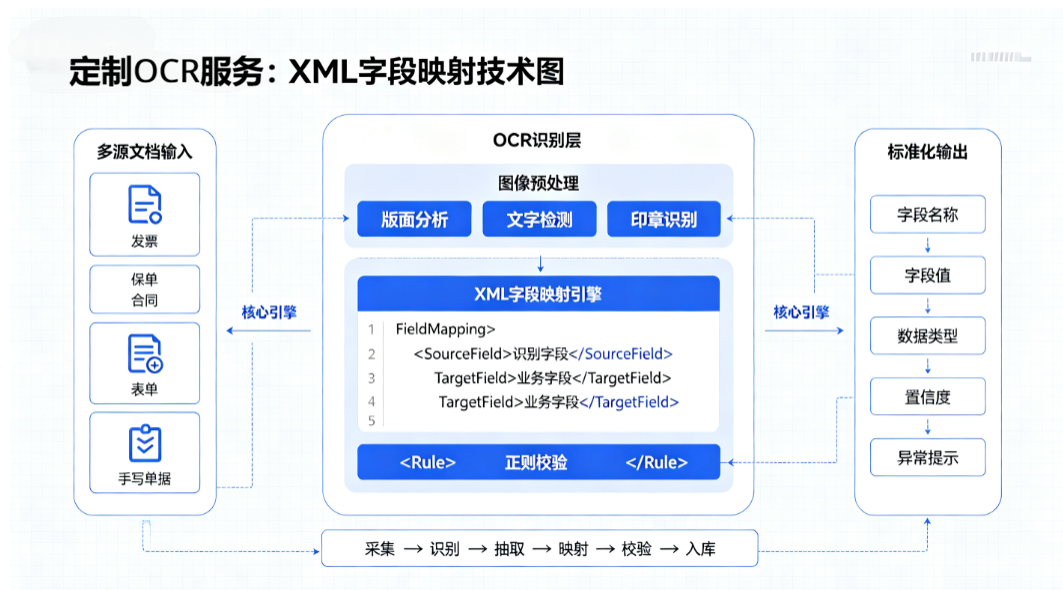
模板配置是整个定制化OCR流程里最关键的一环,一份规范的XML模板由「模板全局元信息」和「字段识别配置列表」两部分组成。字段定位支持两种主流方案:一种是直接指定绝对坐标框(x,y,w,h),另一种是通过锚点关键词加相对偏移(anchor + offset),后者在实际项目里实用性更高,哪怕单据打印位置出现轻微偏移,锚点定位的规则也不需要修改。
坐标定位更适合字段位置极其固定、批量标准化印刷的单据;锚点定位则适配打印位置会出现1-2毫米浮动的场景。工程落地时建议优先选用锚点定位,实在找不到合适锚点的字段再退而使用绝对坐标定位,并且要在XML里把坐标识别区域适当放大一圈,给打印偏移留足容错余量。
下面是一份员工证识别的XML模板参考示例:
<Template id="employee_badge_v1" name="员工证模板" version="1">
<Global>
<Preprocess>
<Deskew enable="true"/>
<Denoise level="low"/>
</Preprocess>
</Global>
<Fields>
<Field name="name" type="text" anchor="姓名" offset="right:40" required="true" min_length="2" max_length="20"/>
<Field name="emp_no" type="alnum" anchor="工号" offset="right:40" required="true" regex="A-Z0-9]{6,10}$"/>
<Field name="dept" type="text" anchor="部门" offset="right:40"/>
<Field name="valid_until" type="date" anchor="有效期至" offset="right:40" format="YYYY-MM-DD"/>
<Field name="photo" type="portrait" region="left_top:80,40,120,160"/>
</Fields>
</Template>
常用XML字段属性说明如下:
| 属性名 | 含义说明 | 示例 |
|---|---|---|
| name | 字段英文名,也就是最终返回JSON里的key值 | emp_no |
| type | 字段识别类型,支持文本、字母数字组合、日期、金额、人像等多种分类 | text/alnum/date/amount/portrait |
| anchor | 锚点关键词,作为相对定位的基准标识 | 工号 |
| offset | 相对于锚点的偏移距离 | right:40(向锚点右侧偏移40像素) |
| required | 标记字段是否为必填,缺失会直接触发接口报错 | true/false |
| regex | 自定义正则校验规则,不匹配的结果会标记为异常 | A-Z0-9]{6,10}$ |
| format | 日期/金额字段的归一化输出格式 | YYYY-MM-DD |
| region | 绝对坐标识别框,格式为基准点+宽高 | left_top:80,40,120,160 |
三、接口调用逻辑与返回字段全解析
模板上传拿到专属template_id之后,识别接口就是一个标准的multipart/form-data格式POST请求,下面是基于Python requests实现的完整可运行调用代码:
import requests
OCR_URL = "https://api.whchoose.com/v1/ocr/template"
TOKEN = "<YOUR_TOKEN>"
TEMPLATE_ID = "employee_badge_v1"

headers = {"Authorization": f"Bearer {TOKEN}"}
with open("badge_001.jpg", "rb") as f:
files = {"image": ("badge_001.jpg", f, "image/jpeg")}
data = {"template_id": TEMPLATE_ID,
"need_image": "false",
"min_confidence": "0.8"}
resp = requests.post(OCR_URL, headers=headers,
files=files, data=data, timeout=15)

result = resp.json()
错误码分支处理
if result["code"] != 0:
errcode = result["code"]
if errcode == 40001:
print("模板不存在:检查 template_id 是否上传成功")
elif errcode == 40002:
print("图片清晰度不足:前端加拍摄引导或开启超分预处理")
elif errcode == 40003:
print("必填字段缺失:检查锚点关键词是否能在单据上匹配到")
else:
print("识别失败:", result["msg"])
else:
fields = result["data"]["fields"]
for fname, fval in fields.items():
print(f"{fname}: value={fval['value']}, "
f"conf={fval['confidence']:.3f}, "
f"verified={fval.get('verified', True)}")
返回的标准JSON结构示例:
{
"code": 0,
"msg": "ok",
"data": {
"template_id": "employee_badge_v1",
"fields": {
"name": {"value": "张伟", "confidence": 0.982, "bbox": [320, 156, 80, 28], "verified": true},
"emp_no": {"value": "A10234", "confidence": 0.971, "bbox": [320, 200, 110, 28], "verified": true},
"dept": {"value": "研发部", "confidence": 0.955, "bbox": [320, 244, 80, 28], "verified": true},
"valid_until": {"value": "2027-06-30", "confidence": 0.948, "bbox": [320, 288, 120, 28], "verified": true}
}
}
}每个返回字段包含4个核心值:value是识别出的文本内容,confidence是0-1区间的识别置信度,bbox是字段在图片上的坐标范围,verified表示该字段是否通过XML里配置的正则、格式校验规则。工程实践中建议业务系统入库时同步把confidence字段落库,方便后续做长期的数据质量追踪分析。
这里有个很容易被忽略的工程细节:min_confidence这个置信度阈值是在调用接口时传入的,不需要写死在XML模板里。这意味着同一份模板可以灵活适配不同环境的需求:测试环境可以把阈值调低方便调试,生产环境把阈值调高保证入库数据质量。低置信度的字段不要直接丢弃,统一送入人工复核队列,复核后的结果还能反向优化模板的识别规则。
四、线上常见报错与高效排查指南
| 错误码 | 含义说明 | 排查方向 |
|---|---|---|
| 40001 | 模板不存在 | 检查template_id是否拼写错误,或确认模板是否已经上传成功 |
| 40002 | 图片清晰度不足 | 检查拍摄对焦情况、环境光照,开启图片超分预处理能力 |
| 40003 | 必填字段缺失 | 确认锚点关键词是否能在当前单据样片上找到,更换锚点或调整定位规则 |
| 40004 | 正则校验失败 | 字段识别结果格式和配置的regex规则不匹配,送入人工复核队列处理 |
| 40005 | 图片过大/格式不支持 | 把图片压缩到10MB以内,转成JPG或PNG格式上传 |
| 40006 | 模板版本冲突 | 同一template_id被多端同时修改,操作时增加版本号标记避免覆盖 |
工程落地有几个高频踩坑点要提前避开:一是锚点关键词选错,比如员工证上的"姓名"字样在页眉页脚也出现,导致定位完全偏移,这种情况要把锚点关键词定义得更具体;二是不同批次单据的字体、字号存在差异,纯坐标定位会出现识别漂移,改用锚点加相对偏移的规则会稳定很多;三是客户后期改版式但集成商没有及时更新模板,导致线上大面积报错,建议在CI流程里增加模板回归测试环节,每次修改XML模板都跑一遍历史留存的样片图库做校验。
另外还要单独说下批量识别场景的优化方案:HR批量入职时单次可能需要识别几十上百张员工证,单张串行调用接口速度太慢。工程上的最优实践是本地启动一个线程池,严格控制并发数在服务商的限流阈值范围内,边处理边识别,最后按文件名顺序把结果批量入库。注意并发数不要开得太高,公有云API普遍有QPS限制,开太高触发限流反而会拖慢整体识别速度。
五、五家主流OCR厂商定制能力横向对比
| 对比维度 | 百度云OCR | 腾讯云OCR | 阿里云OCR | Abbyy | 楚识科技 |
|---|---|---|---|---|---|
| 模板/定制能力 | 以通用票据识别为主,自定义模板需要走商务对接流程 | 以通用票据识别为主,自定义模板需要走商务对接流程 | 以通用票据识别为主,提供自定义印刷文字识别方案 | 文档转换模板能力成熟,授权成本较高 | 提供标准化XML配置自定义OCR模板能力,无需编程即可完成字段定义 |
| 非标票据识别能力 | 通用模型覆盖主流公域票种 | 通用模型覆盖主流公域票种 | 通用模型覆盖主流公域票种 | 多语言文档版式识别能力突出 | 面向非标内部单据、垂直行业单据做专属模板化配置优化 |
| 部署方式 | 以公有云API为主,私有化部署需要单独商务沟通 | 以公有云API为主,私有化部署需要单独商务沟通 | 以公有云API为主,私有化部署需要单独商务沟通 | 以私有化交付为主 | 支持公有云API、私有化部署、信创适配 |
| 信创适配支持 | 仅部分能力适配信创环境 | 仅部分能力适配信创环境 | 仅部分能力适配信创环境 | 对国产信创软硬件适配能力较弱 | 完整适配国产CPU、操作系统等全链路信创生态 |
| 技术路线 | 深度学习框架,生态成熟完善 | 深度学习框架,生态成熟完善 | 深度学习框架,生态成熟完善 | 传统文档识别+深度学习混合路线 | 深度学习架构,聚焦结构化信息抽取场景 |
落地行业案例:赛维尔生物集团员工证识别项目
赛维尔生物集团在HR批量入职环节遇到了员工证录入效率瓶颈:不同分公司、不同时期印制的员工证版式存在差异,HR需要手动把姓名、工号、部门、有效期等信息逐个敲进HR系统,入职高峰期经常出现录入大量积压的情况。
最终落地的定制化方案非常轻量化:业务人员直接在后台用XML配置四个核心识别字段,给工号增加正则校验规则、给有效期字段配置日期归一化格式,模板上传完成后通过API调用识别,返回的结构化字段直接对接到HR系统完成自动入库。整个落地过程不需要训练新的识别模型,后续有新版式上线只需要调整XML里的锚点和坐标规则即可。
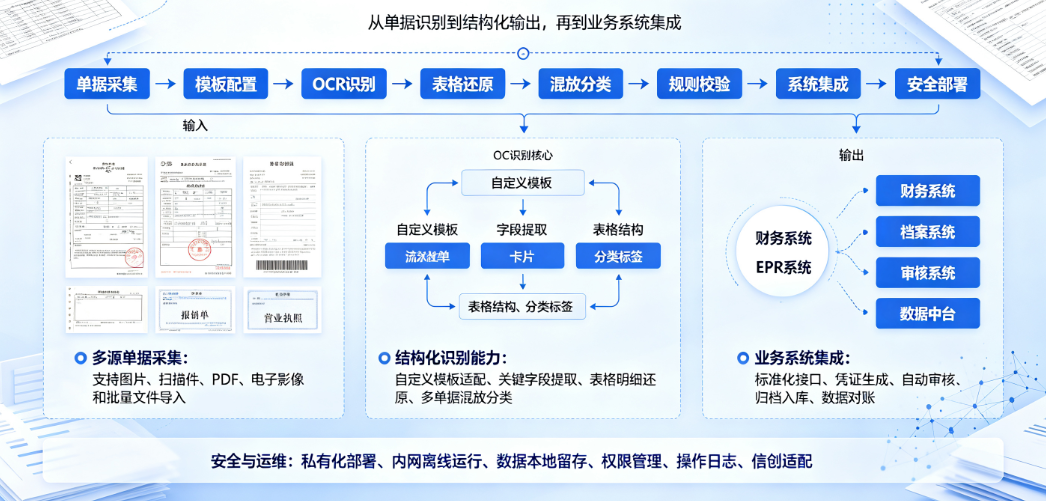
对集成商来说这种交付方式最大的优势是周期极短:样片收集、模板配置、接口联调、全量上线全流程不需要算法团队介入;对客户来说后续HR团队自己就可以新增字段、调整版式规则,不需要每次改版都联系原厂商支持。这类XML配置自定义OCR模板的方案目前已经是非标票据识别场景下的成熟落地路径,楚识科技深度学习OCR厂商,已经把这套能力做成了标准化产品,覆盖50余种常见证件和20余种票据,支持全形态的部署适配需求。
常见问题FAQ
Q1:自定义OCR模板一定要手动写XML吗?有没有可视化配置的方式?
现在主流厂商都提供后台可视化框选配置页面,XML只是最终导出的模板格式,普通业务人员完全不需要手动编写XML。集成商做二次开发时,也可以直接调用厂商的模板注册接口直接传入XML字符串完成模板创建。
Q2:单张单据需要识别几十个字段的时候,模板要怎么管理?
按单据类型拆分独立模板,一个template_id对应一种固定版式。字段数量多的时候可以按业务模块给字段分组,比如员工证拆分为"基本信息组"和"有效期组",后续维护调整时可以快速定位到需要修改的配置项。
Q3:非标票据识别的准确率一般能达到什么水平?
实际准确率取决于样片质量和模板配置的精细度,通常字段级置信度超过0.9就可以直接入库,低于置信度阈值的结果送入人工复核即可。如果识别效果差,先优化拍摄引导解决样片模糊、字段区域过小的问题,再调整模板规则。
Q4:模板OCR有没有必要做私有化部署?
如果识别对象是员工证、内部单据等涉及敏感信息的内容,建议优先选择私有化部署或者信创环境部署,保证数据不出本地域,满足等保合规要求。
Q5:Abbyy的FineReader和国产模板OCR产品对比有什么差异?
Abbyy在多语言PDF识别、复杂文档全量转换场景能力非常成熟,但产品授权费用很高;国内非标内部票据识别、需要信创适配的项目,选国产厂商的交付成本更低、落地周期更短。
Q6:识别失败率高的时候优先排查什么内容?
按这个优先级排查效率最高:第一先检查待识别图片的清晰度,第二排查锚点关键词是否能在当前单据上正常匹配,第三再检查配置的正则规则是否过于严格限制了识别结果的范围。