本文聚焦 RAG 链路中最前置、也最容易被忽视的两个组件------Document Loader (文档加载器)与 Text Splitter (文本切分器),并以最常用的
RecursiveCharacterTextSplitter为例,从原理到代码进行完整拆解。
一、RAG 数据流水线中的两道关卡
在深入组件之前,先用一张全景图定位 Loader 和 Splitter 在整个 RAG 系统中的位置:
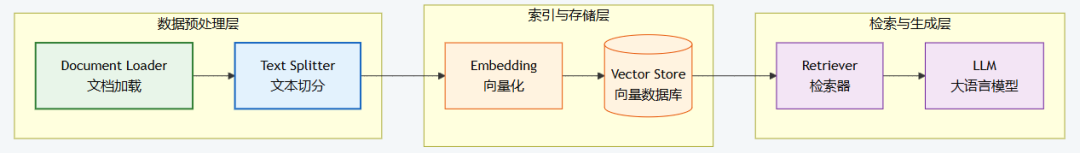
上图标注绿色的 Document Loader 和蓝色的 Text Splitter,是 RAG 数据流入系统的第一道和第二道关卡:
-
• Loader 负责"把东西读进来 "------从 PDF、网页、数据库、SaaS 工具等异构数据源读取内容,统一封装为 LangChain 内部的
Document对象。 -
• Splitter 负责"把大块切成小块"------将长文档拆分为语义连贯的片段(chunk),使每个片段既能独立被检索,又不会超出模型的上下文窗口。
这两步做不好,后面再强的 Embedding 模型和 LLM 也救不回来------垃圾进,垃圾出。
二、Document Loader:统一数据入口
2.1 Document 对象------一切的起点
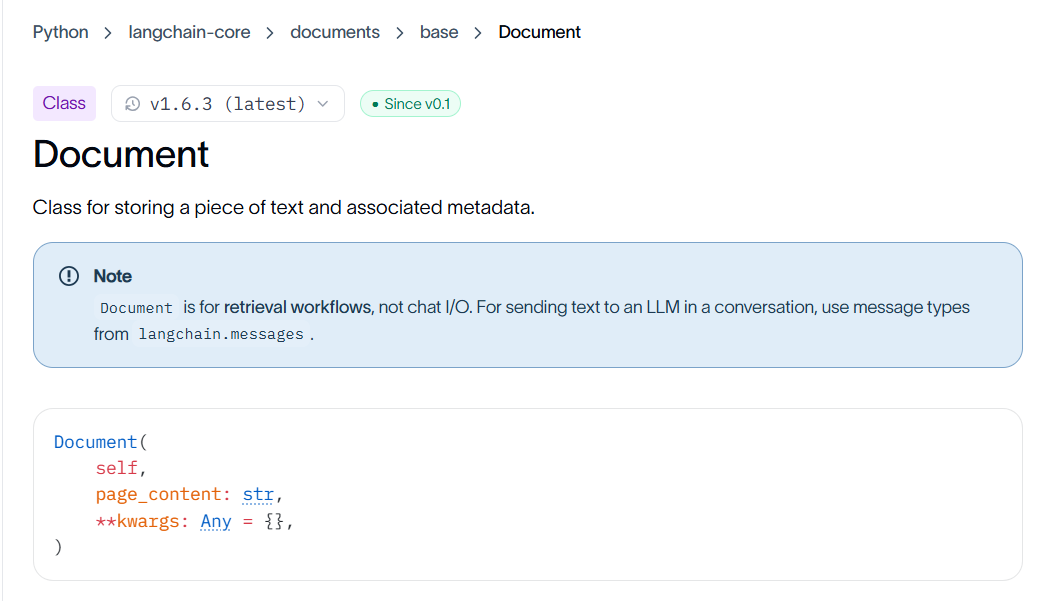
Loader 输出的每个文档都是一个 Document 对象,结构非常简洁:
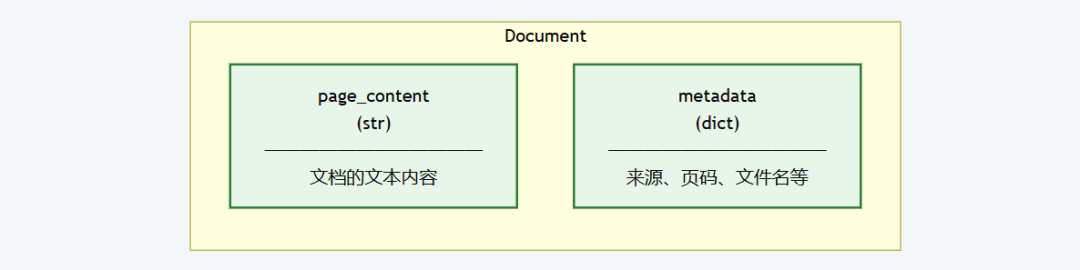
| 字段 | 类型 | 说明 |
|---|---|---|
page_content |
str |
文档的核心文本内容,后续所有切分、向量化都基于此字段 |
metadata |
dict |
附属信息,如来源 URL、页码、作者等,不参与切分,但会随 chunk 一起传播 |
metadata 是一个容易被忽略但至关重要的设计。
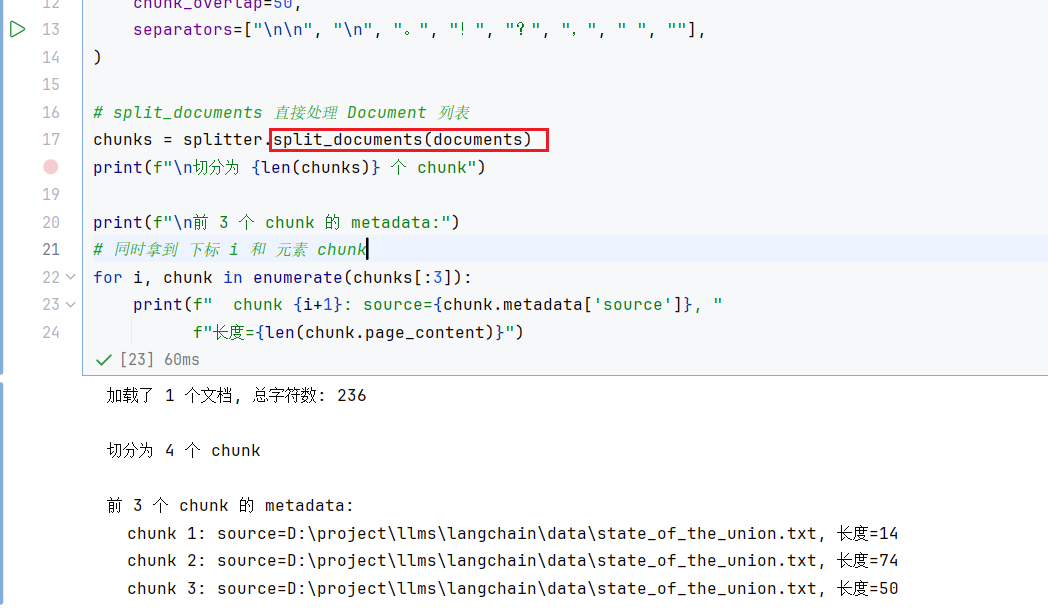
切分后的每个 chunk 都会继承父文档的 metadata,这意味着你在检索阶段不仅能拿到文本,还能追溯到它来自哪个文件、哪一页。
2.2 BaseLoader------所有加载器的统一接口
LangChain 的设计哲学是"接口统一、实现多样 "。所有 Loader 都实现 BaseLoader 接口:
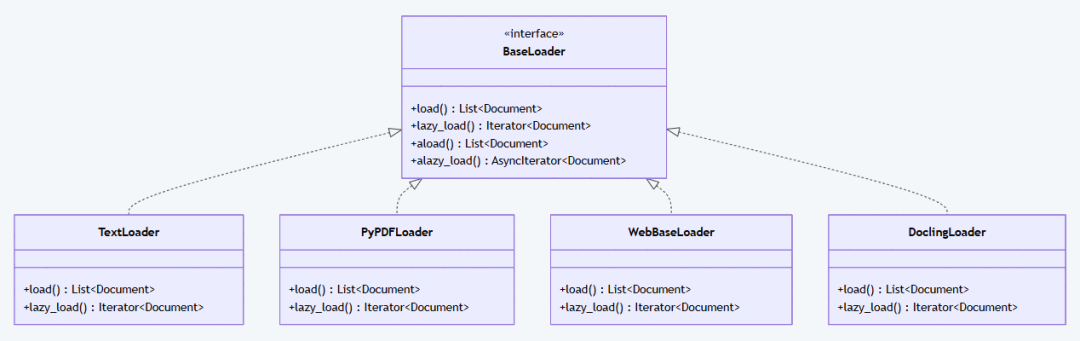
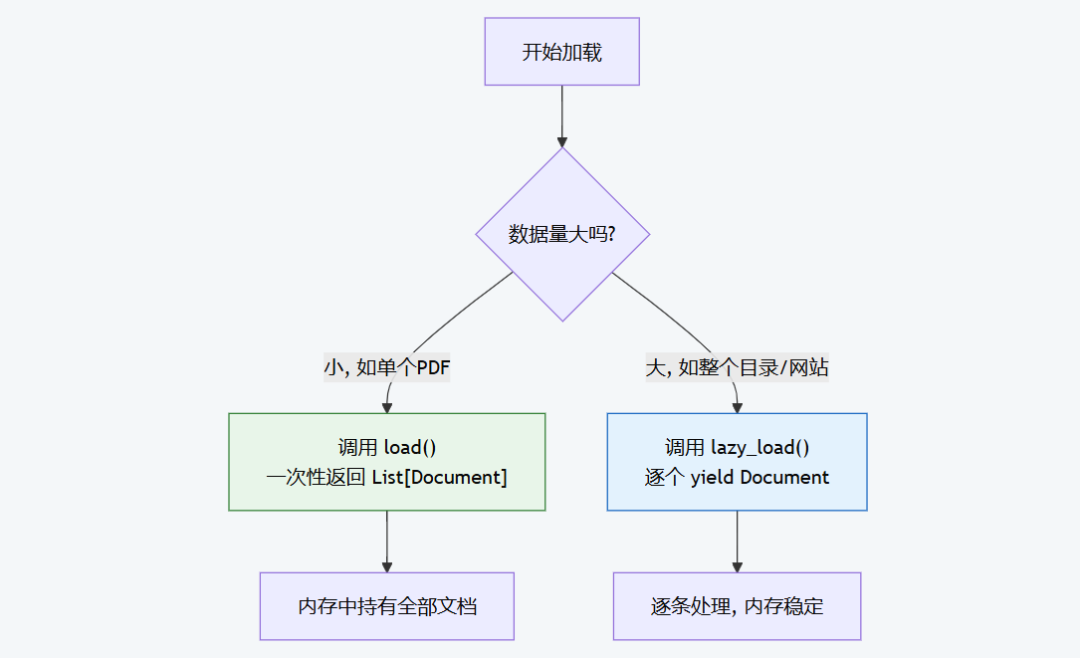
核心方法只有两个,但它们的区别决定了你能处理多大规模的数据:
| 方法 | 行为 | 适用场景 |
|---|---|---|
load() |
一次性加载所有文档到内存 | 小数据集、快速原型 |
lazy_load() |
逐个 yield 文档,惰性迭代 | 大数据集、流式处理 |
这个区别看似微妙,但在处理包含数千个文件的目录或爬取大型网站时,load() 可能直接导致内存溢出,而 lazy_load() 则可以平稳地逐条处理
2.3 Loader 分类全景
LangChain 官方文档将 Loader 按数据源类型分为几大类:
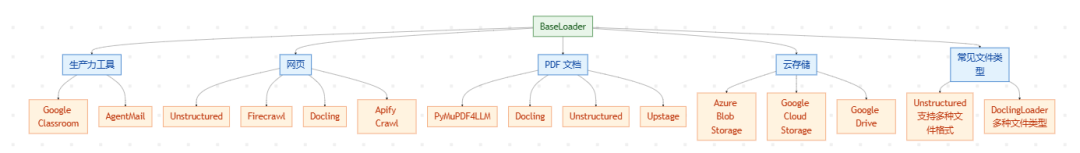
这里有几个值得关注的加载器:
-
• Unstructured :生态最广的通用加载器,支持 PDF、HTML、Word、PPT、邮件等数十种格式,底层依赖
unstructured库。 -
• Docling:IBM 开源的新一代文档解析引擎,对复杂排版(表格、多栏、图文混排)的解析质量很高。
-
• PyMuPDF4LLM:专为 LLM 场景优化的 PDF 加载器,速度快,对表格和图片的处理较好。
-
• Firecrawl / Apify:商用爬虫服务,适合大规模网页采集后直接灌入 RAG。
2.4 Loader 代码案例
下面演示几种最常用的 Loader 用法,你可以自行测试并截图。
案例 1:加载文本文件
loader = TextLoader("D:\\project\\llms\\langchain\\data\\state_of_the_union.txt",encoding = 'utf-8')
documents = loader.load()

print(f"加载了 {len(documents)} 个文档\n")
print(f"page_content 前 100 字符: {documents[0].page_content[:100]}\n")
print(f"metadata: {documents[0].metadata}")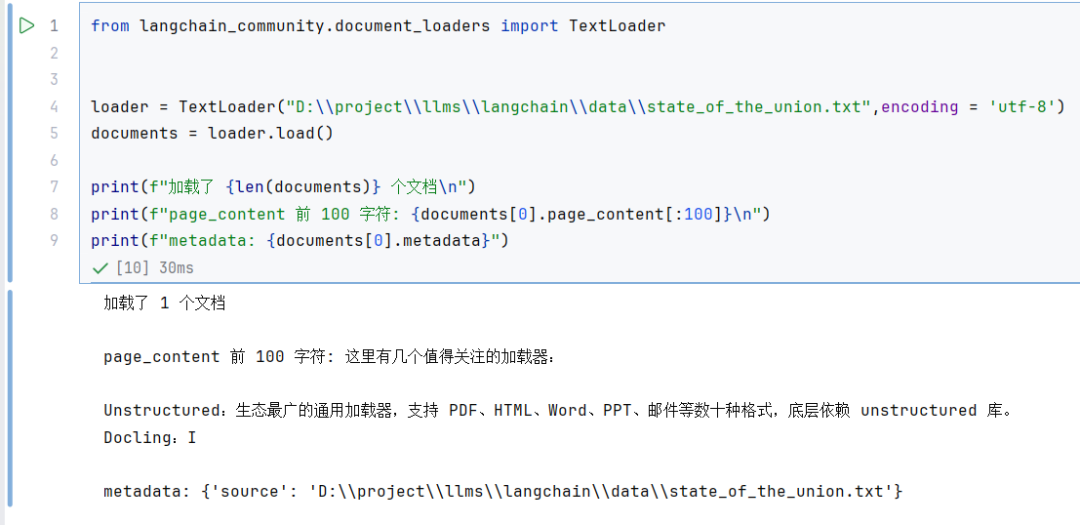
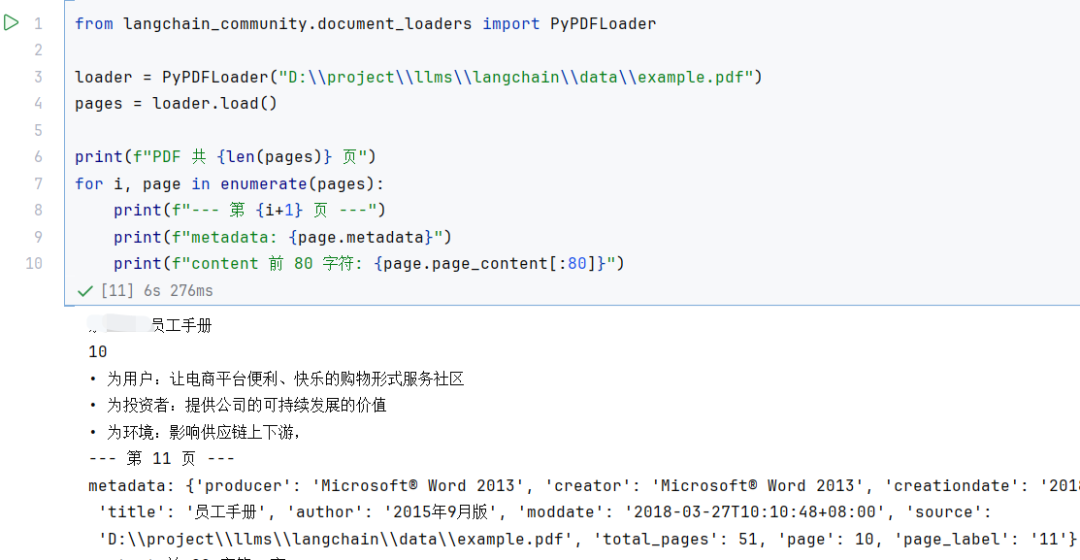
案例 2:加载 PDF(每页一个 Document)
from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader("example.pdf")
pages = loader.load()

print(f"PDF 共 {len(pages)} 页")
for i, page in enumerate(pages):
    print(f"--- 第 {i+1} 页 ---")
    print(f"metadata: {page.metadata}")
    print(f"content 前 80 字符: {page.page_content[:80]}")
PyPDFLoader 会将每页 PDF 封装为一个独立的
Document,metadata中包含{'page': N, 'source': 'example.pdf'}。
这个页码信息在后续检索时非常有用------你可以告诉用户答案来自原文第几页。
案例 3:加载网页
from langchain_community.document_loaders import WebBaseLoader

loader = WebBaseLoader("https://python.langchain.com/docs/get_started/introduction")
docs = loader.load()

print(f"加载了 {len(docs)} 个文档")
print(f"metadata: {docs[0].metadata}")
print(f"content 前 200 字符: {docs[0].page_content[:200]}")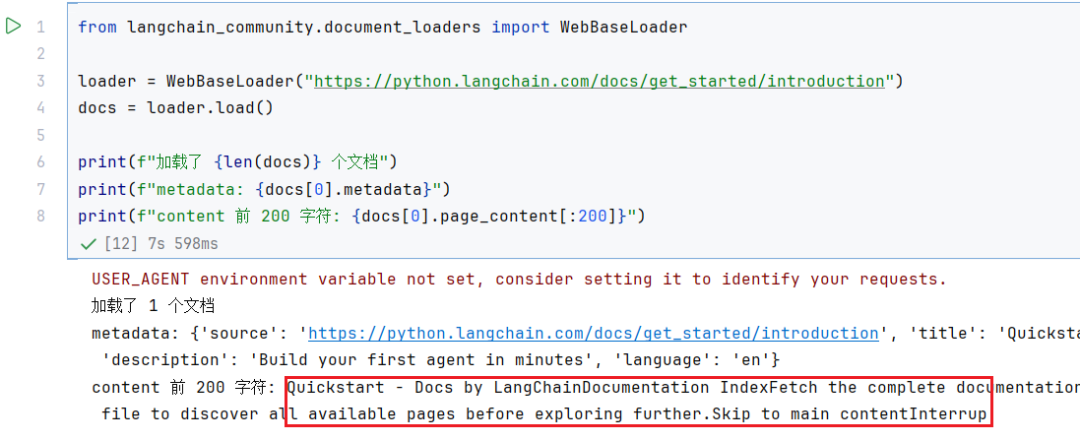
案例 4:惰性加载大型目录
from langchain_community.document_loaders import DirectoryLoader

# 批量加载目录下所有 .txt 文件
loader = DirectoryLoader(
    "./documents",
    glob="**/*.txt",
    loader_cls=TextLoader,
    show_progress=True,
)

# 大目录场景:使用 lazy_load 逐条处理
for doc in loader.lazy_load():
    print(f"处理: {doc.metadata['source']}, 长度: {len(doc.page_content)}")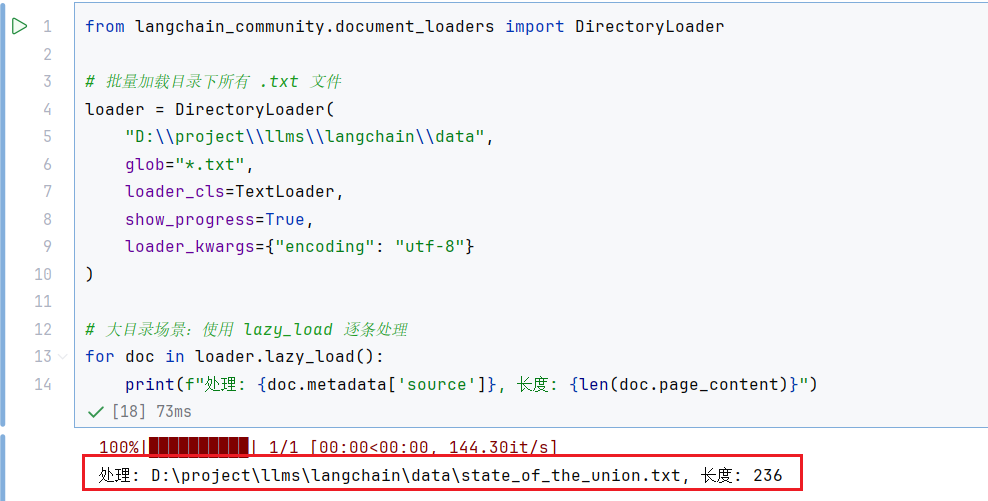
三、Text Splitter:切分策略与选型
3.1 为什么必须切分
Loader 产出的是完整文档,但直接将一篇万字长文喂给 Embedding 模型或 LLM 有两个致命问题:
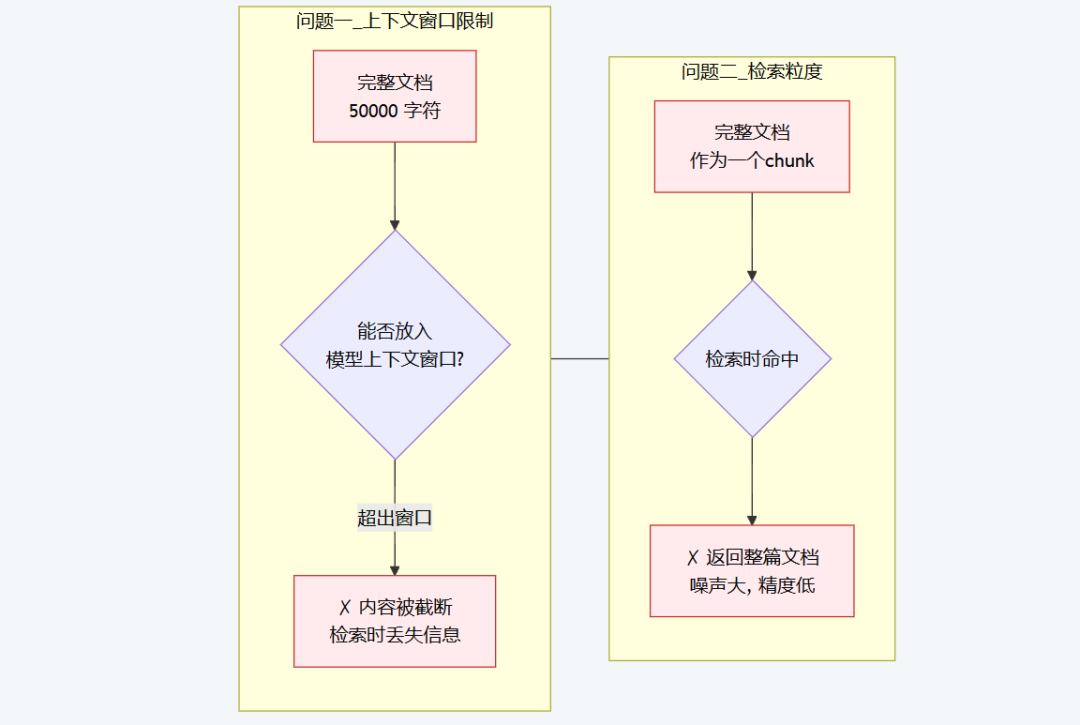
切分的目标是在语义完整性 和chunk 大小约束之间找到平衡:每个 chunk 足够小以适配模型窗口,又足够大以保持语义自洽
3.2 三大切分策略概览
LangChain 官方文档将切分策略分为三类:
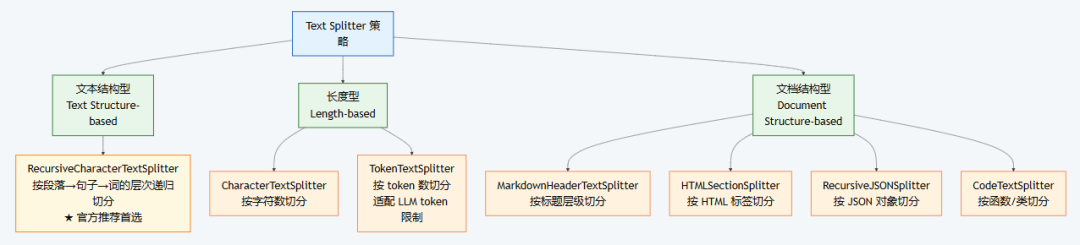
| 策略 | 切分依据 | 适用场景 | 代表 Splitter |
|---|---|---|---|
| 文本结构型 | 段落、句子、词的层次 | 通用文本(推荐首选) | RecursiveCharacterTextSplitter |
| 长度型 | 字符数或 token 数 | 需精确控制 chunk 大小 | CharacterTextSplitter 、TokenTextSplitter |
| 文档结构型 | HTML 标签、Markdown 标题、JSON 结构 | 有结构标记的文档 | MarkdownHeaderTextSplitter 等 |
官方文档明确建议:对于大多数场景,直接从 RecursiveCharacterTextSplitter 开始,它在保持上下文完整和管理 chunk 大小之间提供了良好的平衡1。
四、RecursiveCharacterTextSplitter 深度解析
这是整个 Splitter 体系中最核心、使用率最高的组件。理解它的原理,等于掌握了 LangChain 文本切分的核心思想。
4.1 核心思想:递归降级切分
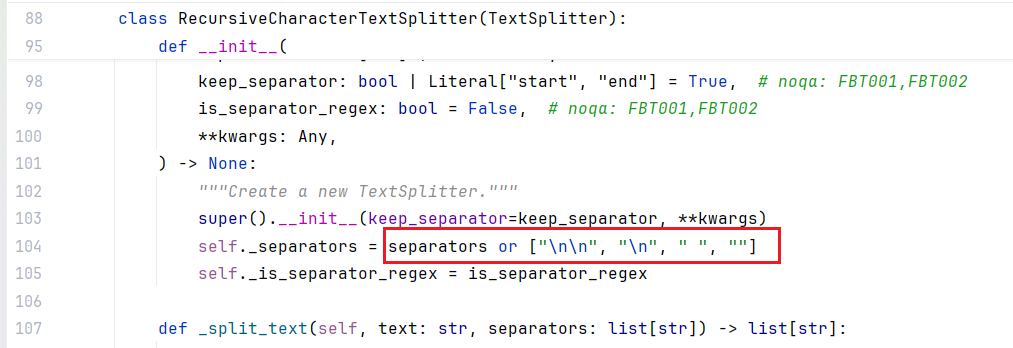
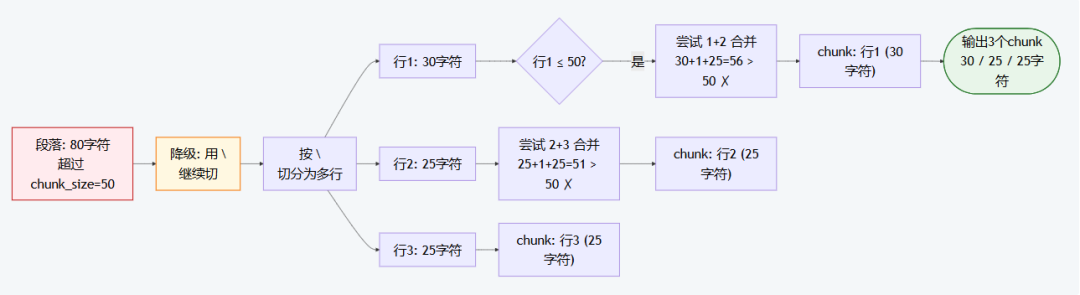
RecursiveCharacterTextSplitter 的设计哲学是:尽最大努力保持语义单元的完整性。
它维护一个有序的分隔符列表,默认值为:
这个列表的顺序不是随意的------它代表了从大到小的语义层次:
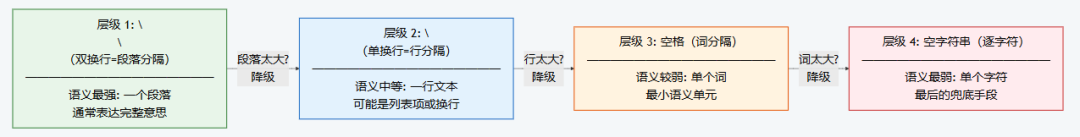
切分算法的核心逻辑可以用以下伪代码描述:
function split_text(text, separators, chunk_size):
    separator = separators[0]  # 先用最大的分隔符

    # 用 separator 把文本分成多段
    splits = text.split(separator)

    chunks = []
    current_chunk = ""

    for split in splits:
        # 如果这段本身就已经超出了 chunk_size
        if length(split) > chunk_size and len(separators) > 1:
            # 递归:用下一级分隔符继续切
            sub_chunks = split_text(split, separators[1:], chunk_size)
            chunks.extend(sub_chunks)
        elif length(current_chunk + separator + split) <= chunk_size:
            # 当前段还能放下,拼进去
            current_chunk += separator + split
        else:
            # 放不下了,当前 chunk 收尾,开始新 chunk
            chunks.append(current_chunk)
            current_chunk = split

    if current_chunk:
        chunks.append(current_chunk)

    return chunks
对应的流程图:
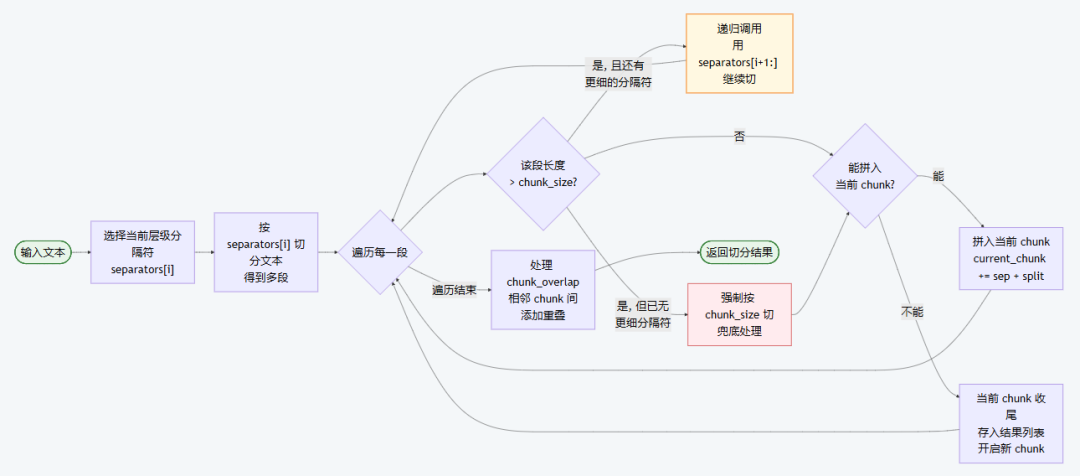
关键直觉:这个算法就像剥洋葱------先尝试沿段落边界撕开(代价最小、语义保持最好),撕不开再沿行边界撕,还不行再沿词边界撕,最差情况才会把一个词从中间劈开。
4.2 一个完整的切分示例
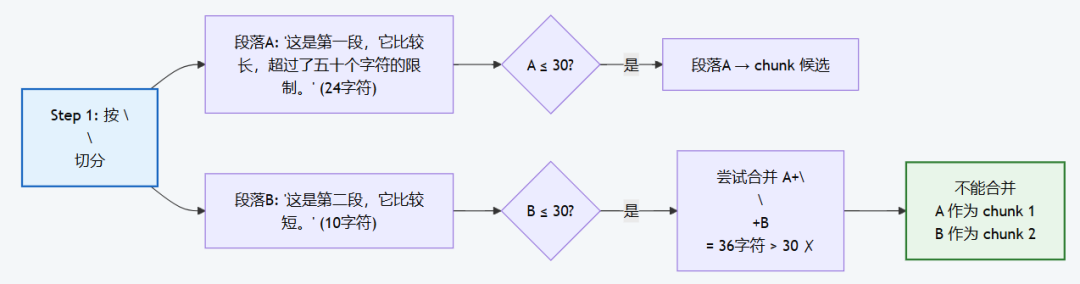
用一个具体例子来走一遍流程。假设有如下文本,chunk_size=50,chunk_overlap=0:
这是第一段,它比较长,超过了五十个字符的限制。\n\n这是第二段,它比较短。切分过程如下:
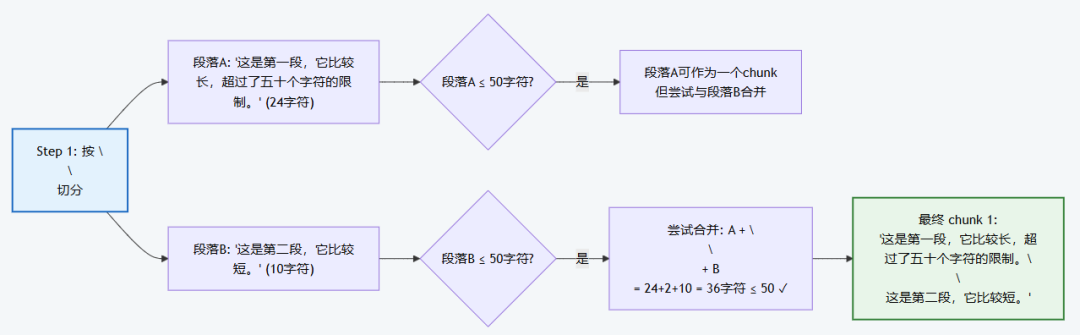
现在改一下条件:chunk_size=30:
如果段落本身就超过了 chunk_size,递归降级就启动了:
4.3 chunk_overlap:为何要让 chunk"重叠"
chunk_overlap 参数控制相邻 chunk 之间的重叠区域大小。为什么要重叠?看下图:
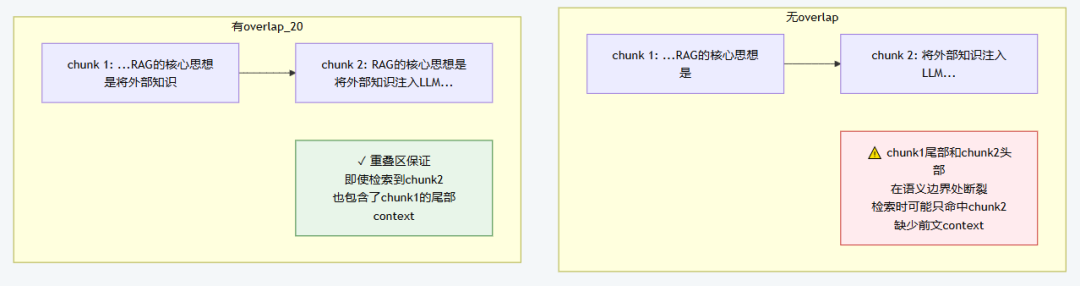
重叠区的本质是用冗余换鲁棒性 ------在 chunk 边界处牺牲一点存储空间,换取检索时上下文不会断裂。典型的经验值是 chunk_overlap = chunk_size * 10%~20%。
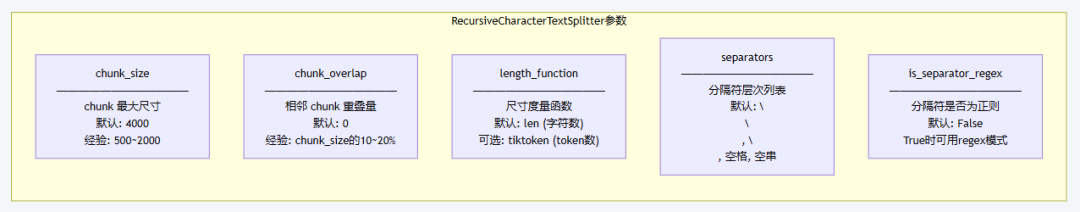
4.4 参数全景
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
chunk_size |
int |
4000 | chunk 的最大尺寸,尺寸由 length_function 定义 |
chunk_overlap |
int |
0 | 相邻 chunk 之间的重叠字符数 |
length_function |
Callable |
len |
度量文本长度的函数,默认按字符数,也可用 tiktoken 按 token 数 |
separators |
List[str] |
["\n\n", "\n", " ", ""] |
有序分隔符列表,从大到小递归降级 |
is_separator_regex |
bool |
False |
是否将 separators 视为正则表达式 |
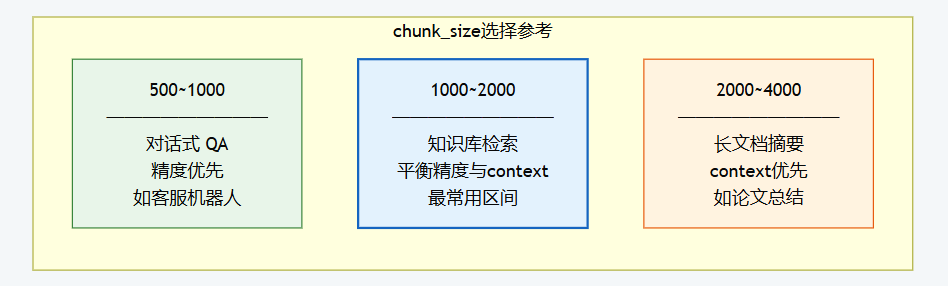
关于 chunk_size 的选择,没有一个放之四海皆准的值,但有一些经验区间:
4.5 中文与无词边界语言的处理
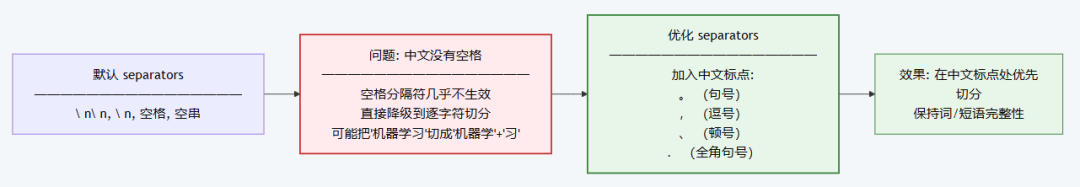
默认分隔符列表 ["\n\n", "\n", " ", ""] 对英文很合适,因为英文以空格分词。
但中文、日文、泰文等书写系统没有词边界,空格分隔符几乎无效,直接降级到逐字符切分,可能把一个词从中间切断。
官方文档给出了针对中文的解决方案------在分隔符列表中加入中文标点:
4.6 完整代码案例
案例 1:基础用法------split_text vs create_documents
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 示例文本
text = """太长"""

# 创建 splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=100,
    chunk_overlap=20,
    length_function=len,
    is_separator_regex=False,
)

# 方式1: split_text --- 返回字符串列表
texts = text_splitter.split_text(text)
print(f"切分为 {len(texts)} 个 chunk:")
for i, t inenumerate(texts):
    print(f"\n--- chunk {i+1} ({len(t)}字符) ---")
    print(t)

# 方式2: create_documents --- 返回 Document 对象列表(带 metadata)
documents = text_splitter.create_documents([text])
print(f"\ncreate_documents 返回 {len(documents)} 个 Document:")
for i, doc inenumerate(documents):
    print(f"\n--- Document {i+1} ---")
    print(f"page_content ({len(doc.page_content)}字符): {doc.page_content[:80]}...")
    print(f"metadata: {doc.metadata}")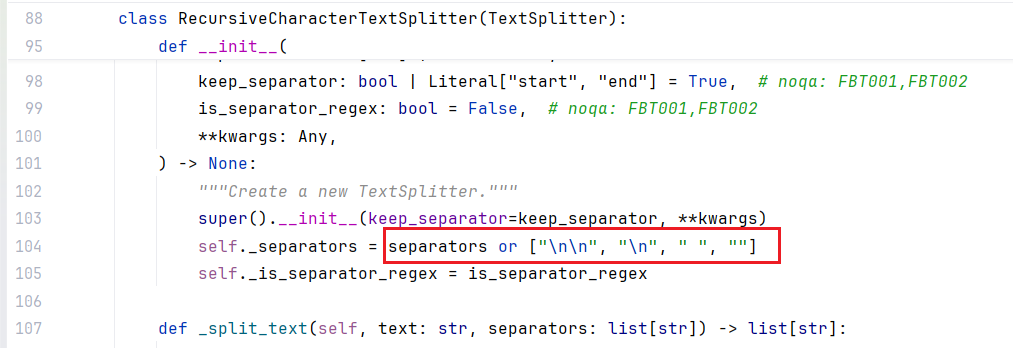
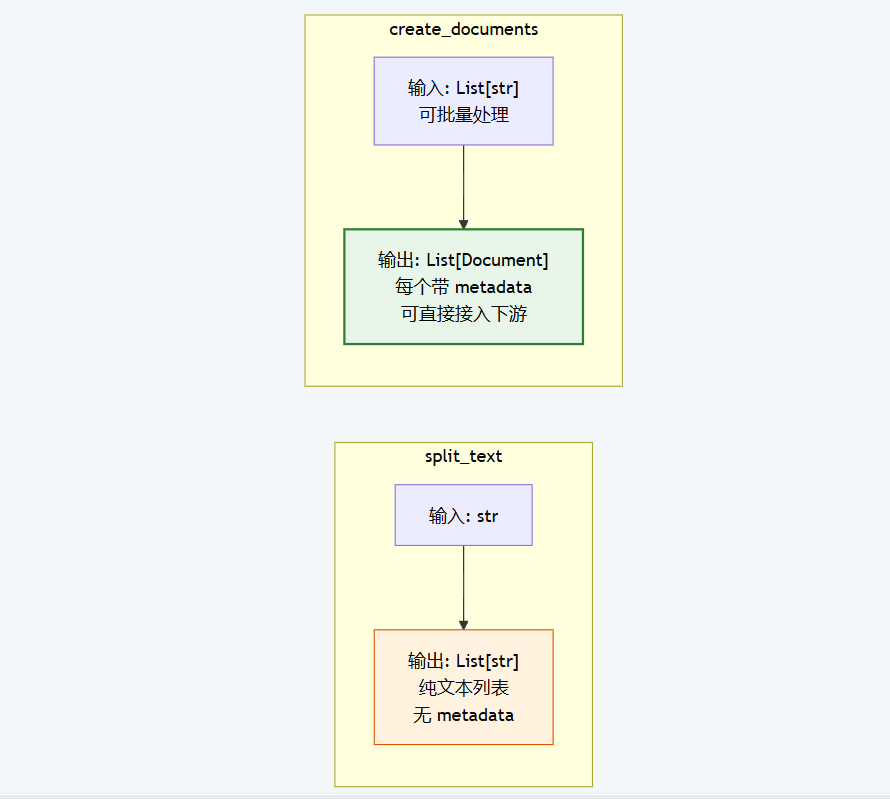
split_text 和 create_documents 的核心区别:
案例 2:中文优化分隔符
from langchain_text_splitters import RecursiveCharacterTextSplitter

chinese_text = """太长"""

# 默认分隔符------对中文可能不太友好
splitter_default = RecursiveCharacterTextSplitter(
    chunk_size=100,
    chunk_overlap=10,
)
texts_default = splitter_default.split_text(chinese_text)
print("=== 默认分隔符 ===")
for i, t inenumerate(texts_default):
    print(f"chunk {i+1}: {t[:60]}...")

# 中文优化分隔符
splitter_cn = RecursiveCharacterTextSplitter(
    chunk_size=100,
    chunk_overlap=10,
    separators=[
        "\n\n",
        "\n",
        "。",
        ",",
        "、",
        "\uff0c",  # 全角逗号 ,
        "\u3001",  # 顿号 、
        "\uff0e",  # 全角句号 .
        "\u3002",  # 句号 。
        "\u200b",  # 零宽空格(泰语/日语)
        " ",
        "",
    ],
)
texts_cn = splitter_cn.split_text(chinese_text)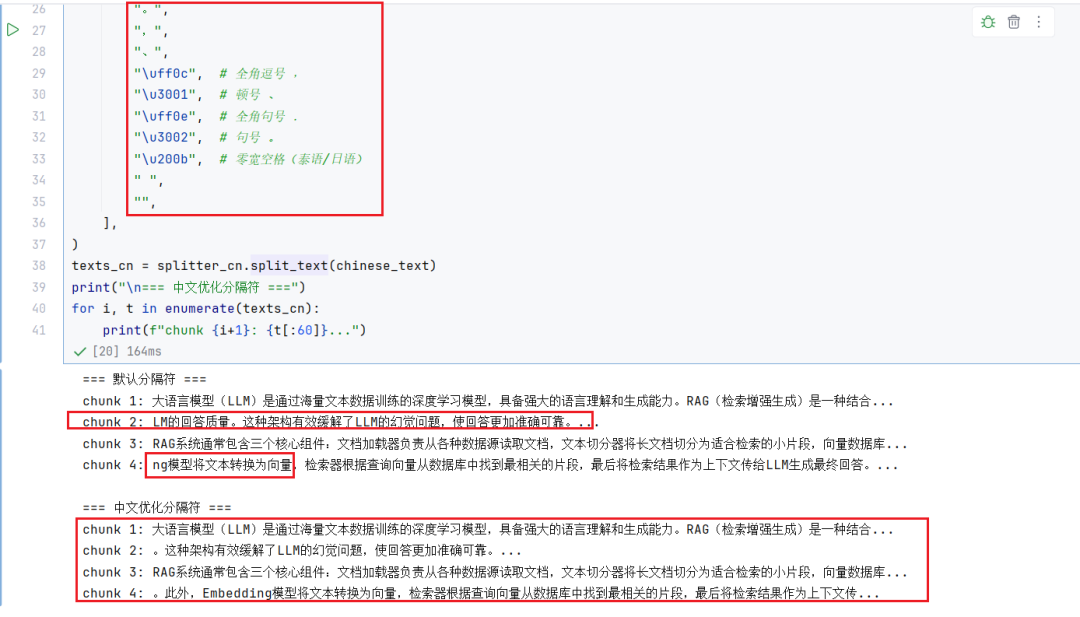
案例 3:从 Document 切分------load_and_split
当你从 Loader 拿到 Document 后,可以直接用 split_documents 方法切分,metadata 会自动传播:
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 1. 用 Loader 加载
loader = TextLoader("state_of_the_union.txt")
documents = loader.load()
print(f"加载了 {len(documents)} 个文档, 总字符数: {sum(len(d.page_content) for d in documents)}")

# 2. 用 Splitter 切分
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ",", " ", ""],
)

# split_documents 直接处理 Document 列表
chunks = splitter.split_documents(documents)
print(f"\n切分为 {len(chunks)} 个 chunk")
print(f"\n前 3 个 chunk 的 metadata:")
for i, chunk inenumerate(chunks[:3]):
    print(f"  chunk {i+1}: source={chunk.metadata['source']}, "
          f"长度={len(chunk.page_content)}")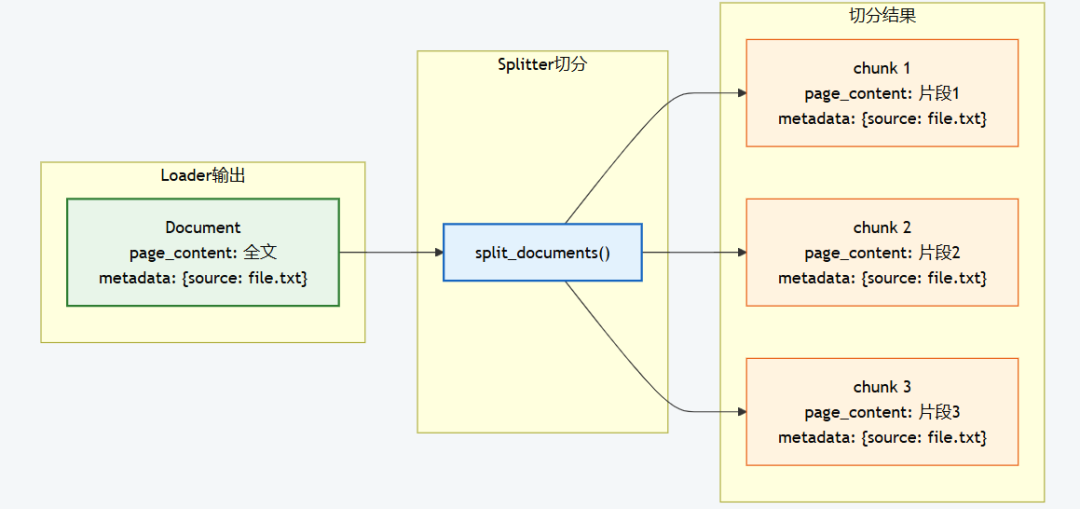
metadata 被原封不动地复制到每个 chunk------这就是追溯能力的来源。
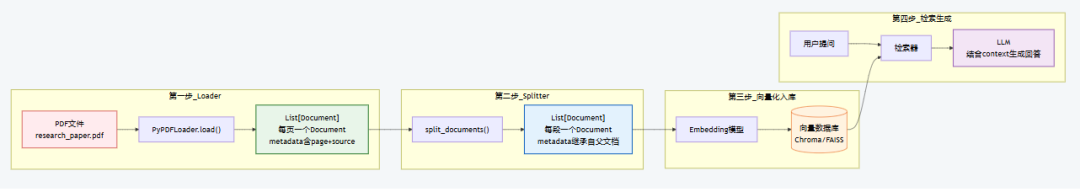
五、端到端实战:Loader + Splitter 串联
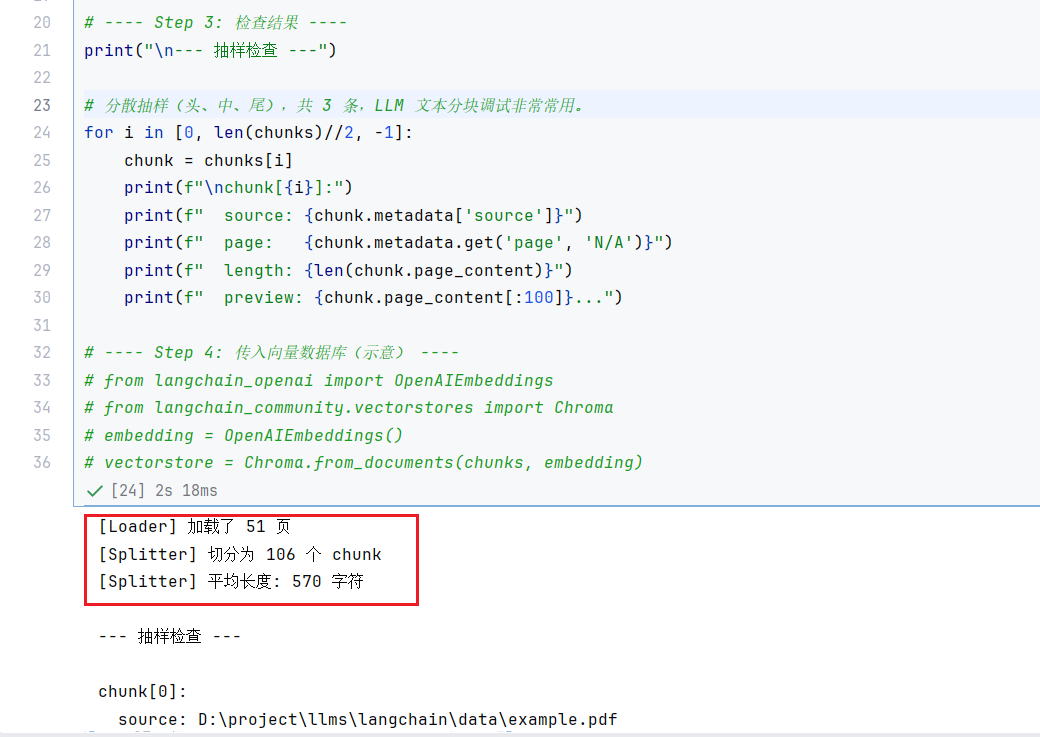
将两个组件串联起来,完成从原始文件到可入库 chunk 的完整流程:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

# ---- Step 1: Loader 加载 ----
loader = PyPDFLoader("research_paper.pdf")
pages = loader.load()
print(f"[Loader] 加载了 {len(pages)} 页")

# ---- Step 2: Splitter 切分 ----
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=800,
    chunk_overlap=100,
    separators=["\n\n", "\n", "。", "!", "?", ",", "、", " ", ""],
)

chunks = text_splitter.split_documents(pages)
print(f"[Splitter] 切分为 {len(chunks)} 个 chunk")
print(f"[Splitter] 平均长度: {sum(len(c.page_content) for c in chunks) / len(chunks):.0f} 字符")
完整的端到端数据流:
六、参数调优建议
不同场景下的推荐参数配置:
| 场景 | chunk_size | chunk_overlap | 分隔符策略 | 理由 |
|---|---|---|---|---|
| 精确问答(客服/FAQ) | 300~500 | 50~100 | 中文标点优化 | 小 chunk 检索精度高,重叠避免边界丢信息 |
| 知识库检索(通用) | 800~1200 | 100~200 | 中文标点优化 | 平衡精度与 context 丰富度 |
| 长文档摘要(论文/报告) | 1500~2000 | 200~400 | 段落优先 | 大 chunk 保留更多上下文,适合摘要任务 |
| 代码文档 | 500~800 | 50~100 | 代码专用分隔符 | 按函数/类边界切分 |
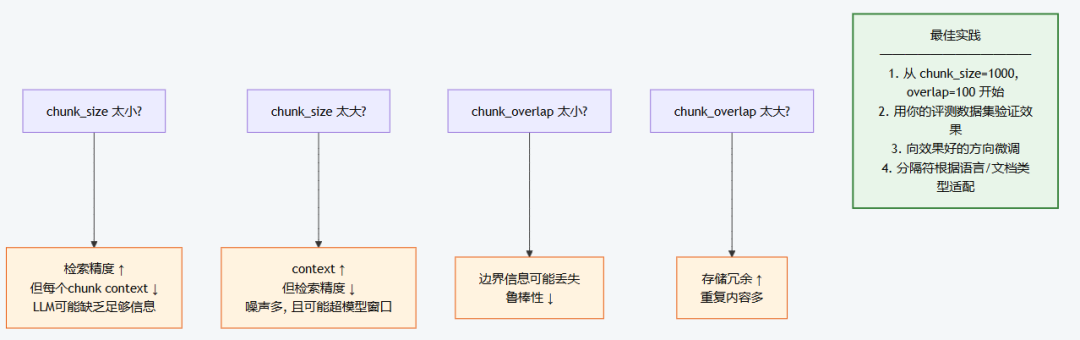
调优时的核心思路可以用一张图概括:
七、结语
Document Loader 和 Text Splitter 是 RAG 系统中"做对了看不出价值,做错了全链路遭殃"的基础组件。
Loader 的核心价值在于接口统一 ------BaseLoader 的 load() / lazy_load() 双方法设计,让你可以无缝切换数据源而不改动下游代码。选 Loader 时,关注它对你目标文件格式的解析质量(尤其是表格、多栏、图文混排),而不仅仅是"能不能加载"。
RecursiveCharacterTextSplitter 的核心智慧在于递归降级 ------不是一刀切,而是先尝试沿最强语义边界(段落)切,切不动再逐级降级。这个设计让它在绝大多数场景下都能产出语义连贯的 chunk,这也是官方推荐它作为首选的原因。
两个容易踩的坑 :一是对中文文本忘记加入中文标点分隔符,导致词被从中间切断;二是把 chunk_overlap 设为 0,在 chunk 边界处丢失上下文。记住这两点,你的 RAG 数据预处理质量就能超过多数匆忙上手的实现。
参考来源
-
- LangChain 官方文档 --- Text splitter integrations
-
- LangChain 官方文档 --- RecursiveCharacterTextSplitter 详细指南
-
- LangChain 官方文档 --- Document loader integrations
- LangChain 官方文档 --- Document loader integrations