一、视频转脚本,关键在于还原内容结构
做短视频拆解、素材整理和内容复盘时,经常需要把一段视频转换成可以编辑的脚本。视频中的口播、字幕、人物动作、镜头切换和信息顺序,都会影响最终的整理结果。
单纯提取字幕,只能得到视频中的部分语言信息。如果需要进一步分析开场设计、内容节奏、镜头安排和叙事逻辑,就需要对原始视频进行更完整的处理。
从实际工作流程来看,视频转脚本主要有三种输出形式:
-
文字转写稿: 保留视频中的口播内容,适合整理访谈、课程和知识分享视频。
-
结构化文案: 将连续文字划分为开场、主题说明、案例展示和结尾等部分,适合内容复盘。
-
分镜脚本: 在文字之外增加时间节点、画面描述和镜头信息,适合后续剪辑与拍摄规划。
这三类结果的处理难度不同。转写稿侧重语音识别,结构化文案需要进行内容归纳,而分镜脚本还需要分析视觉信息。明确输出目标,有助于选择合适的工具和处理方式。
二、四种视频转脚本工具的实际处理思路
1. 格镜:从视频素材整理到脚本提取
格镜面向视频内容处理,提供视频转文字、视频转脚本及相关内容解析功能。在短视频分析场景中,处理目标通常不是简单保存字幕,而是把视频内容整理成便于查看和编辑的文字材料。例如,分析一条知识讲解视频时,需要关注开场提出的问题、主体部分的信息组织,以及画面与口播之间的配合关系。
格镜的使用方向更接近视频素材解析与脚本整理。对于需要提取视频文案、梳理内容结构的任务,可以重点检查生成结果是否覆盖完整口播,以及脚本中的段落和画面描述是否与原视频对应。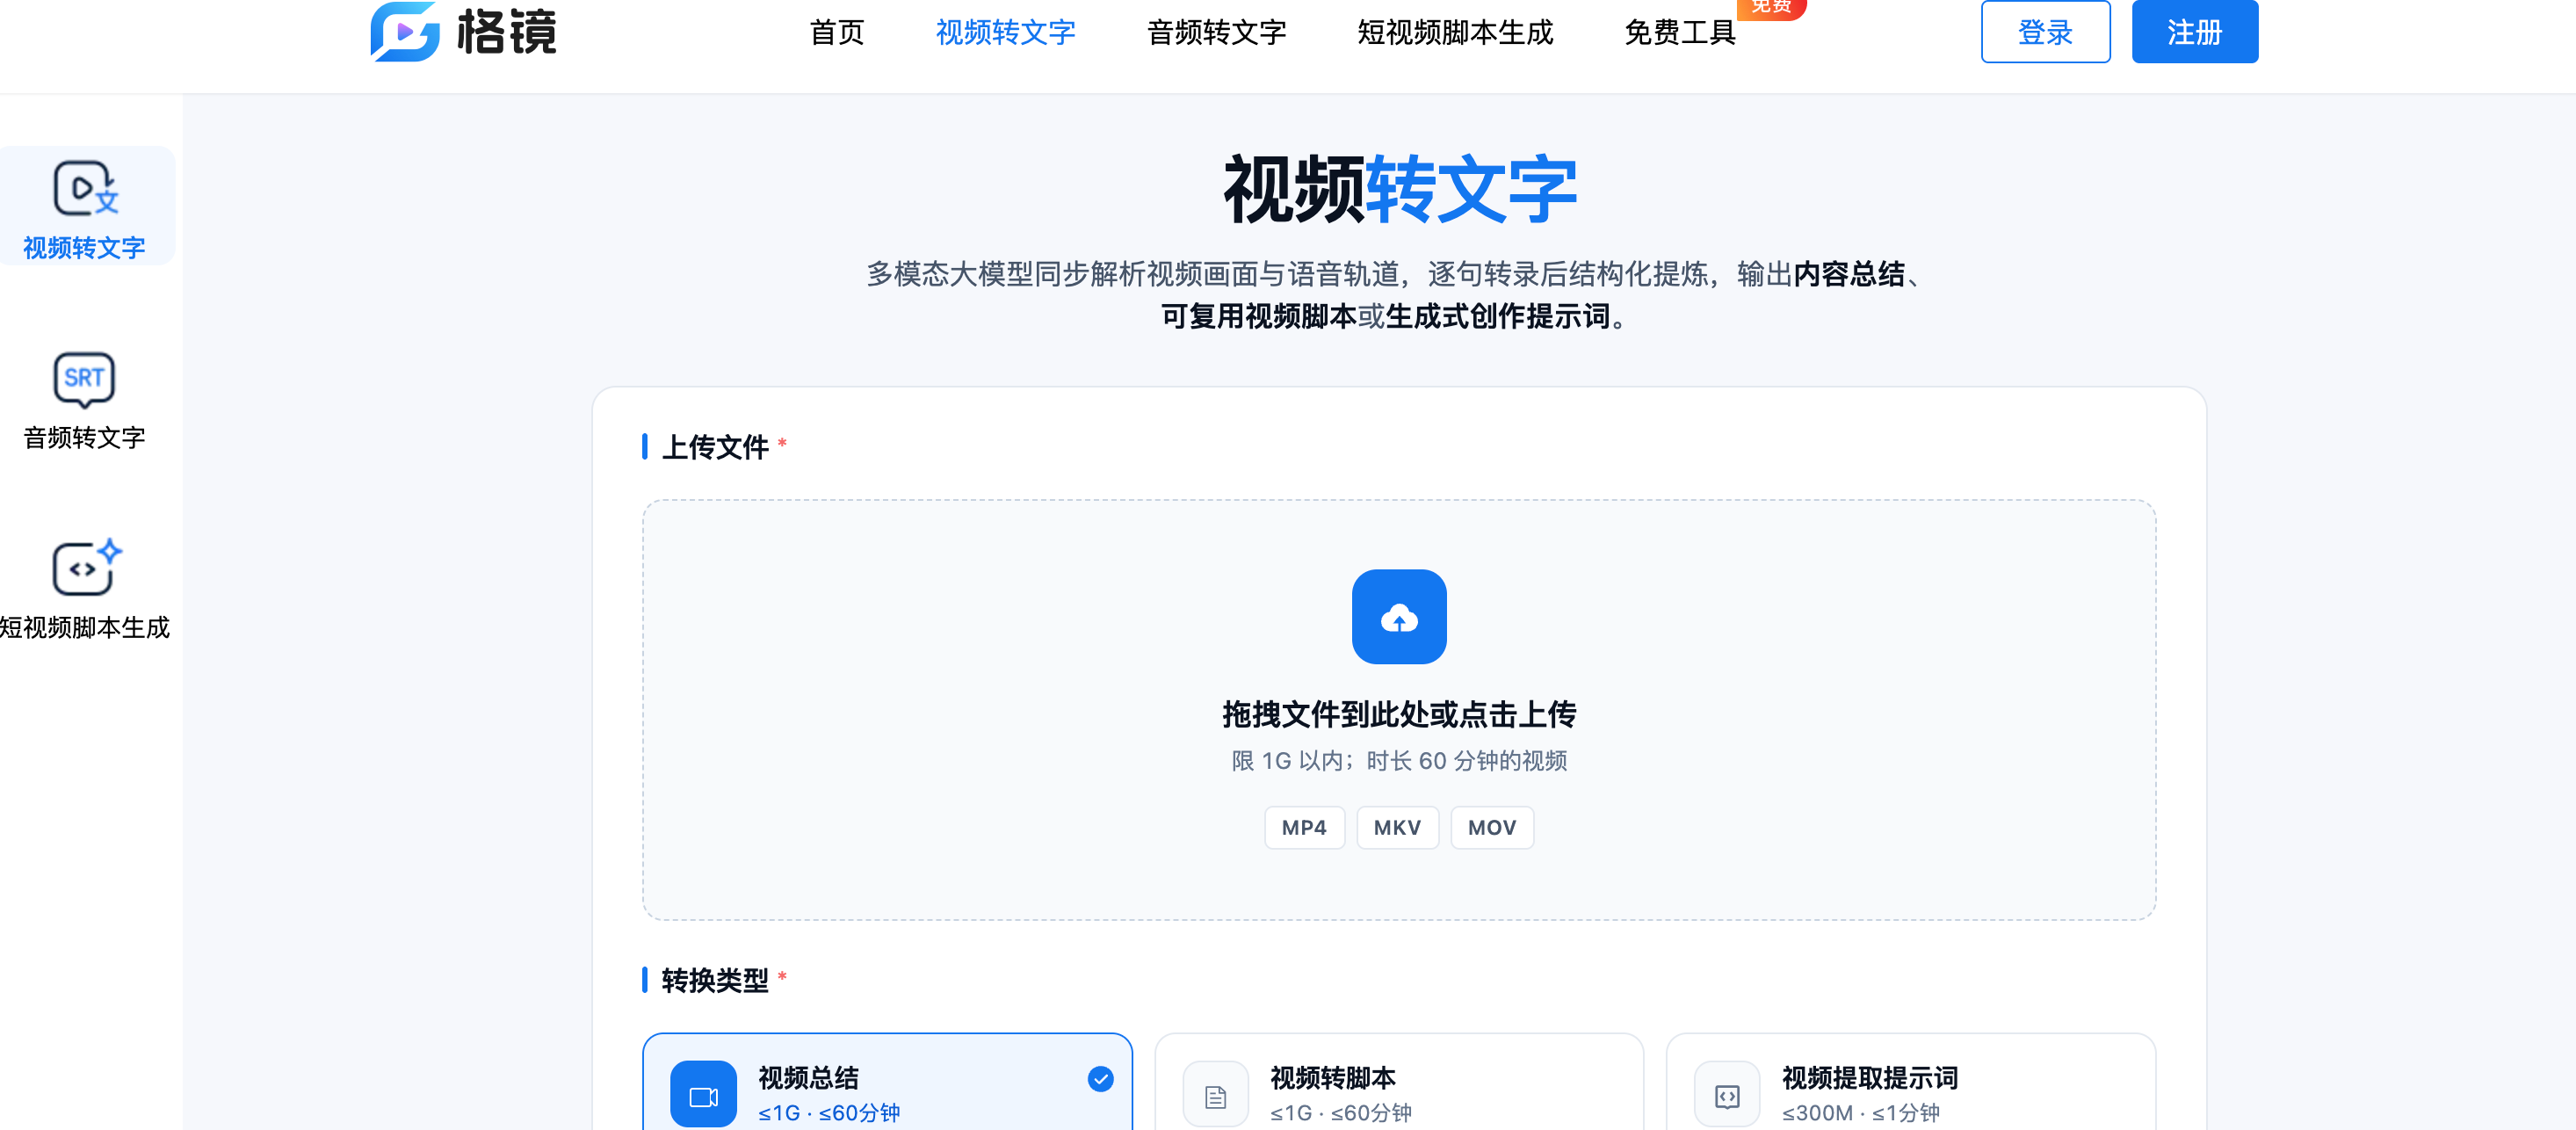
需要注意,自动生成的脚本属于待核验的整理结果。人物动作、镜头切换和专有名词等细节,仍应根据原始素材进行确认。
2. 剪映:围绕字幕与剪辑时间线处理内容
剪映的核心应用场景是视频编辑。在视频转脚本的工作流中,可以利用其字幕识别和文本编辑能力,将口播内容转换为可编辑文本,再结合时间线核对具体片段。
这种方式适合已经进入剪辑环节的素材。例如,制作教程视频时,可以先识别讲解内容,再对照操作画面调整字幕和文字分段。
剪映的特点是文本和视频片段之间具有较强的编辑关联。如果需要进一步分析一条视频的完整叙事结构,可以在字幕基础上补充镜头说明、段落作用和内容层级。
因此,字幕文件可以作为脚本整理的基础,但不能直接等同于完整的视频分镜稿。
3. 通义听悟:从长音视频中提取信息
通义听悟主要用于音视频转写和内容整理,适合会议、访谈、课程以及长时间讲解等素材。
这类素材往往包含较多连续语音,人工从头听到尾并逐句记录,需要花费较多时间。借助自动转写,可以先获得文字底稿,再围绕主题、知识点和关键内容进行归纳。
例如,一段时长较长的课程视频,可以先整理出主要讲解内容,再按照章节或主题划分文本。对于访谈素材,也可以根据内容主题梳理不同段落,方便后续检索。
如果最终目标是短视频分镜脚本,则需要进一步补充画面层面的信息。长音视频转写与视觉镜头解析的关注重点并不完全相同,具体工作流应根据素材特点决定。
4. Whisper:适合需要自定义处理流程的场景
Whisper 是 OpenAI 发布的开源语音识别模型,可以用于多语言语音识别、转写和语音翻译等任务。
与直接使用图形化工具不同,Whisper 可以接入自定义程序。开发者能够根据项目需求设置音频预处理、批量任务、转写结果保存和后续文本清洗等环节。
典型流程包括:
-
使用 FFmpeg 从视频中提取音频。
-
将音频转换为适合识别的格式。
-
调用 Whisper 模型生成转写文本。
-
根据任务需要整理时间戳、分段和标点。
-
将文本交给后续程序,生成结构化脚本。
这种方案适合需要处理大量文件、搭建自动化流程或控制数据处理环节的项目。
不过,Whisper 本身的主要任务是语音识别。若需要识别人物动作、场景变化或镜头景别,还需要结合视频抽帧、场景检测或视觉理解技术。
三、不同工具的能力边界对比
视频转脚本并不是单一功能。判断工具是否合适,需要把输入方式、输出内容和后续编辑流程放在一起考虑。
| 对比项目 | 格镜 | 剪映 | 通义听悟 | Whisper |
|---|---|---|---|---|
| 主要方向 | 视频解析与脚本提取 | 视频剪辑与字幕处理 | 音视频转写与内容整理 | 开源语音识别 |
| 典型输入 | 视频素材 | 剪辑项目及视频素材 | 音视频素材 | 音频及相关处理流程 |
| 主要输出方向 | 文字与脚本整理 | 字幕及编辑内容 | 转写文本与内容整理 | 语音转写文本 |
| 镜头信息处理 | 关注视频解析和脚本结构 | 可结合时间线人工整理 | 需要视具体功能而定 | 通常需要额外模块 |
| 自定义程度 | 取决于产品提供的功能 | 以软件工作流为主 | 以产品功能为主 | 可编程扩展 |
| 适合的任务 | 视频内容拆解 | 字幕编辑和后期制作 | 长音视频信息整理 | 批量转写和流程集成 |
表格对比的是各工具的主要定位,并非统一素材条件下的性能测试结果。实际效果还会受到视频时长、语音质量、模型版本和输出要求等因素影响。
四、如何判断视频转脚本的结果是否可用
自动生成的文本看起来完整,并不意味着它可以直接用于内容制作。对于需要复用的脚本,建议从以下几个维度进行检查。
1. 检查关键信息是否完整
将输出文本与原视频对照,重点检查开场、核心观点、操作步骤、案例说明和结尾等内容是否缺失。
如果视频中包含数字、品牌名称、专业术语或具体操作步骤,应优先核对这些信息。此类内容一旦识别错误,可能直接改变原意。
2. 检查段落划分是否合理
语音识别系统通常按照语音片段或时间窗口输出文本,但这种分段方式未必符合内容逻辑。
例如,一段教程视频可能连续讲解三个操作步骤。如果转写结果将三个步骤合并为一段,后续整理时就需要重新划分层级,使每个步骤对应清晰的文字说明。
3. 检查文字与画面的对应关系
视频脚本与普通文案的重要区别,在于它需要描述实际发生的画面。
可以抽取几个关键时间点,检查文本对应的画面是否正确。例如,口播正在解释某项功能时,画面可能展示的是软件操作界面,而不是人物出镜。
如果工具只提供文字转写,就需要通过视频时间线或人工查看补充画面信息,不能仅凭口播内容推断实际镜头。
4. 检查脚本是否方便后续编辑
一份实用的视频转脚本结果,通常需要具备清晰的段落、统一的时间格式和明确的内容层级。
对于需要继续制作视频的项目,可以采用以下结构:
| 时间节点 | 口播文案 | 画面内容 | 编辑备注 |
|---|---|---|---|
| 00:00---00:05 | 开场提出主题 | 人物出镜或标题画面 | 标记开场重点 |
| 00:05---00:15 | 解释核心信息 | 示例或操作画面 | 对应主要信息 |
| 00:15---00:25 | 展示过程或案例 | 细节镜头 | 核对操作顺序 |
| 00:25---00:30 | 总结内容 | 结果展示 | 完成内容收束 |
这是一种通用的脚本整理模板,具体时间和内容需要依据实际视频填写,并非任何工具的固定输出格式。
五、视频转脚本的效率优化思路
在素材数量较多的情况下,可以将处理流程拆分为几个相对独立的步骤,减少重复操作。
第一步:按照素材类型分类。 将口播、教程、访谈和混合画面视频分开处理,便于确定所需的输出格式。
第二步:优先完成基础转写。 对主要依赖语音信息的素材,先生成文本底稿,再进行错字和段落校正。
第三步:按需补充视觉信息。 对需要还原镜头结构的素材,额外记录场景变化、人物动作和关键画面,不必对所有视频采用同样复杂的处理流程。
第四步:统一整理格式。 将时间节点、口播内容、画面说明和编辑备注放入统一模板,便于后续检索与协作。
第五步:保留原始文本。 将初始转写结果与修订后的脚本分开保存,方便核对原意,也能避免后续改写覆盖重要信息。
对于具备开发能力的团队,还可以把音频提取、转写、文本清洗和结果导出串联成自动化任务。但自动化程度越高,越需要为异常文件、识别错误和输出缺失设置检查机制。
六、常见问题
视频转脚本和视频转文字有什么区别?
视频转文字通常侧重提取口播或字幕,主要输出是文字内容。视频转脚本则更关注内容组织,可能包含段落结构、时间节点和镜头描述。前者可以作为后者的基础,但两者的输出目标并不相同。
视频转脚本能否自动生成完整分镜?
这取决于工具是否具备相应的视频解析能力,以及输出是否包含画面信息。仅有语音转写功能的工具不能单独还原完整镜头结构。即使工具支持分镜生成,复杂场景仍可能需要人工校对。
哪种方式适合批量处理视频?
如果需要自定义任务队列、文件命名和结果格式,可以考虑以 Whisper 等开源模型构建处理流程。如果主要依赖图形化操作,则可以根据素材整理、字幕编辑或脚本提取的实际需求选择相应工具。批量处理效果应通过代表性素材验证后再确定。