「 线上接口忽然变慢,第一反应别急着加机器。十次有七八次是慢 SQL 卡住,而慢 SQL 背后八成又和索引有关。这篇把从「抓慢查询」到「把索引用对」的完整链路拆开讲,命令都能直接复制。 」
一、先把「慢」抓出来:慢日志怎么开
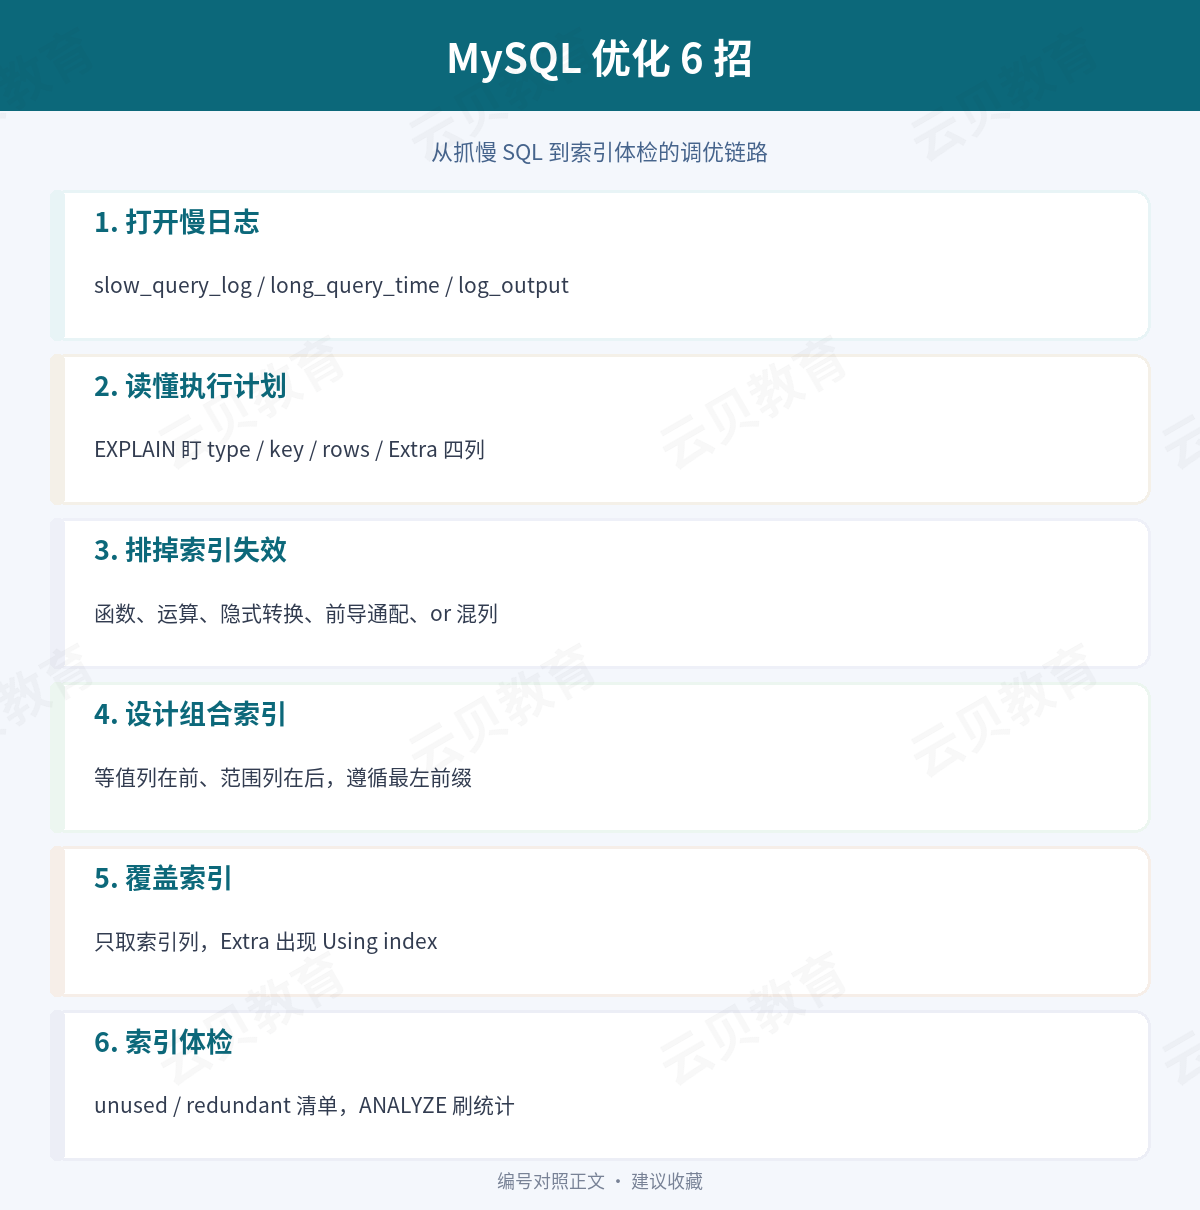
▲ 六步链路图(对照正文)
MySQL 自带慢查询日志,比自己瞎猜靠谱得多。
|-------------|----------------------------------------------------------|
| 操作 | 命令 |
| 临时开启(全局生效) | SET GLOBAL slow_query_log = ON; |
| 设定阈值(秒,可小数) | SET GLOBAL long_query_time = 1; |
| 记录未走索引的语句 | SET GLOBAL log_queries_not_using_indexes = ON; |
| 限制无索引日志频率 | SET GLOBAL log_throttle_queries_not_using_indexes = 100; |
两个要点:
-
long_query_time 改完只对新建立的连接 生效,已打开的会话还是旧值。要永久生效,把这几行写进 my.cnf 的 mysqld 段并重启。
-
开了 log_queries_not_using_indexes 后,全表扫的语句会刷屏,一定要配 log_throttle_queries_not_using_indexes 限流,否则日志瞬间膨胀。
二、用 EXPLAIN 看穿执行计划
抓到慢 SQL,下一步是看它到底怎么走的。
EXPLAIN SELECT id, amount FROM orders WHERE user_id = 1001 AND status = 'PAID';
重点盯四列:
|-------|----------------------------------------------------------|
| 列 | 看什么 |
| type | 访问类型,ALL 是全表扫要警惕;index/range/ref/eq_ref/const 依次更优 |
| key | 实际用到的索引,空着说明没用上 |
| rows | 估算扫描行数,越大越危险 |
| Extra | Using filesort/Using temporary 要留意;Using index 是好事(覆盖索引) |
补充:
-
EXPLAIN 是估算 ,EXPLAIN ANALYZE(8.0.18+)才给真实执行行数。
-
EXPLAIN FORMAT=JSON 能看 used_key_parts(实际命中了组合索引的哪几列)、rows_examined_per_scan,定位「索引用了但没用全」很有用。
-
估算和实际差得远,先 ANALYZE TABLE 表名; 刷一下统计信息。
三、六个让索引「假死」的写法
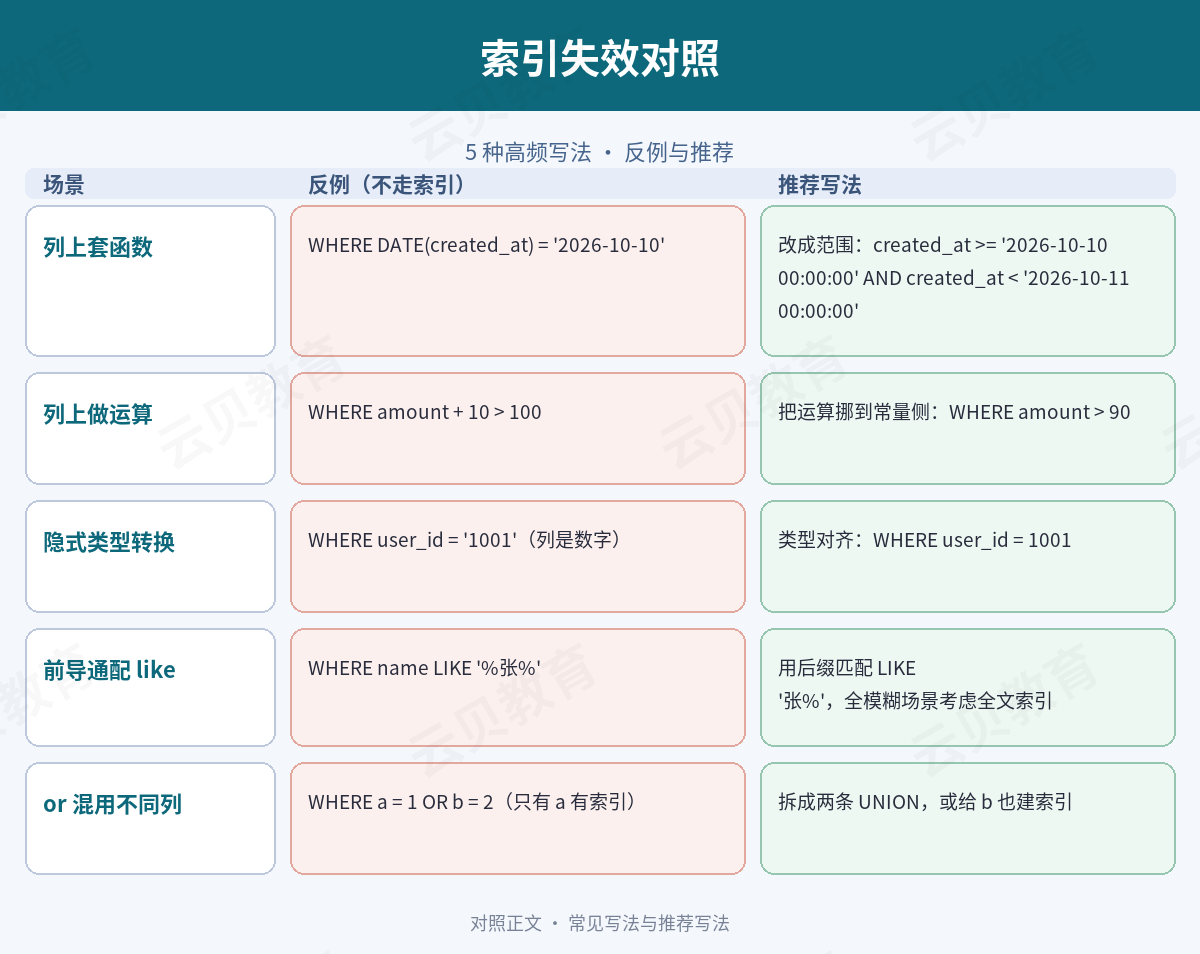
▲ 对照图(对照正文)
索引建了却不生效,多半是写法踩了下面这些坑。左边是反例,右边是推荐写法。
|-----------|---------------------------------------|-----------------------------------------------------------------------------------|
| 场景 | 反例(不走索引) | 推荐写法 |
| 列上套函数 | WHERE DATE(created_at) = '2026-10-10' | 改成范围:created_at >= '2026-10-10 00:00:00' AND created_at < '2026-10-11 00:00:00' |
| 列上做运算 | WHERE amount + 10 > 100 | 运算挪到常量侧:WHERE amount > 90 |
| 隐式类型转换 | WHERE user_id = '1001'(列是数字) | 类型对齐:WHERE user_id = 1001 |
| 前导通配 like | WHERE name LIKE '%张%' | 用后缀匹配 LIKE '张%';全模糊考虑全文索引 |
| or 混用不同列 | WHERE a = 1 OR b = 2(只有 a 有索引) | 拆成两条 UNION,或给 b 也建索引 |
| NULL 判断 | 误以为 IS NULL 不走索引 | InnoDB 里 IS NULL/IS NOT NULL 走范围扫描,能命中索引 |
最后一行要特别说清:网上常把 IS NULL、!=、NOT IN、NOT LIKE 一股脑说成「都不走索引」,这是错的。IS NULL/IS NOT NULL 在 InnoDB 是能走索引 的(范围扫描);真正会扫大部分数据的是 !=、NOT IN、NOT LIKE 这类不匹配前缀的写法,别混为一谈。
四、组合索引与最左前缀
单列索引不够用时上组合索引,但顺序有讲究。
ALTER TABLE orders
ADD INDEX idx_user_status_time (user_id, status, created_at);
规则:
-
等值条件列放前面,范围条件列放后面 。user_id = ? 和 status = ? 是等值,放前;created_at 如果用来做范围(>/</BETWEEN),放最后。
-
最左前缀 :查询必须包含最左列才能用上索引。只查 status(跳过 user_id)就用不上这个索引。
-
范围列会截断后缀:一旦某一列用了范围比较,它右边的列只能用过滤、用不上索引定位。所以范围列尽量靠后。
五、覆盖索引:省掉一次回表
如果查询要的列刚好都在索引里,MySQL 不用回主键表取数据,速度更快。
EXPLAIN SELECT user_id, amount FROM orders WHERE user_id = 1001;
Extra 里出现 Using index 就是覆盖索引生效,没有回表。常见做法:把高频查询的「条件列 + 返回列」一起塞进组合索引。
六、索引也要体检:清理冗余
索引不是越多越好,每多一个索引,写入就慢一分。
|-----------|----------------------------------------------|
| 操作 | 命令 |
| 查长期没用到的索引 | SELECT * FROM sys.schema_unused_indexes; |
| 查重复/冗余索引 | SELECT * FROM sys.schema_redundant_indexes; |
注意这两个视图依赖 performance_schema,实例没开就查不到。
碎片方面:OPTIMIZE TABLE 对 InnoDB 会重建表(等价于 ALTER TABLE ... FORCE),大表耗时随表量增长,务必低峰执行;碎片不明显就别定期跑。
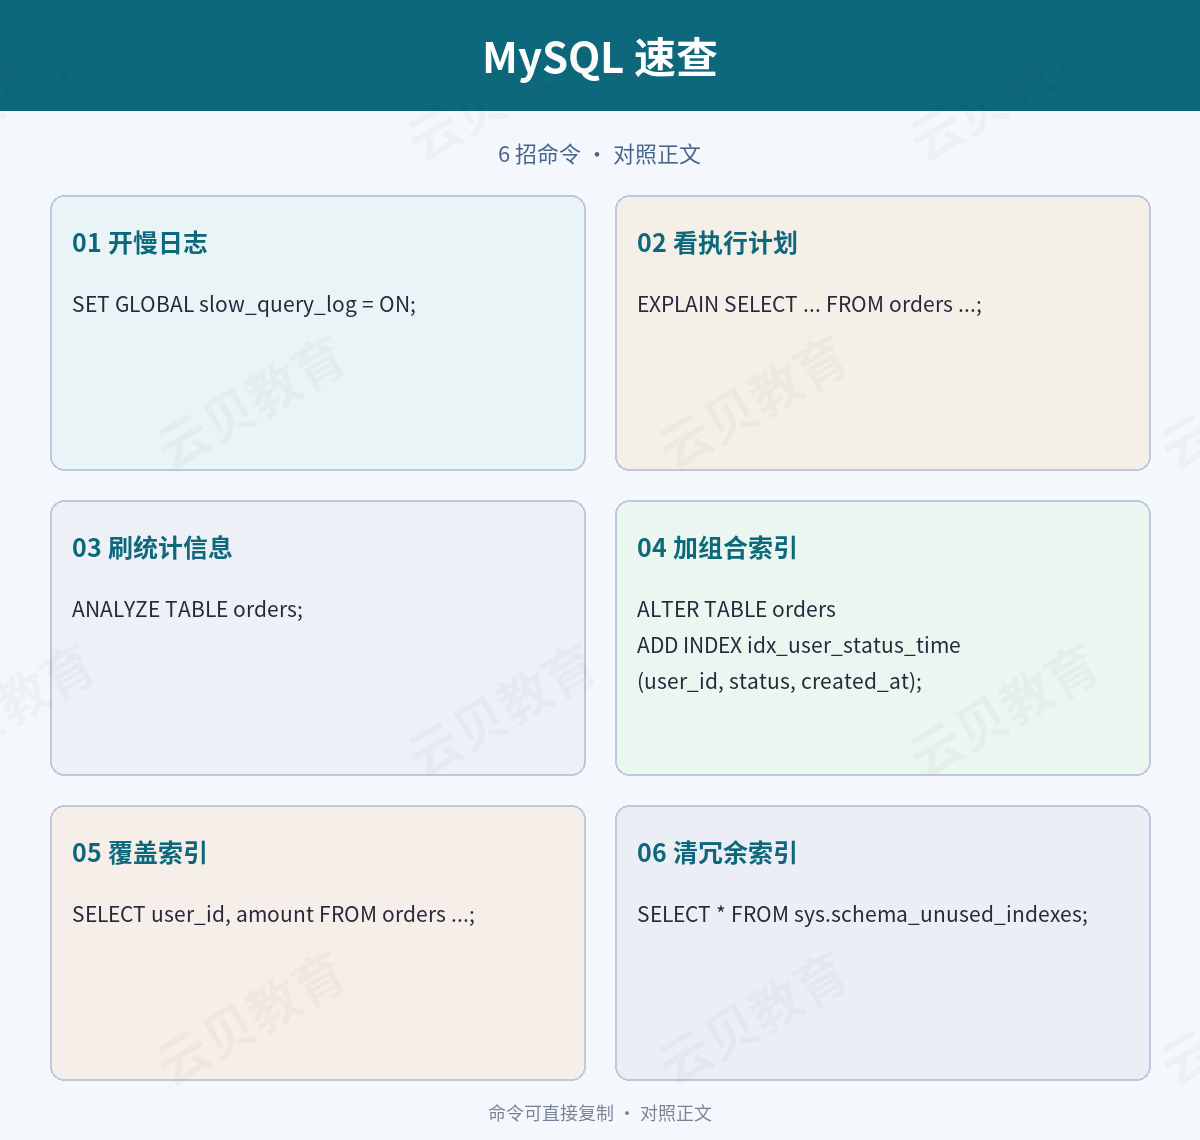
▲ 一图速查:核心命令汇总(建议收藏)
小结
慢查询定位就三步:开慢日志抓是谁慢 → EXPLAIN 看它怎么走 → 按上面的坑改写法或补索引。索引优化的核心是「让它用上、让它用全、让它别回表」。
常见故障速查表
|--------|----------------|----------------------------------------------|
| 现象 | 先查什么 | 命令 |
| 接口偶发慢 | 慢日志开关 | SHOW VARIABLES LIKE 'slow_query_log'; |
| 全表扫 | EXPLAIN 的 type | EXPLAIN SELECT ... |
| 索引建了没用 | 是否套函数/隐式转换 | 看第三节六类写法 |
| 组合索引失效 | 最左前缀 | EXPLAIN FORMAT=JSON 看 used_key_parts |
| 写入越来越慢 | 冗余索引 | SELECT * FROM sys.schema_redundant_indexes; |
我是云贝教育的 MySQL 讲师,上面这些是日常排障里最常踩的点。把慢日志、EXPLAIN 和索引这三点用熟,大部分慢查询都能自己定位,不用等救火。