千笔-AIWritePaper · https://www.aiwritepaper.com
一个 Agent 调完工具之后,接下来发生什么?默认情况下,工具结果会交回模型,模型再决定是继续调用还是给出终答。这个默认值看起来理所当然,直到线上出现两类事故:通知发了两遍,因为模型在第二轮「确认一下」又调了一次;管理员的清缓存工具突然不见了,因为开关函数读错了上下文里的键。
Agents 文档里的 tool_use_behavior 决定「工具之后谁来收尾」,Tools 文档里的 is_enabled 决定「工具这一轮对模型是否可见」。本文在 openai-agents 0.23.1 下用脚本化假模型离线实跑这两个开关,记录每轮模型看得见哪些工具、被调用了几次、副作用发生了几次,13 行结果全部写进 CSV(_w/tub-smoke/),输出原样贴出。
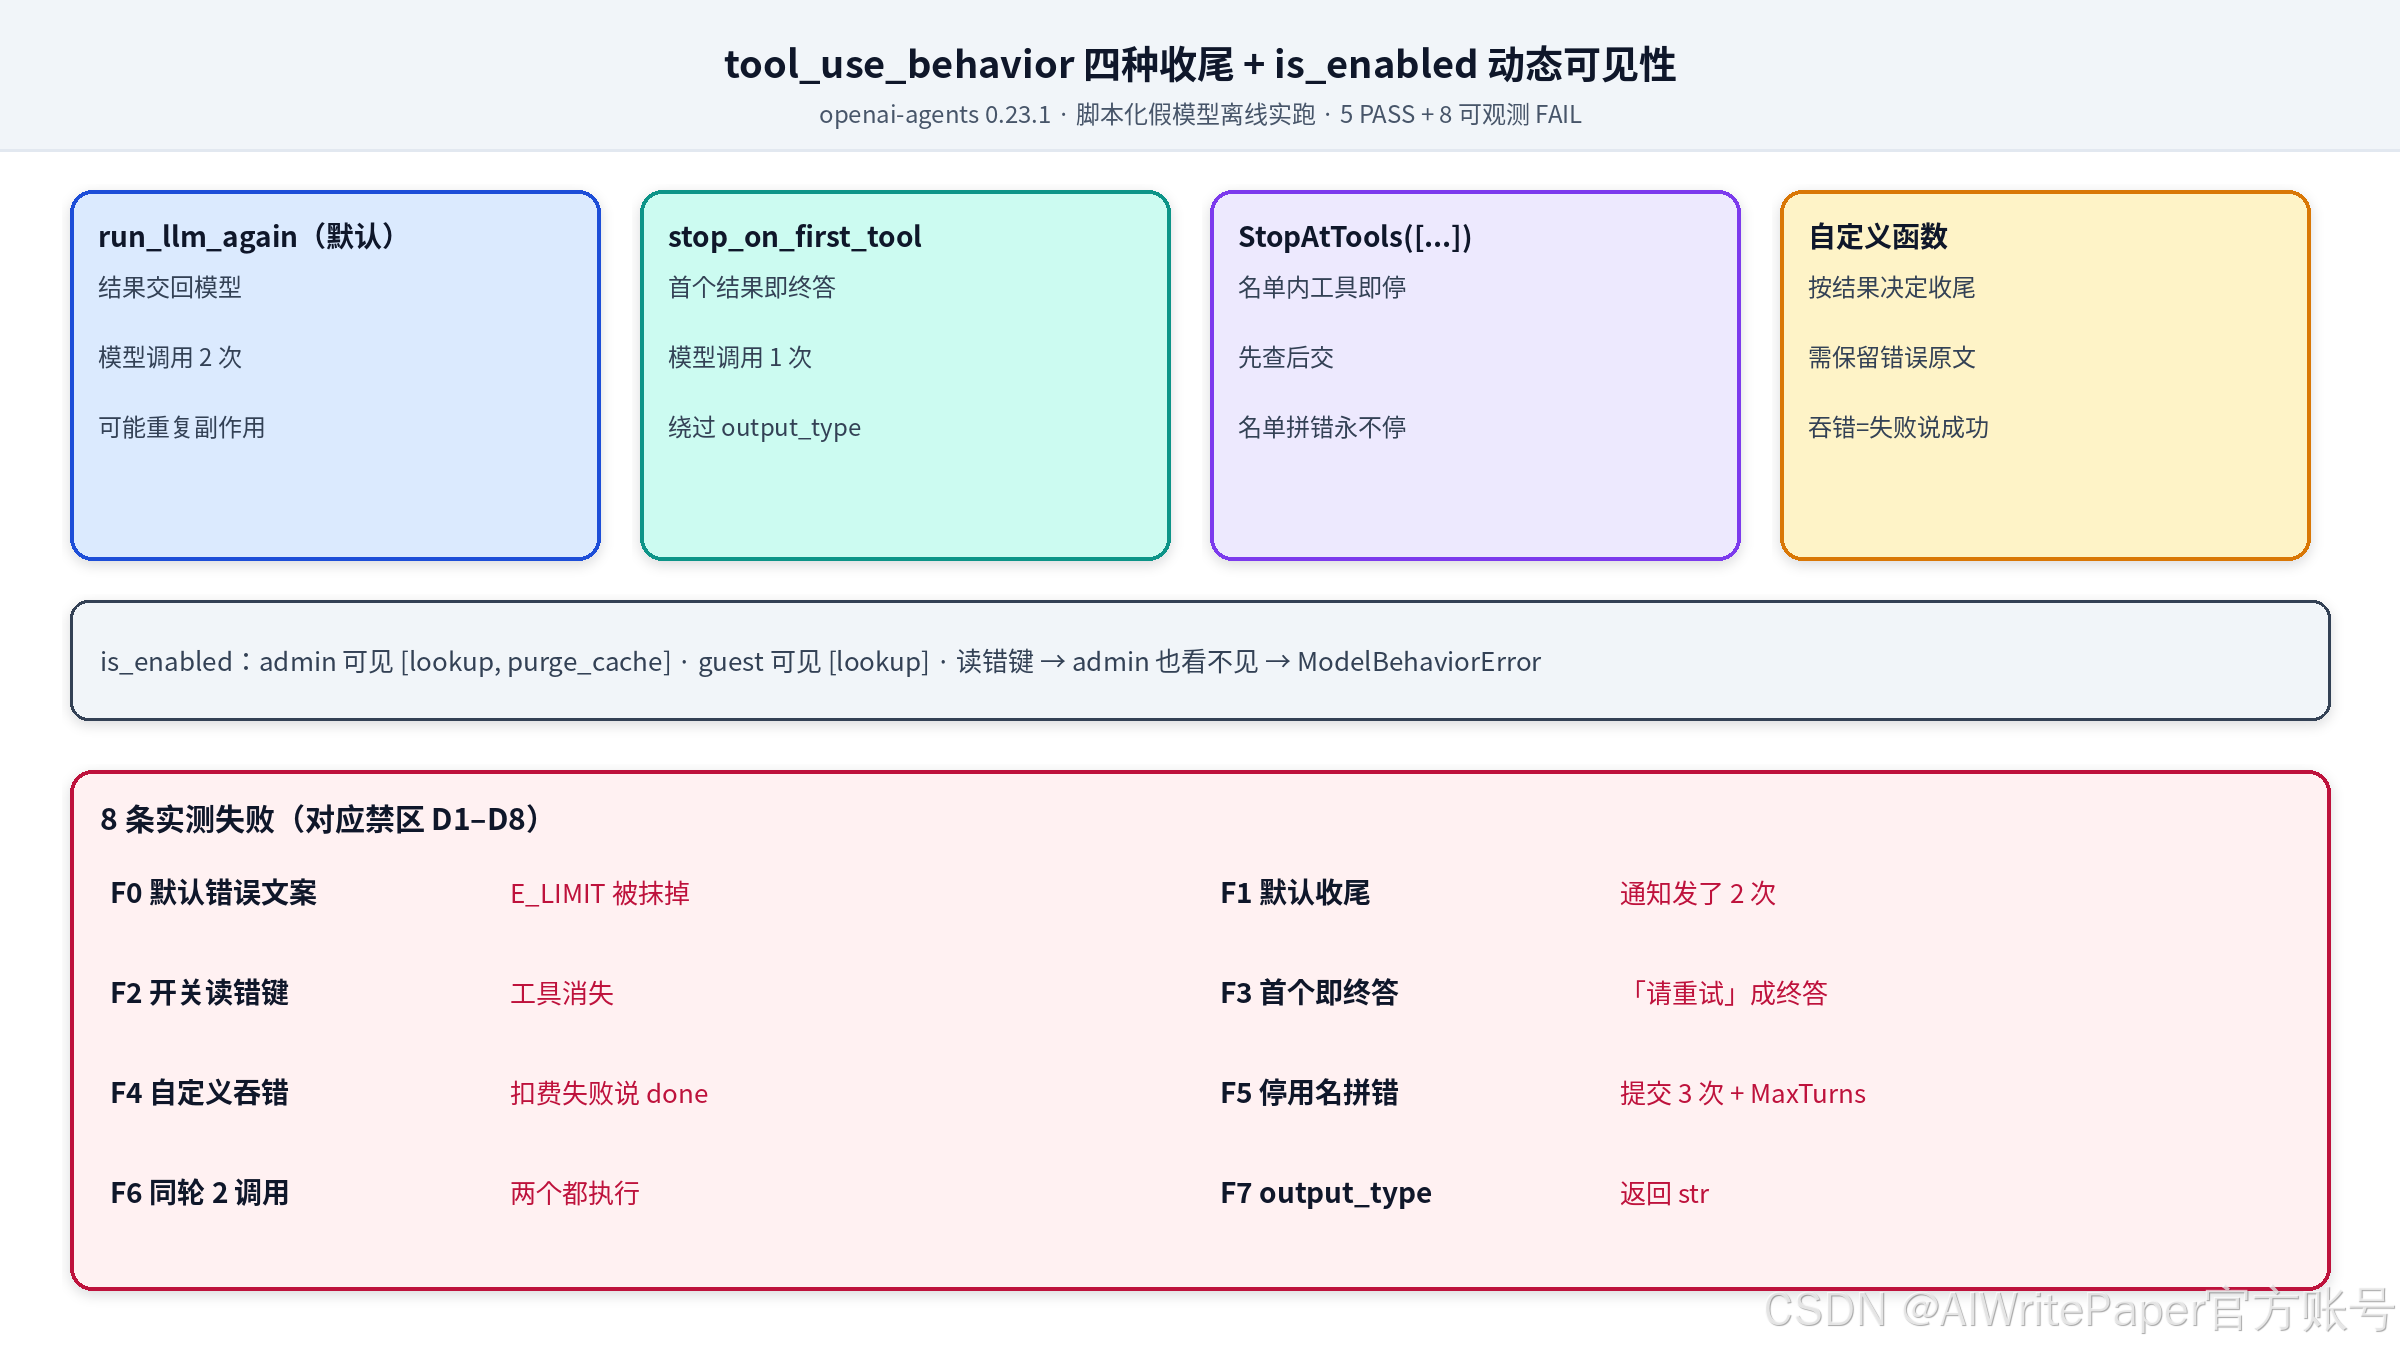
图:上排为四种停用行为下「工具结果交给谁」与模型调用次数;中间为 is_enabled 按上下文决定的可见工具列表;底部为 8 条实测失败与禁区编号。
目标说明
读完你应能独立完成五件事:
- 为每个 Agent 选对
tool_use_behavior:run_llm_again、stop_on_first_tool、StopAtTools(stop_at_tool_names=[...])或自定义函数。 - 写一个不吞错的自定义
tools_to_final_output_function,并知道它依赖failure_error_function保留错误原文。 - 用
function_tool(is_enabled=...)按用户角色控制工具可见性,并给开关写启动断言。 - 解释为什么
stop_on_first_tool会绕过output_type,以及同一轮多个调用时副作用不会只发生一次。 - 把 8 条失败样本写进禁区表和 CI。
适用与边界
适合:工具本身就是答案(查询类、提交类);有副作用的工具需要「调完即停」;同一个 Agent 要对不同角色暴露不同工具。
不讲:tool_choice、reset_tool_choice 与 parallel_tool_calls(已有 ModelSettings 专文),以及审批中断(见 needs_approval 专文)。is_enabled 只控制模型看不看得见,不是权限系统;工具内部仍需鉴权。
失败含义:假模型按脚本发调用,不代表真实模型一定会重复调用;但「副作用次数」由工具函数体内的计数器记录,只要模型那样做,后果就是这样。
机制:四种收尾方式
| 取值 | 工具结果去哪 | 模型调用次数(本例) | 适合 |
|---|---|---|---|
run_llm_again(默认) |
交回模型,由模型写终答 | 2 | 需要模型解释或综合结果 |
stop_on_first_tool |
第一个工具的输出直接成为终答 | 1 | 工具输出就是最终结果 |
StopAtTools([...]) |
调到名单内工具时停,其他工具照常交回模型 | 2 | 先查后交,交完即停 |
| 自定义函数 | 由你返回 ToolsToFinalOutputResult(is_final_output, final_output) |
1 或 2 | 按结果内容决定是否收尾 |
is_enabled 可以是布尔值,也可以是 (ctx, agent) -> bool 函数,每轮请求前计算一次。返回 False 的工具不会出现在发给模型的工具列表里。
python
def admin_only(ctx: RunContextWrapper, agent) -> bool:
    return ctx.context["role"] == "admin"      # 用下标,缺键直接报错

@function_tool(is_enabled=admin_only)
def purge_cache() -> str:
    """清缓存(仅管理员)。"""
    ...
离线 smoke:5 条通过 + 8 条失败
text
P1  PASS 默认 run_llm_again -> 模型调用=2 final='model-final'
P2  PASS stop_on_first_tool -> 模型调用=1 final='hit:x'
P3  PASS StopAtTools(['submit']) -> 模型调用=2 final='submitted:R1' 副作用=[('submit', 'R1')]
P4  PASS is_enabled 按 ctx.context['role'] -> admin 可见=['lookup', 'purge_cache'] guest 可见=['lookup']
P5  PASS 自定义函数查错误码 + failure_error_function 保留原文 -> 模型调用=2 final='model-final'
F0  FAIL 同一自定义函数,但用默认 failure_error_function -> 模型调用=1 final='An error occurred while running the tool. Please try again.'
F1  FAIL send_notice + 默认 run_llm_again,模型重复调用 -> 模型调用=3 副作用=[('notice', 'u1'), ('notice', 'u1')]
F2  FAIL is_enabled 读 ctx['roles'](实际 key=role) -> 可见=['lookup'] 结果=ModelBehaviorError: Tool purge_cache not found in agent ops
F3  FAIL stop_on_first_tool + 工具抛错 -> 模型调用=1 final='An error occurred while running the tool. Please try again.'
F4  FAIL 自定义函数固定返回 done -> final='done' 实际扣费=[]
F5  FAIL StopAtTools(['sumbit']) 拼错 -> 模型调用=3 副作用=[('submit', 'R1'), ('submit', 'R1'), ('submit', 'R1')] 异常=MaxTurnsExceeded
F6  FAIL stop_on_first_tool + 同一轮 2 个调用 -> final='sent:u1' 副作用=[('notice', 'u1'), ('notice', 'u2')]
F7  FAIL output_type=Report + stop_on_first_tool -> final 类型=str 值='hit:x'
CSV rows: 13
逐条读法:
- P1/P2 对比清楚:同一个查询,默认要两次模型调用,
stop_on_first_tool只要一次,终答就是工具原文。 - P3 先查后交,
lookup结果交回模型,调到submit立即停,提交只发生一次。 - P4 同一个 Agent,管理员看得见
purge_cache,访客看不见。 - P5 与 F0 是这次最意外的发现:同一个「有错误码就交回模型」的自定义函数,配上保留原文的
failure_error_function能正常工作;用默认值时,工具异常被替换成通用句An error occurred while running the tool. Please try again.,错误码E_LIMIT被抹掉,函数检测不到错误,把这句通用文案当成终答返回给了用户。 - F1 默认行为下模型重复调用通知工具,副作用发生两次。默认值不是幂等保证。
- F2 开关函数读了不存在的键,返回 False,管理员也看不到工具;模型若仍尝试调用,run 直接抛
ModelBehaviorError。 - F3
stop_on_first_tool遇到工具异常,通用错误句直接成为终答,用户看到一句「请重试」,而系统没有任何重试。 - F4 自定义函数无条件返回 done,扣费实际失败,用户收到「完成」。
- F5 停用名单拼错,
submit永远不触发停止,连续提交三次,直到MaxTurnsExceeded。 - F6 同一轮两个调用,
stop_on_first_tool只把第一个结果当终答,但两个通知都已发出。 - F7 设了
output_type=Report,stop_on_first_tool直接返回工具的字符串,结构化输出校验被绕过。
生产禁区表
| 编号 | 禁区 | 实测证据 | 替代做法 |
|---|---|---|---|
| D1 | 有副作用的工具配默认 run_llm_again |
F1:通知两次 | 用 StopAtTools 或在工具内做幂等键 |
| D2 | 开关函数用 get 带默认值 |
F2:管理员工具消失 | 用下标取值;启动时对每种角色打印可见工具列表 |
| D3 | stop_on_first_tool 不处理工具异常 |
F3:「请重试」成为终答 | 配 failure_error_function 返回结构化错误,或改自定义函数 |
| D4 | 自定义函数不看结果就收尾 | F4:失败被说成完成 | 检查每个 FunctionToolResult.output,有错误就交回模型 |
| D5 | 停用名单手写字符串 | F5:连续提交三次 | 用工具对象的 .name 生成名单,启动时断言名单 ⊆ 工具名 |
| D6 | stop_on_first_tool 搭配可能并行的副作用工具 |
F6:两个都执行 | 关闭并行调用,或让工具自己去重 |
| D7 | 依赖 output_type 校验却用工具直出 |
F7:类型为 str | 工具直出场景不设 output_type,或在应用层校验 |
| D8 | 自定义函数靠错误码判断,却用默认错误文案 | F0:错误码被抹掉 | 为工具显式设置保留错误原文的 failure_error_function |
配置对照:四个问题定一个值
| 问题 | 是 | 否 |
|---|---|---|
| 工具输出就是用户要的答案吗? | 考虑 stop_on_first_tool |
保留默认 |
| 有没有「调了就该停」的工具? | StopAtTools,名单由工具对象生成 |
保留默认 |
| 收尾与否取决于结果内容吗? | 自定义函数,并配置错误原文 | 用前两种 |
设了 output_type 吗? |
不要用工具直出 | 无限制 |
最小复现:记录「模型看见了什么」
这次 smoke 的关键不是假模型会说什么,而是它每轮都把收到的工具列表记下来。这样 is_enabled 的效果和模型调用次数都能被直接断言:
python
class ScriptModel(Model):
    def __init__(self, turns): self.turns, self.n, self.seen = turns, 0, []
    async def get_response(self, system_instructions, input, model_settings,
                           tools, output_schema, handoffs, tracing, **kw):
        self.seen.append(sorted(t.name for t in tools))   # 本轮可见工具
        turn = self.turns[min(self.n, len(self.turns) - 1)]; self.n += 1
        ...  # turn == "final" 时返回文本,否则返回一组 function_call
在你自己的项目里,把这个假模型换进任意 Agent,跑一遍各角色的上下文,就能得到一张「角色 × 可见工具」快照表。快照表提交进仓库,任何人改了开关函数,CI 都会因为快照变化而提醒评审。
常见误判
- 「终答是工具原文,说明工具成功了」:F3 的终答也是工具输出,只不过是错误文案。要看的是副作用计数,而不是终答文字。
- 「StopAtTools 没报错,说明名单配对了」:F5 的名单拼错时,SDK 不会提示,只会一直跑到轮数上限。
- 「管理员看不见工具,是权限生效了」:F2 是开关函数的 bug,不是权限设计。两者在日志里看起来一样,只有快照测试能分开。
与已写主题的咬合
| 相邻主题 | 关系 | 一句话 |
|---|---|---|
| ModelSettings / tool_choice | 决定模型这一轮是否必须调用工具 | 先定能不能调,再定调完谁收尾 |
| needs_approval | 调用前暂停等人批 | 审批通过后,仍由本文的收尾规则决定下一步 |
| tool 超时 | 超时结果同样走错误文案 | 超时与异常都需要保留原文 |
| guardrails | 校验输入输出 | 工具直出已绕过 output_type 校验(F7),输出护栏是否覆盖这条路径要单独测一次 |
验收清单
- 每个 Agent 的
tool_use_behavior写进配置表,并注明选它的理由。 - 所有有副作用的工具都有幂等键或停用规则,CI 覆盖「模型重复调用」用例。
- 每个
is_enabled函数有按角色的可见工具快照测试。 -
StopAtTools名单在启动时与工具名做集合断言。 - 自定义收尾函数有「工具抛错」用例,确认错误不会被包装成成功。
- CI 跑
_w/tub-smoke/smoke.py,P 系列 PASS,F 系列保持可复现。
当天 30 分钟落地
- 5 分钟:列出所有 Agent 的
tool_use_behavior,标出带副作用工具的那些。 - 10 分钟:给副作用工具加幂等键,或把收尾方式改为
StopAtTools。 - 5 分钟:把
is_enabled里的get改成下标,并为每个角色打印一次可见工具。 - 5 分钟:给自定义收尾函数补「工具抛错」测试,配置保留原文的错误函数。
- 5 分钟:把
tub-smoke.csv存进仓库,作为升级 SDK 的对照基线。
踩坑
- 以为
stop_on_first_tool等于「只执行一个工具」:它只决定终答取第一个结果,同一轮的其他调用照样执行(F6)。 - 以为
is_enabled=False等于禁止调用:它只让模型看不见;模型凭历史上下文仍可能发出调用,结果是报错而不是安全拒绝(F2)。 - 把
is_enabled函数写成依赖外部状态(数据库、时间)的慢查询:它每轮都会被调用,既拖慢请求,也让同一轮对话里工具忽隐忽现。尽量只读上下文里已经准备好的字段。 - 以为默认错误文案无害:对人类用户它只是一句「请重试」,对自定义函数它抹掉了全部错误信息(F0)。
总结
tool_use_behavior 管的是「工具之后谁说话」,is_enabled 管的是「这一轮模型能看见什么」。两个开关都很短,坑都在默认值和手写字符串里:默认交回模型会重复副作用,默认错误文案会抹掉错误码,手写的停用名和上下文键一旦拼错就静默失效。把 8 条失败写进禁区表,配置里每个值都写上理由,升级 SDK 时复跑同一份 smoke。本文实跑版本为 0.23.1,字段名与默认值以你安装的版本为准。