千笔-AIWritePaper · https://www.aiwritepaper.com
多轮 Agent 最容易踩的坑,不是「忘了上一句」,而是以为落盘了其实只落了半截 、以为隔离了其实共用了 session_id 、以为删掉了其实 messages 还在 。OpenAI Agents SDK 的 SQLiteSession 把对话 item 写进 SQLite:默认 :memory: 进程结束即丢;传入文件路径才跨重启。Runner.run(..., session=...) 跑前 get_items 取历史并前置,跑后把本轮新 item(用户输入、助手回复、工具调用与工具输出)写入同一 session_id。
本文在 openai-agents 0.23.1 下用脚本化假模型离线实跑:同 session 续聊、跨 ID 隔离、clear_session、SessionSettings(limit=...)、文件库跨对象持久化,以及五条生产向失败。全部结果进 _w/sqlite-session-smoke/ 的 CSV 与 smoke_output.txt,长输出原样可贴回。
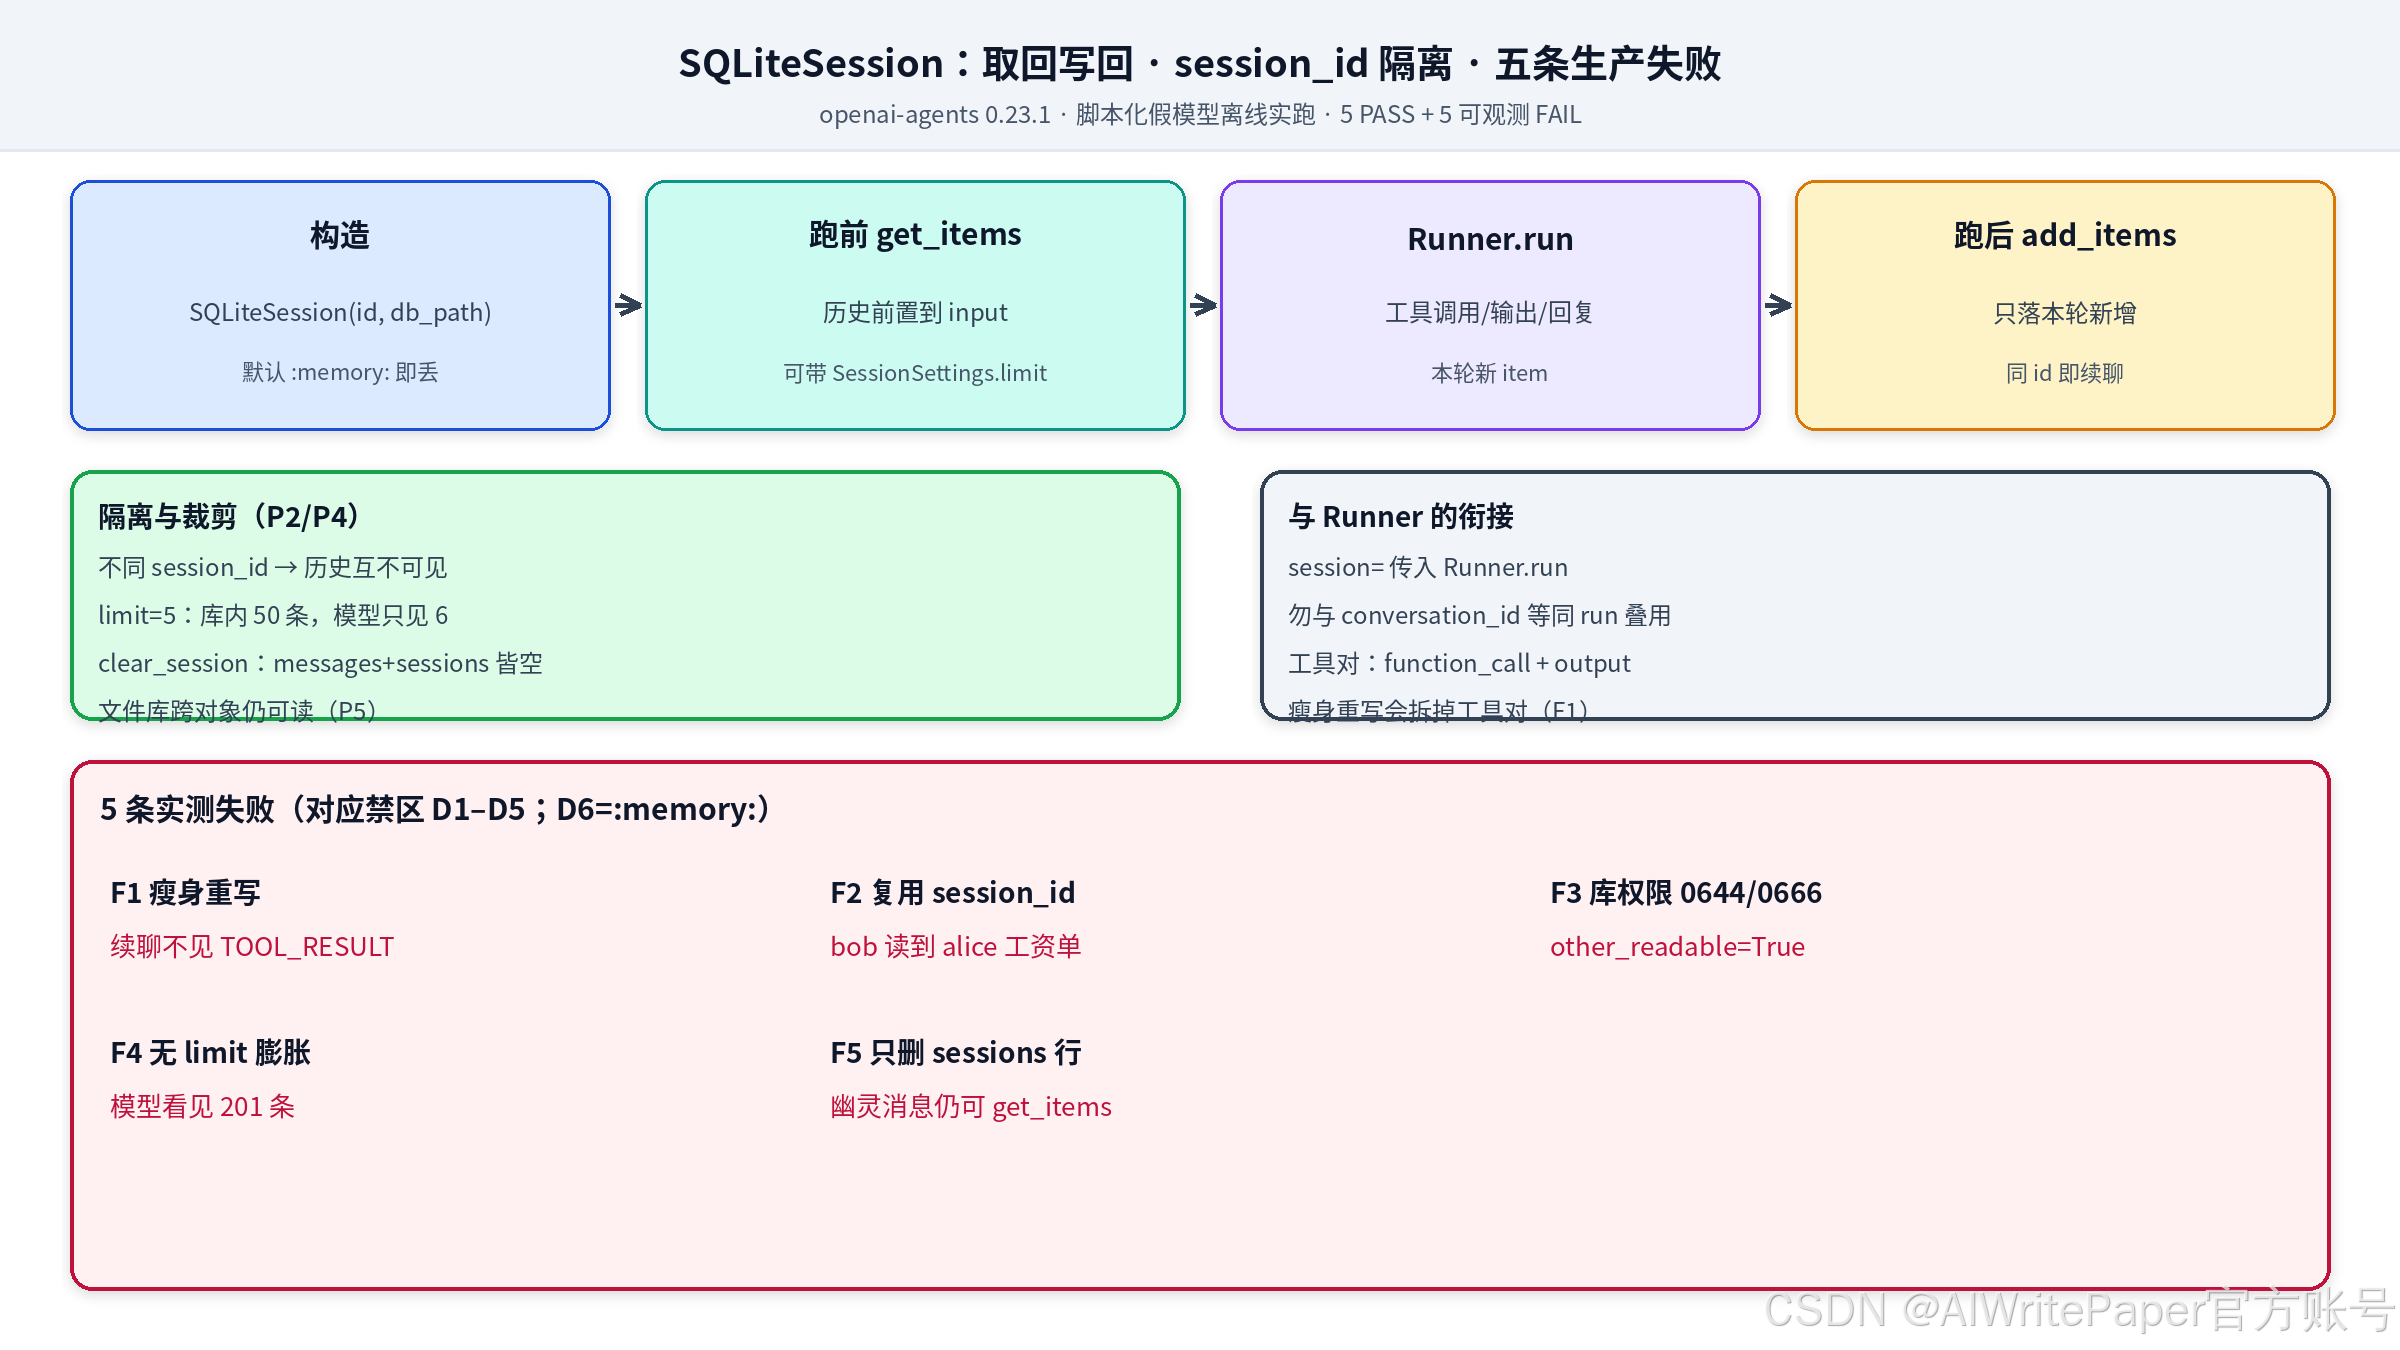
图:上排为 Runner 与 SQLiteSession 的取回/写回路径;中部为 session_id 隔离与 limit 裁剪;底部为 F1--F5 实测失败与禁区编号。
目标说明
读完你应能独立完成五件事:
- 用文件路径构造
SQLiteSession(session_id, db_path=...),并解释为何默认:memory:不能当生产持久化。 - 把同一个
session传给连续两次Runner.run,确认第二轮模型输入里仍有上一轮的function_call与function_call_output。 - 为每个终端用户生成不可猜测且不复用 的
session_id,并在库层按 ID 做清理。 - 用
SessionSettings(limit=N)或RunConfig(session_settings=...)限制送入模型的取回量,而不是把整库历史塞进上下文。 - 把 5 条失败样本写进禁区表和 CI:瘦身重写丢工具结果、跨用户共用 ID、库文件权限过宽、无 limit 膨胀、错误 DELETE 留下幽灵消息。
适用与边界
适合:需要 SDK 代管多轮历史,而不是每轮手写 .to_input_list();本地或自有磁盘落盘;同一用户下多个 Agent 共享一条会话线程;中断审批恢复时必须带回同一历史。
不讲:conversation_id / previous_response_id / auto_previous_response_id 等服务端续写(与 session 同 run 互斥,见 Sessions 文档);Redis / SQLAlchemy / Mongo / Dapr 等其他后端选型细节;ChatKit Store(官方写明不是 SDK session 的即插替换);业务授权真源(session 存的是对话 item,不是「谁有权看这笔订单」)。
失败含义:假模型按脚本返回调用,不代表真实模型一定会再调工具;但「库里有没有 function_call_output」「第二轮模型 input 里有没有 TOOL_RESULT」「错误 DELETE 后 get_items 是否仍能读出密文」由 session 与 Runner 决定,与模型聪明与否无关。权限位与 umask 随操作系统变化,本文数字来自本机实跑当日环境。
机制:落盘、衔接、隔离
| 环节 | 行为 | 工程含义 |
|---|---|---|
| 构造 | SQLiteSession(session_id, db_path="...") |
无路径即 :memory:;文件库才跨进程可见 |
| 跑前 | Runner 调 get_items(可带 limit) |
历史前置到本轮 input |
| 跑后 | 只持久化本轮新 item | 含用户、助手、工具调用与工具输出 |
| 隔离键 | session_id 字符串 |
相同 ID = 同一条历史;跨用户绝不可复用 |
| 清理 | clear_session() |
删本 ID 的 messages + sessions 行;手写 SQL 易留幽灵 |
表结构要点:agent_sessions(session_id PK) 与 agent_messages(session_id, message_data, ...),messages 上有按 session_id 的索引。get_items 按 id 升序解码 JSON;坏 JSON 行会被跳过。文件库启用 WAL,同进程内多 SQLiteSession 共享同一文件时靠路径级锁串行化写操作;这能减少「写一半」的概率,但不能 代替应用层的 session_id 设计与文件权限加固。
limit 只影响取回窗口:库内旧 item 仍在。合规删除、用户注销、租户退订,都必须走 clear_session() 或等价的后端 TTL,并抽检 agent_messages 行数为零。session_input_callback 可以改「送进模型的合并结果」,但持久化仍只落本轮新 item------用 callback 把工具对滤掉,等于人为制造 F1。
python
from agents import Agent, Runner, SQLiteSession
from agents.memory import SessionSettings
from agents.run import RunConfig

session = SQLiteSession("user-alice-thread-1", db_path="agents.db")
result = await Runner.run(agent, "第一问", session=session)
# 同一 session 对象或同 ID + 同 db_path 再跑,即续聊
result2 = await Runner.run(agent, "追问", session=session,
    run_config=RunConfig(session_settings=SessionSettings(limit=40)))
离线 smoke:5 条通过 + 5 条失败
text
P1  PASS 同 session 续聊保留工具调用与结果 -> 库条数=6 类型=['user', 'function_call', 'function_call_output', 'message'] 第二轮见fc=True 见output=True 含TOOL_RESULT=True
P2  PASS 不同 session_id 隔离 -> alice条数=2 bob条数=2 isolated=True
P3  PASS clear_session 后同对象与新对象皆空 -> 同对象=0 新对象=0
P4  PASS SessionSettings(limit=5) 裁剪送入 -> 库内≥50 模型看见=6 期望=6
P5  PASS 文件库跨 SQLiteSession 对象持久化 -> 新对象条数=2 含原文=True
F1  FAIL 同 session 续聊:瘦身重写丢掉工具结果 -> 重写后类型=['user', 'assistant', 'user', 'message'] 第二轮见TOOL_RESULT=False 模型输入类型=['user', 'assistant', 'user']
F2  FAIL 跨用户复用同一 session_id -> bob 读到 alice 原文=True 条数=2
F3  FAIL 库文件权限过宽 -> 默认mode=0o644 other_readable=True chmod后=0o666
F4  FAIL 会话膨胀无 limit 拖垮上下文 -> 库内200+ 模型看见=201(含本轮输入)
F5  FAIL 删除会话后幽灵消息(只删 sessions 行) -> messages残留=1 get_items条数=1 含原文=True
CSV rows: 10
逐条读法:
- P1:第一轮调
lookup后,库内四类 item 齐全;第二轮模型 input 仍含function_call与带TOOL_RESULT:alpha的function_call_output。 - P2:
alice/bob各写一句密钥,互不可见。 - P3:
clear_session后,同对象与重新SQLiteSession(同ID)都读到 0 条。 - P4:库内预置 50 条,
limit=5时模型只看见 5 条历史 + 本轮 1 条输入。 - P5:关闭旧对象再开新对象,文件库仍读到
survive-restart。 - F1:应用把历史「瘦身」成只有 user/assistant 再写回,续聊时
TOOL_RESULT从模型上下文消失------这是同 session 续聊丢工具结果的典型人工事故。助手上一轮的自然语言摘要不是工具原文的审计替代品。 - F2:业务上两个用户共用字符串
shared-id,后者直接读到前者的alice-payroll-99001。SDK 不会替你做租户校验,隔离完全等于 ID 设计。 - F3:本机 umask 下新建库默认
0o644(他人可读);再chmod 0o666可写。会话里常有系统提示、工具输出与用户隐私,权限过宽等于把明文会话放在共享磁盘上。 - F4:无 limit 时 200 条填充 + 本轮输入 = 模型看见 201 条,上下文被历史拖垮;账单与延迟一起上升,且更容易触发截断策略把最近的工具结果挤掉。
- F5:运维脚本只
DELETE FROM agent_sessions,agent_messages残留;随后get_items仍返回ghost-secret-token。元数据行删了不等于遗忘。
生产禁区表
| 编号 | 禁区 | 实测证据 | 替代做法 |
|---|---|---|---|
| D1 | 为省 token 把历史重写成纯文本对话 | F1:续聊不见 TOOL_RESULT |
需要压缩用官方 compaction / limit / 受控 callback,保留工具对 |
| D2 | session_id = user_id 或跨用户复用 |
F2:工资单原文串库 | ID = 用户密钥 + 线程 UUID;禁止前端自选裸 ID |
| D3 | 库文件保持默认 0644 / 0666 | F3:other_readable | 创建后 chmod 0o600,目录 0o700;多租户勿共目录 |
| D4 | 生产不设 limit 也不截断 |
F4:201 条塞进模型 | 默认 SessionSettings(limit=...),并监控 item 数 |
| D5 | 手写 SQL 只删 sessions 行 | F5:幽灵消息仍可 get_items |
只走 clear_session();清理作业断言 messages=0 |
| D6 | 默认 :memory: 当持久化 |
进程结束即空(对照 P5) | 生产必须显式文件路径或外部后端 |
配置对照:四个问题定落盘方式
| 问题 | 是 | 否 |
|---|---|---|
| 需要跨重启 / 跨进程? | 文件 db_path 或外部后端 |
不要用默认内存库 |
| 是否多租户同机? | 每租户独立库或严格 ID 前缀 + 0600 | 仍要防 F2/F3 |
| 历史是否可能很长? | 设 limit 或 compaction |
会走上 F4 |
| 删除是否合规要求? | clear_session + 抽检 messages |
禁止只删元数据行 |
最小复现:断言「第二轮是否还看得见工具结果」
这次 smoke 的关键不是假模型说了什么,而是它把每一轮收到的 input 列表 记下来。这样就能直接断言续聊有没有丢掉 function_call_output:
python
class ScriptModel(Model):
    def __init__(self, turns):
        self.turns, self.n, self.seen_inputs = turns, 0, []
    async def get_response(self, system_instructions, input, model_settings,
                           tools, output_schema, handoffs, tracing, **kw):
        self.seen_inputs.append(list(input) if input else [])
        ...
在你自己的项目里,用同一假模型跑「工具轮 → 追问轮」,断言 any(i.get("type")=="function_call_output" for i in model.seen_inputs[0])。谁若在中间做了瘦身重写,CI 会红。
常见误判
- 「第二轮还能接着聊,说明工具结果还在」:F1 也能接着聊,只是模型再也看不到
TOOL_RESULT,只能靠助手摘要幻觉补全。 - 「
clear_session调过了就安全」:若清理任务绕过 API 只删 sessions 表,F5 证明消息仍在。 - 「limit 会删掉旧记录」:P4 显示它只影响取回;库内旧 item 仍在,合规删除仍要
clear_session或后端 TTL。
与已写主题的咬合
| 相邻主题 | 关系 | 一句话 |
|---|---|---|
| tool_use_behavior | 工具之后谁收尾 | 收尾结果会作为 item 写入 session |
| needs_approval | 中断后恢复 | 恢复必须同一 session 实例或同 ID+同库 |
| ModelSettings / 上下文 | 控制单轮请求形态 | session 决定历史有多长地进入该请求 |
| sessions 记忆边界专文 | 互斥与后端地图 | 本篇专打 SQLite 落盘与五条可复现失败 |
session_id 生成与清理约定
生产里把三件事写进同一份配置,而不是散落在各个路由里:
- 生成 :
session_id = f"{tenant}:{user_key}:{thread_uuid}",其中thread_uuid由服务端签发,前端只持有不透明句柄。 - 绑定 :请求鉴权通过后,用令牌里的
user_key与句柄解析出的 ID 做前缀校验,拒绝跨用户句柄。 - 清理 :用户点击「新会话」或注销时调用
await session.clear_session(),随后用只读连接SELECT COUNT(*) FROM agent_messages WHERE session_id=?断言为 0;清理作业禁止只删agent_sessions。
这三条直接对应 F2 与 F5。缺任何一条,smoke 里的失败都会在线上以「偶发串话」或「删不干净」的形式出现。
验收清单
- 每个线上会话使用文件库或外部后端,启动时拒绝
:memory:。 -
session_id生成规则有单测:不同用户不可能碰撞。 - CI 覆盖「工具轮 → 追问轮」:第二轮 input 必须含
function_call_output。 - 默认配置带
SessionSettings(limit=...),并有膨胀告警。 - 库文件权限断言为
0o600;清理作业调用clear_session后抽检 messages=0。 - CI 跑
_w/sqlite-session-smoke/smoke.py,P 系列 PASS,F 系列保持可复现。
当天 30 分钟落地
- 5 分钟:列出所有
SQLiteSession构造点,标出仍用:memory:或相对路径写在临时目录的。 - 10 分钟:把
session_id改成「用户密钥 + 线程 UUID」,并加「禁止前端传裸 ID」校验。 - 5 分钟:给 Runner 默认挂上
SessionSettings(limit=40)(按你的模型窗口再调)。 - 5 分钟:对库文件
chmod 0o600,清理脚本改为只调clear_session。 - 5 分钟:把
sqlite-session-smoke.csv存进仓库,升级 SDK 时复跑对照。
踩坑
- 以为「续聊成功」等于「工具结果仍在上下文」:F1 用瘦身重写证明两者可分离;能聊下去只说明还有 user/assistant 文本。
- 以为删掉 session 元数据就等于遗忘:F5 的幽灵消息仍可被
get_items读出,审计与合规都会被骗。 - 把
session_id设计成邮箱或用户主键:F2 一旦调用方拼错或缓存串键,就是串库;前端若可自选裸 ID,攻击面更大。 - 在共享 NFS/容器卷上使用默认 umask 建库:F3 的
0o644对同机其他用户可读;多租户共目录时问题被放大。 - 靠人工「觉得差不多了」截断历史:没有
limit时 F4 会把数百条一次性送进模型,且截断位置不受你控制。 - 中断审批恢复时换了一个新的内存
SQLiteSession:恢复轮看不到原历史,用户会感觉「批了但 Agent 失忆」。 - 把
session_input_callback写成无条件丢弃function_call_output:库里还在,模型侧等价于 F1,排障时两边对不上。
总结
SQLiteSession 管的是按 session_id 把多轮 item 落进 SQLite ,Runner.run 负责跑前取回、跑后追加。真正决定生产能不能扛住的,不是 API 有多短,而是默认值与应用层习惯:内存库当持久化、共用 ID、默认文件权限、无 limit 膨胀、为省 token 拆掉工具对、手写 DELETE 留幽灵。把 5 条失败写进禁区表,配置里每个选择都写上理由,升级 SDK 时复跑同一份 smoke。本文实跑版本为 openai-agents 0.23.1,字段名与默认值以你安装的版本为准;若升级后 get_items / clear_session 语义有变,先以官方 Sessions 文档与本目录 CSV 对照。