本文收录于专栏 开源多肽性质预测 ------ 专栏系统覆盖开源多肽性质预测工具,点击订阅可跟踪后续更新。
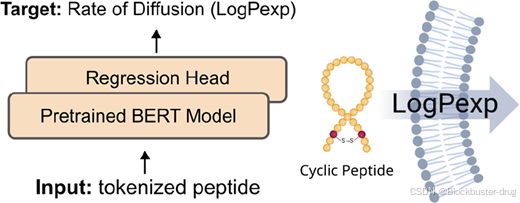
你做环肽 SAR,候选里全是 D-氨基酸、N-甲基化、非天然侧链,通用化学语言模型要么不认识这些 token、要么把环当隐式字符串让模型自己猜。PeptideCLM(JCIM 2025)把 2300 万分子(1200 万小分子 + 1100 万修饰肽)混训出一个 4400 万参数的 RoFormer 编码器,从第一天就学会"肽的 SMILES 长什么样"。这篇给你原理、与 HELM-BERT/MoLFormer-XL 的性能对比、本地部署与膜渗透预测实战。你在消费级硬件上跑它,先筛掉膜渗透不达标的环肽再进合成。
关键字:PeptideCLM、修饰肽、化学语言模型、环肽膜渗透、SMILES 预训练、RoFormer 编码器、膜渗透排序、JCIM 2025
目录
- 一、场景:做环肽 SAR 时,你最想先筛掉什么?
- 二、模型怎么工作的
- 三、性能:跟 HELM-BERT 和 MoLFormer-XL 比
- 四、本地部署
- 五、模型的局限
- 六、什么时候用 PeptideCLM
- 七、待追踪
环肽设计最大的痛:SMILES 里塞了 D-氨基酸、N-甲基化、非天然侧链,市面上所有化学语言模型要么不认识这些 token,要么把环当成隐式字符串让模型自己"猜"。PeptideCLM 的思路很直接------把 1200 万小分子 + 1100 万修饰肽混在一起预训练,让模型从第一天就学会"肽的 SMILES 长什么样"。
论文 : Feller AL, Wilke CO. Peptide-Aware Chemical Language Model Successfully Predicts Membrane Diffusion of Cyclic Peptides. J. Chem. Inf. Model. 2025, 65(2), 571--578. doi:10.1021/acs.jcim.4c01441
GitHub: https://github.com/AaronFeller/PeptideCLM(MIT License)
HuggingFace: https://huggingface.co/aaronfeller/PeptideCLM-23M-all
一、场景:做环肽 SAR 时,你最想先筛掉什么?
合成一个环肽类似物至少 2 周------合成、纯化、PAMPA 测渗透性。20 个类似物就是半年。
如果有一个模型能先用 SMILES 预测渗透性排序,把合成资源集中到 Top 5------这就是 PeptideCLM 做的事。
它不是第一个化学语言模型(之前有 ChemBERTa、MolFormer),但是第一个专为修饰肽设计的。区别在哪?
- ChemBERTa 训练数据 99% 是小分子,遇到 D-氨基酸的
[C@@H]token 就当低频词处理 - PeptideCLM 的训练数据里 ~48% 是肽(SmProt 天然肽 + RandPept 计算机生成的环肽),模型见过足够多的非天然氨基酸、N-甲基化、环化标记
二、模型怎么工作的
先看看文章的解释:
2.1 架构:RoFormer --- 旋转位置编码 + MLM
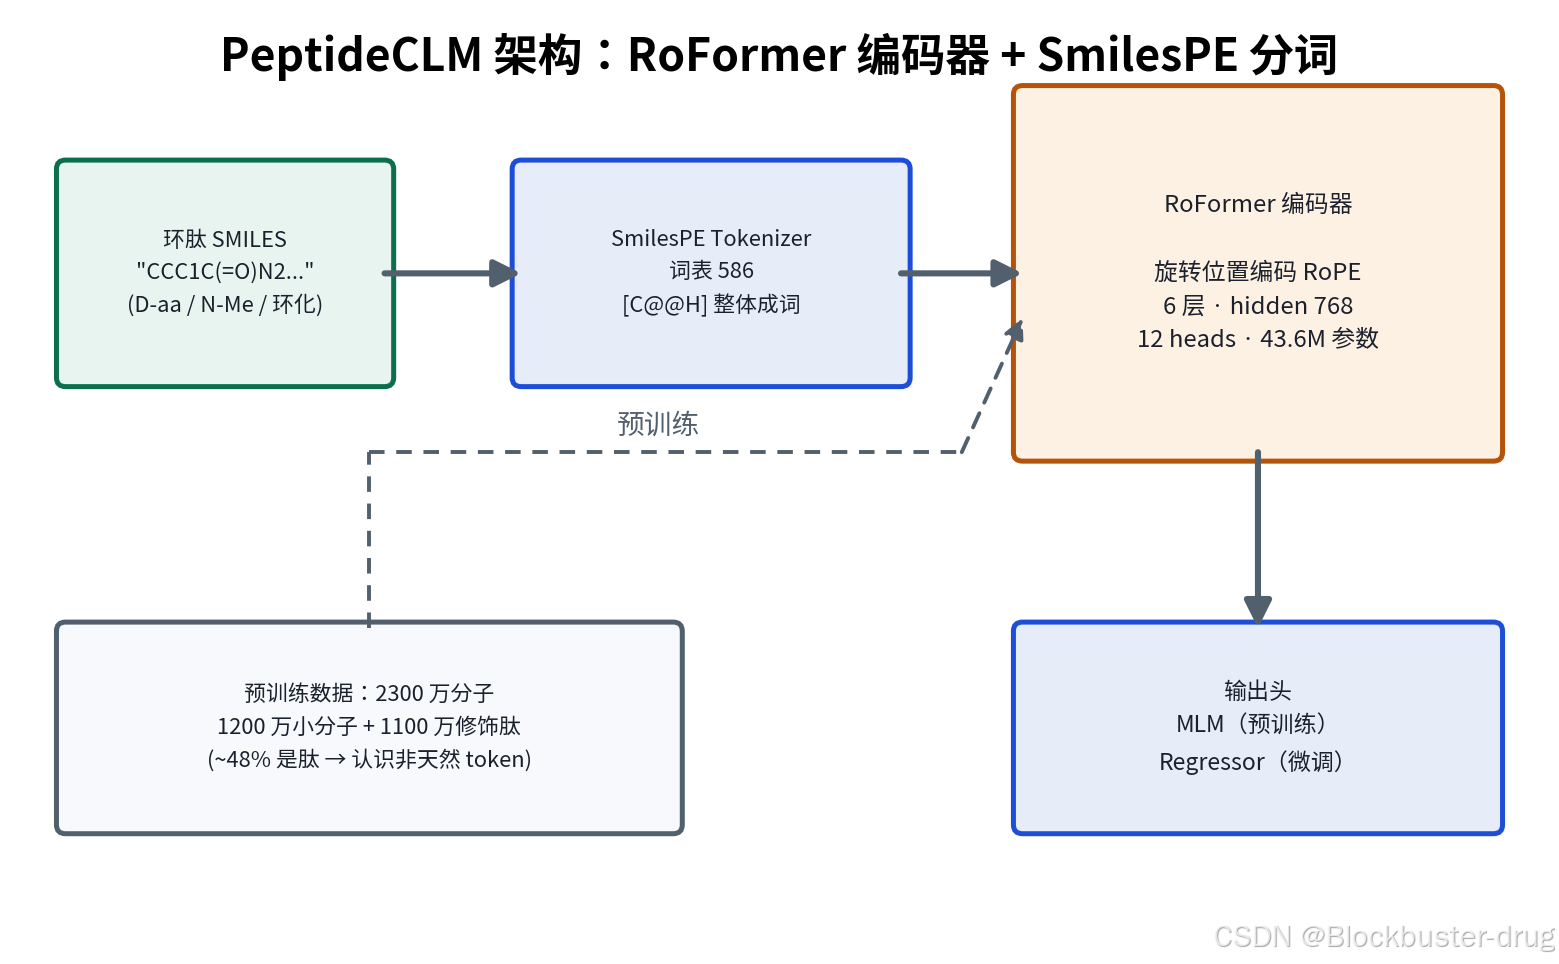
核心组件:
| 组件 | 选择 | 原因 |
|---|---|---|
| 骨干 | RoFormer (6 层 × 12 头, hidden 768, FFN 3072) | 旋转位置编码天然适合 SMILES------环闭合数字的相对距离比绝对位置重要 |
| Tokenizer | SmilesPE 变体 (词表 586) | 专为 SMILES 设计的 pair encoding,[C@@H] 等手性 token 不被打散 |
| 参数量 | 43.6M (实测加载) | 名字里的 23M 指预训练分子数,不是参数量 |
| 预训练数据 | 2300 万分子 | 1200 万小分子 + 1100 万肽 |
| 微调数据 | CycPeptMPDB | 约 8000 条环肽 PAMPA 数据 |
SmilesPE 是什么?标准的 BPE(Byte Pair Encoding)用在 SMILES 上。比如
[C@@H]这个 D-氨基酸手性标记不会被打散成[C@@H]三个 token,而是作为一个整体 token 保留------这对非天然氨基酸的表示很重要。
2.2 三个模型变体
| 模型 | 预训练数据 | 用途 |
|---|---|---|
| PeptideCLM-23M-all | PubChem + SureChEMBL + SmProt + RandPept | 完整版,微调渗透性预测效果最好 |
| PeptideCLM-12M-smol | PubChem + SureChEMBL(纯小分子) | 消融对照:证明肽数据贡献 |
| PeptideCLM-11M-pep | SmProt + RandPept(纯肽) | 消融对照 |
三、性能:跟 HELM-BERT 和 MoLFormer-XL 比
从 HELM-BERT 论文(JCIM 2026)的横向对比可以直接看到 PeptideCLM 在同任务上的位置:
| 模型 | 参数量 | 随机拆分 R² | 骨架拆分 R² |
|---|---|---|---|
| HELM-BERT (full FT) | 54.2M | 0.668 | 0.483 |
| MoLFormer--XL | 44.4M | 0.578 | 0.374 |
| PeptideCLM | 43.6M | 0.536 | 0.239 |
| SMILES-HELM-BERT | 54.2M | 0.646 | 0.449 |
测试集:CycPeptMPDB 膜渗透性(PAMPA),7,715 条环肽。
PeptideCLM 参数量 43.6M------与 MoLFormer-XL 相当、约为 HELM-BERT 的 80%。随机拆分 R²=0.536,骨架拆分 R²=0.239(远弱于 HELM-BERT 的 0.483------这是 PeptideCLM 的已知短板,后面会说)。
正确期待:
- 随机拆分:43.6M 模型能做到 R² ~0.54------比随机强很多,略弱于同量级的 MoLFormer-XL
- 骨架拆分:表现差------如果你的类似物骨架跟训练集差异大,PeptideCLM 的预测不可靠
四、本地部署
4.1 硬件要求
| 阶段 | 最低 | 推荐 |
|---|---|---|
| 推理 | CPU | 任意 GPU |
| 微调 | 消费级 GPU(12 GB 显存) | 单卡 GPU |
| 预训练 | A100 40GB+ | --- |
模型权重 175 MB(实测 pytorch_model.bin)。
4.2 安装
bash
pip install torch transformers datasets SmilesPE pandas4.3 加载模型
模型从 HuggingFace 加载,但 tokenizer 必须从 GitHub 仓库加载 (HF repo 里没有 tokenizer 文件,作者明确说明没能移植过去,AutoTokenizer.from_pretrained 会直接报错):
bash
git clone https://github.com/AaronFeller/PeptideCLM.git
cd PeptideCLM
pip install SmilesPE
python
from transformers import AutoModelForSequenceClassification
from tokenizer.my_tokenizers import SMILES_SPE_Tokenizer   # GitHub 仓库内

# tokenizer: GitHub 仓库的 vocab + splits 文件
tokenizer = SMILES_SPE_Tokenizer("tokenizer/new_vocab.txt", "tokenizer/new_splits.txt")
# 模型: HuggingFace hub (首次下载 175 MB)
model = AutoModelForSequenceClassification.from_pretrained(
    "aaronfeller/PeptideCLM-23M-all", num_labels=1
)
Linux 实测:模型加载 3.5 s、词表 586、backbone 43.0M + 分类头 0.59M 参数。
4.4 预测一条环肽
python
import torch

# 环孢素 A 的 SMILES
smiles = "CCC1C(=O)N2CCCC2C(=O)N(C)C(=O)C(C)C(NC(=O)...(省略)...)C"

# 按作者微调协议: padding 到 max_length=768
inputs = tokenizer(smiles, padding="max_length", truncation=True,
                   max_length=768, return_tensors="pt")
with torch.no_grad():
    logits = model(**inputs).logits
    pampa_logp = logits.item()

print(f"预测 logP(PAMPA): {pampa_logp:.2f}")
注意:直接加载的预训练模型分类头是随机初始化的(
num_labels=1),输出的 logit 无意义------必须先在 CycPeptMPDB 上微调(见下一节),或用于提取 embedding。
推理速度(Linux 实测,消费级 GPU):单条 19.6 ms(环孢素 A,padding 到 768 token,50 次平均)。20 条类似物串行不到 0.5 秒,批处理更快。
4.5 踩坑
⚠️ 踩坑 #1(实测最深的坑) :
AutoTokenizer.from_pretrained必然失败 ------HF 仓库里只有config.json+pytorch_model.bin,没有 tokenizer 文件;transformers 会按model_type: roformer回退到RoFormerTokenizer,先要装 rjieba,装完还是在 encode 时抛TypeError: argument of type 'NoneType' is not iterable。作者在 README 里明说尝试移植 HF 未成功。正解 :clone GitHub 仓库,用tokenizer/my_tokenizers.py里的SMILES_SPE_Tokenizer(new_vocab.txt, new_splits.txt)加载(词表 586)。
⚠️ 踩坑 #2(显存) :作者示例padding="max_length"到 768,RoFormer 的注意力矩阵按序列长度全量计算------batch 32 在 12 GB 消费级 GPU 上直接 OOM(实测峰值 >11 GB)。解法:实测语料 token 长度 p99=111(环肽 SMILES 都很短),截断到 256 即可零信息损失,batch 16 fp32 稳跑(峰值 ~3 GB)。
4.6 微调复现(leave-one-cluster-out 实测)
按作者 example_training_script.py 的协议,在仓库自带 clustered_data/all_clusters.csv(6,701 条 CycPeptMPDB 环肽 + PAMPA)上做 leave-one-cluster-out:
python
# 关键设置 (Linux 实测, 消费级 GPU 12GB)
# tokenizer: SMILES_SPE_Tokenizer, max_length=256 (语料 p99=111 token)
# model: AutoModelForSequenceClassification, num_labels=1, lr=2e-5
# batch=16, epochs=5, AdamW + linear warmup 6%
# split: cluster 2 (1,465 条) held-out, 其余 5 簇 4,713 条训练 / 523 条验证| 指标 | 值(实测) |
|---|---|
| 训练时长 | 385 s(5 epochs,GPU 满载 ~3 GB) |
| val R(训练分布内) | 0.384(持续上升,未饱和) |
| test R(cluster 2 跨簇) | 0.255 |
| test MAE | 0.582(数据集 std=0.77) |
跨簇 R(0.255)只有分布内 val R(0.384)的三分之二------与论文"leave-one-cluster-out 显著掉点"的结论方向一致。5 epochs 是 smoke 预算,作者全量协议是 10 epochs,想复现论文数字按 README 跑满。
五、模型的局限
- 骨架泛化差 :骨架拆分 R²=0.239------如果你的环肽骨架跟 CycPeptMPDB 差别大,预测不可靠。Linux 复现实测(消费级 GPU,cluster 2 作 held-out 测试集、其余 5 簇训练 4,713 条、5 epochs):训练集内在学(val R 爬到 0.38),但跨簇测试 R 只有 0.255------跨化学空间泛化弱是真实短板,不是论文夸大
- 只输出排序,不输出绝对值:模型做的是排序(ranking),不适合直接比较不同系列的绝对值
- 不编码 3D 构象:跟 EnsembleCycPerm / HELM-BERT 不同,PeptideCLM 是纯序列级模型------"变色龙效应"(构象依赖渗透性)是盲区
- SMILES 表示的限制 :大环的环闭合用数字标签(
C1CCCCC1),模型需要从 token 序列中推断拓扑------这是 HELM 表示法要解决的痛点
六、什么时候用 PeptideCLM
| 场景 | 推荐 | 理由 |
|---|---|---|
| 环肽类似物渗透性快速排序 | ✅ | 43.6M 模型,GPU 单条 ~20 ms |
| 含非天然氨基酸的肽 | ✅ | 训练数据覆盖了修饰 token |
| 先筛 1000 → 50,再做 MD | ✅ | 省掉 95% 合成 |
| 全新骨架环肽 | ❌ | 骨架泛化差,用 HELM-BERT |
| 需要绝对值(不是排序) | ❌ | 用实验 PAMPA 或更复杂的模型 |
| 需要 3D 构象信息 | ❌ | 纯序列模型------盲区 |
七、待追踪
- PeptideCLM v2 --- 作者在 GitHub 提到"future publication",但 JCIM 2025 版是当前正式版
- HELM-BERT 已经全面超越 PeptideCLM(R² 0.668 vs 0.536),关注后续对比
- SmilesPE tokenizer 的 HF 集成 --- 仍是 PR welcome 状态
- 预训练数据集 DOI: 10.5281/zenodo.14194469
- CycPeptMPDB v1.2 更新 --- 作者用的 v1.0,v1.2 数据更多
参考
- Feller AL, Wilke CO. J. Chem. Inf. Model. 2025, 65(2), 571--578.
- GitHub: https://github.com/AaronFeller/PeptideCLM
- HuggingFace: https://huggingface.co/aaronfeller/PeptideCLM-23M-all
- Lee S et al. HELM-BERT. J. Chem. Inf. Model. 2026, 66, 7900--7916. (横向对比数据来源)
- 预训练数据: https://doi.org/10.5281/zenodo.14194469
Linux 实测(2026-10):Ubuntu 22.04 / 消费级 GPU(12 GB 显存)/ PyTorch 2.13 / transformers 4.58。加载 3.5 s、单条推理 19.6 ms、GPU 显存 184 MB、权重 175 MB、微调 385 s(val R 0.384 / 跨簇 test R 0.255)均为实测值。
系列导航 :专栏全集 开源多肽性质预测
我的专栏
| 蛋白 / 抗体 / 多肽 / 核酸 | 分子模拟 / 动力学 / 对接 | 药物 / 设计 / 案例 | AI / Agent / 大模型 |
|---|---|---|---|
| 开源蛋白结构预测 | 分子模拟基础 | 小分子药物设计案例 | AI Agent系列 |
| 开源蛋白生成方法实践 | 分子动力学模拟-Amber | 蛋白药物设计案例 | 化学大模型 |
| 开源多肽设计模型 | 分子动力学模拟-Gromacs | 多肽药物设计案例 | 《AI Agent原理与实战》 |
| 开源多肽性质预测 | 分子动力学模拟-OpenMM | 开源小分子生成设计 | CADD中的机器学习模型 |
| DNA/RNA药物设计 | 結合自由能 | 高效计算配置 | 《MCP 入门实战》 |
| siRNA药物设计模型 | UCSF DOCK系列 | 我胡师兄说药 | 《AI入门实战2026》 |
| ASO药物设计模型 | rDock系列 LeDock系列 gnina系列 | 《经典机器学习实战》 |