文章目录
-
- [1. 先明确事实边界:不要把猜测写成架构](#1. 先明确事实边界:不要把猜测写成架构)
- [2. 多模态模型到底多了什么](#2. 多模态模型到底多了什么)
- [3. 早期融合和后期融合:工程路线不同](#3. 早期融合和后期融合:工程路线不同)
- [4. 图片 token 成本:一张图不是一个 token](#4. 图片 token 成本:一张图不是一个 token)
- [5. 视频和音频:多了时间维度](#5. 视频和音频:多了时间维度)
- [6. 长上下文:放得下、找得到、用得对](#6. 长上下文:放得下、找得到、用得对)
- [7. 工具生态:产品能力不只来自模型本体](#7. 工具生态:产品能力不只来自模型本体)
- [8. 多模态输出应该带证据](#8. 多模态输出应该带证据)
- [9. 多模态评估清单](#9. 多模态评估清单)
- [10. 项目落地建议](#10. 项目落地建议)
- [11. 常见误区](#11. 常见误区)
- [12. 小结](#12. 小结)
- 大模型视角
- 下一篇
摘要:Gemini 系列常被讨论的关键词是多模态、长上下文、工具生态和复杂推理。由于它是闭源模型,外部不能确认完整内部结构、参数量、训练数据和所有融合细节;但我们可以从公开能力和多模态大模型通用原理中学习:图片、音频、视频和文档如何变成模型可处理的表示,视觉 token 为什么有成本,长上下文为什么不等于"都能用好",工具生态为什么会影响产品能力,多模态评估为什么必须看证据。本文会用开发者视角拆解这些设计问题,而不是猜测闭源细节。
- 前置知识:专栏一Transformer、 Tokenization、上下文扩展
- 阅读时间:60-75 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释多模态大模型的通用结构,能理解视觉 token、视频时序、长上下文定位和工具生态的评估难点,能设计多模态业务评估集
1. 先明确事实边界:不要把猜测写成架构
Gemini 是闭源模型。外部不能确认它每一层的内部结构、参数量、训练数据配比、完整多模态融合方式和安全训练流程。
本文只讨论三类内容:
text
1. 多模态大模型普遍要解决的技术问题;
2. Gemini 这类闭源多模态产品公开呈现出的能力方向;
3. 开发者做多模态应用时可复用的评估和工程方法。
这条边界很重要。闭源模型文章如果为了显得"深"而编造内部细节,反而会误导读者。更可靠的写法是:把不可知的内部结构放下,重点学习可迁移的系统问题。
2. 多模态模型到底多了什么
纯文本模型的输入是 token 序列。多模态模型要处理更多输入形态:
text
文字;
图片;
截图;
PDF 和扫描件;
表格和图表;
音频;
视频;
工具返回结果;
网页和 UI 状态。
这些模态的数据结构完全不同:图片是像素网格,音频是时间序列,视频是帧序列,PDF 有页面和版式,文本是离散 token。多模态模型要做的第一件事,是把不同模态转成可以共同推理的表示。
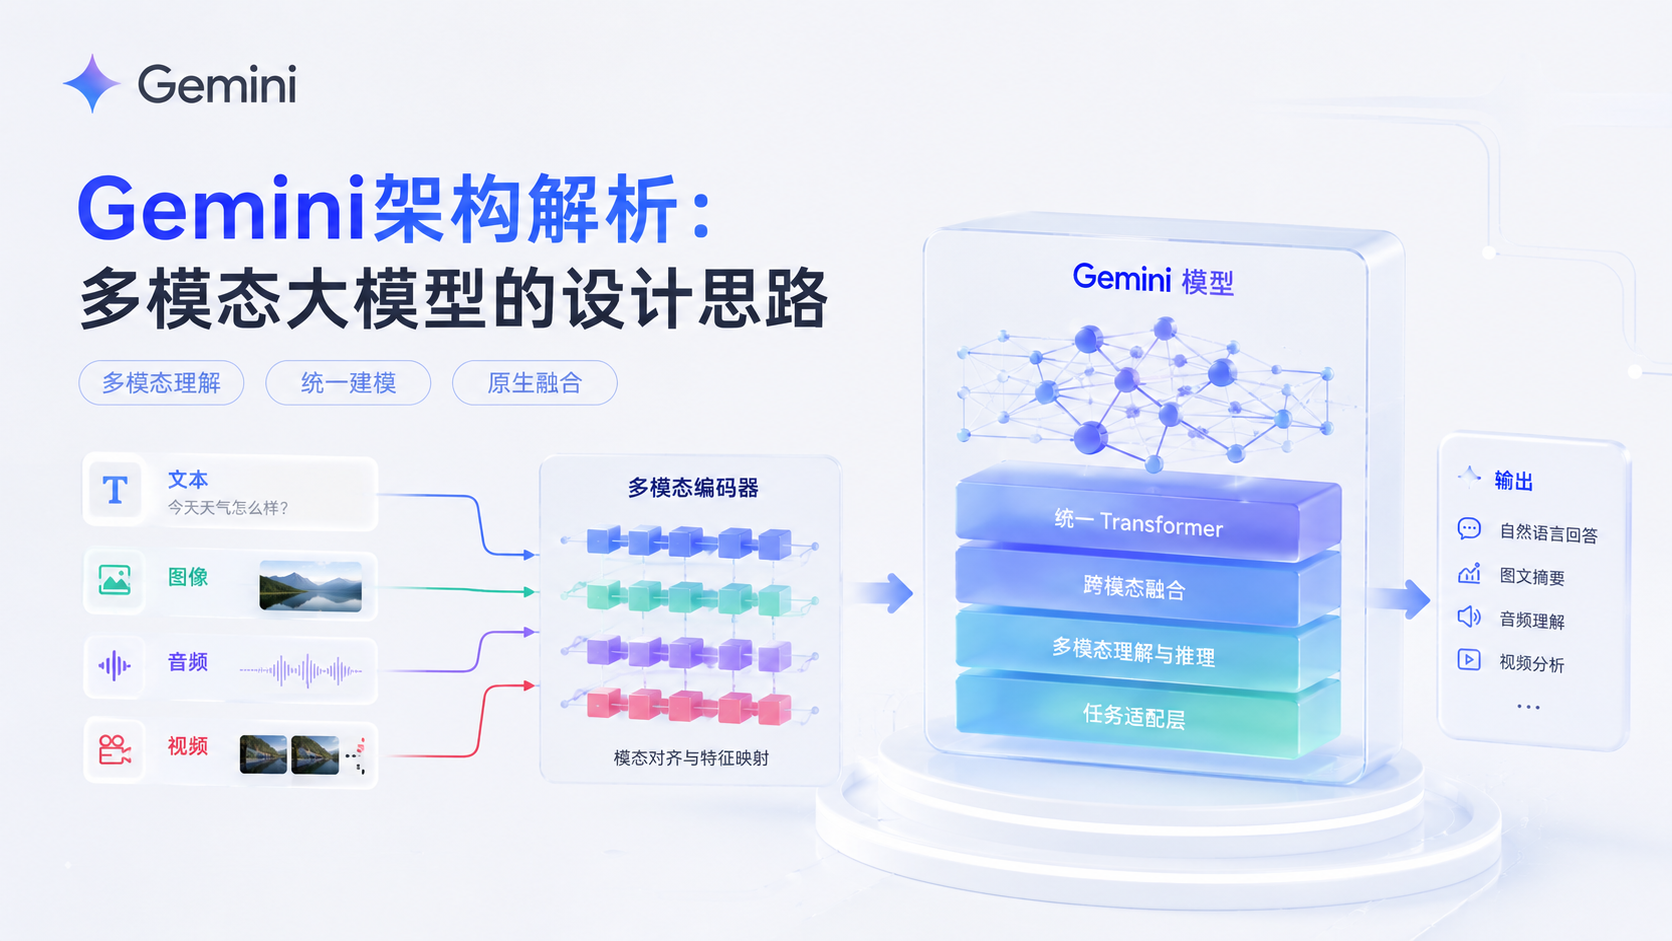
通用流程可以写成:
text
输入模态 -> 模态编码器 -> 投影/对齐模块 -> 统一表示序列 -> 多模态/语言模型推理 -> 输出比如图片问答:
text
image -> vision encoder -> visual embeddings -> projector -> visual tokens + text tokens -> model -> answer这和"OCR 后交给文本模型"不同。OCR 只提取文字,多模态模型还可能利用布局、空间关系、颜色、图形和视觉上下文。
3. 早期融合和后期融合:工程路线不同
多模态系统可以粗略分成后期融合和早期/原生融合。
| 方式 | 大白话理解 | 优点 | 风险 |
|---|---|---|---|
| 后期融合 | 先用 OCR/ASR/检测工具转成文本,再给 LLM | 工程简单、可控、可替换 | 丢失位置、版式、视觉细节、时序 |
| 早期/原生融合 | 图像/音频/视频特征直接进入模型表示 | 信息更完整,跨模态推理更自然 | 训练复杂、成本高、评估难 |
举例:票据审核任务里,OCR 可以识别"金额 1200 元",但它未必保留金额所在区域、印章位置、勾选框状态、表格行列关系。原生多模态模型更有机会综合这些视觉结构。
但后期融合并不是落后方案。很多企业项目中,OCR + 规则 + LLM + 人工复核更可控。选早期融合还是后期融合,取决于任务是否需要视觉结构,而不是哪种听起来更先进。
4. 图片 token 成本:一张图不是一个 token
图片通常会被切成 patch 或视觉 token。分辨率越高,patch 越多,视觉 token 越多。视觉 token 会占上下文、增加计算和费用。
用 patch 数建立直觉:
python
# Python 3.10+
import math


def patch_count(width, height, patch_size):
    return math.ceil(width / patch_size) * math.ceil(height / patch_size)

for width, height in [(224, 224), (1024, 768), (1920, 1080), (2480, 3508)]:
    print((width, height), "patch16=", patch_count(width, height, 16))
最后一个尺寸接近 A4 扫描图量级。你会看到视觉 token 数可能很大。真实模型会使用缩放、裁剪、动态分辨率、多尺度编码、token 压缩等策略,但核心事实不变:多模态输入不是免费的。
因此多模态系统要做输入预算:
text
1. 图片是否需要原始高分辨率?
2. 能否先裁剪关键区域?
3. 是否需要多图同时输入?
4. PDF 是否按页处理?
5. OCR 文本和图片是否都要传?
6. 是否需要证据区域而不是整图回答?
5. 视频和音频:多了时间维度
图片主要是空间问题;音频和视频还多了时间维度。视频问答不是"看一张图",而是要理解事件顺序。
例子:
text
用户:视频里用户点击提交后,页面出现了什么错误?模型或系统需要:
text
1. 找到点击动作发生的时间;
2. 读取点击后的页面状态;
3. 识别错误提示文字或 UI 变化;
4. 把答案和时间戳关联起来。
抽帧策略会直接影响结果。抽太少,漏掉关键瞬间;抽太多,成本高。
下面用代码模拟按固定间隔抽帧:
python
# Python 3.10+

def sample_frames(duration_seconds, fps, sample_every_seconds):
    total_frames = int(duration_seconds * fps)
    step = int(sample_every_seconds * fps)
    return list(range(0, total_frames, max(step, 1)))

frames = sample_frames(duration_seconds=30, fps=30, sample_every_seconds=2)
print("sampled frame indices:", frames[:10])
print("count:", len(frames))
固定间隔抽帧简单,但不一定适合所有任务。UI 操作、体育比赛、监控异常等场景可能需要事件检测、关键帧检索、ASR 字幕和时间戳共同工作。
6. 长上下文:放得下、找得到、用得对
Gemini 类模型常被讨论长上下文能力。但长上下文必须拆成三层:
text
放得下:输入不超过窗口;
找得到:模型能定位关键证据;
用得对:模型能整合证据并正确回答。
多模态长上下文更难,因为证据可能分布在:
- 第 80 页 PDF 的表格;
- 第 20 张截图的小字;
- 视频 03:21 的错误提示;
- 音频里某一句话;
- 多个图表之间的交叉引用。
可以构造一个"needle in multimodal haystack"评估:把关键证据放在不同位置,看模型是否能找到。
python
# Python 3.10+

def make_needle_eval(num_pages, needle_page):
    pages = [f"第{i}页:普通背景资料。" for i in range(1, num_pages + 1)]
    pages[needle_page - 1] = f"第{needle_page}页:关键证据:退款周期为3-5个工作日。"
    question = "退款周期是多少?请指出证据页。"
    return pages, question

pages, question = make_needle_eval(10, 7)
print(question)
print(pages[6])
真实评估要把 needle 放在不同页、不同图、不同视频时间点,并加入相似干扰证据。只测"短上下文图片描述"无法说明长上下文多模态可靠。
7. 工具生态:产品能力不只来自模型本体
多模态产品常结合很多工具:OCR、ASR、搜索、地图、代码执行、文档解析、表格识别、浏览器、办公套件、移动端系统能力。用户看到的是整体产品,不是裸模型。
评估时必须区分:
text
模型本体看懂了什么;
OCR/ASR 提供了什么;
检索系统找到了什么;
工具执行返回了什么;
后处理校验了什么;
UI 做了哪些隐藏约束。
一个 demo 表现好,不代表你直接调用模型 API 就能复现。比如"读懂 PDF"可能依赖文档解析器、OCR、页码切分、表格抽取和模型总结的组合。
多模态系统架构通常更像:
text
输入文件 -> 解析/OCR/抽帧/ASR -> 检索和证据定位 -> 多模态模型推理 -> 结构化校验 -> 人工复核/输出8. 多模态输出应该带证据
业务多模态任务最好要求模型输出证据位置。否则人工复核成本很高。
示例结构:
json
{
  "answer": "第二项费用可能不合规,因为发票日期晚于报销周期。",
  "evidence": [
    {"page": 1, "region": "费用明细第2行", "text": "发票日期:2026-03-18"},
    {"page": 1, "region": "报销周期", "text": "2026-03-01 至 2026-03-10"}
  ],
  "confidence": "medium"
}
可以用简单校验器检查输出结构:
python
# Python 3.10+
import json

required_keys = {"answer", "evidence", "confidence"}


def validate_multimodal_output(text):
    try:
        obj = json.loads(text)
    except json.JSONDecodeError:
        return ["invalid json"]
    errors = []
    missing = required_keys - obj.keys()
    if missing:
        errors.append(f"missing keys: {sorted(missing)}")
    if not isinstance(obj.get("evidence", []), list):
        errors.append("evidence must be list")
    return errors

sample = '{"answer":"...","evidence":[{"page":1,"region":"A1"}],"confidence":"medium"}'
print(validate_multimodal_output(sample))
证据结构不是形式主义。它让模型输出可审计、可回归、可人工复核。
9. 多模态评估清单
多模态评估要按任务拆,不要只问"图里有什么"。
| 任务 | 评估点 |
|---|---|
| 图片描述 | 物体、关系、细节、错误承认 |
| OCR | 小字、模糊、旋转、多语言、遮挡 |
| 表格 | 行列、合并单元格、跨页表格 |
| 图表 | 坐标轴、单位、趋势、图例、异常点 |
| UI 截图 | 控件、状态、错误提示、操作路径 |
| 文档问答 | 页码、证据定位、跨页整合 |
| 视频 | 时间点、事件顺序、关键帧证据 |
| 音频 | ASR、说话人、时间戳、噪声 |
| 多图 | 图片编号、跨图对比、避免混淆 |
| 安全隐私 | 人脸、证件、未成年人、高风险建议 |
每个任务都要有"看不清/证据不足"样本。多模态模型很容易在图像模糊、小字缺失或证据不存在时仍然给出自信答案。
10. 项目落地建议
做 Gemini 类多模态项目时,可以按这个顺序推进:
text
1. 明确主模态:图片、PDF、视频、音频、截图还是混合?
2. 明确任务:描述、抽取、问答、审核、操作指导?
3. 明确证据要求:页码、区域、时间戳、原文片段?
4. 先做小评估集:正常、模糊、干扰、无证据、高风险。
5. 控制输入预算:分辨率、页数、帧数、上下文长度。
6. 区分模型能力和工具能力:OCR/ASR/检索是否可替换?
7. 加失败处理:看不清、证据不足时拒答或转人工。
8. 高风险场景保留人工复核和审计。
如果没有评估集,多模态 demo 很容易制造过高期待。尤其是票据、合同、医疗影像、身份信息、监控视频这类高风险任务,不能只靠模型一句话输出。
11. 常见误区
误区一:多模态就是 OCR 加文本模型。 OCR 是一部分,多模态还涉及空间关系、视觉结构、图表、UI 和跨模态推理。
误区二:长上下文越长越好。 还要看证据定位、抗干扰、成本和延迟。
误区三:高分辨率图片总是更好。 更清晰但更贵。要按任务平衡分辨率、裁剪和 token 成本。
误区四:闭源多模态模型可以靠外部猜架构。 不能。应基于公开资料、API 行为和自己的评估集。
误区五:多模态答案不需要证据。 业务场景必须可复核,页码、区域、时间戳和原文片段很重要。
12. 小结
Gemini 类多模态模型代表了大模型从文本助手走向通用输入接口的趋势。学习它的重点不是猜闭源内部结构,而是理解多模态系统要解决的通用问题:模态编码、表示对齐、视觉 token 成本、视频时序、长上下文证据定位、工具生态和结构化评估。
对开发者来说,多模态落地要把任务、模态、证据、成本和失败处理说清楚。模型能看图只是起点,能不能稳定抽取、定位、引用、拒答和复核,才决定它能不能进入业务系统。
大模型视角
从大模型演进看,多模态让模型连接真实世界的图片、声音、视频和工具,也让错误类型变多:看错、听错、定位错、引用错、工具错。系统评估必须随之升级,从"答案像不像"变成"证据是否存在、位置是否正确、风险是否可控"。
下一篇
下一篇会深入 MoE 专家混合架构。它解决的是另一个问题:如何扩大模型容量,同时控制每个 token 的计算成本。