用华为云码道开发策境 CampusFlow:让校园活动的人力安排,先在浏览器里推演一次
一键开通华为云码道 CodeArts 代码智能体:https://developer.huaweicloud.com/codeartsco.html?source=dmzntgwatomgit1&sourcead=dmzntgwatomgithd
一次校园活动,总共只有 12 名服务人员:签到处应该安排几个人?体验区又应该如何分配?如果签到队伍很长,是不是多安排两个人就一定能改善整个活动的体验?
我想做的不是一个直接给出"最优答案"的系统,而是一个能把这些假设放到同一组条件下比较的工具。
于是,我借助华为云码道 CodeArts 代码智能体,分阶段开发了 策境 CampusFlow------校园活动运营推演平台:在浏览器里编辑场景、调整 A/B 人员方案,运行排队仿真,再通过统计表和过程回放观察差异。
这个项目也让我更具体地理解了 AI 编程中的一个问题:生成页面和代码只是开始,真正需要花精力的,是把需求说清楚、把状态管理做稳、把结果的含义讲明白。
项目边界:本文中的人数、等待时间和完成率来自人工设定的合成场景与仿真计算,不是真实校园活动的采集数据。参数尚未经过现场校准,平台不用于疏散安全认证,也不能据此得出真实活动安全结论。
项目仓库:AtomGit · maaath/CampusFlow
一、从"签到处加两个人"开始,问题其实没有那么简单
校园活动中的排队,不是几个互不相关的队列。
参加者先进入活动区域,再到签到站,之后前往某个体验区,完成体验后离场。前一个站点放行得更快,会改变后一个站点接收到人流的节奏;如果增加签到人员的代价是减少体验区人员,那么签到队伍虽然变短,后续体验环节却可能更加拥堵。
因此,策境希望回答的是一组可以通过模拟比较的问题:
- 在总人力预算相同的情况下,不同分配方式会产生什么差异?
- 签到等待时间缩短以后,体验区的等待是否反而增加?
- 在同一个观察窗口内,多少人完成体验,多少人已经离场?
- 哪些站点长期繁忙,哪些站点仍有余量?
- 如果修改服务时长或场地路径,结果会怎样变化?
当前版本采用简化流程:入口 → 签到站 → 选中的一个体验区 → 出口。每位访客选择一个目标体验区,系统根据路径与服务配置模拟其移动、排队、服务和离场。
这不是对现实活动的完整复刻,而是一个有明确假设、可以重复运行的运营方案实验环境。
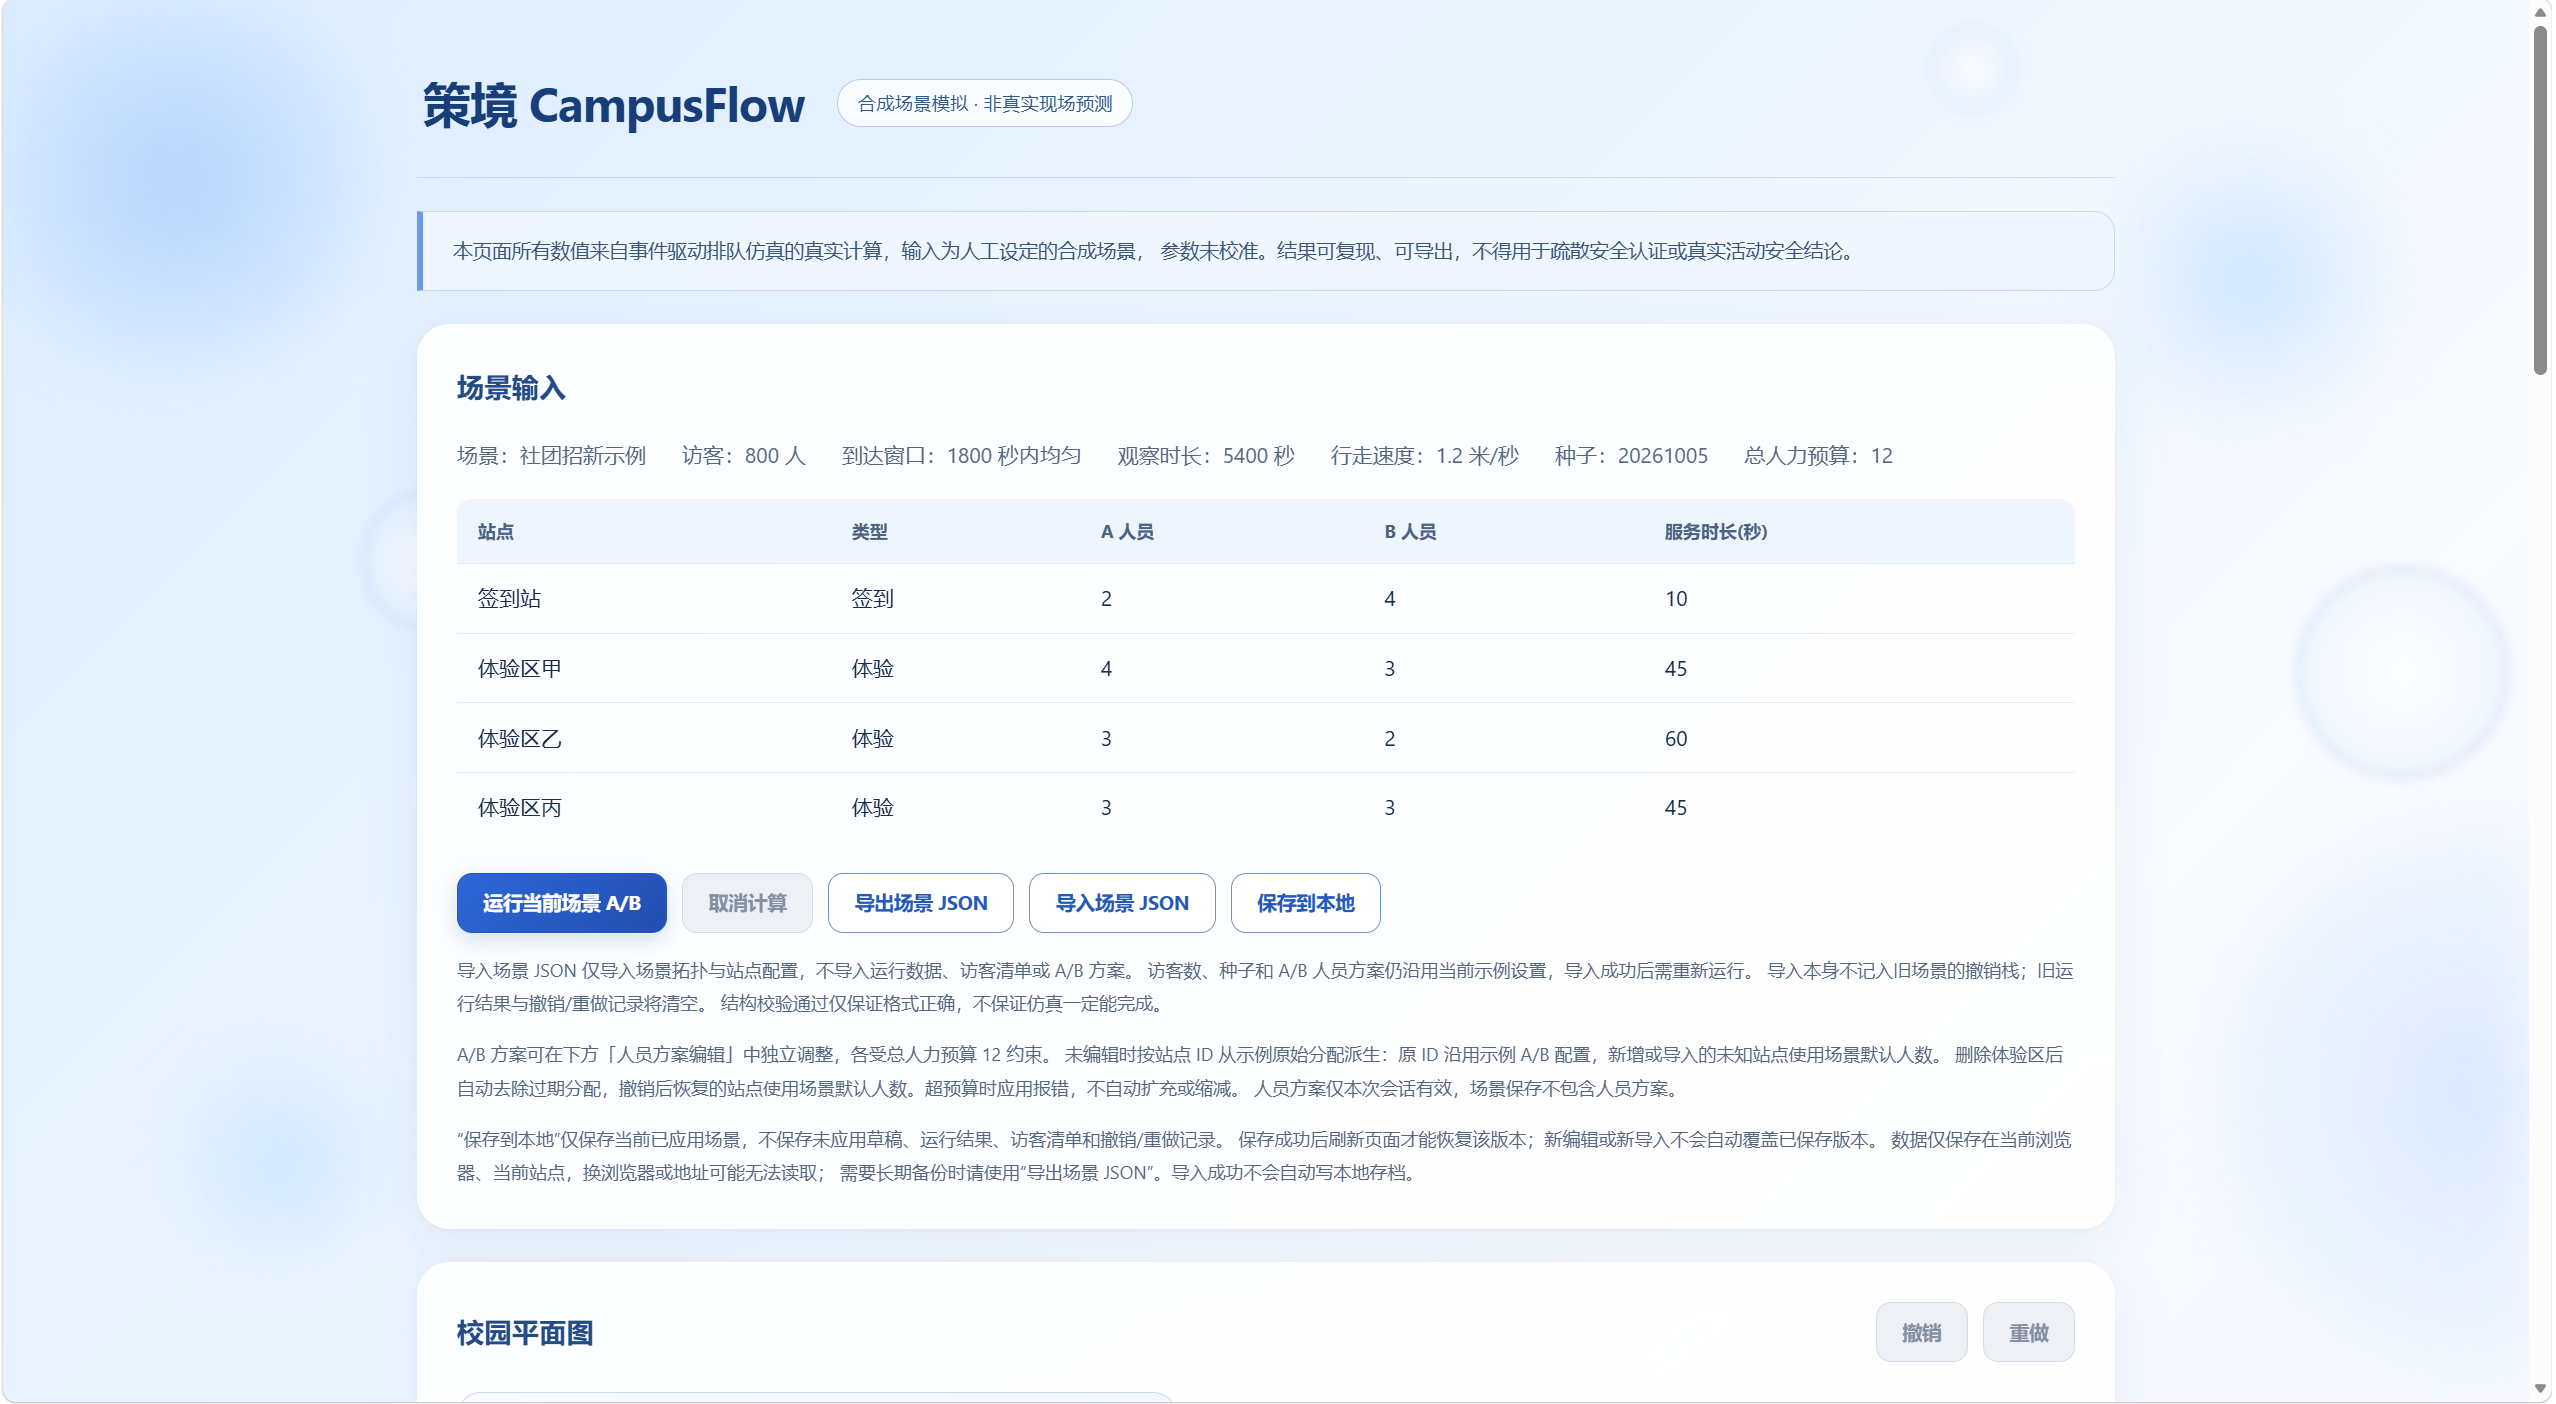
图 1:项目实际运行首页。界面同时展示场景参数和模型边界,避免将合成仿真误读为真实现场预测。
二、我怎样与华为云码道协作开发
2.1 先写约束,再让 Agent 开始实现
项目没有从一句"帮我做一个校园仿真网站"直接进入整站生成。
起步时,我先整理启动方案、演示与验收说明、项目隔离约定,再交给码道确认仓库、理解目标并拆分任务。第一轮先检查项目和落地方案文档,后续才进入计算核心与页面实现。
任务书里除了功能,还会明确这些约束:
- 本轮对应哪个分支、以哪个提交作为基线。
- 可以修改哪些文件,哪些模块暂时不要动。
- 什么算完成,需要提供哪些测试与构建输出。
- 哪些属于自动化测试,哪些仍需要浏览器实际操作。
- 开发完成后先交付材料审查,不自动提交、推送或合并。
这样的拆分,让每一轮工作都有可以核对的输入和输出,也避免一个局部需求带来过多无关修改。
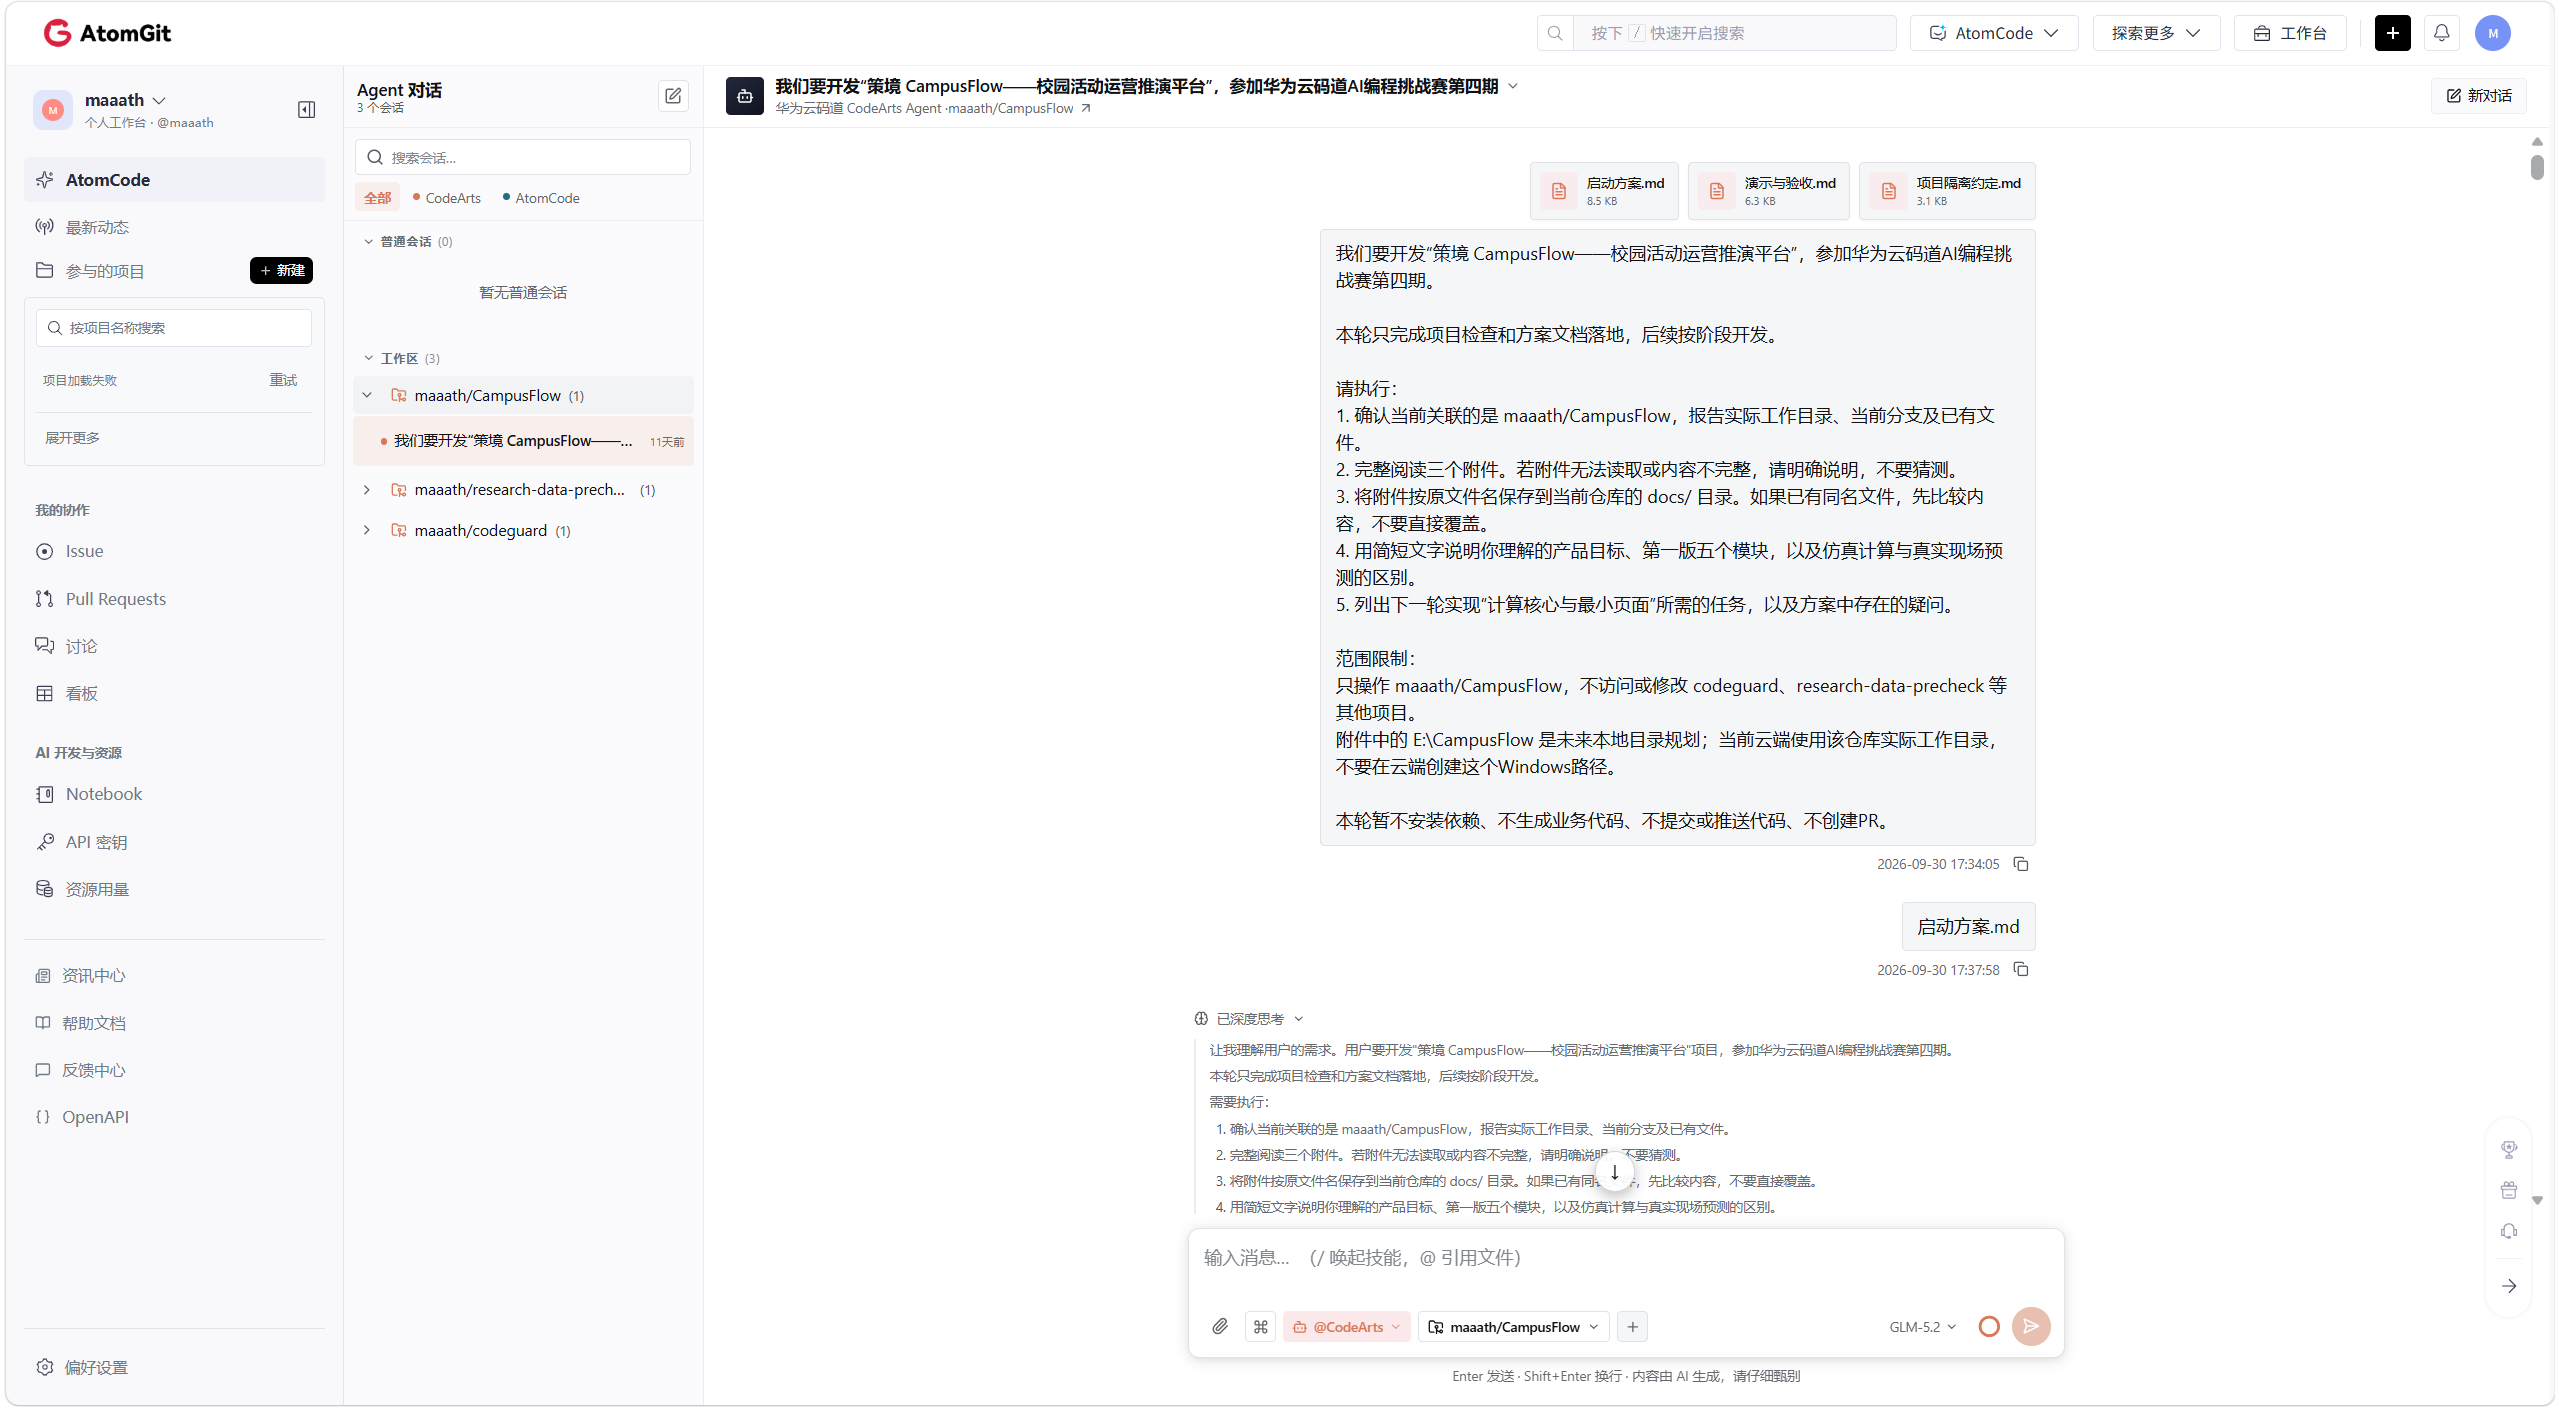
图 2:项目启动阶段的真实对话。截图保留了 AtomGit 账号 maaath、CampusFlow 项目与华为云码道 CodeArts Agent 标识。
2.2 把"结果可比较"写成具体规则
仿真工具最怕的情况,是画面看起来合理,但两次运行实际上并没有使用同一组输入。
因此,在计算核心阶段,我把访客总量、到达窗口、随机数生成、路径选择和同时间事件顺序都写进了约定。例如,示例场景使用固定种子生成访客清单,A/B 两个方案共享同一清单,而不是各自重新抽取一批访客。
这意味着,当 A/B 结果出现差异时,我们可以在固定场景和同一批访客的条件下,分析人员分配变化的影响,而不必先猜测是不是随机输入不同造成的。
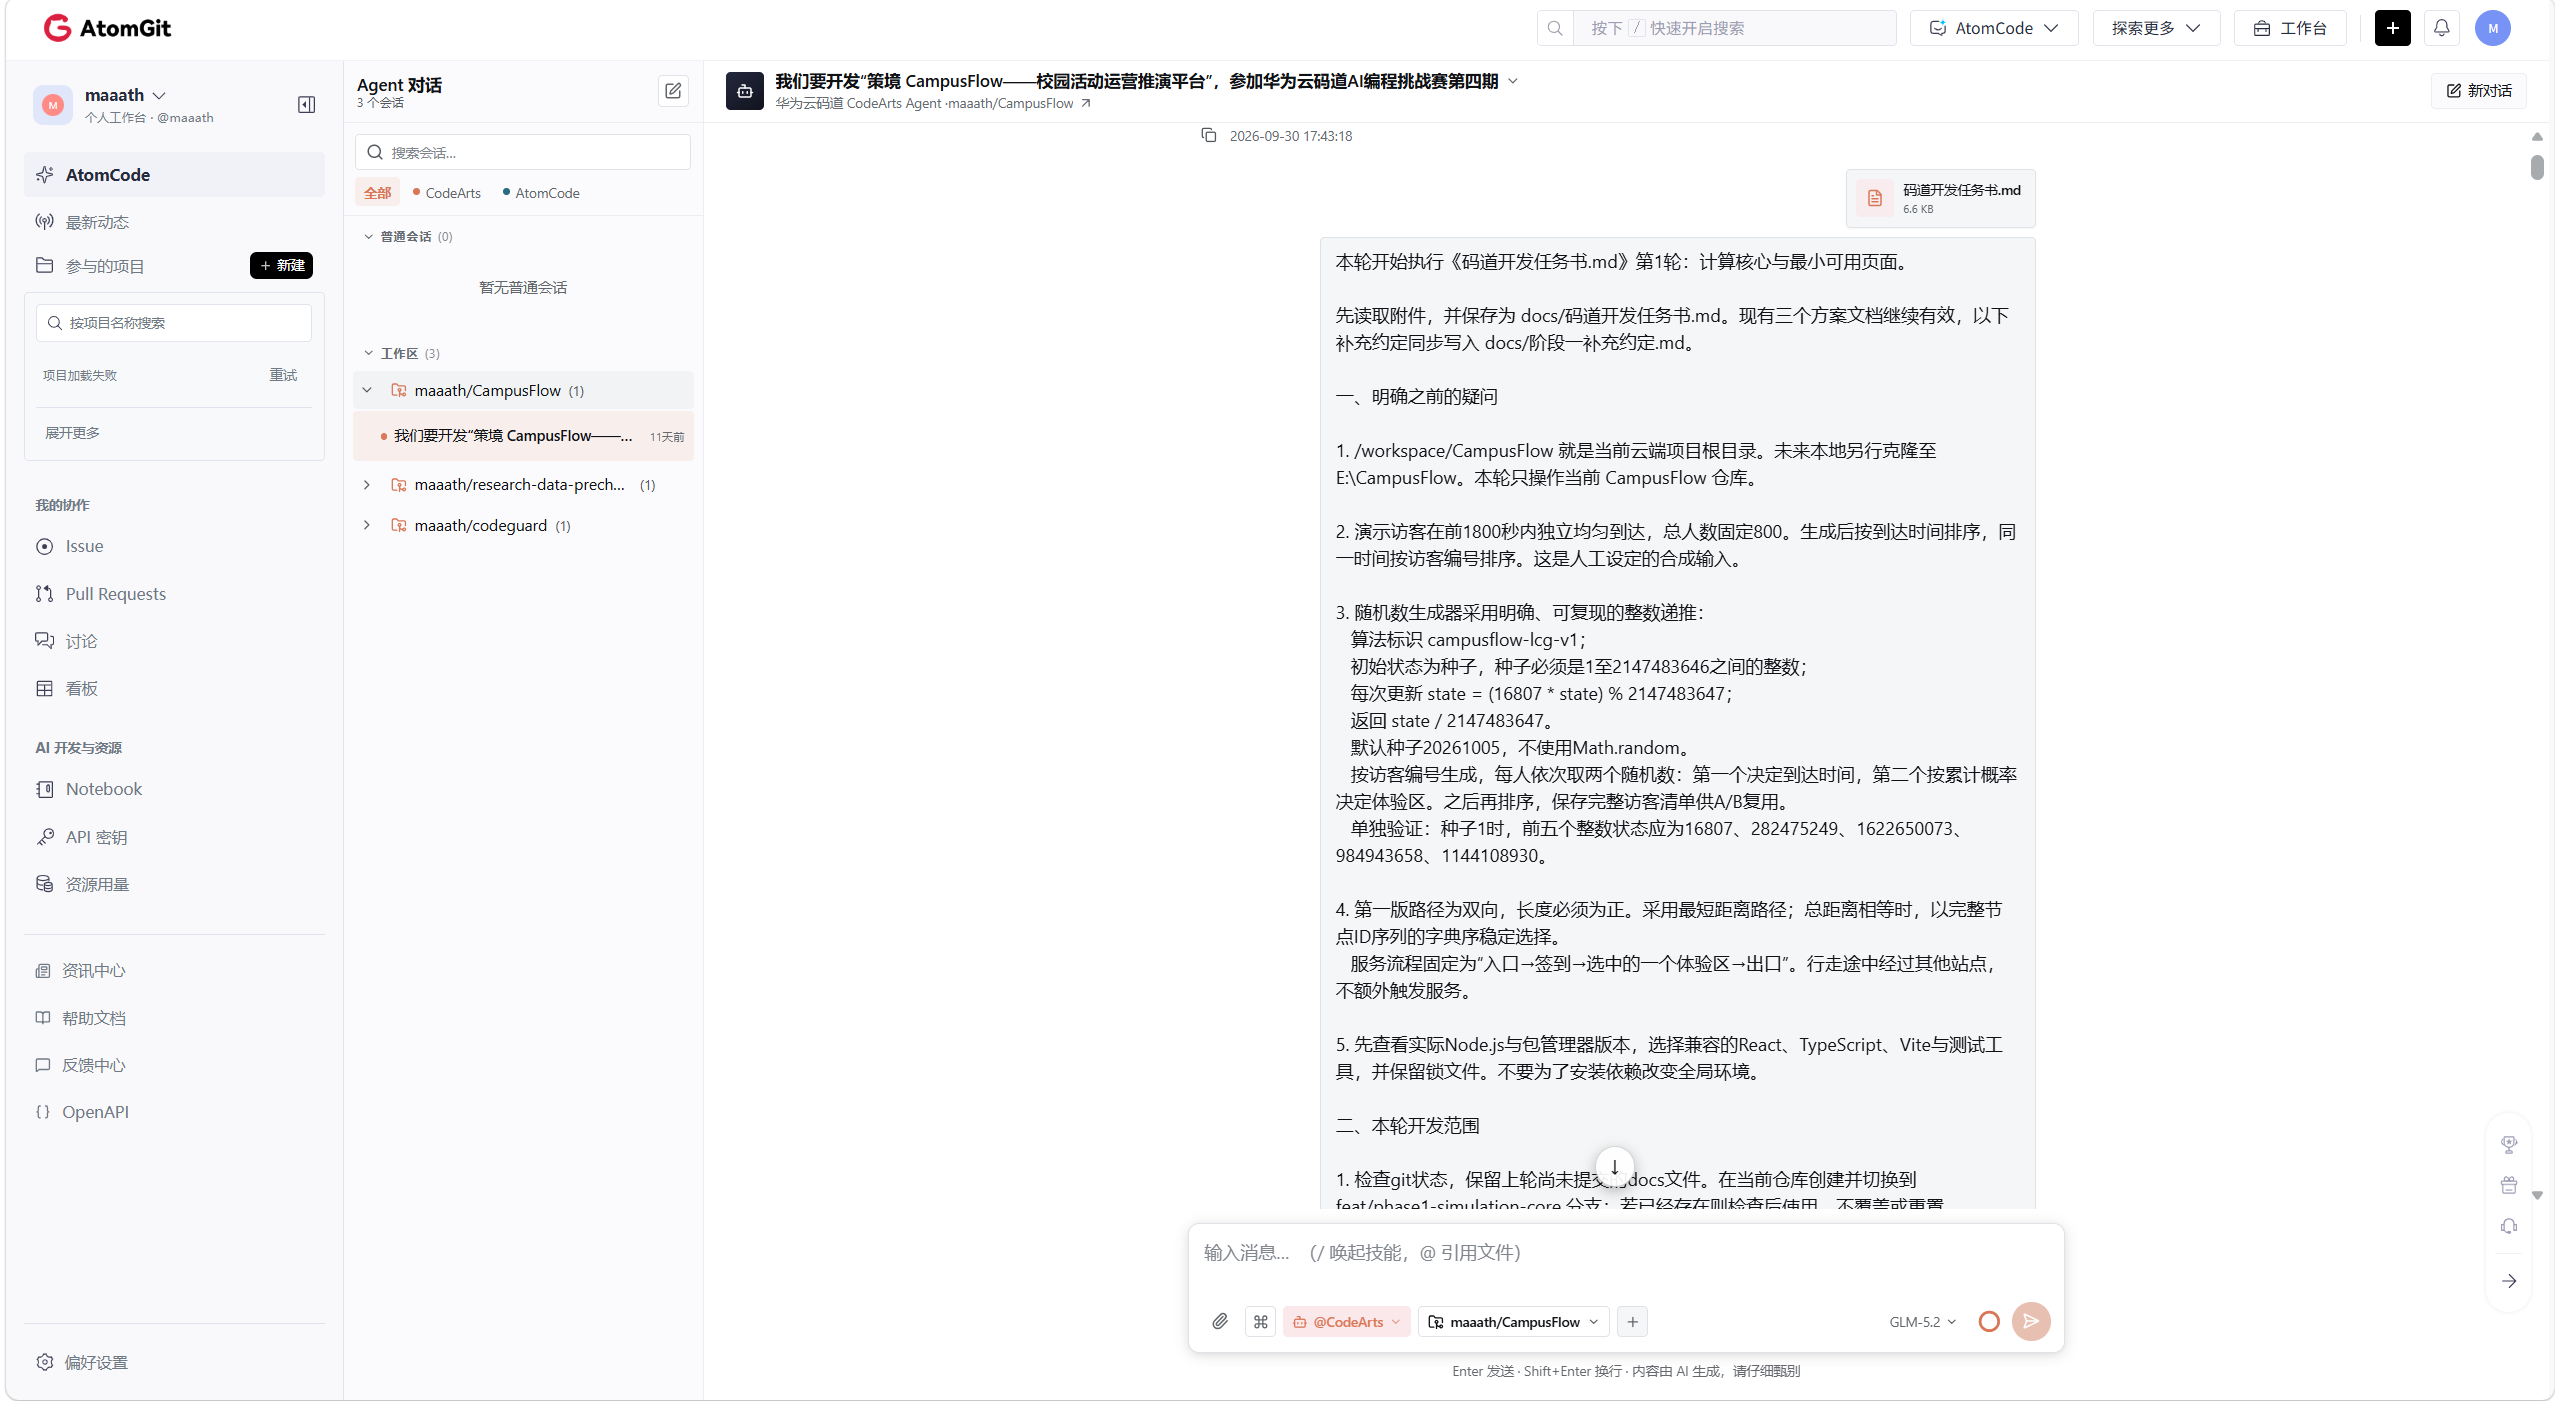
图 3:与码道约定仿真输入和确定性规则。技术要求先于页面效果,目的是让后面的比较有共同基线。
2.3 生成之后,还要经历审查、修正与复验
实际协作过程中,码道承担了分阶段代码实现、测试补充和修正工作;我负责需求约束、材料核对、页面操作与验收,并结合其他辅助工具进行独立检查。
这不是一次提示词就完成的项目。计算核心、场景编辑、Worker 后台计算、结果回放和人员方案编辑,都是逐步推进的。对于审查中发现的问题,我会把复现条件和期望行为写清楚,再要求定点修改。
对我来说,AI 编程的价值不是省去所有判断,而是让我能够把更多精力放在问题定义和验证上,同时更快地落实实现与回归测试。
三、当前版本可以做什么
3.1 编辑场景,而不是只能运行固定示例
校园平面图用节点和连线表达活动流程。选择一个节点后,可以查看其类型与 ID,并编辑名称、坐标等参数;签到站和体验区还支持编辑服务时长。
场景编辑采用独立草稿。只有通过校验并点击应用后,修改才进入正式场景;未应用草稿不会悄悄改变运行输入。
页面还提供节点拖动、撤销与重做。历史记录保存的是成功应用的场景修改,最多保留 50 步,而不是每次输入框敲字都写入历史。
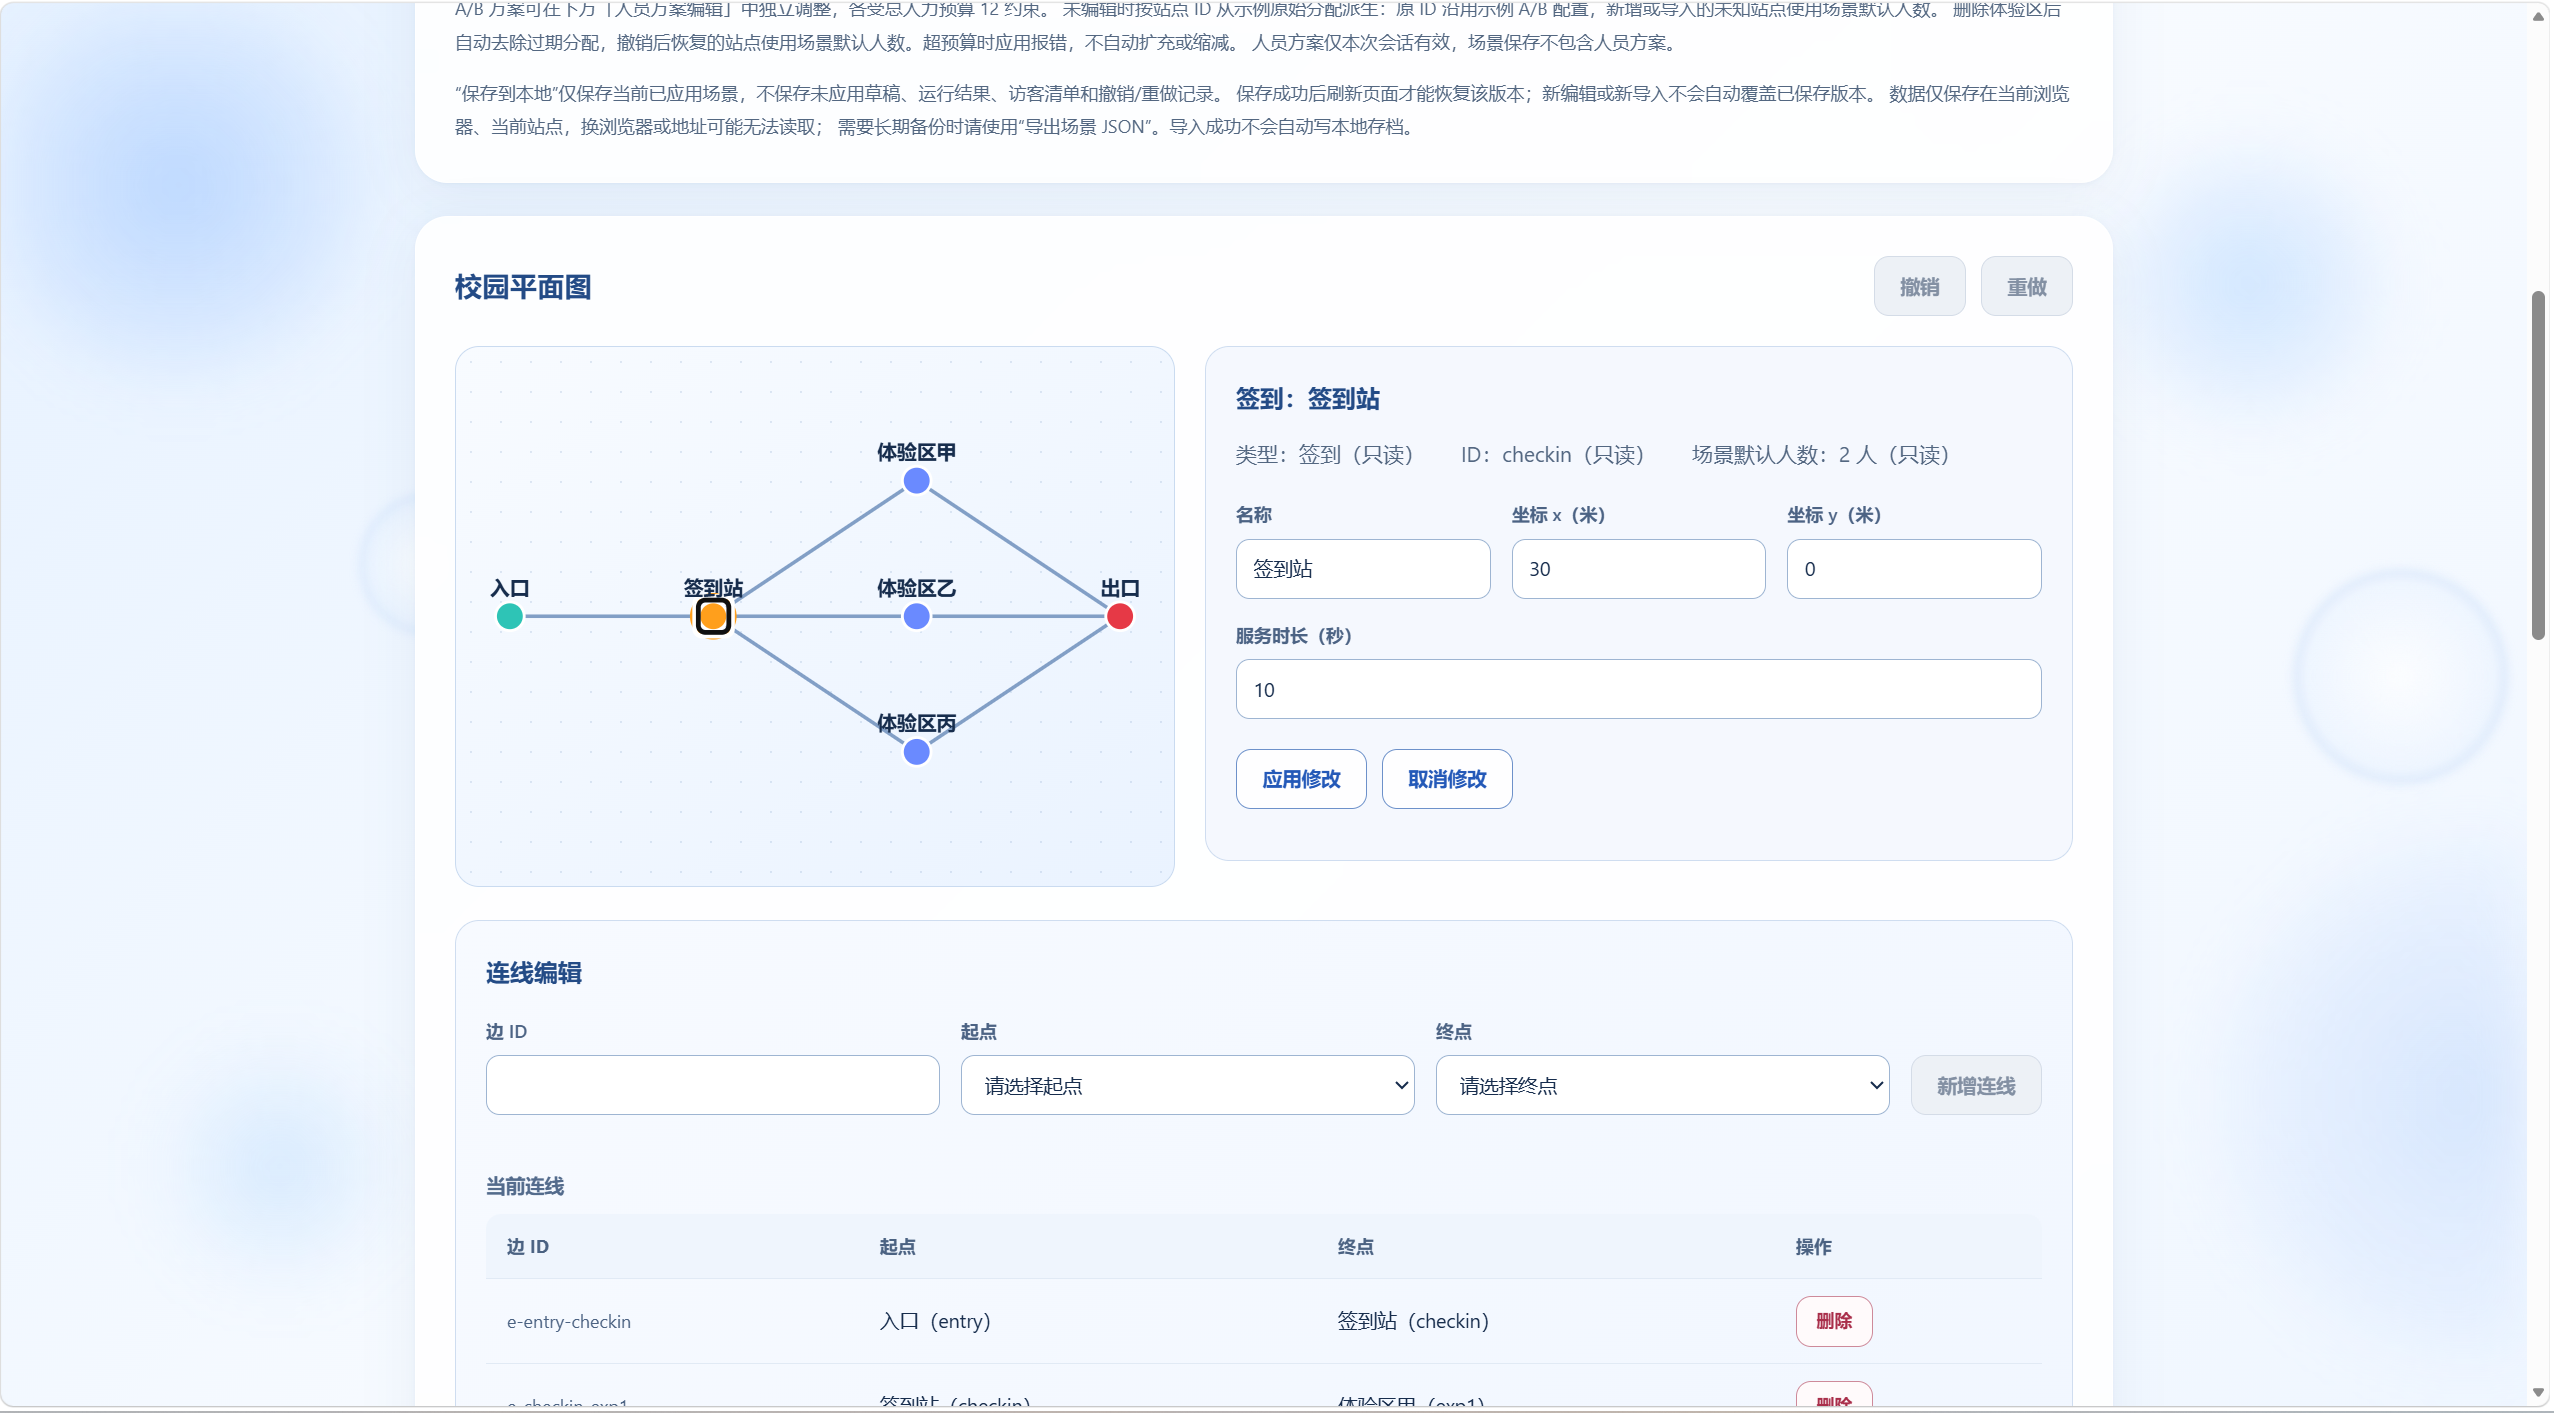
图 4:选中签到站后,右侧展示对应参数。地图和编辑面板使用同一个场景状态。
连线编辑可以选择起点和终点,增加或删除路径。这里的路径是双向的,长度由节点的米制坐标决定。删除连线可能造成站点不可达,因此"结构编辑成功"不等于"当前场景一定能够完成仿真"。
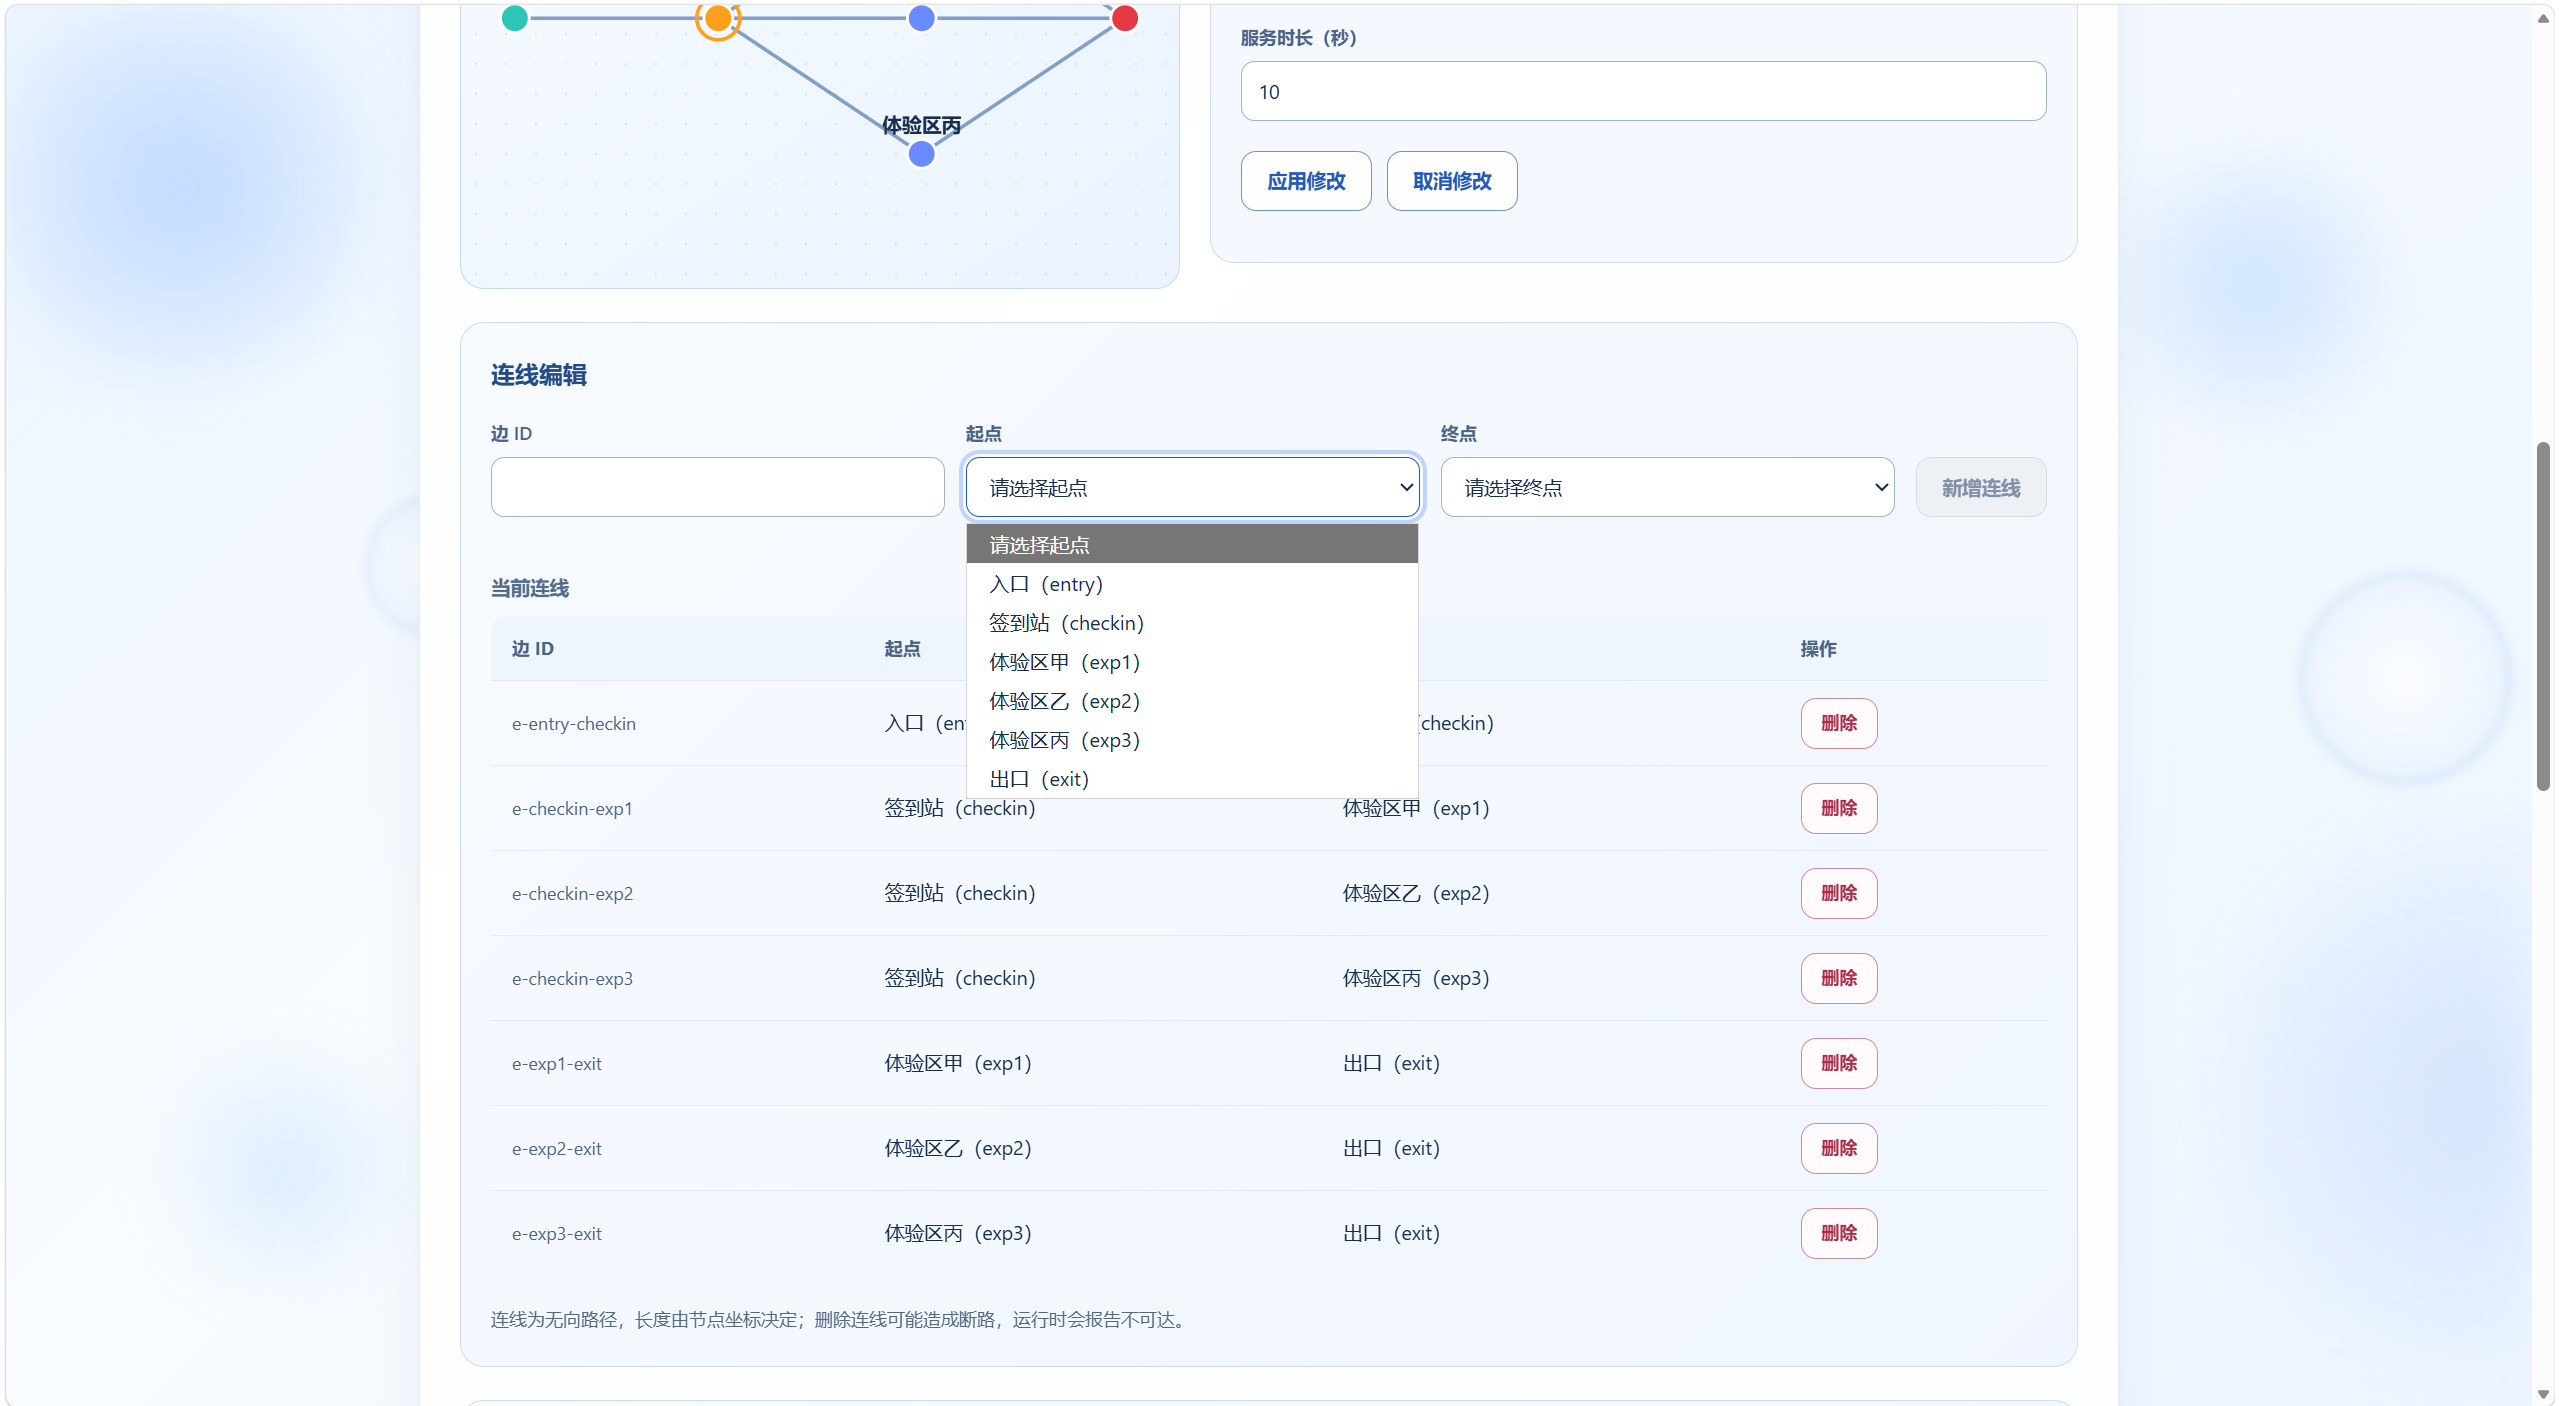
图 5:连线编辑界面。节点名称与 ID 一起展示,便于区分场景中的不同位置。
体验区管理允许新增或删除体验区,并维护其默认服务人数、服务时长和选择概率。新增体验区不会自动接上路径,需要继续配置连线;删除体验区则需要同步处理关联数据,不能只从地图上移除一个圆点。
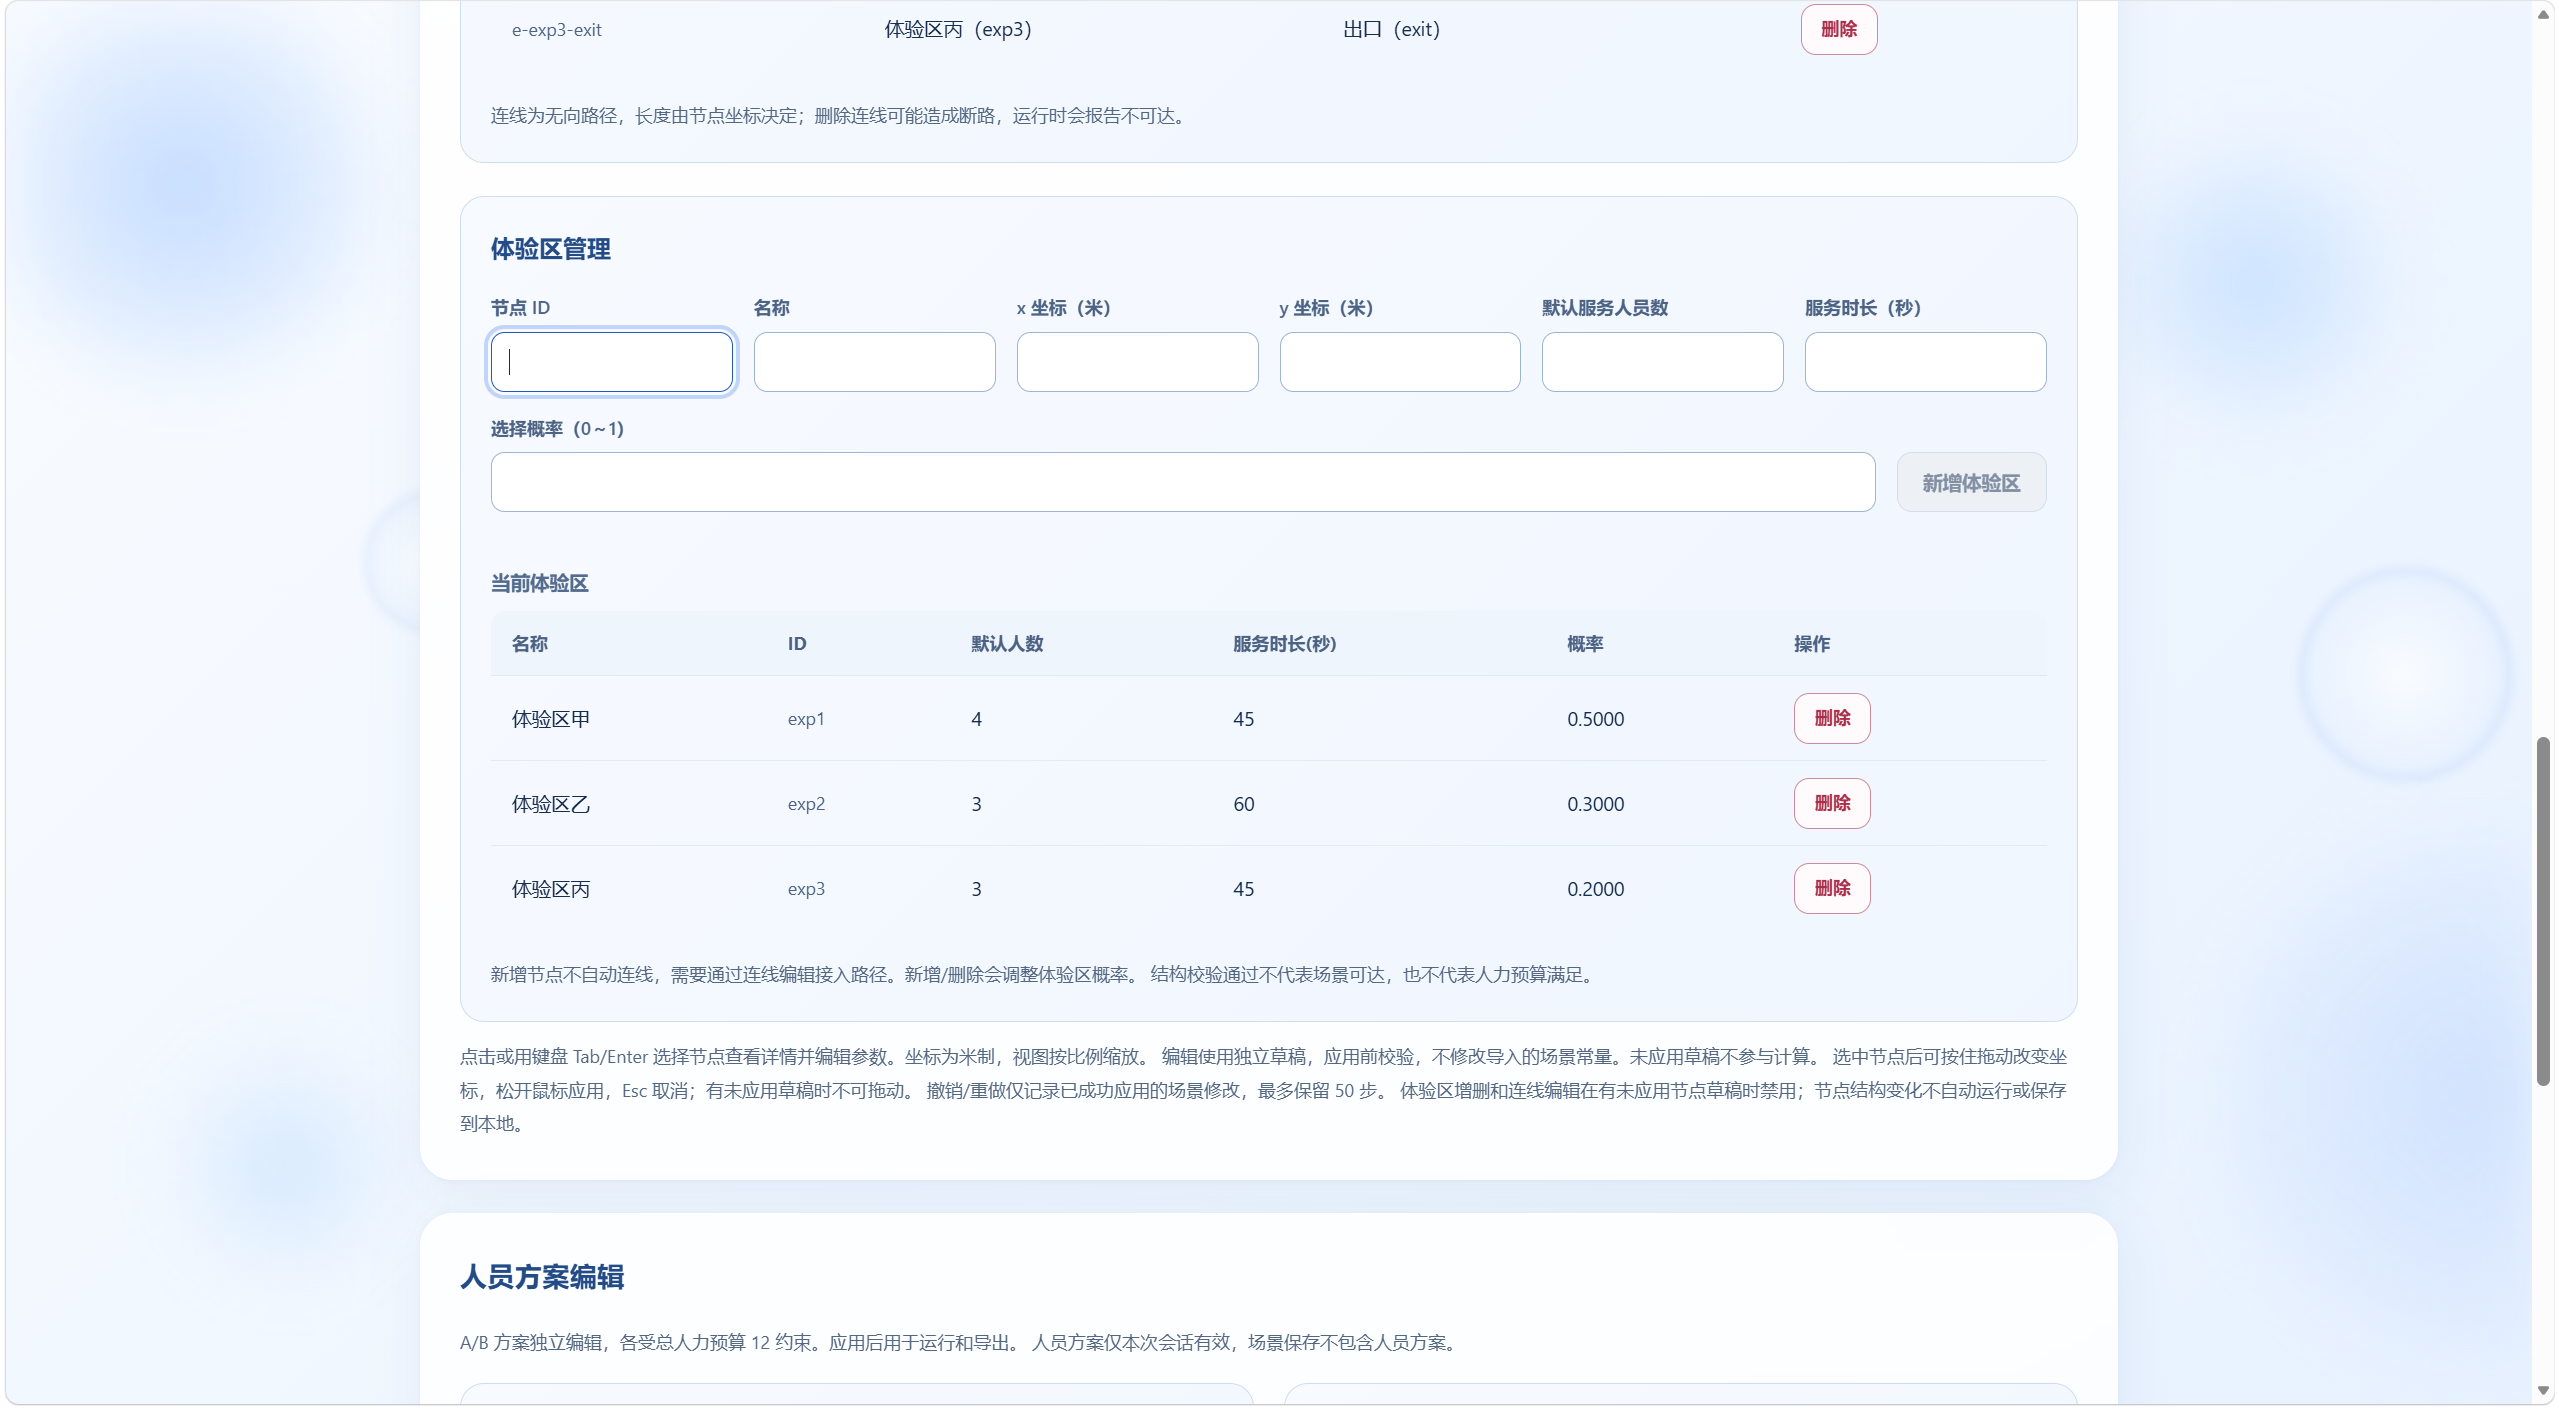
图 6:体验区配置界面。展示的是当前功能入口和配置状态,不把一张界面截图等同于所有增删场景均已完成验收。
3.2 独立编辑 A/B 人员方案
人员方案编辑是当前版本的重要补充。
同一个场景下,A/B 两个方案各自拥有独立的已应用配置和编辑草稿,并分别受到总人力预算约束。用户可以先调整草稿,再决定应用或取消,不必每修改一个数字就立即重算。
这里刻意区分了三种状态:
| 状态 | 含义 | 对运行的影响 |
|---|---|---|
| 已应用方案 | 当前正式生效的人数配置 | 作为仿真输入 |
| 编辑草稿 | 输入框中的候选配置 | 未应用前不影响运行 |
| 校验错误 | 草稿不满足人数或预算要求 | 拒绝应用,保留原方案 |
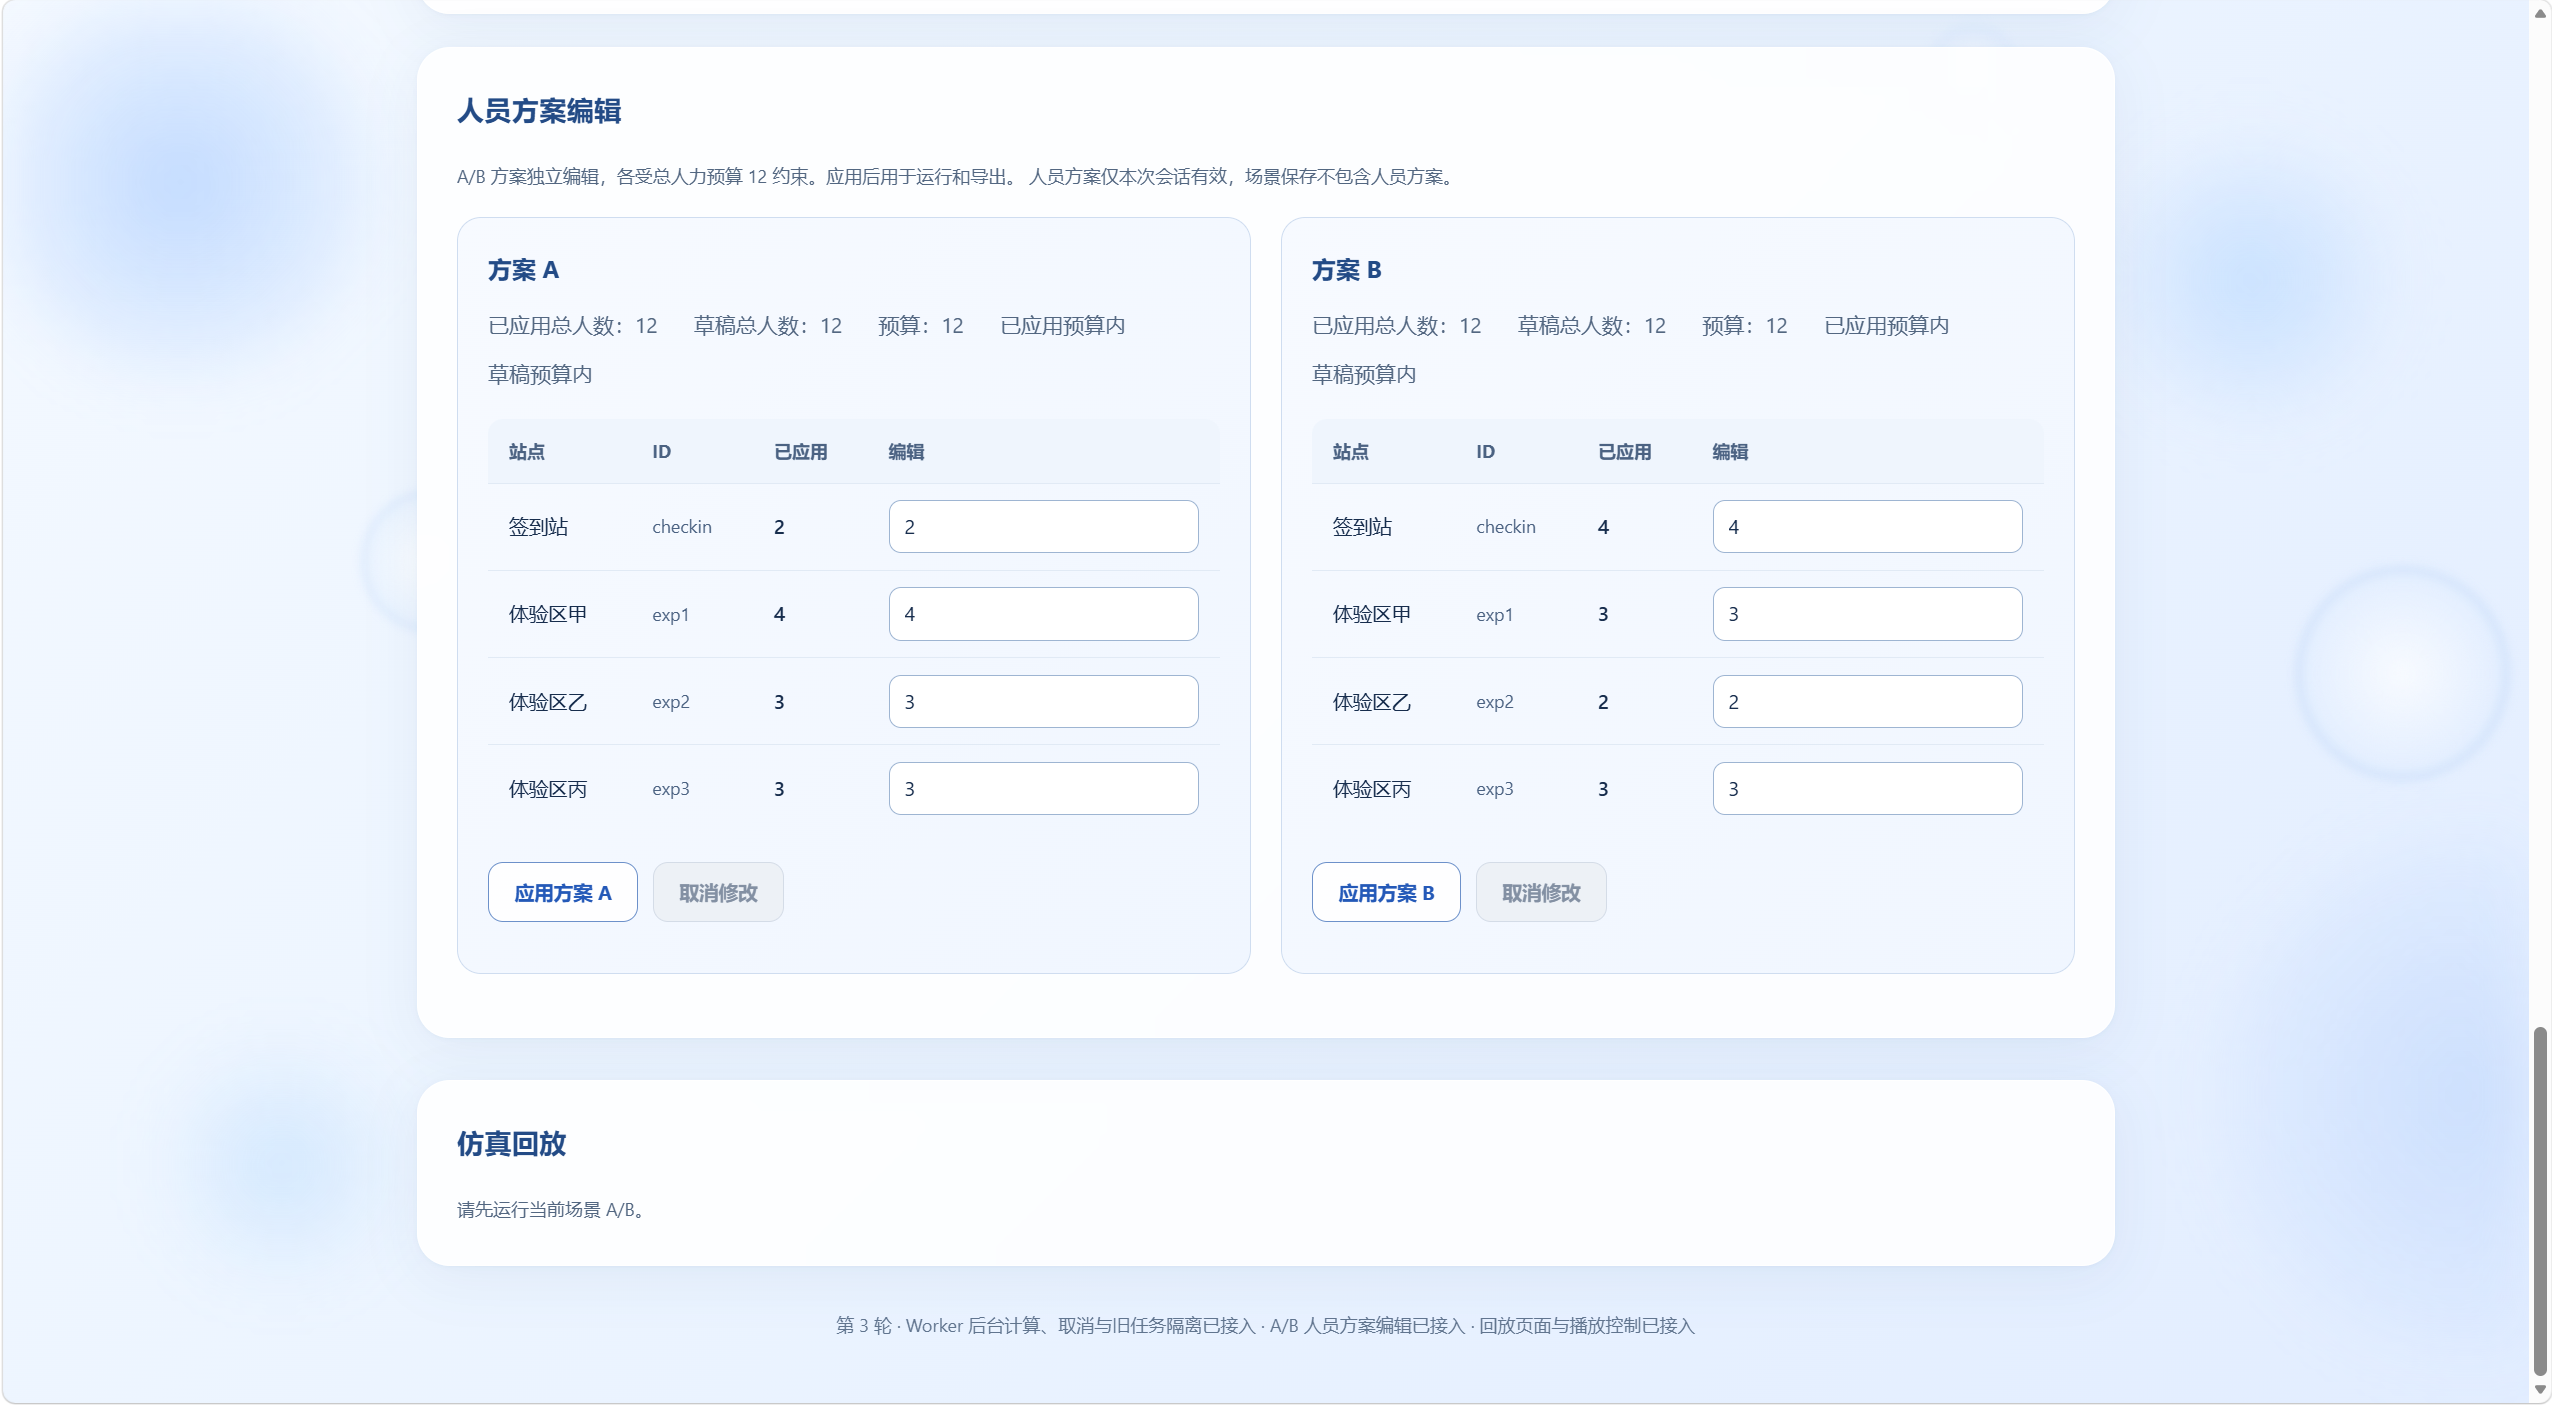
图 7:A/B 人员方案独立编辑。默认配置下,两套方案的总人数都是 12,但各站点分配不同。
实际操作中,我将方案 A 的签到人数从 2 改成 3,其他站点保持不变。草稿总人数因此变为 13,超过预算 12。点击应用后,页面显示超预算错误,而已应用的签到人数仍然是 2;方案 B 也仍保持原配置。
这个细节很重要:系统没有偷偷扩充预算,也没有自动从其他站点减掉一个人,而是把决策权交还给用户。
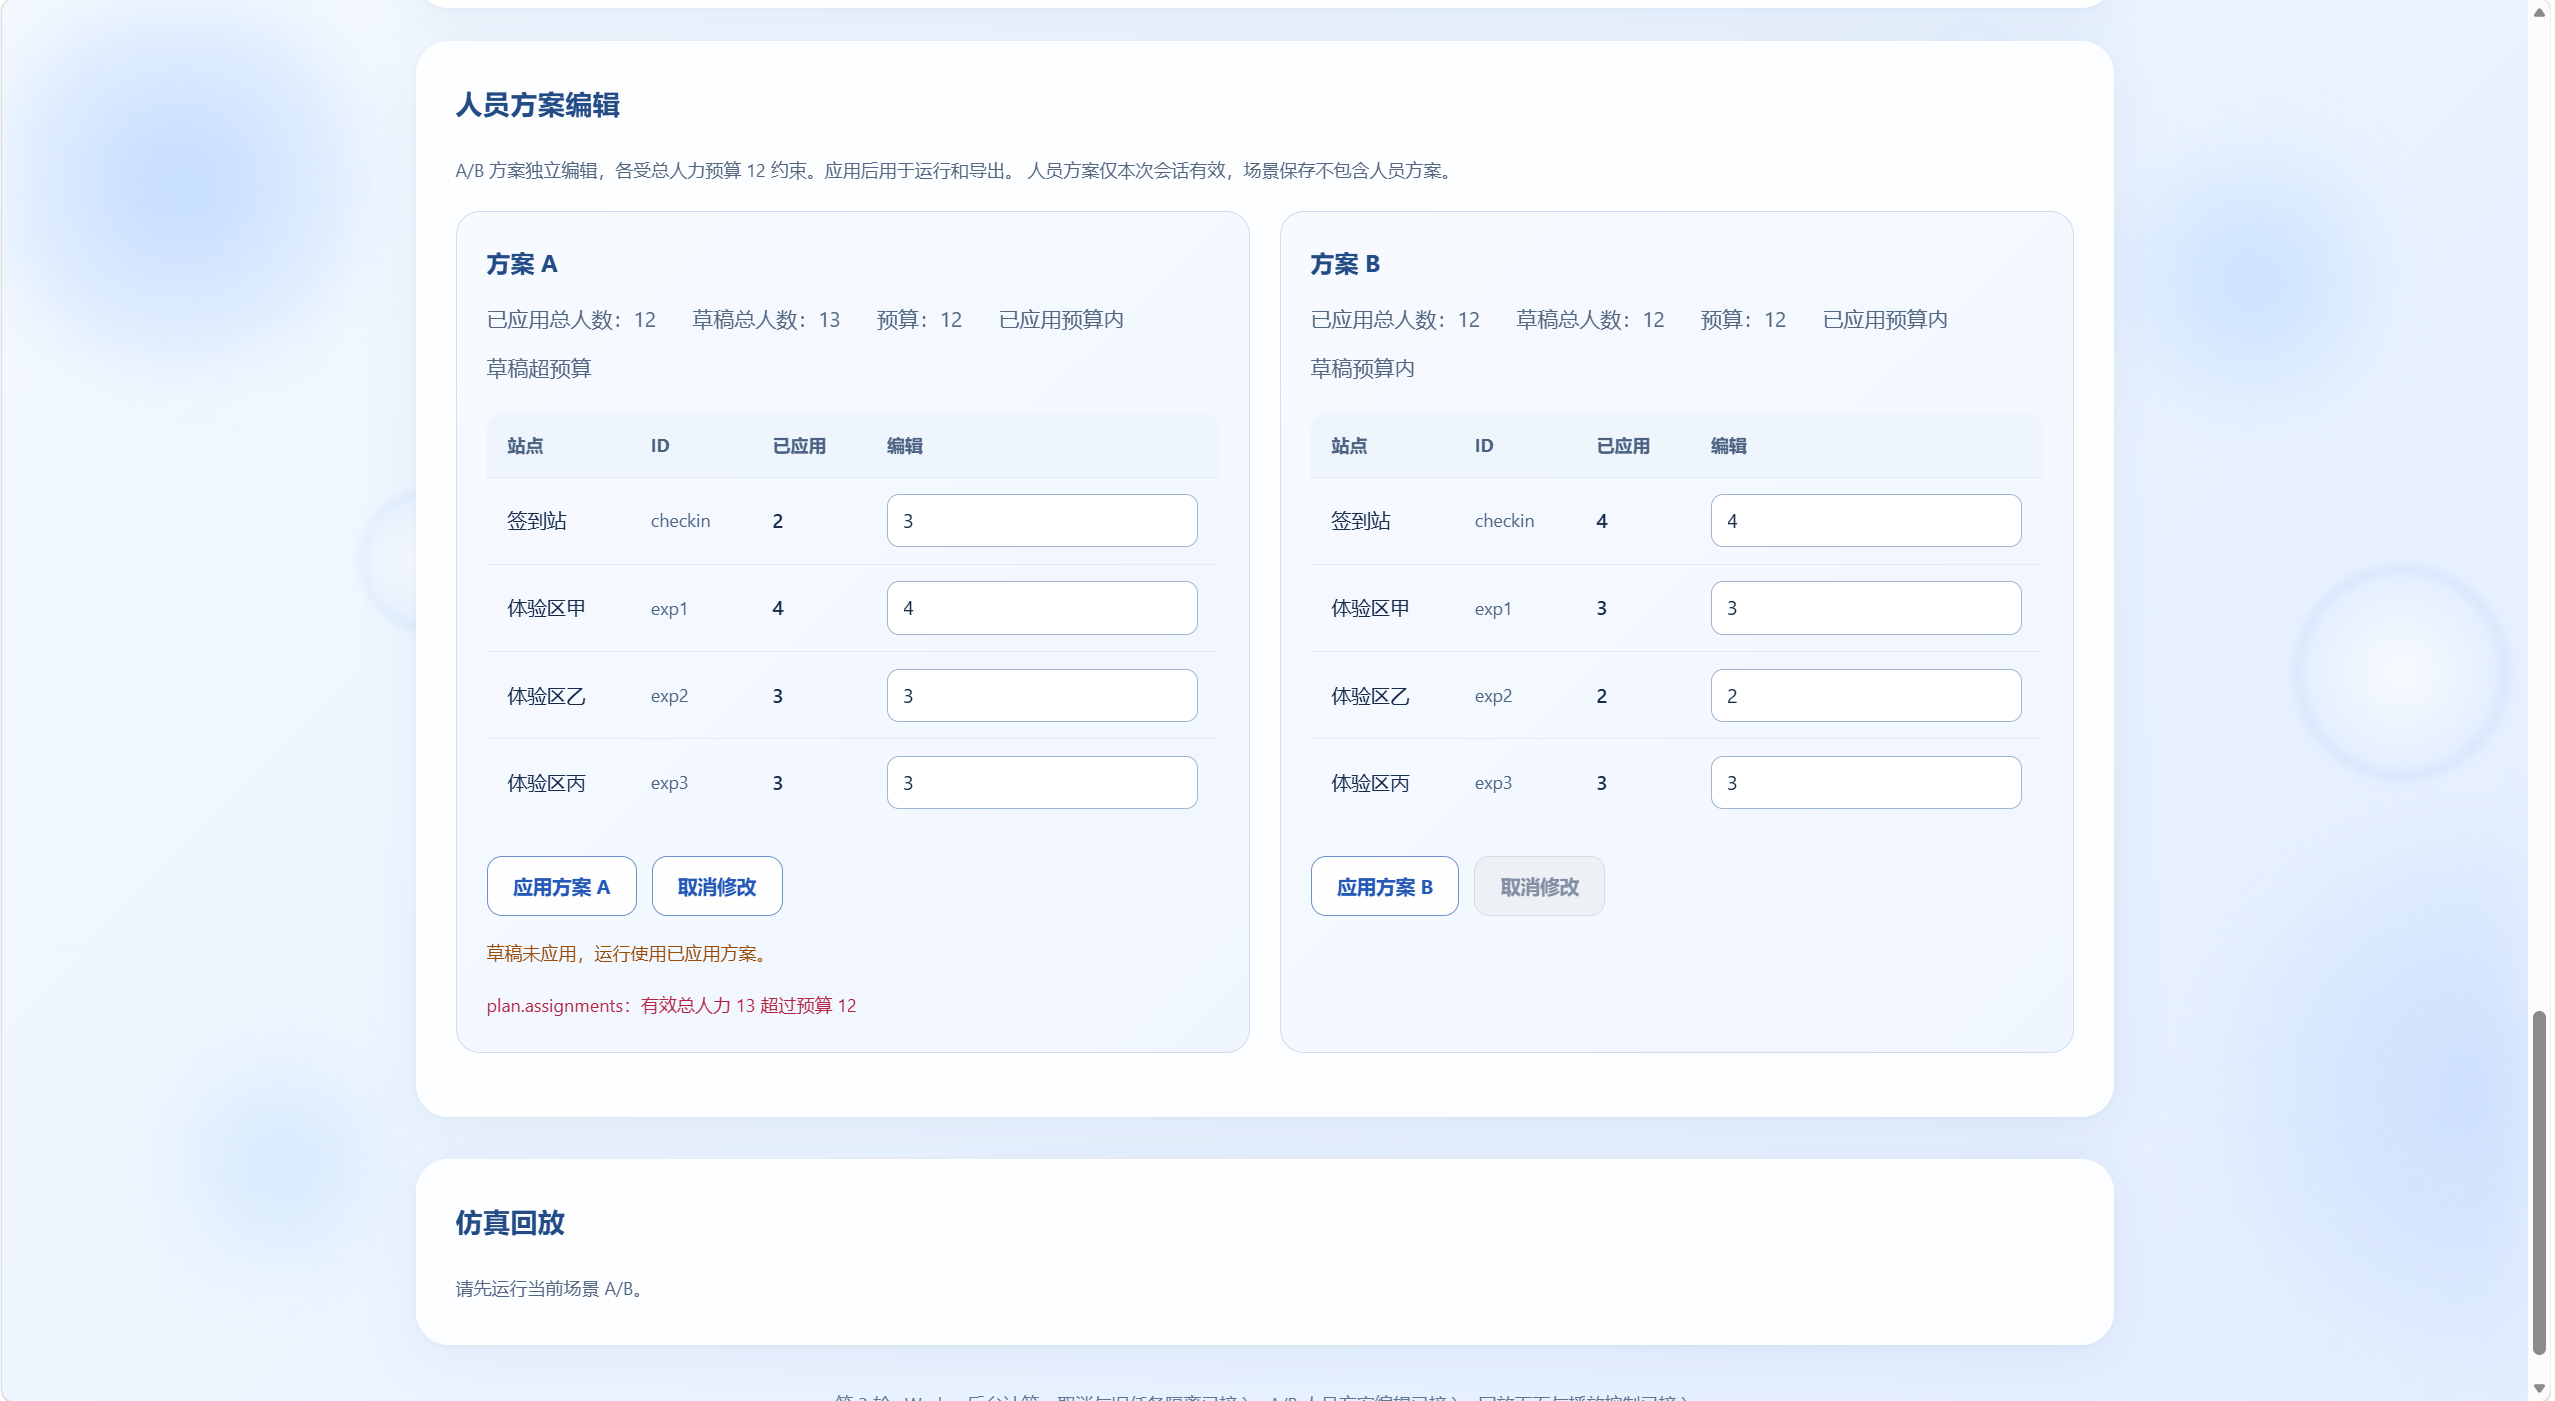
图 8:超预算保护的实际运行截图。草稿总人数为 13,已应用总人数仍为 12,错误输入没有覆盖原方案。
3.3 场景保存与导出:明确"保存了什么"
项目支持场景 JSON 导入、导出,以及浏览器本地保存。
这里没有把"保存到本地"包装成完整项目存档:当前保存的是已应用场景,不包含人员方案、未应用草稿、运行结果、访客清单和撤销/重做历史。人员方案只在当前会话中有效。
场景 JSON 与运行结果 JSON 也不是同一种文件:前者描述场景拓扑和站点配置,后者记录一次运行的数据。导入场景不会恢复某次仿真的全部状态。
本地保存依赖当前浏览器和来源地址,换浏览器、主机名或端口可能读不到原存档。因此,需要长期备份时,应导出场景 JSON,而不是只依赖浏览器存储。
四、技术实现:让计算、任务和动画各司其职
项目使用 React、TypeScript 和 Vite 构建界面,使用 Vitest 编写自动化测试。仿真核心采用纯 TypeScript,不依赖 React 渲染或动画帧推进。
从职责上,可以把当前实现理解为以下几层:
| 层次 | 主要职责 |
|---|---|
| 场景与人员方案状态 | 保存已应用数据、草稿、校验结果和编辑历史 |
| 仿真核心 | 处理事件、路径、队列、服务与统计指标 |
| Worker 任务层 | 执行后台计算,处理取消、重跑与旧任务隔离 |
| 回放投影与控制层 | 从已有结果还原指定时刻状态,管理时间轴与播放生命周期 |
| React 页面层 | 接收操作并展示地图、表格、提示和回放 |
4.1 先算出结果,再展示过程
仿真以事件驱动的方式推进,而不是让页面上的小圆点移动一次就更新一次业务统计。
事件按时间、优先级和序号稳定排序;同一时刻,先结束服务并释放人员,再处理新到达。站点使用先进先出的排队规则,最多同时服务的人数由人员配置决定。
路径按最短距离选择;距离相同时,使用确定的节点 ID 序列规则处理并列情况。访客清单使用固定种子生成,A/B 共用同一份输入。
这些设计的目的,是减少与渲染时机、运行偶然性有关的差异,让结果能够在相同条件下复现。
4.2 Worker 的难点不只是"放到后台"
把计算移到 Web Worker,可以将计算任务与界面线程分开。但如果用户连续运行、取消,或者在运行中应用了新的人员方案,还需要回答一个问题:旧任务晚到的消息,是否仍会覆盖新状态?
当前实现同时处理任务身份和版本校验。人员方案实际变化时,递增方案版本并取消旧任务;接收消息时,再检查它是否仍属于当前有效任务。
同时,"编辑草稿"和"应用变化"有不同的后果:
- 只修改草稿,不取消正在执行的计算。
- 成功应用且人数配置确实变化,取消旧任务并清空不再适用的结果。
- 草稿校验失败,原方案继续保留。
- 应用后数值没有实际变化,不因一次点击就无意义地取消任务。
- 运行完成时读取最新会话状态,不用旧快照覆盖用户在等待期间输入的新草稿。
这让输入框、后台任务和结果区之间形成了明确的关系,而不是几个彼此独立的按钮。
4.3 回放修正:取消动画帧之外,还需要让旧回调失效
回放阶段的一次修正很有代表性:只调用 cancelAnimationFrame,不足以完整表达"这一轮播放已经失效"。我们还需要在业务逻辑上拒绝旧回调,避免它修改当前状态或继续安排下一帧。
项目中的 PlaybackRunner 使用 generation 计数器。在停止旧循环时递增版本,回调执行前核对自己捕获的版本。
下面是当前实现中停止循环的代码节选:
ts
private stopLoop(): void {
  this.generation++;
  if (this.rafId !== null) {
    this.scheduler.cancelFrame(this.rafId);
    this.rafId = null;
  }
  this.lastTimestamp = null;
}
对应的帧回调入口还有一道检查:
ts
if (gen !== this.generation) return; // 旧回调零写入、零排队另一个修正点,是将播放控制器内部状态作为时间推进依据。React 负责订阅和展示,不让界面渲染是否及时决定仿真回放时间是否正确累加。
测试中通过可注入调度器构造旧回调迟到等情况,检查暂停、跳转、切换方案和替换结果后,旧回调是否仍能产生影响。
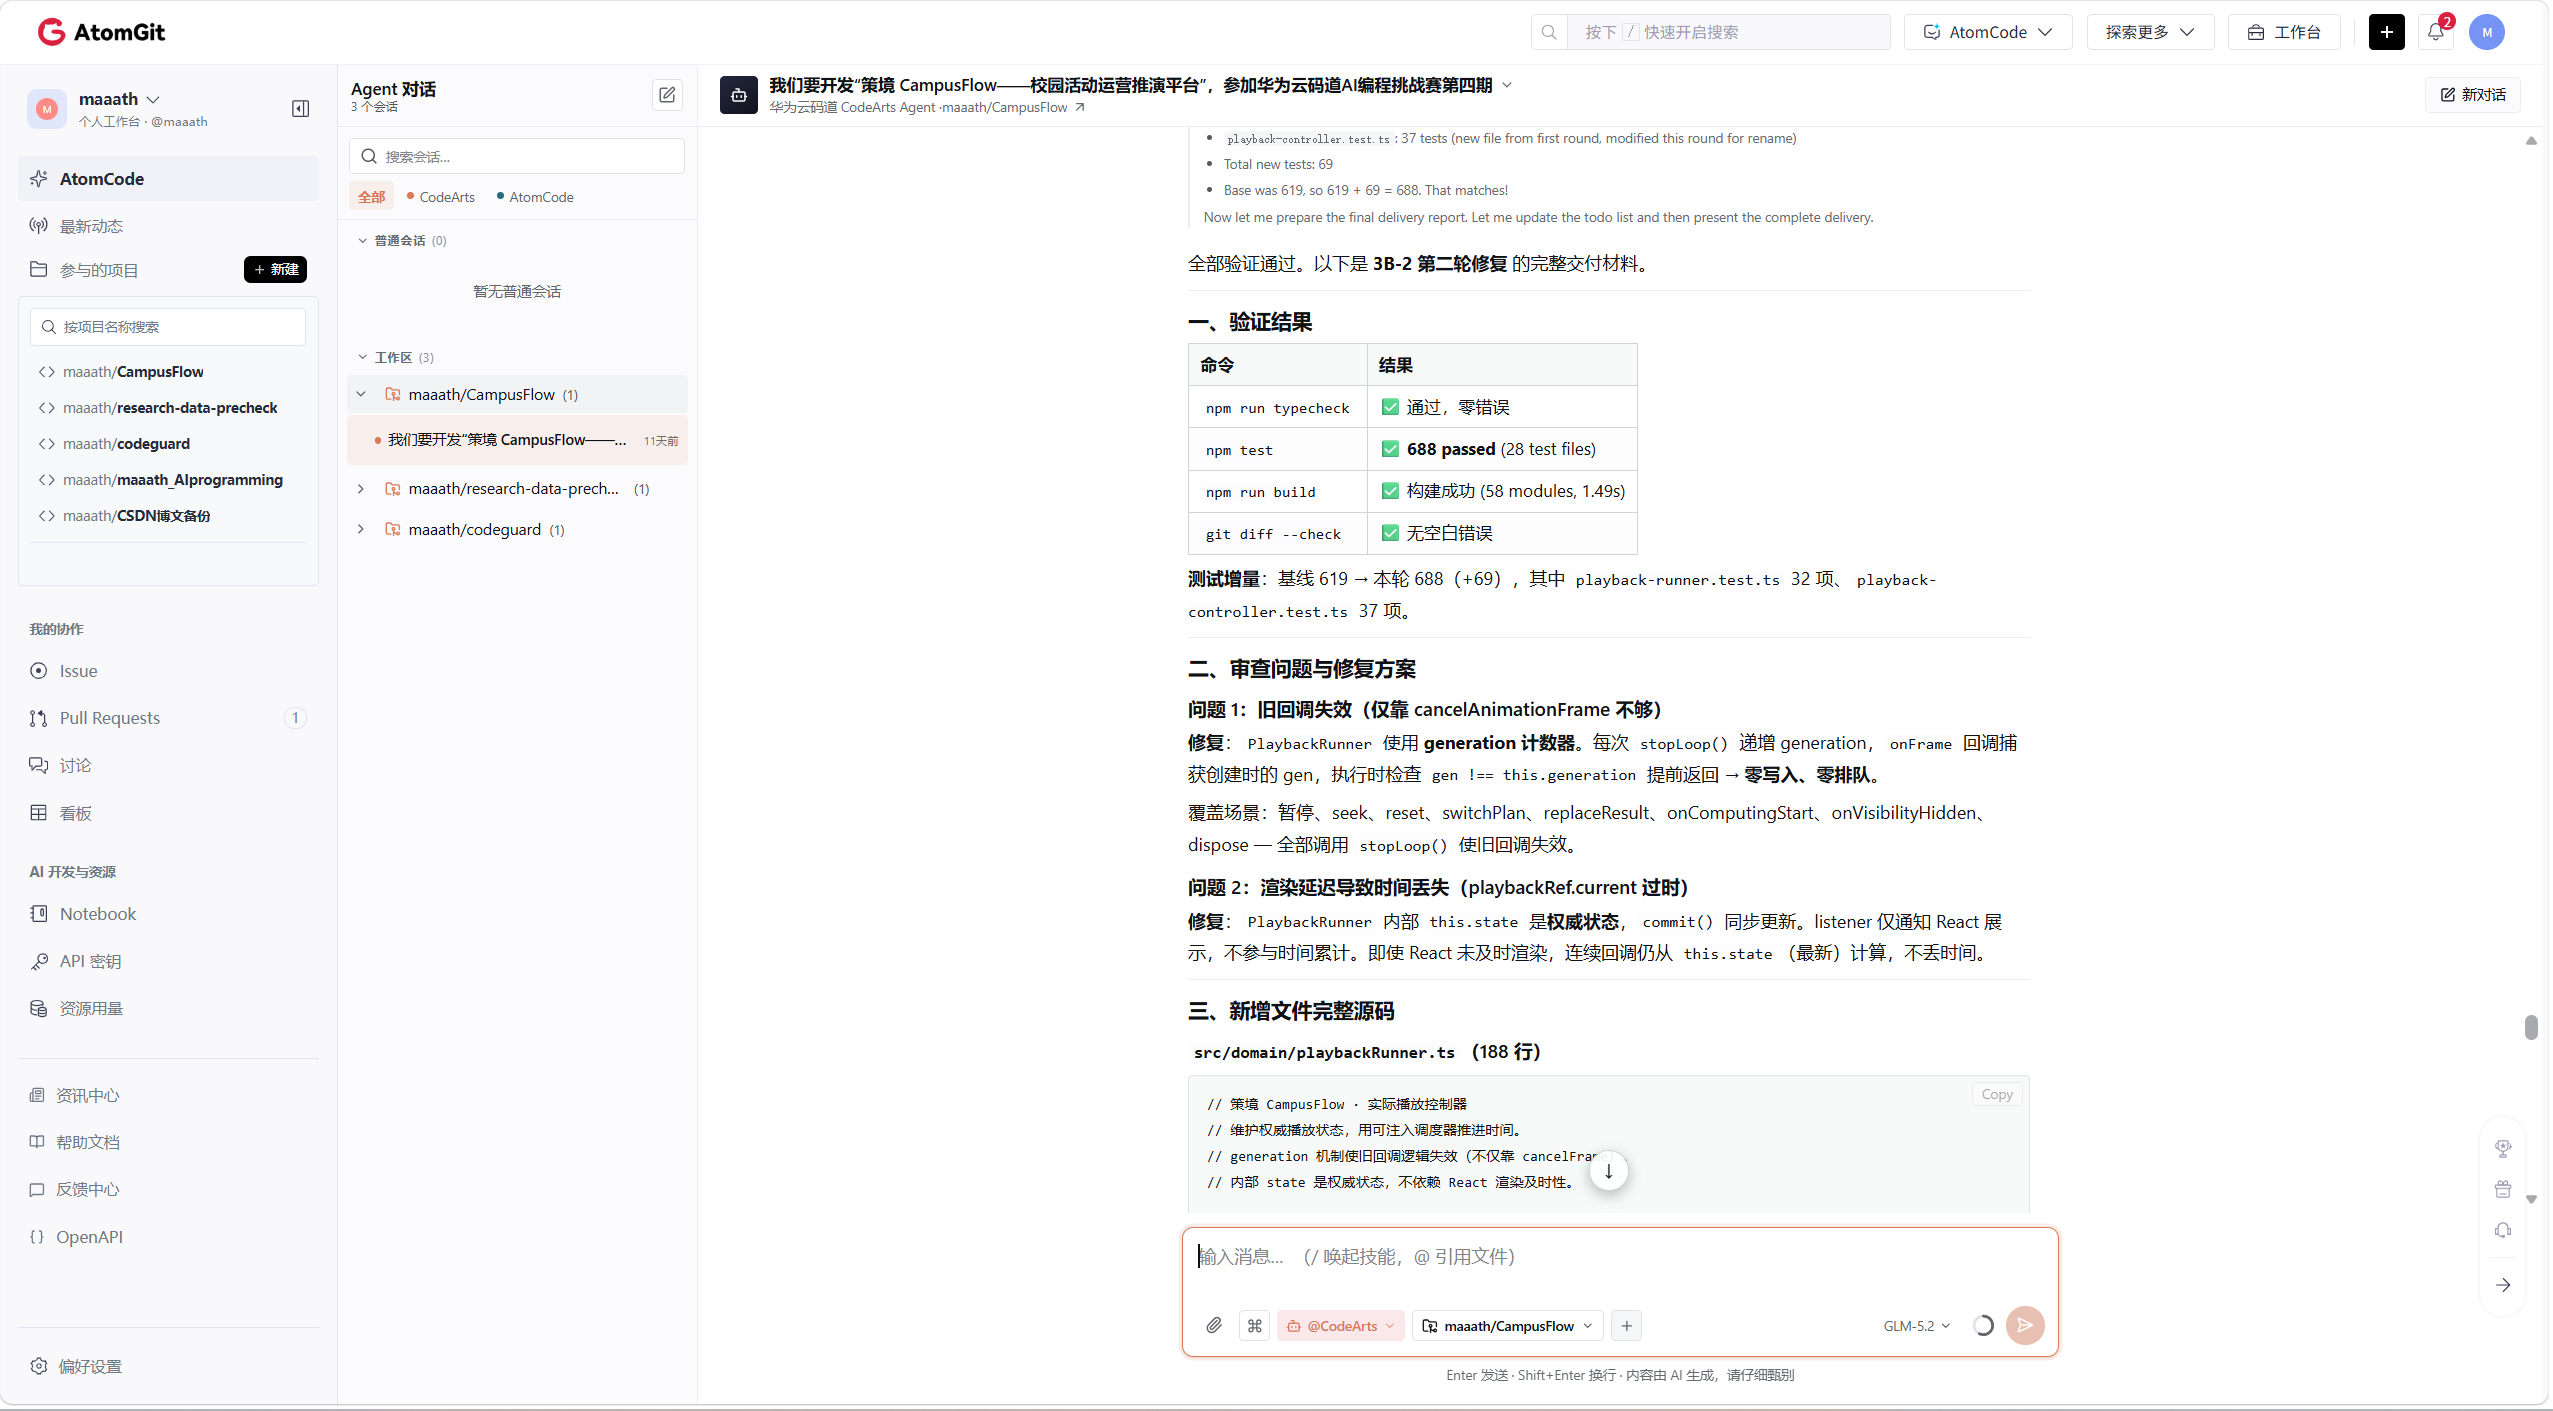
图 9:回放阶段的修正记录。截图中的 688 项测试属于当时的阶段结果,不是后续人员方案编辑版本的最终测试数量。
五、用回放理解过程,而不是只看最后一个数字
统计表适合比较结果,但有些过程更适合通过回放观察:队列从什么时候开始积累?某个站点出现拥堵时,其他站点是什么状态?
当前回放支持方案切换、播放与暂停、倍速、时间轴跳转和回到起点。地图用不同颜色区分行走、排队与服务状态,并展示站点排队人数和服务人数。
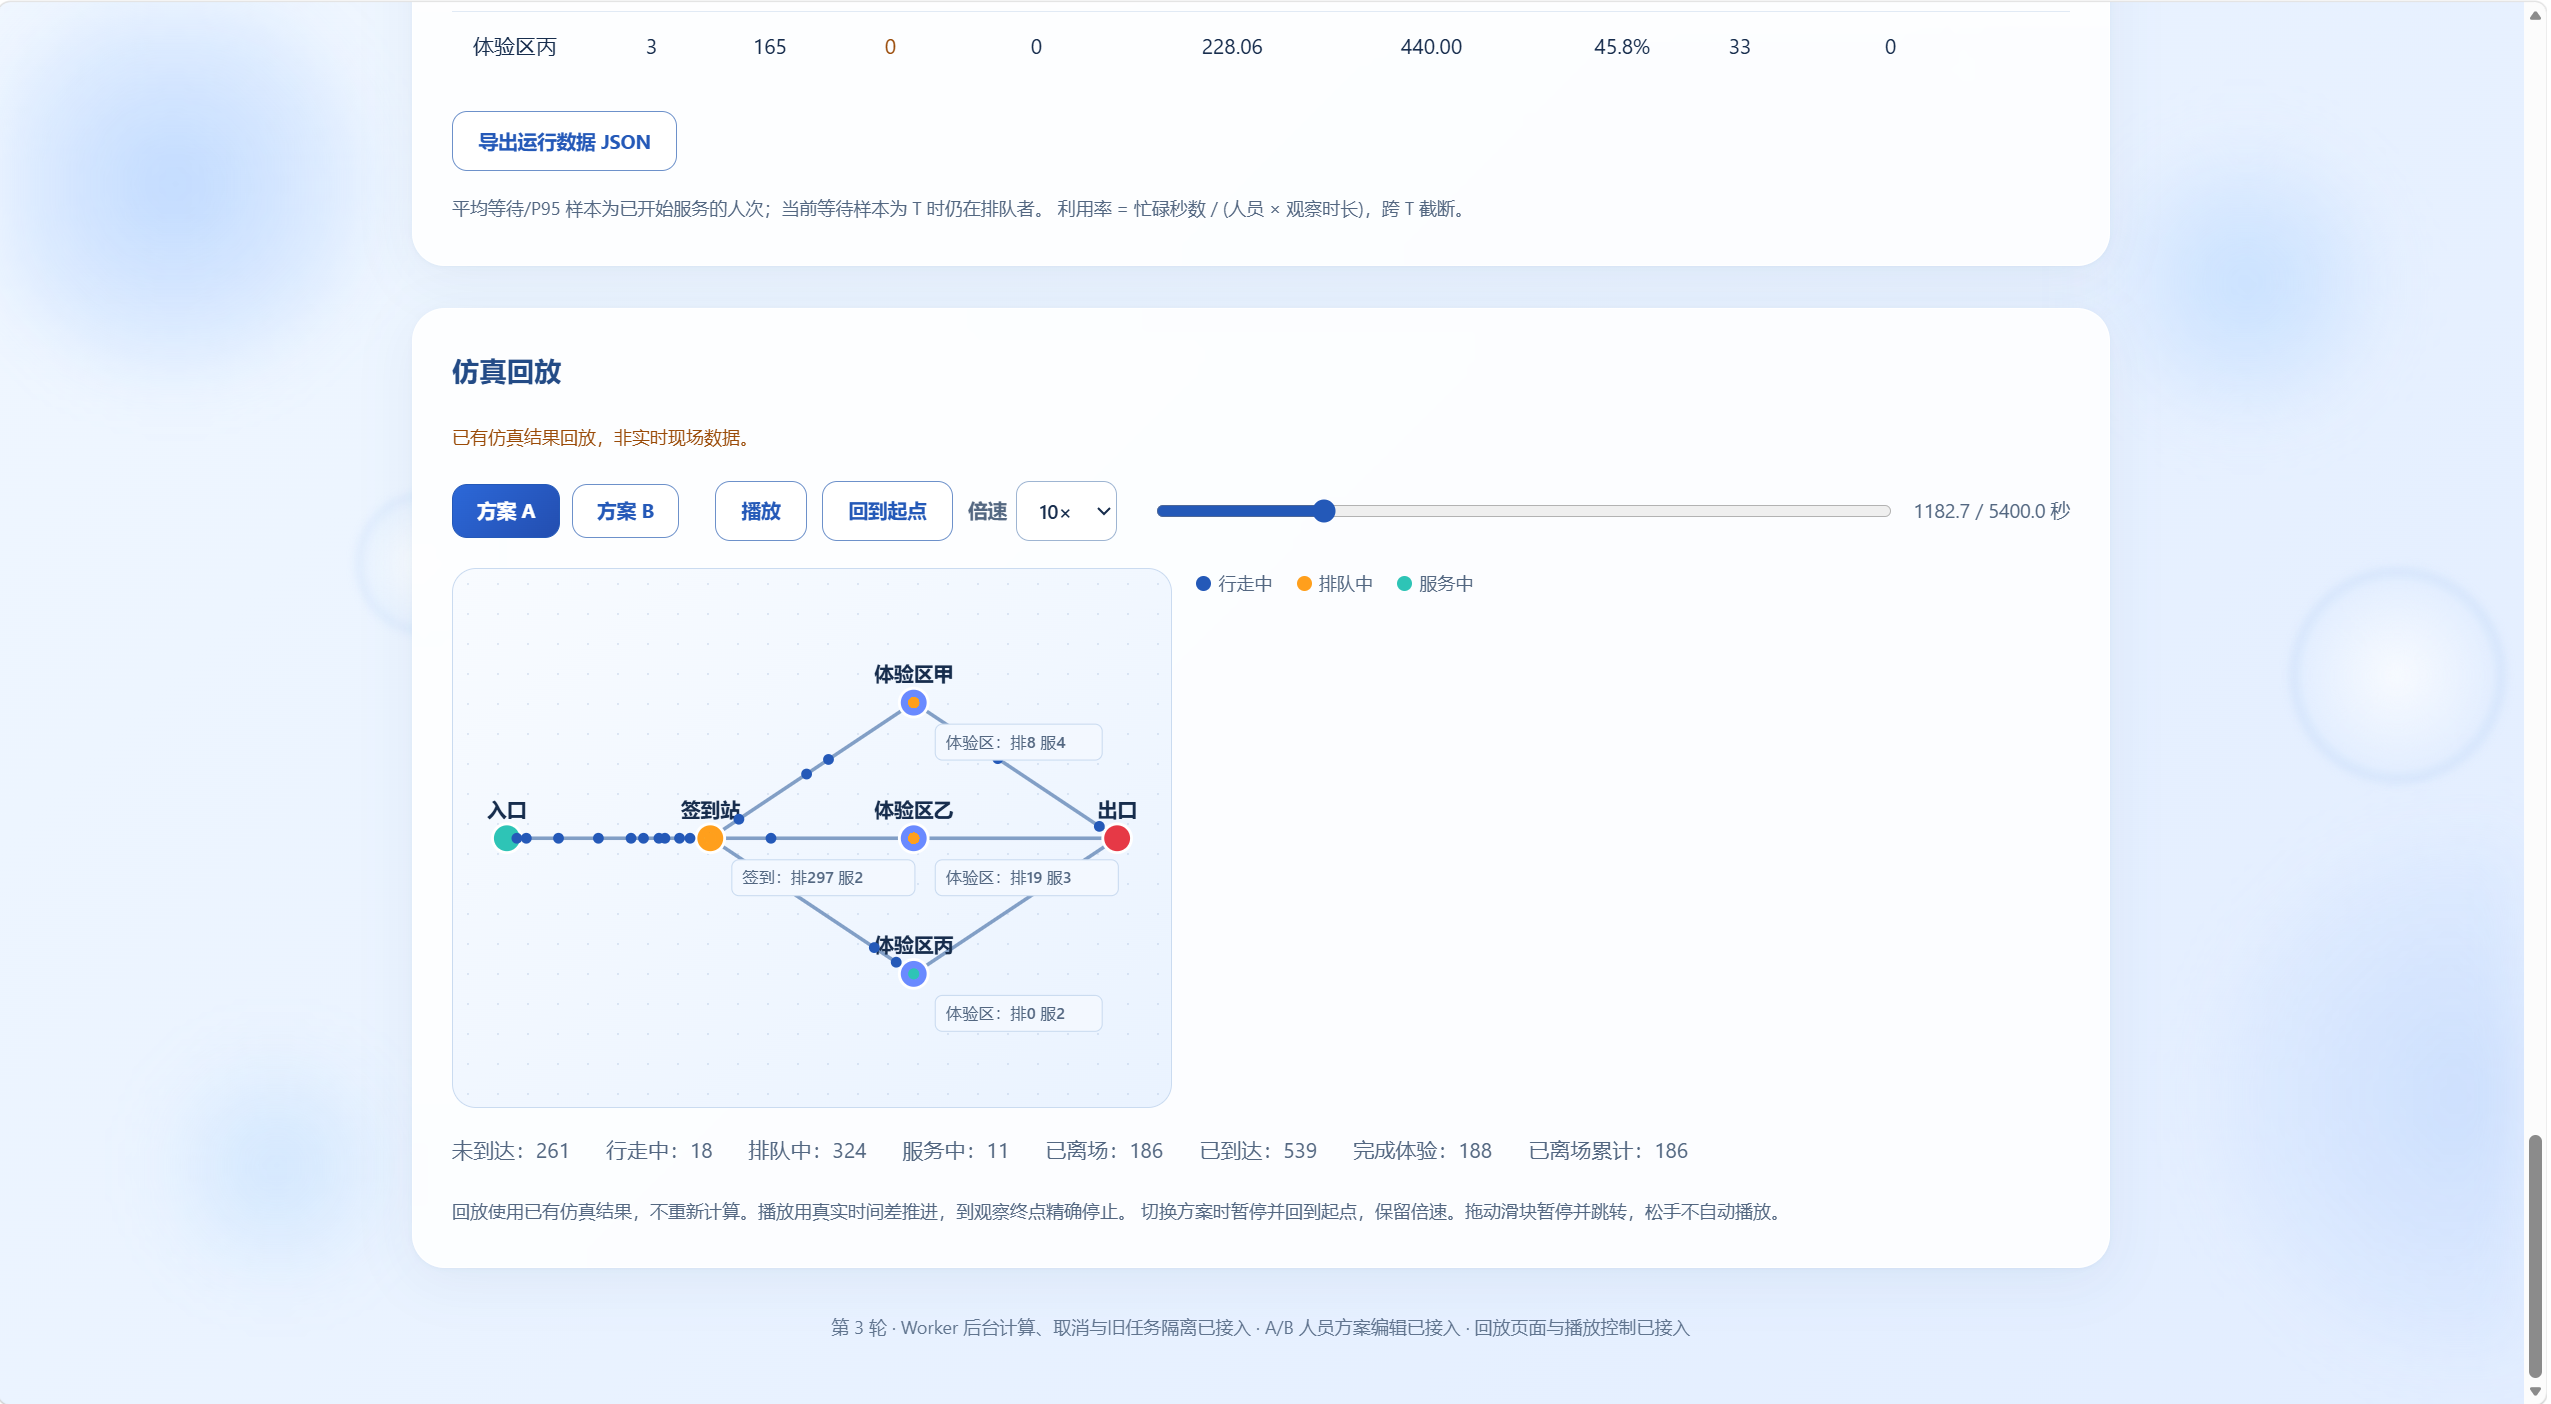
图 10:方案 A 在约 1182.7 秒处的回放画面。此时签到站队列已经明显积累,可以结合后面的统计表分析该阶段的瓶颈。
回放使用已经计算完成的仿真结果,不是每播放一帧就重新运行一次仿真,也不是摄像头或实时签到系统提供的现场数据。
状态人数还有一个便于理解的检查关系:
text
未到达 + 行走中 + 排队中 + 服务中 + 已离场 = 访客总数例如截图中,261 + 18 + 324 + 11 + 186 = 800。
"完成体验"则是累计指标,不属于上述互斥状态求和。一个人完成体验以后,可能仍在前往出口的路上,因此完成体验人数和已离场人数不能直接视为同一个指标。
六、一次 A/B 实验:签到更快,不代表整个活动完成得更好
6.1 实验条件
下面的数据来自本文展示的同一次合成场景运行。两种方案使用相同场景、相同访客输入和相同总人力预算。
| 参数 | 设置 |
|---|---|
| 场景 | 社团招新示例 |
| 访客总数 | 800 人 |
| 到达窗口 | 前 1800 秒内均匀生成到达时间 |
| 观察时长 | 5400 秒 |
| 行走速度 | 1.2 米/秒 |
| 随机种子 | 20261005 |
| 总人力预算 | 每套方案 12 人 |
人员配置如下:
| 站点 | 方案 A | 方案 B | 单次服务时长 |
|---|---|---|---|
| 签到站 | 2 | 4 | 10 秒 |
| 体验区甲 | 4 | 3 | 45 秒 |
| 体验区乙 | 3 | 2 | 60 秒 |
| 体验区丙 | 3 | 3 | 45 秒 |
| 合计 | 12 | 12 | --- |
方案 B 并没有额外增加人力,而是从体验区甲和乙各调出 1 人,放到签到站。
6.2 运行结果
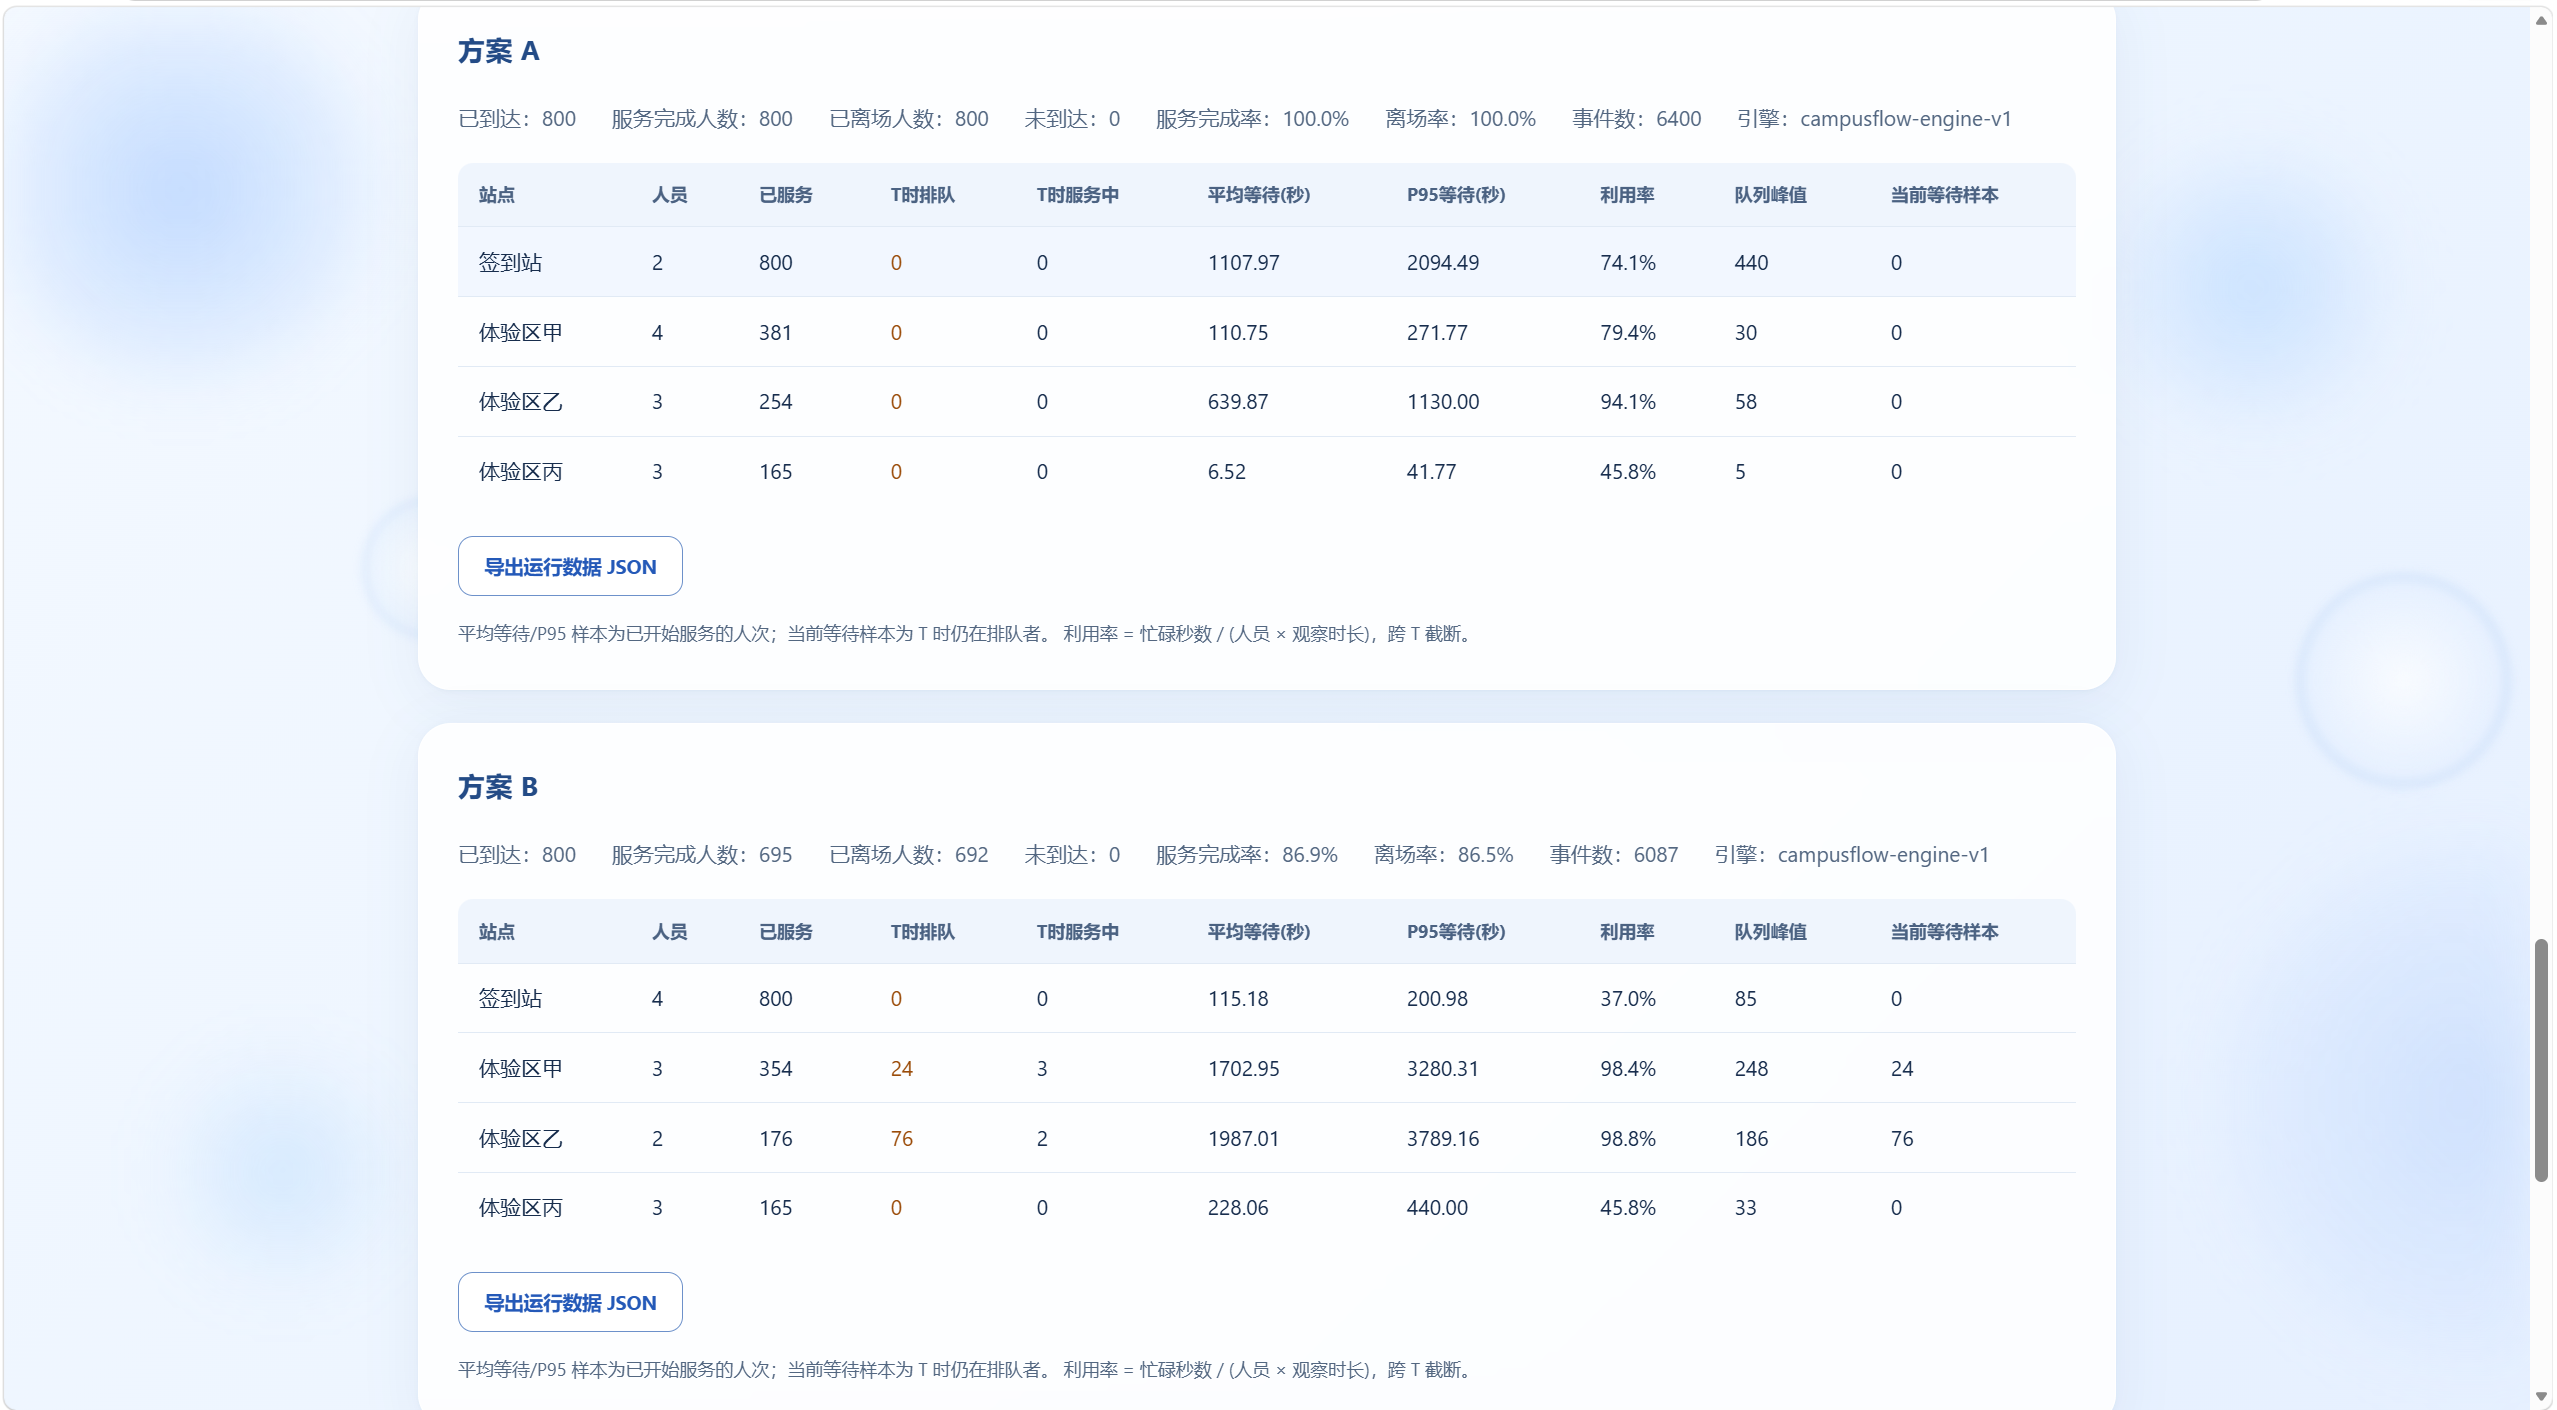
图 11:A/B 实际运行结果。下表中的数值取自该截图,而不是人工编造的展示数据。
| 指标 | 方案 A | 方案 B |
|---|---|---|
| 已到达人数 | 800 | 800 |
| 服务完成人数 | 800 | 695 |
| 已离场人数 | 800 | 692 |
| 服务完成率 | 100.0% | 86.9% |
| 离场率 | 100.0% | 86.5% |
| 签到站平均等待 | 1107.97 秒 | 115.18 秒 |
| 签到站队列峰值 | 440 | 85 |
| 体验区甲平均等待 | 110.75 秒 | 1702.95 秒 |
| 体验区乙平均等待 | 639.87 秒 | 1987.01 秒 |
结果很直观:方案 B 的签到环节明显改善,签到平均等待由 1107.97 秒降到 115.18 秒,队列峰值也由 440 降到 85。
但在同一个观察窗口内,方案 B 完成体验的人数反而少了 105 人。观察终点时,体验区甲仍有 24 人排队、3 人服务中,体验区乙仍有 76 人排队、2 人服务中。
结合人员配置和结果,可以看到这个合成场景中的取舍:签到端更快地放行访客,而两个体验区的服务人员减少,后续环节承受了更大的排队压力。
这正是我希望策境能呈现的价值:不只看一个局部指标有没有变好,而是把同一方案对多个环节的影响放到一起观察。
需要强调,这不是"方案 A 永远优于方案 B"的结论,也不是一次现场运营实测。它只说明在当前固定输入、服务时长、路径和观察窗口下,两套人员配置出现了这样的差异。改变条件后,需要重新运行和比较。
6.3 指标的口径同样重要
结果表中的平均等待和 P95,统计样本是已经开始服务的人次。观察终点仍在队列中的访客,其等待状态需要结合终点排队数据理解,不能把表中的平均值当作所有访客最终等待时间的完整统计。
服务完成率以截至观察终点实际到达的人数为分母;服务完成人数表示完成目标体验区服务的人数,离场人数则表示已经到达出口的人数。
人员利用率按服务人员总忙碌秒数与"人员数 × 观察时长"的比值计算,跨越观察终点的服务时间会截断。
如果不说明这些口径,即使数值计算没有出错,读者也可能理解出另一种含义。
七、测试与验收:不把"显示完成"当成真正完成
随着功能增加,测试也从计算核心扩展到场景编辑、任务隔离、回放生命周期和人员方案状态。
在人员方案编辑阶段,审查进一步推动了这些修正:
- 普通场景变化时,保留仍然存在的站点的已应用人数和未应用草稿。
- 导入场景的确认提示明确说明人员方案会重置。
- 草稿总人数除了检查各个输入,也检查累加后的安全整数范围。
- 运行完成时,通过实际页面使用的协调函数接收结果,避免测试与生产逻辑脱节。
- 验证结果清空和保留时,从非空结果开始测试,避免"本来就是空"的无效证明。
- 验证运行期间产生的空值草稿、新草稿不会在完成回调中被旧状态覆盖。
其中,"每个输入合法"不代表"累加后仍合法"是一个容易忽略的边界。当前草稿汇总函数在累加后还有如下检查:
ts
if (!Number.isSafeInteger(total)) return null;
return total;
这类边界检查不一定会成为页面演示的主角,却决定了系统在异常输入下是否仍然可信。
本轮交付验证记录为:
| 检查项 | 记录结果 |
|---|---|
| TypeScript 类型检查 | 通过 |
| Vitest 自动化测试 | 807 项通过,32 个测试文件 |
| 生产构建 | 通过 |
git diff --check |
通过 |
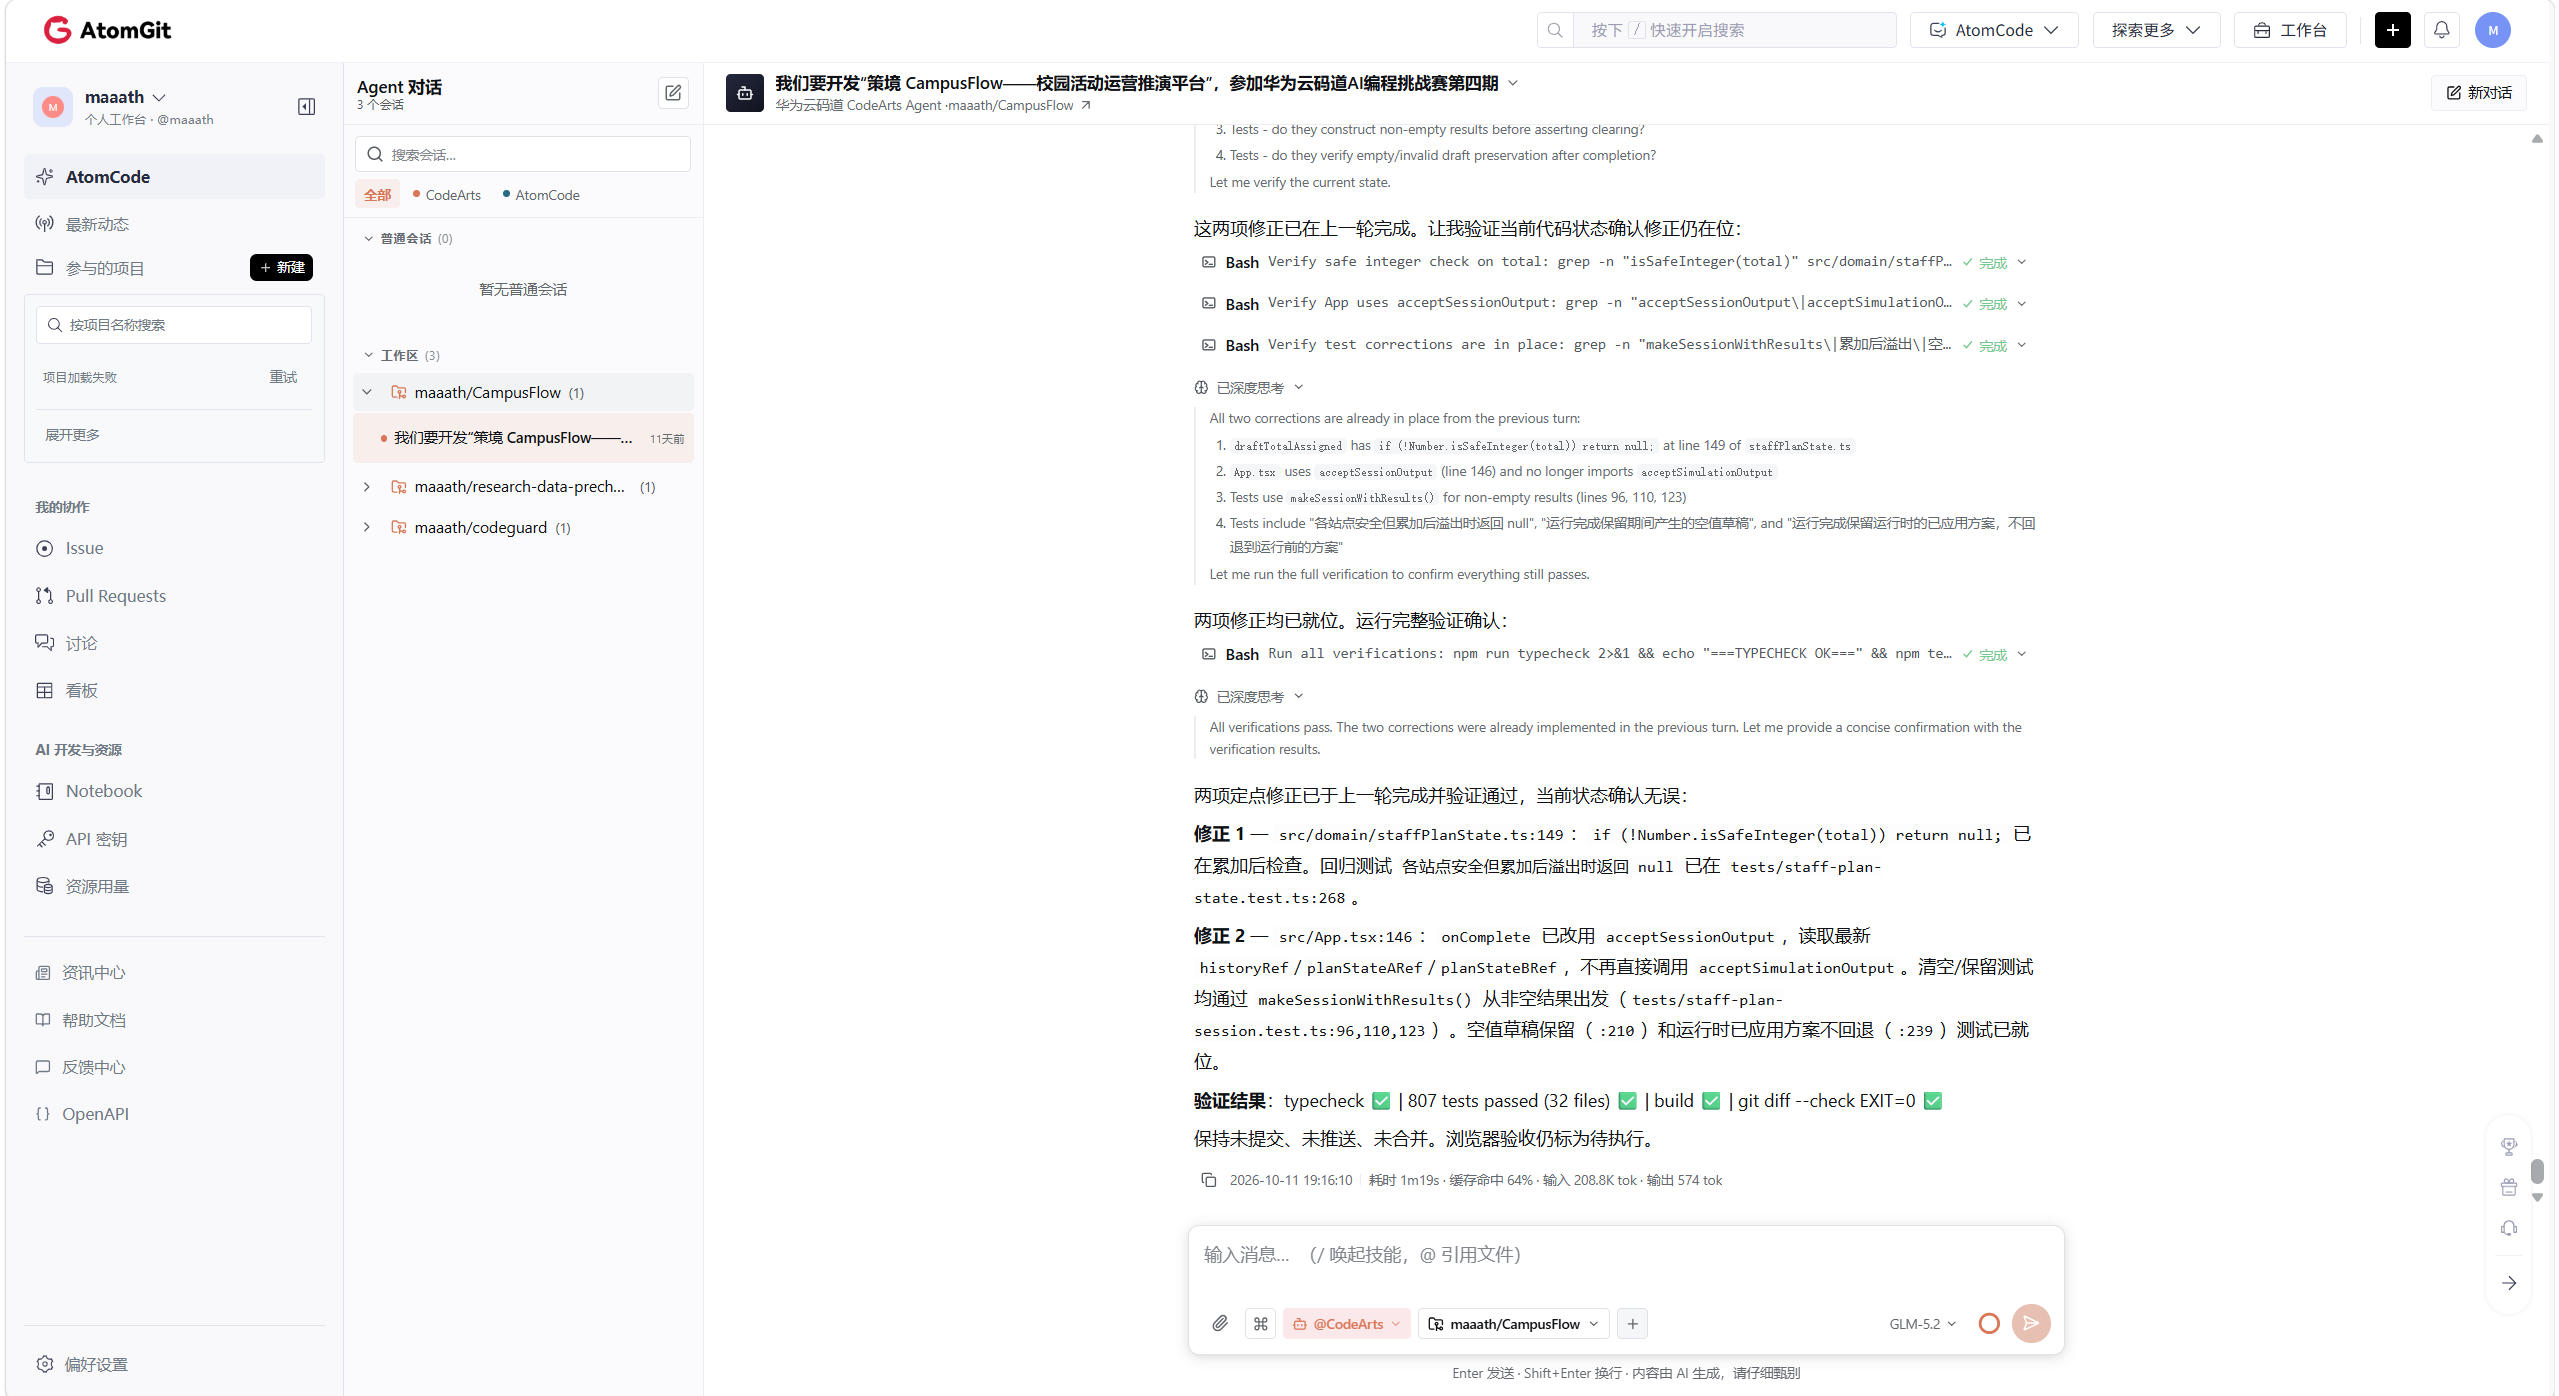
图 12:人员方案编辑阶段的修正与验证记录。与前面的回放阶段截图相比,测试数量随功能和回归用例增加而变化。
这里也需要保留验证边界:截图中的测试数量是该轮验证记录,不能等同于所有浏览器交互都已完成验收。自动化测试运行在 Node 环境;本文展示了真实页面运行效果和超预算拒绝应用状态,但运行中切换方案、导入确认、撤销恢复等交互仍需要按浏览器验收清单继续核对。
我更愿意把"测试通过"和"浏览器验收完成"分开记录,而不是为了交付摘要整齐,把尚未执行的检查写成已通过。
八、源码、技术栈与本地运行
项目源码地址:https://atomgit.com/maaath/CampusFlow
项目采用 MIT 许可证,使用的主要技术包括:
- React 18:页面组件与交互展示。
- TypeScript 5.6:领域模型、仿真计算与状态约束。
- Vite 6.4:开发服务与生产构建。
- Vitest 4.1:单元测试和模块协作测试。
- Web Worker:后台仿真任务执行。
- SVG:场景地图与回放可视化。
在已安装 Node.js 和 npm 的环境中,可以克隆仓库并运行:
bash
git clone https://atomgit.com/maaath/CampusFlow.git
cd CampusFlow
npm install
npm run dev
开发服务默认使用 5185 端口,访问地址以终端实际输出为准。端口被占用时不会自动切换,应先确认已有服务情况。
检查与构建命令如下:
bash
npm run typecheck
npm test
npm run build
Windows PowerShell 如果拦截 npm.ps1,可以使用对应的 npm.cmd 命令,例如:
powershell
npm.cmd run dev不同开发阶段的测试数量不同,复现时应同时核对代码版本和对应文档,不把旧提交的输出与新版本混在一起。
九、当前边界与下一步计划
策境目前已经串起了场景编辑、A/B 人员配置、后台运行、结果统计与回放,但它仍是一个有明确范围的原型。
当前模型不包含人与人之间的碰撞、通道容量、拥挤压力,也没有摄像头、真实签到数据或现场传感器接入。每个站点在一次运行中使用固定服务时长,而不是从现场统计拟合的随机服务时间分布。
它也不是一个人员分配自动优化器:当前由用户给出 A/B 配置,再比较结果,不会自动搜索所有分配并给出全局最优答案。
后续准备继续推进的方向包括:
- 更清晰的方案差异展示:在已有 A/B 结果表之外,增加专门的差值和变化幅度展示,降低比较成本。
- 离线 HTML 报告:把场景参数、人员方案、统计口径和运行结果整理成可独立查看的报告。
- 补齐浏览器回归验收:覆盖运行中取消、方案切换、导入、撤销恢复等跨模块交互。
- 评估模型与性能边界:开展更多输入条件下的实验和规模测试;若要面向真实活动,则先补充数据采集、参数校准与模型验证。
这些属于下一步工作,不能因为已经列入规划,就当作当前版本已具备的能力。
十、这次 AI 编程实践带给我的体会
做完这些阶段之后,我对"用 AI 开发一个应用"的理解,已经不只是描述界面、等待生成、打开看效果。
华为云码道帮助我把较长的开发链条拆成可以逐步落实的任务:先完成计算核心,再接入编辑器;先实现纯函数,再处理页面状态;先修复问题,再补充回归测试。
而我需要持续做的,是把含糊的期待变成明确规则:
- "可以取消",到底是按钮状态变化,还是旧任务真的不能再写回?
- "运行完成",会不会覆盖用户刚刚输入的新草稿?
- "方案更好",指签到更快,还是整个观察窗口内完成体验的人更多?
- "保存成功",保存的是场景,还是用户误以为的全部工作状态?
- "验证通过",有哪些真实执行记录,又有哪些仍然待验收?
这些问题,比页面上多一个按钮更难处理,也更值得认真处理。
策境 CampusFlow 目前还不能替代真实活动的运营判断,但它已经能够把一种人员安排变成可运行的假设,把一次运行变成可查看的结果,再把不同方案的取舍放到同一张桌面上讨论。
这就是我想通过这个项目实现的事情:让活动方案不只停留在"感觉应该这样安排",而是先在明确假设下推演一次,再带着结果继续提问。