深度 | 记忆的锁定账:模型可以随便换,记忆却搬不走
风险投资机构 Activant 2026 年那份《记忆护城河》研究,副题叫「最后一道 AI 切换成本」,核心判断就一句:模型正在变成可替换的商品,上下文却不会商品化,锁定不会消失,只是顺着栈往上爬,最后停在记忆这一层。报告里还有一句更冷的细节,审计师能调取数据库记录,却没法「传唤」一个缓存。
几乎同一时间,LangChain 创始人 Harrison Chase 发了一条被转了一百多万次的帖子:harness 和记忆是同一件事,拆不开,在封闭运行时上开发,等于把用户的记忆和背后的数据价值亲手交给平台,等你反应过来,切换成本已经高到走不了。LangChain 随后开源了 Deep Agents Deploy,主打卖点就是「记忆归你」。
这两件事指向同一处:这一年,Agent 的竞争从「谁能记住你」转向「谁肯让你把记忆带走」,而记忆这一层,恰好是整条栈里唯一没有协议的那一层。
三层有协议,一层是真空
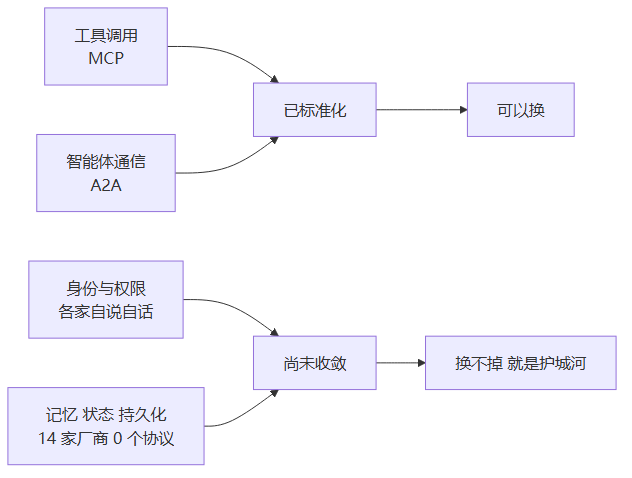
2026 年的 Agent 技术栈,四层里三层已经立起标准。工具调用有 MCP,Anthropic 提出后成了事实标准,管智能体怎么调工具、读资源、连数据;智能体之间的通信有 A2A,谷歌发起、Linux 基金会托管,管智能体怎么发现彼此、委派任务。这两层各有清晰的边界和治理主体。
唯独状态管理这一层,记忆、上下文、会话的持久化,没有协议。一篇行业盘点给它定性:十四家以上厂商、约七个架构流派、零个共享标准,连基准都不互通。
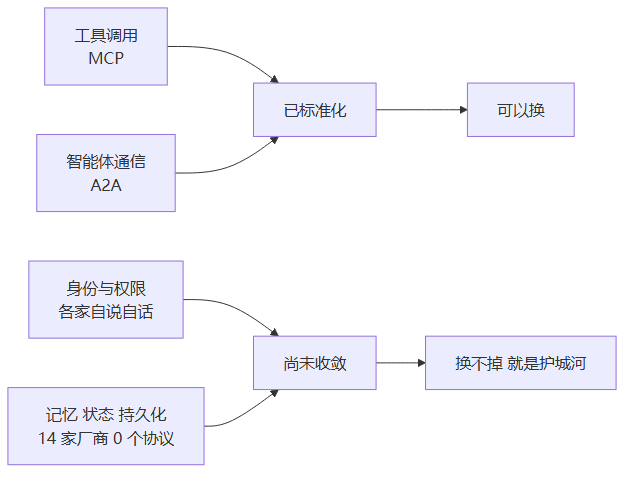
上图:Agent 技术栈四层里,工具和通信已经标准化,记忆仍是真空,真空恰好是锁定生长的地方。
这个真空不是没人看见。2026 年 MCP 的势头在加速,10 月 Home Assistant 把 MCP 嵌进平台,两千多个智能家居集成一键变成 Agent 工具,同周 Google Cloud 的 Data Agent Kit 把十五个以上数据服务接进 Claude Code 和 Codex。工具层正在被协议统一,这反而让记忆层的空白更扎眼。
两条相反的赌注:原地改写,还是保留原文
锁定深浅,最先体现在两大平台对「记忆该不该可逆」的回答上。
OpenAI 的 Dreaming V3 走原地改写。后台持续把对话里的持久上下文抽出来,合并、重写成一份统一的记忆状态,而不是一张事实清单,「要去新加坡」会随时间演化成「去过新加坡」。代价是可逆性:用户看到的是「记忆摘要页」,官方明说它不包含全部记忆;用户能删单条「记忆链」,却不能直接编辑那份被合成的状态;删掉对话,也删不掉已经从中派生出的记忆。这条路线快、省、不可审计。
Anthropic 走保留原文。Claude 记忆把原始输入留在原地,并行产出一份可读的 Markdown 记忆,逐行可改、可删、可暂停、可重置,文件落在客户端。Arize 那篇对比文章的标题是《两个实验室都开始做梦,造出了两种相反的架构》,一句话总结:这是关于「梦该不该可逆」的两笔相反赌注。
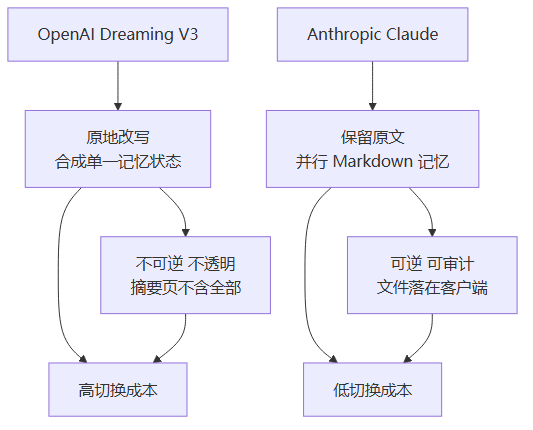
上图:OpenAI 与 Anthropic 对记忆可逆性的两笔相反赌注,前者原地改写、后者保留原文,切换成本一高一低。
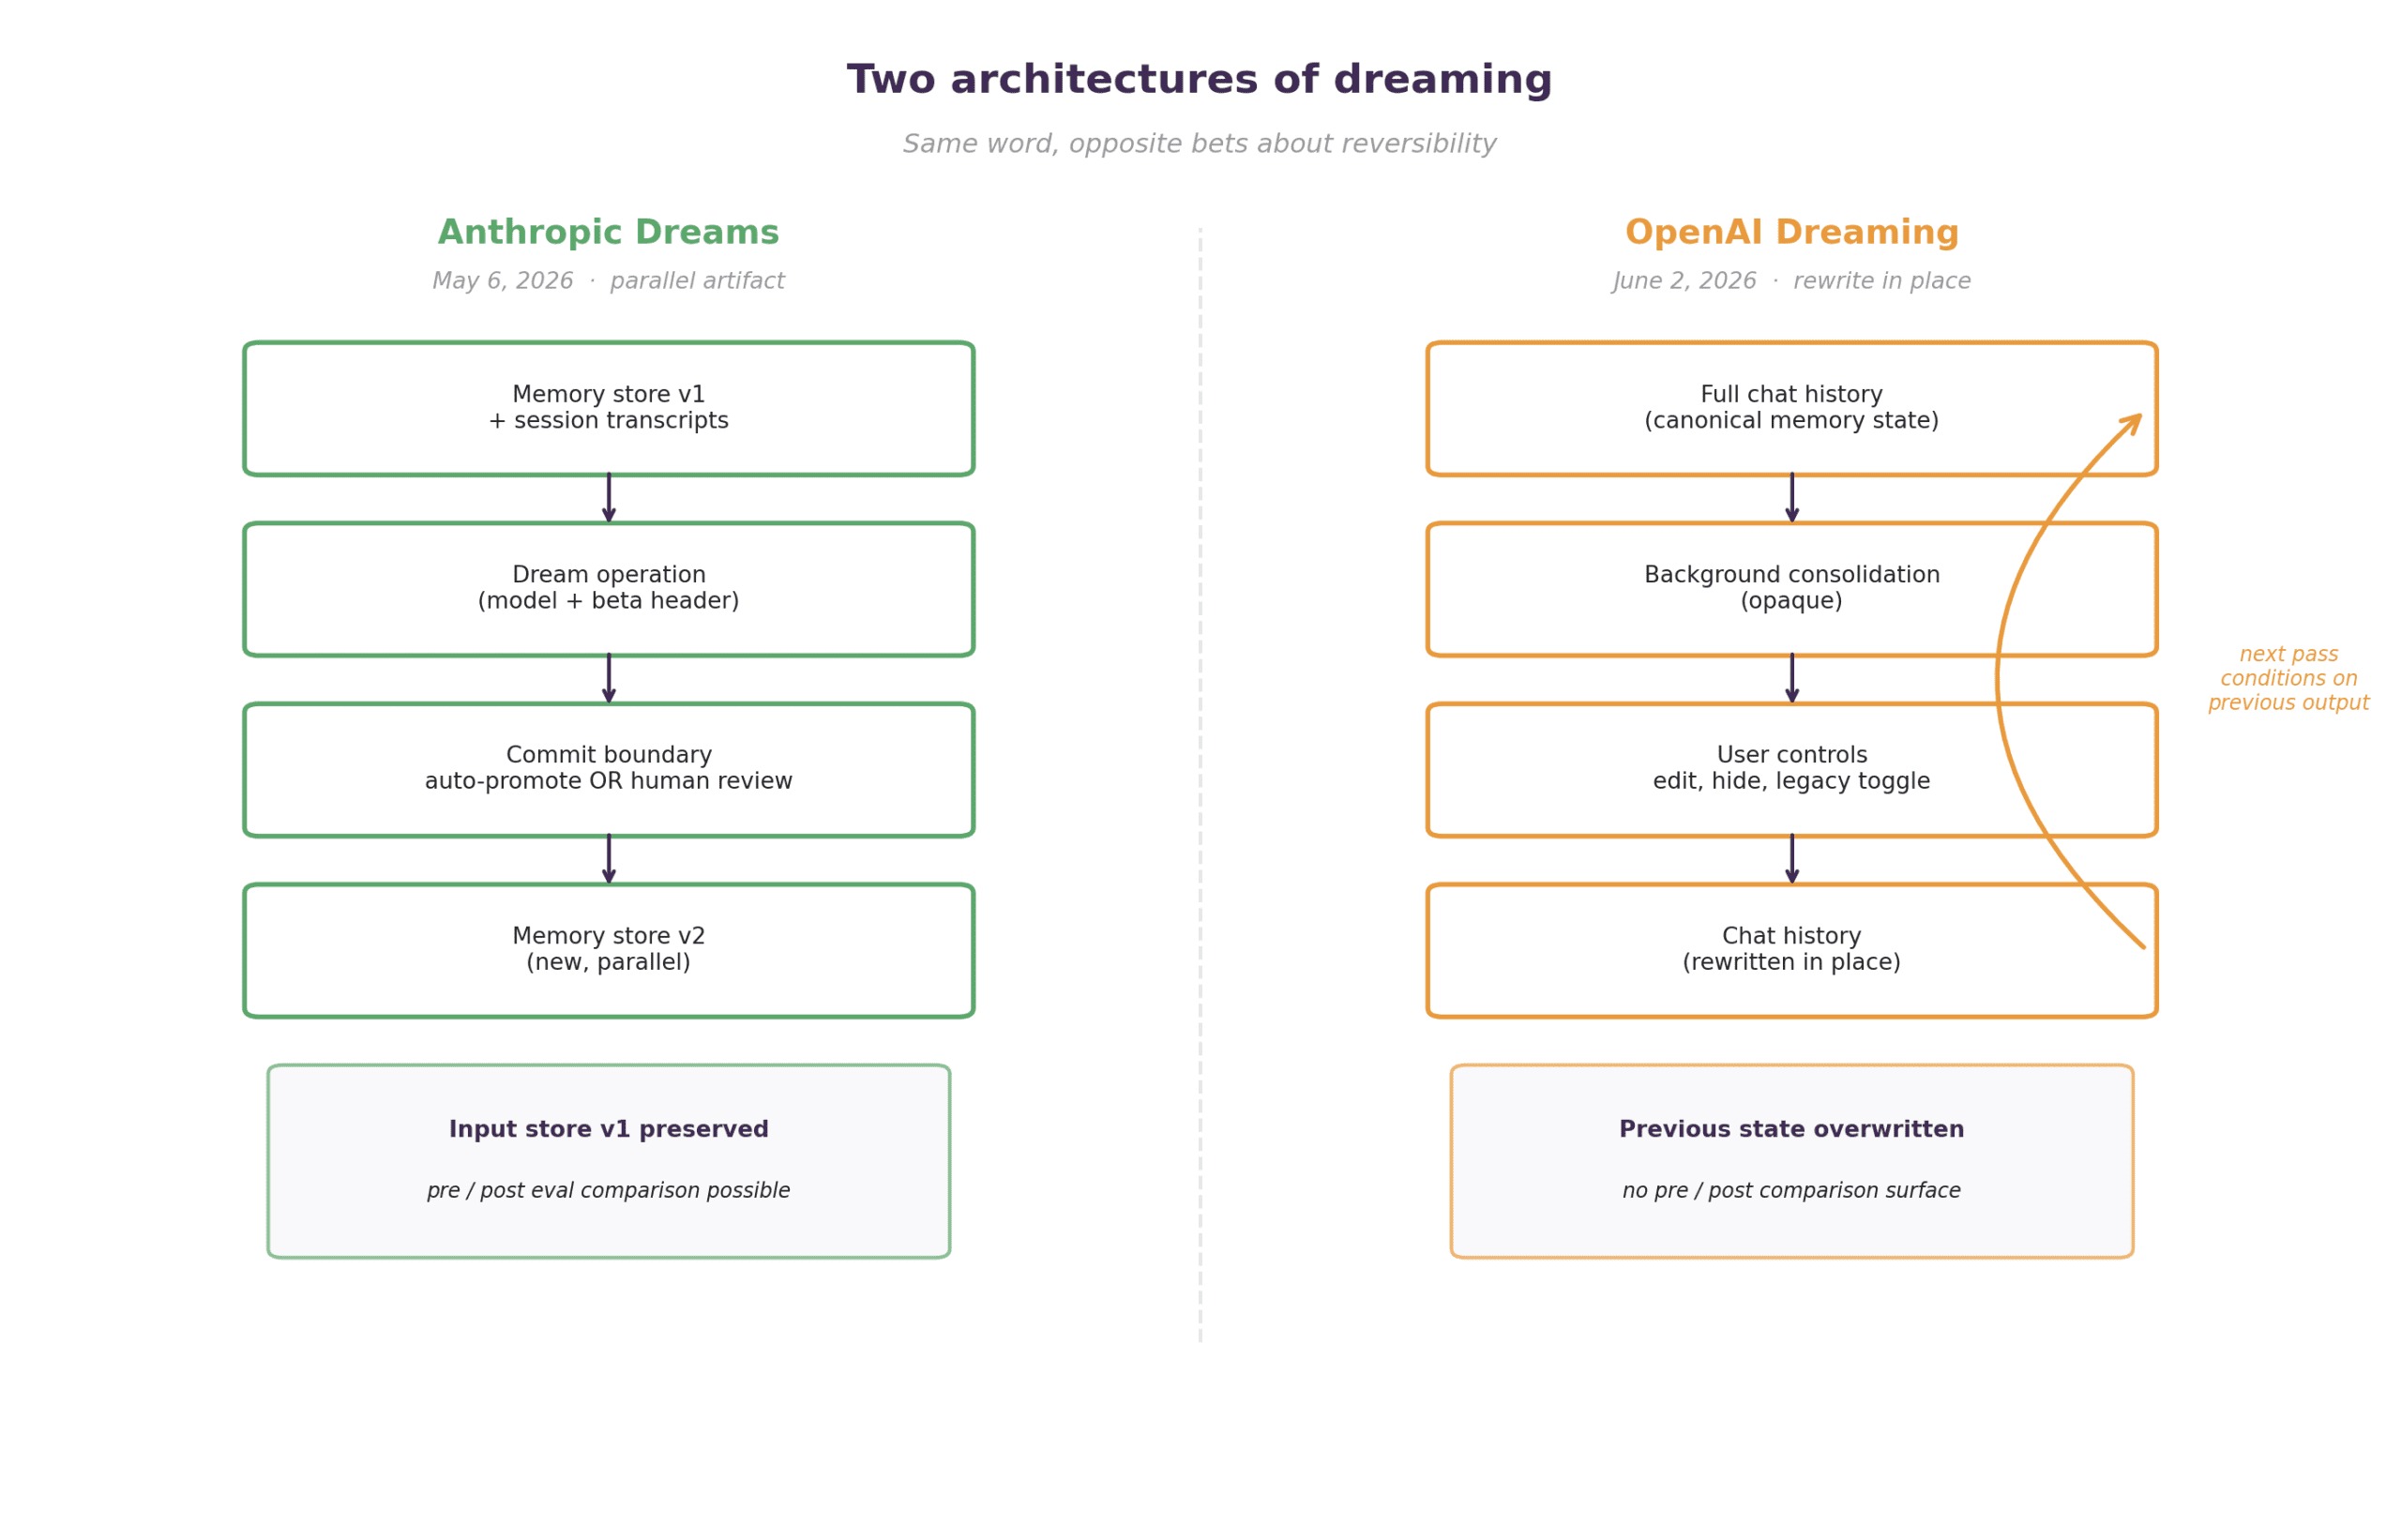
上图:Arize 官方博客《Two labs started dreaming》中 OpenAI 与 Anthropic 两种记忆架构对比原图,2026-06-04,来源:arize.com 官网
需要点破的是,这并非「一条锁、一条不锁」的善恶之分,区别只在于锁定深度。Anthropic 的可逆设计降低了切换成本,但记忆同样是它平台留存的一部分,Claude 三月的免费记忆和「导入记忆」工具,本身也是面向 ChatGPT 用户的拉新动作。区别在于,可逆设计保留了逃离的梯子,原地改写把梯子收走了。
导出,不等于可移植
宣传页上,记忆好像已经能自由搬家。真搬一次就知道,这些工具底层是同一件事:让旧助手自己吐一段文本,再粘进新助手。
这里有三道裂缝。第一道,导出的只是模型愿意输出的部分:Claude 的导入工具抓不到后台数据库和完整日志,官方标了「实验性」;OpenAI 的摘要页被明说成对合成状态的「高层、有限视图」,而且从未开放用户记忆的 API 导出。第二道,结构被抹平:一位开发者 2026 年 7 月把七个记忆产品挨个测了一遍,导出时全部摊平成散文,他给的结论是,只有一家产品能写的格式不叫可移植性,叫「写得好的方言」。第三道最讽刺:Anthropic 在把 Claude 聊天记忆并进 Cowork 时,没用自家导入工具,而是直接合并了存储层。副本不等于一份活着、共享的记忆,连造出工具的人自己都不走这条路。
上图:当前的「记忆搬家」都是让旧模型自述再粘贴,结构在导出时被抹平,真正的开放格式迁移尚不存在。
这条裂缝在中国更直白。一组对两千多条 ChatGPT 记忆的研究发现,96% 是系统自己创建的,28% 含敏感信息,52% 含对用户的心理判断。用户删了聊天记录,模型却未必真忘,这是中文社区反复传播的一句话。
锁是怎么造进产品里的
记忆不光缺协议,供应商还有动力让协议继续缺席。最干净的两刀,都来自头部记忆平台的开源策略收缩。
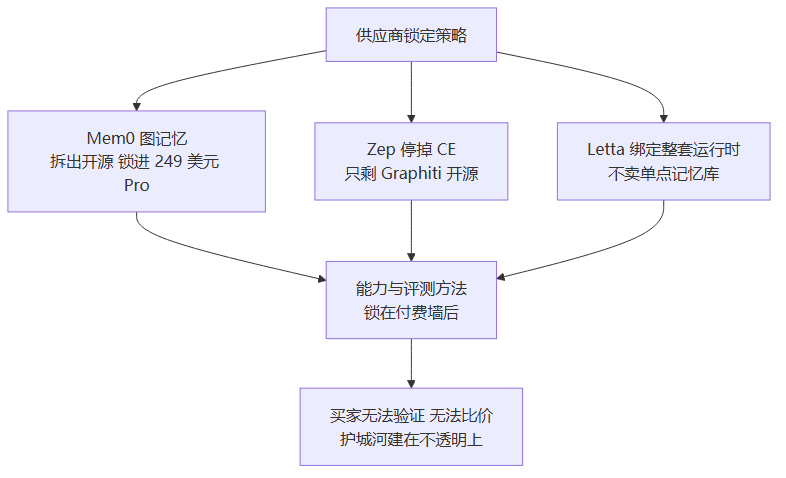
Mem0 把图记忆从开源 SDK 拆了出去,划进每月 249 美元的 Pro 档,免费档和 19 美元档只剩纯向量检索,19 到 249 之间没有任何中间档,社区管这叫「定价悬崖」。这家公司 2025 年底拿了 2400 万美元 A 轮,还成了 AWS Agent SDK 的指定记忆层。Zep 更干脆,2025 年停掉了开源 Community Edition,只留双时态知识图谱引擎 Graphiti 开源,生产用户被导向 Cloud 或 Bring Your Own Cloud。
两件事合起来,是记忆行业「开源内核加商业增值」的收敛。最关键的评测方法和最强的能力锁在付费墙后面,买家没法验证、没法比价。Letta 的锁定是另一种,它不卖记忆库,要求你采纳整套运行时,前身是 UC Berkeley 的 MemGPT,种子轮 1000 万美元、投后 7000 万,天使名单里有 Jeff Dean 和 Clem Delangue。Cognee 也在 2026 年初拿了 750 万美元种子轮。
上图:三类锁定策略殊途同归,把关键能力和评测方法锁进付费墙,让买家失去比价能力。
企业侧的账早有人算。Gartner 预测到 2027 年底超四成 agentic AI 项目会因成本失控、价值不清被取消;一份架构研究讲得更重,平台部署的持久记忆「创造了远超社交媒体时代的切换成本」,记忆越深,离开平台就越接近离开用户自己的运营能力。
撬锁的人已经进场
真空的另一面,是已经有人往洞里填协议。
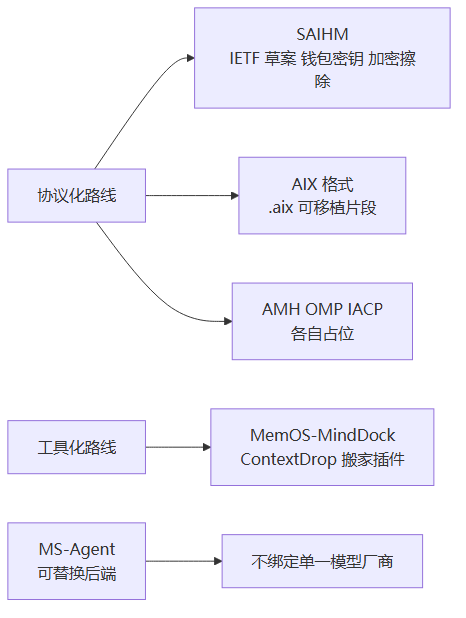
最完整的是 SAIHM,全称 Sovereign AI Horizontal Memory Protocol,一份挂在 IETF 独立提交流上的草案。它把自己定位成 MCP 的记忆层伴侣:MCP 管智能体怎么够到工具和数据,SAIHM 管记忆怎么跨会话、跨模型、跨厂商地持久化、共享和擦除。机制很激进:记忆单元用钱包派生的密钥在客户端加密,运营商只看得见密文;擦除靠销毁密钥加墓碑记录,直接对应 GDPR 第十七条;还挂了八条 MCP 工具。
不过得泼冷水。SAIHM 的推手是 COTI 这家区块链项目,草案走 IETF 的「独立提交流」,不是工作组共识文档,离被采纳还远。W3C 确实有一个「AI Agent Memory Interoperability」社区组,但它明说在草案审议期间不发布竞争规范。协议有了雏形,还没有大厂站出来认领。
同一方向还有 AIX 协议的 .aix 开放格式、跑成 MCP server 的 Agent Memory Hall、Open Memory Protocol 和 IACP 各自占位。国内是另一路,不写协议,直接做搬家工具:MemOS-MindDock、ContextDrop 这类插件一键抓取 ChatGPT、Kimi、豆包的记忆再注入任意 AI。豆包 2026 年 7 月下线自定义智能体那次,用户发现记忆搬不走,小厂立刻用「一键搬家、永不失联」接住了这批人。
上图:破锁的力量分协议化和工具化两路,前者还在草案阶段,后者已在帮用户搬家,但都未形成标准。
合规是把迟早落下的钥匙
就算商业上没动力造协议,合规也会逼出可移植和可擦除。欧盟 GDPR 第十七条的删除权、第二十条的数据可携带权,落到记忆上变成一个硬问题:用户要求删除时,你删的到底是哪一层。
西班牙数据保护机构 AEPD 2026 年 2 月发布的 agentic AI 数据保护指引,被多家律所称为迄今最详细的欧盟监管文件。它把记忆列为 agentic AI 的四大核心风险之一,拆成工作记忆和长期记忆,并把「记忆控制」列为五大缓解支柱之一,要求组织能定位访问、更正、删除、可携带请求范围内的所有要素,包括处理过程中产生的提示词和中间结果。
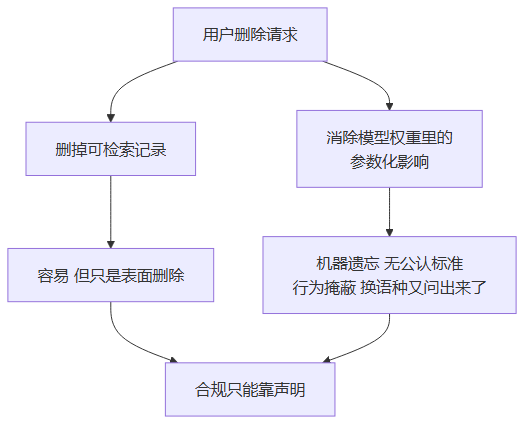
这条要求踩在一个未解难题上。记忆系统存的是派生的反思和摘要,不是原始对话,「存储的单位不是事实的单位」,一条融合后的记忆无法为其中一个事实单独删除。学界对机器遗忘的共识是:可验证的删除至今没有公认标准,大量所谓「遗忘」其实是行为掩蔽,换个语言问,内容又回来了。
上图:删除请求在「删记录」和「改模型」之间分裂,前者容易、后者无解,合规停留在声明层面。
国内法条其实早写下了同样义务。《生成式人工智能服务管理暂行办法》第十一条要求服务提供者及时处理用户更正、删除个人信息的请求,不得非法留存可识别用户的输入信息和使用记录。法条里没有「记忆」二字,但输入信息和使用记录,就是记忆在监管眼里的名字。问题在于,删掉聊天记录和模型真正忘掉之间,隔着一整条没人打分的链路。
谁拥有记忆,谁拥有客户
把这些线收在一起,我判断接下来十二个月记忆市场的竞争主线,会从「谁记得更准」转向「谁肯让你带走」。理由很具体:模型在降价、在趋同,工具和通信在标准化,唯独记忆既是客户关系、又是最深的切换成本,还没有协议约束。这是护城河最好挖的地方,也是最先被监管盯上的地方。
先不下结论的是最终赢的形态。是 SAIHM 这种带钱包密钥的密码学协议,还是某家大厂突然开放一个导出标准,还是国内那批搬家工具用体量倒逼出事实格式,现在都看不准。能确定的是方向:可移植性会从没人要的东西变成卖点,今天还在用定价墙锁记忆的厂商,会在采购谈判桌上撞上「怎么导出、怎么删除」这两个绕不过去的问题。
给正在选记忆层的企业一句最实用的话:别先问它记得多准,先问三件事。记忆怎么导出、导出后能不能在新环境跑起来;删一条记忆时,权重里那部分影响怎么算;记忆存在谁的库里,合同到期那天你拿不拿得走。答不上来这三个的,再高的基准分也只是租来的记忆。
参考来源
- Activant Capital:《The Memory Moat / The Last AI Switching Cost?》
- LangChain 创始人 Harrison Chase 论「harness 即记忆」及 Deep Agents Deploy
- The Agent State Management Layer Is Fracturing:14 Vendors, Zero Standards(forkast.news)
- Arize:《Two labs started dreaming, and they built two different architectures》
- Glasp:《Your AI Is Dreaming About You》(Dreaming V3 机制拆解)
- Wire Blog:《AI memory lock-in works until it blocks your own product》
- SAIHM:Sovereign AI Horizontal Memory Protocol(IETF 草案 + 官方 FAQ)
- Zep 官方博客:《A New Direction for Zep's Open Source Strategy》
- Mem0 定价页(图记忆位于 Pro 档)
- Pearl Cohen:Spain AEPD issues guidance on agentic AI and GDPR
- See Sol Lab:《国内 Agent 都在说「记忆」,真正会自己记的有多少?》
- 《生成式人工智能服务管理暂行办法》全文(gov.cn)
每日更新。