OpenRig 是一个开源的多 agent harness,4 月 1 日建仓,本周在 GitHub trending 上涨了 2,028 颗星,总数接近 7,000,当前版本 0.6.10,Apache-2.0 协议。它的 README 第一句话是「A harness wraps a model. A rig wraps your harnesses.」:Claude Code 和 Codex 各自是包住模型的 harness,OpenRig 再把多个 harness 包成一个团队。它不修改任何 agent,每个 agent 仍然是一个普通的 Claude Code 或 Codex 会话,跑在你能随时 attach 进去的 tmux 里。OpenRig 加的是四样东西:用 YAML 描述的团队拓扑、往终端里投递消息的机制、一个记录工作归属的队列,以及重启后把团队恢复原样的快照。本文按这四部分拆它的源码,最后列出安装前需要知道的配置改动。
这个项目最值得看的地方,是它对「多个 agent 之间靠什么协作」给出的答案。
常见的多 agent 方案让 agent 之间互相发消息、在对话里交接任务。OpenRig 的内置团队规则明确禁止这样做:「Do not use chat text as the work record」。消息只负责叫醒对方,任务本身写在 SQLite 队列里,有归属、有状态、有交接记录;daemon 每 5 分钟扫一遍队列,找出领了没做、交了没人接的条目,再写成新条目派回给负责的 agent。团队的拓扑也一样落在文件里:谁给谁派活、谁能看谁的输出,写在 YAML 的边上,而不是写在某个 agent 的 prompt 里。
一个 agent 的上下文会被压缩、会话会断、进程会重启,对话里的承诺随时可能丢失。OpenRig 把所有需要跨越这些中断的东西都放在 agent 之外,这是一个团队能长时间连续工作的前提。
用一份 YAML 定义团队:分组、角色和五种关系
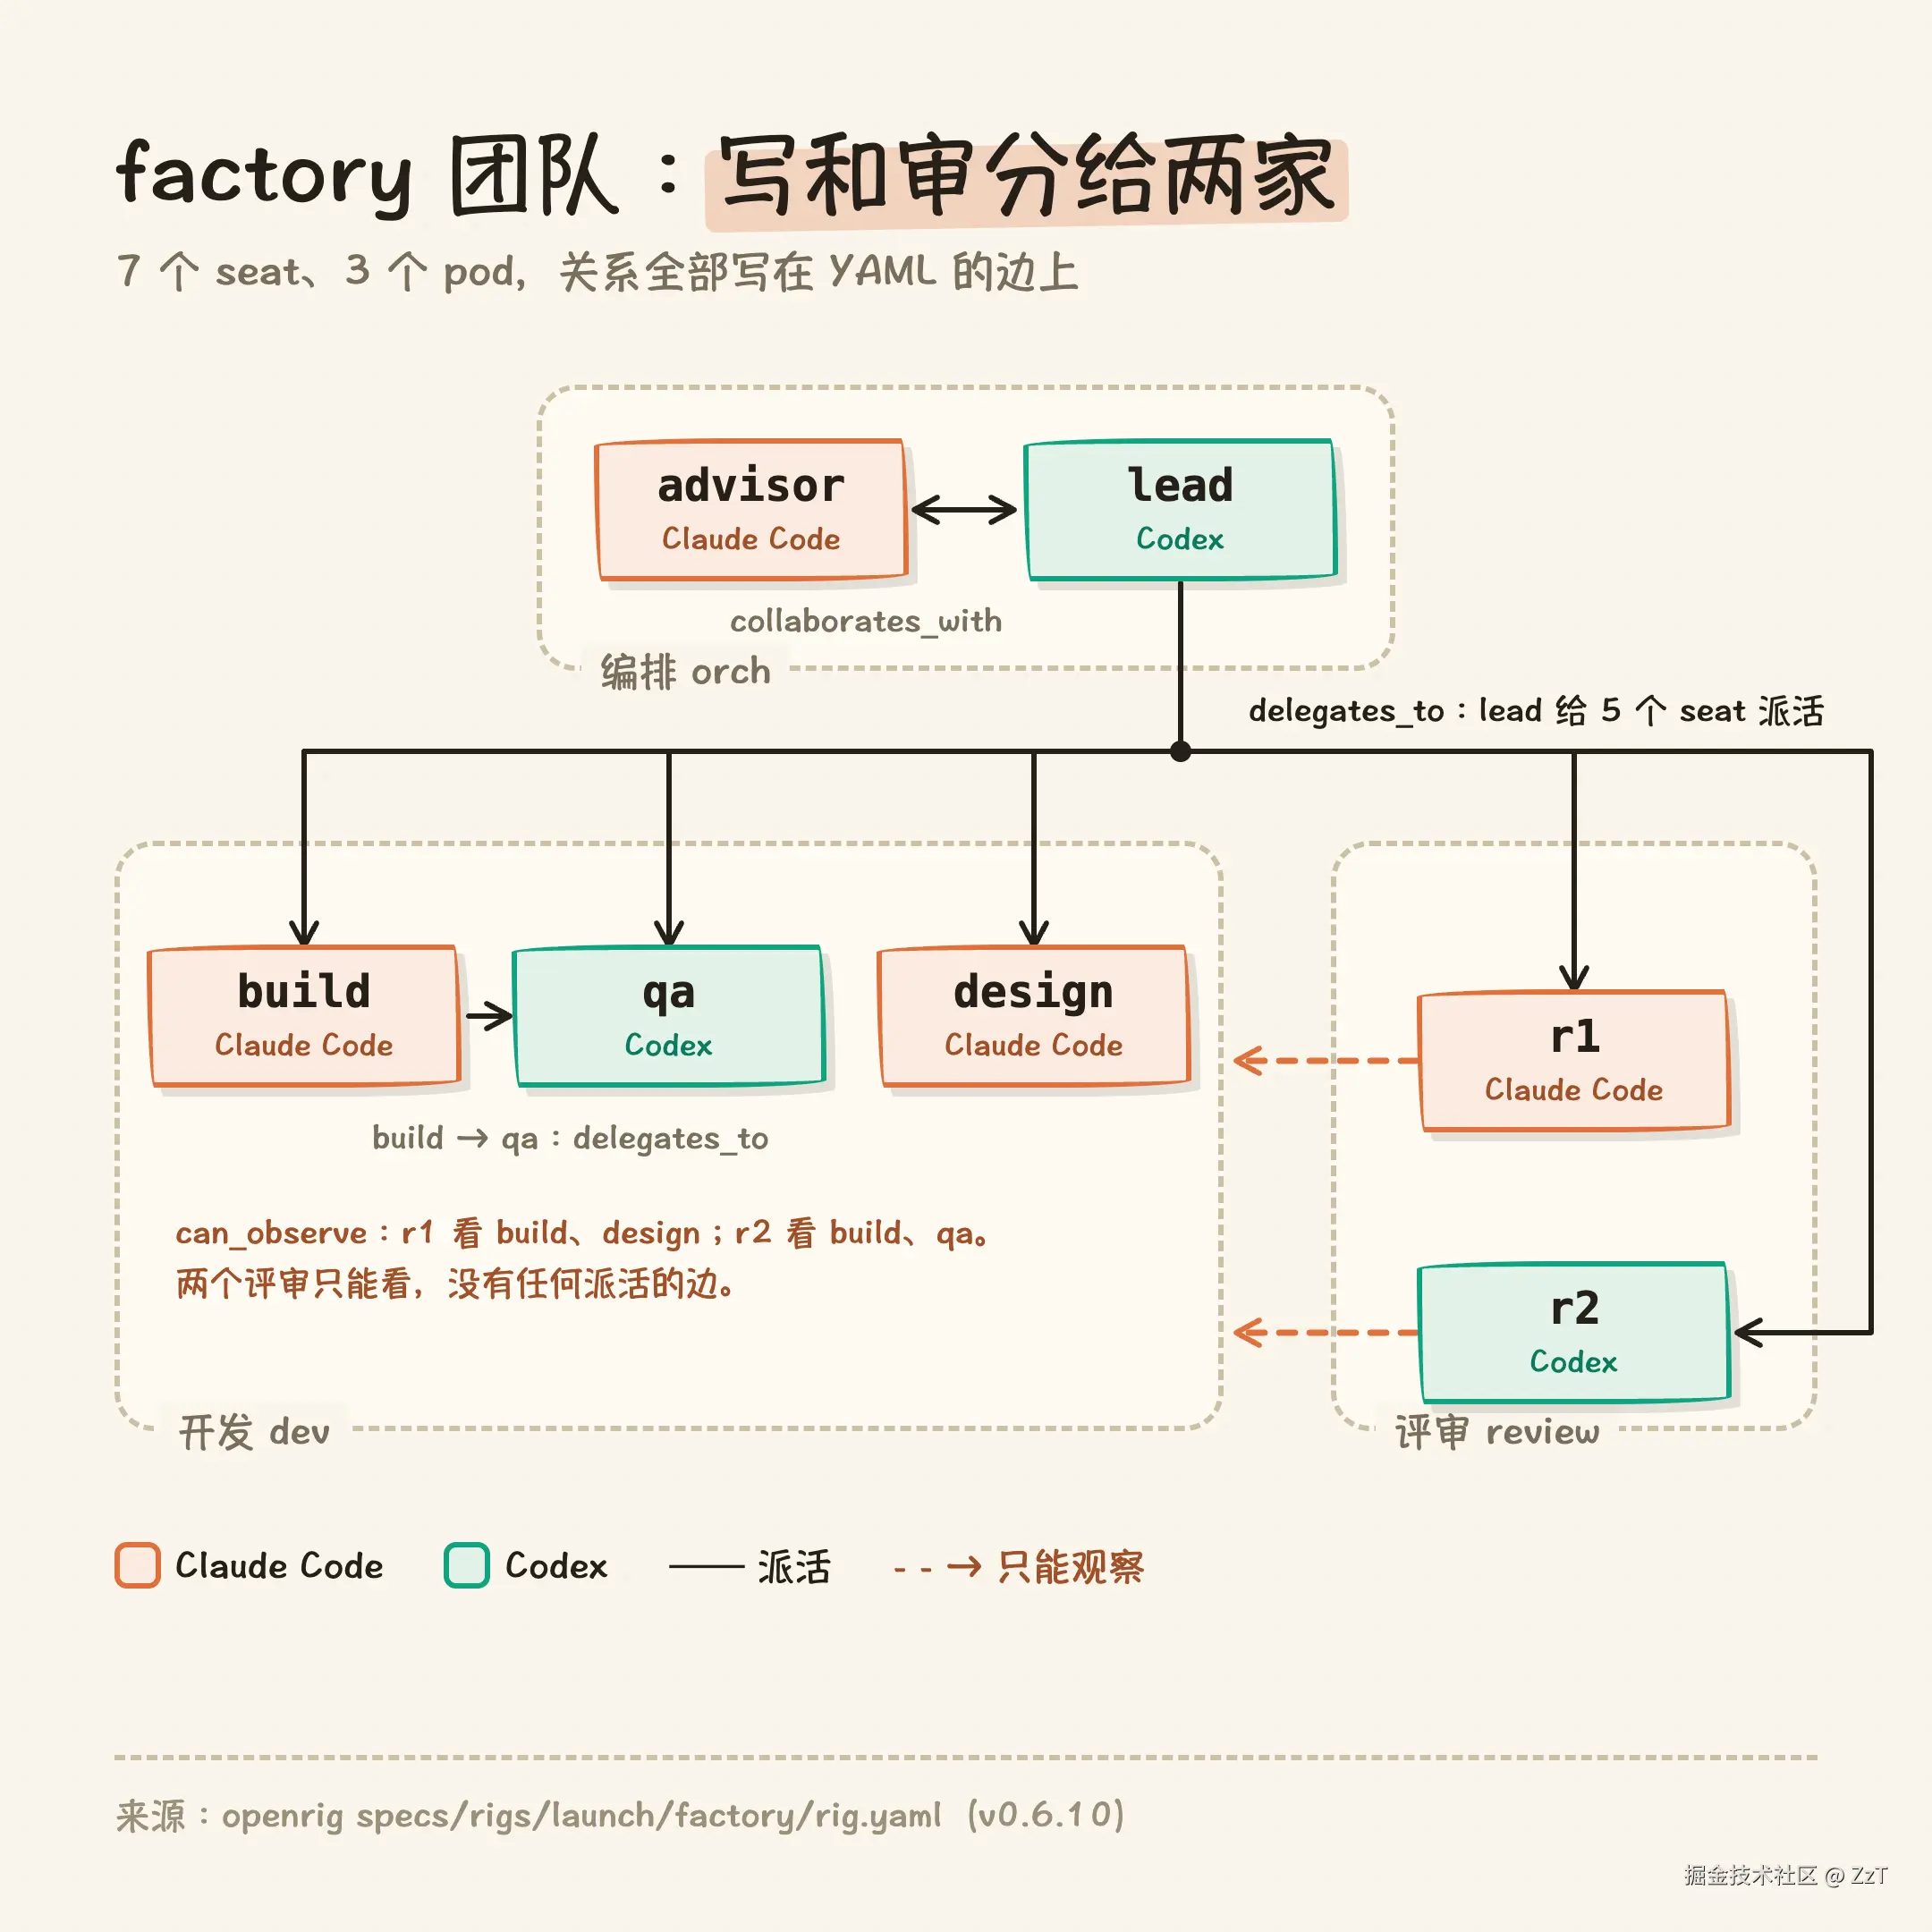 团队用一份叫 RigSpec 的 YAML 定义。最外层是 rig,下面分若干 pod,每个 pod 里有若干 member。每个 member 声明自己用哪个 runtime(
claude-code、codex、pi 等)、引用哪份 AgentSpec(角色的 skill、guidance、hook)、在哪个目录工作。启动后每个 member 成为一个 seat,地址形如 dev-build@starter:pod 是 dev,成员是 build,所在 rig 是 starter。
成员之间的关系用边表达,schema 里一共五种:
| 边 | 含义 | 是否约束启动顺序 |
|---|---|---|
delegates_to |
源给目标派活 | 是 |
spawned_by |
源由目标拉起,目标先启动 | 是 |
can_observe |
源可以查看目标的输出 | 否 |
collaborates_with |
平级协作 | 否 |
escalates_to |
源向目标升级决策 | 否 |
内置的 factory 团队是一个完整示例:编排 pod 里有 lead(Codex)和 advisor(Claude Code),开发 pod 里有 build(Claude Code)、qa(Codex)、design(Claude Code),评审 pod 里有 r1(Claude Code)和 r2(Codex)。lead 对其余五个 seat 都有 delegates_to 边;两个评审只有 can_observe 边,能看 build、design、qa 的输出,但没有任何派活关系,评审 pod 内部也没有边。
这种写法把组织结构变成了可以 review、可以 diff 的文件。改团队等于改 YAML,rig grow 和 rig shrink 可以在运行中增删 seat。
starter 团队:Claude Code 写,Codex 审
最小的内置团队 starter 只有两个 seat:build 跑 Claude Code,review 跑 Codex,一条 delegates_to 边从 build 指向 review。它的团队规则(CULTURE.md)要求 builder 在第一个有意义的改动后,把「确切的 diff 和它承诺的行为」交给 review 独立检查,并通过 rig queue handoff 交接,附上仓库路径、候选 commit、跑过的检查和已知限制。
factory 延续了同样的配对:build 是 Claude Code,qa 是 Codex;两个独立评审一个是 Claude Code,一个是 Codex。README 对这一点只写了「Claude Code and Codex in the same rig」,没有解释原因。但从内置团队的配置看,写和审被刻意分给了不同厂商的模型,这样审查不会和实现共享同一套盲区。同一个模型审自己写的代码,倾向于认同自己的推理路径;换一个模型家族,等于在流程里引入一个训练数据和偏好都不同的 reviewer。
只有一家订阅的用户也能用。安装后的 kernel operator 会把 starter 改写成单厂商版本,同名保存。
消息投递:往 tmux 面板里粘贴,再按回车
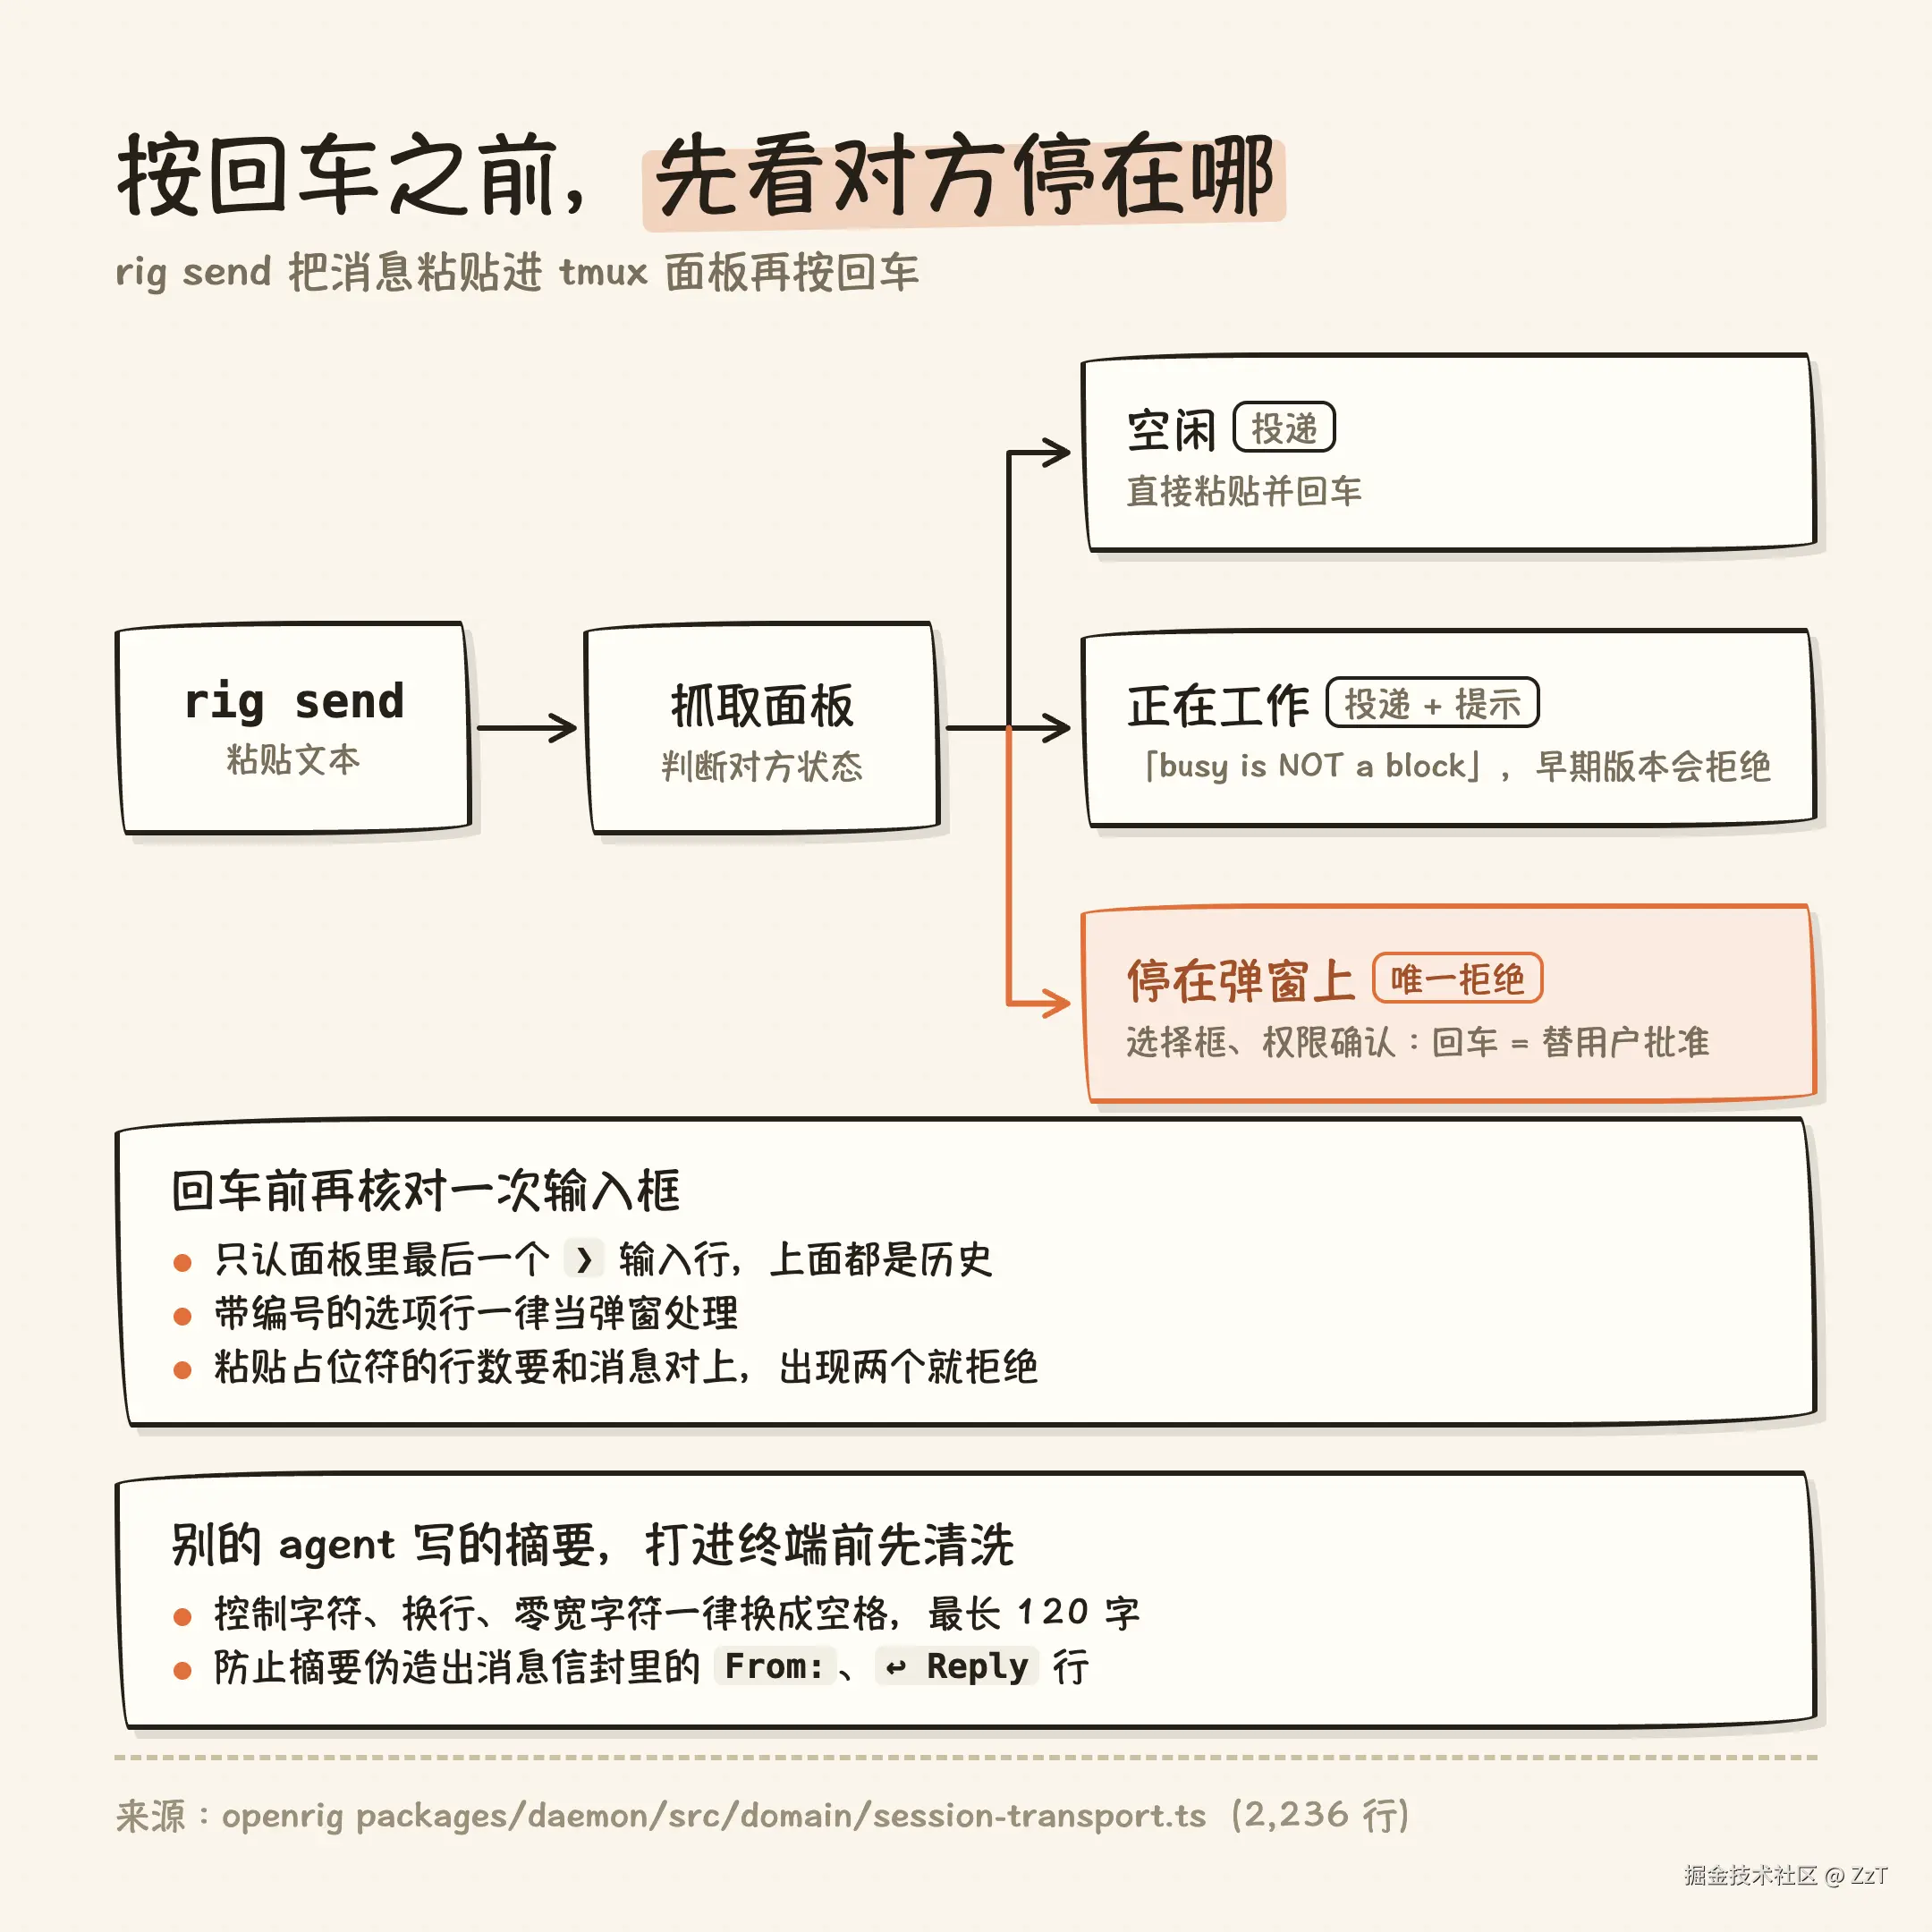 既然 agent 是没有改过的 Claude Code 和 Codex 会话,OpenRig 给它们发消息只有一个办法:把文本粘贴进 tmux 面板,然后按回车。
rig send 走的就是这条路,实现在 session-transport.ts,2,236 行。
这么长的代码主要在处理一个问题:回车按下去的时候,输入框里是不是真的是这条消息。如果目标 agent 正停在权限确认弹窗上,一个回车就等于替用户批准了一次操作。所以投递前,daemon 会抓取面板内容判断对方状态:
- 空闲:直接投递。
- 正在工作:照样投递,附一条提示。代码注释写明「busy is NOT a block」,早期版本会拒绝,后来改成了只提示,理由是不能为了等对方空闲而阻断沟通。
- 正停在选择框或权限确认上:唯一的硬拒绝。
回车之前还有一道核对:只看面板里最后一个 ❯ 输入行;带编号的选项行一律视为弹窗;粘贴后折叠成 [Pasted text #N +X lines] 的占位符,行数必须和这条消息对得上,出现两个占位符就拒绝。另一个细节是队列唤醒消息里带的摘要:摘要是别的 agent 写的,会被打进对方的终端,所以所有控制字符、换行和零宽字符都被替换成空格,防止摘要伪造出消息信封里的「From:」「↩ Reply」行。
这部分是 OpenRig 最工程化的地方。把终端当成 agent 之间的接口,好处是不依赖任何厂商的 API,代价是要自己处理终端的所有歧义。
队列才是工作记录
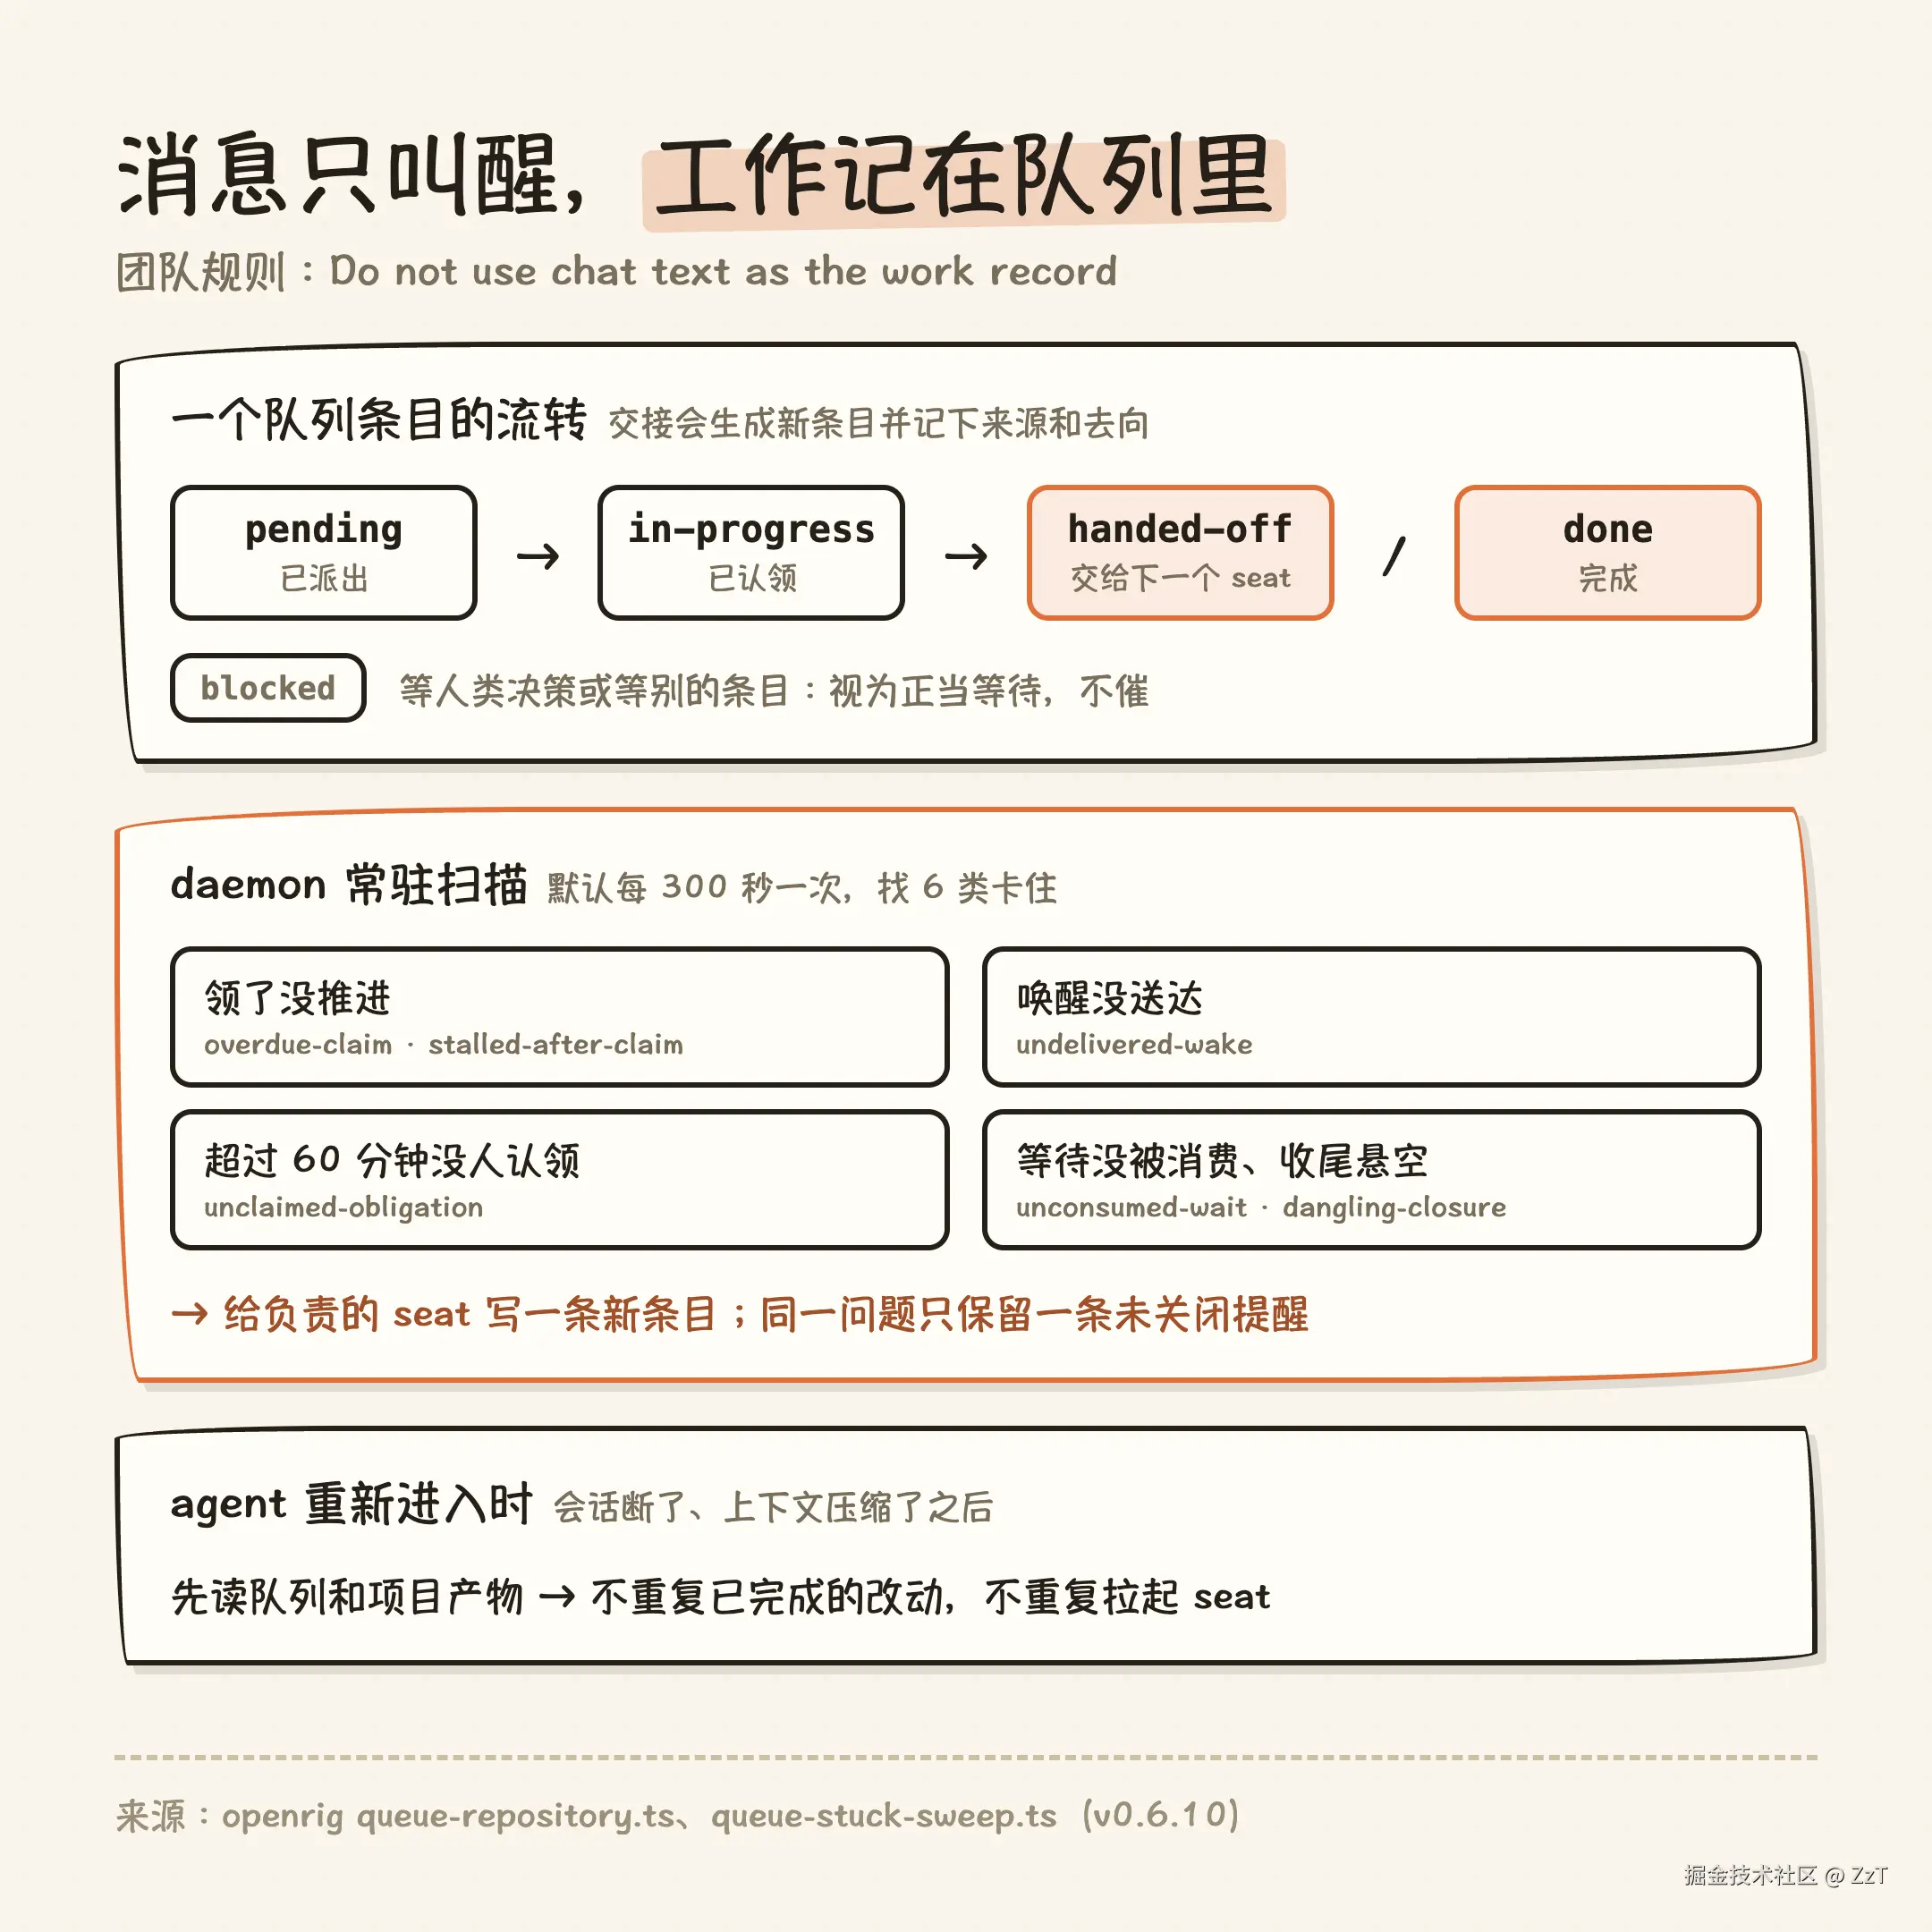 消息只负责叫醒,工作本身记在队列里。每个队列条目有来源 seat、目标 seat、状态和交接链,状态一共八种,其中仍在推进的是
pending、in-progress、blocked,正常结束的是 done 和 handed-off,另有 failed、denied、canceled。seat 拿到任务先 claim,做完 handoff 给下一个 seat,交接会生成新条目并记下 handed_off_from 和 handed_off_to。starter 的团队规则要求 agent 每次重新进入时先读队列和项目产物,不重复已完成的改动,也不重复拉起 seat。
队列的另一半是 daemon 里的常驻扫描 queue-stuck-sweep。默认每 300 秒跑一次,找六类卡住的情况,包括领了没推进、派了没送达、超过 60 分钟没人认领。找到后不在终端里喊,而是给负责的 seat 写一条新的队列条目,并按「卡住的条目 + 问题类型」去重,同一个问题只会有一条未关闭的提醒。这个扫描以前是两条需要人记得去跑的命令,源码注释里写明了改成常驻循环的原因:靠人记得去查,就会有任务悄悄卡住。
blocked 状态单独处理。等人类决策、等另一个条目完成的任务会停在 blocked,扫描把它视为正当等待,不会反复催。
seat 的地址不变,会话可以换
README 对 seat 的定义是「一个稳定的角色和地址,占据它的对话可以更换,身份和配置的上下文保留」。rig down --snapshot 保存整个拓扑,rig up <name> 按名字恢复,每个 seat 会得到一个明确的结果:原会话恢复成功、新会话加启动上下文、原会话无法恢复需要用户选择、需要人工处理、失败。每个 member 还可以在 YAML 里声明 restore_policy,三选一:能恢复就恢复、总是新开、只保存检查点。
这和队列是同一个思路。对话随时会断,所以团队靠的是地址和队列:消息发给 dev-build@starter,任务记在发给这个地址的条目上,地址后面换了哪个会话,交接链都不会断。
安装前需要知道的配置改动
OpenRig 会改动本机配置,README 用了一整节列出来,建议安装前先读并备份:
| 对象 | 改动 |
|---|---|
| Claude Code | 写入工作区信任和 onboarding 完成标记;项目内 .claude/settings.local.json 加 statusLine 和活动 hook;共享设置资源会把 permissions.defaultMode 设为 acceptEdits |
| Codex | 写 ~/.codex/config.toml:开启 hooks、加活动上报命令并预写信任哈希,工作区标记为 trusted |
| skills | daemon 启动时往 ~/.claude/skills 和 ~/.agents/skills 种入三个 skill |
| tmux | rig setup 在 ~/.tmux.conf 写入一段配置 |
默认权限是收着的:普通团队 seat 只免确认运行 rig 命令、项目读取和常见测试,rig up、rig down 这类生命周期命令仍然会问;YOLO 默认关闭。例外是管理整个实例的 kernel rig,它的 Codex seat 默认以 -s danger-full-access -a never 启动。活动上报只发事件类型、seat 身份和时间戳,不含 prompt 文本和工具参数。README 也写明,这些写入没有完整的回滚保证。
对自建多 agent 的参考
| 你的情况 | 可以借鉴的做法 |
|---|---|
| 已经在多个终端里同时开 Claude Code 和 Codex | 先给每个会话一个固定地址和角色,再谈编排 |
| agent 之间靠聊天交接任务 | 把任务移到 agent 之外的存储里,消息只用来唤醒 |
| 担心任务悄悄卡住 | 用常驻扫描代替「记得去查」,发现问题写成新任务派回负责人 |
| 想让 agent 互相 review | 写和审用不同厂商的模型,审查方只给观察权不给派活权 |
| 要往 agent 终端里自动发消息 | 回车前确认输入框里是你的消息,权限弹窗上绝不按回车 |
| 单人、单仓库、一次性小改动 | 不需要 OpenRig,一个会话加 subagent 足够 |
OpenRig 的价值不在于让 agent 变聪明,而在于让一个团队在会话断开、上下文压缩、机器重启之后还能接着干。它为此付出的工程量,主要花在 agent 之外:队列、扫描、快照,以及 2,000 多行确保回车按对地方的代码。
参考
- OpenRig 仓库:github.com/mvschwarz/o...
- RigSpec 文档:github.com/mvschwarz/o...
- harness 工程实践合集:github.com/androidZzT/...