本文是「Spring Boot + AI 全栈后端」系列第 06 篇。前五篇我们解决了"能不能对话""成本能不能降""输出有没有形状""能不能查实时数据"这些问题,这一篇处理一个更普遍的痛点:模型根本不知道你们公司自己写的那份手册。示例基于 Spring AI 2.0 / Boot 4.1。
一个让售后背锅的场景
V哥 给一家做工业真空机组的客户做方案时,他们的售后总监倒了一肚子苦水。厂里卖的是 VM-200 型真空机组,客户买了设备,遇到问题就打电话问:
- "这台机器保修多久?"
- "控制面板上显示 E-04 是什么意思?"
- "过保了上门维修怎么收费?"
答案全都写在《VM-200 产品手册》《操作指南》《2025 版售后政策》这三份文档里,加起来两百多页。但接电话的是人,新人背不下;老员工凭记忆,偶尔记串。于是他们把希望寄托在 AI 上,接了个通用大模型做客服助手。
结果更糟。客户问"VM-200 保修多久",模型挺自信地回答"通常这类工业设备保修一年"------它是照着行业常识推测的,根本没有读过他们家的保修条款。而真实的条款是"整机 24 个月、真空泵主机 36 个月、密封圈等易耗件不在保修范围"。客户拿着这个"一年"的答复去索赔,售后只能背锅。
问题到这里非常具体了:不是模型不会说话,是它的脑子里压根没有你公司这份私有资料。通用模型有海量常识,但常识里没有你的产品型号、你的保修政策、你上个月刚改的价格表。
为什么"让它学一遍"行不通
遇到这个问题,团队通常先想到三条路,我在这里一并说清它们为什么都不合适:
一是把整本手册塞进提示词。 两百页文档,几十万字,一次对话塞不下;就算塞下了,模型也会被无关内容稀释注意力,命中率反而下降,token 费用还照单全收。
二是微调。 让模型"记住"手册内容。问题是产品手册一个月改一次,你打算每月微调一次?成本和时间都不现实,而且微调记进去的知识依然可能胡编,因为它并没有真的"查"。
三是给每个人发 PDF 让他自己搜。 那还要 AI 干什么?
真正卡住的是三件事连在一起:模型没有 你的私有知识、加上它不敢说不知道 、于是它只能用常识编一个像答案的答案。第三件才是最可怕的------错误答案听着比"我不知道"专业多了。
解决思路:先检索,再让它照着资料说
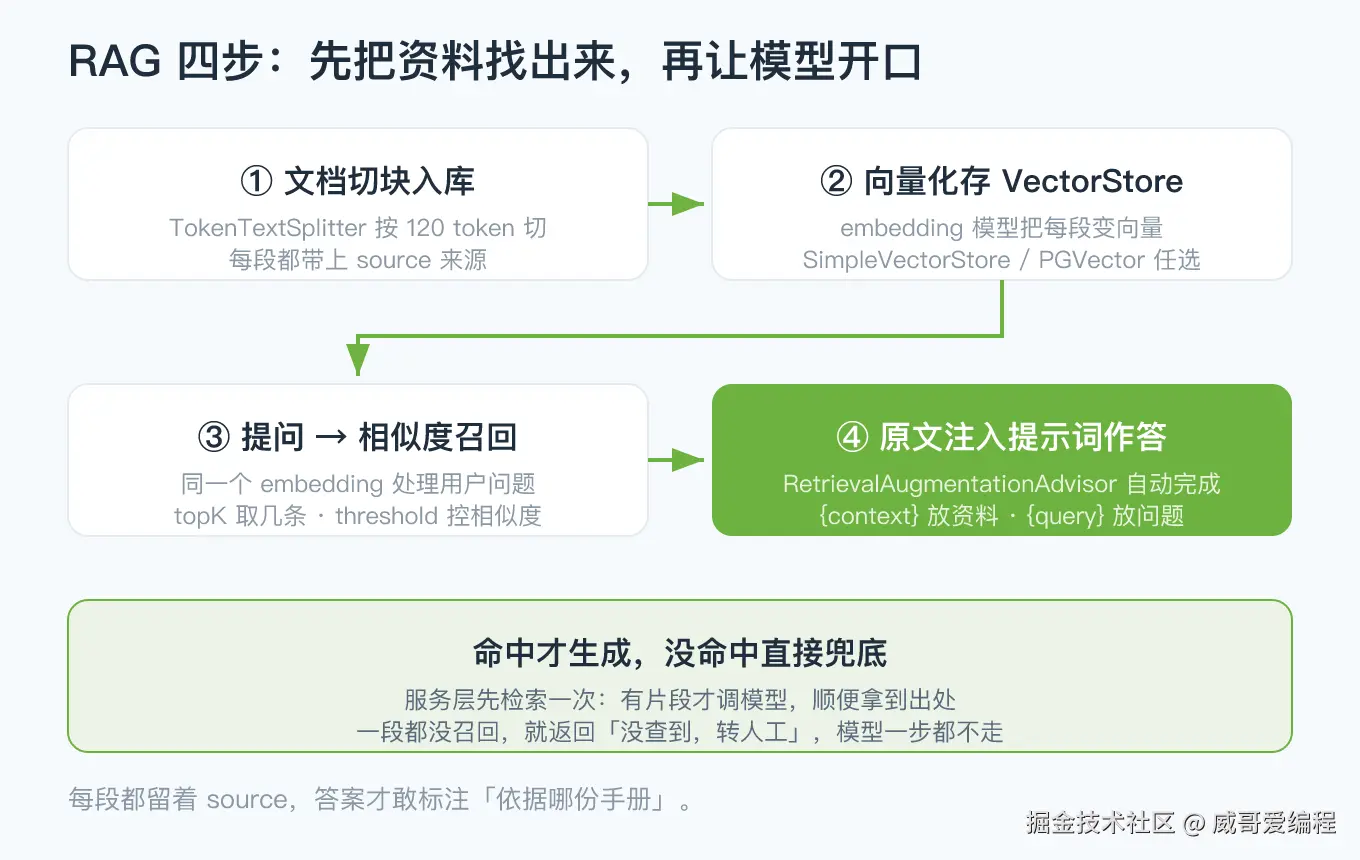
RAG(Retrieval-Augmented Generation,检索增强生成)的思路朴素得不能再朴素:
- 入库:把手册切成小段,每段算出一个向量(embedding),存进向量库;
- 检索:用户提问时,把问题也做成向量,去库里找最相似的几段;
- 增强生成:把这几段原文塞进提示词,告诉模型"只准照着这些资料回答";
- 兜底:一段都没命中,就直接说"没查到",不许它自由发挥。
第 3、4 步是整套方案的价值所在------模型从"靠记忆答题"变成"开卷考试,而且监考老师看着"。
第一步:文档切块,别整篇扔进去
切块(chunking)这一步容易被新手跳过,但它直接决定召回质量。整篇手册作为一个片段,就意味着"任何问题都会召回整篇",等于没召回。
Spring AI 提供了 TokenTextSplitter,按 token 数量切,并且尽量在句号、分号这些地方断开:
java
@Service
public class KbIngestService {

    private final VectorStore vectorStore;
    private final TextSplitter splitter;

    public KbIngestService(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
        this.splitter = TokenTextSplitter.builder()
                .withChunkSize(120)
                .withMinChunkSizeChars(20)
                .withKeepSeparator(true)
                .build();
    }

    public int ingest(List<KbDoc> docs) {
        List<Document> chunks = docs.stream()
                .flatMap(doc -> splitter
                        .split(new Document(doc.content(), Map.of("source", doc.title())))
                        .stream()
                        .peek(chunk -> chunk.getMetadata().put("source", doc.title())))
                .toList();
        vectorStore.add(chunks);
        return chunks.size();
    }
}
KbDoc 只是标题和正文两个字段的记录:
java
public record KbDoc(String title, String content) {
}
注意那句 peek:每段我们都把来源标题写进 metadata。这是后面"答案能给出处"的前提------没有来源的片段,等于没有引用价值的答案。
第二步:向量库,选哪个都不影响业务代码
Spring AI 把向量库抽象成 VectorStore,内存版、PGVector、Milvus、Redis、Elasticsearch 等等,业务层看到的都是同一个接口。想离线把逻辑跑通,用最简单的 SimpleVectorStore 就行:
java
@Configuration
public class KbTestConfig {

    @Bean
    @Primary
    EmbeddingModel embeddingModel() {
        return new StubEmbeddingModel();
    }

    @Bean
    VectorStore vectorStore(EmbeddingModel embeddingModel) {
        return SimpleVectorStore.builder(embeddingModel).build();
    }
}
上线的项目换成 PGVector,也只是在同一个地方换掉这个 bean------引入 spring-ai-starter-vector-store-pgvector 依赖,配置数据库连接即可,KnowledgeBaseService 一行都不用改。这就是抽象的价值:存储选型改到最后,也只是配置层的事。
第三步:问答------把检索到的资料塞进提示词
这一步 Spring AI 给了现成的 advisor:RetrievalAugmentationAdvisor。它在调用模型之前先执行一遍检索,把命中的片段拼进提示词,再发给你惯用的模型。
java
@Service
public class KnowledgeBaseService {

    private final VectorStore vectorStore;
    private final ChatClient chatClient;
    private final int topK;
    private final double similarityThreshold;

    public KnowledgeBaseService(ChatModel chatModel,
                                VectorStore vectorStore,
                                @Value("${kb.top-k:3}") int topK,
                                @Value("${kb.similarity-threshold:0.35}") double similarityThreshold) {
        this.vectorStore = vectorStore;
        this.topK = topK;
        this.similarityThreshold = similarityThreshold;
        this.chatClient = ChatClient.builder(chatModel)
                .defaultSystem(SYSTEM)
                .defaultAdvisors(RetrievalAugmentationAdvisor.builder()
                        .documentRetriever(VectorStoreDocumentRetriever.builder()
                                .vectorStore(vectorStore)
                                .topK(topK)
                                .similarityThreshold(similarityThreshold)
                                .build())
                        .queryAugmenter(ContextualQueryAugmenter.builder()
                                .promptTemplate(new PromptTemplate(AUGMENT_TEMPLATE))
                                .emptyContextPromptTemplate(new PromptTemplate(EMPTY_CONTEXT_TEMPLATE))
                                .allowEmptyContext(false)
                                .build())
                        .build())
                .build();
    }
}
RetrievalAugmentationAdvisor 做三件事:用 VectorStoreDocumentRetriever 取回片段(topK 控制取几条、similarityThreshold 控制多相似才算数),交给 ContextualQueryAugmenter 把资料拼进模板,最后把增强后的 prompt 发给模型。
模板必须换成中文,而且兜底模板有个坑
默认的模板是英文的,用在中文客服系统里有两个问题:一是风格不统一,二是它会在没检索到时允许模型基于常识回答。所以两个模板都自己写:
java
public static final String AUGMENT_TEMPLATE = """
        请依据下面的资料回答用户的问题。只使用资料中的内容,资料里没有就说不知道。

        资料:
        {context}

        用户问题:{query}
        """;

public static final String EMPTY_CONTEXT_TEMPLATE = """
        当前知识库里没有任何与用户问题相关的资料。
        请直接回复:"抱歉,这个问题在我们的产品手册和售后政策里没查到依据,我帮您转人工核实。"
        不要尝试用常识作答,也不要做任何推测。
        """;
这里有个 2.0.1 的实际坑,V哥 踩过一次:正常模板里的变量是 {query} 和 {context},但兜底模板渲染时框架不传任何变量 ------默认的兜底模板本身连一个占位符都没有。你要是在 EMPTY_CONTEXT_TEMPLATE 里写 {query},运行时就直接抛"Not all variables were replaced"。兜底话术要么写死成静态文案,要么自己在服务层拼好后传进去。
关键一步:没查到,就别让它编
很多 RAG 教程到上一步就结束了,但真正决定系统敢不敢上线的是这一段------前置一次检索,自己判断是否命中:
java
public KbAnswer answer(String question) {
    List<Document> hits = vectorStore.similaritySearch(SearchRequest.builder()
            .query(question)
            .topK(topK)
            .similarityThreshold(similarityThreshold)
            .build());

    if (hits.isEmpty()) {
        return KbAnswer.miss(question);
    }

    String answer = chatClient.prompt()
            .user(question)
            .call()
            .content();
    return new KbAnswer(question, answer, sourcesOf(hits), true);
}

/** 出处去重,答案里挨着的同一份手册不必重复列出。 */
private static List<String> sourcesOf(List<Document> hits) {
    return hits.stream()
            .map(hit -> String.valueOf(hit.getMetadata().getOrDefault("source", "未标注来源")))
            .distinct()
            .toList();
}
为什么还要再检索一次?因为它换来三样东西:
- 出处 :
sourcesOf(hits)拿到了回答依据了哪几份手册,前端可以显示"本答复依据《VM-200 产品手册》",客户查得到、法务认得出; - 硬拦截:一段都没命中时直接返回兜底话术,连模型都不调------既省钱,也从根上杜绝了编造;
- 可审计 :每一次回答是不是"有据可依",用
grounded这个布尔值记下来,方便后面做人工抽检。
KbAnswer 就是干这事的:
java
public record KbAnswer(String question, String answer, List<String> sources, boolean grounded) {

    static KbAnswer miss(String question) {
        return new KbAnswer(question, MISS_MESSAGE, List.of(), false);
    }

    public static final String MISS_MESSAGE =
            "抱歉,这个问题在我们的产品手册和售后政策里没查到依据,我帮您转人工核实。";
}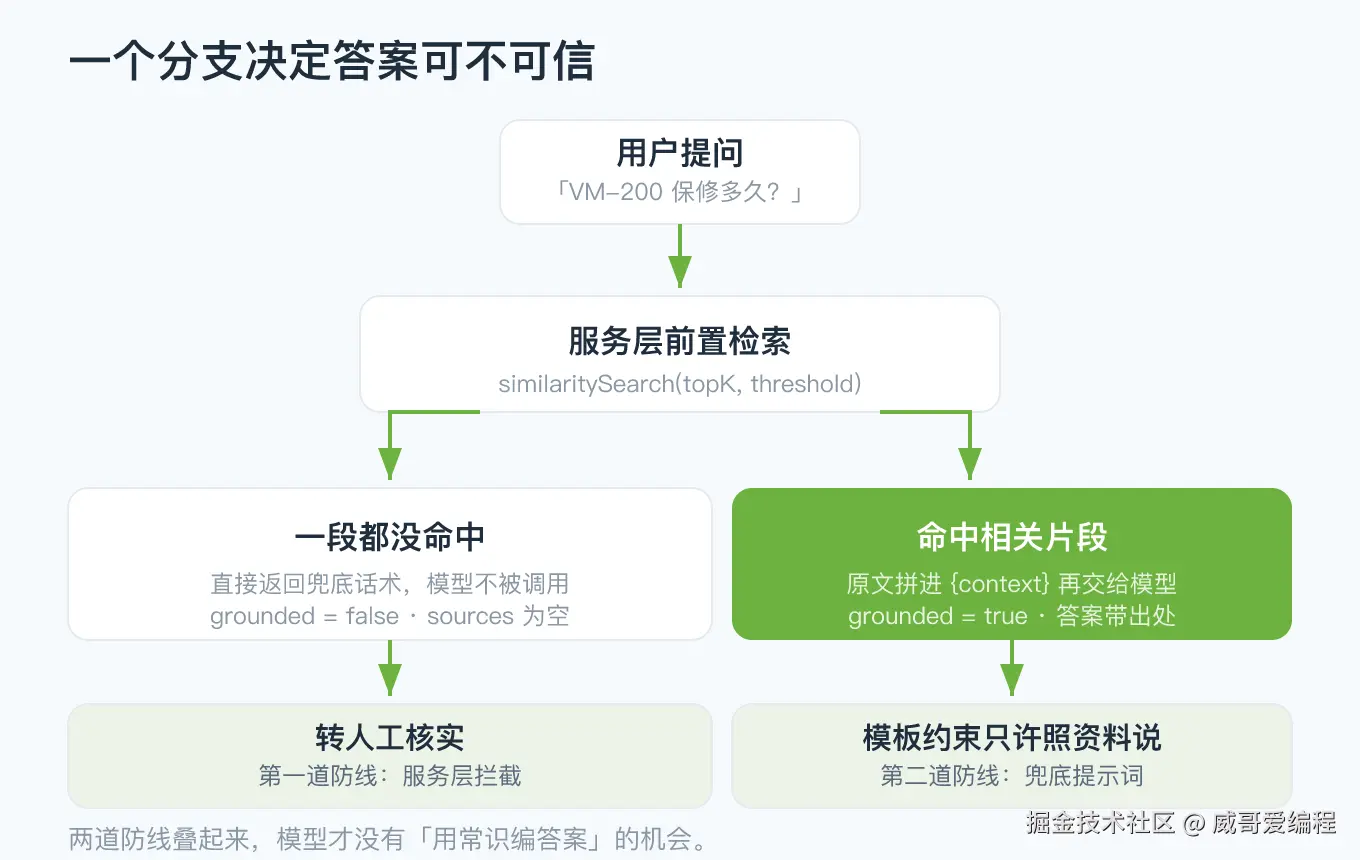
于是你有两道防线:服务层的前置拦截是第一道,ContextualQueryAugmenter 的 EMPTY_CONTEXT_TEMPLATE 是第二道------哪怕有人绕过服务层直接调 advisor,模型收到的依然是"请告诉用户没查到",而不是裸的那个问题。
对外接口就两个,一个灌库一个问答:
java
@RestController
@RequestMapping("/api/kb")
public class KnowledgeBaseController {

    private final KbIngestService ingestService;
    private final KnowledgeBaseService knowledgeBaseService;

    public KnowledgeBaseController(KbIngestService ingestService,
                                   KnowledgeBaseService knowledgeBaseService) {
        this.ingestService = ingestService;
        this.knowledgeBaseService = knowledgeBaseService;
    }

    @PostMapping("/ingest")
    public ResponseEntity<Map<String, Integer>> ingest(@RequestBody KbIngestRequest request) {
        int chunks = ingestService.ingest(request.docs());
        return ResponseEntity.ok(Map.of("chunks", chunks));
    }

    @PostMapping("/ask")
    public ResponseEntity<KbAnswer> ask(@Valid @RequestBody KbAskRequest request) {
        return ResponseEntity.ok(knowledgeBaseService.answer(request.question()));
    }
}
怎么验证:离线也能把这套链路跑通
RAG 看着链路长,但每一环都能在没有密钥、没有网络的环境里验证。重点验证这几件事:
- 切块与召回:手册灌进去之后,问"VM-200 保修多久",能不能召回包含"24 个月"的那一段;
- 片段真的进了提示词:用一个会记录收到内容的桩模型,断言它收到的用户消息里含手册原文------这一步证明增强是"真的发生了",而不是你以为发生了;
- 答案带出处 :同一个问题返回的
sources里应当有《VM-200 产品手册》;问"E-04 是什么意思"则应当来自《VM-200 操作指南》; - 无关问题走兜底 :问"公司团建去哪里玩",应当返回
grounded = false、sources为空、答案是"转人工",且根本没有调用模型; - 兜底模板生效:单独用 advisor 问那个无关问题,桩模型收到的应当是兜底话术,而不是原问题;
- 入参校验:空问题返回 400。
向量化那一环不需要真实 embedding 模型:把文本按词哈希成固定维度向量、再做归一化,就能让"共享词越多余弦相似度越高"。它当然没有真实 embedding 模型的语义能力,但验证逻辑够用了;真上线换成 OpenAI / 国产 embedding,业务代码一个字不动。
落地要点
- 阈值要自己调 :
similarityThreshold不是拍脑袋定的。0.35 是个起步值,具体要拿真实问题一批一批试------设高了答"不知道",设低了召回垃圾;把这个数放到配置里(kb.similarity-threshold),上线后还能热改。 - 切块大小跟着业务走:手册段落清晰就用小块(100-200 token),法律条款这种前后关联强的用大块,必要时让相邻片段重叠一部分,避免一句话被切成两半。
- 来源元数据别省 :售价表、售后政策、培训手册混在一个库里时,少了
source字段的片段既没法给前端展示出处,也没法按文档做权限过滤。 - 入库要幂等、要能增量更新:文档改了就重新灌,别让旧版本留在库里和客户说话;生产上给每份文档一个版本号,按版本覆盖。
- 权限别忘:知识库里可能有机密报价、内部政策,按用户角色过滤 handler 后再检索,比事后审核便宜得多。
- 成本账要算两次:一次是 embedding 入库的开销(一次性),一次是每次问答 embedding 的成本(持续)。文档总量大时,增量入库很重要。
最后 V哥 总结一句
通用模型最大的问题从来不是"不会说话",而是"没有读过你写的东西,还能说得很自信"。RAG 干的事,就是先把你的手册找出来,再把它的嘴按在资料上------答得出来给依据,答不出来就老老实实说没查到。带上出处的答案才敢给客户看,答不上来会喊停的助手才敢上线。
下一篇(07)V哥 带你解决更难的一步:单轮问答搞不定的多步运营任务------查数据、算出图、再发周报,这种一串动作的任务,怎么交给 Agent 自动跑完。
最后一句:别再把几百页手册塞进提示词赌模型记住------切成块存进向量库,问一句召回一段,让它在你的资料里开卷作答,答得出给依据、答不出转人工,这才叫能落地的企业知识库。