排序的概念:
1.基本概念:
排序是指将一组数据元素(或记录)的任意序列,根据其中一个或多个关键字的大小,重新排列成一个按关键字递增(升序)或递减(降序)的有序序列的过程
生产中排序的对象通常是结构体,只排数字没有太大的实际意义,例如各大学的综合排名,某游戏的综合得分排序等等
2.常见的排序分类:
常见的排序算法主要分为两大类:比较类排序 和非比较类排序。
比较类排序
比较类排序通过比较元素之间的大小关系来决定顺序,时间复杂度下界为 O(n log n)。常见的有:
- 交换排序:冒泡排序、快速排序
- 插入排序:直接插入排序、希尔排序
- 选择排序:简单选择排序、堆排序
- 归并排序:二路归并排序、多路归并排序
非比较类排序
非比较类排序不通过元素间的比较来确定顺序,而是利用数据本身的特性,时间复杂度可达到 O(n)。常见的有:
- 计数排序
- 基数排序
- 桶排序
各类排序算法对比
补充:
- 评价算法的指标包括平均时间复杂度,空间复杂度,以及稳定性(排序前后,相等元素的相对次序保持不变,则称该排序是稳定的)
- 针对排序甚至数据结构的具体过程,有两个对外开放的动图网站可以作为参考:
新加坡国⽴⼤学 (NUS) 计算机学院的教授 Steven Halim 博⼠牵头创建的:
https://visualgo.net/en/sorting
美国旧⾦⼭⼤学 (University of San Francisco) 计算机科学系 的官⽅⽹站:
https://www.cs.usfca.edu/\~galles/visualization/ComparisonSort.html
-
由于排序涉及大量数据的移动,使用数组等顺序存储的效率更高,下面会默认使用顺序存储;
-
分类如下:
| 排序算法 | 平均时间复杂度 | 空间复杂度 | 稳定性 |
|---|---|---|---|
| 冒泡排序 | O(n²) | O(1) | 稳定 |
| 快速排序 | O(n log n) | O(log n) | 不稳定 |
| 直接插入排序 | O(n²) | O(1) | 稳定 |
| 希尔排序 | O(n^1.3) | O(1) | 不稳定 |
| 简单选择排序 | O(n²) | O(1) | 不稳定 |
| 堆排序 | O(n log n) | O(1) | 不稳定 |
| 归并排序 | O(n log n) | O(n) | 稳定 |
| 计数排序 | O(n + k) | O(k) | 稳定 |
| 基数排序 | O(n × k) | O(n + k) | 稳定 |
| 桶排序 | O(n) | O(n) | 稳定 |
直接插入排序:
1. 基本思想:
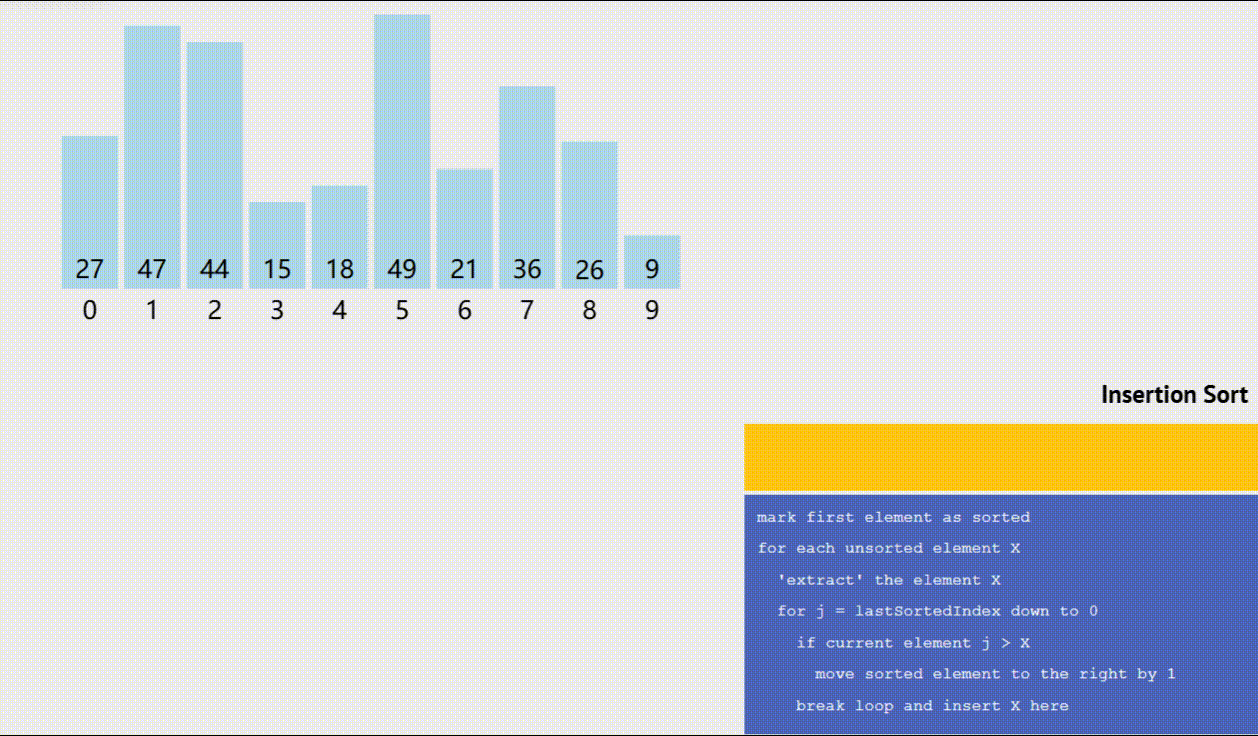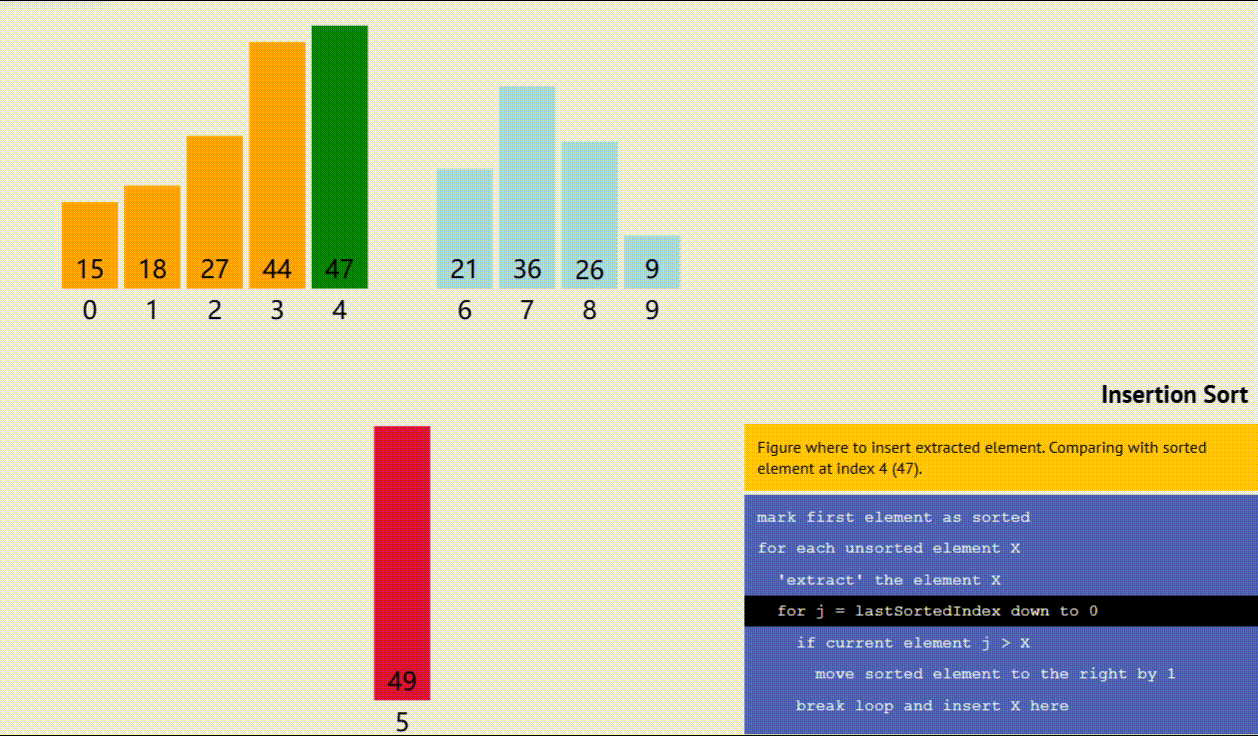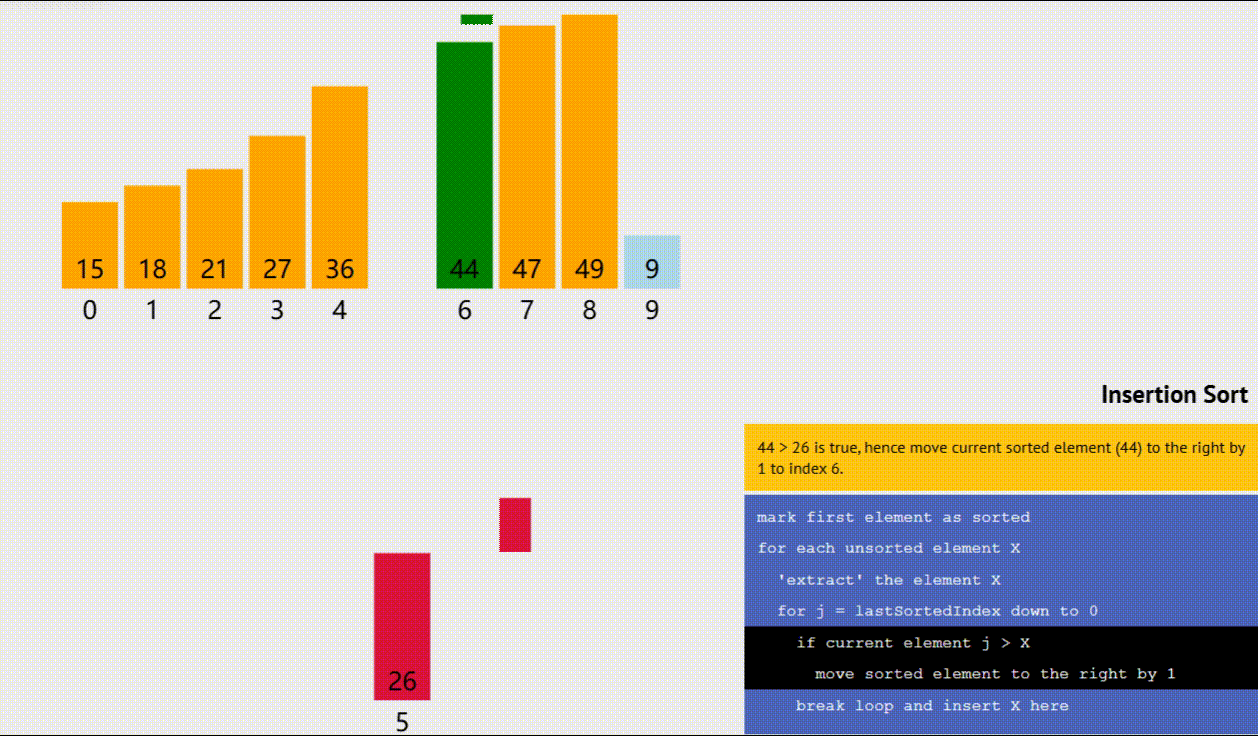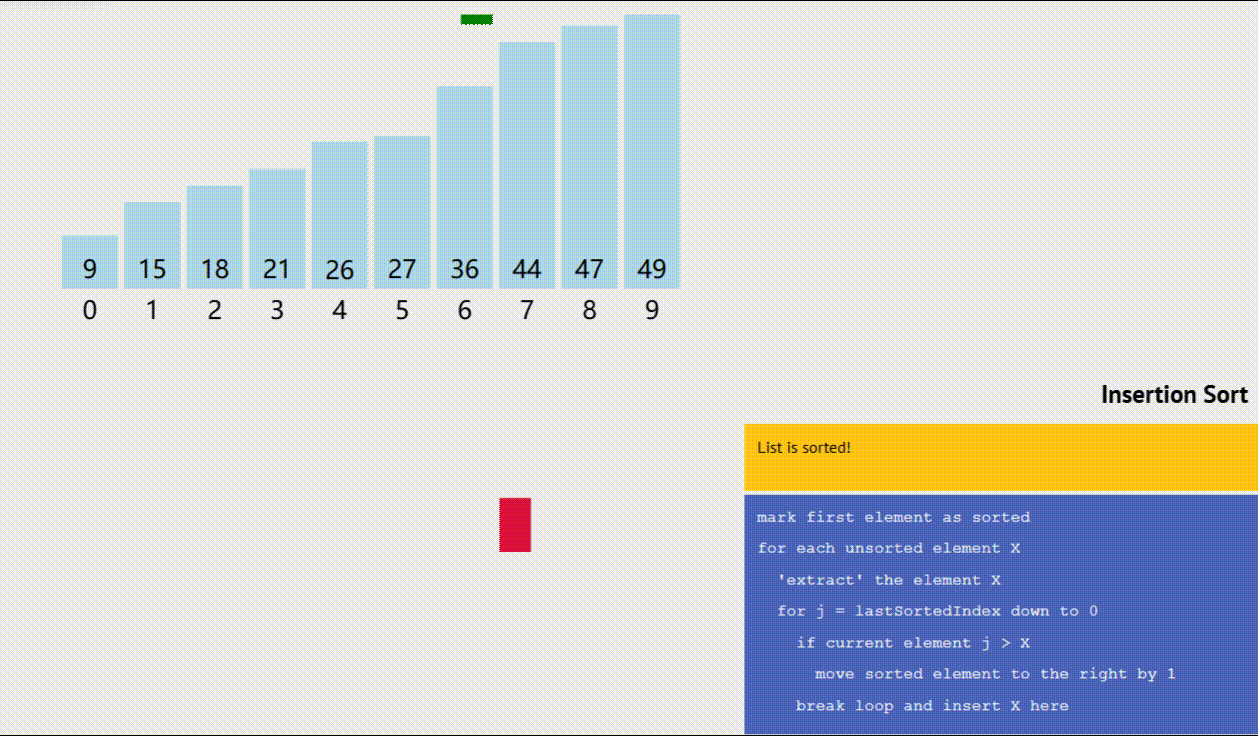
插入排序是一种简单直观的排序算法,其核心思想是构建有序序列,通过逐个将未排序的元素插入到已排序部分的正确位置来完成排序。
就好比斗地主整理扑克,需要将新的牌和拿到的排序好的牌进行比较,选择合适的位置放进去
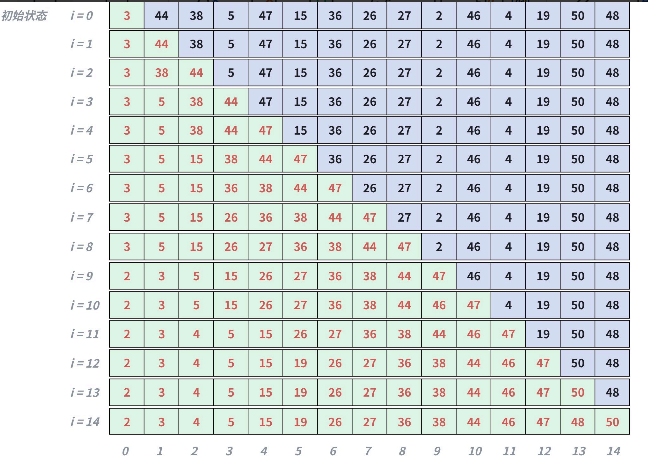
2.代码实现:
c
void Insert_sort(int*arr,int n)
{
	//先写单次比较过程,再套循环
	for (int i = 0; i < n-1; i++)
	{

		int end = i;
		//单次比较过程:
		//已排序部分是[0,end]
		int temp = arr[end + 1];

		//然后开始比较,而且需要循环,结束条件是比完了仍没有找到位置,超出了已排序部分
		while (end >= 0)
		{
			if (temp < arr[end])
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else {
				break;
			}
		}
			arr[end + 1] = temp;
	}

}
3.复杂度及稳定性:
时间复杂度:O(n2)
最好情况是本来就是升序,需要升序排列,时间复杂度为O(n);
最坏情况是本来是升序,但需要降序排列,时间复杂度为O(n2);
空间复杂度:O(1)
直接插⼊排序只需要常数个辅助变量,空间复杂度为 O(1);
稳定性:稳定
直接插入排序的稳定性由其插入逻辑决定:相等元素之间不发生位置交换,仅在必要时插入到正确位置,从而维持原有顺序。
4.折半插入排序
基本思想:
在直接插入排序的基础上增加了二分查找的方法,减少了一定的比较次数,但如果存在大量数据,其时间复杂度仍然是O(n2),相比代码简洁,缓存友好,容易被作为其他排序算法的子过程的直接插入排序,折半插入排序的使用场景并不多,作为了解就行
代码实现:
c
void InsertSortMid(int* a, int n) {
	// [0, n-1]
	for (int i = 0; i < n - 1; i++) {
		// [0,end]有序 end+1位置的值插⼊[0,end],保持有序
		int end = i;
		int key = a[end + 1];
		// 利⽤⼆分查找找待插⼊元素在前⾯已有序部分的位置
		// left > right时,left指向第⼀个⼤于key的值
		int left = 0, right = end;
		while (left <= right) {
			int mid = (left + right) / 2;
			if (key < a[mid])
				right = mid - 1;
			else
				left = mid + 1;
		}
		// 将[left, end]之间的元素整体往后搬移⼀个位置
		for (int j = end; j >= left; j--)
			a[j + 1] = a[j];
		// 插⼊key
		a[right + 1] = key;
	}
}
希尔排序
1.背景:
直接插入排序代码简单,它还有两个优点,当数据基本有序时,效率很高;当数据量较少时,效率很高。为了让插入排序在大量乱序的数据下效率更高,有个叫希尔的人,基于这两项优点开发出了希尔排序
2.基本思想:
插入排序适合数据少的情况,所以我们要对数据进行分组,分组的区间由增量d 表示,一般是数据的个数除2且向下取整 ,然后将每组对应的数据相互进行插入排序 ,将分组的数据变得相对有序 能有效增加效率,之后将增量d除2且向下取整 ,再次重复进行插入排序直到d为1
可以发现,希尔排序在插入排序的基础上,用分组的方式将大量数据分成小部分数据比较,然后在数据相对有序后再对所有数据插入排序,充分发挥了插入排序的两个优点
3.代码实现:
c
void Shell_sort(int* arr, int n)
{
	//1.希尔排序,需要对一组数据分组并进行插入排序,那首先写一个插入排序,令[0,end]为有序区域,end+1就是待比较数据,
	// 同时需要一个临时变量来防止数据被覆盖
	int d = n;
	while (d > 1)
	{
		d = d / 2;//4.d可以自己调整,但要保证最后的取值为1

		for (int i = 0; i < n - d; i++)
		{
			int end = i;//3.一趟循环相当于排序了每组的第一个,还需要一趟循环排每组的第二个第三个...
			int temp = arr[end + d]; //2.由于分组,间距是d,需要对每组对应的数据插入排序

			while (end >= 0)
			{
				if (temp < arr[end]) {
					arr[end + d] = arr[end];
					end = end - d;
				}
				else {
					break;
				}
			}
			arr[end + d] = temp;
		}
	}
}
4.复杂度及稳定性:
时间复杂度:不确定
由于希尔排序的时间复杂度会受到增量d的影响,而不同的d又会因为数据的不同产生不同的效果,导致时间复杂度不确定,比如希尔本人提出d=n/2,但当数据中奇数都为较小的值,偶数都为较大的值,就会导致时间复杂度趋向O(n2),而Knuth提出的d=n/3+1,+1是为了让d不等于0,经过证明最坏时间复杂度在O(n1.5),平均大概在O(n1.25),我们通常使用这两项
增量序列的选择是希尔排序的核心,不同序列影响复杂度
空间复杂度:O(1)
稳定性:不稳定
相同的数据可能经过不同的分组排序导致原本的顺序调换,所以是不稳定的