搭一个像样的 AI 应用,存储这一层经常要拼三样东西:关系库存业务状态,向量库存 embedding,图库存实体关系,再写胶水代码在三个系统之间保持同步。每多一个系统,就多一份一致性负担和运维成本。HelixDB 的想法是把这三件事装回一个引擎:一个用 Rust 写的开源数据库,数据模型是属性图,向量检索和 BM25 全文搜索是建在图之上的两条访问路径,所有数据放在对象存储上。项目在 GitHub 上是 HelixDB/helix-db,Apache 2.0 协议,2026 年 10 月 star 数在 6100 上下,背后是一家 YC 系公司,90 天内有一千多次提交,迭代相当快。
这篇把它的工作机制、查询方式和存储架构拆开看一遍,重点讲清它跟对象存储的关系,以及自托管时怎么接一个 S3 兼容后端。
一个引擎装下图、向量、全文搜索
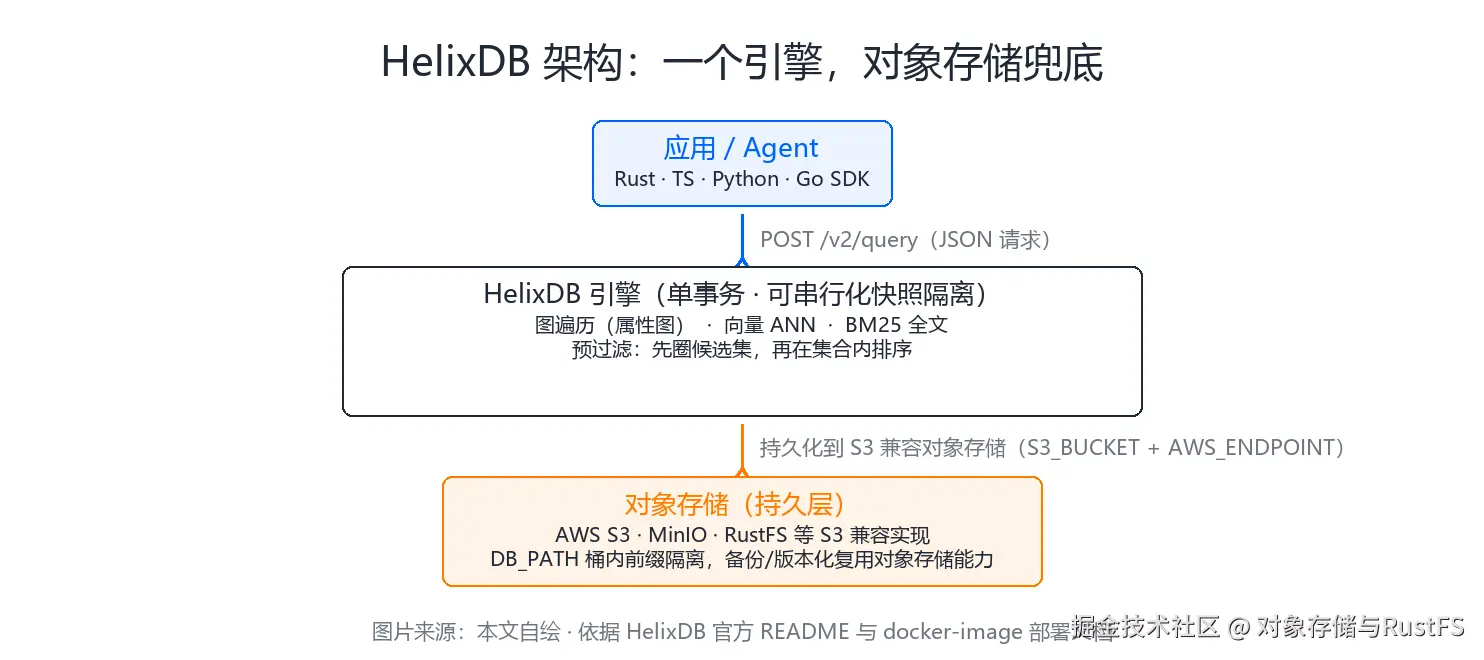
HelixDB 的数据模型是一张带标签的属性图:实体是节点,关系是边,节点和边都带类型化属性。向量索引和 BM25 全文索引不是独立系统,官方的表述很准确:它们是节点和边属性之上的访问路径。向量做近似最近邻检索,全文走 BM25,边和节点一样可以被搜索,这点不少图数据库做不到。
每次请求是一个 ACID 事务,隔离级别是可串行化快照隔离,图遍历、向量检索、全文检索共享同一个快照;写批次要么整体提交要么整体回滚。按官方架构文档的说法,这套事务是围着单写入点设计的:所有写经一个写入进程串行提交,靠这一点消掉分布式协调,代价是跨写入点的分布式事务不在能力范围内。对一个要给 agent 当记忆层的库来说,这个保证比吞吐数字更实际:写进去的记忆和它的出处边要么同时存在,要么都不存在。
它最值得看的机制是预过滤检索。常见需求是「在用户有权看到的文档里做语义搜索」,一般方案是先查权限再查向量库,两步之间靠应用代码保证一致性。HelixDB 把这两步并进一个请求:先用图遍历或租户索引圈出候选集,比如某个用户可见的全部文档,向量排序和 BM25 只在这个集合内部跑,集合之外的数据不会出现在结果里。多租户场景下,向量和文本索引还能按租户分区。对做企业内部知识库的人,这个设计直接省掉一层过滤代码,也省掉一类「检索结果越权」的事故。
边界也要说清:HelixDB 不生成 embedding,也不做重排序。向量得由应用自己算好再写入,同时用向量和 BM25 的话,两路结果的融合也在应用侧做。它只负责存向量、跑近似检索和 BM25、并把检索范围约束在图遍历圈定的集合内。
官方 FAQ 里给了一个很典型的用法示范,拿它做 agent 的长期记忆:记忆存成节点,租户、生命周期这类字段(比如 isLatest、expiresAt)建成索引属性,出处、关联实体、版本历史用边表达;召回的时候先遍历出「这个 agent 被允许看到的记忆」,再在这个集合里跑向量和 BM25,一个事务里完成。记忆的写入、过期、越权控制都落在图模型里,不用另建一套标记清理机制。
查询方式:没有查询语言,SDK 生成请求
HelixDB 没有文本查询语言。早期的 HelixQL(HQL)已经归档,现在的用法是用官方 SDK 的类型化构造器把查询写成代码,SDK 生成 JSON 请求发给 POST /v2/query,没有编译或部署步骤。官方 SDK 覆盖 Rust、TypeScript、Python、Go 四种语言,所有 SDK 生成同一种 JSON 请求格式。Cypher 做读和 CRUD 的 POST /v2/cypher 接口,官方文档明确说要用源码 checkout 自己构建 SDK 和服务端才有,也就是说直接从 ghcr.io 拉官方镜像默认不带这个端点(镜像契约里只有 /v2/query)。想从 Neo4j 迁移的团队别指望开箱即用,这是要自己编译的退路。
拿官方 README 里的 Python 例子看,写一个「按名字查用户」是这样的:
python
from helixdb import Client, Predicate, g, param, define_params, read_batch

get_user_params = define_params({"name": param.string()})
get_user = (
    read_batch()
    .var_as(
        "user",
        g()
        .n_with_label("User")
        .where(Predicate.eq("name", get_user_params.name))
        .value_map(["name"]),
    )
    .returning(["user"])
)

client = Client("http://localhost:6969")
user = client.query(get_user.to_query_request(get_user_params, {"name": "John Doe"}))
链式构造器本质是在拼一张查询计划,写起来比裸 SQL 啰嗦,但类型检查和版本管理都落在应用代码里。好不好用见仁见智,习惯 SQL 的团队可能要适应一段时间,Cypher 接口算个缓冲。
存储层就是对象存储
这是这篇最想讲的部分。HelixDB 的持久层直接建在对象存储上,官方仓库的部署文档把存储模式分成三种:内存(默认,重启丢数据)、本地磁盘(HELIX_DATA_DIR 指定目录)、S3 兼容对象存储。官方托管版 Helix Cloud 也是同一个思路:对象存储是持久化的 system of record,单写入点保证每个事务的完整 ACID,读节点按查询负载自动扩缩。价格也给了个锚点:入门计划每月 5 美元,含 20 万次读和 10 万次写,存储不限量。
自托管的容器镜像(ghcr.io/helixdb/helixdb)对 S3 模式的配置是标准化的,环境变量清单如下:
| 变量 | 作用 |
|---|---|
S3_BUCKET |
数据桶名,设置后即启用 S3 存储模式 |
AWS_ACCESS_KEY_ID / AWS_SECRET_ACCESS_KEY |
标准 AWS 风格凭证 |
AWS_ENDPOINT |
自定义 S3 端点,AWS_ENDPOINT_URL_S3 也认 |
S3_REGION |
桶区域,缺省回落到 AWS_REGION,再缺省 us-east-1 |
AWS_ALLOW_HTTP |
内网明文 HTTP 端点设 true |
DB_PATH |
桶内逻辑数据库前缀,默认 db/ |
注意 HELIX_DATA_DIR 和 S3_BUCKET 互斥,一个容器要么落盘要么落对象存储。镜像本身是无发行版的精简镜像,HTTP 服务在 8080 端口,健康检查走 /healthz 和 /readyz。
部署形态一共三种:把引擎嵌进自己的进程(官方支持 Rust、TypeScript、Python 嵌入)、用 helix CLI 起一个本地单节点容器(依赖 Docker 或 Podman)、或者上 Helix Cloud。官方 FAQ 里专门强调了一句:所有形态跑的是同样的查询、走同样的 SDK,开发时嵌在进程里,生产切到对象存储模式,代码不用动。
把存储底座放在 S3 兼容对象存储上,是个聪明的架构选择:持久化交给专门干这层的系统,数据可以放便宜的机器加盘上,备份和容灾直接复用对象存储的现成能力(版本化、复制、生命周期)。这也意味着存储后端是可替换的,AWS S3、MinIO、RustFS 这类 S3 兼容实现理论上都在选择范围内。
不过上生产前有两件事要想清楚。一是冷读。官方对架构的表述是对象存储做持久层,NVMe 和内存只作缓存;在项目的 Show HN 帖里,创始人自报过一组数:热查询 p99 在 10 毫秒上下,冷数据每跳约 50 毫秒,并承认冷数据上的深遍历是主要性能瓶颈。换句话说,读体验取决于缓存命中率,遍历深、访问冷的负载会大量回源对象存储,这只能拿自己的数据压测,官方暂无公开的调优指南。二是自托管的高可用边界:自托管服务端是单节点,写节点没有内置的多主或自动故障转移,官方 FAQ 把高可用明确归到 Helix Cloud 一侧(BYOC 尚在规划中)。备份同理:helix backup 命令备份的是本地实例的数据库文件,S3 模式没有公开文档的导出命令,持久性押在桶上,桶侧的版本化和复制策略就是你的备份策略。
桶里的对象数量也要有预期。官方架构文档写明云侧引擎是构建在对象存储上的 LSM 引擎,开源代码的存储层同样构建在 SlateDB 之上,同属 LSM 路线:桶里落的是 LSM 分层的数据文件,compaction 会不停重写和删除对象,桶内对象数会明显高于业务实体数量,容量和请求费用规划要按这个口径算。数据集大了之后,compaction 在后台持续产生的对象读写量也要计入对象存储的请求配额,别让它挤占业务请求。顺带一条通用的 S3 提醒:如果给桶开了版本化,引擎删除对象时只是打上 delete marker,旧版本会一直留在桶里,得配对象存储侧的生命周期规则清理非当前版本,否则存储会持续膨胀;不开版本化则没有这层问题。
用 RustFS 当 HelixDB 的存储后端
既然接口是标准 S3,自托管时后端选谁都行。这里给一个用 RustFS 的组合示例,两条 compose 服务,官方镜像都是现成的:
yaml
services:
  rustfs:
    image: rustfs/rustfs:latest
    restart: unless-stopped
    ports:
      - "9000:9000"
      - "9001:9001"
    volumes:
      - rustfs-data:/data
    environment:
      RUSTFS_ACCESS_KEY: "helix-admin"
      RUSTFS_SECRET_KEY: "改成强密钥"
      RUSTFS_ADDRESS: ":9000"
      RUSTFS_CONSOLE_ADDRESS: ":9001"

  helix:
    image: ghcr.io/helixdb/helixdb
    restart: unless-stopped
    depends_on:
      - rustfs
    ports:
      - "8080:8080"
    environment:
      S3_BUCKET: "helix-data"
      AWS_ACCESS_KEY_ID: "helix-admin"
      AWS_SECRET_ACCESS_KEY: "改成强密钥"
      AWS_ENDPOINT: "http://rustfs:9000"
      AWS_ALLOW_HTTP: "true"
      S3_REGION: "us-east-1"
      DB_PATH: "db/"

volumes:
rustfs-data:几个实操注意点:AWS_ALLOW_HTTP 只该在内网明文环境开,出内网就走 TLS;DB_PATH 是桶内前缀,同一个桶可以跑多套实例隔离数据;启动后桶会由 HelixDB 按前缀组织对象,不需要预先建目录结构,但提前建好桶、确认凭证能读写是基本动作。另外 depends_on 只控制启动顺序,不会等 RustFS 真正就绪,HelixDB 先起来可能连不上端点,好在 helix 服务配了 restart: unless-stopped,起不来会自动重试,RustFS 就绪后即自愈,对 PoC 场景够用。这份 compose 只为本地验证,真要上生产,凭证管理(密钥别写死在文件里)、TLS、日志持久化和监控采集都得自己补齐。社区里也有先例可抄,有人用同一套环境变量把 HelixDB 接到 MinIO 上做了 compose 部署,把端点换成 RustFS 就是上面这份文件。
诚实的边界
几个动笔前就打算写进来的提醒。第一,HelixDB 没有公开的第三方 benchmark,官方也没有给吞吐和延迟承诺,性能适不适应你的负载,只能自己压测。第二,项目迭代非常快,10 月上旬连续发了 v3.5.0 和 v3.5.1,一周一个版本对尝鲜是好事,对生产是负担,API 还在动。第三,第三方评测普遍把它当早期项目看:jonalonso.com 的评测直言「尚未经受生产考验,先跑 PoC,别急着迁生产」,Modern DataTools 的评估也指出它缺公开 benchmark 与运维架构文档,这类判断我觉得中肯。第四,云托管版的读节点有短暂滞后,要读写一致就得把请求发给写入点。第五,没有文本查询语言对运维是个取舍,调数据现在只能走 SDK 或裸 JSON。
也有加分的工程细节:容器镜像带完整的打包测试,含凭证扫描、非法配置拒绝和优雅退出验证;helix chef 命令能把查询技能和文档 MCP 装进 Claude Code 这类编码代理,直接代理生成完整应用,官方对 AI 辅助开发这条路的投入很明显。helix explorer 还能在浏览器里可视化浏览本地图实例,调数据的时候不用全程命令行。
值不值得试
适合的场景:给 agent 做长期记忆(记忆是节点、出处是边、语义检索内置)、企业知识图谱加检索、需要权限感知的 RAG,这些场景下「一个引擎 + 对象存储底座」比拼三个系统省事得多。已经有成熟向量库栈、或者主要诉求是大规模分析型负载的,不用动。
横向放在一起看会更清楚。和 Neo4j 加向量插件的传统组合比,HelixDB 的向量检索是一等公民,预过滤在同一请求里完成;代价是生态和工具链差着十年的积累。和 Milvus、Qdrant 这些纯向量库比,HelixDB 多了关系遍历和全文检索,但单论向量检索的规模和调优深度,专门向量库更成熟。和「关系库 + 向量库 + 图库」三件套拼装的方案比,HelixDB 赢在运维面小、一致性强;输在每一项单项能力都不一定是最强的,且应用侧要接受它的 SDK 查询模型。三道题问下来基本能定:要不要关系语义?要不要一个引擎?能接受早期项目吗?
它对存储侧的启示倒是普适的:新一代数据基础设施在把对象存储当默认持久层用,向量库、湖仓、现在连 OLTP 图数据库都这么干。底座选一个 S3 兼容、协议实现扎实的对象存储,上面的组件都有的换。RustFS 兼容 S3 协议、Apache 2.0 开源,这类构建在对象存储上的新引擎,都可以直接接。
完整复现命令:
bash
curl -sSL "https://install.helix-db.com" | bash

mkdir my-helix-app && cd my-helix-app
helix init local
helix start dev          # 内存模式,http://localhost:6969
helix start dev --disk   # 落盘模式
helix query dev --file examples/request.json
HelixDB 的文档在 docs.helix-db.com,源码在 github.com/HelixDB/hel...。RustFS 的 Docker 部署见 docs.rustfs.com,仓库在 github.com/rustfs/rust...。