先认识一下这篇论文
| 项目 | 内容 |
|---|---|
| 论文名 | HorizonNet: Learning Room Layout with 1D Representation and Pano Stretch Data Augmentation |
| 作者 | Cheng Sun、Chi-Wei Hsiao、Min Sun、Hwann-Tzong Chen |
| 发表 | CVPR 2019(计算机视觉顶会) |
| 一句话贡献 | 把"看懂整个房间"这道题,从画一张二维图 变成写三行数字,又快又准 |
| 江湖地位 | 它是后续 HoHoNet、LED²-Net、LGT-Net 等一系列方法的地基,在 IJCV 对比研究里被评为"通用房型全能冠军" |
一、要解决的问题:一张全景图 → 一个立体房间
给你一张站在房间中央拍的 360° 全景图 ,让电脑输出这个房间的三维骨架:墙在哪、天花板多高、地板是正方形、L 形还是 T 形。
前人的做法:"画一张二维地图"
当时主流方法(LayoutNet 等)的思路是:让神经网络对每一个像素做判断------"这个像素是不是墙角?是不是边界?"输出一整张 512×1024 的图。
作者发现了这种做法的三个致命毛病:
毛病 1:满纸都是"0"------零主导背景问题
一张 512×1024 的图有 52 万个像素,而真正的边界线只占极少数。论文里算了一笔账:即使做过平滑处理,二维表示中仍有约 95% 的值是 0。
类比:让一个人在 52 万个格子的巨型表格里找几十个"√",他大概率会摆烂------干脆全填"没有",正确率也有 95%。神经网络也一样,它会学成"一律回答没有",因为这样损失最低。
HorizonNet 的一维表示把这个比例从 2N/(512×1024) 提升到 N/1024(N 是墙角数),"有效信号"的浓度提高了几百倍。
毛病 2:数据太少,网络一大就过拟合
标注一张全景图的房间布局非常费人力,而且不同人标的结果还不一致(家具挡住的地方到底算不算墙?)。当时可用的数据只有区区几百张,网络做大就过拟合,做小又不够聪明。
毛病 3:后处理慢得离谱
网络输出之后,还要"按规则拼出一个规整的盒子"。此前的方法要靠几十秒的优化迭代,根本没法实时用。
二、核心创新 ①:把房间压成"三条线"(1D 表示)
这是整篇论文最漂亮的一招。
关键洞察:房间是"上下结构"的
全景图被摊平后(等距柱状投影),有一个重要性质:天花板在上,地板在下,墙在中间 。那么在图的任意一列(竖着切一刀)看过去,从上到下只有三个关键信息:
- 天花板-墙的分界线在哪一行?
- 地板-墙的分界线在哪一行?
- 这一列是不是正好切在"墙与墙的交界"(也就是墙角)上?
于是,一张 512×1024 的图(宽 1024 列),就只需要输出 3 条长度为 1024 的数字串:
| 向量 | 含义 | 数值形式 |
|---|---|---|
| yᶜ | 每一列的天花板-墙边界位置 | 实数,归一化到 −π/2, π/2(相当于俯仰角) |
| yᶠ | 每一列的地板-墙边界位置 | 实数,同上 |
| yʷ | 这一列存在墙角(墙-墙边界)的概率 | 0~1 之间的数 |
**为什么叫 "Horizon"(地平线)?** 因为 yᶜ 和 yᶠ 两条曲线,画出来就像一条起伏的"天花线"和一条"地平线",围着房间绕一圈。名字由此而来。
yʷ 的巧思:不用 0/1,用"距离衰减"
如果直接让网络预测"这一列是不是墙角",又回到"满屏都是 0"的老问题。作者改成: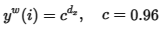
其中 dₓ 是第 i 列到最近的墙角列的距离(单位:列数)。
- 正好在墙角那一列 → dₓ=0 → yʷ = 1(满格)
- 离墙角 10 列 → 0.96¹⁰ ≈ 0.66
- 离墙角 50 列 → 0.96⁵⁰ ≈ 0.13
类比:不是只在墙角点一个"亮点",而是在墙角周围画一座小山包。网络不用精准命中那一列,只要把山头大致画对就行------学习难度大幅下降。而且这样天然给出"哪些列最可能是墙角"的排序。
一维表示带来的三大好处
| 好处 | 说明 |
|---|---|
| 没有零背景 | yᶜ/yᶠ 是实数回归(不是分类),每一列都有一个真实答案,不存在"绝大多数是 0" |
| 参数更少 | 从密集二维输出 67M 参数 → 一维输出只需 25M |
| 更快 | 输出空间从 O(H×W) 降到 O(W),少了整整一个维度 |
三、核心创新 ②:网络结构 = ResNet-50 + 双向 LSTM
输入:512×1024 全景图
   ↓
预处理:对齐(让墙角线变竖直)
   ↓
ResNet-50 提取多尺度特征
   ↓
各层特征上采样到统一宽度 256 → 拼接成 1024×1×256
   ↓
双向 LSTM(沿"宽度方向"前后各扫一遍)
   ↓
输出:1024×3(三条数字串)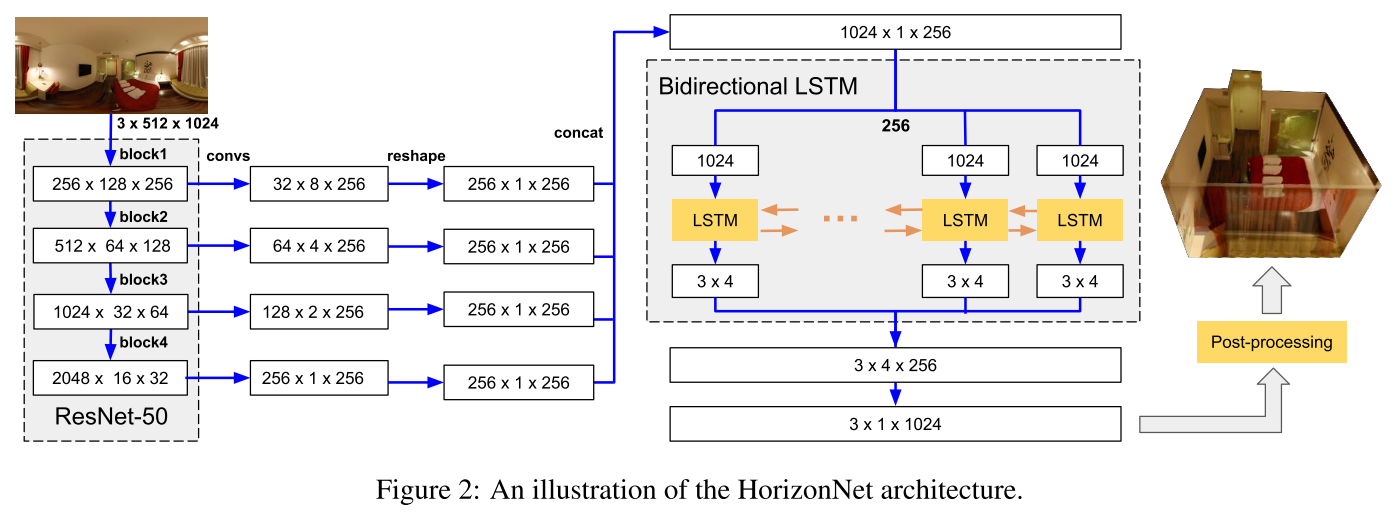
1. 特征提取器
- 骨干采用改编的 ResNet-50,专门针对全景图做了优化:不断压缩高度方向的维度,最终把 2D 特征图压缩成 1 维序列。
- 多尺度特征融合:把 ResNet 不同层级的特征都上采样到相同宽度,拼接在一起,同时保留低层次的边缘信息和高层次的语义信息。
- 最终输出 1024 维通道、宽度 256 的 1D 特征序列。
2. 为什么一定要 LSTM(RNN)?
这是理解这篇论文的第二个关键点。
**房间是一个整体,不是 1024 个独立的小问题。** 如果你看到左边有一个墙角,那么它对面的墙大概率也有一个;如果这边天花板压得很低,那边通常也一样高。
卷积网络(CNN)只能看到"局部"一小片区域,而 双向 LSTM 把整张图当成一句话来"读":从左到右读一遍,再从右到左读一遍,让每一列都知道"全局发生了什么"。
**这带来的超能力:家具挡住的墙角,能"脑补"出来。** 沙发挡住的那一列虽然看不清,但网络根据整圈墙的走势,照样能推出那里应该有个角。
消融实验的铁证:加 RNN 后,3D IoU 从 81.22 提升到 83.74。
3. 训练细节
| 设置 | 值 |
|---|---|
| 骨干网络 | ResNet-50 |
| 输入分辨率 | 512×1024 |
| 损失函数 | yᶜ、yᶠ 用 L1 损失 (回归);yʷ 用二元交叉熵 BCE(概率) |
| 优化器 | Adam,学习率 0.0003 |
| 训练 | 300 轮,batch size 24 |
| 硬件耗时 | 3 张 GTX 1080 Ti,约 4 小时 |
四、核心创新 ③:20 毫秒拼出 3D 盒子(极速的后处理)
网络输出的三条数字串还是"软"的、抖动的。后处理负责把它变成规整的 3D 房间------而且平均只要 12 毫秒,比此前动辄几十秒的方法快了上千倍。
完整五步流程
第 1 步:假设相机高度
相机离地多高?论文假设 1.6 米(成年人手持/三脚架的常见高度)。有了这个"比例尺",图上像素才能换算成真实米数。
注意这也是它的一个先天限制:单张图无法知道真实尺度,必须靠这个假设。
第 2 步:每一列投票决定"层高"
对每一列:把地板边界点投影到 3D 空间,天花板边界点在同一列的 3D 水平位置相同,于是两点之间的垂直距离就是这一列看到的"房高"。1024 列各投一票,取平均作为最终层高------用"集体投票"抵消单列的误差。
第 3 步:找"峰值"定位墙角
在 yʷ 那条曲线上找山头,要同时满足两个条件:
- 在 5° 水平视角范围内,它比周围所有值都大(局部最强);
- 它的值 > 0.05(不能是噪声)。
每个山头 = 一个墙角,把天花板边界曲线切成若干段,每段对应一面墙。
第 4 步:PCA 自动纠偏(很妙的一招)
万一第 1 步的"对齐"没做完美(相机水平方向转歪了一点)怎么办?作者对每一段边界点做主成分分析(PCA) ,找出这面墙最主要的走向,然后按所有段的平均角度把整个场景旋转回来。相当于自动补做一次对齐。
第 5 步:按"曼哈顿规则"投票定墙
所有墙被分成两类:垂直于 X 轴 的 和 垂直于 Z 轴 的。相邻的两面墙必须互相垂直。构建顺序按"方差从小到大"(越确定的墙先定),每个投影点给 0.16 米范围内的候选平面投票,得票最多的胜出。
最后,房间的每个角点 = 三个相邻曼哈顿平面的交点,整个房间就拼出来了。
复杂度 O(W),只跟图片宽度线性相关------这就是它能做到毫秒级的根本原因。
五、核心创新 ④:Pano Stretch(全景拉伸数据增强)
这是论文的第三个贡献,也是最能迁移的思路。
动机:常规增强对全景图不管用
图像分类里常用的"随机裁剪",对全景图是有害的------裁掉一块就破坏了 360° 的完整结构。作者想要的是:造出一个真实的、不同长宽比的新房间。
做法:把房间真的"拉长"一遍
- 把全景图的每个像素,用 (u, v) 经纬度坐标表示(u ∈ −π, π,v ∈ −π/2, π/2);
- 把像素投影回 3D 空间 (x, y, z),其中 z 方向有个未知深度 d;
- 沿 x / z 轴乘以缩放系数 kₓ、k_z(也就是把房间拉长或压扁);
- 再投影回全景图。
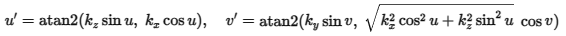
最漂亮的地方:深度 d 被"约掉了"
公式里出现了 atan2,而深度 d 同时出现在分子和分母里,直接被消掉。也就是说:
不需要知道任何深度信息,就能把一张全景图"变形成另一个形状的房间"。
这正是它能被广泛移植到其他全景任务(语义分割、深度估计、目标检测)的原因。
采样策略
- kₓ、k_z 从均匀分布 U1, 2 中随机抽;
- 然后以 50% 的概率取倒数 (变成 1/2 ~ 1 之间)------这样房间既能被拉长 ,也能被压扁,两个方向都覆盖到。
成本
处理一张 512×1024 的图约 130 毫秒 ,可以边训练边实时生成,不用提前存一堆图。
效果
论文里有一句非常硬气的话:**"在所有实验设置下,这个增强策略都提升了定量结果。"** 看消融表,它的增益是实打实的:
| 配置 | 3D IoU |
|---|---|
| 无拉伸 | 81.23 |
| 加 Pano Stretch | 83.74(+2.5) |
在一般房型上更夸张:77.4 → 82.5(+5.1)。
六、实验结果
数据集
| 数据集 | 规模 | 特点 |
|---|---|---|
| PanoContext | 514 张 | 卧室、客厅,全是长方体房间 |
| Stanford 2D-3D | 552 张 | 办公室等大空间,也是长方体 |
长方体房间(PanoContext)
| 方法 | 3D IoU ↑ | 角点误差 ↓ | 像素误差 ↓ |
|---|---|---|---|
| PanoContext(原方法) | 67.23 | 1.60 | 4.55 |
| LayoutNet | 74.48 | 1.06 | 3.34 |
| DuLa-Net | 77.42 | --- | --- |
| CFL | 78.79 | 0.79 | 2.49 |
| HorizonNet | 82.17 | 0.76 | 2.20 |
| **HorizonNet(合并两数据集训练)** | 84.23 | 0.69 | 1.90 |
长方体房间(Stanford 2D-3D)
| 方法 | 3D IoU ↑ |
|---|---|
| CFL | 65.13 |
| LayoutNet | 76.33 |
| DuLa-Net | 79.36 |
| HorizonNet | 79.79 |
| **HorizonNet(合并训练)** | 83.51 |
消融实验(每一项到底有多大用)
| 输出形式 | Pano Stretch | RNN | 3D IoU | 参数量 | FPS |
|---|---|---|---|---|---|
| 密集 O(HW) | ✗ | ✗ | 77.87 | 67M | 98 |
| 密集 O(HW) | ✓ | ✗ | 79.64 | 67M | 98 |
| **一维 O(W)** | ✗ | ✗ | 80.65 | 25M | 119 |
| **一维 O(W)** | ✓ | ✗ | 81.22 | 25M | 119 |
| **一维 O(W)** | ✗ | ✓ | 81.23 | 57M | 20 |
| **一维 O(W)** | ✓ | ✓ | 83.74 | 57M | 20 |
读表结论(这是全篇最值得记住的三条):
- 光是把输出从二维改成一维,IoU 就从 77.87 → 80.65(+2.8),参数还从 67M 砍到 25M。少即是多。
- Pano Stretch 每一行都带来提升,无一例外。
- RNN 是最后一块拼图,但代价是速度从 119 FPS 掉到 20 FPS(LSTM 要逐列串行计算,天生慢)。
速度对比
| 环节 | 耗时 |
|---|---|
| 网络前向(不带 RNN) | 约 8 ms |
| 网络前向(带 RNN) | 约 50 ms |
| 后处理 | 约 12 ms |
| 此前的方法后处理 | 几十秒 |
小提示:论文正文中"with and without RNN"那句数字顺序疑似笔误,与表 3 的 FPS(119 vs 20)对照即可确认:不带 RNN 是 8ms,带 RNN 是 50ms。
一般房型(非长方体)
因为非长方体数据太少,作者手工重新标注了 65 张一般布局的图用于微调:
| 方法 | 3D IoU |
|---|---|
| LayoutNet | 74.1 |
| LayoutNet + Pano Stretch | 75.1 |
| HorizonNet | 77.4 |
| HorizonNet + Pano Stretch | 82.5 |
只用 65 张数据微调,就涨了 5 个点------这既说明 Pano Stretch 的威力,也说明 HorizonNet 的表示本身就很"省数据"。
七、它的局限(作者没回避)
| 局限 | 说明 |
|---|---|
| 曼哈顿世界假设 | 默认墙都互相垂直、地面天花板水平。斜墙、曲面墙、斜天花板搞不定 |
| 相机高度是假设的 | 固定 1.6 米。真实相机高度不同会带来尺度误差;单张图本身无法测出真实尺寸 |
| 每列只能有一条边界 | 这意味着无法处理"同一列上有高低两层"的复杂结构(如错层、楼梯口) |
| 依赖预处理对齐 | 如果对齐算法失效,虽然后处理有 PCA 兜底,但仍会影响精度 |
| 带 RNN 后变慢 | 20 FPS 虽够用,但 LSTM 串行计算是瓶颈 |
| 重度遮挡仍会失手 | 家具把整面墙挡完时,全局推断也救不回来 |
八、它对后续研究的影响
HorizonNet 几乎重新定义了这个领域:
- HoHoNet(2021)沿用"沿列压缩成一维"的思路,但用特征金字塔 + 注意力替代 LSTM,同时还能估深度;
- LED²-Net (2021)在 HorizonNet 架构基础上加入可微深度渲染损失;
- LGT-Net(2022)把 LSTM 换成 Transformer,进一步涨点;
- IJCV 的那篇对比研究 系统评测后给出的结论是:HorizonNet 在通用曼哈顿布局上四项指标全胜(3D IoU 79.11、2D IoU 81.71、RMSE 0.197、δ₁ 0.929),尤其在墙角多的复杂房间领先更明显。
九、一句话总结 + 三条可迁移的思路
HorizonNet 的成功在于"做减法":它没有堆更大的网络、没有造更多的数据,而是重新定义了"房间的答案应该长什么样"------把一张二维地图压成三条一维曲线,逼网络只学最关键的几何信息,再配上一个尊重全景几何的数据增强,就同时拿到了更高精度、更少参数和快上千倍的速度。
三条可以带走的方法论:
- 换个"答案格式",可能比换个更强的模型更有效。 二维 → 一维,参数从 67M 降到 25M,精度反而涨了 2.8 个点。当你觉得模型学不会时,先问问:是不是"答案的表达方式"本身就太难学了?
- 数据增强要"懂行"。 通用的翻转、加噪声是万能药但也是安慰剂;真正有效的是遵循任务背后物理/几何规律的增强------Pano Stretch 就是"把房间真的拉长一遍",所以它在所有配置下都涨点。
- "少即是多"的另一面是"先做对简化版"。 曼哈顿假设、固定相机高度、每列单一边界------每一条限制都在缩小搜索空间。先把简化版做到极致,再一步步放宽,往往比一上来就求全更有效。
论文核心贡献
- 提出 1D 布局表示 :大幅降低了房间布局估计的问题复杂度,同时提升精度和速度,是该领域的经典范式创新。
- 提出 Pano Stretch 数据增强 :为全景视觉任务提供了一种符合几何原理的通用数据增强方法,被后续大量论文沿用。
- 验证了 RNN 的价值 :证明循环神经网络能有效捕捉房间布局的全局几何规律,提升遮挡区域的预测效果。
- 极速后处理 :首次把布局重建后处理做到毫秒级,为实时应用(VR、机器人)提供了可能。
📖 名词小抄
| 名词 | 大白话 |
|---|---|
| 全景图 / 等距柱状投影 | 把球形画面摊成"世界地图",两极方向会被拉扯变形 |
| 1D 表示 | 不再逐像素判断,而是给每一列只输出 3 个数字 |
| yᶜ / yᶠ | 天花线 / 地平线,记录每列上下边界的高度 |
| yʷ | 墙角概率曲线,用 0.96^距离 做成"山包"而非孤立的点 |
| 零主导背景 | 答案里 95% 是 0,网络会学成"一律答没有" |
| 双向 LSTM | 把整张图当一句话,正读一遍倒读一遍,获取全局视野 |
| 曼哈顿世界假设 | 一切横平竖直,像搭乐高 |
| 后处理拟合 | 按"必须横平竖直"的规则,把抖动的预测修成规整的盒子 |
| PCA 纠偏 | 用数学找出墙的主方向,自动把没对准的图转回来 |
| Pano Stretch | 在 3D 里把房间拉长/压扁,再投回全景图,凭空造出新训练样本 |
| 3D IoU | 预测房间和真实房间的立体重叠比例,越大越好 |
| 消融实验 | 每次只拆掉一个零件再测一遍,看这个零件值多少分 |