多 Agent 客服的短期记忆改造:用 Redis + Checkpointer 管理会话状态
前言
mall-customer 的短期记忆原本是一个手写的 Redis 封装:把对话消息按会话 ID 存进 Redis list,读的时候取最近 N 条。封装本身是通的,但它和 Agent 图之间是断开的------消息存下来了,模型看不到。用户第一轮说"我要退款",第二轮说"给它升级优先级",客服会把第二句当成一件新的事处理:要么答非所问,要么再建一张新工单。
Agent State 本来就是用来记录整个图执行过程中的状态的,其中就包括消息------它完全可以替代原来那套短期记忆,只需要把这份状态持久化下来。框架已经提供了现成的做法------checkpointer:编译图时传入它,每个节点执行后的状态都会自动持久化,下一轮自动恢复,存进去的状态就是下一轮要用的。
所以这次改造没有重写短期记忆,只是把自建的 Redis 封装删掉,状态存取交给 checkpointer。过程中还清掉了状态模型里的两个冗余字段,并解决了暴露出来的两个问题。
一、旧短期记忆的问题
memory/short_term.py 短期记忆就围绕三个核心操作:
python
async def add_message(self, session_id: str, role: str, content: str) -> None:
    message = {"role": role, "content": content, "timestamp": datetime.now().isoformat()}
    key = f"smartcs:short_term:{session_id}"
    await r.rpush(key, json.dumps(message, ensure_ascii=False))  # 追加一条消息
    await r.ltrim(key, -self.max_turns, -1)                      # 只保留最近 20 条
    await r.expire(key, self.ttl_seconds)                        # 30 分钟过期
Redis 里确实存放着最近的对话,/api/history 也能读回来。但它和图是断开的,具体有两个问题:
- 存了,但没用上。
/api/chat调用graph.ainvoke()时,初始 state 只带本轮这一条新消息:"messages": [HumanMessage(content=request.message)]。Redis 里存着 20 条历史,图里只读得到 1 条------历史从未注入状态,多轮追问缺少上下文。 - 两套状态各自维护。 短期记忆里存的是消息文本;图的内部还有
intent(路由给哪个 Agent)、compliance_passed(合规是否通过)这类编排状态。这些字段既不落 Redis、也不进下一轮,进程一重启就丢失。
二、Checkpointer 如何持久化会话状态
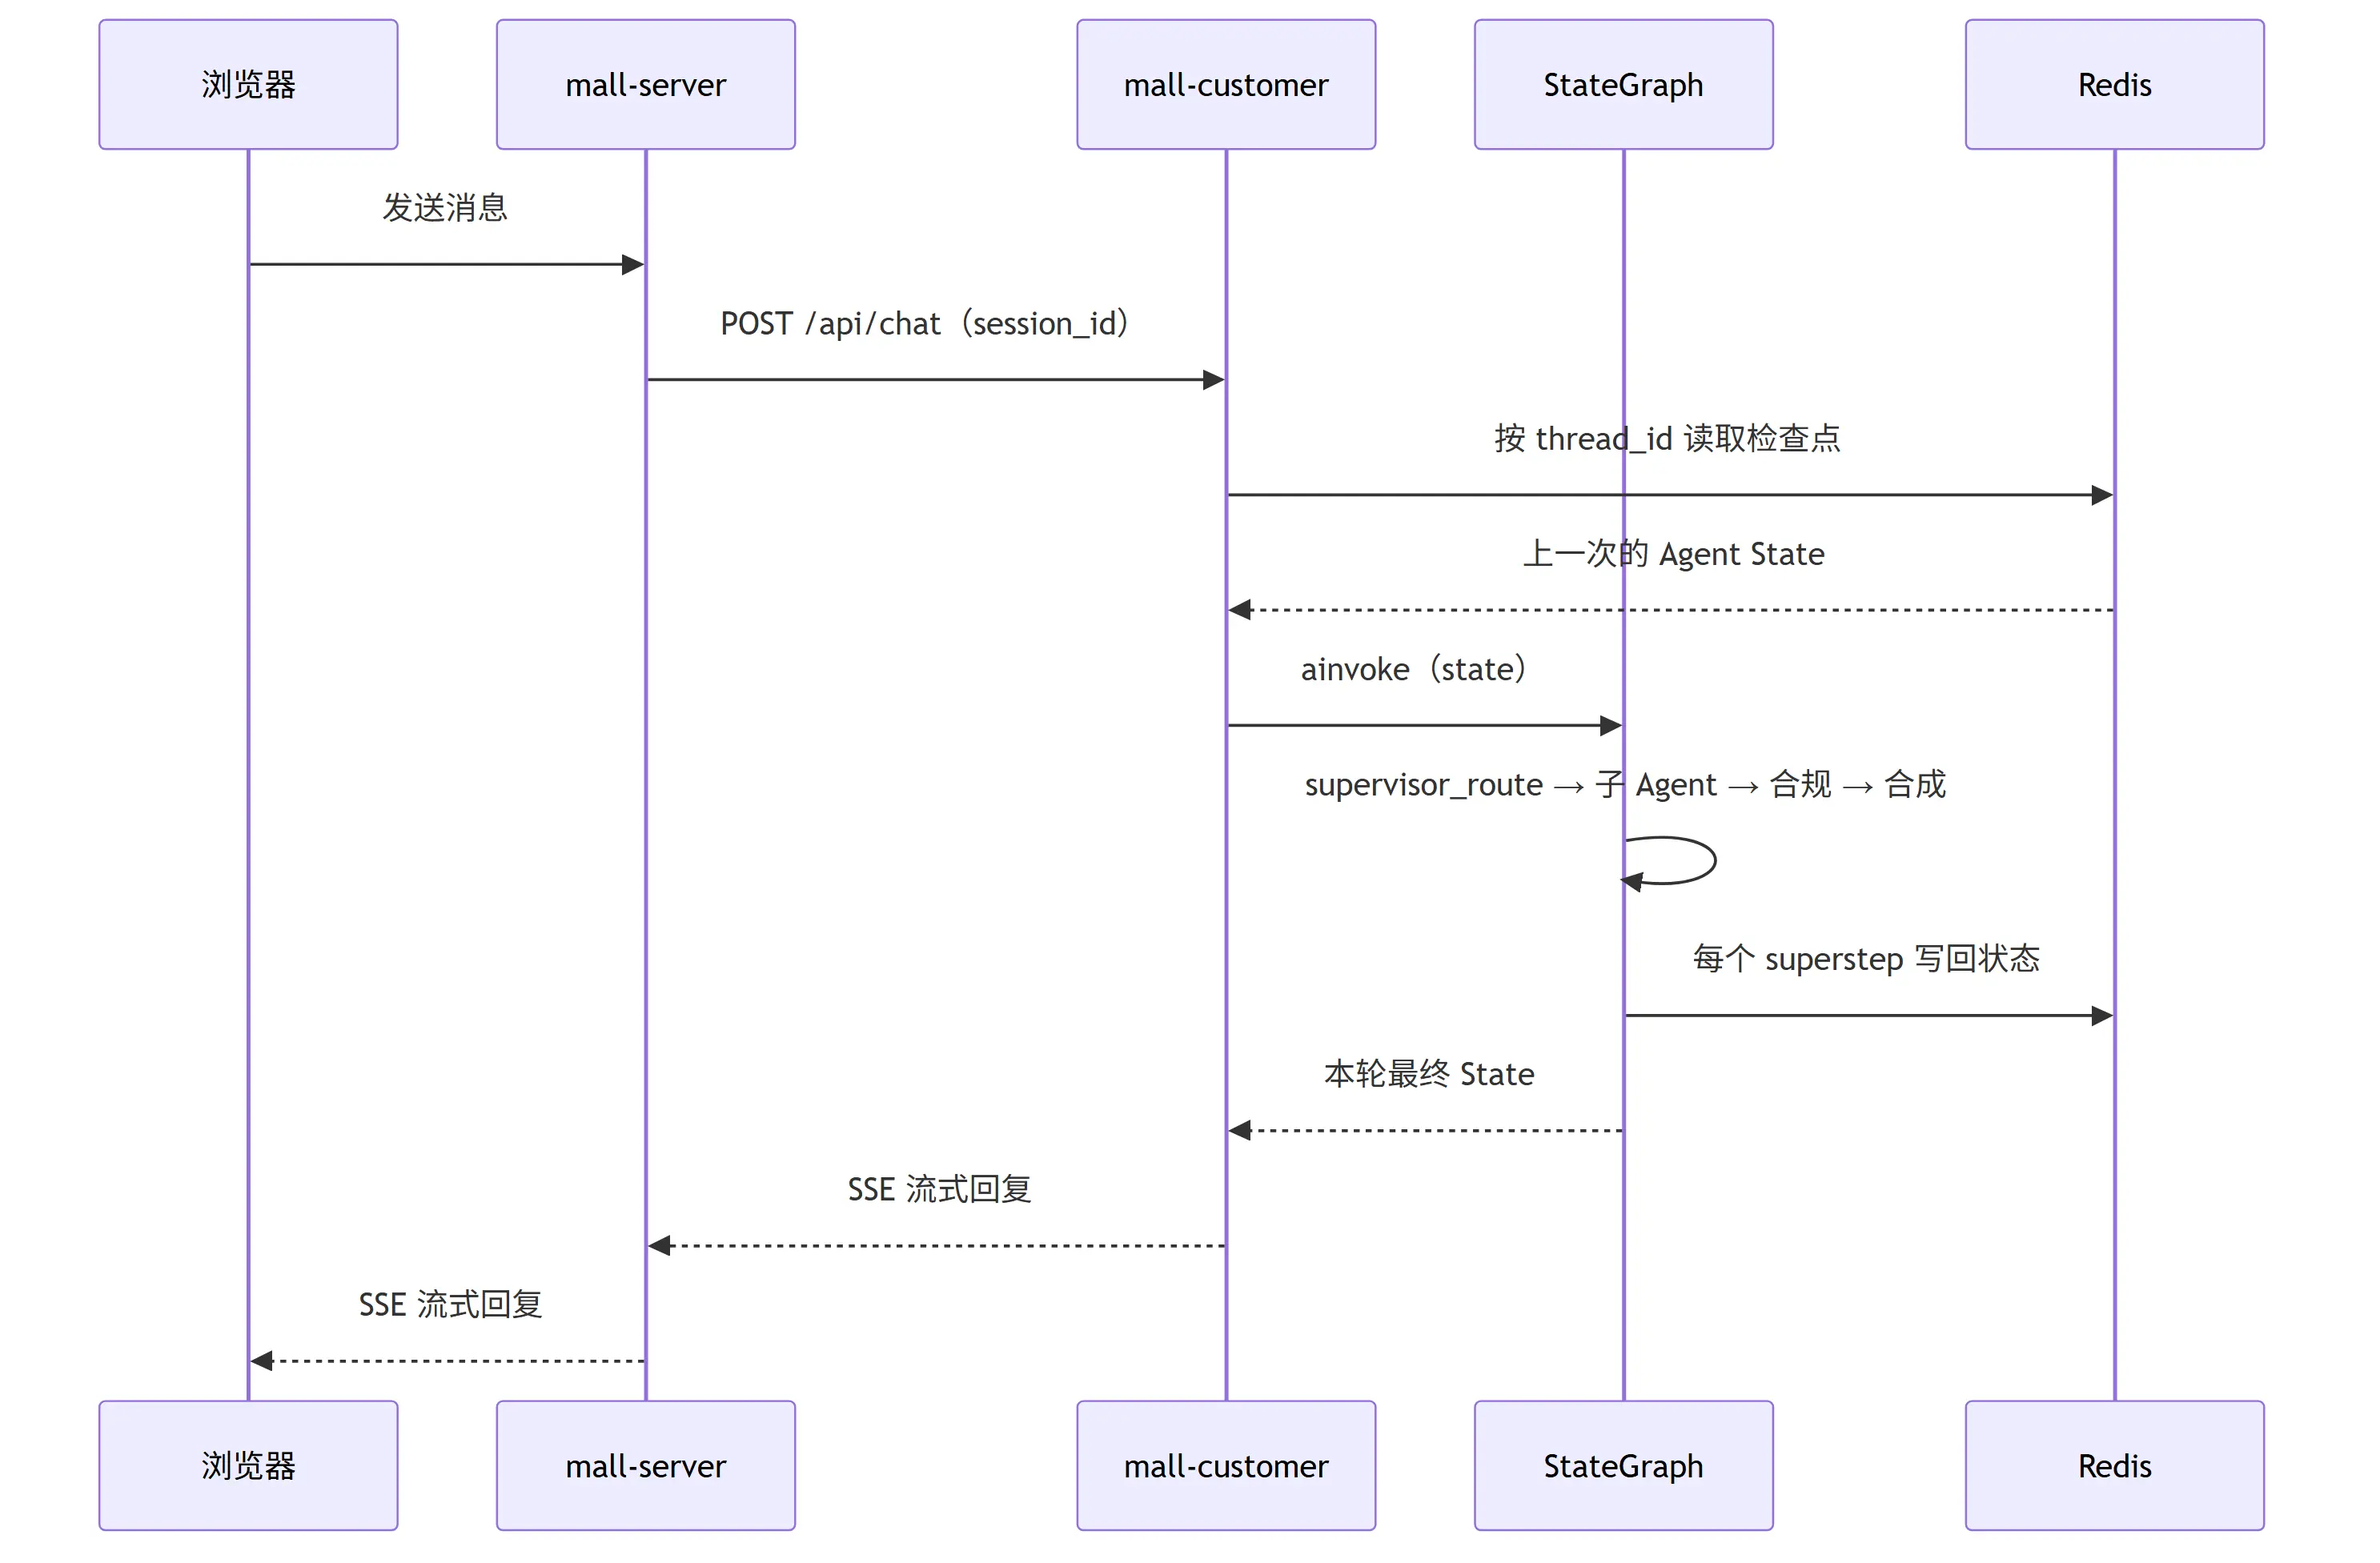
checkpointer 存到哪、怎么存:graph.compile(checkpointer=...) 之后,每次执行都会以 thread_id 为键,把每个 superstep 之后的完整状态快照写入存储;下一轮用同一个 thread_id 调用 ainvoke() 时,框架先恢复上次的状态,再把这一轮的输入按 reducer(messages 字段上是 add_messages)合并进去;任何时刻都可以用 graph.aget_state() 读出当前状态。
三、换成 Redis Checkpointer
依赖与前置条件
requirements.txt增加一行langgraph-checkpoint-redis>=0.5.0(本次接入用的 0.5.2);- 这个 checkpointer 不是普通的 KV 存储:它用 RedisJSON 保存状态、用 RediSearch 建索引,所以需要 Redis Stack 或 Redis 8+ 。本地 compose 用的本来就是
redis/redis-stack-server镜像,不用额外改; REDIS_URL环境变量补上密码。
初始化与降级
新的 memory/short_term_memory.py 里,初始化都放在 setup() 方法中:
python
# Agent State 检查点:TTL 30 分钟(读取/写入均刷新过期时间)
CHECKPOINT_TTL = {"default_ttl": 30, "refresh_on_read": True}


class ShortTermMemory:
    async def setup(self) -> None:
        """初始化 checkpointer:优先 Redis,失败降级进程内 MemorySaver"""
        from langgraph.checkpoint.memory import MemorySaver
        from langgraph.checkpoint.redis.aio import AsyncRedisSaver

        stack = AsyncExitStack()
        try:
            checkpointer = await stack.enter_async_context(
                AsyncRedisSaver.from_conn_string(self._redis_url, ttl=CHECKPOINT_TTL)
            )
            await checkpointer.asetup()
            self._stack, self._checkpointer = stack, checkpointer
        except Exception as e:
            print(f"[ShortTermMemory] Redis checkpointer 初始化失败,降级为内存 MemorySaver: {e}")
            await stack.aclose()
            self._stack, self._checkpointer = None, MemorySaver()
几个实现细节:
ttl控制的是会话的生命周期:default_ttl的单位是分钟,refresh_on_read: True表示读取时也续期------会话持续使用就一直存活,30 分钟没有读写才过期;from_conn_string()是异步上下文管理器,这里用AsyncExitStack手动进入,好处是进出成对:连接建立失败时,已申请的资源会被回滚掉,然后降级为进程内的MemorySaver,服务正常启动。降级只保证可用性------内存版重启即失效,多进程之间也不共享(当前版本里MemorySaver是InMemorySaver的兼容别名);asetup()负责建立 RediSearch 索引和 JSON 文档结构,启动时执行一次,幂等。
接线:thread_id、/api/chat 与 /api/history
在 api/main.py 的 lifespan 里,先初始化短期记忆,再把 checkpointer 传给图:
python
@asynccontextmanager
async def lifespan(app: FastAPI):
    global graph

    # 短期记忆:Redis 持久化 Agent State,Redis 不可用时自动降级内存
    await short_term_memory.setup()

    graph = create_supervisor_graph(
        working_memory=working_memory,
        long_term_memory=long_term_memory,
        checkpointer=short_term_memory.checkpointer,
    )
    ...
    yield
    await short_term_memory.aclose()
create_supervisor_graph 的参数里,原来传的是 short_term_memory 对象,现在传 checkpointer------图不再依赖具体的存储实现:
python
def create_supervisor_graph(..., checkpointer: Any | None = None, enable_checkpointing: bool = True):
    ...
    if checkpointer is None and enable_checkpointing:
        from langgraph.checkpoint.memory import MemorySaver
        checkpointer = MemorySaver()
    compiled = graph.compile(checkpointer=checkpointer)
    return compiled
/api/chat 里,会话 ID 直接当作 thread_id。这一轮的初始 state 只包含新消息和业务字段,历史对话由框架恢复:
python
session_id = request.session_id or str(uuid.uuid4())
config = {"configurable": {"thread_id": session_id}}

initial_state = {
    "messages": [HumanMessage(content=request.message)],
    "user_id": request.user_id,
    "session_id": session_id,
    ...
}
result = await graph.ainvoke(initial_state, config=config)
在 /api/history 里,通过读取图的状态快照获取对话历史:
python
async def get_history(self, graph: Any, session_id: str, last_n: int = 20) -> list[dict]:
    """读取会话对话历史 --- 从 LangGraph Agent State(checkpointer)获取"""
    from langchain_core.messages import AIMessage, HumanMessage, SystemMessage

    try:
        snapshot = await graph.aget_state({"configurable": {"thread_id": session_id}})
    except Exception:
        snapshot = None

    messages = (snapshot.values or {}).get("messages", []) if snapshot else []
    role_map = {HumanMessage: "user", AIMessage: "assistant", SystemMessage: "system"}
    history = [
        {"role": role_map.get(type(msg), "system"), "content": msg.text}
        for msg in messages
    ]
    return history[-last_n:]
只保留最近 20 条
TTL 控制的是会话何时过期,不管状态里累积了多少消息------如果只有 TTL,持续时间长的会话,检查点里的消息会一直累积。旧实现用 ltrim 把列表裁到 20 条,新方案需要补上同样的条数限制。
做法是在图的入口加一个 trim_history 节点,紧跟本轮输入合并之后执行:消息数超过窗口的部分裁掉------用 RemoveMessage 把最旧的几条标记移除(而不是让 reducer 静默丢弃),经 add_messages 缩减之后再做路由。这样后续节点(Supervisor 路由、子 Agent、合规)读到的就是同一个窗口,checkpointer 落盘的也是有界状态:
python
# 短期记忆滑动窗口:Agent State 中最多保留最近 20 条消息(约 10 轮对话),
# 超出部分由 trim_history 节点用 RemoveMessage 移除,防止状态无限增长
MESSAGE_WINDOW_SIZE = 20


def trim_history(state: AgentState) -> dict[str, Any]:
    """滑动窗口:把 Agent State 的消息裁剪到最近 MESSAGE_WINDOW_SIZE 条

    作为图的入口节点执行,紧接着本轮的输入合并之后------保证后续所有节点的
    LLM 只看得到窗口内的消息,checkpointer 持久化的也是有界状态。
    通过 RemoveMessage 走 add_messages reducer 裁剪,而不是直接覆盖列表。
    """
    messages = state.get("messages", [])
    overflow = len(messages) - MESSAGE_WINDOW_SIZE
    if overflow <= 0:
        return {}

    removals = [RemoveMessage(id=m.id) for m in messages[:overflow] if m.id]
    return {"messages": removals}
接线时把入口从 supervisor_route 改为 trim_history:
python
graph.add_node("trim_history", trim_history)   # 滑动窗口:裁剪超窗口的历史消息
...
graph.set_entry_point("trim_history")
graph.add_edge("trim_history", "supervisor_route")
和 ltrim 的差别在于:ltrim 是物理删除,被裁掉的消息无法找回;RemoveMessage 是往状态里提交一次"删除指令",由 add_messages reducer 处理,语义上仍是一次状态更新------和第四节合规撤回是同一套机制。窗口大小 20 条(约 10 轮对话),沿用旧实现的默认值。
四、状态模型调整:从 sub_results 到 messages
接入 checkpointer 之前,AgentState 里还有 sub_results 和 final_response 两个字段(节选):
python
class AgentState(TypedDict):
    messages: Annotated[list[BaseMessage], add_messages]
    user_id: str
    session_id: str
    intent: str
    sub_results: dict[str, Any]   # 各子 Agent 的结果,按 Agent 名分桶
    compliance_passed: bool
    final_response: str           # 合成节点拼出来的最终回复
    current_agent: str
    retry_count: int
sub_results 和 final_response 的问题在于:
- 子 Agent 处理完,不是往消息流里写回答,而是把结果写进
sub_results["knowledge_rag"]这样的字典;这些内容不是消息,也不会被恢复成对话上下文; final_response是合成节点拼好之后再写回状态的,和 messages 里最后追加的那条 AIMessage 是同一份内容,存了两遍。
既然会话状态都放在 messages 里,这两个字段就是多余的。改造后,子 Agent 的结果直接作为 AIMessage 写入 messages------它既是要给用户的回复,也是下一轮对话历史的组成部分:
python
return {
    **state,
    "messages": [AIMessage(content=result)],
}
合成节点不再做拼接:末尾的 AIMessage 就是最终回复。
改造过程中处理了两个边界情况,均来自实际运行:
其一,合规不通过时,子 Agent 的结果要撤回。 该结果已经写入 messages;如果合规不通过只是追加一句转人工话术,违规内容会留在会话历史中,下一轮仍会作为上下文送入模型。因此需要用 RemoveMessage 将其移除:
python
if not state.get("compliance_passed", True):
    final_response = (
        "抱歉,您的请求涉及敏感内容,已转交人工客服处理。"
        "工单编号已自动生成,请留意后续通知。"
    )
    updates: list[BaseMessage] = []
    if isinstance(last, AIMessage) and last.id:
        updates.append(RemoveMessage(id=last.id))   # 撤回子 Agent 的结果
    updates.append(AIMessage(content=final_response))
    return {**state, "messages": updates}
RemoveMessage 配合 add_messages reducer,按消息 id 移除已写入的消息------状态统一到 messages 之后,撤回才能这样实现。
其二,合规通过时,不再追加第二份"最终回复"。 合成节点最初沿用旧逻辑:无条件把 final_response 追加进 messages,导致子 Agent 的回复与合成节点追加的回复同时存在,会话历史中出现两条内容相同的 AI 消息。修复方式是在追加前判断末尾是否为子 Agent 已写入的回复:
python
if isinstance(last, AIMessage) and bool(last.content):
return state # 子 Agent 已写入回复,直接收尾配套地,合规节点的审查对象也从"sub_results 拼接串"改成了"messages 末尾的 AIMessage";末尾没有子 Agent 的回复时(比如直达合规审查)直接跳过:
python
last = messages[-1] if messages else None
if not isinstance(last, AIMessage) or not last.content:
    return {**state, "compliance_passed": True}
compliance_result = await self.full_check(last.content)
改造后的整张图:
五、多轮工单:记忆的存储与消费
状态改造完成、checkpointer 接入之后,多轮场景的测试显示上下文问题并没有完全解决。
测试会话中依次发送三条消息:
- 第一条:"我上周买的超声波香薰机坏了,我要申请退款" → 建单成功:
TK-20261011-B35059; - 第二条:"太慢了,给它升级为紧急优先级" → 又建了一张新单:
TK-20261011-78F6D1; - 第三条:"查一下它的进度" → 再建一张新单:
TK-20261011-80BF76。
三条消息,三张工单。检查点里已存有完整历史,为什么升级优先级和查进度的请求仍在新建工单?
原因在 ticket_handler 的分析逻辑:分析请求时,只有最后一条消息进入了 LLM 的 prompt:
python
last_message = messages[-1].content
ticket_info = await self.analyze_request(last_message)   # 历史从未传入
修复分两层:
- 把历史注入分析 prompt。 取最近 10 条对话格式化成文本,和当前消息一起交给 LLM:
python
# 关键修复:把对话历史一并交给分析 LLM,否则它只看得到最新一条消息,
# 无法得知用户指代的已有工单(记忆存了却用不上)
history_text = self._format_history(messages[:-1])
ticket_info = await self.analyze_request(last_message, history_text)
同时在系统 prompt 里把规则写死:指代、查询、处理已存在 工单的消息("那个工单""它""刚才的单子""查一下进度""给它升级优先级"),action 必须是 query 或 update,并从对话历史里提取工单号;此时严禁新建工单。
- 正则兜底: LLM 可能漏带
ticket_id,因此在历史消息中由新到旧扫描,用正则提取最近出现过的工单号作为兜底:
python
TICKET_RE = re.compile(r"TK-\d{8}-[A-Fa-f0-9]{6}")

def _extract_ticket_id(self, messages: list[Any]) -> str | None:
    """从对话历史(由新到旧)中提取最近出现的已有工单号。"""
    for m in reversed(messages):
        content = m.content if isinstance(m.content, str) else str(m.content)
        match = TICKET_RE.search(content)
        if match:
            return match.group(0)
    return None

# 双保险:LLM 没带 ticket_id 时,直接从对话历史里提取
ticket_id = ticket_info.get("ticket_id") or self._extract_ticket_id(messages)
判定逻辑变成:
六、补充一个 chitchat 节点
改造验证过程中发现一类不必要的开销:用户只发送一句"你好",消息也会被路由到 knowledge_rag,多出一次无意义的知识库检索。
解决办法是加一个 chitchat 节点,专门处理打招呼、感谢、告别这类非业务消息,不检索知识库,直接生成回复。行为约束写在系统 prompt 中:
python
CHITCHAT_SYSTEM_PROMPT = """你是一个友好的电商客服,负责处理用户的寒暄与闲聊。
...
回答规则:
1. 简短友好,符合客服场景,不超过3句话
2. 不检索、不编造任何业务信息(商品价格、订单状态等一律不回答)
3. 不做任何业务承诺(退款、赔付、优惠等)
4. 用户若提及具体业务问题,礼貌引导其重新描述,由知识库回答
"""
改动共三处:Supervisor 的路由 prompt 增加 chitchat 选项和路由规则(闲聊 → chitchat,不要为此检索知识库);图上注册 chitchat 节点,和另外两个子 Agent 一样汇聚到合规检查;route_map 增加对应映射。
七、验证
验证环境为本地 docker compose 启动的中间件(含 redis-stack-server),mall-customer 用 python -m api.main 直接启动,测试用例直接调用 Python 服务的接口,不经过 Java 后端,测的就是短期记忆本身。以下均为实际运行结果(模型回复每次生成略有不同)。
多轮上下文与历史读取
新建一个会话,依次发送两轮:
text
[轮1] user: 你好,我叫小明,记住我的名字
[轮1] assistant: 你好小明,很高兴认识你!有什么需要帮忙的,比如查订单、退换货或商品咨询,都可以告诉我。

[轮2] user: 我叫什么名字?
[轮2] assistant: 你叫小明呀~我记住啦。有什么电商相关的问题需要我帮忙吗?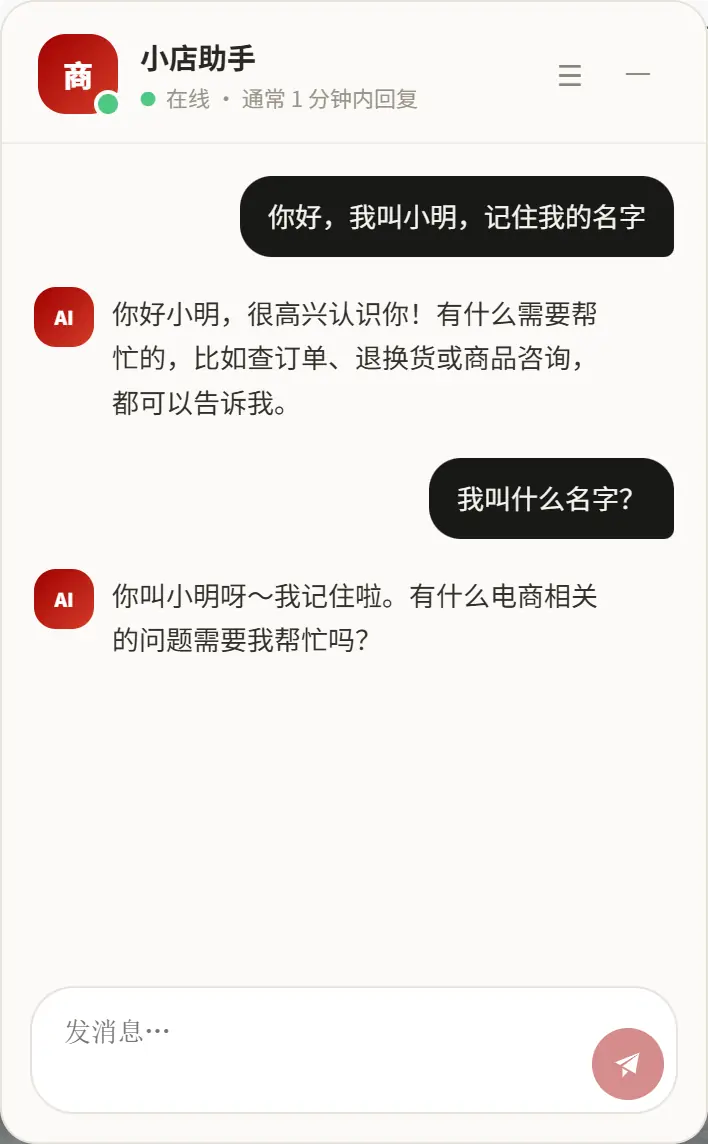
第二轮回答正确引用了第一轮的信息。随后读 /api/history,返回 4 条消息,角色顺序为 user / assistant / user / assistant,与对话一致;last_n=2 时只返回最近两条。
跨进程重启的状态恢复
会话建立后,终止 mall-customer 进程并重启,再读 /api/history,4 条消息完整返回。重启后继续追问:
text
user: 我刚才说我叫什么名字来着?
assistant: 你刚才说你叫小明呀~我记着呢。有什么需要帮忙的吗?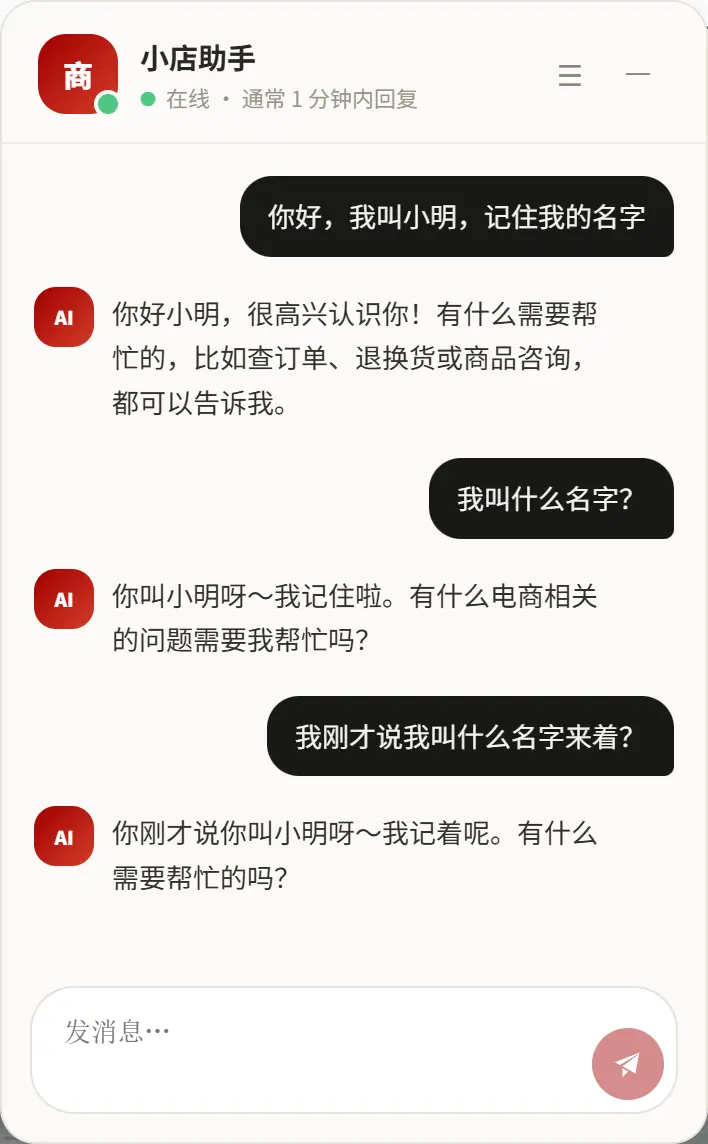
多轮工单:修复前后
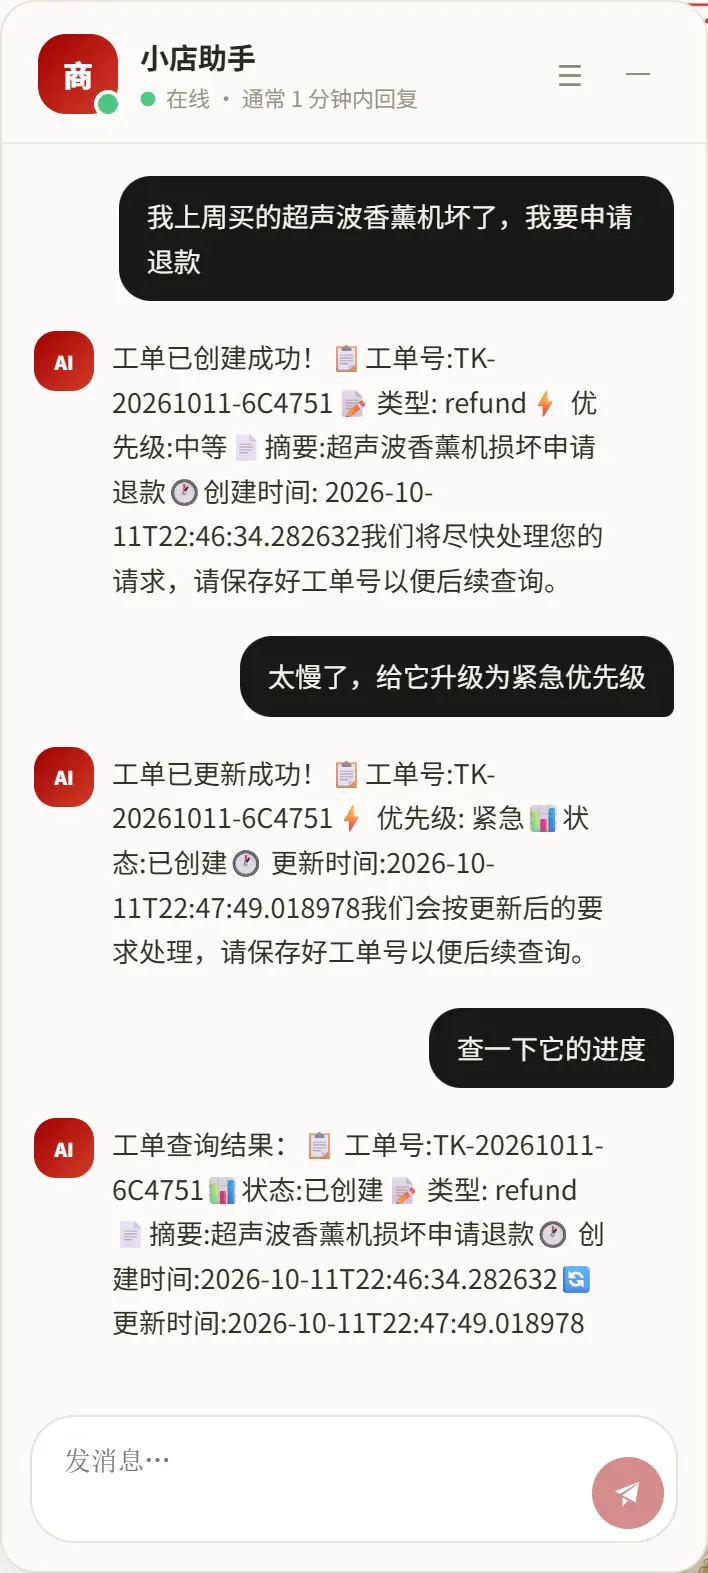
同一个场景(建单 → 要求升级优先级 → 查进度)在修复前后分别验证:
- 修复前:三条消息建了三张工单(
TK-20261011-B35059/TK-20261011-78F6D1/TK-20261011-80BF76),升级优先级和查进度均被当作新诉求; - 修复后:第一条消息建单
TK-20261011-6C4751(中等优先级);第二条"太慢了,给它升级为紧急优先级"返回"工单已更新成功!工单号: TK-20261011-6C4751 ⚡ 优先级: 紧急";第三条"查一下它的进度"直接查回同一张单,更新时间正是升级优先级操作的时间。全程只存在一张工单。
合规撤回与消息去重
这两条路径涉及不适合展示给用户的内容,无法通过对话直接验证,因此用 FakeListChatModel 编写临时冒烟脚本,按图的三条出口分别断言:
- 合规通过:历史里只有一条 AI 回复,没有重复追加;
- 合规不通过:子 Agent 的违规结果被
RemoveMessage撤回,messages里查不到,只留转人工话术; - 直达合规:追加兜底话术"抱歉,暂时无法处理您的请求,请稍后重试。";
- 三轮累积对话:第 1 轮的回复仍在、第 2 轮违规内容没有泄漏、第 3 轮的兜底话术正常,
messages长度与轮次严格对应。
以上断言全部通过。
Redis 里存了什么
一个会话在 Redis 里的实际键(会话 ID test-stm-3ffa40b6):
text
checkpoint:test-stm-3ffa40b6:__empty__:{checkpoint_id}
checkpoint_latest:test-stm-3ffa40b6:__empty__
checkpoint_write:test-stm-3ffa40b6:__empty__:{checkpoint_id}:{task_id}:{序号}
write_keys_zset:test-stm-3ffa40b6:__empty__:{checkpoint_id}checkpoint:是每个 superstep 的状态快照;checkpoint_write:是各节点执行的写入记录(channel 更新);checkpoint_latest:指向该会话最新的检查点;write_keys_zset:记录某次检查点关联的写入键,交给 saver 统一管理 TTL;- 中间那段
__empty__是空命名空间(checkpoint_ns)在存储层的占位,子图场景才会取别的值; - 取样时 TTL 剩余 1797 秒------正好是
default_ttl: 30分钟,且会随读写刷新。
窗口部分,验证会话连续进行了 15 轮对话,状态中的消息数在第 10 轮达到 20 后不再增长:每轮入口先裁到 20 条再处理本轮,轮末最多到 21(20 条窗口 + 本轮回复),下一轮入口再次裁剪;到第 15 轮时,最早的几轮对话已滑出窗口。向一个会话直接写入 22 条消息再触发一轮,最早 2 条被 RemoveMessage 移除,从第 3 条开始保留。
降级路径同样验证过:把 REDIS_URL 指向一个不存在的端口启动,服务打印降级日志后正常启动,checkpointer 类型从 AsyncRedisSaver 变为 InMemorySaver:
text
[ShortTermMemory] Redis checkpointer 初始化失败,降级为内存 MemorySaver: ...
Redis 不可用时 => InMemorySaver
Redis 可用时   => AsyncRedisSaver
小结
这次改造去掉了手写的状态存取,交给框架来做:
- 短期记忆不再由业务代码维护消息列表,
AsyncRedisSaver以thread_id为键持久化整份会话状态:TTL 30 分钟失效,trim_history节点把状态裁剪到最近 20 条,Redis 不可用时自动降级进程内存储; AgentState里只留messages一条主线:子 Agent 的结果直接作为消息存入短期记忆,合规撤回用RemoveMessage,合成节点不再重复追加;- 子 Agent 消费历史是另一件事:工单 Agent 现在分析请求时会带上最近 10 条对话,并用正则从历史里兜底提取工单号,"给它升级优先级"能落到那张已有的工单上。
上一篇剩下的待办里,这篇解决的是"短期记忆"一项;工单持久化(目前仍是内存存储)、业务数据接入、回复的 Markdown 渲染还在后面的计划里。
相关链接
- 项目地址 :github.com/quuuuj/mall
- 在线访问 :mall.qiujie.net.cn/(默认体验账号:
admin/123456)