LingBot-World 能连续生成一小时,为什么回到原地仍可能变样?
一个世界可以持续生成,镜头前的画面也始终自然。但你沿原路返回时,先前打开的门、停放的车和墙上的标记,仍在原位吗?
LingBot-World-Infinity 的论文报告了超过一小时的单次连续 session;同一论文的限制部分又承认:区域离开上下文后再访问,可能被重新生成,而不是按原样取回。两句话并不矛盾。持续输出、响应当前控制、保存可回访的世界状态,是三个不同的验收问题。
本文依据截至 2026 年 9 月 26 日的论文与官方仓库,给出一种能失败、也能复核的回访实验。文中没有本机生成或实时系统测试结果。 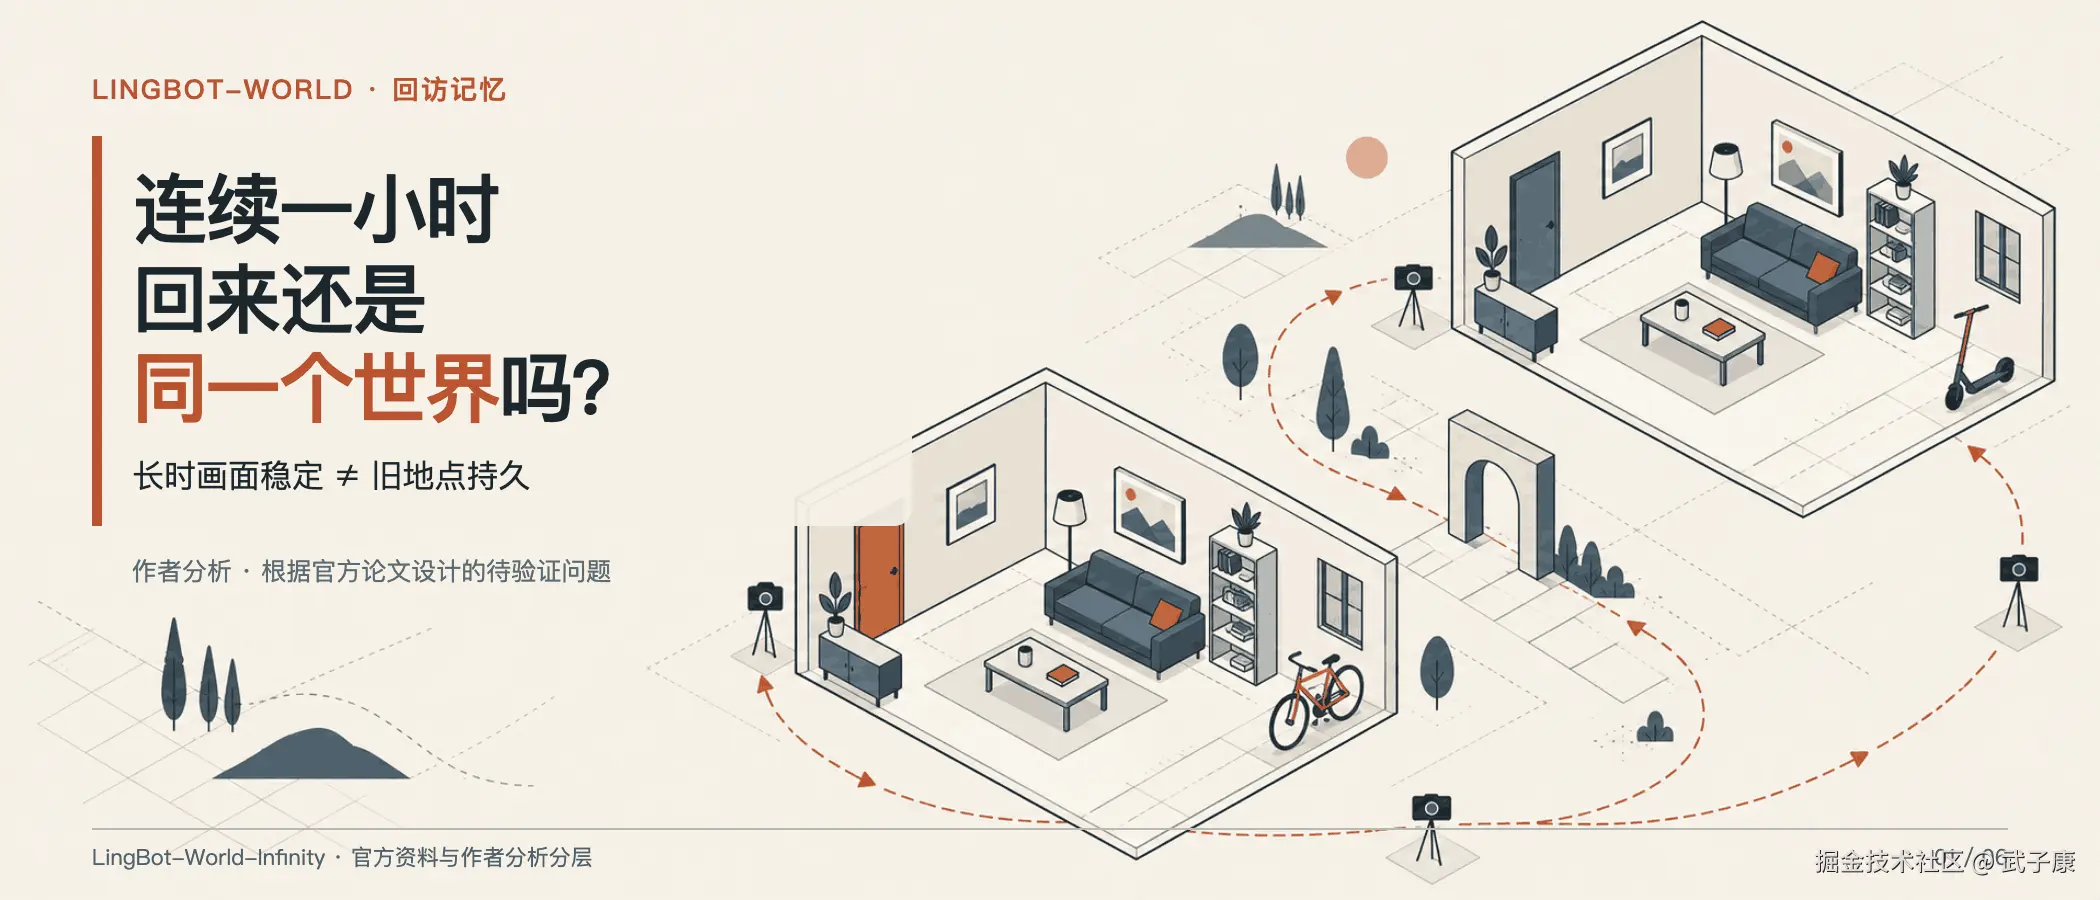
一小时演示到底证明了什么
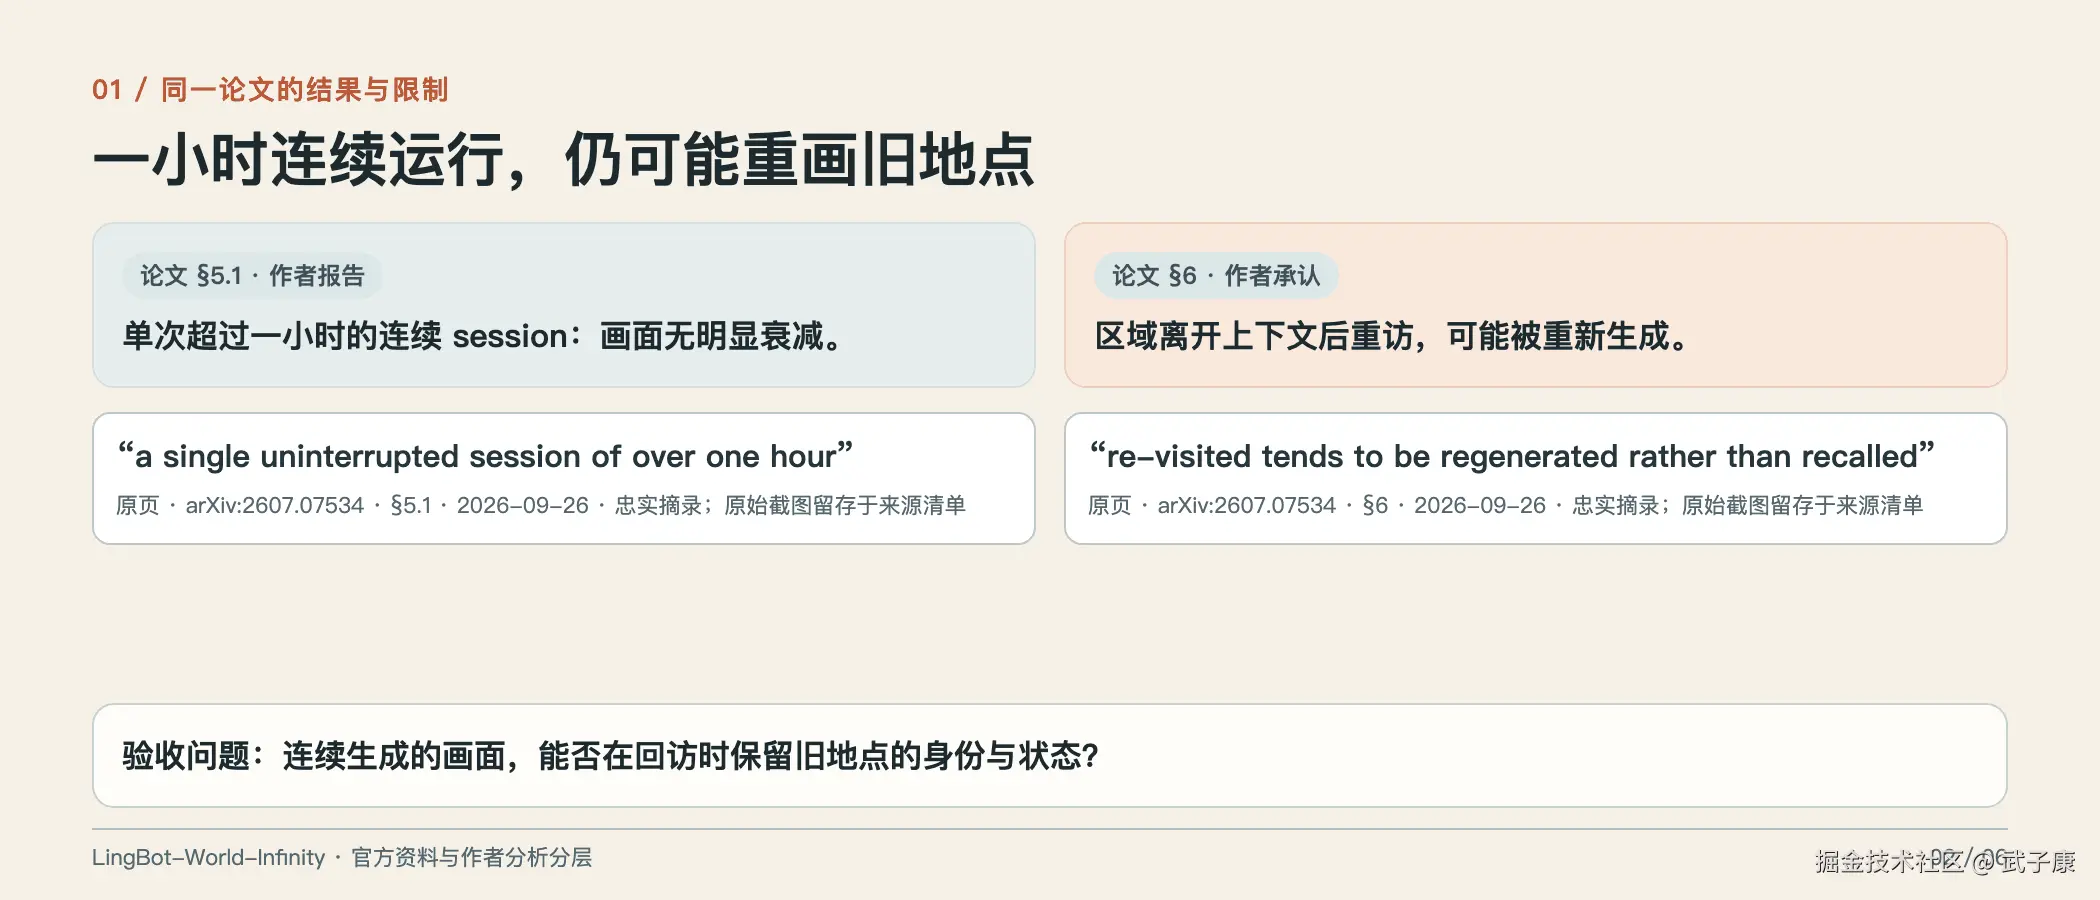
自回归视频模型会把已生成帧继续作为条件,误差有机会一块块累积。纹理、几何和角色如果在长时间滚动生成中没有明显塌陷,就是一项有价值的结果。论文第 5 节用超过一小时的连续运行展示这一点,并在第 3、4 节说明因果预训练、蒸馏与实时系统优化。论文全文
但单向前进时,模型未必需要重新找到一个已离开视野很久的具体对象。因此三类问题要分开观察:
| 要验收什么 | 应观察什么 | 一小时单向演示能否回答 |
|---|---|---|
| 长时输出 | 视频是否继续、画面是否逐渐损坏 | 可以提供作者报告的证据 |
| 当前控制 | 同一起点下不同动作能否形成预期分叉,响应是否及时 | 需要动作与时间对照 |
| 世界持久性 | 返回旧地点后,布局、对象身份和已发生事件是否保持 | 需要回访及状态记录 |
论文第 6 节把第三项限制说得很清楚:模型尚未真正记住已生成世界;区域离开上下文后,重访时可能重新生成,角色身份、风格和物理交互也仍可能失真。这限定了第一项结果的解释范围,并不抹去长时生成的进展。
为什么动态 KV Cache 不等于世界存档
模型生成下一帧或下一块时,会利用前面的画面、相机姿态与文字条件。论文描述的底层控制主要是相机姿态和分块提示;更复杂的对象操作与事件由上层 Agentic Harness 组织。相机路径不是机器人电机命令,也不是游戏引擎的完整状态变更。论文第 3.2、4.2 节
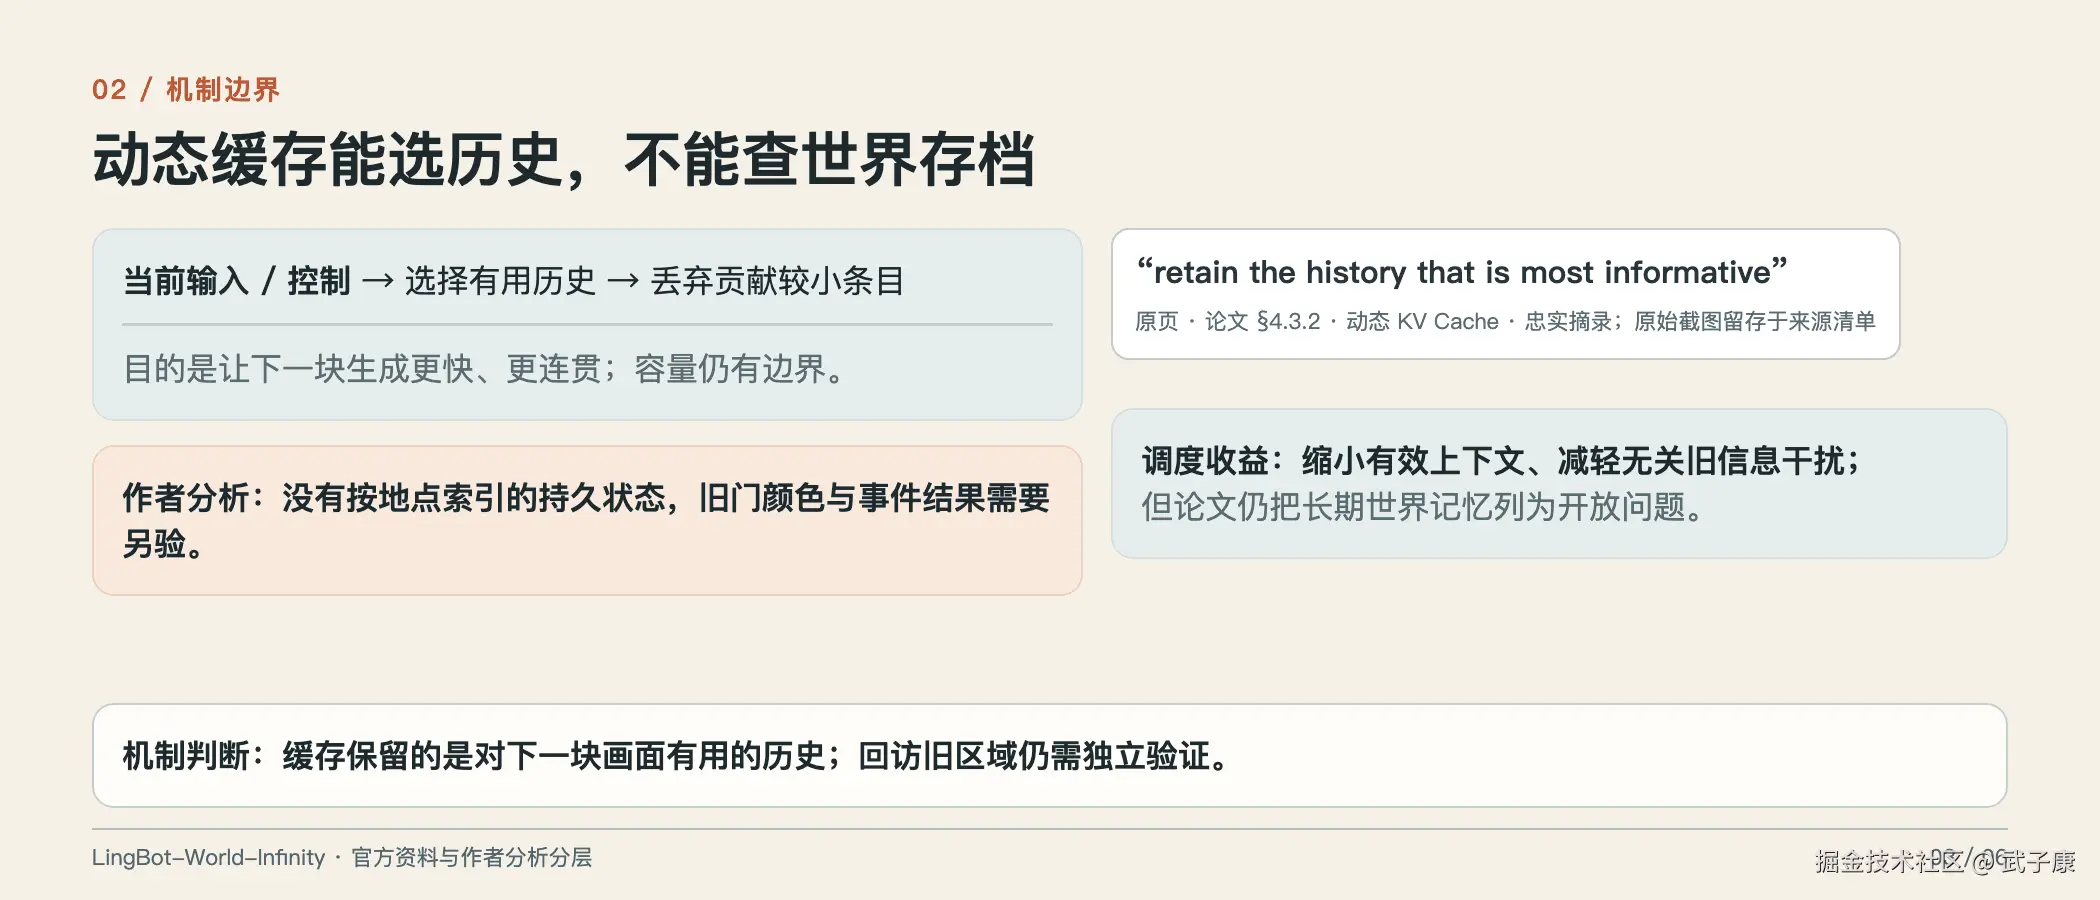
KV Cache 留下部分历史特征,让下一块视频利用先前内容。实时系统中的动态缓存调度会依据当前输入选择较有用的历史,并丢弃部分条目,以控制计算成本和干扰。论文第 4.3.2 节
缓存的作用是为当前生成提供有限上下文。它并不是一个按地点索引、可精确查询的世界数据库。某个房间离开上下文后,再出现的房间可以在风格上相似,却未必保留那扇门的颜色、车辆的方向或先前事件的结果。若应用要求"回来时仍是同一件物体",持久状态或独立回访校验就必须另做;公开论文没有交付一个已验证的持久世界状态接口。
公开代码能测到哪一层
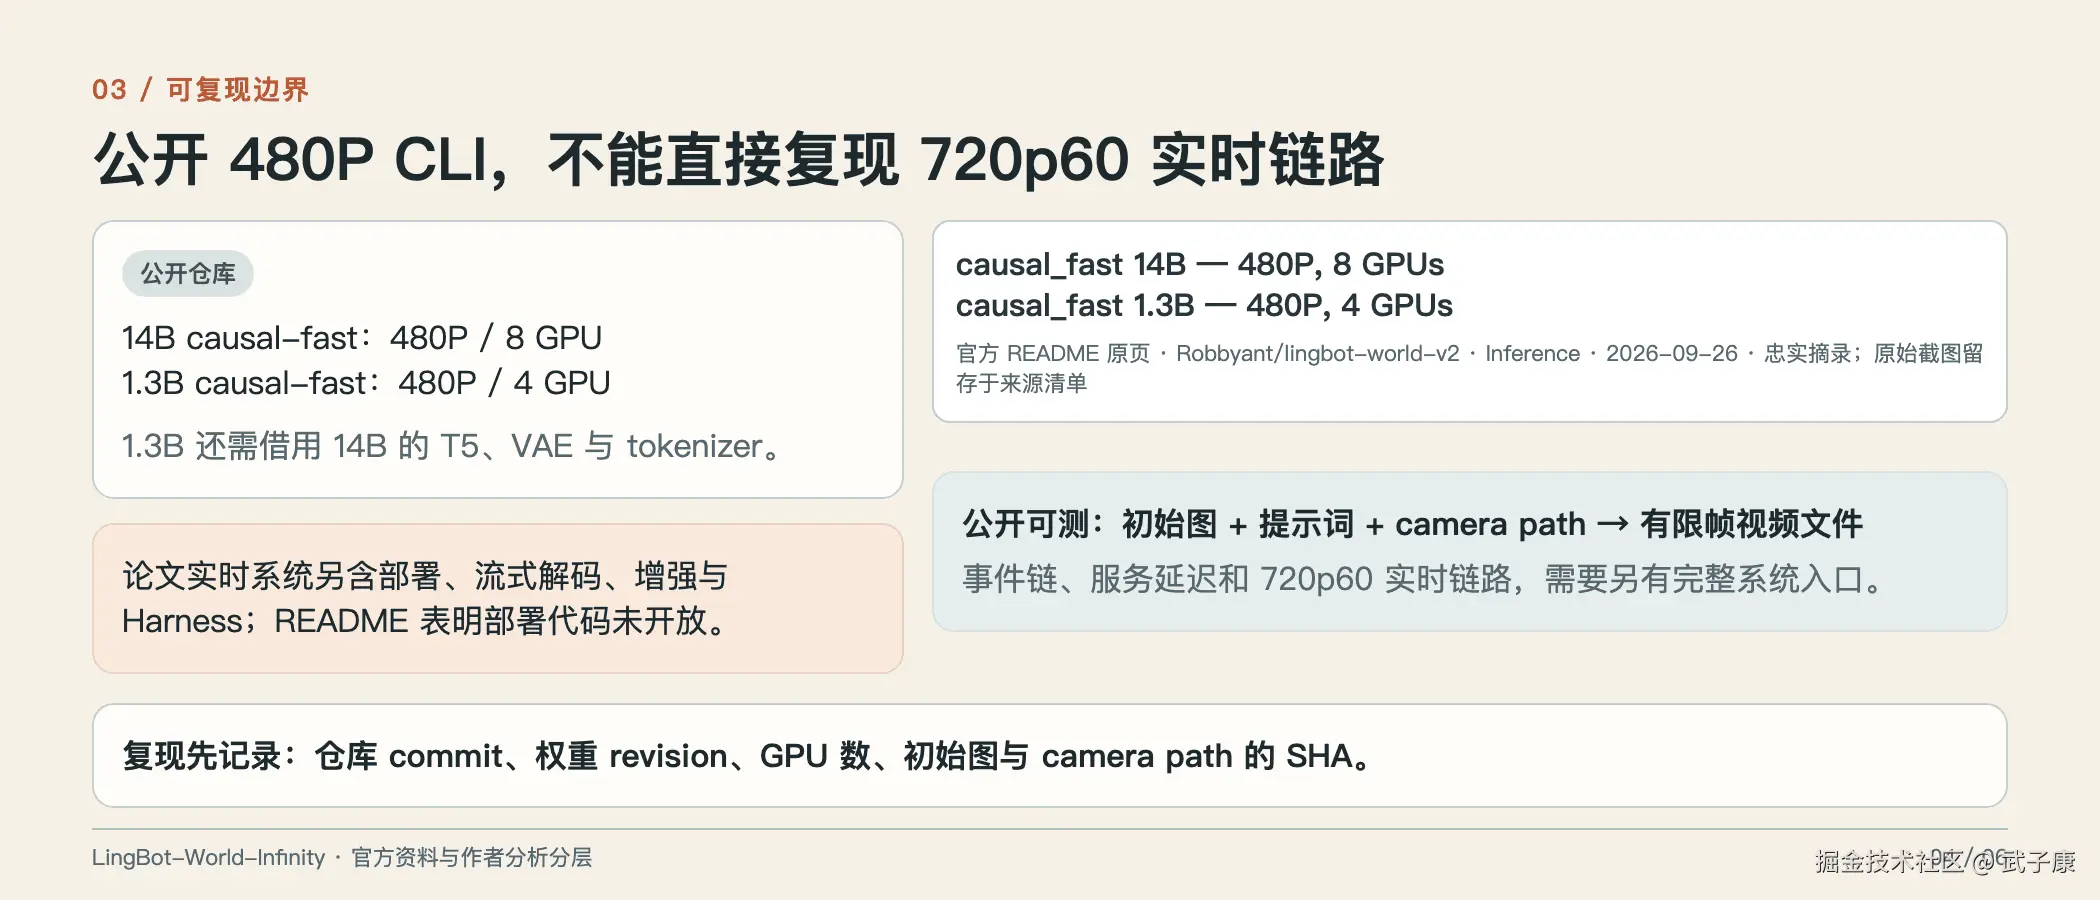
项目官方 README给出 14B causal-fast 的 480P、8 GPU 示例,以及 1.3B causal-fast 的 480P、4 GPU 示例。1.3B 包只含 DiT 权重,T5、VAE 和 tokenizer 还要取自 14B 发布资产。公开的 generate.py 使用初始图片、文字与 --action_path 生成有限帧数的视频文件;脚本把 action_path 解释为 camera path。
论文另报告一条部署系统链:编译与并行、异步 VAE 解码、逐帧流式传输、时空增强和动态缓存调度,共同支撑作者展示的 720p、60 fps 实时交互。运行 README 的离线 480P 命令,不会自动复现这一链路。README 也明确说不计划开放其部署代码。论文第 4 节、仓库说明
论文摘要的"1.3B 单 GPU 可部署"与当前 README 的四 GPU 公开示例,描述的是不同实现条件;不能把前者写成当前 CLI 的单卡复现命令。本文不据此估算 A6000 显存,也不把 camera path 脚本当成已开放的 Director/Pilot 事件控制系统。
设计一次能失败的回访实验
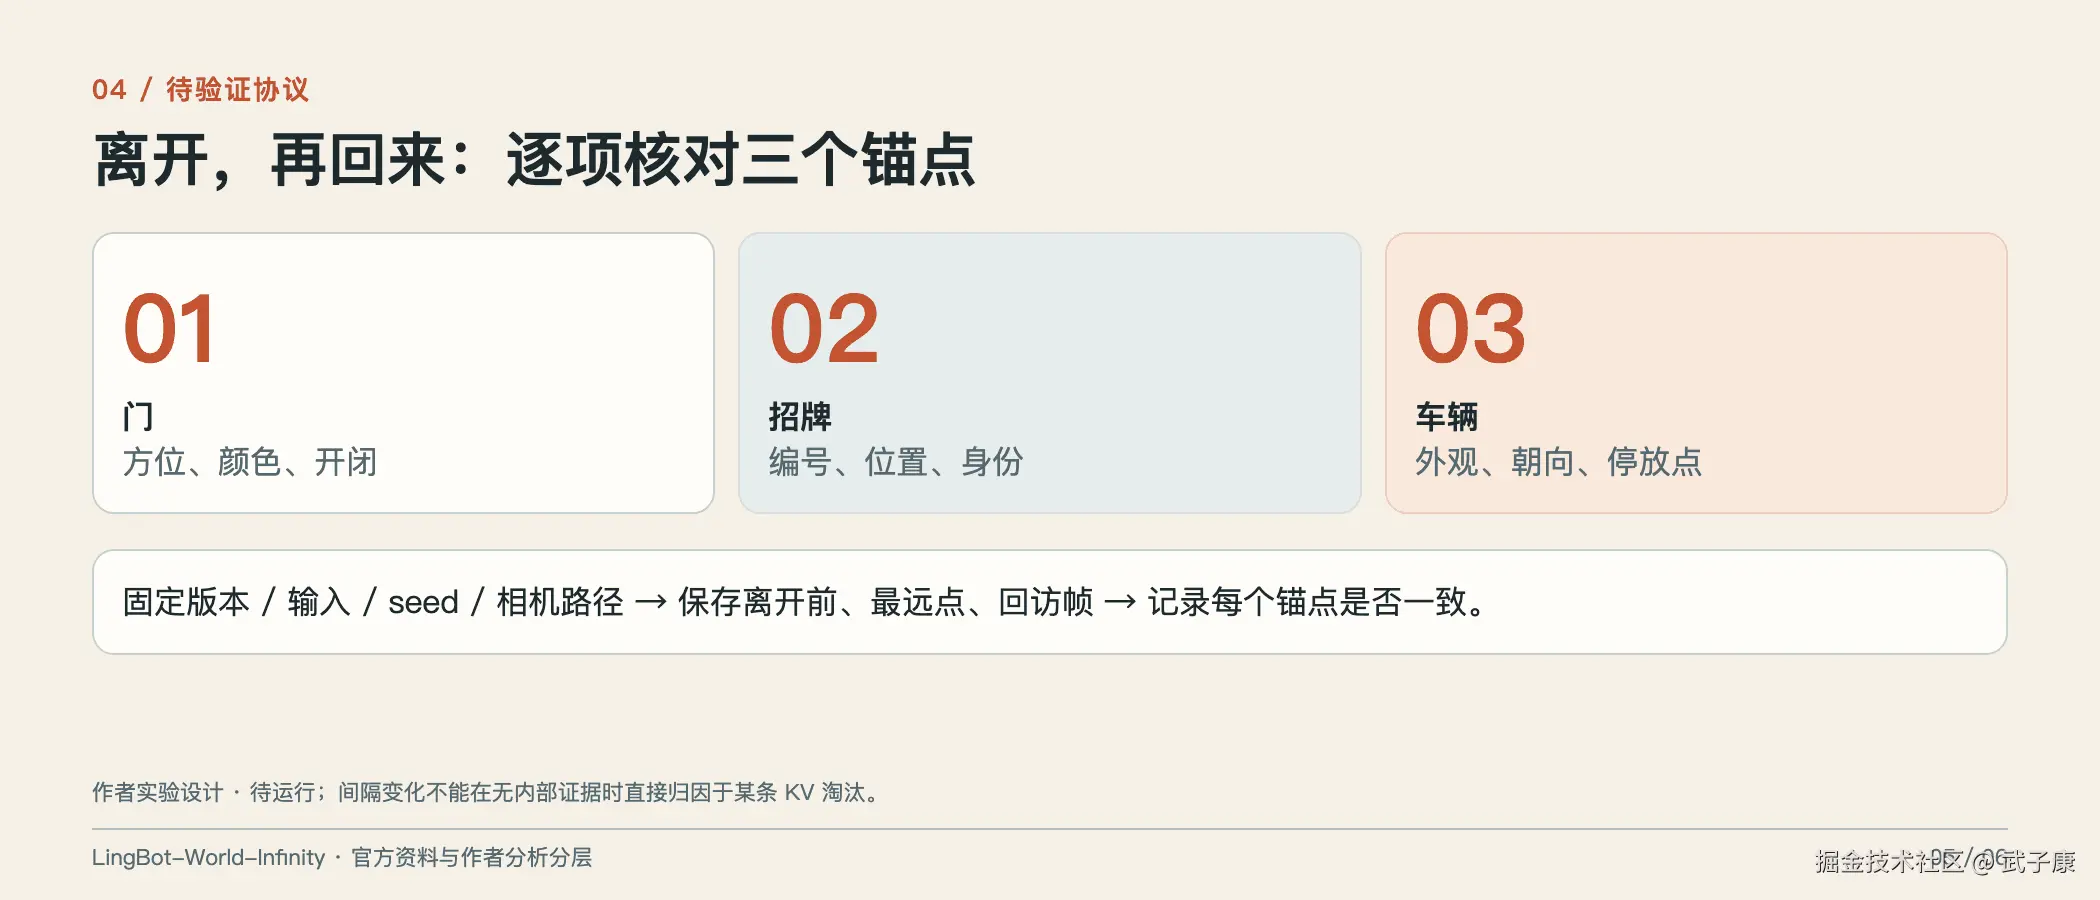
实验要把三个能力分开留下证据。先固定仓库 commit、权重 revision、推理后端、设备、分辨率、帧数、seed、初始图像和控制文件。公开 CLI 只能先测其支持的离线输入;实时热键、Agent 事件与服务延迟需要另记完整系统版本。
1. 旧地点:锚点是否仍是同一组
在初始场景选三个可识别锚点,例如左右不同颜色的门、带编号的招牌、固定位置的车辆。让镜头离开、经过多个视频块,再沿明确路径返回。保存离开前、最远点与返回时的关键帧,逐项记录门的方位与颜色、招牌编号、车辆身份及位置。不要只给整体"像不像"的印象分。
把离开到回访的间隔与缓存参数一并记录,逐步增加路径长度或间隔。短距离回访成功,只说明那一组条件下历史可能仍足够;失配也不能在没有缓存内部证据时直接归因于某条 KV 被淘汰。可报告的是"锚点随间隔变化的现象"。
2. 事件:发生过的事有没有保留
如果系统确实提供可执行的对象事件,让门打开或物体移动,然后离开并回访。分别检查动作是否发生、结果是否保持、回访时是否退回未执行前的版本。
论文的 Agentic Harness 通过 VLM 和视频生成器联动处理对象与事件。单独给 generate.py 一条 camera path 并不能复现这条事件链。只有公开 CLI 时,事件保持应标为"当前入口不可测";文字提示生成一段开门视频,不能替代状态更新和回访。
3. 控制:同一起点能否按动作分叉
固定初始图像、prompt 和 seed,仅改变一个控制变量,例如左转与右转的相机路径。比较早期响应方向、响应延迟、场景分叉及各自的回访结果。它可以测控制是否被使用;即使分叉清楚,也不能推出长期记忆成立。
每次实验至少保留:模型和权重 revision、仓库 commit、后端与设备;输入图、提示词和控制文件的 SHA;分辨率、帧数、seed、chunk 与缓存参数;关键帧和时间戳;预先指定的锚点;期望和实际控制响应;回访逐项结果及失败位置。没有实际生成与逐帧目检,不填写"通过"。
回到应用判断
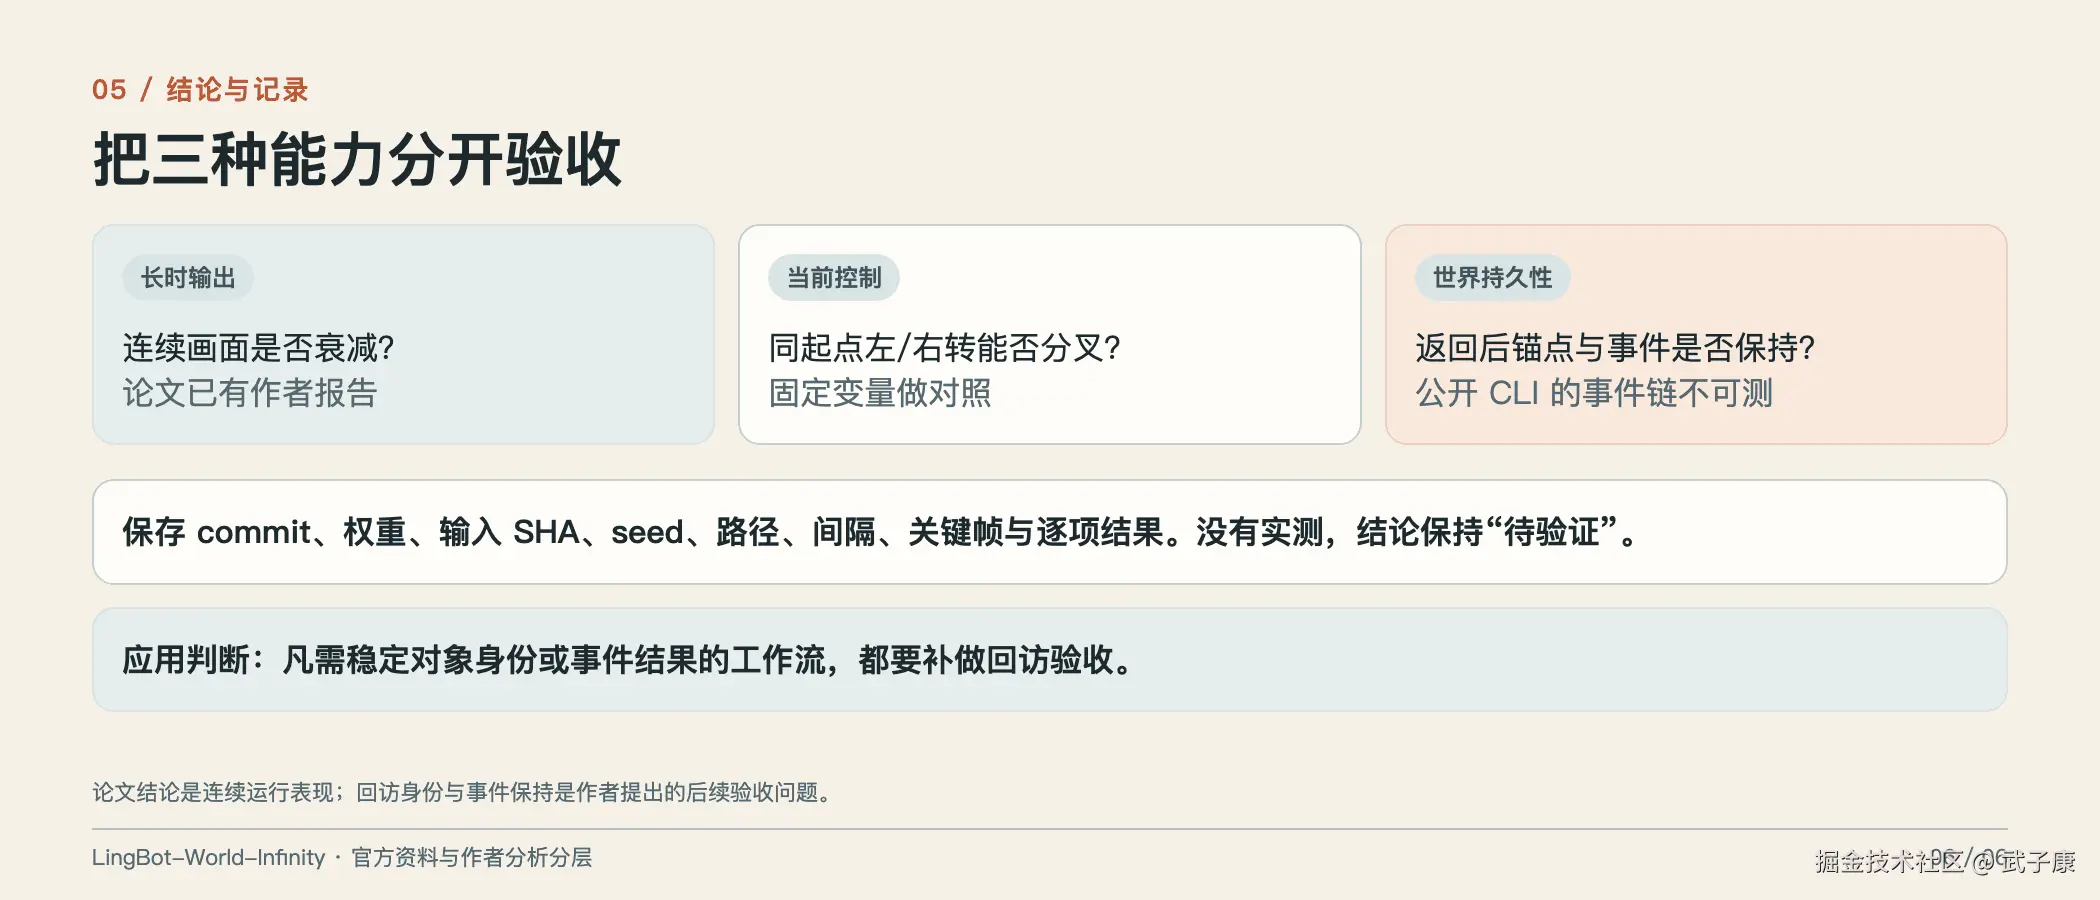
互动原型可能只要求画面连续和即时响应;需要稳定对象身份、可查询场景或可验证动作结果的 Agent 与机器人工作流,则必须单独验收世界持久性。视频回访成功本身,也不证明真实机器人的闭环控制安全。
现在的公开证据支持提出回访问题、设计离线锚点试验,并清楚划出哪些事件链尚不能由公开入口测试。"能连续生成一小时"是一项结果;"回来时仍是同一个世界"仍须另交证据。
资料:官方论文(第 3--6 节);官方仓库(权重、离线示例和部署边界);公开推理脚本(camera path 与帧数参数)。论文性能为作者报告,本文未运行模型。