调用一次大模型 API 很简单:提交消息,等待模型返回文本。真正困难的是解释下面这些现象:为什么相同问题会得到不同答案,为什么上下文越长反而越容易遗漏信息,为什么流式输出能显著改善体验,以及为什么一个看起来很便宜的请求在多轮对话中会迅速变贵。
这些现象并不是 API 的偶然行为,而是由大模型的生成机制决定的。本文从一次请求的完整生命周期出发,建立一套可以直接用于系统设计、故障分析和成本治理的技术模型。
一、一次模型调用究竟发生了什么
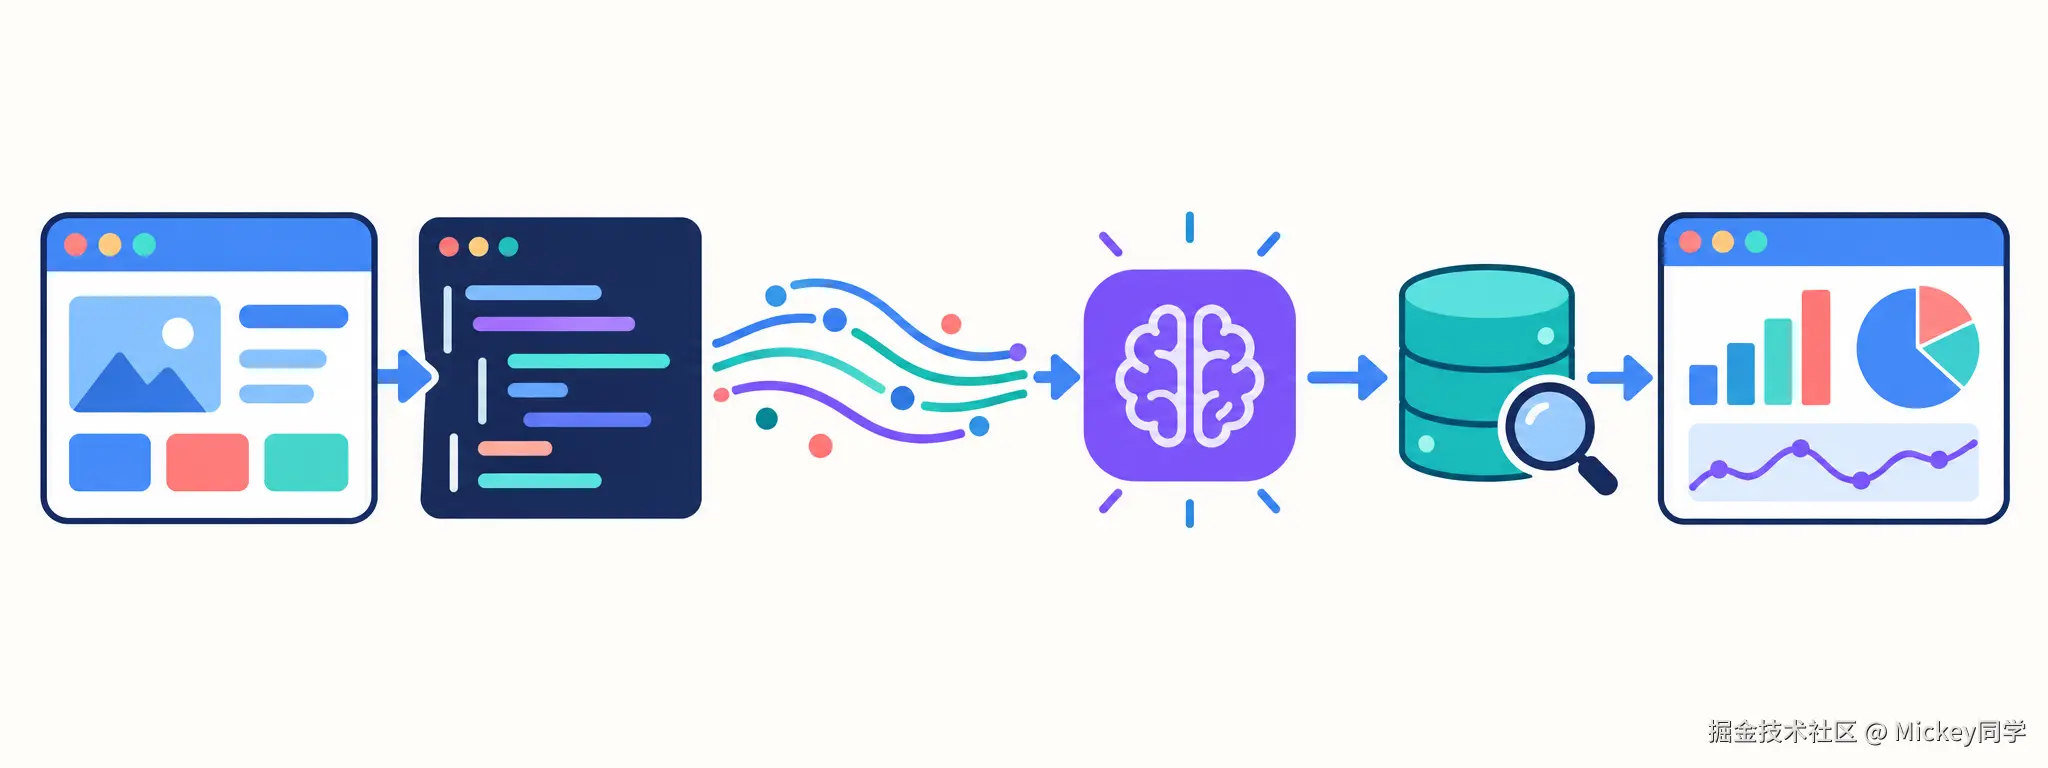
一个典型请求会经过六个阶段:
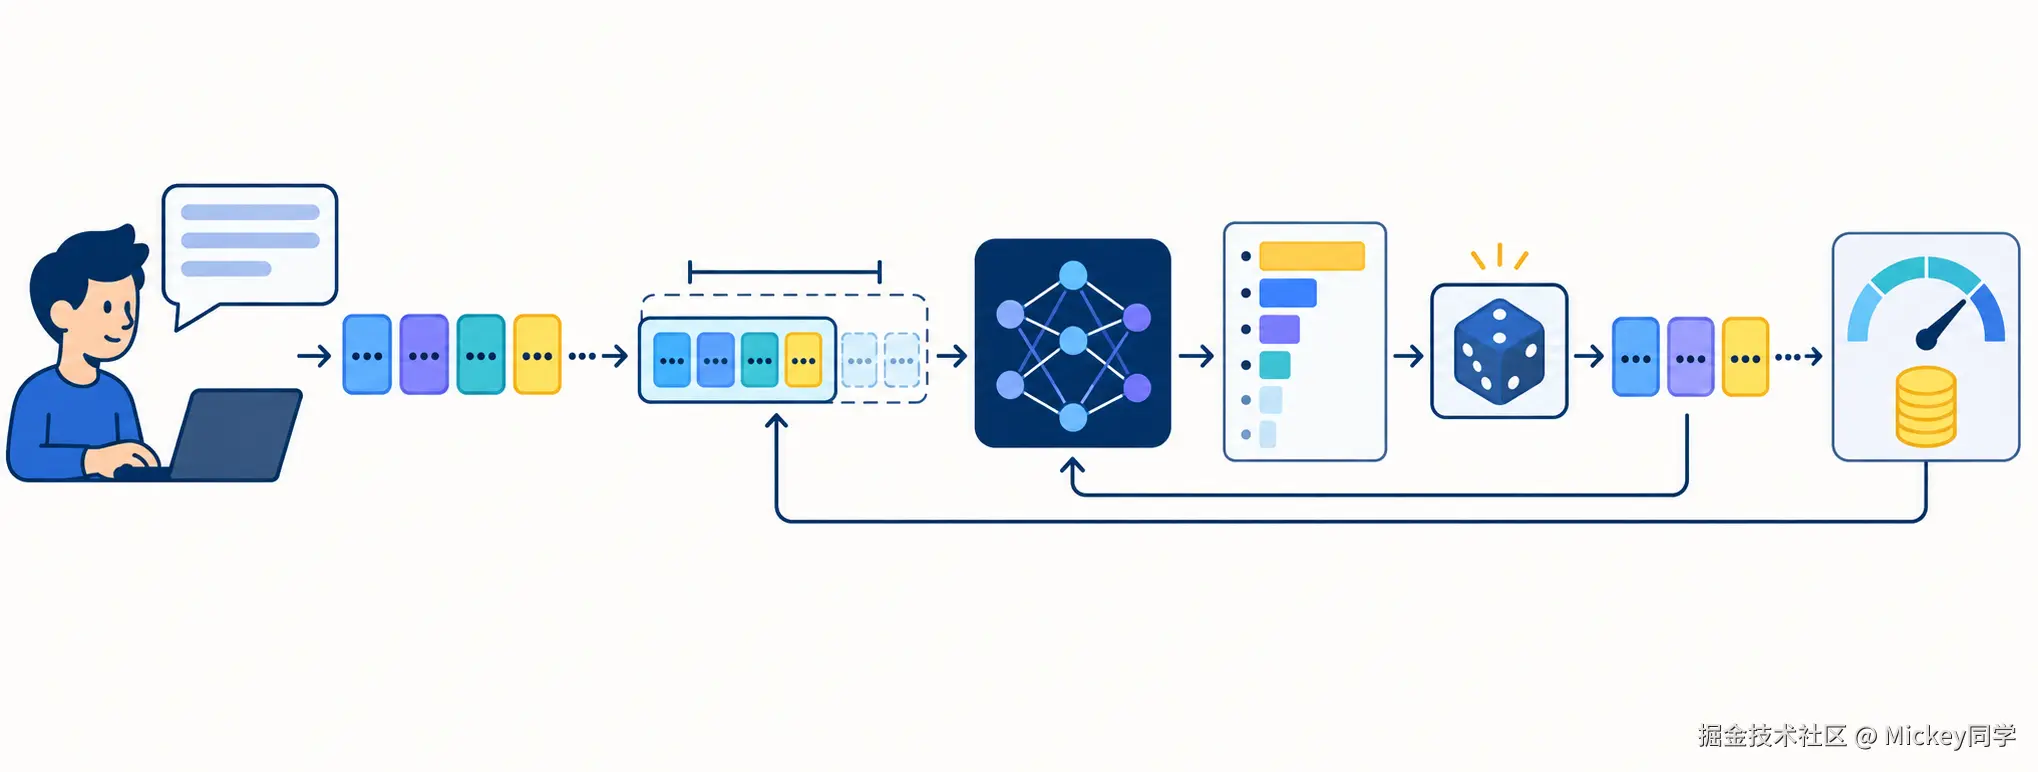
模型并不是一次性写出整段答案。它每轮只做一件事:根据当前上下文,计算词表中每个 Token 成为"下一个 Token"的可能性,再从中选出一个。新 Token 会追加到上下文,参与下一轮计算,直到生成结束标记或达到长度上限。
因此,一段 500 Token 的回答,至少经历了约 500 次自回归生成。流式接口只是把已经生成的片段尽快交给客户端,并没有改变模型逐 Token 生成的本质。
在工程上,一次调用还包含模型之外的链路:
- 应用层负责身份、权限、会话、输入校验和输出渲染;
- 上下文层负责系统指令、历史消息、检索结果和工具结果的编排;
- 模型层负责概率推断,而不是事实查询或事务提交;
- 工具与数据层提供模型参数中没有的实时知识和确定性能力;
- 观测层记录延迟、Token、成本、检索证据、工具轨迹和错误类型。
把这些职责混在一个 Prompt 里,通常就是系统从 Demo 走向生产时开始失控的原因。
二、Token 是模型真正处理的单位
模型看到的不是字符、单词或 JavaScript 字符串,而是一串整数 ID。Tokenizer 会把输入转换成 Token 序列:
text
原始文本 -> 子词或字节片段 -> Token ID -> 向量表示现代模型常使用 BPE、Unigram 或它们的变体。以 BPE 的直觉为例:先把文本拆成很小的单元,再反复合并语料中高频相邻片段。常见词可能只占一个 Token,罕见词会被拆成多个 Token。
这会带来三个重要后果。
1. 字符数不能准确代表成本
同样长度的中文、英文、代码、Base64 或随机 ID,Token 数可能差异很大。下面只能作为直觉,不能作为计费依据:
text
一段自然英文       通常能以常见子词压缩
中文与混合语言     取决于词表覆盖率
代码与 JSON        标点、缩进、标识符都会占 Token
随机串和 Base64    重复模式少,往往更昂贵
可靠做法是在发送请求前使用对应模型的 tokenizer 估算,而不是用 text.length。
2. 截断必须按 Token 进行
如果系统按字符截断,既无法精确控制窗口,也可能把代码块、JSON、UTF-8 字节或检索段落截断在不可解析的位置。正确顺序是:先按业务边界分段,再计算 Token,最后按预算选择完整片段。
3. Tokenizer 也是模型契约的一部分
更换模型时,即使 Prompt 完全相同,Token 数、边界和成本也可能变化。因此模型迁移测试不能只比较回答质量,还应记录:
- 输入和输出 Token 数;
- 长文本截断位置;
- 结构化输出稳定性;
- 首 Token 延迟与生成速度;
- 相同评估集上的单位成功成本。
4. 字节级 Token 会影响流式解码
部分 tokenizer 会退化到字节级表示。一个中文字符或 Emoji 的 UTF-8 字节可能落在多个 Token 中,而模型服务返回的网络分块又可能继续切断 Token 对应的字节序列。因此下面的做法并不安全:
ts
// 错误示例:每个分块单独解码,可能产生替换字符 �
const text = new TextDecoder().decode(chunk);
应复用同一个 TextDecoder,让它保留未完成的多字节序列:
ts
const decoder = new TextDecoder("utf-8", { fatal: false });
let text = "";

for await (const chunk of byteStream) {
  text += decoder.decode(chunk, { stream: true });
}

text += decoder.decode(); // 刷出解码器内部剩余字节
这说明应用看到的三种边界并不相同:
text
模型 Token 边界 ≠ UTF-8 字符边界 ≠ HTTP 网络分块边界流协议只能在自己的事件边界上解析 JSON,Markdown 只能在累计文本上解析语法,不能假设一次 read() 就对应一个完整 Token、字符或事件。
三、下一 Token 概率是怎样产生的
模型对词表中每个候选 Token 输出一个未归一化分数,称为 logit。Softmax 把这些分数转换成概率:
P(xi)=∑jezj/Tezi/T
其中:
- zi 是候选 Token 的 logit;
- T 是 temperature;
- P(xi) 是采样概率。
假设三个候选 Token 的 logits 是 [3, 2, 1]。当温度较低时,最大值会更加突出,输出更稳定;温度升高时,概率分布变平,低概率候选更容易被选中。
严格地说,上式要求 T>0。API 中的 temperature=0 通常表示采用贪心或接近贪心的实现,并不是把 0 直接代入分母。
需要注意:temperature 不会让模型"知道更多",它只改变已有概率分布的形状。知识问答提高温度通常不会减少事实错误,只会让错误表达得更多样。
Greedy、Top-k 与 Top-p
常见解码策略并不等价:
- Greedy:总是选择概率最高的 Token,可复现性较好,但可能出现机械重复或局部最优;
- Top-k:只保留概率最高的 k 个候选,再重新归一化;
- Top-p:从高到低累加概率,只保留累计概率达到 p 的最小候选集合;
- 随机采样:按过滤后的概率抽取,能提高多样性,也引入不确定性。
Top-p 的候选数量会随分布变化:模型很确定时集合可能只有几个 Token;模型不确定时集合会自动扩大。这也是它比固定 Top-k 更适合通用生成的原因之一。
生产系统应根据任务设置采样参数,而不是全站共用一组配置:
| 任务 | 建议倾向 | 原因 |
|---|---|---|
| 分类、抽取、路由 | 低温度、严格 Schema | 需要稳定和可验证 |
| 事实问答 | 低温度、带证据 | 多样性价值低 |
| 摘要 | 中低温度 | 兼顾忠实度与表达 |
| 创意写作 | 中高温度 | 允许探索更多候选 |
即使 temperature 为 0,也不应把模型调用理解为严格确定性函数。并行计算、服务端模型版本、量化方式和供应商实现都可能造成细微差异。真正需要幂等的业务,必须在应用层实现幂等,而不能依赖模型每次返回相同文本。
用熵观察模型到底有多犹豫
概率分布的熵可以描述下一步选择的不确定性:
H(P)=−i∑P(xi)logP(xi)
当一个 Token 的概率接近 1 时,熵较低,说明模型对下一步较确定;当很多候选概率接近时,熵较高,说明模型存在多条可能路径。温度升高通常会让分布更平、熵更高。
供应商未必暴露完整 logits,但这个概念仍然有工程意义:创意任务允许高熵输出,分类和工具参数则应尽量降低不确定性,并通过枚举、Schema、候选约束和业务校验把输出空间收紧。
不要把模型给出的 confidence 字段直接当作统计置信度。它通常也是模型生成的文本,没有经过校准。若业务需要概率意义上的置信度,应在标注集上比较预测分数与真实正确率,并使用可靠性图、ECE 等方法做校准。
四、Transformer 为什么需要上下文窗口
Transformer 会把每个 Token 转换成向量,并通过自注意力计算不同位置之间的关系。单个注意力头的核心形式可以写成:
Attention(Q,K,V)=softmax(dk QKT)V
直觉上,Query 表示当前位置想找什么,Key 表示每个位置能被怎样匹配,Value 表示匹配后实际取回的信息。 QKT 会产生一个"每个位置关注其他位置"的矩阵。
当序列长度为 n 时,标准注意力矩阵包含 n2 个位置关系。虽然现代模型会使用 FlashAttention、分组查询注意力、滑动窗口注意力等优化,但长上下文依然会显著增加显存、计算和延迟。
上下文窗口是工作区,不是长期记忆
上下文窗口包含的通常是:
text
系统指令
+ 开发者规则
+ 当前用户输入
+ 历史消息
+ 检索文档
+ 工具参数与结果
+ 模型输出预算
可以把预算写成:
Btotal=Binstruction+Bhistory+Bretrieval+Btools+Boutput
任何一部分增长,都会挤压其他部分。一个支持 128K 上下文的模型,并不意味着应该塞满 128K;更长的输入会带来更高成本、更长首 Token 延迟,以及重要信息被噪声淹没的风险。
Lost in the Middle 与上下文腐化
模型对上下文中不同位置的利用并不均匀。关键证据位于超长上下文中部时,可能不如开头或结尾稳定;加入大量相似但无关的材料,还会让注意力在多个候选之间分散。
因此上下文工程的目标不是"放进去最多的信息",而是"在预算内放入完成当前任务所需的最小充分信息"。
五、API 通常是无状态的,记忆来自应用
多数大模型 API 不会自动记住上一次请求。所谓多轮对话,通常是应用在每次调用时重新发送必要历史:
这解释了为什么对话轮数增加时成本会不断上升。如果每次都携带所有历史,第 i 轮的输入包含前 i−1 轮内容,总输入量会接近二次增长。
假设每轮用户输入 200 Token、模型输出 400 Token,忽略系统指令:
text
第 1 轮输入:200
第 2 轮输入:200 + 400 + 200 = 800
第 3 轮输入:200 + 400 + 200 + 400 + 200 = 1400
...
10 轮对话不是只支付 10 次单轮成本。应用需要组合使用:
- 最近消息滑动窗口;
- 旧历史结构化摘要;
- 用户偏好的长期记忆;
- 按当前问题检索相关往事;
- 对不可丢失的业务状态使用数据库,而不是自然语言摘要。
KV Cache 与 Prompt Cache 不是同一件事
模型生成时会复用此前 Token 的 Key/Value 表示,这称为 KV Cache,它避免每生成一个 Token 都重新计算整个前缀。KV Cache 主要发生在一次生成内部,也会占用随上下文增长的显存。
部分供应商提供 Prompt Cache:当多个请求共享相同前缀时,服务端可以复用前缀计算,并对命中的 Token 提供更低价格或更低延迟。要提高命中率,应把稳定内容放前面,把动态内容放后面:
text
稳定系统指令 -> 稳定工具定义 -> 稳定知识前缀 -> 动态历史 -> 当前问题如果在前缀中加入时间戳、随机 ID 或频繁变化的用户数据,会导致后续完全相同的规则也无法命中缓存。
Prefill 与 Decode 是两种不同的计算阶段
一次生成可以拆成:
text
Prefill:并行处理全部输入 Token,建立每层 KV Cache
Decode:每轮生成一个新 Token,并把新的 K/V 追加到缓存
输入很长时,Prefill 主导 TTFT;输出很长时,串行 Decode 主导总耗时。优化时必须先判断瓶颈属于哪一段:
| 现象 | 更可能的瓶颈 | 优先手段 |
|---|---|---|
| 首字很慢,生成后速度正常 | Prefill 或排队 | 减少输入、缓存稳定前缀 |
| 首字正常,后续输出很慢 | Decode | 限制输出、换高吞吐模型 |
| 工具之间停顿很长 | 外部 I/O | 并行只读工具、超时与缓存 |
| 并发升高后全部变慢 | 排队或显存压力 | 限流、批处理、容量扩展 |
KV Cache 的占用会随层数、序列长度和并发数线性增长。忽略对齐与实现差异,一个使用 GQA/MQA 的近似公式是:
MemoryKV≈2⋅L⋅N⋅Hkv⋅D⋅B
其中 L 是层数, N 是当前序列长度, Hkv 是 KV 头数, D 是每个头的维度, B 是每个元素的字节数;前面的 2 分别代表 Key 和 Value。批量与并发还会继续乘上对应序列数。
例如 L=32、 N=32,768、 Hkv=8、 D=128、BF16 每元素 2 字节,仅一条序列的 KV Cache 就约为:
2×32×32768×8×128×2≈4GiB
这个估算解释了为什么"模型支持超长上下文"和"系统能以低成本承载大量超长并发"是两回事。GQA 与 MQA 通过减少 KV 头数降低缓存占用,但不会让上下文成本消失。
六、幻觉不是一个单一故障
模型的目标是生成"在当前上下文下概率合理的后续文本",不是执行数据库中的真值查询。所谓幻觉至少可以拆成四类:
| 类型 | 根因 | 典型治理方式 |
|---|---|---|
| 参数知识错误 | 模型记忆过时或模糊 | RAG、实时工具、要求引用 |
| 上下文遗漏 | 证据未召回或被截断 | 检索评估、上下文预算 |
| 指令冲突 | 多层规则含义不一致 | 明确优先级、Prompt 回归 |
| 推理与计算错误 | 概率生成不等于精确计算 | 代码执行、计算器、规则引擎 |
"请不要编造"只能提供弱约束。更可靠的系统会把不确定性显式设计进协议:
json
{
  "answer": "无法从当前资料确认",
  "status": "insufficient_evidence",
  "citations": [],
  "confidence": 0.21
}
然后由服务端验证:引用是否真实存在、引用片段是否支持结论、低于阈值时是否触发拒答或人工确认。
七、结构化输出为什么比解析自然语言可靠
如果下游程序需要使用模型结果,不要从一段自然语言里用正则表达式"捞字段"。应该提供 JSON Schema 或等价约束,并在服务端再次校验:
ts
import { z } from "zod";

const TicketResult = z.object({
  category: z.enum(["billing", "account", "bug", "other"]),
  urgency: z.enum(["low", "medium", "high"]),
  reason: z.string().max(300),
});

const parsed = TicketResult.safeParse(modelOutput);
if (!parsed.success) {
  // 记录失败原因,可选择修复调用或受控重试
}
Schema 约束解决的是"形状正确",不保证"语义正确"。例如 urgency: high 可以通过校验,但仍可能分错。完整链路要分三层验证:
- 语法层:是否是合法 JSON;
- 结构层:字段、枚举、长度是否符合 Schema;
- 业务层:字段组合是否满足业务规则,是否有证据支持。
工具调用也是结构化输出的一种。模型只负责提出"调用什么工具、参数是什么";权限判断、参数校验、幂等、超时与审计必须由应用执行。
八、Embedding 为什么能用于语义检索
生成模型输出 Token,Embedding 模型则把一段文本映射为高维向量。语义相近的文本,其向量方向通常更接近。常用的余弦相似度为:
cos(θ)=∥A∥∥B∥A⋅B
向量检索的一般流程是:
text
文档切分 -> 计算文档向量 -> 写入向量索引
用户问题 -> 计算查询向量 -> 近邻搜索 -> 返回候选片段
但向量相似并不等于事实相关。精确型号、错误码、专有名词和版本号常常更适合关键词检索。因此生产级 RAG 通常结合:
- 向量召回,覆盖语义改写;
- BM25 或倒排索引,命中精确词项;
- 元数据过滤,限定租户、权限、时间和文档类型;
- Rerank,对候选进行更精细的相关性排序。
Embedding 还存在版本契约:更换模型后,新旧向量通常不能直接比较,需要重建索引或采用双写迁移。
九、延迟应该拆开看
用户感知到的总延迟可以近似拆成:
Ttotal=Tnetwork+Tqueue+Tprefill+Tdecode+Ttools
- 网络与排队:请求到达供应商及等待算力;
- Prefill:处理输入上下文,输入越长通常越慢;
- Decode:逐 Token 生成输出;
- 工具时间:搜索、数据库或第三方接口调用。
至少要分别记录:
- TTFT:发出请求到收到第一个 Token;
- TPS:稳定生成阶段每秒输出 Token 数;
- 总耗时:从请求开始到完成;
- 工具耗时:每次外部调用的独立 Span。
流式输出主要改善"多久看到第一个字",并不会缩短模型完成全部生成的时间。若 TTFT 很高,应检查输入长度、排队和代理缓冲;若 TTFT 正常但总耗时高,应检查输出长度、模型生成速度和工具调用。
十、成本要按完整调用链计算
单次模型成本通常可以近似写成:
C=TinPin+ToutPout+Ccache+Ctools
其中 T 是 Token 数, P 是单位 Token 价格。Agent 与 RAG 系统中,还要加上改写、Embedding、Rerank、工具结果总结、失败重试等隐性调用。
真正有价值的指标不是"每次调用多少钱",而是:
CostPerSuccess=成功完成且通过质量门槛的任务数总成本
一个便宜但经常失败、需要多次重试的小模型,单位成功成本可能高于一次完成任务的强模型。
常见优化顺序是:
- 删除无关上下文和重复工具描述;
- 限制输出长度,避免模型重复复述输入;
- 对稳定前缀使用缓存;
- 让规则、分类器或搜索引擎完成确定性工作;
- 按任务难度做模型路由;
- 最后才考虑用更小模型替换。
算一笔多阶段调用的完整成本
假设一次 RAG 请求包含四个计费阶段:
| 阶段 | 输入 Token | 输出 Token | 调用次数 |
|---|---|---|---|
| Query 改写 | 800 | 80 | 1 |
| Rerank | 取决于候选总长度 | 少量分数 | 1 |
| 最终生成 | 6,000 | 900 | 1 |
| 失败修复 | 6,900 | 300 | 发生时 1 |
若只统计最终生成,就会漏掉改写、Rerank 和失败修复。设阶段 i 的调用次数为 ni,输入输出价格为 Pin,i、 Pout,i,完整成本应写成:
Crequest=i∑ni(Tin,iPin,i+Tout,iPout,i)+Cinfra
C_infra 还包括向量数据库、搜索、对象存储、GPU 工具和观测平台。缓存命中不能直接从 Token 中删除,而应按供应商的缓存读写价格分别计费。对比方案时固定同一批任务,最终比较 P95 延迟、成功率和 CostPerSuccess,否则"单价更低"没有决策意义。
十一、模型路由应该由任务特征驱动
模型选型不能只看公开榜单。应用实际需要的是一个受约束的多目标优化:
text
质量达到阈值
+ 延迟满足体验要求
+ 单位成功成本可接受
+ 支持所需上下文、工具和结构化输出
+ 数据与合规条件满足
可以为请求建立简单的复杂度特征:
ts
type RouteInput = {
  inputTokens: number;
  needsTools: boolean;
  needsVision: boolean;
  strictJson: boolean;
  risk: "low" | "medium" | "high";
};

function routeModel(x: RouteInput) {
  if (x.needsVision) return "vision-model";
  if (x.risk === "high" || x.needsTools) return "strong-model";
  if (x.inputTokens < 2000 && x.strictJson) return "small-fast-model";
  return "general-model";
}
这只是路由入口。生产系统还需要使用真实评估集验证每个分支,并记录路由选择、回退原因和最终结果。模型版本升级时先跑离线回归,再做小流量灰度,而不是直接替换全量流量。
十二、可观测性必须覆盖输入、轨迹与结果
只记录 HTTP 200 无法解释 AI 系统是否真的工作。一次请求至少应形成如下 Trace:
text
request_id
├─ context_build:各部分 Token 数、截断与缓存命中
├─ retrieval:查询、过滤条件、候选与分数
├─ model_call:模型版本、参数、TTFT、输入输出 Token
├─ tool_call:工具名、参数摘要、耗时、重试与结果
├─ validation:Schema 与业务校验结果
└─ response:完成状态、引用、用户反馈与总成本
日志中不要直接保存密钥、完整个人信息或敏感文档。可观测性和数据最小化并不冲突:可以记录哈希、长度、类型、脱敏摘要、引用 ID 和错误码,把原始内容放在受控存储中。
建议同时维护四类指标:
- 质量:正确率、引用支持率、拒答准确率、工具成功率;
- 性能:TTFT、TPS、P50/P95/P99 总延迟;
- 成本:每请求 Token、缓存命中率、单位成功成本;
- 安全:越权拦截、提示词注入命中、敏感输出与人工审批率。
十三、从机制推导出的工程原则
理解运行原理后,许多最佳实践不再是需要背诵的规则,而是自然结论:
- 模型是概率组件,所以关键结果必须验证;
- API 通常无状态,所以记忆必须由应用显式管理;
- 上下文有限且昂贵,所以要检索、压缩和按预算组装;
- 模型不拥有业务权限,所以工具执行必须经过应用授权;
- 流式输出只是传输策略,所以仍要处理取消、断线和半成品状态;
- 模型知识存在边界,所以实时事实应来自检索和工具;
- 单次成功不代表稳定,所以每次改动都要经过固定评估集。
十四、小结
一个大模型应用不是"界面加一个模型 API",而是概率模型与确定性软件系统的组合。模型负责理解、生成和提出候选动作;应用负责上下文、事实、权限、事务、验证与观测。
真正需要掌握的因果链是:
text
逐 Token 概率生成
-> 输出不确定且延迟与长度相关
-> 需要流式传输、结构校验与评估

有限上下文与注意力成本
-> 历史不能无限追加
-> 需要摘要、检索、缓存与预算控制

模型没有实时事实和业务权限
-> 需要 RAG 与工具
-> 需要引用、授权、幂等与审计
当系统设计可以从这些机制推导出来,而不是依赖零散 Prompt 技巧时,大模型能力才真正变成可维护、可测量、可上线的软件能力。
参考资料
- Vaswani 等:《Attention Is All You Need》
- Sennrich 等:《Neural Machine Translation of Rare Words with Subword Units》
- OpenAI:《Tokenizer 与 Prompt Caching 相关文档》
- Anthropic:《Context Engineering 与 Long Context 相关文档》
- Stanford CRFM:《Foundation Model Transparency 与评估资料》