网上哈希工具很多,但核心逻辑其实不到 100 行代码。本文从零实现一个哈希计算器:Web Crypto API 的 digest 用法、ArrayBuffer 转十六进制、UTF-8 编码一致性、MD5 的动态加载方案、文件哈希计算、五种算法并发优化。这是 盘子工具站哈希计算工具 的实现原理剖析,代码已在 GitHub 开源。
整体架构
一个完整的哈希计算器需要三个核心函数:
| 函数 | 作用 |
|---|---|
computeTextHash() |
对文本计算指定算法的哈希值(UTF-8 安全) |
computeFileHash() |
对浏览器 File 对象计算哈希值 |
bufferToHex() |
将 ArrayBuffer 转为小写十六进制字符串 |
设计原则:
- 纯函数,无副作用,可在 SSR 和测试环境中运行
- UTF-8 安全,中文文本与各语言结果一致
- SHA 系列用浏览器原生 Web Crypto API(性能最优)
- MD5 动态加载第三方库(Web Crypto 不支持 MD5)
- 支持文本和文件两种输入模式
先定义类型:
typescript
export type HashAlgorithm = 'MD5' | 'SHA-1' | 'SHA-256' | 'SHA-384' | 'SHA-512'

export interface HashResult {
  algorithm: HashAlgorithm
  value: string
}
一、bufferToHex:ArrayBuffer 转十六进制
Web Crypto API 的 digest() 返回 ArrayBuffer------原始字节缓冲区。需要转成人类可读的十六进制字符串。
typescript
export function bufferToHex(buffer: ArrayBuffer): string {
  const bytes = new Uint8Array(buffer)
  let hex = ''
  for (let i = 0; i < bytes.length; i++) {
    const h = bytes[i].toString(16)
    // 不足两位补前导零
    hex += h.length === 1 ? '0' + h : h
  }
  return hex
}
为什么补前导零? 每个字节 0-255,转十六进制后可能是 1 位(0-15)或 2 位(16-255)。如果不补零,[10, 20] 会变成 "a14" 而不是 "0a14",丢失了字节边界信息。
字节 [10, 20]:
补零: 0a 14 → "0a14"(4 字符,正确)
不补: a 14 → "a14"(3 字符,错误,无法还原)
二、computeTextHash:文本哈希计算
typescript
/**
 * 计算文本哈希值。
 *
 * 文本先通过 TextEncoder 编码为 UTF-8 字节,再计算哈希,
 * 确保与各语言(Python hashlib / Node crypto)的 UTF-8 结果一致。
 */
export async function computeTextHash(
  text: string,
  algorithm: HashAlgorithm
): Promise<string> {
  // 1. 文本 → UTF-8 字节
  const data = new TextEncoder().encode(text)
  // 2. 字节 → 哈希 → 十六进制
  return computeHashFromBytes(data, algorithm)
}关键一步:TextEncoder().encode(text)。它把 JavaScript 的 UTF-16 字符串转为 UTF-8 字节数组。没有这一步,直接把字符串当字节处理(btoa 的思路),中文会乱码,且和其他语言结果不一致。
三、computeHashFromBytes:核心计算逻辑
SHA 系列用 Web Crypto,MD5 用第三方库。两者统一入口:
typescript
async function computeHashFromBytes(
  data: Uint8Array,
  algorithm: HashAlgorithm
): Promise<string> {
  if (algorithm === 'MD5') {
    return computeMD5(data)
  }
  // SHA-1 / SHA-256 / SHA-384 / SHA-512 由 Web Crypto API 提供
  const digestBuffer = await crypto.subtle.digest(algorithm, data)
  return bufferToHex(digestBuffer)
}
Web Crypto API 的 digest 方法
crypto.subtle.digest(algorithm, data) 是浏览器原生 API,性能极高:
- 参数 algorithm :
'SHA-1'|'SHA-256'|'SHA-384'|'SHA-512' - 参数 data :
BufferSource(Uint8Array / ArrayBuffer 等) - 返回值 :
Promise<ArrayBuffer>------哈希结果的原始字节
注意命名规范:Web Crypto 用连字符(SHA-256),Node.js 用小写(sha256),Python 用下划线风格的模块名。跨环境时要注意名称转换。
MD5 的动态加载方案
Web Crypto API 不支持 MD5(因为 MD5 不安全,浏览器厂商不想推广)。但作为工具站,用户有 MD5 计算需求,所以需要引入第三方库。
typescript
/**
 * 使用 js-md5 计算 MD5(动态加载,避免打包进首屏 chunk)。
 * js-md5 接受 string | number[] | ArrayBuffer | Uint8Array,此处统一传 Uint8Array。
 */
async function computeMD5(data: Uint8Array): Promise<string> {
  const { default: md5 } = await import('js-md5')
  return md5(data)
}
为什么动态 import?
- MD5 不是所有用户都用,首屏加载没必要包含
await import('js-md5')按需加载,打包时生成独立 chunk- 首屏体积更小,加载更快
- 用户第一次使用 MD5 时有一次加载延迟(几十 KB),后续复用缓存
这是前端性能优化的常用模式------低频功能按需加载。
Web Crypto 的安全上下文限制
crypto.subtle 只在 HTTPS 和 localhost 下可用。HTTP 环境下 crypto.subtle 是 undefined。
生产环境必须 HTTPS,这个没问题。但开发时如果用 IP 访问而非 localhost,也会不可用。
如果需要兼容 HTTP 环境,可以对所有算法都做降级:
typescript
async function computeHashFromBytes(
  data: Uint8Array,
  algorithm: HashAlgorithm
): Promise<string> {
  // 检查 Web Crypto 是否可用
  if (typeof crypto !== 'undefined' && crypto.subtle && algorithm !== 'MD5') {
    const digestBuffer = await crypto.subtle.digest(algorithm, data)
    return bufferToHex(digestBuffer)
  }

  // 降级:用第三方纯 JS 实现
  switch (algorithm) {
    case 'MD5': {
      const { default: md5 } = await import('js-md5')
      return md5(data)
    }
    case 'SHA-1': {
      const { sha1 } = await import('js-sha1')
      return sha1(data)
    }
    case 'SHA-256': {
      const { sha256 } = await import('js-sha256')
      return sha256(data)
    }
    // ... 其他算法同理
  }
}
盘子工具站部署在 HTTPS 上,所以只对 MD5 做了动态加载降级。
四、computeFileHash:文件哈希计算
typescript
/**
 * 计算文件哈希值。
 *
 * 文件通过 File API 读取为 ArrayBuffer,所有计算在浏览器本地完成,
 * 文件不会上传到服务器。
 */
export async function computeFileHash(
  file: File,
  algorithm: HashAlgorithm
): Promise<string> {
  const buffer = await file.arrayBuffer()
  const data = new Uint8Array(buffer)
  return computeHashFromBytes(data, algorithm)
}
file.arrayBuffer() 是 File API 的方法,直接读取文件全部内容为 ArrayBuffer。小文件没问题,大文件可能占用较多内存。
大文件流式计算优化
对于几百 MB 甚至几 GB 的大文件,一次性读入内存可能导致浏览器卡顿。可以用 FileReader 分块读取 + 增量计算:
typescript
async function computeLargeFileHash(
  file: File,
  algorithm: HashAlgorithm,
  chunkSize: number = 8 * 1024 * 1024  // 8MB 一块
): Promise<string> {
  if (algorithm === 'MD5') {
    // js-md5 支持增量计算
    const { default: MD5 } = await import('js-md5')
    const md5 = MD5.create()

    let offset = 0
    while (offset < file.size) {
      const chunk = file.slice(offset, offset + chunkSize)
      const buffer = await chunk.arrayBuffer()
      md5.update(new Uint8Array(buffer))
      offset += chunkSize
    }
    return md5.hex()
  }

  // Web Crypto 不支持增量 digest,需要用 SubtleCrypto 的替代方案
  // 或者用第三方纯 JS 实现(如 js-sha256)
  throw new Error('大文件流式计算建议用第三方库实现')
}
Web Crypto 的 digest() 方法是一次性的------传进去多少数据算多少。如果要增量计算,需要用 SubtleCrypto 的其他方案或纯 JS 实现。对于大多数场景(工具站上 MB 级文件),一次性读取完全够用。
五、五种算法并发计算
工具的交互设计是输入文本后同时显示五种算法的结果。串行计算慢,用 Promise.all 并发:
typescript
const ALL_ALGORITHMS: HashAlgorithm[] = [
  'MD5', 'SHA-1', 'SHA-256', 'SHA-384', 'SHA-512'
]

async function computeAllHashes(text: string): Promise<HashResult[]> {
  const promises = ALL_ALGORITHMS.map(async (algo) => {
    const value = await computeTextHash(text, algo)
    return { algorithm: algo, value }
  })
  return Promise.all(promises)
}
Promise.all 让五个哈希计算同时进行。Web Crypto 的 digest 是异步操作(浏览器内部用 C++ 实现,可能走多线程),并发计算比串行快得多。
六、单元测试设计
typescript
import { describe, it, expect } from 'vitest'
import { computeTextHash, bufferToHex } from './hash'

describe('bufferToHex', () => {
  it('空 buffer 返回空字符串', () => {
    expect(bufferToHex(new ArrayBuffer(0))).toBe('')
  })

  it('单字节转换正确', () => {
    const buf = new Uint8Array([0x0A]).buffer
    expect(bufferToHex(buf)).toBe('0a')  // 补前导零
  })

  it('多字节转换正确', () => {
    const buf = new Uint8Array([0xDE, 0xAD, 0xBE, 0xEF]).buffer
    expect(bufferToHex(buf)).toBe('deadbeef')
  })

  it('输出为小写', () => {
    const buf = new Uint8Array([0xAB, 0xCD]).buffer
    expect(bufferToHex(buf)).toBe('abcd')
  })
})

describe('computeTextHash', () => {
  // 已知答案的测试用例(用 Python 或 Node.js 预计算)
  const testCases = [
    { input: '', md5: 'd41d8cd98f00b204e9800998ecf8427e' },
    { input: 'Hello World', md5: 'b10a8db164e0754105e766fea50c4316' },
    { input: 'Hello World', sha256: 'd2a84f4b8b650937ec8f73cd8be2c74add5a911ba64df27498ed22a0d624c945' },
  ]

  it('空字符串 MD5', async () => {
    expect(await computeTextHash('', 'MD5'))
      .toBe('d41d8cd98f00b204e9800998ecf8427e')
  })

  it('英文文本 SHA256', async () => {
    expect(await computeTextHash('Hello World', 'SHA-256'))
      .toBe('d2a84f4b8b650937ec8f73cd8be2c74add5a911ba64df27498ed22a0d624c945')
  })

  it('中文文本(UTF-8 一致)', async () => {
    // 和 Python hashlib.sha256('中文'.encode('utf-8')).hexdigest() 对比
    expect(await computeTextHash('中文', 'SHA-256'))
      .toBe('72726d8818f693066ceb69afa364218b692e62ea92b385782363780f47529c2e')
  })

  it('五种算法都能计算', async () => {
    const algos = ['MD5', 'SHA-1', 'SHA-256', 'SHA-384', 'SHA-512'] as const
    for (const algo of algos) {
      const result = await computeTextHash('test', algo)
      expect(typeof result).toBe('string')
      expect(result.length).toBeGreaterThan(0)
      expect(/^[0-9a-f]+$/.test(result)).toBe(true)  // 纯小写十六进制
    }
  })

  it('输出长度符合算法', async () => {
    expect((await computeTextHash('test', 'MD5')).length).toBe(32)
    expect((await computeTextHash('test', 'SHA-1')).length).toBe(40)
    expect((await computeTextHash('test', 'SHA-256')).length).toBe(64)
    expect((await computeTextHash('test', 'SHA-384')).length).toBe(96)
    expect((await computeTextHash('test', 'SHA-512')).length).toBe(128)
  })
})
最关键的测试用例是中文 UTF-8 一致性------确保工具的计算结果和 Python/Node.js 的输出完全相同。如果 UTF-8 处理有 Bug,这个测试会失败。
完整代码与在线体验
本文拆解的代码完整实现在 PanziTool GitHub 仓库 的 frontend/utils/tools/hash.ts 文件中,约 80 行 TypeScript 代码,核心依赖只有 js-md5(动态加载)。Vue 组件 HashTool.vue 负责交互层,调用这些纯函数完成文本和文件的多算法哈希计算。
如果你想体验最终效果,可以访问 盘子工具站哈希计算工具,输入任意文本即可看到:
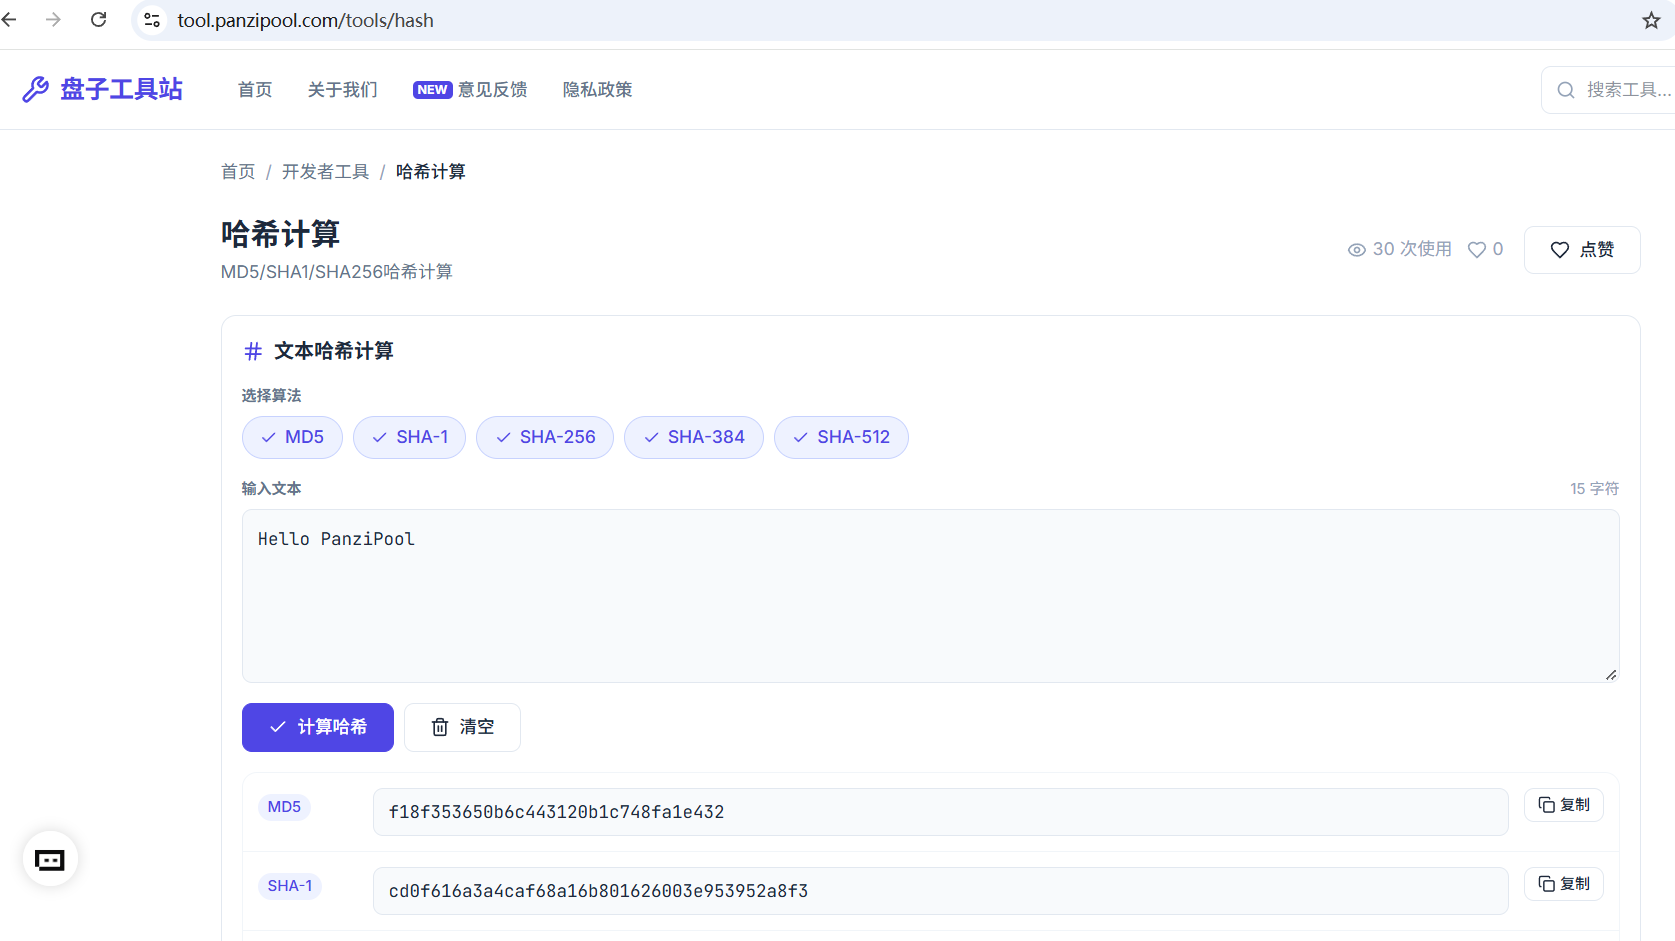
- 实时计算 MD5、SHA1、SHA256、SHA384、SHA512 五种结果
- 支持文件上传计算哈希,所有运算在浏览器本地完成
- 输出统一为小写十六进制,和各语言标准库结果一致
- 中文文本基于 UTF-8 编码,跨平台结果一致
所有计算在浏览器本地完成,不上传服务器,适合处理敏感数据。