法兰克福的推理集群服务欧洲用户,就是比弗吉尼亚的集群快------算力放在哪里,直接决定用户要等多久;而同一批 GPU,白天跑推理、夜间跑训练,就不用为两种负载各建一个资源池。
这篇文章讲清一件事:训练和推理的算力该往哪里放,以及怎么用一张网把分散的算力调度起来。
文章目录
-
- 一、场景:一个集群,两拨人抢卡
- 二、底层原理:两种负载的镜像需求
- [三、解决方案:推理按 PD 分离分层卸载](#三、解决方案:推理按 PD 分离分层卸载)
- [四、实操验证:同一批 GPU 的时间折叠](#四、实操验证:同一批 GPU 的时间折叠)
- 五、总结延伸
一、场景:一个集群,两拨人抢卡
业务起来之后,集群里同时塞了两种负载:离线训练团队要长时间占用整卡,在线推理团队要 7×24 留资源。我原以为多买卡就能解决,结果卡越多,账越算不平。
我在现场踩中的三个现象:
| 现象 | 当时的判断 | 真正的问题 |
|---|---|---|
| 训练任务跑到一半被打断,进度反复回滚 | 调度器不稳定 | 推理高峰临时抢走了训练卡 |
| 偏远地区用户频繁投诉首字慢,集群负载却很低 | 模型太大 | 算力物理位置离用户太远 |
| 多机训练一开跑,网络带宽打满,GPU 在空等 | GPU 买少了 | 用 Web 通用网络跑 AllReduce 通信 |
三个现象指向同一个根因:我把训练和推理当成了同一种均质的"算力",以为哪里的卡都一样。
二、底层原理:两种负载的镜像需求
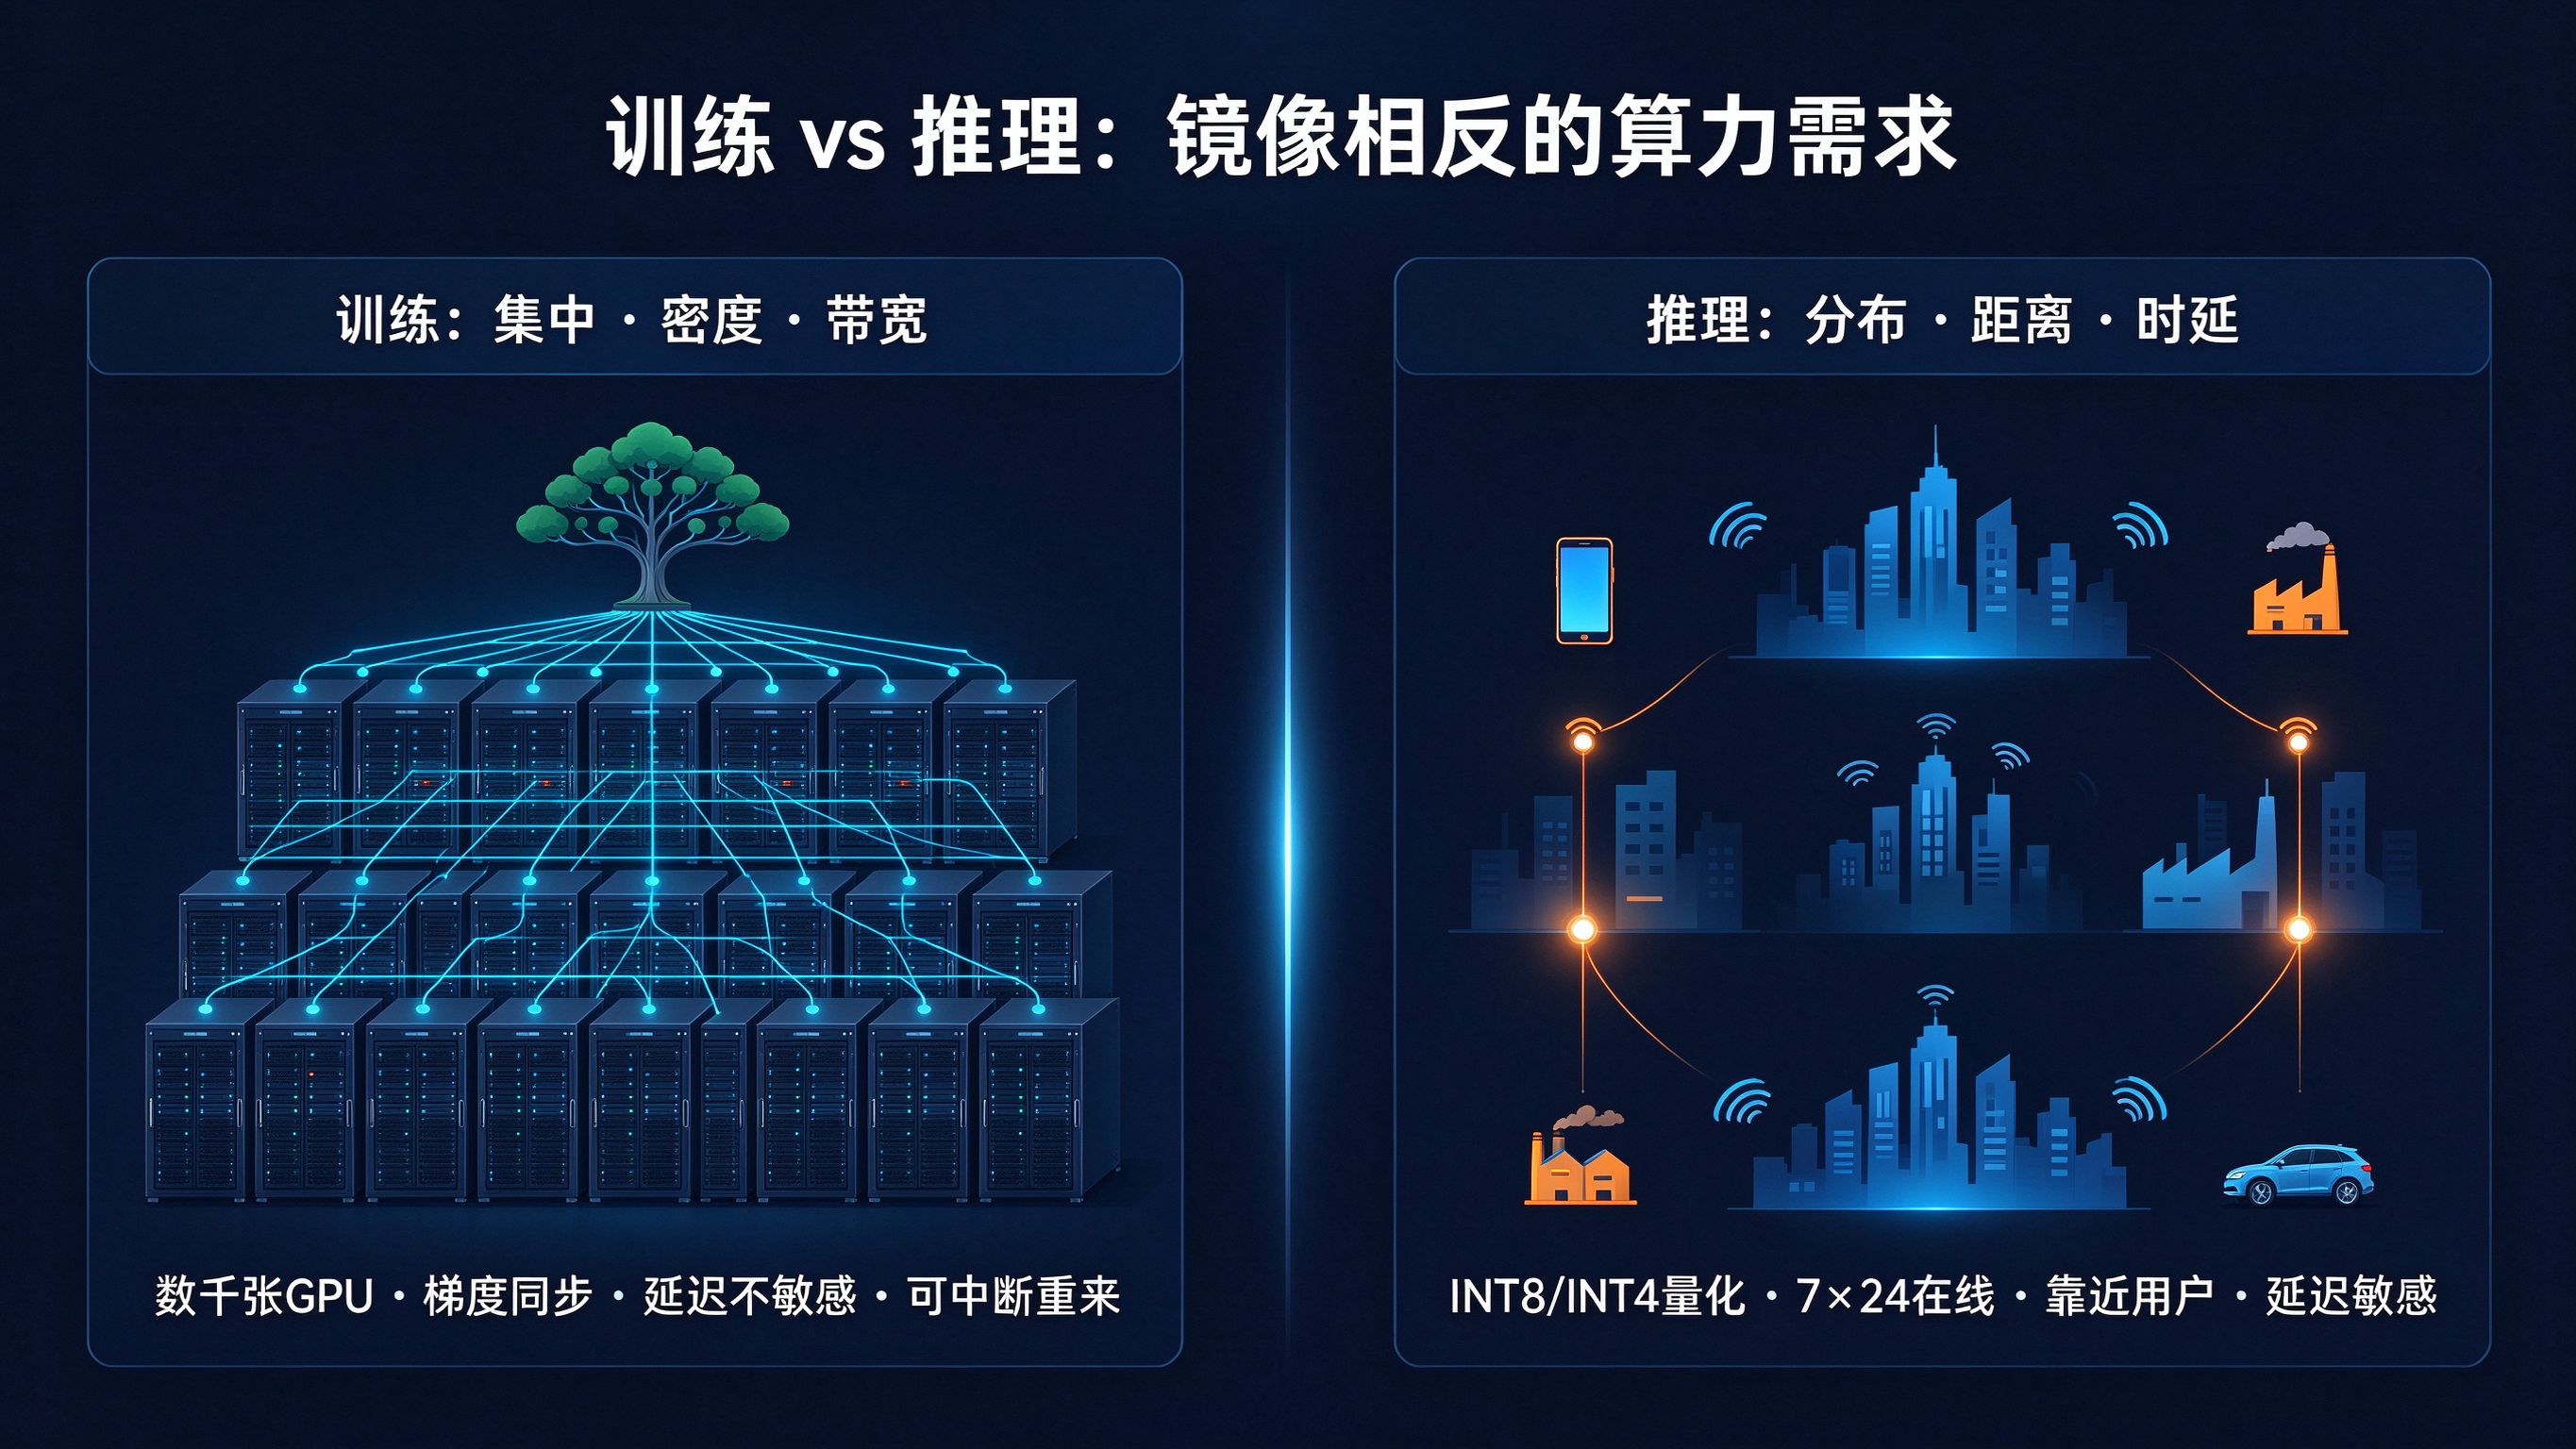
训练是分布式系统问题,推理是服务可用性问题,两者对基础设施的要求几乎镜像相反。
| 维度 | 训练 | 推理 |
|---|---|---|
| 核心诉求 | 带宽、密度、确定性 | 延迟、分布、成本 |
| 请求特征 | 数百到数千卡协同,梯度同步 | 毫秒到秒级单请求 |
| 硬件方向 | 高带宽互联 | INT8/INT4 量化、低显存占用 |
| 位置敏感度 | 不敏感 | 高度敏感,可测量 |
| 容错方式 | 可中断重来,代价是数小时算力 | 必须 7×24 在线 |
节点内 GPU 经 NVLink 互联,聚合带宽可达 900 GB/s;跨节点依赖 InfiniBand 或 RoCE,每节点 400~800 Gb/s。推理侧则把物理位置直接兑换成用户体验,集群和用户之间的物理距离,最终体现为可测量的延迟差。
到 2026 年初,推理已占企业 AI 基础设施支出的 55%,长期预期走向 80% 推理、20% 训练的结构。训练向集中要密度,推理向分布要距离。
注意:训练集群的技术核心不是单卡算力,而是 GPU 之间的通信效率。
第五代 NVLink 为单卡提供的聚合带宽是当前以太网或 InfiniBand 的 9~18 倍;数千节点规模下,AllReduce 通信时间相比千兆以太网可减少 78%;GPUDirect RDMA 让 GPU 绕过 CPU 直接交换数据。
这些数字的工程含义是训练网络不能"通用"。纵向扩展靠 NVSwitch fabric,横向扩展靠 InfiniBand/RoCE,两者带宽差着数量级。专用网络固定成本极高,这也是训练算力市场走向寡头化的原因------不是每朵云都建得起、建得好。
三、解决方案:推理按 PD 分离分层卸载
推理的分布化不是把服务器搬到用户旁边,而是按任务类型做分层。
中国电信研究院提出的广域分布式推理网络,引入预填充-解码(Prefill-Decode,PD)分离机制:
| 阶段 | 资源类型 | 主要工作 | 部署位置 |
|---|---|---|---|
| Prefill 预填充 | 计算密集 | 处理输入、生成 KV Cache | 靠近数据源的边缘节点 |
| Decode 解码 | 访存密集 | 逐 token 生成输出 | 高吞吐中心云 |
latex
 工厂/园区/手机                 用户侧
      │
      ▼
 ┌────────────┐   KV Cache    ┌────────────┐
 │ 边缘节点    │◄────────────►│ 中心云      │
 │ Prefill    │   广域网协同   │ Decode     │
 │ 算力密度    │              │ 内存带宽    │
 └────────────┘              └────────────┘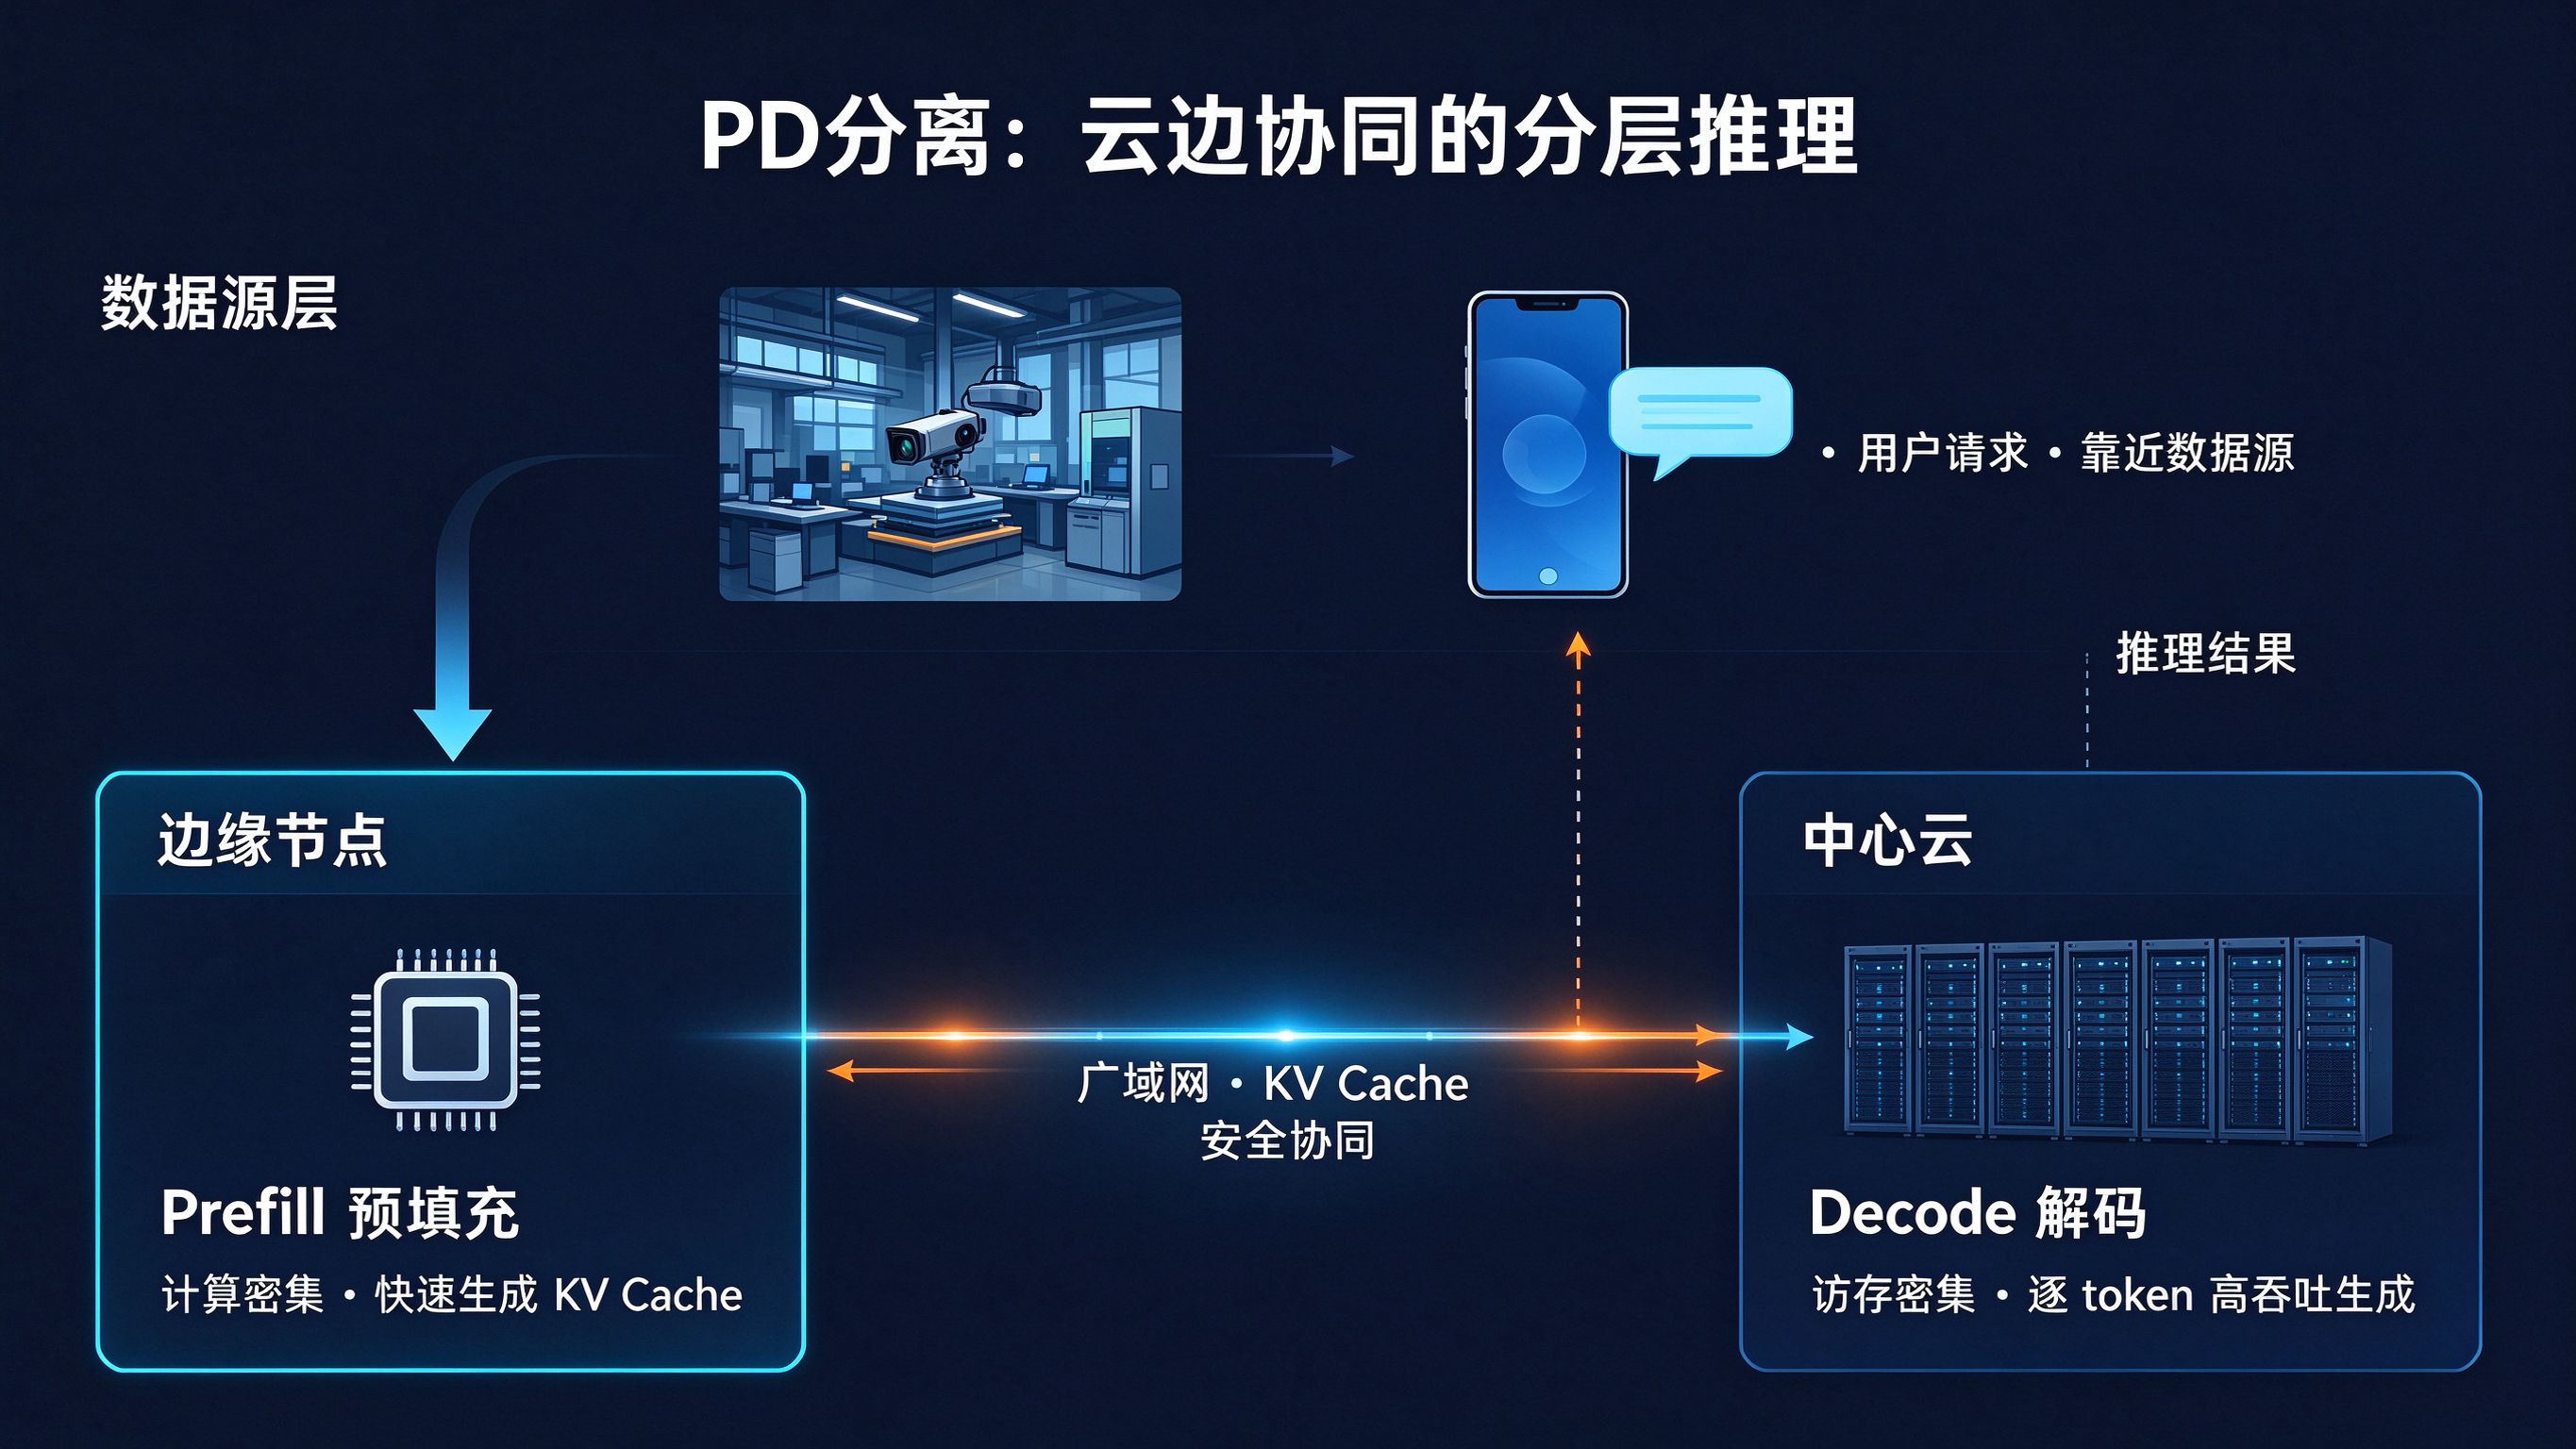
这套架构已经过工程验证。中国电信完成业界首例长距跨数据中心分布式无损智算推理网络验证:Prefill 放在模拟企业园区的边缘节点,Decode 放在云上,云边通过 KV Cache 协同,对 DeepSeek 671B 模型完成压力测试。拆开部署后,Prefill 节点专注算力密度,Decode 节点专注内存带宽,两类硬件各取所长,整体利用率随之提升。
边缘节点的角色不是替代中心云,而是承接那些"不能等"的任务。邯郸永年国智科技紧固件产线用的是"中训边推":云端训练、压缩下发到厂区边缘盒子,产线本地推理、数据不出厂区。
| 指标 | 改造前 | 改造后 |
|---|---|---|
| 产品检测覆盖率 | 人工巡检约 1% | 100% |
| 故障响应 | 约 1 小时 | 5 分钟 |
| 算力成本 | 传统部署 | 下降 50% |
注意:边缘只放"等不起"的任务,重吞吐的 Decode 仍留在中心云,分层才有硬件利用率。
四、实操验证:同一批 GPU 的时间折叠
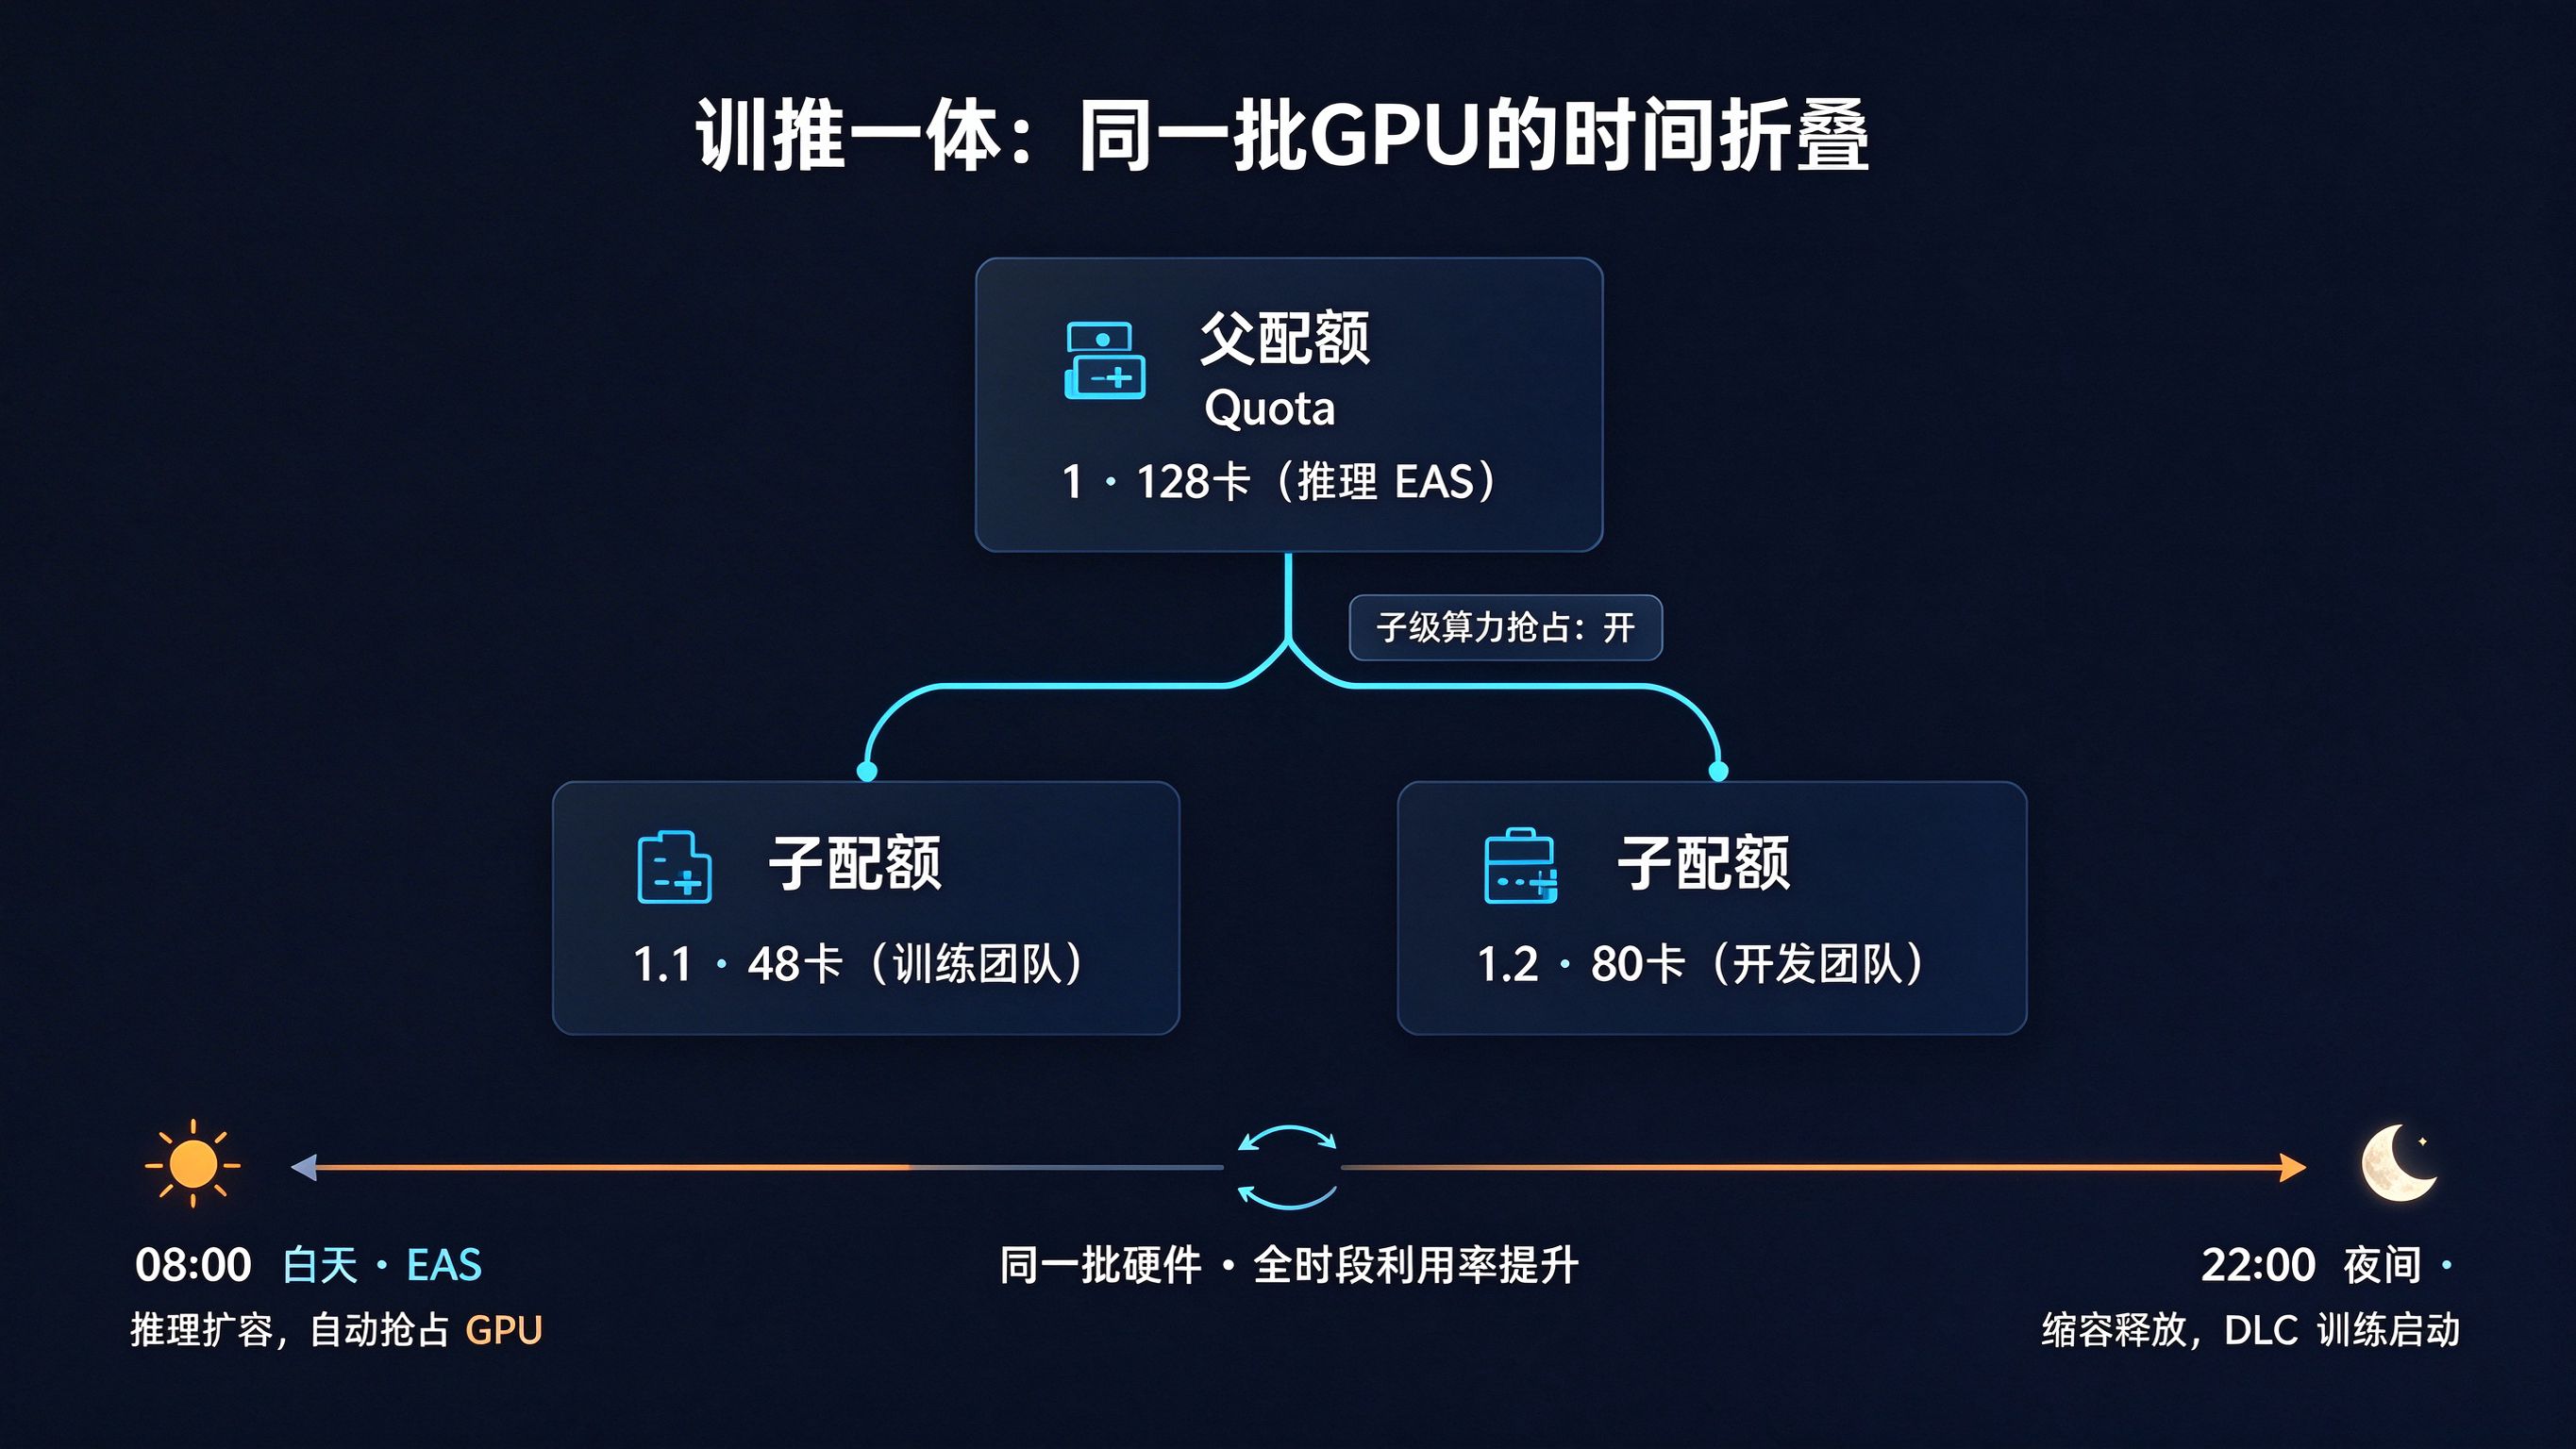
物理布局之外,同一集群内部还能在时间维度上分工。阿里云 PAI 的训推一体方案,核心是父子级资源配额的算力抢占。
latex
 Quota 1(父配额 · 128卡 · 推理 EAS)
   ├── Quota 1.1(48卡 · 训练团队 B · DLC)
   └── Quota 1.2(80卡 · 开发团队 C · DLC)
 子级算力抢占:开
你在控制台上按这个顺序操作:
- 创建父配额 Quota 1,规格 128 卡 GPU,打开子级算力抢占开关。
- 在 Quota 1 下新增两个子配额:1.1 分 48 卡、1.2 分 80 卡。
- 把 EAS 推理服务部署在父配额,DLC 训练任务部署在子配额。
- 给推理服务配置定时扩缩容,系统自动回收和释放 GPU。
latex
 08:00  白天高峰  EAS 扩容 → 抢占子配额 GPU → 训练排队
 22:00  夜间低谷  EAS 缩容 → 释放 GPU      → DLC 自动启动
这套机制不需要为推理和训练各建一个资源池,夜间训练、白天推理,同一批硬件被"折叠"出两种用途。
推理分布化要成立,前提是一张能把分散算力"连起来、调得动"的网。国家未来网络试验设施(CENI)给了国家级参照:
latex
 覆盖:40 个城市骨干网
 压测:100% 负载 · 途经 13 省市 · 跨越 1.3 万公里
 结果:零丢包 · 时延抖动 < 50 微秒
 调度:峰值分发速率 2.25 Tbps · 推理成本降低 50%
       千亿级模型跨域池化训练算效 98%
区域侧也在落地。湖北构建"1+M+N"省域体系:1 个国家节点连接 M 个区域节点、N 个行业节点,支持中训边推、异构跨域混训混推,并提供按词元计费的大模型推理 API。算力感知层把 CPU、GPU、NPU 的算力、带宽、延迟、功耗抽象成标准度量,编排调度层再按多因素算法生成分配方案。标准化度量让不同厂商的芯片进入同一调度池,中训边推、混训混推才有落地基础。
五、总结延伸
训推分工的本质,是承认"算力"不是均质商品:训练要密度、带宽和确定性,推理要分布、延迟和成本效率。集中与分布不是二选一,而是同一张算力网上并行的两条逻辑线。这张网最终要解决的,是让算力在该集中的地方集中、该下沉的地方下沉,把"算不了、算不好、算不起"变成可调度的工程问题。
术语速查表:
| 术语 | 含义 |
|---|---|
| NVLink / NVSwitch | 节点内 GPU 直连互联及其交换网络 |
| InfiniBand / RoCE | 跨节点高带宽低延迟互联技术 |
| AllReduce | 多卡间梯度归约的集合通信操作 |
| GPUDirect RDMA | GPU 绕过 CPU 直接跨网交换数据 |
| PD 分离 | 预填充与解码两阶段分开部署 |
| KV Cache | 推理中缓存注意力键值的中间数据 |
| 中训边推 | 云端训练、边缘推理的部署模式 |
| QuotaTree | 父子级资源配额的树状组织 |
参考链接:
- 阿里云 PAI《训推一体资源管理》:https://help.aliyun.com/zh/pai/training-push-integrated-resource-management
- 阿里云 PAI《资源配额(Quota)抢占策略》:https://help.aliyun.com/zh/pai/resource-quota-quota-preemption-policy
- 中国电信研究院《基于广域分布式推理网络的 PD 分离架构与实现》:http://ictp.caict.ac.cn/CN/10.12267/j.issn.2096-5931.2026.02.003
- 央广网《全域一体化数算网调度平台发布》:http://tech.cnr.cn/ycbd/20250823/t20250823_527334721.shtml
- 人民邮电报《邯郸移动"数智平台+AI 质检+数字贸易"赋能特色产业》:https://rmydb.cnii.com.cn/html/2026/20261009/20261009_002/20261009_002_05_4247.html