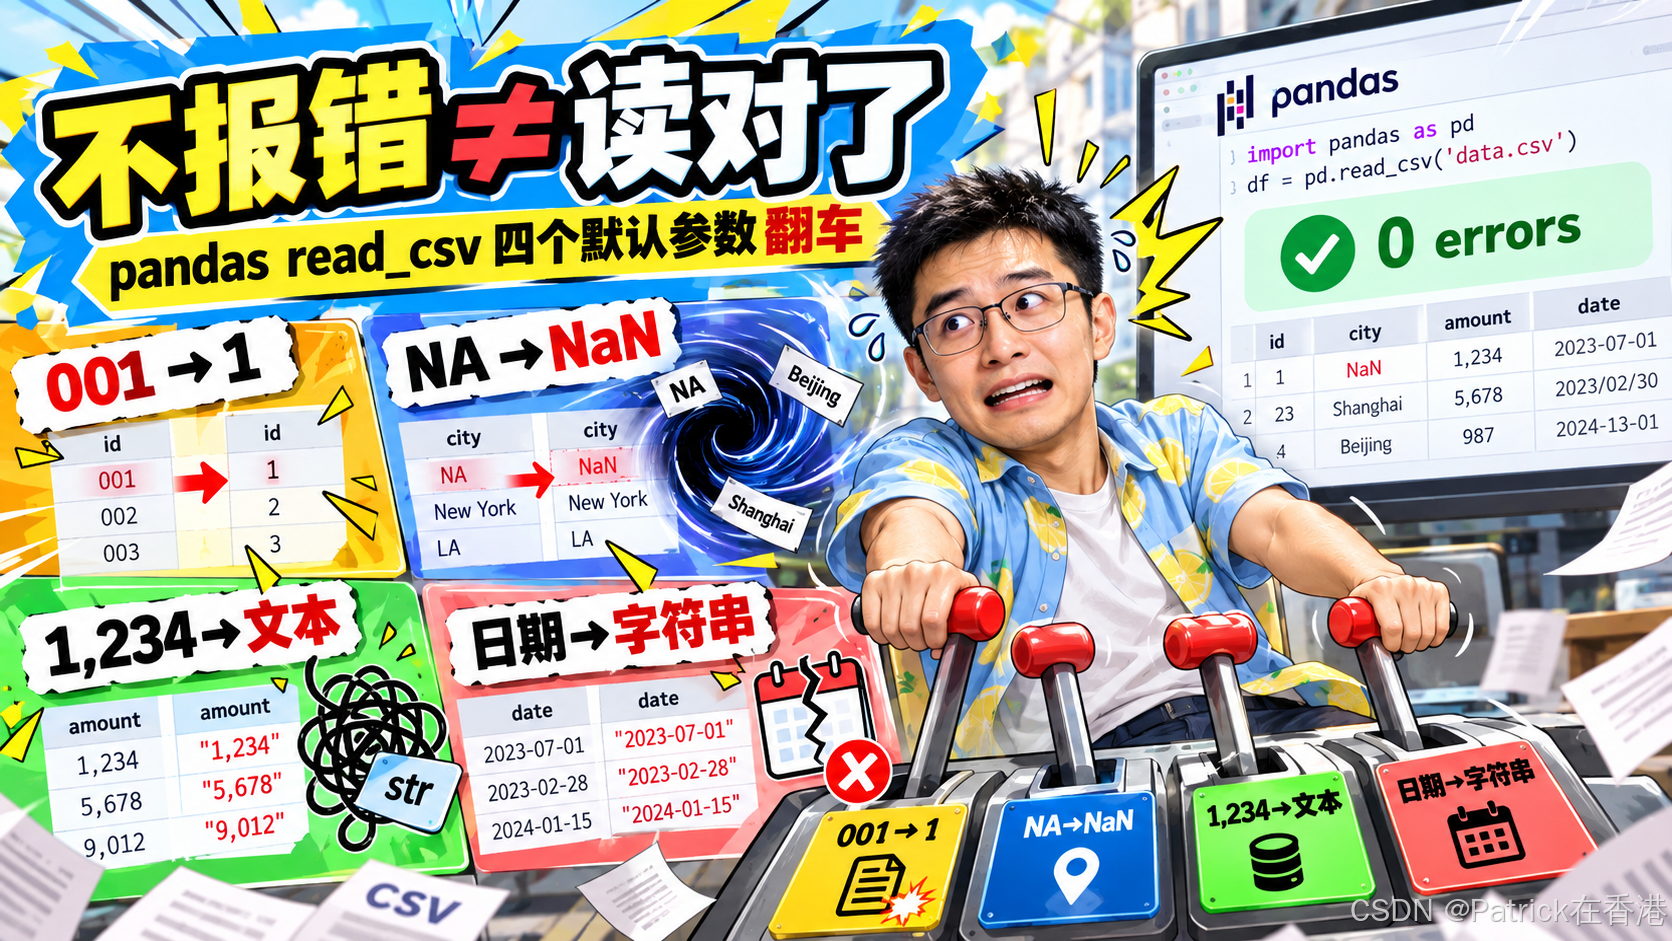
read_csv 大概是所有 Python 数据人的第一行代码,也是「零报错假象」的重灾区:它几乎从不报错------前导零悄悄消失、真实地名悄悄变 NaN、千分位数字悄悄变成字符串,全程安静得像什么都没发生。这周整理口岸客流数据时又被咬了一口,索性把四个默认参数逐一实测(pandas 3.0.3------对,3.0 大版本已经在很多人机器上了),账单如下。
文章目录
-
- [一、四行小 CSV,四类事故](#一、四行小 CSV,四类事故)
- 二、修复:四个默认值各配一个解药
- [三、NA 吞噬清单:18 个字面量吞 16 个](#三、NA 吞噬清单:18 个字面量吞 16 个)
- [四、pandas 3.0 的两个时代注脚](#四、pandas 3.0 的两个时代注脚)
- 五、口径与边界
- [六、30 秒带走版](#六、30 秒带走版)
一、四行小 CSV,四类事故
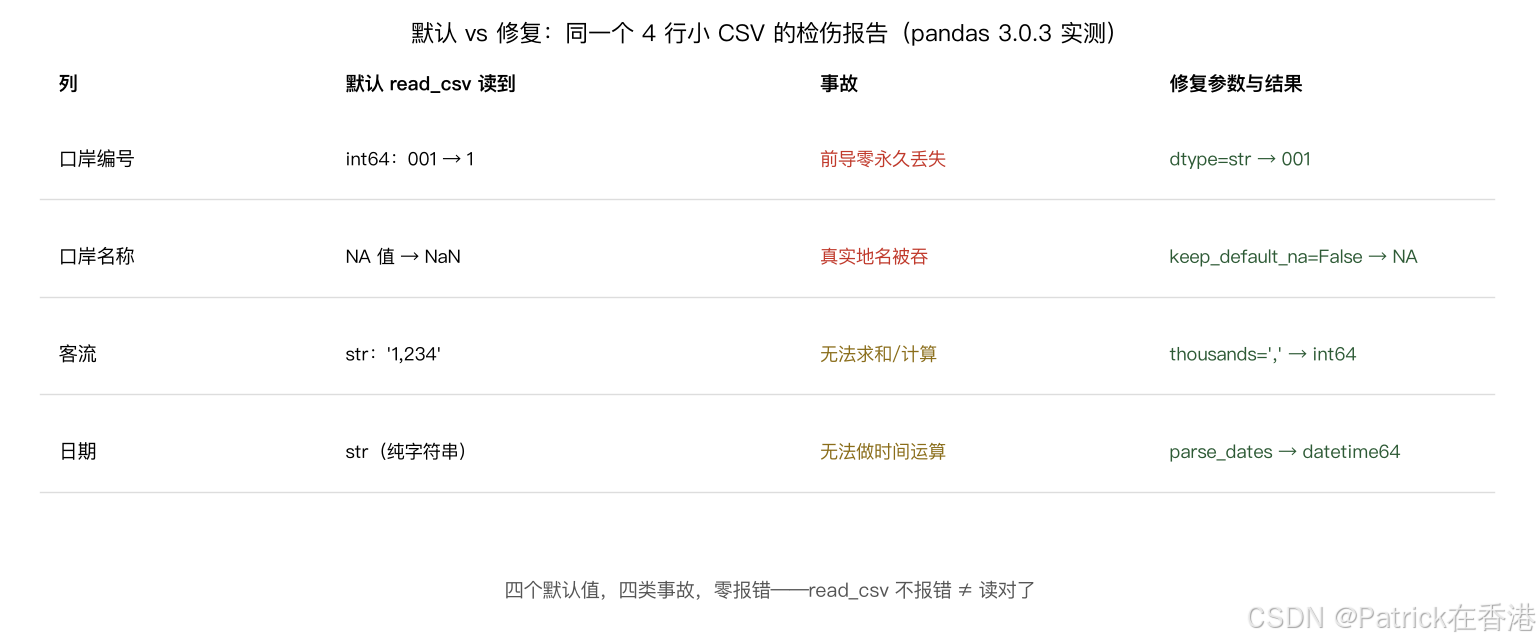
构造一个最小的脏数据样本:四行口岸客流记录,带前导零的编号、一个值为 NA 的地名、带千分位的客流、标准日期。默认参数读入后逐列检伤:
- 口岸编号 :int64,
001变成1------前导零永久丢失,这列从此只能当计数用,不能再当主键对账。前导零的重灾区远不止口岸编号:电话区号、邮编、身份证与护照号、股票代码(00700 涨成 700 的那一刻,join 对账就断了)------凡是「以 0 开头有意义」的字段,类型推断一概不认; - 口岸名称 :值为 NA 的那个单元格变 NaN------真实地名被当成缺失值吞掉;
- 客流 :千分位导致整列变字符串------
sum()直接拼接报错,任何计算全废; - 日期:纯字符串------想做「按月汇总」「环比」就得再补一步解析。
四类事故,零报错 。read_csv 不报错从来不等于读对了,它只是把「解释权」交给了类型推断,而类型推断的每一条规则都有反例。根源在于 CSV 的出身:它是一个没有类型的纯文本格式,每一列是数字还是文本、缺失用什么表示,文件本身不知道------全靠读取方猜。猜对是巧合,猜错是日常,显式声明才是工程。
二、修复:四个默认值各配一个解药
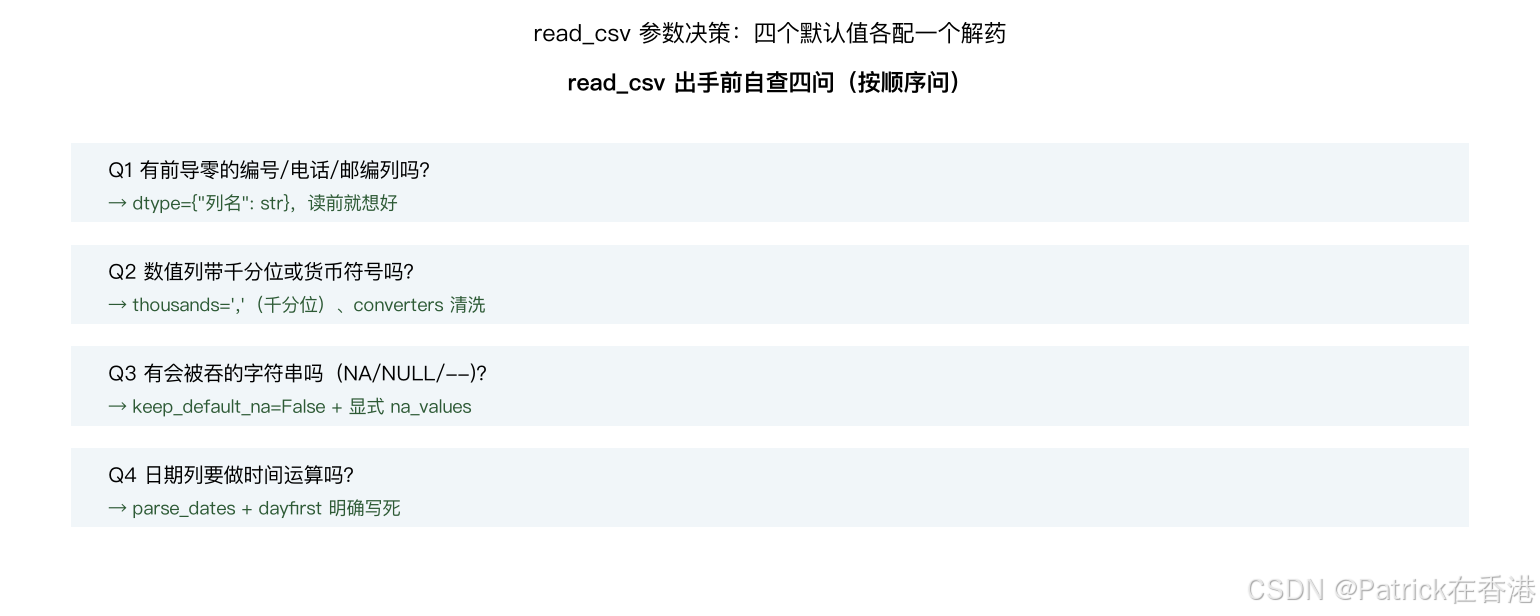
实测修复对照(同一份文件重读),四个参数四行配置:
python
import io
import pandas as pd

csv_text = """口岸编号,口岸名称,日期,客流
001,罗湖,2026-09-30,"1,234"
002,NA,2026-10-01,"2,345"
003,皇岗,2026-10-02,"3,456"
001,罗湖,2026-10-03,"4,567"
"""

df = pd.read_csv(io.StringIO(csv_text))          # 默认参数:四类事故
assert str(df["口岸编号"].iloc[0]) == "1"         # 001 → 1,前导零没了
assert pd.isna(df["口岸名称"].iloc[1])            # NA → NaN,地名被吞

df2 = pd.read_csv(io.StringIO(csv_text),
                  dtype={"口岸编号": str},        # 前导零:001 保住
                  thousands=",",                  # 千分位:→ int64
                  keep_default_na=False,          # NA 字面量:不再吞
                  parse_dates=["日期"])           # 日期:→ 时间戳
assert df2["口岸编号"].iloc[0] == "001"
assert df2["口岸名称"].iloc[1] == "NA"
assert df2["客流"].sum() == 11602
print("默认 vs 修复:全部断言通过")
四个参数,四行配置,从「看似成功」到「真的正确」:编号列保住 001,地名原样保留,客流列直接变 int64、四行合计 11,602 立刻可算,日期一步到位变时间戳。
三、NA 吞噬清单:18 个字面量吞 16 个
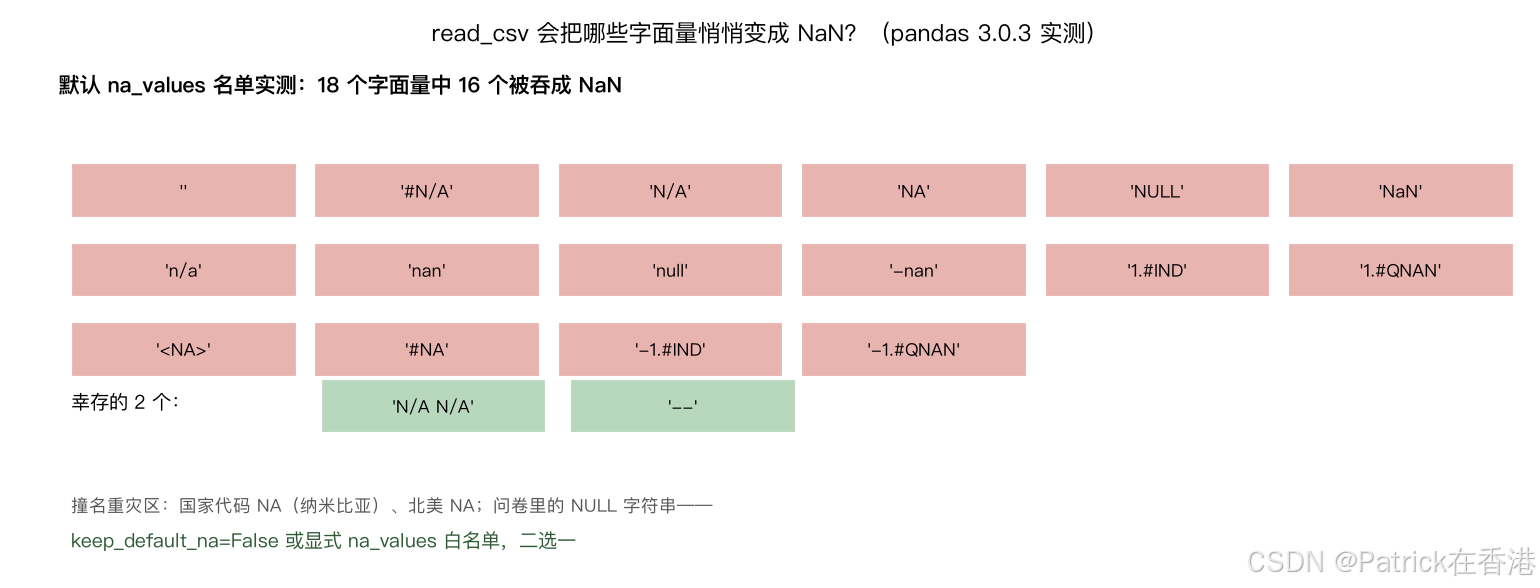
NA 误吞值得单独拉清单。实测默认名单:18 个常见字面量里 16 个会被吞成 NaN ------空串、N/A、NA、NULL、nan 全军覆没,连 1.#IND 这种 Excel 导出遗留都在名单里。幸存的只有「N/A N/A」(带空格)和「--」两个冷门写法。
撞名重灾区两类:国家与地区代码 (ISO 里 NA = 纳米比亚所属的北美分类,大陆数据库里一列 NA 直接变成整列缺失);问卷与工单导出 (用户认真填的 NULL 字符串被当成没填)。修法二选一:keep_default_na=False 彻底关闭自动识别,或在 na_values 参数里显式给一份白名单------让「什么算缺失」由你的业务定义,不由上游导出工具的巧合定义。顺带一提大文件场景:百万行以上、列内混合类型时,默认读取还会补一条 DtypeWarning(某列 dtype 不一致)------它不拦你,但大概率意味着这一列已经被切成两段不同的类型。
四、pandas 3.0 的两个时代注脚
实测环境是 pandas 3.0.3,两个细节顺带交代。其一,检伤报告里字符串列的 dtype 显示为 str 而不是熟悉的 object------3.0 起默认启用了新的专用字符串类型,== 比较与缺失值语义都更严格;其二,日期解析结果带 datetime64[us] 尾巴------3.0 把非纳秒时间单位作为合法选项(us 微秒),老代码里写死的 [ns] 断言会意外失败。大版本升级的破坏性从来不在文档第一页,而在这些静默的 dtype 尾巴上。给升级者一份体检清单:全局搜 object 类型的字符串列断言、datetime64 纳秒单位的硬编码比较、以及所有依赖 inplace 参数的调用(3.0 起 Copy-on-Write 默认化,inplace 语义已变)------三处过一遍,大版本升级才敢说从容。
五、口径与边界
实验为 4 行小样本 + 18 字面量清单,全本地实测------四行小样本四雷全中,脏数据的杀伤力与行数无关、与默认值有关;大文件场景(百万行)下默认读取还会触发 DtypeWarning(混合类型列),提示本质相同------「推断」在行数变大后会更不稳定;na_values 名单以 pandas 3.0.3 实测为准,历史版本个别字面量有出入;日期解析对 dayfirst 敏感(欧式日期必显式写死),本文样本为 ISO 格式未涉及;顺带记一个真实翻车面:欧式日期 03/04/2026 在默认解析里是 3 月 4 日,英国同事眼里是 4 月 3 日------dayfirst 不写死,日期对不上只是时间问题。
六、30 秒带走版
read_csv零报错是假象:前导零、NA 字面量、千分位、日期四个默认值各埋一雷;- 编号/电话/邮编一律
dtype=str,读前想清楚,读后无法挽回; - NA 吞噬实测 18 吞 16:撞名重灾区是国家代码与问卷导出------
keep_default_na=False或显式na_values二选一; - 千分位在 thousands 参数里指明、日期交给 parse_dates(欧式日期写死 dayfirst);
- pandas 3.0 时代注脚:dtype 显示
str、时间戳带[us]------老断言该体检了; - 拿不准就读两遍:默认参数一遍检伤、显式参数一遍定稿,两份 diff 一下,你的数据踩了哪几雷一目了然。
参考链接
- https://pandas.pydata.org/docs/reference/api/pandas.read_csv.html
- https://pandas.pydata.org/docs/user_guide/io.html
本文实验环境:Python 3.13.12 + pandas 3.0.3;全部行为本机实测复现,na_values 名单以 3.0.3 为准,历史版本个别条目有出入。