AiService
比如实现聊天记忆这个小功能,一般是某个助手接口创建,然后是chat方法,接着aiservice注解配置这个接口要的组件,再去对aiservice指定的组件新建配置类,注入为bean,然后return它的相关配置或者要用的方法属性,然后是测试类(实际业务使用)先注入某助手bean,然后直接操作该接口的chat方法即可,然后我觉得就是封装的方法就是配置aiservice指定的组件新建配置类的bean注入return的方法,所以就是直接业务使用chat()
纠正
① 不是"因为 @AiService 指定了组件,所以去写配置类",而是反过来。
零件(bean)先存在 于 Spring 容器里,
@AiService只是按名字去容器里取。代码块
配置类   →  生产 bean   →  容器  →  @AiService 按名字取  →  装进代理
(生产者)                              (消费者)
所以
chatMemoryProvider = "chatMemoryProvider"里那个字符串,就是"去容器里找叫这个名字的 bean"。找不到 → 启动直接NoSuchBeanDefinitionException。你 ChatMemoryProvider.java 现在编译不过,就是这个"名字对不上"的另一面。② "注入为 bean" 这个说法要拆开:
@Bean是"生产",不是"注入"。
@Bean方法的return值就是 那个 bean 对象本身(所以上一条我们讲return memoryId -> ...返回的是个 lambda 工厂,不是 ChatMemory)。而"注入"是另一件事------当配置类自己也需要零件 的时候才发生。你马上会在第 5 章碰到:MongoChatMemoryStore要被注入进SeparateChatAssistantConfig,因为"记忆存在哪"这个零件得有人告诉 Provider。这就是文档 5.3.2 突然改那个配置类的原因。③ 你混了两层"封装",而它们是两个不同技术。
层 谁干的 干了什么 和 Spring 有关吗 代理层(真正干活) AiServices接口 → 动态代理:String↔UserMessage/AiMessage 转换、渲染提示词、读写记忆、跑 Tools、塞 RAG 结果 ❌ 无关,纯 LangChain4j 装配层(你写的配置类) Spring 把零件按名字塞进 AiServices.builder()✅ 全在这 你说的"封装的方法就是配置类的 bean 注入 return"------配置类只是提供了零件,真正的封装是代理层干的。这两层分清楚,LangChain4j 就通了一半。
一条链:
注解属性名 = builder 方法名;注解属性值 = bean 名;bean 名 = 配置类里 @Bean 的方法名(或 @Component 的类名首字母小写)
// A. 你现在的写法(Spring 装配)
@AiService(wiringMode = EXPLICIT,
           chatModel = "qwenChatModel",
           chatMemoryProvider = "chatMemoryProvider")
public interface SeparateChatAssistant {
    String chat(@MemoryId int memoryId, @UserMessage String userMessage);
}

@Configuration
class SeparateChatAssistantConfig {
    @Bean ChatMemoryProvider chatMemoryProvider() { return memoryId -> ...; }
}

// B. 完全等价的写法(不用 @AiService,不用配置类)
SeparateChatAssistant assistant = AiServices.builder(SeparateChatAssistant.class)
        .chatModel(qwenChatModel)                    // ← chatModel = "qwenChatModel"
        .chatMemoryProvider(chatMemoryProvider())    // ← chatMemoryProvider = "..."
        .build();
完整流程
java
【编译/扫描期】
  Spring 扫到 @AiService → 不给它建普通 bean,而是登记一条"这个接口将来由 LangChain4j 生成实现"

【启动期 · 第一步:造零件】
  QwenConfig            → qwenChatModel        (OpenAiChatModel 实例)
  SeparateChatAssistantConfig → chatMemoryProvider (一个 lambda 工厂)
  application.yml+starter → openAiChatModel     (DeepSeek,starter 读配置自动建)
  ⚠️ 注意:此时 chatMemoryProvider 里花括号一行都没执行

【启动期 · 第二步:造代理】
  Spring 处理 @AiService → 内部执行 AiServices.builder(SeparateChatAssistant.class)
      .chatModel( 去容器找 "qwenChatModel" )
      .chatMemoryProvider( 去容器找 "chatMemoryProvider" )
      .build()
  → 得到一个 JDK 动态代理对象(不是你写的接口,接口没法 new)
  → 注册成 bean,名字 = "separateChatAssistant"

【运行期:业务/测试】
  @Autowired SeparateChatAssistant assistant;   ← 拿到的是上面那个代理
  assistant.chat(1, "我是张三");
      ↓ 代理内部按顺序做:
      1. 取出 @MemoryId 的 1
      2. 问 provider:get(1) → 没见过 → 造一份 ChatMemory(id=1) → 缓存
      3. memory.messages() 读历史(第一次是空的)
      4. 渲染 @SystemMessage / @UserMessage 模板({{it}}、{{current_date}} 在这替换)
      5. 组装成 ChatRequest(SystemMessage + 历史 + 本次 UserMessage)
      6. 交给 ChatModel 发 HTTP 请求
      7. 拿回 AiMessage → 写回 memory(第 5 章起会顺手落 MongoDB)
      8. 把 AiMessage 转成 String 返回
隔离聊天记忆
0. 需求 → 需要什么零件
需求:两个用户不能串台 → 每个 memoryId 一个独立的记忆 → 需要一个"按 id 发记忆"的东西。
| 零件 | 谁来做 |
|---|---|
| "按 id 发记忆"的工厂 | ChatMemoryProvider(你写) |
| 记忆本体(一个柜子) | MessageWindowChatMemory(框架给) |
| 柜号 | memoryId 参数 + @MemoryId 注解 |
| 把工厂交给框架 | @Configuration + @Bean |
| 告诉框架用哪个工厂 | @AiService(chatMemoryProvider = "chatMemoryProvider") |
1. 写代码的顺序(3 步)
第 1 步:先写记忆工厂(配置类)
思路:框架要一个"输入柜号、输出柜子"的函数,我生产它并交出去。
java
@Configuration                      // ① 我是"生产对象的配置类",启动时会扫描我
public class SeparateChatAssistantConfig {

    @Bean                           // ② 这个方法返回的对象交给 Spring 容器保管,方法名 = bean 名
    ChatMemoryProvider chatMemoryProvider() {
        return memoryId -> MessageWindowChatMemory.builder()   // ③ 输入柜号
                .id(memoryId)                                  //    给柜子贴上柜号
                .maxMessages(10)                               //    最多留 10 条消息
                .build();                                      //    造出一个柜子返回
    }
}
第 2 步:再写接口(声明"用哪个模型 + 哪个工厂")
思路:接口不写实现,只写"我要什么",实现由框架的动态代理生成。
java
@AiService(
        wiringMode = AiServiceWiringMode.EXPLICIT,      // 依赖都按名字从容器取
        chatModel = "qwenChatModel",                    // 用哪个模型
        chatMemoryProvider = "chatMemoryProvider"       // 用哪个工厂(注意:名字要和第 1 步的方法名一致)
)
public interface SeparateChatAssistant {
    //           柜号(不发给模型)     真正发给模型的话
    String chat(@MemoryId int memoryId, @UserMessage String userMessage);
}
第 3 步:调用 + 验证隔离
java
separateChatAssistant.chat(1, "我是小明");
separateChatAssistant.chat(1, "我是谁");      // 记得 → 小明(1 号柜有历史)
separateChatAssistant.chat(2, "我是谁");      // 不记得(2 号柜是空的)→ 隔离成功
写代码顺序总结:工厂 → 接口 → 调用。 先有"柜子的来源",才能声明"用这个来源"。
2. 两段流程(记这两张图就够)
① 启动时
代码块
Spring 启动,扫描注解
 ├─ 看到 @Configuration → 调用 chatMemoryProvider() → 得到一个工厂对象,登记为 "chatMemoryProvider"
 ├─ 看到 @AiService    → 生成 SeparateChatAssistant 的代理对象
 │                       按名字取:qwenChatModel + chatMemoryProvider
 └─ 看到 @Bean chatMemory(MemoryChatAssistantConfig)→ 给 MemoryChatAssistant 用
② 每次调用
代码块
separateChatAssistant.chat(1, "我是谁")     ← 你拿到的是代理对象,不是你写的实现
   │
   ├─ 读注解:@MemoryId → 1 是柜号;@UserMessage → "我是谁" 是消息
   ├─ 向工厂要柜子:provider.get(1)
   │     第一次见 1?→ 执行你的 lambda,造一个新柜子
   │     之后再见 1?→ 直接用缓存里的那个柜子(框架用 computeIfAbsent 缓存,不用你管)
   ├─ 柜子加入 "我是谁" → 把 [柜子里的历史] + 新消息 一起发给 qwenChatModel
   └─ 模型的回答存回柜子 → 返回字符串
3. 为什么必须有 @Configuration + @Bean 这个类
一句话:这个类存在的唯一目的,就是把"记忆工厂"这个对象登记到 Spring 容器里,让框架能按名字拿到它。
自己 new 行不行?不行,三个原因:
| 原因 | 说明 |
|---|---|
框架是"按名字取件",不是 new |
@AiService(chatMemoryProvider = "chatMemoryProvider") 是一句"从容器里找这个名字的 bean"。你手动 new 的对象容器不认识 → 启动报 No bean named 'chatMemoryProvider' available |
| 工厂必须是全应用唯一一份 | @Bean 默认单例。同一个 id 每次都要拿到同一个柜子,所以工厂必须唯一、且本身不存用户数据(缓存由框架做) |
| 要和模型、代理一起装配 | wiringMode = EXPLICIT 就是"所有依赖都从容器按名取"。模型 qwenChatModel 也是 @Bean(在 QwenConfig 里),工厂必须用同样方式提供,才能被一起装配 |
两个注解的分工:
| 注解 | 含义 | 缺了会怎样 |
|---|---|---|
@Configuration |
"这是一个生产对象的类,启动时扫描我" | 类里的 @Bean 不生效 |
@Bean |
"本方法产出的对象交给容器,方法名就是 bean 名" | 容器里没有这个 bean,框架找不到 |
所以第 1 步的方法名
chatMemoryProvider和第 2 步的字符串"chatMemoryProvider"必须一模一样------它们靠名字对接。
4. memoryId -> ... 这种写法为什么可以
因为 ChatMemoryProvider 是函数式接口(只有一个抽象方法):
java
public interface ChatMemoryProvider {
    ChatMemory get(Object memoryId);      // 唯一的抽象方法
}
所以 lambda 写的就是 get 方法的方法体(你注释里说的"省略了重写方法的方法头"就是这个意思,理解正确):
java
// 你写的
memoryId -> MessageWindowChatMemory.builder().id(memoryId).maxMessages(10).build()

// 完全等价于
new ChatMemoryProvider() {
    @Override
    public ChatMemory get(Object memoryId) {
        return MessageWindowChatMemory.builder().id(memoryId).maxMessages(10).build();
    }
};
方法链拆开看:
| 代码 | 作用 |
|---|---|
MessageWindowChatMemory.builder() |
开始造一个"消息窗口"型柜子 |
.id(memoryId) |
柜号。不写默认是 "default";将来接持久化时它就是主键 |
.maxMessages(10) |
最多保留 10 条消息,满了丢最旧的 |
.build() |
造好并返回这个 ChatMemory |
5. 速查:背这 5 个名字
| 名字 | 是什么 | 出现在哪 |
|---|---|---|
ChatMemoryProvider |
函数式接口:ChatMemory get(Object memoryId) |
配置类的返回类型 |
MessageWindowChatMemory |
记忆实现(按消息条数淘汰) | lambda 里造柜子 |
@MemoryId |
指认"哪个参数是柜号" | 接口方法参数 |
@UserMessage |
指认"哪个参数是发给模型的话"(2 个以上参数时必写) | 接口方法参数 |
@AiService |
声明式接口:模型 + 记忆来源 | 接口上 |
3 条规则:
- 用了
ChatMemoryProvider,方法上必须有@MemoryId,否则启动报错。 - 接口只留
chatMemoryProvider,不要 再写chatMemory(两个都写会打架)。 - 参数 ≥ 2 个时,每个参数都要有注解(1 个参数时才能省)。
持久化聊天记忆
区别在于:
@Component |
@Configuration + @Bean |
|
|---|---|---|
| 谁变成 Bean | 这个类自己变成 Bean | @Bean 方法的返回值变成 Bean |
| Bean 数量 | 一个类 → 一个 Bean | 一个配置类 → 多个 Bean |
| 适用场景 | 自己写的类 | 第三方类、需要自定义创建逻辑 |
NoSuchBeanDefinitionException 只有三种原因------
① 类没进容器(缺 @Component/不在扫描包下);
② 类型对不上(没 implements 那个接口);
③ 名字对不上(@AiService(xxx = "名字") 写错)。
java
package com.ping.javaai.store;

import dev.langchain4j.data.message.ChatMessage;
import dev.langchain4j.data.message.ChatMessageDeserializer;
import dev.langchain4j.data.message.ChatMessageSerializer;
import dev.langchain4j.store.memory.chat.ChatMemoryStore;
import org.springframework.jdbc.core.JdbcTemplate;
import org.springframework.stereotype.Component;

import java.util.ArrayList;
import java.util.List;

@Component
public class MysqlChatMemoryStore implements ChatMemoryStore {
    private final JdbcTemplate jdbcTemplate;
    public MysqlChatMemoryStore(JdbcTemplate jdbcTemplate){
        this.jdbcTemplate = jdbcTemplate;
    }

    @Override
    public List<ChatMessage> getMessages(Object memoryId) {
        List<String> rows = jdbcTemplate.queryForList(
                "SELECT content FROM chat_memory WHERE memory_id = ?",
                String.class,
                String.valueOf(memoryId)
        );
        if (rows.isEmpty()){
            //ArrayList 是 List 的实现类,所以可以返回
            return new ArrayList<>();
        }
        //LangChain4j 提供的工具方法,把 JSON 字符串反序列化成 List<ChatMessage>
        return ChatMessageDeserializer.messagesFromJson(rows.get(0));
    }

    @Override
    public void updateMessages(Object memoryId, List<ChatMessage> messages) {
        //chatMessage序列化为json
        String json = ChatMessageSerializer.messagesToJson(messages);

        //ON DUPLICATE KEY UPDATE	如果主键或唯一索引冲突,不报错,改走 UPDATE
        //VALUES(content) 取的就是第二个 ? 的值,也就是 json
        //json = 聊天记录列表序列化后的 JSON 字符串,作为第二个 ? 传给 SQL,最终写入 content 字段。
        jdbcTemplate.update("""
                INSERT INTO chat_memory (memory_id, content)
                VALUES (?,?)
                ON DUPLICATE KEY UPDATE content = VALUES(content)
                """,
                String.valueOf(memoryId),   // 第一个 ? → memory_id
                json);                      // 第二个 ? → content
    }

    @Override
    public void deleteMessages(Object memoryId) {
        jdbcTemplate.update(
                "DELETE FROM chat_memory WHERE memory_id = ?",
                String.valueOf(memoryId)
        );
    }
}
Prompt
系统提示词
@SystemMessage("你是我的好朋友,请用东北话回答问题。今天是{{current_date}}")//系统消息提示词
从资源中加载提示模板
@SystemMessage(fromResource = "my-prompt-template.txt")
{{current_date}}表示当前日期
{{current_time}}表示当前具体时间无日期
用户提示词
@UserMessage("你是我的好朋友,请用上海话回答问题,并且添加一些表情符号。 {{it}}")
//{{it}}表示这里唯一的参数的占位符
java
//最终文本 = 占位符前面的内容  +  你传进 chat() 的参数【占位符】  +  占位符后面的内容
    @UserMessage("你是我的好朋友,请用上海话回答问题,并且添加一些表情符号。 {{userMessage}}")//{{。。。}}表示这里唯一的参数的占位符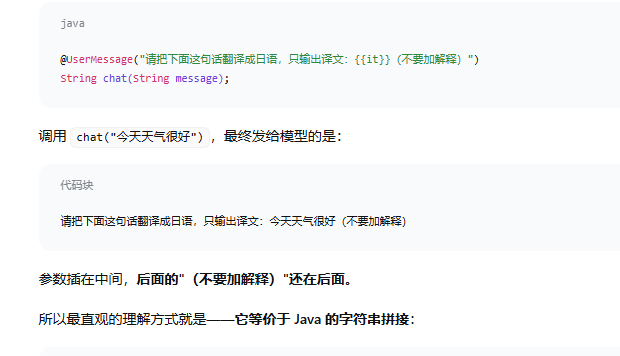
@V
不是"同一个东西被三方识别",而是"两个东西 + 一条绑定"。
| 它是什么 | 什么时候有 | 能改名吗 | |
|---|---|---|---|
userMessage |
Java 参数------装值的槽 | 运行时才有值 | ✅ 随便改 |
@V("message") |
绑定声明------既不是值也不是洞 | 编译期就固定 | 要和 {``{}} 逐字一致 |
{``{message}} |
字符串里的一个洞 | 就是普通文本的一部分 | 要和 @V 逐字一致 |
真正"必须是同一个"的,只有后两个:
@V("message")  ←──────── 必须一模一样 ────────→  {{message}}
   声明                                            洞

userMessage ←── 只是把值递过来的那个人,叫什么无所谓所以准确的说法是:@V 给参数起了一个"对模板可见的艺名" ;模板只认艺名,不认 Java 参数本名。模板不认识 Java 变量,它只认识字符串里的名字。@V 的唯一作用,就是给某个参数"登记一个模板能喊的名字"。
java
@UserMessage("你是我的好朋友,请用上海话回答问题,并且添加一些表情符号。 {{userMessage}}")//{{。。。}}表示这里唯一的参数的占位符
    String chat(@V("userMessage") String userMessage);
多个参数的情况
如果有两个或两个以上的参数,我们必须要用 @V ,在 SeparateChatAssistant 中定义方法 chat2
java
@UserMessage("你是我的好朋友,请用粤语回答问题。{{message}}")
String chat2(@MemoryId int memoryId, @V("message") String userMessage);
@SystemMessage和@V
也可以将 @SystemMessage 和 @V 结合使用
java
@SystemMessage(fromResource = "my-prompt-template3.txt")
String chat3(
    @MemoryId int memoryId,
    @UserMessage String userMessage,
    @V("username") String username,
    @V("age") int age
);
java
你是我的好朋友,我是{{username}},我的年龄是{{age}},请用东北话回答问题,回答问题的时候适当添加表情
符号。
今天是 {{current_date}}。
java
@Test
public void testUserInfo() {
    String answer = separateChatAssistant.chat3(1, "我是谁,我多大了", "翠花", 18);
    System.out.println(answer);
}
实现智能体的基本聊天功能
包含聊天记忆、聊天记忆持久化、提示词
1.创建agent(接口Aiservice),标记Provider和model,系统提示词,用户提示词
2.准备提示词模板文件
3.准备记忆
java
记忆与持久化
   - 内存:MessageWindowChatMemory(保留最近 N 条)
   - 持久化:实现 ChatMemoryStore(Redis / MySQL / Mongo)
     · getMessages(memoryId)
     · updateMessages(memoryId, messages)
     · deleteMessages(memoryId)
4.配置agent(Provider),注意Bean名字对应标记的Provider,然后注入记忆持久化
5.封装会话对象(字段:id+message)
6.controller
ai总结
java
智能体聊天功能 = 模型接入 + 提示词 + 记忆 + 会话管理 + 接口

1. 选型与依赖
   - 框架:LangChain4j / Spring AI
   - Provider:OpenAI / DeepSeek / Ollama ...
   - 引入对应 starter 依赖

2. 提示词准备
   - resources/prompts/system.txt    系统提示词
   - resources/prompts/user.txt      用户提示词模板(含 {{变量}})
   - 用 @SystemMessage / @UserMessage 或 PromptTemplate 加载

3. 声明 Agent(接口)
   - @AiService / @RegisterAiService
   - 指定 provider(Bean 名)、model、temperature
   - 注入 ChatMemory / ChatMemoryProvider

4. 记忆与持久化
   - 内存:MessageWindowChatMemory(保留最近 N 条)
   - 持久化:实现 ChatMemoryStore(Redis / MySQL / Mongo)
     · getMessages(memoryId)
     · updateMessages(memoryId, messages)
     · deleteMessages(memoryId)

5. 会话对象
   - Session { String id; List<Message> messages; }
   - 或用 memoryId 直接对应 sessionId

6. 配置 Bean
   - ChatModel / StreamingChatModel Bean
   - ChatMemoryStore Bean
   - Bean 名必须和 @AiService 里指定的 provider 一致

7. Controller
   - POST /chat       普通问答
   - POST /chat/stream 流式(SSE)
   - 入参:sessionId + userMessage
   - 出参:assistantMessage / Flux<String>
Function Calling
想(第 ③ 步判断要不要用工具)→ 点菜(返回函数名+参数,不执行)→ 做菜(你的 @Tool 方法真跑)→ 传菜(ToolExecutionResultMessage 回给模型)→ 模型把菜名报给客人。
案例:数学工具
当我们提出问题,大模型会判断是否使用该工具
注意:@Configuration和@Component
@Configuration = @Component + CGLIB 代理 + @Bean 方法单例保证。
@Component是你写类、Spring 帮你new;@Configuration是你写方法new、把结果交给 Spring。
分不清的时候,只问自己一个问题:
我要交给容器的这个对象 ,它的**"类"是不是我自己写**的?
| 情况 | 用哪个 |
|---|---|
类是你写的,Spring 能自己 new(默认构造函数 + 构造/字段注入依赖) |
@Component |
对象来自第三方 jar (你没有那个类的源码),或者要**builder()**拼一大堆参数 |
@Configuration + @Bean |
你不需要背"什么时候用哪个"------只需要记住一条:只要你的类里写了 @Bean,就必须配 @Configuration。 否则就是 那种"单例不单例"的鬼故事:容器里那个是单例,但配置类内部直接调用时会偷偷 new 出新的。
这张对比表就是全部答案:
@Configuration |
@Component(同事塞 @Bean) |
|
|---|---|---|
| 类被谁代理 | CGLIB 代理($$SpringCGLIB$$0) |
不代理,就是原始类 |
类内 @Bean 方法互相调用 |
被拦截 → 返回容器里的同一个单例 | 就是普通 Java 方法调用 → 真的又 new 一个 |
| 这种模式的名字 | full 模式 | lite 模式(轻量模式) |
@Bean 产出的对象 |
正常进容器 | 也进容器,但类自己调用时会漏出多个实例 |
这也解释了为什么 Spring 的
@Configuration定义上就标注了@Component------@Configuration=@Component+ CGLIB 代理。这就是你迷惑的根源:它俩本来就是一家的。
流程
1.首先@Component标记工具类,让spring自己new
2.SeparateChatAssistant接口的Ai服务要注入定义的tool组件
3.可以直接使用
java
                       ┌─────────────────────────────────────────┐
   ① 用户提问 ────────▶ │  你:1+2等于几,475695037565的平方根是多少? │
                       └────────────────────┬────────────────────┘
                                            │
                                            ▼
                       ┌─────────────────────────────────────────┐
   ② 应用组包 ────────▶ │  SystemMessage(角色设定)                 │
                       │  + UserMessage(你的问题)                 │
                       │  + @Tool 说明书:                        │
                       │      sum(a,b) / squareRoot(x)           │
                       └────────────────────┬────────────────────┘
                                            │
   ━━━━━━━━━━━━━━━━━━━ 第 1 次请求给模型 ━━━━┻━━━━━━━━━━━━━━━━━━━━━━
                                            │
                                            ▼
                       ┌─────────────────────────────────────────┐
   ③ 模型判断 ────────▶ │  API  /  大模型:需要数学工具吗?→ 需要     │
                       │  返回 AiMessage:                        │
                       │      toolExecutionRequests:             │
                       │        sum(a=1, b=2)                    │  ← 只有函数名+参数
                       │        squareRoot(x=475695037565)       │  ← 没有文字回答!
                       └────────────────────┬────────────────────┘
                                            │
   ━━━━━━━━━━━━━━━━━━━ 第 1 次响应回应用 ━━━━┻━━━━━━━━━━━━━━━━━━━━━━
                                            │
                                            ▼
                       ┌─────────────────────────────────────────┐
   ④ 框架反射调用 ────▶ │  你的 JVM 执行:                          │
                       │      CalculatorTools.sum(1,2)     → 3   │
                       │      CalculatorTools.squareRoot(...) → 689706.4865
                       │  ★ 打印"调用加法运算"就发生在这里          │
                       └────────────────────┬────────────────────┘
                                            │
                       ┌────────────────────▼────────────────────┐
   ⑤ 结果回灌 ────────▶ │  ToolExecutionResultMessage:            │
                       │      "3" 和 "689706.4865"               │
                       │  + 之前所有消息一起重发                    │
                       └────────────────────┬────────────────────┘
                                            │
   ━━━━━━━━━━━━━━━━━━━ 第 2 次请求给模型 ━━━━┻━━━━━━━━━━━━━━━━━━━━━━
                                            │
                                            ▼
                       ┌─────────────────────────────────────────┐
   ⑥ 模型组织回答 ────▶ │  这次有真实结果了,说人话:                  │
                       │  "1+2 等于 3;平方根约等于 689706.4865"     │
                       └────────────────────┬────────────────────┘
                                            │
   ━━━━━━━━━━━━━━━━━━━ 第 2 次响应回应用 ━━━━┻━━━━━━━━━━━━━━━━━━━━━━
                                            │
                                            ▼
                       ┌─────────────────────────────────────────┐
   ⑦ 返回用户 ────────▶ │  ZhiController 返回这段文字                │
                       └─────────────────────────────────────────┘

   ↺ 如果模型觉得还需要别的工具,⑤ → ③ 会再转一圈(LangChain4j 有次数上限保护)
@Tool 注解
name(工具名称):工具的名称。如果未提供该字段,方法名会作为工具的名称。
value(工具描述):工具的描述信息
@P注解
value:参数的描述信息,这是必填字段。
required:表示该参数是否为必需项,默认值为 true ,此为可选字段
@ToolMemoryId
核心作用是自动把 AI 服务方法上的 @MemoryId 参数值,透传到工具(Tool)方法中。
-
AI 服务层 :在接口方法参数上使用
@MemoryId,标记当前会话标识。 -
工具层 :在
@Tool方法参数上使用@ToolMemoryId,框架会自动将上面那个memoryId注入进来。
坑点
1.如果你打算把 @ToolMemoryId 用在 UUID 类型 的参数上,需要确保你的 LangChain4j 版本已经处理了 UUID 的自动转换。有反馈提到,旧版本框架可能无法直接将字符串 ID 转换为 UUID 对象,会抛出 Argument is not convertable to java.util.UUID 的异常,此时框架内部可能需要专门处理 @ToolMemoryId 标记的 UUID 参数-8。如果你用的是较新版本,通常不会有这个问题。
2.@ToolMemoryId 的类型必须和 @MemoryId 完全一致
java
文件:src/main/java/com/ping/javaai/service/SeparateChatAssistant.java      【接口侧】

    @AiService(...)
    public interface SeparateChatAssistant {
        String chat(@MemoryId long memoryId, @UserMessage String userMessage);
                     ^^^^^^^^
                     ↑ 这就是 @MemoryId:贴在你"对话接口"的参数上
    }
java
文件:src/main/java/com/ping/javaai/tools/CalculatorTools.java              【工具侧】

    @Component
    public class CalculatorTools {
        @Tool(name = "加法", value = "返回2个参数相加的和")
        double sum(@ToolMemoryId long memoryId,     ← 这就是 @ToolMemoryId:贴在"工具方法"的参数上
                   @P("加数1") double a,
                   @P("加数2") double b) { ... }
    }
说白了 :@MemoryId 是"这个请求属于哪个会话",@ToolMemoryId 是把这个会话号转交给你的工具方法用。
实现小智的查询订单、预约订单、取消订单的功能
预约业务实现
建表,引依赖mp,配置数据库连接,创建实体类,写mapper接口和xml文件,写service和对应的impl,然后测试
小知识
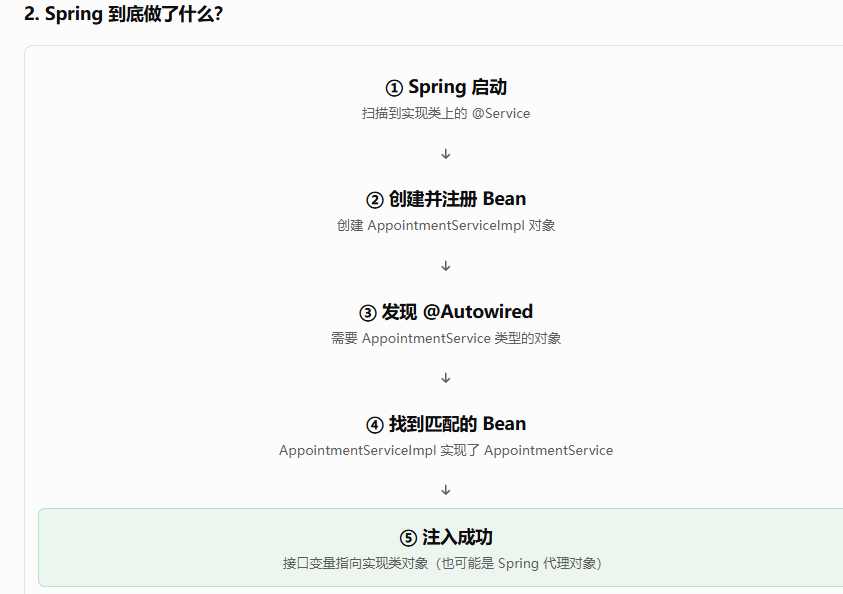
Spring 容器注册的 Bean,必须是能被实例化的对象;接口不能被实例化,所以注解只能加在类上
所以接口无 @Service**,实现类要**@Service
@Service 注册的是实现类对象,@Autowired 注入的是这个对象 ,只不过用接口类型 来接收
java
接口
定义方法规范,可以有多个实现类

@Service
标记实现类,让 Spring 扫描并注册 Bean

@Autowired
Spring 根据接口类型找到合适的 Bean 并注入

多态
接口引用指向具体实现对象,执行对应实现的方法
为什么接口能接收实现类对象?
因为 Java 有一个重要特性:多态。
// 普通 Java 写法
AppointmentService service = new AppointmentServiceImpl();
这是合法的,因为 AppointmentServiceImpl 实现了 AppointmentService 接口。
Spring 的 @Autowired 本质上就是帮你自动完成类似的对象查找和赋值过程
记住三个重点:
-
@Service:告诉 Spring 管理这个实现类。 -
@Autowired:让 Spring 找到合适的 Bean 并注入。 -
接口变量:只是引用类型,真正执行方法的是实现类对象或其代理对象 -
注入接口不是注入所有实现类,而是通过接口引用使用某一个具体实现。
java
package com.ping.javaai;

import com.ping.javaai.entity.Appointment;
import com.ping.javaai.service.AppointmentService;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

@SpringBootTest
public class AppointmentServiceTest {
    @Autowired
    private AppointmentService appointmentService;
    @Test
    void testGetOne(){
        Appointment appointment = Appointment.builder()
                .username("张三")
                .idCard("123456789012345678")
                .department("内科")
                .date("2025-04-14")
                .time("上午")
                .build();
        Appointment appointmentDB = appointmentService.getOne(appointment);
        System.out.println(appointmentDB);
    }
    @Test
    void testSave() {
        Appointment appointment = new Appointment();
        appointment.setUsername("张三");
        appointment.setIdCard("123456789012345678");
        appointment.setDepartment("内科");
        appointment.setDate("2025-04-14");
        appointment.setTime("上午");
        appointment.setDoctorName("张医生");
        appointmentService.save(appointment);
    }
    @Test
    void testRemoveById() {
        appointmentService.removeById(1L);
    }
}
Tools
学习重点是"怎么写描述"而不是方法体本身
注意:
java
@Tool 的 value 是"建议",不是"法律"。模型觉得信息齐全就直接走捷径了。想让流程强制"先查后订",把 value 写得更强硬:

value = "预约前必须先调用queryDepartment确认号源,未查询号源前禁止直接预约。"模型永远不会自己执行你的 Java 代码。它只会"点菜":看完你给的工具清单,返回"我想调 queryDepartment,参数是内科/2026-10-20/上午"。真正执行的一直是你的应用;执行完把结果再喂给模型,它才继续决定下一步。代理负责把"点菜单"翻译成方法调用、把方法返回值翻译回消息。
教的是:
真实业务------让 AI 能帮病人预约挂号
- 9.1 预约业务的实现 :给小智配一个真实的数据库后端------建
appointment预约表、引入 MyBatis-Plus、写实体类 Appointment、Mapper、Service(查科室医生、挂号、取消挂号),本质是标准的 Spring Boot 持久层开发。 - 9.2 Tools :把这些 Service 方法包装成
@Tool(queryDepartment / bookAppointment / cancelAppointment)挂到小智的 Agent 上,让模型在对话中自己决定什么时候查医生、什么时候写库。其中 9.2.3 封装远程调用那小节,因为它调的是 yygh_parent 项目(你没有),当时用本地桩return true替代跳过了
结果:
java
第1轮请求:用户问题 + 3个工具的"说明书"(name/value/@P)

└→ 模型:我不直接回答,我要调【查询是否有号源】,参数{内科,2026-10-20,上午}

└→ 代理执行 queryDepartment() → 返回 true

└→ 把 true 作为 ToolExecutionResultMessage 塞回对话

第2轮请求:历史 + 工具结果(true)

└→ 模型:号源充足,我再调【预约挂号】,参数{张三,123...,内科,...}

└→ 代理执行 bookAppointment() → 查库→插库 → 返回"预约成功"

第3轮请求:历史 + 工具结果("预约成功")

└→ 模型:这次不用工具了 → 生成自然语言"已为您预约成功😊" → 返回给你
这个循环由 langchain4j 自动驱动,你在代码里看不到 for 循环------它藏在代理对象里。你在控制台看到的 @Tool 参数打印和 SQL,就是图中"代理执行"环节的证据
java
模型(点菜的顾客)
   ↓ 只看得见 @Tool 菜单
AppointmentTools ------ @Tool 三件套(queryDepartment / bookAppointment / cancelAppointment)
   ↓ 方法体内部调用
AppointmentService ------ getOne(你手写的)+ save / removeById(MyBatis-Plus 继承来的)
   ↓
AppointmentMapper ------ selectOne / insert / deleteById
   ↓
数据库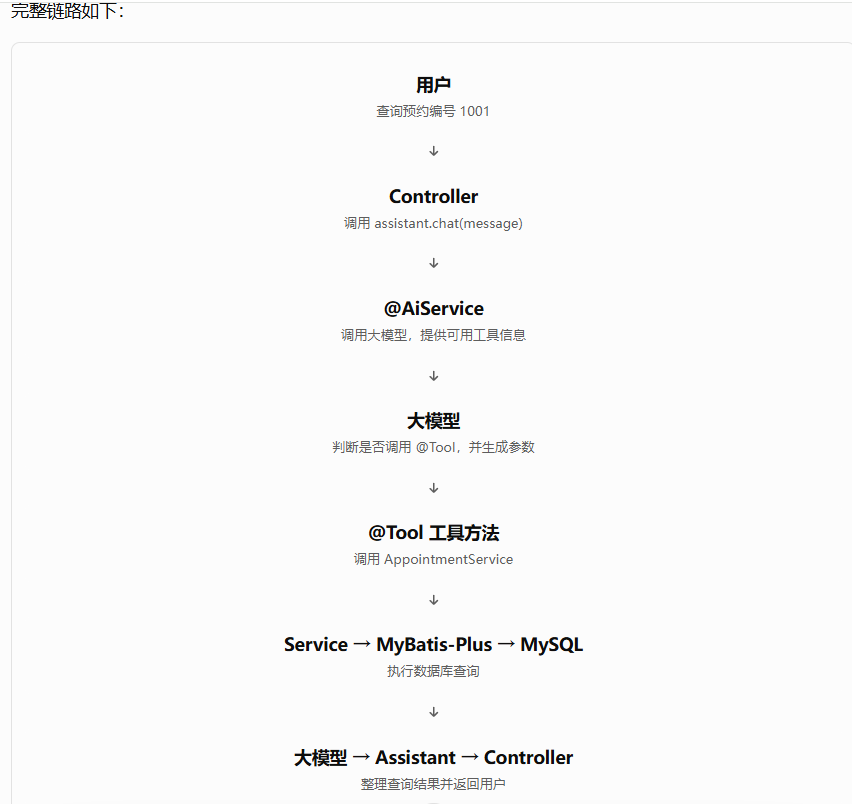
我的理解:
企业级真实使用tool是在aiservice注解标记好tool,
然后tool工具类注入mp的接口进行数据库操作,这样可以持久化,也就是可以理解为Service 方法包装成 @Tool
然后就是直接正式使用是Aiservicec标记的assistent接口注入,直接调用chat并且传参即可,期间tool是通过tool和p注解进行工具方法的说明和方法参数的说明,会影响到方法的是否调用
记住:
@AiService 负责 AI 交互,@Tool 负责暴露业务能力,@P 负责解释参数,Service 负责业务逻辑,MyBatis-Plus 负责数据库操作。
RAG:
小知识:
1.RAG其实并不适合在特定问题条件下穷举文本数据集里面答案,更像是通过模糊检索以后找到一个文本量小,精准符合用户需求的片段。想用RAG技术处理数千条新闻并让他梳理,发现经常会漏内容!穷举的问题还是用"MCP+数据库"似乎更好做一点
2.存的是向量和对应的文本,向量是中间的过程,文本才是结果
1)提前准备=分片+索引
索引=文本转向量+存向量和文本到数据库
2)用户提问之后=
召回(获取最相关的片段【海选】【快 便宜 不准】)+
重排(与召回的计算不一样【精挑细选】【慢贵准】)+
生成(根据原始问题+rag得到的发给llm得到的结果)
LLM 的知识仅限于它所训练的数据。 如果你想让 LLM 了解特定领域的知识或专有数据,你可以:
使用 RAG,使用你的数据微调 LLM
R etrieval-A ugmented Generation 检索增强生成
将原始问题以及提示词信息发送给大语言模型之前,先通过外部知识库检索相关信息,然后将检索结果和原始问题一起发送 给大模型,大模型依据外部知识库再结合自身的训练数据,组织自然语言回答问题。通过这种方式,大语言模型可以获取到特定领域的相关信息,并能够利用这些信息进行回复。
-
优点:数据存储在外部知识库,可以实时更新,不依赖对模型自身的训练,成本更低。
-
缺点:需要两次查询:先查询知识库,然后再查询大模型,性能不如微调大模型
-
应用场景:适用于知识库规模大且频繁更新的场景,如企业客服 、实时新闻 查询、法律 和医疗 领域的最新知识问答等。
RAG常用方法
-
全文(关键词)搜索。 这种方法通过将问题和提示词中的关键词与知识库文档数据库进行匹配 来搜索文档。根据这些关键词在每个文档中的出现频率 和相关性 对搜索结果进行排序。
-
向量搜索 ,也被称为 "语义搜索"。文本通过嵌入模型 被转换为 数字向量 。然后,它根据查询向量 与文档向量 之间的余弦相似度或其他相似性 / 距离度量来查找和排序文档,从而捕捉更深层次的语义含义。
-
混合搜索。 结合多种搜索方法(例如,全文搜索 + 向量搜索)通常可以提高搜索的效果。
向量Vectors
可以将向量理解为从空间中的一个点到另一个点的移动。例如,在下图中,我们可以看到一些二维空间中的向量:
a 是一个从 (100, 50) 到 (-50, -50) 的向量,b 是一个从 (0, 0) 到 (100, -50) 的向量。
很多时候,我们处理的向量是从原点 (0, 0) 开始的,比如b。这样我们可以省略向量起点部分,直接说 b是向量 (100, -50)。
如何将向量的概念扩展到非数值实体上呢(例如文本)?
维度Dimensions如我们所见,每个数值向量都有 x 和 y 坐标(或者在多维系统中是 x、y、z,...)。x、y、z... 是这个向量空间的轴,称为维度。对于我们想要表示为向量的一些非数值实体,我们首先需要决定这些维度,并为每个实体在每个维度上分配一个值。
例如,在一个交通工具数据集中,我们可以定义四个维度:"轮子数量"、"是否有发动机"、"是否可以在地上开动"和"最大乘客数"。然后我们可以将一些车辆表示
因此,我们的汽车Car向量 将是 (4, yes, yes, 5),或者用数值表示为 (4, 1, 1, 5)(将 yes 设为 1,no 设为0)。
向量的每个维度代表数据的不同特性 ,维度越多 对事务的描述越精确,我们可以使用"是否有翅膀"、"是否使用柴油"、"最高速度"、"平均重量"、"价格"等等更多的维度信息。
相似度Similarity
如果用户搜索 "轿车Car" ,你希望能够返回所有与 "汽车automobile" 和 "车辆vehicle" 等信息相关的结果 。向量搜索 就是实现这个目标的一种方法。
如何确定哪些是最相似的?
每个向量都有一个长度和方向。例如,p 和 a 指向相同的方向 ,但长度不同。p 和 b 正好指向相反的方向,但有相同的长度。然后还有c,长度比p短一点,方向不完全相同,但很接近。
那么,哪一个最接近 p 呢?
如果"相似"仅仅 意味着指向相似的方向 ,那么a 是最接近 p 的 。接下来是 c。b 是最不相似的,因为它正好指向与p 相反的方向。如果"相似"仅仅意味着相似的长度,那么 b 是最接近 p 的(因为它有相同的长度),接下来是 c,然后是 a。
由于向量通常用于描述语义意义,仅仅看长度通常无法满足需求。大多数相似度测量要么仅依赖于方向,要么同时考虑方向和大小。
相似度测量Measures of similarity
相似度测量即相似度计算。四种常见的向量相似度计算方法(这里不展开讨论):
-
欧几里得距离 Euclidean distance(2个向量的距离,相减得到的向量)
-
曼哈顿距离 Manhattan distance
-
点积 Dot product(点乘,方向一致最大)
-
余弦相似度 Cosine similarity(只比较夹角)
RAG 后端必须掌握的 7 个知识点
| 知识点 | 需要掌握什么 | 重要程度 |
|---|---|---|
| 1. Embedding | 文本转换成语义向量 | 必须 |
| 2. Chunking | 把长文档切成小片段 | 必须 |
| 3. 向量数据库 | 存储向量、检索相似内容 | 必须 |
| 4. 相似度检索 | Cosine、Top-K、Score | 必须 |
| 5. Reranking | 对检索结果重新排序 | 建议 |
| 6. Prompt 增强 | 把检索内容提供给大模型 | 必须 |
| 7. 文档更新与权限 | 文档版本、增量更新、访问控制 | 企业级必须 |
注意:
不一定一开始就上 Reranker。
先做向量检索,测量检索效果。如果经常找错文档,再加入 Reranker
几个参数要会调
| 参数 | 含义 | 初期建议 |
|---|---|---|
| Chunk Size | 每个文档片段的大小 | 约 300~500 中文字符起步 |
| Overlap | 相邻片段重复的内容 | 约 50~100 字符 |
| Top-K | 每次取回多少片段 | 先测试 5 |
| Min Score | 相似度过滤阈值 | 根据模型实际分数调试 |
| Rerank Top-N | 重排序后保留多少片段 | 可以从 3 开始 |
RAG 不只是能回答问题,还要考虑:
eg:
-
权限隔离:学生不能检索到辅导员内部文件或其他学生的敏感信息。
-
来源追踪:回答最好附上文件名称、章节、版本。
-
文档更新:旧政策失效后,要删除或停用对应的旧向量。
-
幻觉控制:没有检索到可靠依据时,应明确表示不知道。
-
检索评测:准备真实问题,检查是否检索到了正确文档,而不只是看回答是否流畅。
尤其项目涉及学生信息,权限过滤必须在检索阶段执行,不能只靠 Prompt 告诉 AI 不要泄露