用 hrt_model_exec 在 J6M 上给 YOLOv5x 建立性能基线
拿到 HBM 后,很多人会先跑一条 perf 命令,看到 FPS 就开始和别的模型比较。这个数字往往不够用。
同一个 HBM,在单线程和多线程下,平均延时、FPS、BPU 耗时的含义并不一样。更容易踩坑的是,把模型加载时间、单帧推理时间和应用端到端时延混到一起。
本文用 J6M 上的 yolov5x_640x640_nv12.hbm 做一次实测,记录我如何用 hrt_model_exec 完成三件事:
- 确认 HBM 真正需要的输入;
- 建立单线程延时基线;
- 找到单 BPU 核模型的合理并行度。
测试环境
| 项目 | 本次实测配置 |
|---|---|
| 开发板 | J6M |
| 系统 | Linux 6.1.134-rt51,aarch64 |
| UCP / HBRT | UCP 3.12.1 / HBRT 4.4.6 |
| 模型 | yolov5x_640x640_nv12.hbm |
| 模型输入 | NV12,640×640 |
| 编译核数 | 1 |
| 测试输入 | input_bus.jpg |
| 测试帧数 | 1000 |
测试前通过 hrut_somstatus 确认板端温度约 48℃,bpu0 空闲。本文所有测试固定使用 core_id=1,也就是固定到 bpu0。
第一步:先看模型输入
执行:
bash
hrt_model_exec model_info \
  --model_file=./yolov5x_640x640_nv12.hbm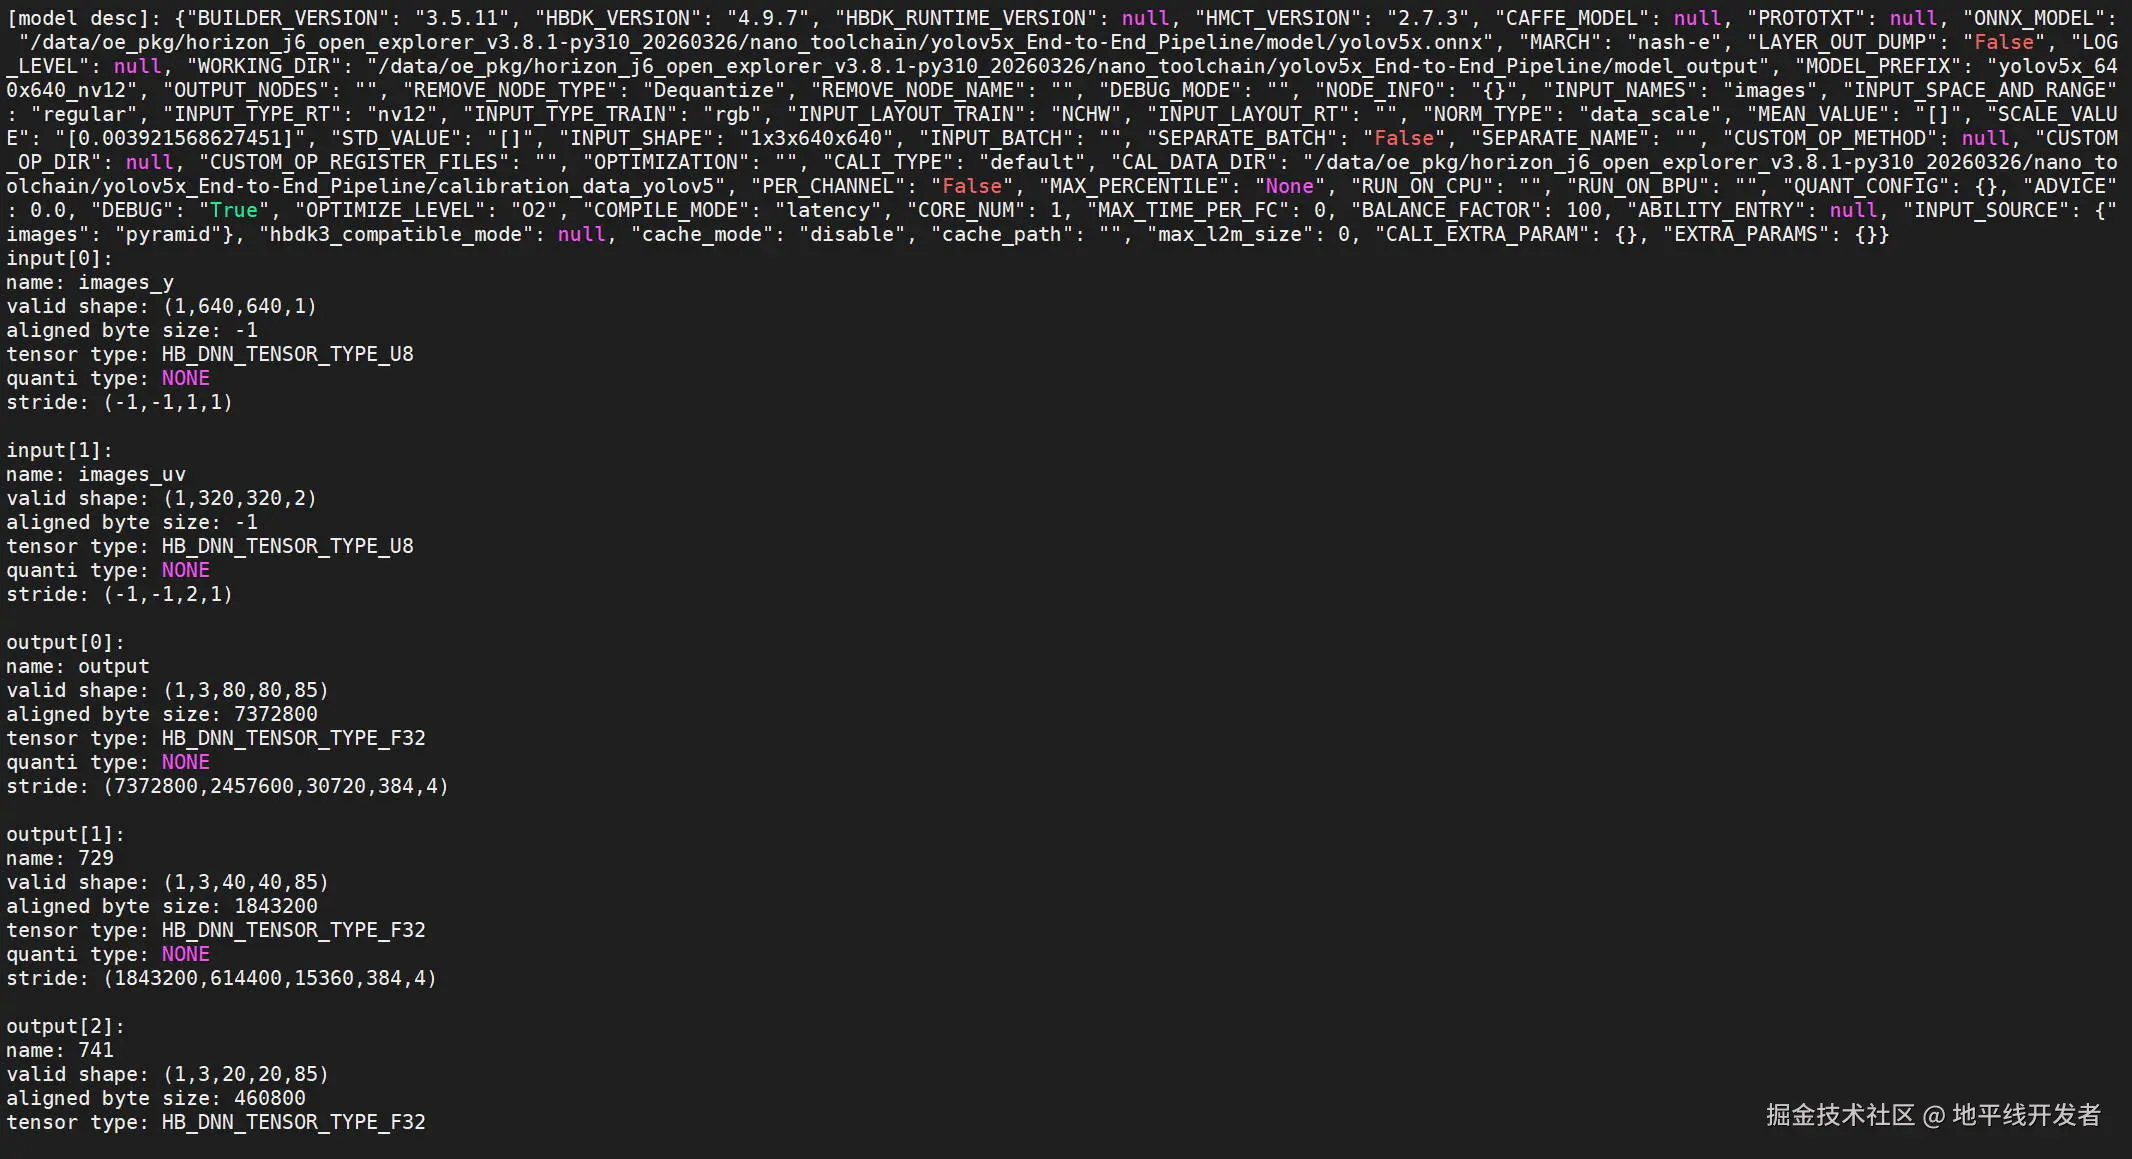
图 1:model_info 输出截图
模型并不是一个普通的 RGB 单输入模型。它有两路 NV12 输入:
text
images_y : (1, 640, 640, 1)
images_uv: (1, 320, 320, 2)
Y 平面大小是 640×640,UV 平面是 320×320×2。两路输入的 stride 都是动态的。
因此,拿一张 JPG 做冒烟推理时,需要把同一个文件传入两次,并显式声明它们分别用于 Y 和 UV:
bash
hrt_model_exec infer \
  --model_file=./yolov5x_640x640_nv12.hbm \
  --input_file=./input_bus.jpg,./input_bus.jpg \
  --input_img_properties=Y,UV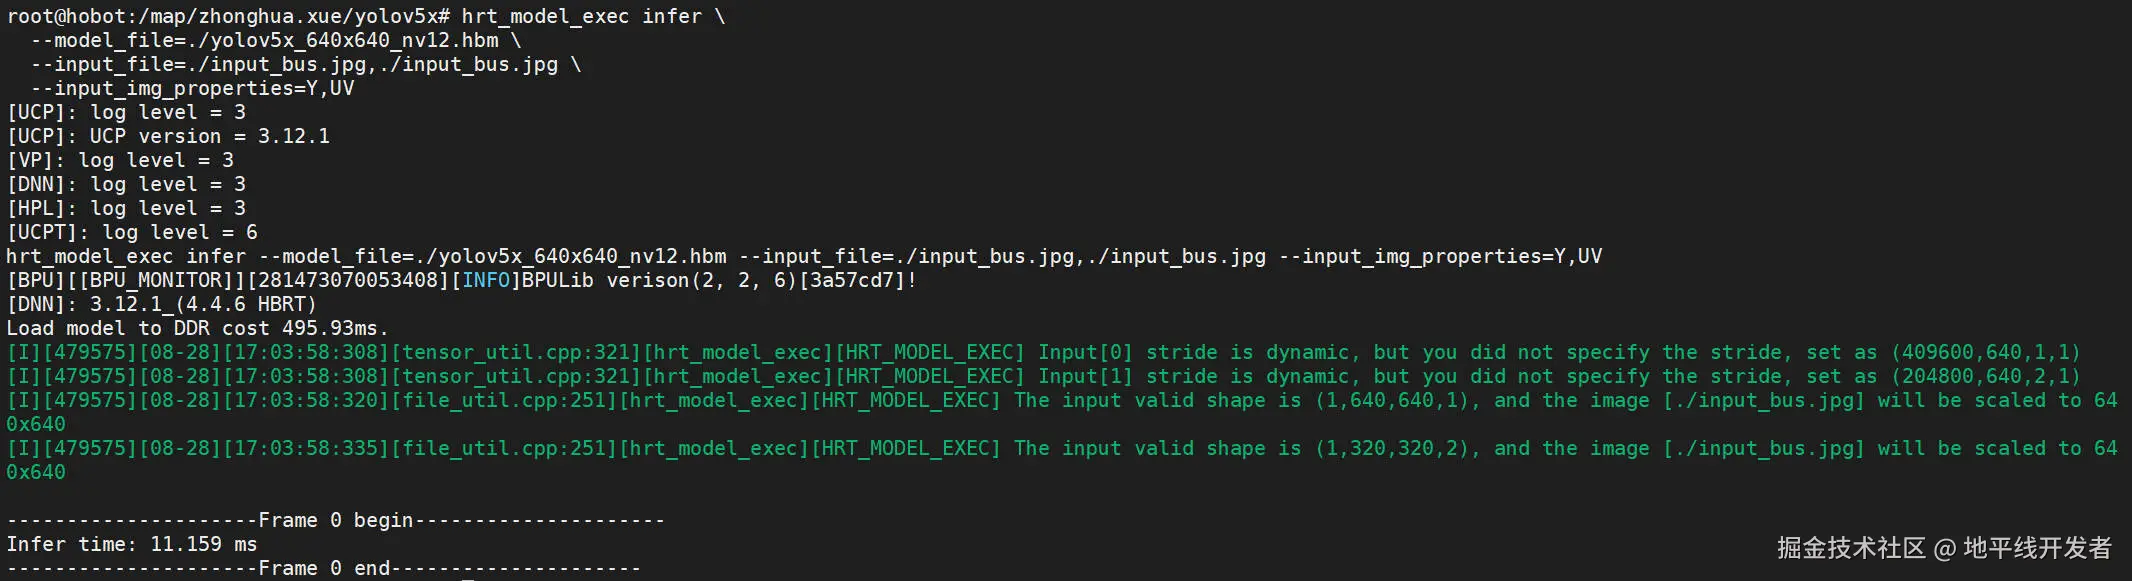
图 2:infer 输出截图
工具输出了以下信息:
text
Input[0] stride is dynamic ... set as (409600,640,1,1)
Input[1] stride is dynamic ... set as (204800,640,2,1)

The input valid shape is (1,640,640,1)
The input valid shape is (1,320,320,2)

Infer time: 11.249 ms
这里有两个值得记录的细节。
第一,hrt_model_exec 根据模型输入和图片尺寸自动补齐了 stride。409600 正好对应 Y 平面的 640×640,204800 对应 UV 平面的 320×320×2。对于这类动态 stride 模型,先让工具打印实际补齐结果,比手填一串数字更稳妥。
第二,日志中的 Load model to DDR cost 495 ms 是模型加载时间,不应和 Infer time 11.249 ms 相加,更不能当成单帧推理时延。前者属于启动开销,后者才是这次单帧执行输出。
第二步:随机输入和真实图片,差别有多大?
perf 不提供输入文件时,会依据模型信息构造随机 Tensor。工具也会给出提示:如果模型包含对输入范围敏感的算子,建议提供合法输入。
我先跑了一组随机输入基线:
bash
hrt_model_exec perf \
  --model_file=./yolov5x_640x640_nv12.hbm \
  --core_id=1 \
  --thread_num=1 \
  --frame_count=1000 \
  --profile_path=./profile_t1
随后使用真实图片再跑一组:
bash
hrt_model_exec perf \
  --model_file=./yolov5x_640x640_nv12.hbm \
  --core_id=1 \
  --thread_num=1 \
  --frame_count=1000 \
  --input_file=./input_bus.jpg,./input_bus.jpg \
  --input_img_properties=Y,UV \
  --profile_path=./profile_t1_bus
结果如下:
| 输入方式 | 平均延时 | FPS |
|---|---|---|
| 工具构造的随机输入 | 10.274 ms | 96.804 |
input_bus.jpg 的 NV12 输入 |
10.281 ms | 96.744 |
两组平均延时相差 0.0077 ms,约为 0.07%。对这个固定输入尺寸的 YOLOv5x HBM 而言,随机输入和真实图片输入给出的模型性能基线基本一致。
不过这个结论只适用于本次模型和测试条件,不能推广到所有模型。遇到动态控制流、ROI、索引类输入或输入范围敏感算子时,仍应优先用真实输入测试。
第三步:单线程延时和并行吞吐要分开测
真实图片输入下,单线程 1000 帧测试结果为:
text
Average latency: 10.281 ms
Frame rate: 96.744 FPS
对应的 profiler.log 显示:
text
BPU_inference_time_cost: 10.236 ms
CPU_inference_time_cost: 0 ms
TaskRunningTime: 10.268 ms
模型只有一个 BPU segment,CPU 推理耗时为 0。说明在 hrt_model_exec 的模型执行口径下,这个 HBM 的主要耗时在 BPU。
这里不能直接推出"整个应用没有 CPU 开销"。图片采集、解码、前后处理、业务逻辑和应用调度并不在这组模型基线里。hrt_model_exec 的作用是先回答:模型本身要花多少时间。
接下来固定同一份图片输入,把 thread_num 从 1 提升到 16:
thread_num |
平均延时 | FPS |
|---|---|---|
| 1 | 10.281 ms | 96.744 |
| 2 | 19.844 ms | 100.397 |
| 4 | 39.680 ms | 100.406 |
| 8 | 79.300 ms | 100.393 |
| 16 | 158.068 ms | 100.388 |
结果很直观:
- 从 1 线程升到 2 线程,FPS 从 96.744 提升到 100.397,增幅约 3.8%;
- 线程数继续增加,FPS 基本停在 100.4 左右;
- 单个请求的平均延时则持续增加,16 线程时达到 158.068 ms。
2 线程的 profile 也能看到这个现象:
text
BPU_inference_time_cost: 19.784 ms
TaskRunningTime:          19.826 ms
Stage2-BpuCoreProcess:    19.718 ms
该组的最小 BPU 段耗时为 10.361 ms,接近单线程基线;平均值接近 20 ms,说明部分任务在单核上发生了排队。
因此,本模型的配置建议是:
| 目标 | 推荐配置 |
|---|---|
| 单路请求低延时 | thread_num=1 |
| 单核吞吐接近上限 | thread_num=2 |
thread_num>=4 |
不建议用于该模型,吞吐没有实际提升 |
有一个容易误解的点:并发场景下,不能简单用 1000 / Average latency 计算 FPS。thread_num=2 时,单任务平均延时是 19.844 ms,但整体吞吐仍有 100.397 FPS,因为有任务在并行提交、串行执行。
用 hrt_model_exec 建立基线后,还该做什么?
这次测试只回答了模型执行层的问题:
- HBM 输入是什么;
- 单帧模型延时约是多少;
- 单核 BPU 能跑到多少吞吐;
- 增加线程后是否还有效。
如果实际应用的端到端帧率远低于约 100 FPS,排查范围就更清楚了:问题不在这个 HBM 的单核执行上,需要继续看图片处理、后处理、CPU 任务、多个模型争抢 BPU,或者应用 Pipeline 调度。
官方文档中,hrt_model_exec 提供模型信息、单帧推理和性能分析;profile_path 可输出节点、BPU、CPU 与任务耗时信息。实际使用时,先建立这条模型基线,再讨论应用性能,沟通成本会小很多。
参考资料:hrt_model_exec 工具说明、模型性能分析。