🎯 LangSmith 学习与面试全攻略:从 Agent「盲盒」到全链路观测与量化评估
摘要:用 LangChain/LangGraph 写 Agent 时,最怕的就是「盲盒感」------调用了哪个工具、每步耗时多少、流式输出了多少 Token、总共烧了多少钱,全是一团黑。LangSmith 就是把这团黑照亮的仪表盘。本文梳理 LangSmith 的核心概念、接入方式、四大功能,并结合两个真实 Demo(错误追踪 + RAG 量化评估),最后附上面试高频考点。
Demo gitee链接
📌 前言:为什么你必须学 LangSmith
写 Agent 的人都有过这种崩溃瞬间:昨天还答得好好的,今天就乱说。你想定位问题,却发现自己面对的是一个黑盒:
- 它到底调用了哪个工具?
- 每一步耗时多少?Token 消耗多少?成本多少?
- 哪个节点把答案带偏了?
管理学里有句话:「如果你无法度量它,你就无法管理它」 。LLM 应用的度量工具,就是 LangSmith。
LangSmith 是 LangChain 团队 推出的 LLMOps 平台,定位是「可观测性 + 评估」,与生态里其他组件的分工如下:
| 组件 | 职责 | 一句话理解 |
|---|---|---|
| LangChain | 开发框架 | 用来「搭」应用(prompt、chain、RAG) |
| LangGraph | 状态机编排 | 用来「编」多步 Agent 流程 |
| LangSmith | 可观测/评估 | 用来「看」和「考」应用 |
| LangServe | 部署 | 用来「上线」 |
简单说:LangChain/LangGraph 负责生产 Agent,LangSmith 负责给 Agent 装监控和出考卷。
🗺️ 一、学习脉络:一张地图理清 LangSmith
结合我自己的学习路径,LangSmith 可以拆成 一条主线 + 四大功能:
markdown
         ┌─────────────────────────────────────────┐
         │         LangSmith(可观测 + 评估)          │
         └─────────────────────────────────────────┘
             │                                        │
      ┌──────┴───────┐                        ┌──────┴───────┐
      │   观测侧       │                        │   评估侧       │
      │ Tracing       │                        │ Datasets      │
      │ Monitoring    │                        │ Evaluators    │
      └──────────────┘                        └──────────────┘
调试 Agent、看链路 出考卷、自动化打分四大功能对应四个问题:
| 功能 | 解决的痛点 | 我的理解 |
|---|---|---|
| Tracing(追踪) | 「Agent 执行过程看不到」 | 每次运行都能回放完整调用链,debug 利器 |
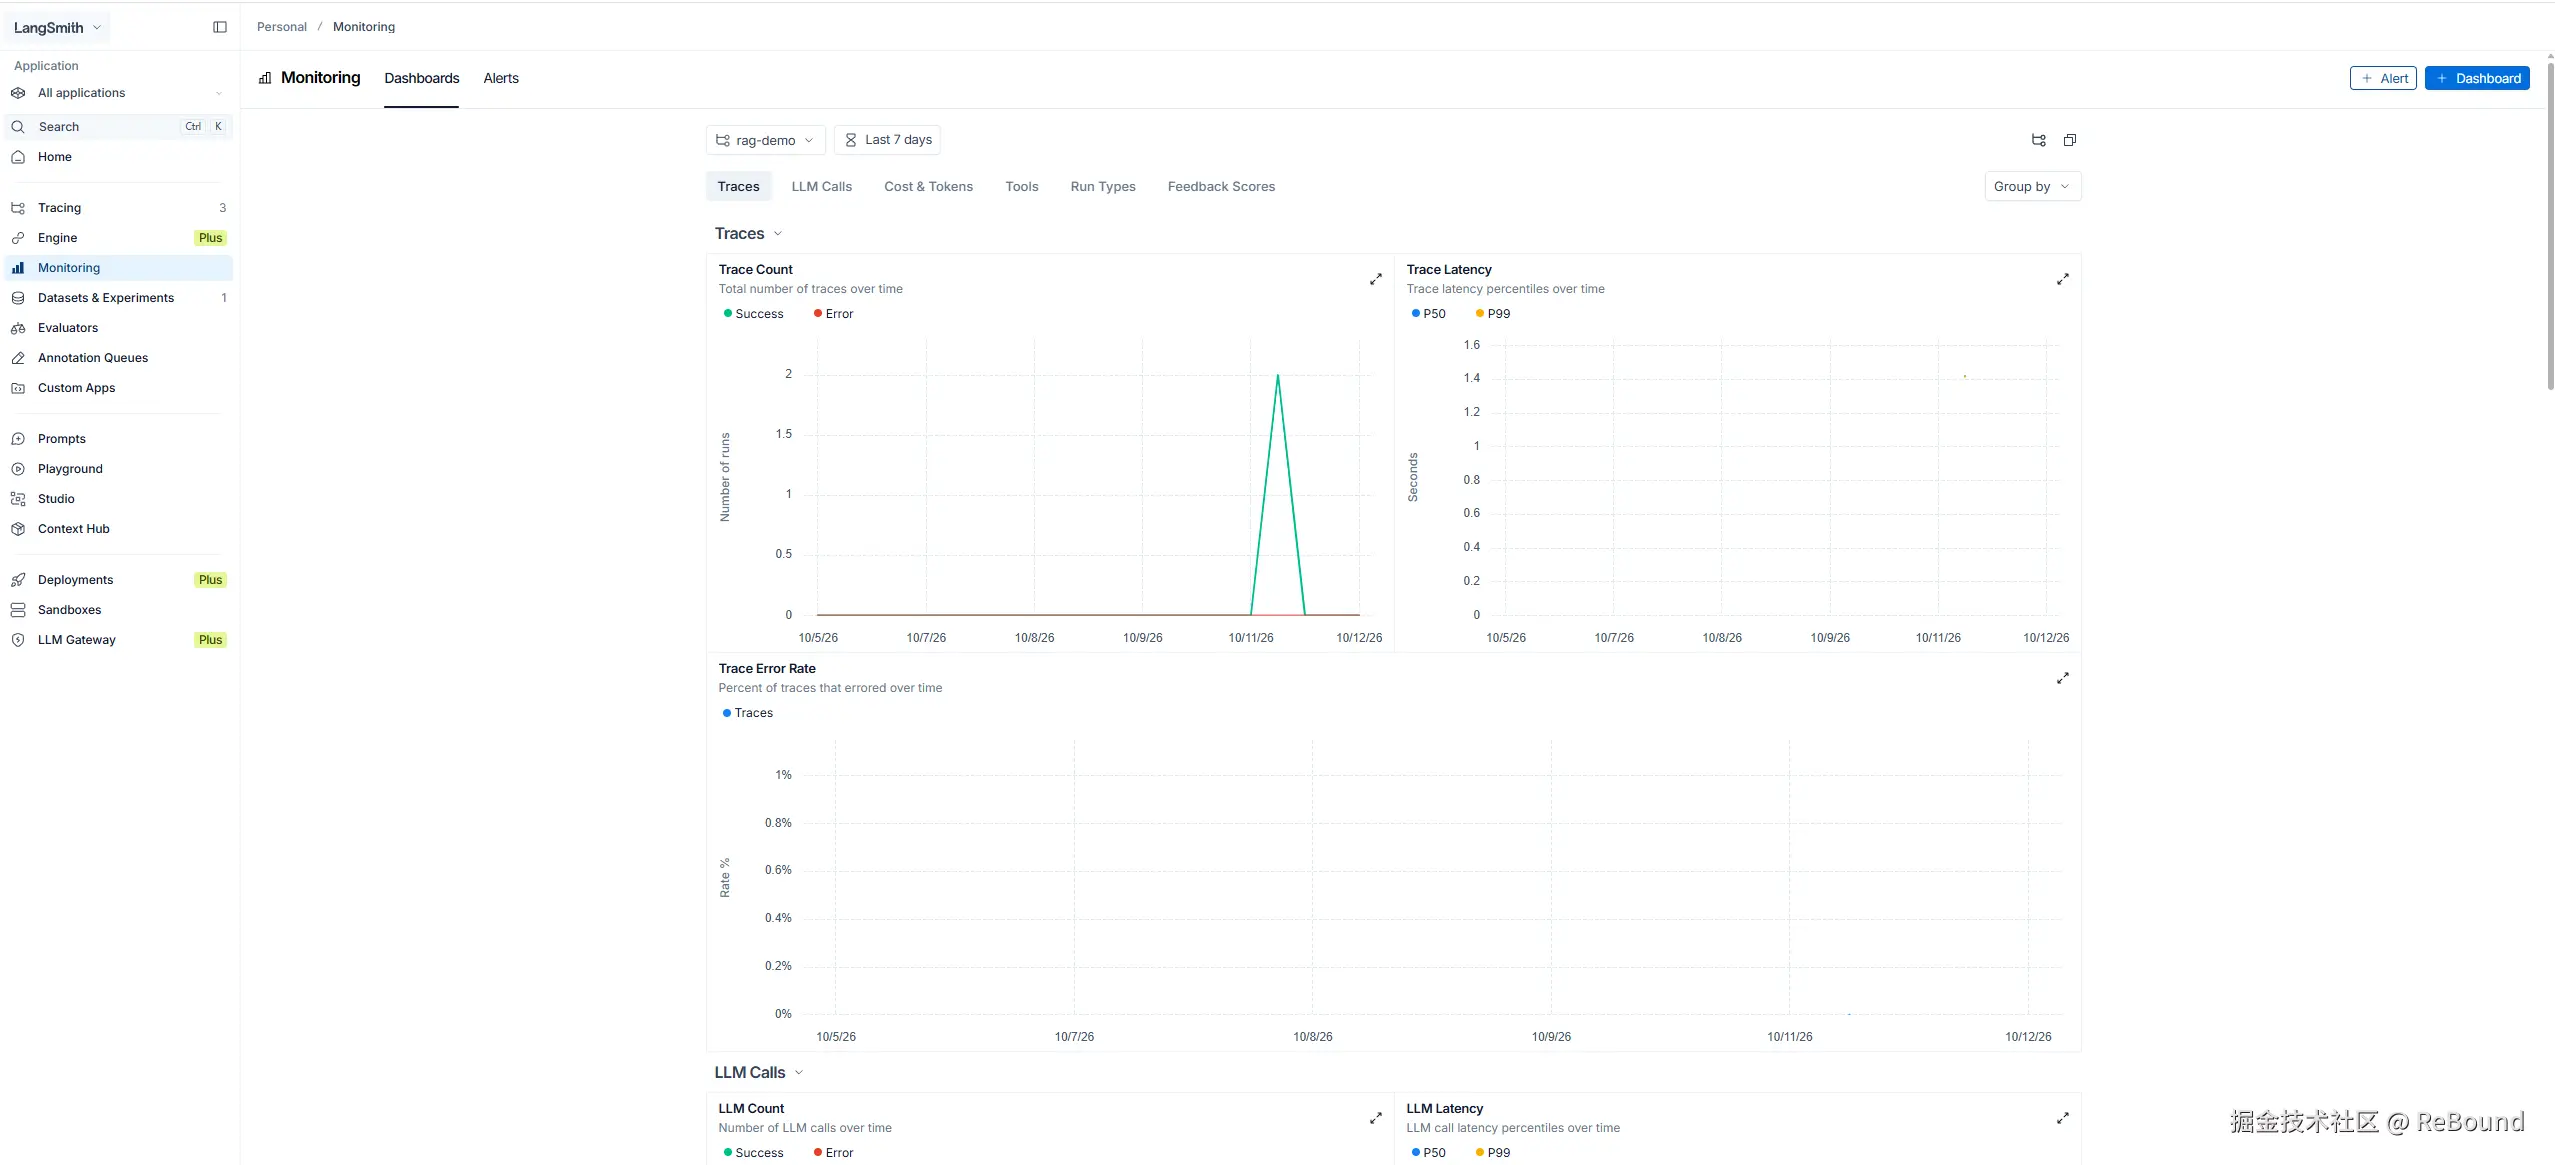
| Monitoring(监控) | 「线上 Agent 跑飞了不知道」 | Token 开销、耗时、错误率的实时仪表盘 |
| Datasets(数据集) | 「没有标准答案怎么测试」 | 统一存放「问题 - 标准答案」对 |
| Evaluators(评估器) | 「改完 prompt 不知道变好变坏」 | 批量自动打分,量化回答质量 |
学习顺序建议:先 Tracing 建立「看得见」的能力,再用 Datasets + Evaluators 建立「考得准」的闭环。下面会分别用两个 Demo 演示这两条线。
📚 二、核心概念:面试必背的术语
LangSmith 的概念模型是一个层级树结构,这是理解它的一切基础:
css
Project(项目)
 └── Trace(一次完整运行 = 根 Run)
      ├── Run / Span(LLM 调用)
      ├── Run / Span(Tool 调用)
      │     └── Run / Span(内部 HTTP 请求)
└── Run / Span(输出解析器)| 概念 | 定义 | 记忆点 |
|---|---|---|
| Project | Trace 的集合容器 | 通常按应用/环境划分,如 rag-demo |
| Trace | 一次端到端运行的全部记录 | 含 prompt、中间输出、工具参数、token、延迟、错误 |
| Run | 最小执行单元 | 一次 LLM 调用 / 一次工具调用 / 一次节点执行 |
| Span | Trace 树中的某个节点 | 与 Run 基本等价,强调树状父子关系 |
| Dataset | 测试用例集合 | 输入 + 期望输出(reference) |
| Evaluator | 打分函数 | 给某次运行打 0~1 分 |
💡 一句话区分 :
Project > Trace > Run/Span,Trace 是一棵树,Run/Span 是树上的节点,树根叫 Root Run。
🔌 三、接入方式:一行代码都不用改
LangSmith 最爽的一点:如果你用的是 LangChain/LangGraph,配几个环境变量就能自动追踪,零侵入。
bash
# .env
LANGCHAIN_TRACING_V2=true        # 开启追踪
LANGCHAIN_API_KEY=lsv2_xxxx      # API Key(示例占位,勿泄露真实 key)
LANGCHAIN_PROJECT=smith-demo # 项目名,trace 会归到这个项目下配置后,graph.invoke() 执行时,所有 LLM 调用、节点跳转、工具调用会被自动上报,无需手动埋点。
如果你不用 LangChain 生态 (比如裸调 OpenAI SDK),则用 @traceable 装饰器手动标记:
javascript
// 示意(Python 同理)
import { traceable } from "langsmith";

const generate = traceable(async (question) => {
    return await llm.invoke(question);
}, { name: "generate_answer" });这也是面试常考点:「LangSmith 怎么做到零代码接入?」 答案就是------LangChain/LangGraph 内部已经集成了 LangSmith 的回调钩子,环境变量一开就自动埋点。
🧪 四、实战 Demo 1:用 LangGraph「故意抛错」看 Trace
第一个 Demo 演示 Tracing 的调试价值:搭一个 LangGraph 图,第二个节点故意抛异常,看 LangSmith 如何帮你定位。
javascript
import "dotenv/config"; // 自动读取 .env 中的 LangSmith 配置
import { Annotation, END, START, StateGraph } from "@langchain/langgraph";

const StateAnnotation = Annotation.Root({
    text: Annotation({ reducer: (_prev, next) => next, default: () => "" }),
});

const stepOk = (state) => ({ text: `${state.text}[ok]` });  // 正常节点
const stepThrow = () => {
    throw new Error("DemoError: 节点内故意跑错");            // 抛错节点
};

const graph = new StateGraph(StateAnnotation)
    .addNode("step_ok", stepOk)
    .addNode("step_throw", stepThrow)
    .addEdge(START, "step_ok")
    .addEdge("step_ok", "step_throw")
    .addEdge("step_throw", END)
    .compile();

try {
    await graph.invoke({ text: "start" });
} catch (err) {
    console.error("已捕获:", err?.message ?? err);
    process.exitCode = 1;
}
这个 Demo 想说明什么?
- 代码里只写了业务逻辑,没有任何 LangSmith 相关代码,但 trace 已经自动上报了。
- 打开 LangSmith 控制台,能看到一条 trace 树:
step_ok成功 →step_throw抛错,错误信息、堆栈、耗时一目了然。 - 这就是「盲盒」到「透明」的转变:以前靠
console.log猜,现在直接看调用链回放。
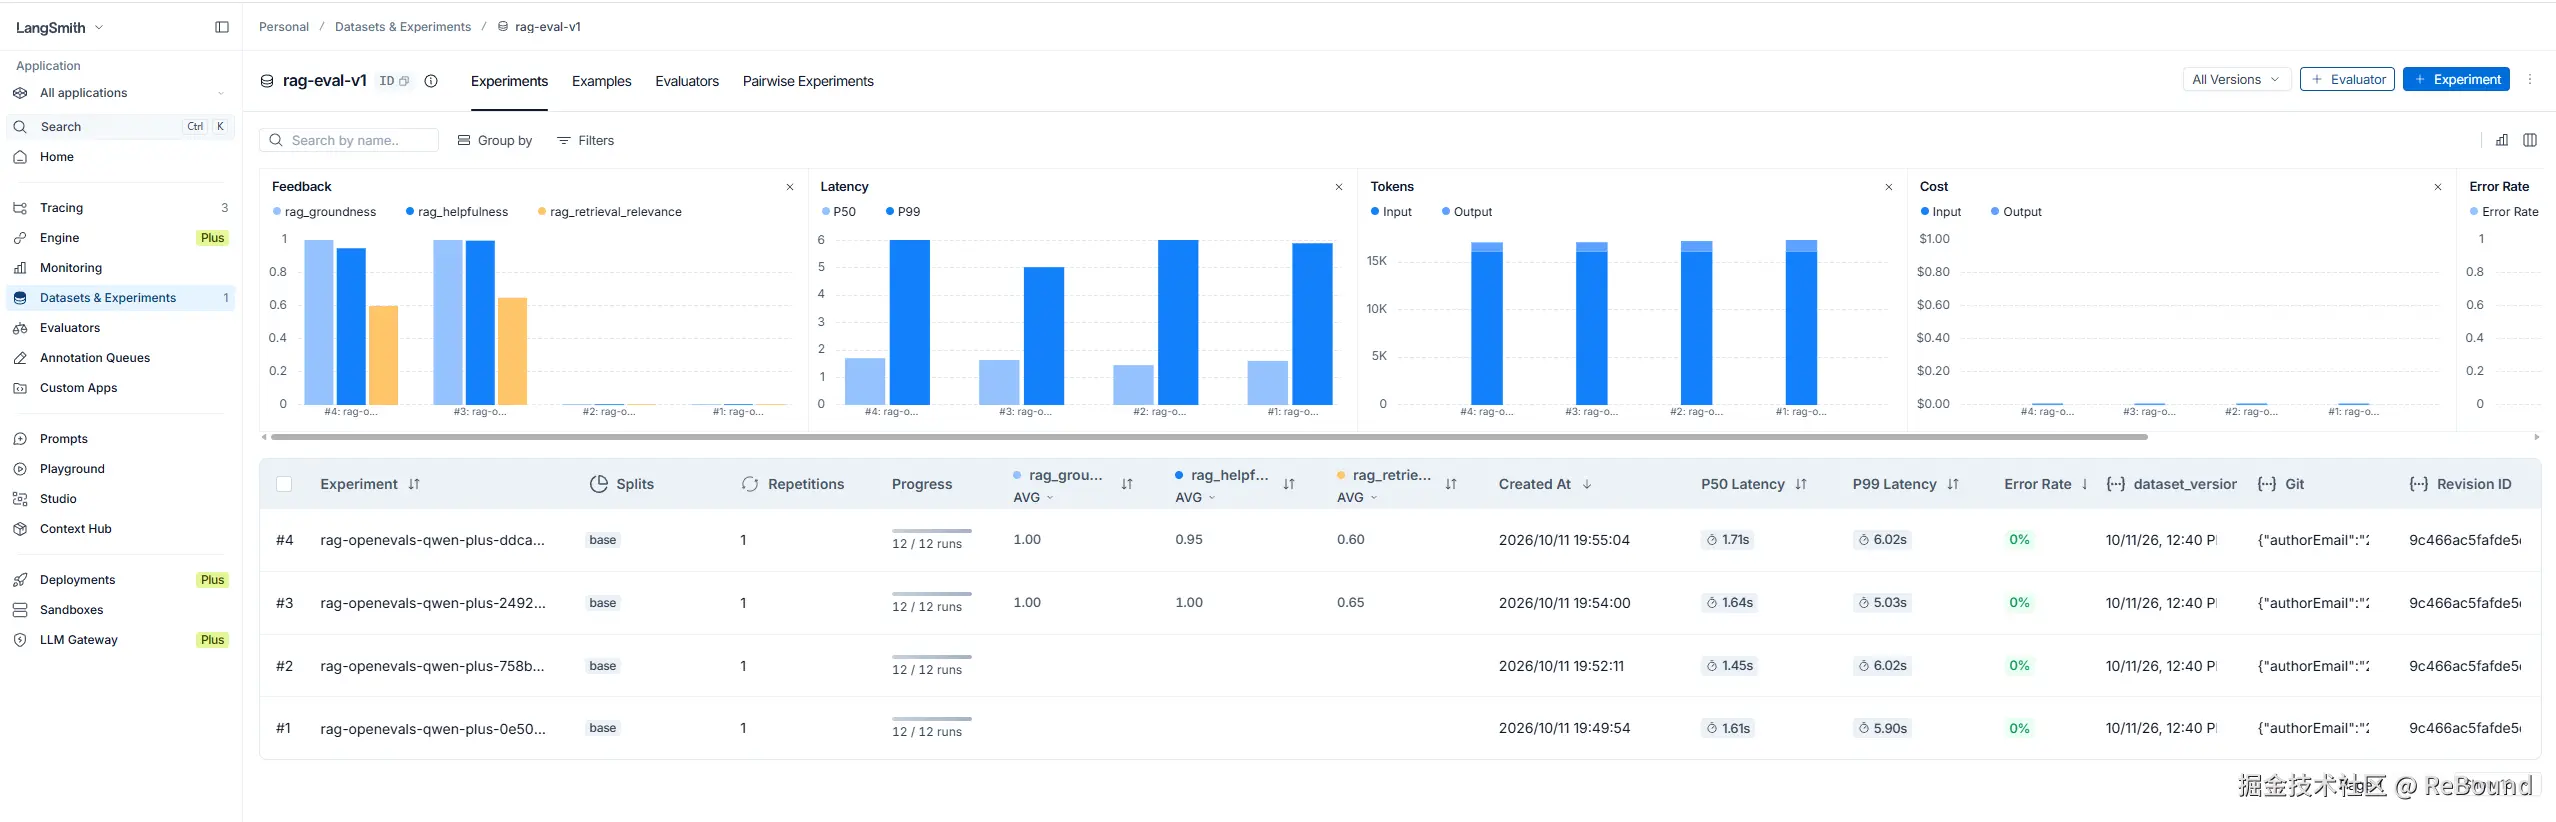
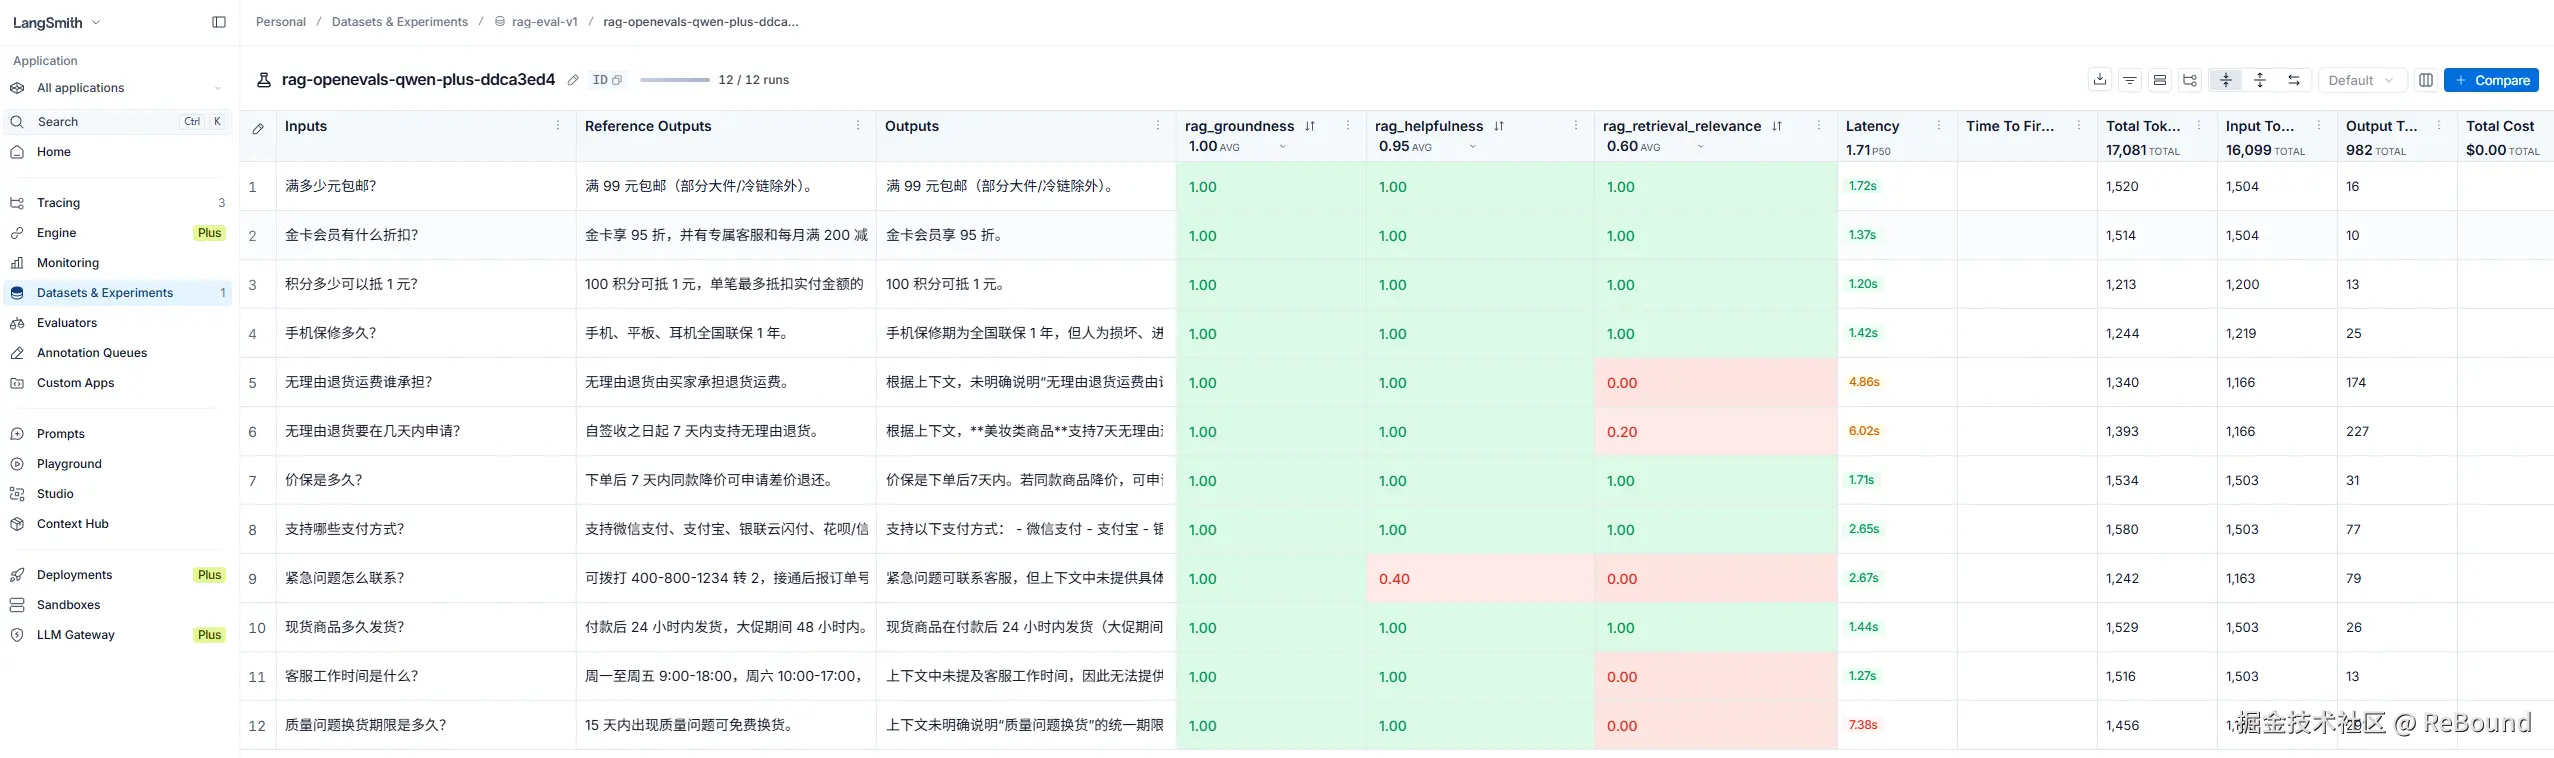
📊 五、实战 Demo 2:RAG 的量化评估(召回 + 回答)
第二个 Demo 更进阶,演示 Datasets + Evaluators 的评估闭环,这也是 RAG 项目最容易踩坑、也最需要客观度量的地方。
5.1 评估什么?两个维度
RAG 质量 = 召回质量(检索到的文档对不对) + 回答质量(基于文档的答案好不好)- 召回质量 :检索节点
retrieve从向量库拿回的文档,是否命中正确答案。 - 回答质量 :生成节点
generate输出的答案,是否准确、有没有幻觉。
5.2 Demo 的技术栈
这个 RAG Agent 用 LangGraph 编排两个节点,配合 Milvus 向量库:
javascript
// rag_agent.mjs(核心链路)
import { Milvus } from "@langchain/community/vectorstores/milvus";
import { ChatOpenAI, OpenAIEmbeddings } from "@langchain/openai";

const embeddings = new OpenAIEmbeddings({ model: "text-embedding-v3" });
const llm = new ChatOpenAI({ model: "qwen-plus", temperature: 0 });

// 已有集合直接挂载,返回 retriever
const vectorStore = await Milvus.fromExistingCollection(embeddings, {
    collectionName: "rag_docs",
    url: "http://127.0.0.1:19530",
});
const retriever = vectorStore.asRetriever({ k: 4 });

// 检索节点
async function retrieve(state) {
    const docs = await retriever.invoke(state.question);
    return { context: docs };
}

// 生成节点(用 prompt + llm + 输出解析器组成链)
async function generate(state) {
    const contextText = state.context.map(d => d.pageContent).join("\n\n");
    const answer = await chain.invoke({ context: contextText, question: state.question });
    return { answer };
}

const workflow = new StateGraph(GraphState)
    .addNode("retrieve", retrieve)
    .addNode("generate", generate)
    .addEdge(START, "retrieve")
    .addEdge("retrieve", "generate")
    .addEdge("generate", END);

export const ragApp = workflow.compile();数据侧,milvus_insert.mjs 负责把 data/ 下的商品文档(售后、物流、支付、质保等)切块 → 向量化 → 写入 Milvus。
5.3 评估闭环怎么跑
这个闭环的价值在于:以前改 prompt 靠感觉,现在改完跑一遍评估,分数涨没涨一目了然 。Demo 的 package.json 里引入了 langsmith 和 openevals(LangChain 官方的评估器框架),正是用来做自动打分的。
🎤 六、面试高频考点
⚠️ 这部分不是机械罗列,而是把最可能被问到的点整理成「怎么答」。
Q1:LangChain、LangGraph、LangSmith 分别是什么?区别?
- LangChain 是开发框架 (搭 chain、RAG);LangGraph 是编排框架 (用状态图编多步 Agent);LangSmith 是可观测 + 评估平台(看、考)。三者分工:构建、编排、观测评估。
Q2:Trace、Run、Span 的区别?
- Trace 是一次完整运行的树;Run 是最小执行单元(一次 LLM/工具调用);Span 是树中节点,与 Run 等价、强调父子关系。层级:
Project > Trace > Run/Span。
Q3:LangSmith 怎么做到「零代码」接入追踪?
- 靠 LangChain/LangGraph 内置的回调集成:只要设
LANGCHAIN_TRACING_V2、LANGCHAIN_API_KEY、LANGCHAIN_PROJECT环境变量,调用链自动上报。非 LangChain 场景用@traceable装饰器手动埋点。
Q4:评估器(Evaluator)有哪几类?
- 四类:人工审核(human)、代码规则(heuristic)、LLM 打分(LLM-as-judge)、两两对比(pairwise)。其中 LLM-as-judge 有位置偏见、冗长偏见等局限,需配合人工抽样。
Q5:RAG 怎么评估?
- 两个维度:召回质量 (检索命中率,如
context_recall、context_precision)+ 回答质量 (准确性、忠实度,如faithfulness、correctness)。用 Dataset 存标准问答对,用 Evaluator 批量打分。
Q6:离线评估 vs 在线评估?
- 离线评估:上线前在数据集上跑,做基准/回归测试,可接 CI/CD 卡质量门禁;在线评估:生产流量实时打分 + 监控,发现问题早告警。
💡 七、总结
回顾这条学习脉络,LangSmith 的核心价值就是一句话:把 LLM 应用从「盲盒」变成「透明 + 可量化」。
- 先观测:Tracing 让你「看得见」Agent 每一步在干什么(Demo 1)。
- 再评估:Datasets + Evaluators 让你「考得准」回答质量(Demo 2)。
- 后监控:Monitoring 让你「守得住」线上运行状态。
面试时记住三个关键词:Trace(看)、Dataset(考题)、Evaluator(打分),再配上你亲手跑过的 LangGraph + RAG Demo,基本就能把 LangSmith 讲透了。
🔗 参考资料
- LangSmith 官方文档 - Evaluation
- LangSmith 入门指南(What is LangSmith)
- LLMOps with LangSmith: Step-by-Step Tutorial
- LangChain vs LangGraph vs LangSmith:Agentic AI 工具链分类(TechRxiv)
- LiteLLM + LangGraph 的 Agent 观测与评估实践(DevelopersIO)
- LangSmith 实现 CI/CD 管道(Docs by LangChain)
觉得有用?点个赞 👍 收藏 ⭐ 关注 👆,下一篇聊聊 LangGraph 的多步 Agent 编排实战!