这篇介绍可控视频生成目前已知的主流技术路线,按"像素从哪来"分成三个类别,依可控性从最确定到最不可控递进讲解。
一、可控性:一个被画质掩盖的问题
选型时最常见的问题是"哪个视频模型最强"。这个问题把注意力放在了画质上限,在目前基模能力接近的情况下,画质已经不是卡住落地的核心要素。
真正的卡点是可控性。模型生成了一条画面惊艳的片子,需求方却说要"商品往左挪、logo 放大一点"。这类精确到帧、精确到像素的改动,靠改提示词重抽做不到,重抽是整条重来,可能连原本已经对的地方一起改掉。把画面生成得好看,和把画面精确控制到某一帧某一像素,是两件难度不同的事,后者是可控视频生成要解决的问题。
要拿到可控性,各条路线的手段并不统一,有的把像素交给代码确定性算出,有的往生成过程里注入控制信号做约束,有的直接扫描真实物体再渲染。但可以用同一个问题把它们排到一起比较:这条视频的每一帧像素,到底从哪来? 按答案,主流路线分三类。下文按像素来源从最确定到最不可控依次展开,A、B 为重点,C 简述。
二、三类路线速览
| 类别 | 像素从哪来 | 代表实现 | 可控性来源 |
|---|---|---|---|
| A 确定性代码渲染 | 代码/场景状态确定性算出,像素是 t 的纯函数 | Opus+HTML+Playwright、Remotion、Shotstack/Creatomate、Codex+Blender | 改参数即改视频,帧级精确 |
| B 神经生成 + 控制信号 | 神经网络生成,被控制信号约束 | Runway Gen-4、Luma、Wan/Kling region-mask、VideoAnydoor/VACE | 区域/相机/关键帧/姿态等条件注入 |
| C 3D 重建与渲染 | 从真实观测重建场景,再按相机轨迹渲染 | Luma AI、Polycam、KIRI Engine、3DGS/NeRF | 相机参数显式,各帧共享同一场景表示 |
三个类比帮助区分:
- A 像印刷:版(代码/模板)确定,印多少张、每张长什么样由版决定,改一处只重印那一张,其余分毫不差。
- B 像拍戏:导演(控制信号)能规定机位、走位、布景,但演员(生成模型)每次表演都有发挥,同一条指令拍两遍细节不同。
- C 像把实物搬进摄影棚:物体是扫描重建来的,棚里的灯和相机随便摆,得到的是那件物体的重建,误差可测可纠。
三类之间存在交叉。例如 image-to-3DGS 的几何由网络生成、像素由显式渲染得到,属于 B 与 C 之间的边界路线。 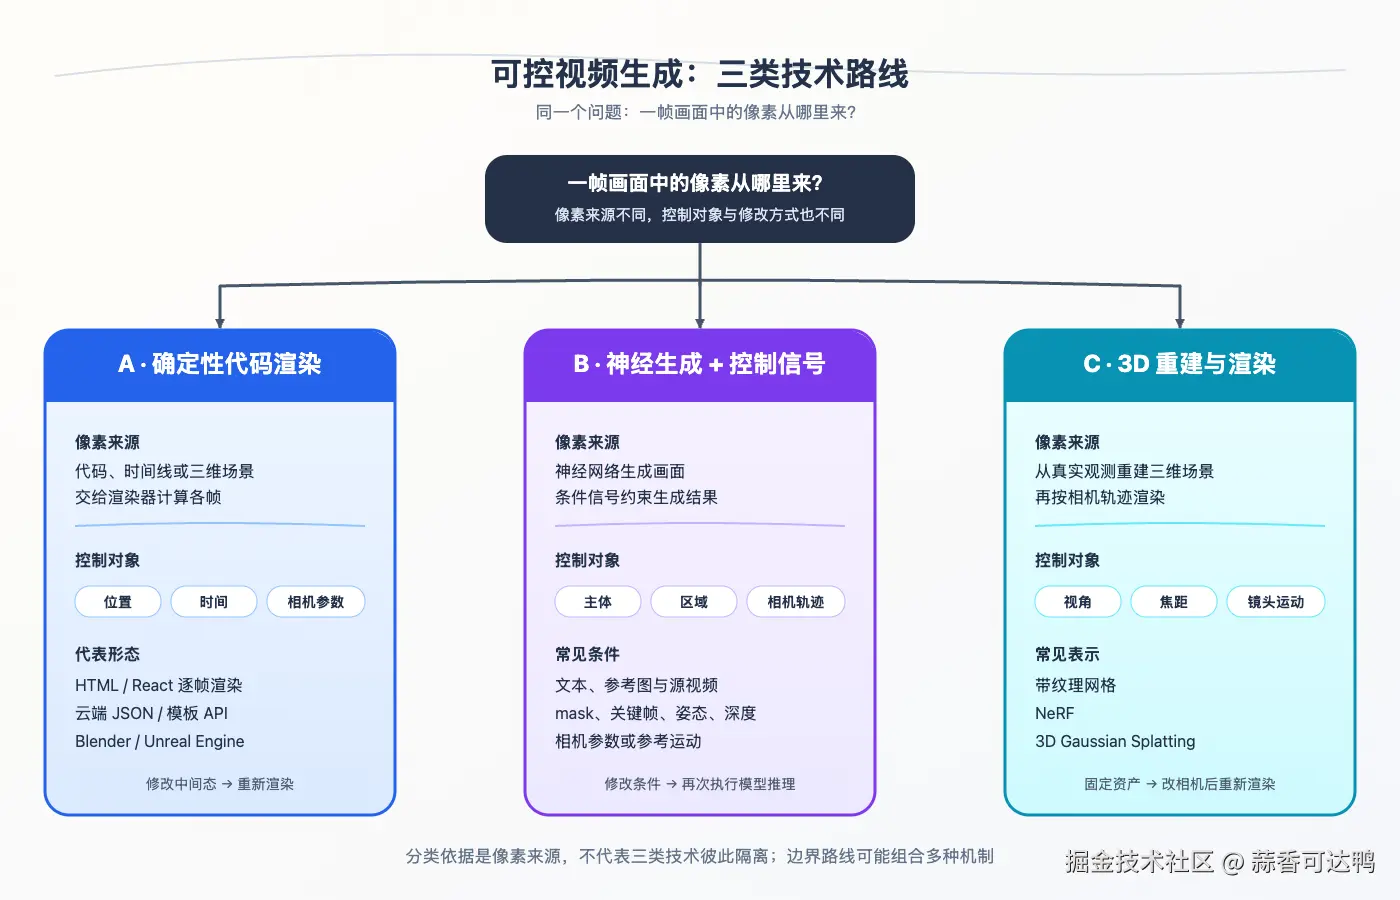
三、类别 A:确定性代码渲染
类别 A 先用显式中间态描述视频,再由渲染器计算各帧。中间态可以是代码、时间线、模板参数或三维场景;位置、尺寸、出现时间、相机轨迹等控制量都能直接修改和检查。在素材、字体、渲染器版本及运行环境固定时,同一份输入通常能够稳定复现。按中间态的表达方式和渲染位置,这类方案可分为自建代码渲染、云端 JSON/模板 API 和程序化 3D 引擎三种。 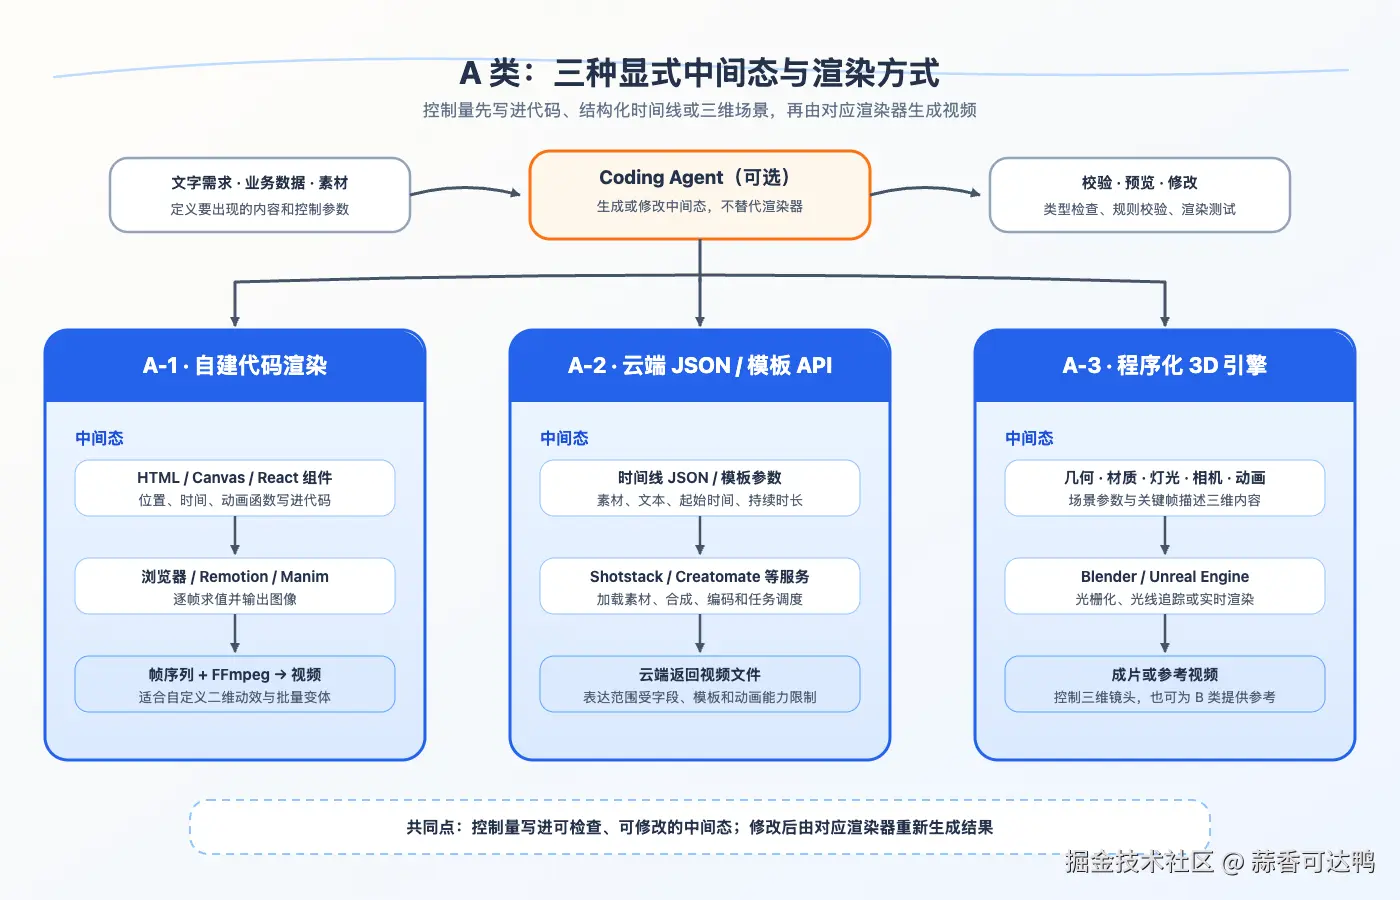
3.1 A-1 自建渲染管线:LLM 写中间态,本地逐帧渲染
思路是让大模型只写代码、不碰像素,像素交给确定性渲染器。
以 HTML/Canvas、Playwright 和 ffmpeg 组成的管线为例:大模型生成动画代码,Playwright 按时间点逐帧截图,ffmpeg 负责编码。流程如下:
- 模型只输出一个自包含 HTML,内含 Canvas/SVG 动画代码,不直接产帧;
- HTML 暴露两个全局约定:
window.DURATION(总时长)和async window.seek(t)(把画面渲染到时间点 t); - Playwright 在固定尺寸的无头浏览器中加载 HTML,等待字体和
window.seek准备完成。渲染第i帧时,调用window.seek(i / fps)将动画定位到对应时间点,再截取一张 PNG; - PNG 直接管道喂 ffmpeg stdin(
image2pipe)编码成 mp4,音频单独 pass 合入,多场景 concat 拼接。
seek(t) 契约的机制示意:
js
window.DURATION = 10;                       // 总时长 10 秒
window.seek = async (t) => {                // t ∈ [0, 10)
  const p = ease(t / 10);                   // 所有运动都是 t 的纯函数
  ctx.clearRect(0, 0, W, H);
  drawBackground(ctx);
  drawProduct(ctx, lerp(X0, X1, p));        // 商品横移:位置 = f(t)
  drawCaption(ctx, t > 6 ? "限时 5 折" : ""); // 字幕出现时机 = f(t)
};为了让各帧能够独立定位,seek(t) 应根据时间 t 和固定输入设置画面,避免依赖上一帧的累积状态。Date.now()、未受控的 requestAnimationFrame 或 CSS 动画、未播种的 Math.random() 等外部时间源和随机源,需要冻结或替换。这样可以减少重复渲染时的帧间偏差,并为并行渲染创造条件;最终结果仍会受到字体、素材和浏览器渲染环境的影响。
Remotion(React) 把同一条管线产品化成了事实标准(GitHub 6 万★ 量级,2026-10)。机制是用 React 组件描述每一帧,useCurrentFrame() 拿帧号驱动动画,<Composition> 声明时长/fps/尺寸,渲染器逐帧把 React 渲成图再编码。帧号是唯一的自变量:
tsx
<Composition id="promo" component={Promo}
  durationInFrames={300} fps={30} width={1080} height={1920}
  defaultProps={{ product: "sku-001", price: "¥99" }} />
批量出片靠 props:CI 里循环 500 个 SKU 各渲染一次就是 500 条变体,模板写一次、数据换 N 次。同族后端还有 Motion Canvas(TS)、Manim(Python 数学动画)、GSAP + p5.js(生成式/手绘风),机制同理,只是渲染器不同。
3.2 A-2 云端 JSON 模板 API:提交一份描述,云端返回 MP4
和 A-1 的区别是不用自己搭 Playwright+ffmpeg、也不用写 React:提交一份结构化 JSON,云端完成渲染并返回 MP4 链接。
- Shotstack:视频用 timeline JSON 描述(clips / transitions / text overlays / audio tracks),向渲染接口提交后,云端完成渲染并返回下载地址;支持数百个渲染任务排队与状态轮询,内建 CDN。
- Creatomate:模板路线,设计师在可视化编辑器搭版式,通过 REST API 灌动态数据出品牌变体,模板支持条件逻辑(同一 payload 按数据值出不同结果),per-render 计费。
- JSON2Video:纯声明式,用 JSON 定义 scenes/elements/timing,无状态、每请求自包含,schema 文档化程度高,专门降低 LLM 生成 payload 的幻觉风险。
一个 Shotstack 风格的载荷示意:
json
{
  "timeline": {
    "tracks": [
      { "clips": [ { "asset": { "type": "image", "src": "https://cdn.../sku-001.png" },
                    "start": 0, "length": 3,
                    "transition": { "in": "fade", "out": "slideLeft" } } ] },
      { "clips": [ { "asset": { "type": "title", "text": "限时 5 折",
                    "style": "boldCenter" }, "start": 1.5, "length": 2 } ] }
    ]
  }
}
JSON 中的素材地址、文本、起始时间和持续时长等字段直接描述视频内容。修改相应字段并重新提交,就能生成新的版本。A-2 的特点是使用结构化描述作为输入,由云端服务负责素材加载、画面合成、视频编码和任务调度;A-1 则由开发者编写并维护渲染代码。
Shotstack、Creatomate 等商用服务没有公开完整的内部渲染架构,不能据此断言它们都采用浏览器逐帧截图。第三方开源项目 cutengine 展示了一种参考实现:解析时间线 JSON,构建 HTML/CSS 场景,预先加载素材,逐帧更新场景并截图,最后交给 FFmpeg 编码。这套流程说明结构化描述可以如何转换成视频,但不代表上述商用服务的实际实现。
结构化接口同时限定了可表达的范围:调用方只能使用服务已经定义的字段、模板和动画能力。超出接口范围的布局或动效,需要修改模板、扩展渲染服务,或转向自建管线。
3.3 A-3 3D 引擎程序化渲染:用场景参数控制画面
A-3 用三维场景作为视频的中间态。与 A-1 的 HTML/React 代码、A-2 的时间线 JSON 不同,这里的描述对象是三维空间中的几何、材质、灯光、相机和动画。它们可以保存在 Blender 场景、Unreal Engine 工程或相应的脚本与配置中,再由 3D 引擎逐帧渲染。
一条视频通常经过四个步骤:
- 组装场景:导入或程序化创建模型,设置物体的位置、旋转和缩放,并配置材质、灯光与背景;
- 定义动画:为物体和相机设置关键帧、运动曲线或约束。相机轨迹、镜头焦距、物体运动和灯光变化都可以随时间变化;
- 逐帧渲染:引擎在每个帧号计算场景状态,经光栅化或光线追踪生成图像;
- 编码视频:把帧序列与音频交给引擎自带的导出工具或 FFmpeg,生成最终视频。
A-3 的控制对象是显式的场景参数。相机路径可以用关键帧和曲线编辑,物体运动可以通过坐标、骨骼或约束定义,材质与灯光也有对应参数。修改参数后重新渲染,就能得到新的版本。需要注意的是,三维场景中的元素会相互影响:移动物体可能改变遮挡、阴影和反射,因此"修改局部参数"不等于"只改变局部像素"。
Blender 提供 bpy 接口,可用 Python 创建和修改场景,也支持无界面批量渲染;Unreal Engine 则通过 Sequencer、Blueprint、Python 或 C++ 控制实时场景和镜头。大模型或 coding agent 可以生成这些脚本与配置,但决定可控性的仍是场景参数是否显式、渲染过程是否可重复,而不是使用了哪一种模型。
Blender 也可以不负责最终画面,只用于制作参考视频。制作时先用简化模型搭建场景,设置主体位置、动作、相机轨迹和镜头时长,再把视口动画或低成本渲染结果导出为视频,交给支持视频参考输入的 Seedance 模型生成正式画面。参考视频提供构图、运动和时间节奏,文本提示与参考图补充主体外观、材质和风格。这种做法把难以用文字准确描述的镜头运动转换成可视化控制信号,但不能保证最终结果逐帧复现参考视频;主体细节、遮挡关系和物理运动仍可能偏离,需要通过生成结果检查和重新生成处理。这里的 Blender 属于 A-3,因为参考视频由显式三维场景渲染;Seedance 生成的最终画面则属于 B 类。 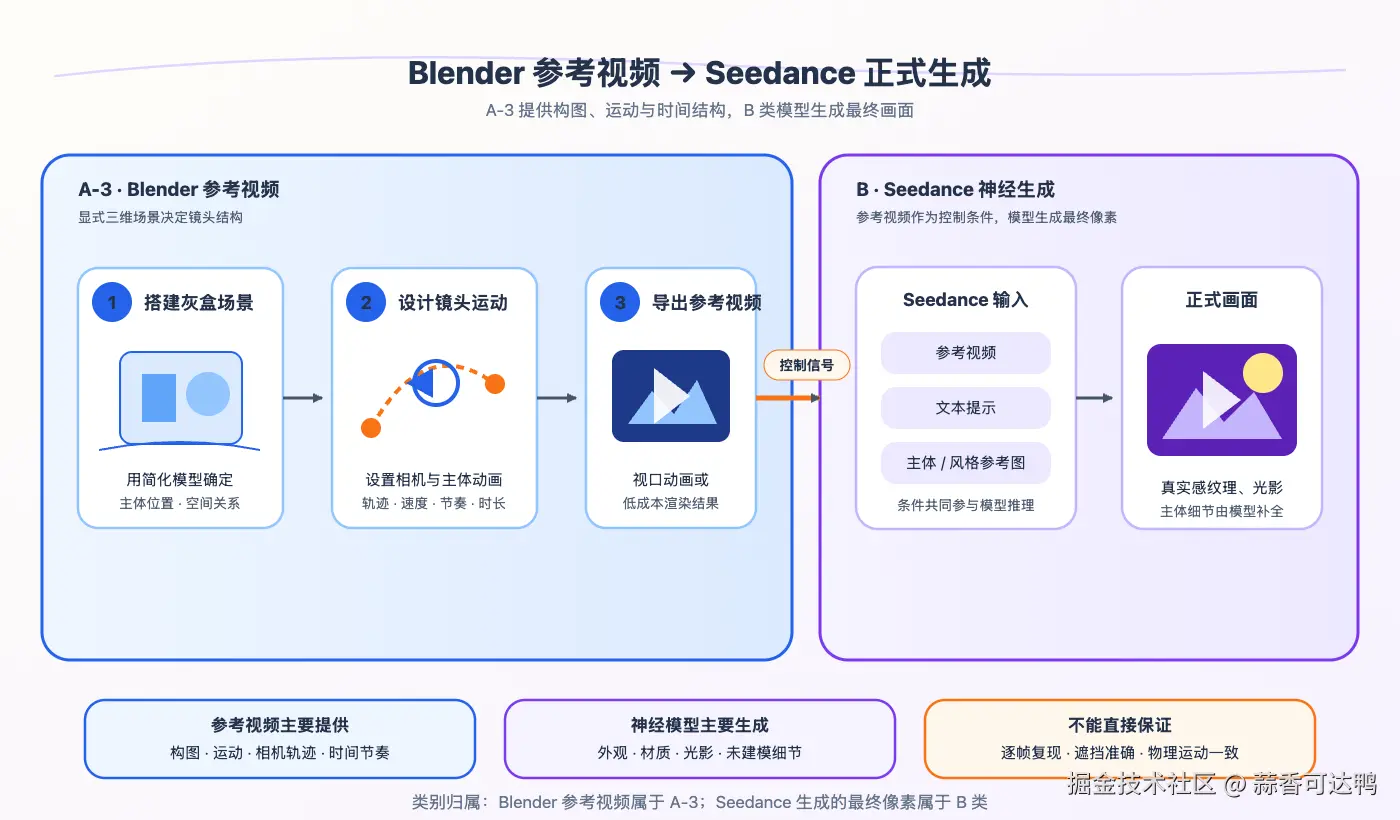
A-3 与类别 C 都会把三维场景渲染成视频,区别在于几何从哪里来。A-3 的模型通常由人工制作、程序生成或资产库导入;C 类则从真实物体的多视角图像或扫描数据中重建几何与外观。A-3 可以自由设计不存在的场景,但效果取决于模型、材质、灯光和动画资产的质量。固定资产、随机种子、引擎版本及渲染设置后,结果通常可以稳定复现;布料、粒子和刚体等物理模拟还需要额外控制缓存、初始条件与随机性。
3.4 Coding Agent 带来的变化:自动生成和修改中间态
代码渲染本身并不是新路线。Manim、Blender 脚本、Remotion 和云端模板 API 已经分别覆盖二维动画、三维场景、React 视频和结构化时间线。近期的变化主要发生在创作环节:coding agent 可以根据文字需求生成 HTML/Canvas 动画、React 组件、时间线 JSON 或 bpy 脚本,再交给已有渲染器执行。
这类流程通常包括需求转译、生成中间态、运行预览、检查结果和修改代码。中间态可以阅读、保存到版本库,也可以通过类型检查、规则校验和渲染测试发现问题。需求方要调整字幕时间、镜头轨迹或物体位置时,agent 修改相应代码或参数,渲染器再生成新版本。可控性仍来自显式中间态和渲染器;agent 主要减少手工编写与修改中间态的工作量。
这种变化没有消除工程约束。生成的代码可能引用不存在的接口,也可能在时间计算、字体加载、素材路径、三维坐标和渲染性能上出错。稳定生产仍需要模板、数据校验、测试、版本管理和人工审核。coding agent 扩大了代码渲染的适用人群,也加快了迭代,但没有改变底层渲染能力及其边界。
A 的边界不在于能否呈现真实感,而在于画面内容需要由素材、代码或三维资产明确提供。它可以合成实拍素材,也可以渲染真实感三维画面,但不会像生成模型那样根据提示自动补出未提供的主体、场景和细节。
四、类别 B:神经生成 + 控制信号
类别 A 要获得真实感,需要已有的实拍素材或完整的三维资产。当目标主体、场景或运动没有现成素材可用,也难以逐项建模时,通常转向神经生成模型。类别 B 的可控性问题因此集中在如何把控制信号注入生成过程。
4.1 生成机制:像素怎么被"生成"出来
B 的像素由神经网络生成,主流机制是扩散,另有自回归(AR)、flow matching 等并行路线,2026 年已出现融合工作(Flex-Forcing、Lumos-1 把离散扩散和自回归统一)。下面以扩散为例讲清"像素怎么被生成出来",自回归的机制差异放在本节末尾。
一条扩散视频的生成有四步,控制信号在第三步进入:
- 加噪的逆过程:模型从一段纯噪声(潜空间里的随机张量)出发;
- 迭代去噪:跑几十步,每步模型预测"当前张量里的噪声是什么"并减掉一点,画面从糊到清;
- 条件注入:每步去噪时模型都会"看一眼"条件信号------文本 prompt 经文本编码器变成向量、参考图/首帧经图像编码器变成特征、mask/深度图/相机参数经各自编码器变成条件张量,去噪方向被这些条件往回拽。控制信号不是事后贴上去的,是在每一步去噪里持续起作用的引力;
- 解码:去噪完成的潜变量经 VAE 解码成像素。
这种生成方式会直接影响视频的修改方式和控制精度:
- 修改需要再次执行模型推理:生成视频通常不能像确定性渲染那样只重算某一帧。改变提示词、参考素材或控制条件后,模型需要重新生成结果。Wan 3.0 等视频编辑模型可以把源视频作为条件,尽量保留未要求修改的内容;但其实际重算范围、未修改区域的一致性,以及是否支持按时间段或掩码精确编辑,取决于具体模型和接口。
- 控制是概率性约束而非像素级精确:条件信号是引力不是模具,它把结果往某个方向拉,但不保证每个像素落点------region-mask 能大致锁住区域、相机控制能大致走出轨迹,但 logo 的一个像素漂没漂,模型不承诺。
自回归路线的机制不同:它把视频当 token 序列逐个预测,条件通过前文 token 注入,天然适合流式/实时续写,但在"精确约束某一帧某一区域"上和扩散有各自的强弱,这里不展开。
4.2 控制信号谱系
B 的可控性来自控制信号的类型和注入方式。按"控制的是什么"分四类: 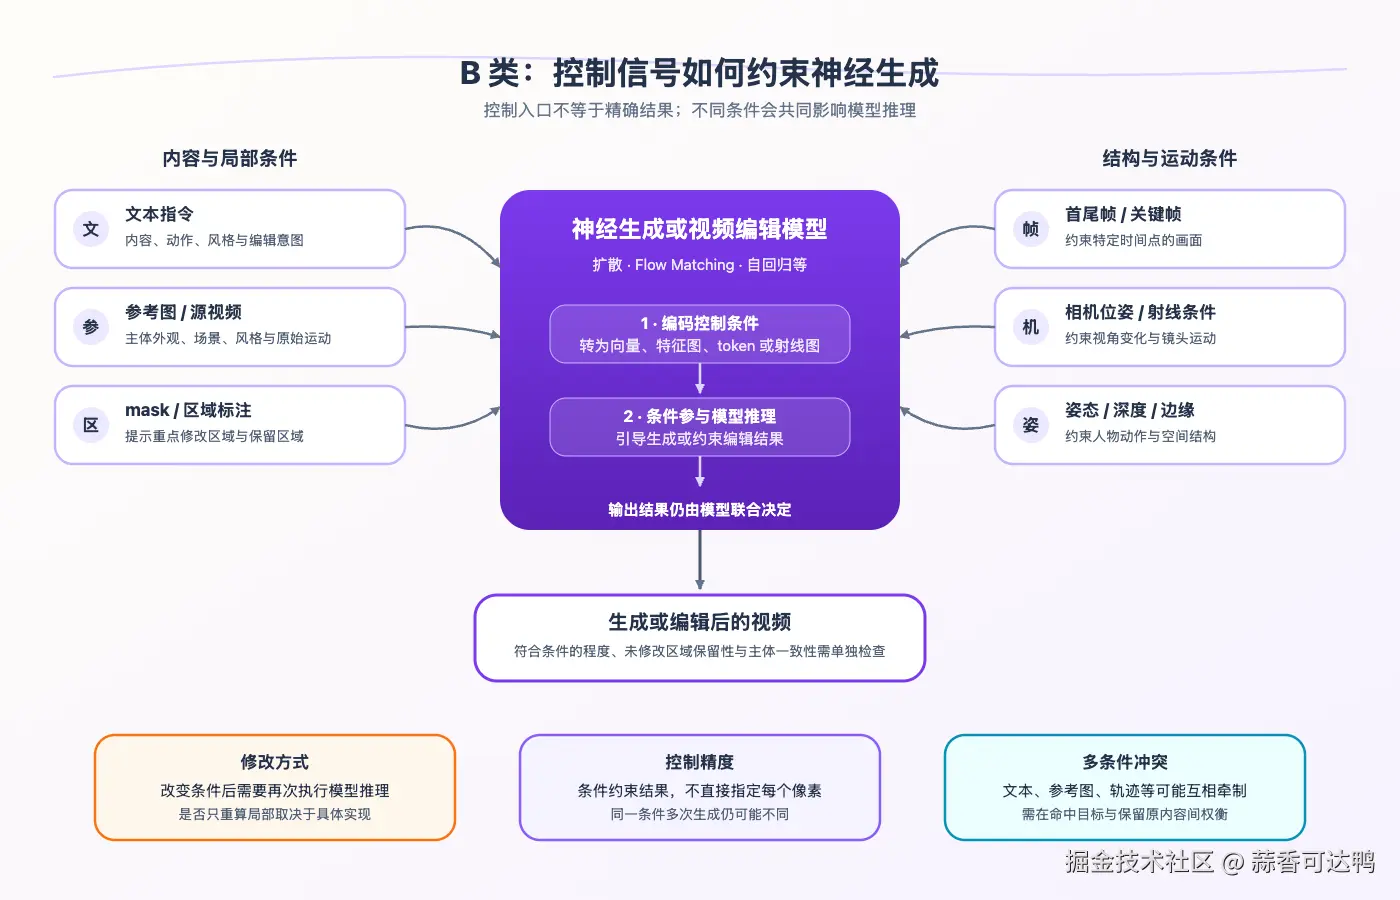
区域/主体控制------指定哪块区域、哪个主体怎么变。
- Runway Gen-4 motion brush:框选区域、指定运动方向/幅度,把 region 控制做成 GUI 旋钮;
- Wan / Kling region-mask 视频编辑:region-aware mask + 通道 concat 注入参考主体,做商品替换/植入;
- VideoAnydoor / VACE(学术线):参考主体注入,VACE(ICCV 2025)把这个接口形式化成统一 context。
在显式 mask 编辑中,模型接收原视频、参考内容和标注目标区域的 mask,再生成修改后的结果。mask 用来指示重点修改区域,并约束其他区域尽量保持原样;具体方法可能在潜空间施加保留约束,也可能对完整视频执行条件生成,不能仅根据"局部编辑"的产品表述判断其内部只计算 mask 区域。mask 不准确时,边缘区域更容易出现接缝、形变或时序不一致。
相机轨迹控制------指定镜头怎么动,2026 最活跃的方向之一。
- Runway Gen-4 camera controls:产品化的推拉摇移;
- PartiCam(arXiv 2609.39504):reward guidance 做相机可控生成;
- CameraSquad:多轨迹相机控制下保持内容一致性;
- SymphoMotion(CVPR 2026):相机运动与物体动态联合控制。
相机轨迹通常由逐帧位姿描述,例如旋转矩阵与平移向量组成的外参序列。不同方法会采用不同的条件编码:MotionCtrl 直接编码逐帧位姿;CameraCtrl 则结合相机内参和外参,为每个像素计算成像射线,并构造 Plücker 射线图。后者是由相机参数派生出的空间条件,不是相机位姿本身。模型利用这些条件生成符合目标机位变化的视频,但仍可能在视角切换或往返运动时改变场景结构与物体细节。
关键帧控制------指定某几帧长什么样,中间由模型补间。Luma Dream Machine / Ray2 keyframes(首尾或多关键帧)、Pika(Pikaframes 关键帧 + Pikaffects 物体特效)。
姿态/深度控制------用 ControlNet 类条件(骨架姿态、深度图、边缘)约束生成,多用于人物/动作对齐。
4.3 接口演进
2025--2026 可控性的演进集中在控制信号的接口,三步:
入口统一到"通道 concat + region-aware mask"。 把外部素材喂进模型(reference injection)的做法一度很多:cross-attention、adapter(IP-Adapter 一类)、textual inversion。2025--2026 收敛到最朴素的一种------参考图用与待生成视频同一个 VAE 编码成同形状潜变量,与带噪潜变量在通道维度拼起来进模型,再附一张 region-aware mask 标明条件作用于哪个时空区域。VACE 把这个接口形式化成统一 context,一个模型通吃生成、补全、编辑。能收敛是因为 DiT 的输入本来就是 patch 序列,能编码成时空对齐张量的条件都可以变成"多拼几个通道的 token",不必像 U-Net 时代复制 ControlNet 旁路或为每种条件训一个 adapter。代价是模型要从数据里学会怎么用这些多出来的通道,训练数据成为护城河。
定位权从人转给模型(mask-based → mask-free)。 上一步的 mask 要人提供,替换商品先得有商品在每帧里的分割 mask,这是极费人力、易出错的一步。mask-free 只给参考图和指令,模型靠注意力或可学习定位模块自己找目标区域(OmniInsert,arXiv 2509.17627;LoVoRA,arXiv 2512.02933)。这是取舍不是单边升级:mask 是人指定的显式把手,mask-free 是模型猜,猜错时没有显式把手可纠。
竞争轴从架构转向数据与评测。 接口收敛后,主流路线的架构差异在缩小(多为 DiT + 通道 concat),拉开差距的是"视频-控制信号"配对数据的质量与规模,以及谁能度量"控得准不准"。同期(2026)针对生成质量的电商视频评测基准开始出现(EVBench 等),与这一重心转移是同一趋势下的并行现象。
4.4 边界与相邻方向
B 的客观能力边界:在三条路线里,生成未实拍主体/场景(想象环境、人物模特)的真实感镜头主要靠它,单模型端到端;代价是像素级不完全可控、改一处可能牵连别处、精确对齐弱。(C 的前馈重建变体也能生成未实拍几何,但保真性弱于实拍重建,见第五章。)
有一类相邻方向处在 B 的边界外延:交互式世界模型(Genie 3、GameNGen、NVIDIA Cosmos)。它的生成机制属于 B 家族(神经网络生成),但控制信号是实时用户动作输入流,输出是一个可交互的世界而非一条固定视频。它的"可控"是实时操纵,和 B 讲的"创作期注入约束(region/相机/关键帧)"是两个不同的控制轴,是否算入"可控视频生成"取决于定义。
五、类别 C:3D 重建与渲染------先重建场景,再控制相机
C 类先从真实对象或场景的多视角图像中恢复三维表示,再按照给定的相机轨迹渲染视频。最终画面来自同一份三维表示的投影与合成,而不是由视频生成模型逐帧采样。常见的三维表示包括带纹理网格、NeRF 和 3D Gaussian Splatting(3DGS);Luma AI、Polycam、KIRI Engine 等工具都提供了从拍摄素材构建三维资产的能力。
生成一条视频通常需要四步:
- 采集素材:围绕对象或场景拍摄多视角照片或视频,使相邻视角保留足够重叠;
- 恢复三维表示:先估计各视角的相机参数,再重建几何与外观。网格、NeRF 和 3DGS 的表示方式不同,但都会形成一份可重复使用的场景资产;
- 定义镜头:设置相机的位置、朝向、焦距和运动轨迹,并确定视频时长与帧率;
- 渲染与编码 :从每个目标视角渲染画面,再将帧序列编码成视频。
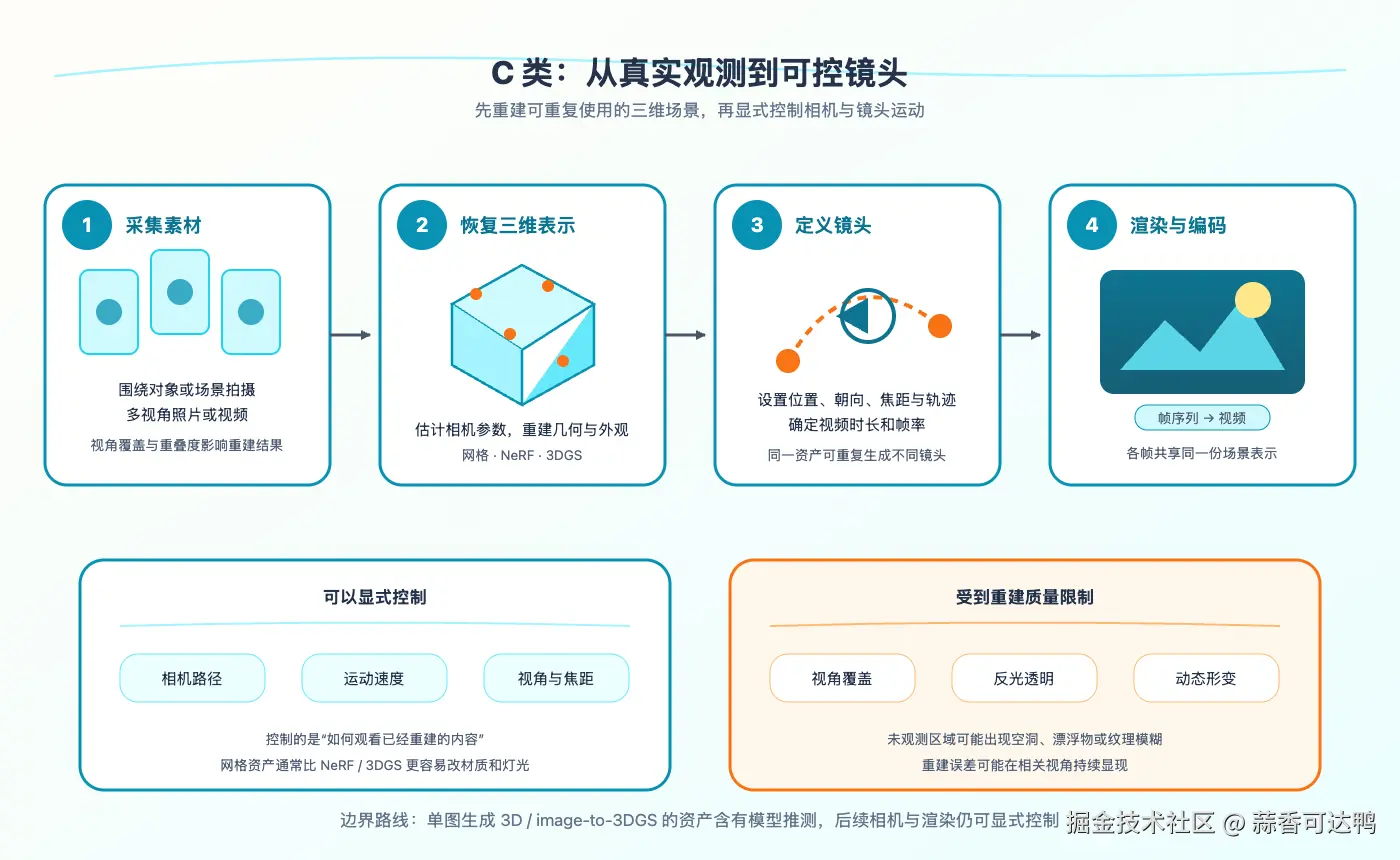
C 类主要控制"如何观看已经重建的内容"。相机路径、速度和焦距可以显式设置,同一份资产也可以重复渲染不同镜头。由于各帧共享同一份三维表示,主体结构和空间关系通常比逐帧生成更稳定。但重建本身会引入误差:采集视角不足时可能出现空洞、漂浮物或纹理模糊;反光、透明、纯色和细长结构也更难恢复;当相机移动到采集范围之外,模型可能无法还原从未观测到的区域。因此,C 类的内容上限首先取决于采集覆盖和重建质量。
A-3 与 C 都先准备可重复使用的三维场景表示,再控制相机进行渲染,区别在于场景资产的来源。A-3 的几何、材质和动画通常由人工制作、程序生成或资产库提供;C 类则从真实对象或场景的观测数据中重建。重建完成后,这些资产也可以进入程序化渲染流程。可编辑程度取决于资产形式:网格通常便于修改几何、材质和灯光;NeRF 与 3DGS 往往将拍摄时的外观和光照编码进表示中,重新打光或改变材质需要额外方法。
单图生成 3D 或 image-to-3DGS 处在 B 与 C 的交界。它们由神经网络推测未观测到的几何和纹理,再从生成的三维表示渲染视频。后续的相机和渲染过程可以显式控制,但资产本身包含生成结果,不能直接继承多视角实拍重建的保真边界。
六、小结与待解决问题
三类路线控制的对象不同。A 类控制代码、时间线和场景参数,由渲染器据此计算画面;B 类用文本、参考素材、区域、轨迹等条件约束生成结果;C 类先重建三维场景,再控制观察视角和镜头运动。因此,判断一项视频生成能力是否"可控",不能只看它是否提供某个控制入口,还要看控制对象是什么、能精确到什么粒度、一次修改会影响多大范围,以及相同条件下结果是否稳定。
目前仍有几类问题没有得到充分解决:
- 控制质量缺少完整的评测口径:现有视频生成评测通常关注画质、文本一致性和时序稳定性。评估可控性还需要测量轨迹误差、编辑目标命中率、未编辑区域的保留程度、主体身份漂移和多次生成的结果波动,这些指标尚未形成统一组合。
- A 类中间态的自动生成仍需验证:coding agent 可以生成代码、时间线 JSON 和三维场景脚本,但生成结果是否符合镜头意图,能否通过接口、素材、时间计算和渲染性能检查,仍需要静态校验、渲染测试和人工审核。
- B 类的局部修改与多条件控制仍不稳定:以源视频为条件的编辑可以减少未修改内容的变化,但局部编辑不等于只计算局部区域。文本、参考图、mask、相机轨迹和关键帧同时使用时还可能互相冲突,模型需要在修改目标、背景保留、主体一致性和运动连贯之间权衡。
- C 类的上限受采集和重建质量约束:动态、反光、透明和细长物体仍难稳定重建;未覆盖视角容易暴露缺失内容;NeRF 与 3DGS 的重新打光、材质编辑和动态场景表示也需要额外方法。
三类路线对"可控"的定义并不相同:A 类把控制落实为可修改的中间态,B 类把控制转化为生成条件,C 类把控制集中在重建资产和相机参数上。它们分别处理视频描述、生成约束和三维观察三个层面的控制问题。
参考来源
类别 A
- Claude Opus 确定性渲染管线(Playwright + ffmpeg +
seek(t)契约):dev.to《How to Make Videos with Claude Opus: A Deterministic Render Pipeline》 - Codex + Blender(YAML/Python 真相源、acceptance.yaml、有界纠错循环):github.com/danielsobrado/Codex-and-Blender
- Remotion:github.com/remotion-dev/remotion
- A-2 渲染引擎内部(五级流水线):开源 Shotstack 兼容引擎 github.com/james3124/cutengine
- 云端 JSON API(Shotstack / Creatomate / JSON2Video):wireflow.ai《Best Video API for Coding Agents Tools in 2026》
类别 B
- Runway Gen-4(camera controls / motion brush / keyframes):多篇 2026 横评交叉确认
- 相机轨迹控制:PartiCam(arXiv 2609.39504)、CameraSquad、SymphoMotion(CVPR 2026)
- 参考注入与统一接口:VideoAnydoor(SIGGRAPH 2025)、VACE(ICCV 2025)
- mask-free:OmniInsert(arXiv 2509.17627)、LoVoRA(arXiv 2512.02933)
- 扩散 vs 自回归融合:Flex-Forcing(arXiv 2607.03509)、Lumos-1(ICLR 2026)
- 交互式世界模型:Genie 3、GameNGen、NVIDIA Cosmos
类别 C
- 3DGS 与 glTF 标准化:Khronos《glTF Gaussian Splatting Extension》(2026-02)
- 3DGS 技术源头:SIGGRAPH 2023(Inria)
评测基准
- EVBench:电商场景视频生成模型综合评测(ACM DOI 10.1145/3830242,2026)
- E-VAds:电商短视频"理解"基准(面向 MLLM,非生成侧评测;ICML 2026,arXiv 2602.08355)