目录
-
- 前言
- [1. 本期内容概览](#1. 本期内容概览)
- [2. 项目定位与代码风格](#2. 项目定位与代码风格)
- [3. 环境搭建与调试配置](#3. 环境搭建与调试配置)
- [4. API server:在线推理入口](#4. API server:在线推理入口)
- [5. ZMQ:前台与后台的通信骨架](#5. ZMQ:前台与后台的通信骨架)
- [6. 三大后台组件:各自的入口与出口](#6. 三大后台组件:各自的入口与出口)
- [7. Scheduler 核心实现](#7. Scheduler 核心实现)
-
- [7.1 调度主循环:prefill 优先与统一的 ForwardInput](#7.1 调度主循环:prefill 优先与统一的 ForwardInput)
- [7.2 chunked prefill](#7.2 chunked prefill)
- [7.3 overlap loop](#7.3 overlap loop)
- 结语
- 参考
前言
前几期文章我们做了 nano-vllm 的深度解读分析,最近 Koala 博主又发布了 mini-sglang 的拆解视频,一起来学习下,记录下个人学习笔记,和大家一起分析交流 😄。
1. 本期内容概览
与 nano-vllm 类似,mini-sglang 是对流行开源引擎 SGLang 的最小化实现。
我们将分上下两集深度解读,对比它与 vLLM 设计上的一些关键差异。
在之前的内容里,我们已经发布过上下两期文章,对 nano-vllm 这个项目做了解读,感兴趣的同学可以看看:
那个项目是对流行的开源引擎 vLLM 的核心架构做了一个极简版的实现,大概是 1200 行的代码,那在 SGLang 的社区里边呢,也有类似的项目叫做 mini-sglang,它就是对流行的开源引擎 SGLang 的一个最小化的实现。
那在这个系列的内容里边,我们也将分为上下两集来对 mini-sglang 做一个深度的解读,那因为我们之前已经介绍过 nano-vllm,所以在解读的时候我们会重点去对比这个 SGLang 和 vLLM 设计上的一些关键的差异,而它们之间相似的逻辑,我们可能就会简略的提一下,我们这次的核心就是看它们不一样的地方。
本期是 mini-sglang 深度拆解的上集,重点解析 SGLang 的整体架构与调度逻辑。通过与 nano-vllm 对比,带你理解 API Server、Tokenizer、Scheduler、Detokenizer 等组件如何借助 ZMQ 协同工作,并深入讲解 Chunked Prefill 如何避免长请求独占 GPU,以及 Overlap Loop 如何重叠 CPU 与 GPU 负载、提升推理效率。下集将继续拆解其核心的 Radix Cache。
在正式开始之前,还是先把这一次的整体目标和上集大纲给大家看一下:
- mini-sglang 简介
- 项目定位
- 与 nano-vllm 的差异
- 上下两集内容拆分
- 整体架构与调度逻辑
- Radix Cache 内部细节
- 上集:整体架构与调度逻辑
- 隐去与 vLLM 相似的细节
- 模型运行逻辑(engine,与 vLLM model runner 类似)
- TP 实现
- API server:在线推理入口
- ZMQ:核心通信逻辑
- Backend 组件拆分:tokenizer、scheduler、detokenizer
- scheduler 核心实现
- chunked prefill
- overlap loop
- 隐去与 vLLM 相似的细节
那 mini-sglang 这个项目呢,我们首先会来看一下它项目的一个定位,也包括核心作者的一些信息。那之后就是刚刚提到的,它和 nano-vllm 的差异大致体现在哪些地方。
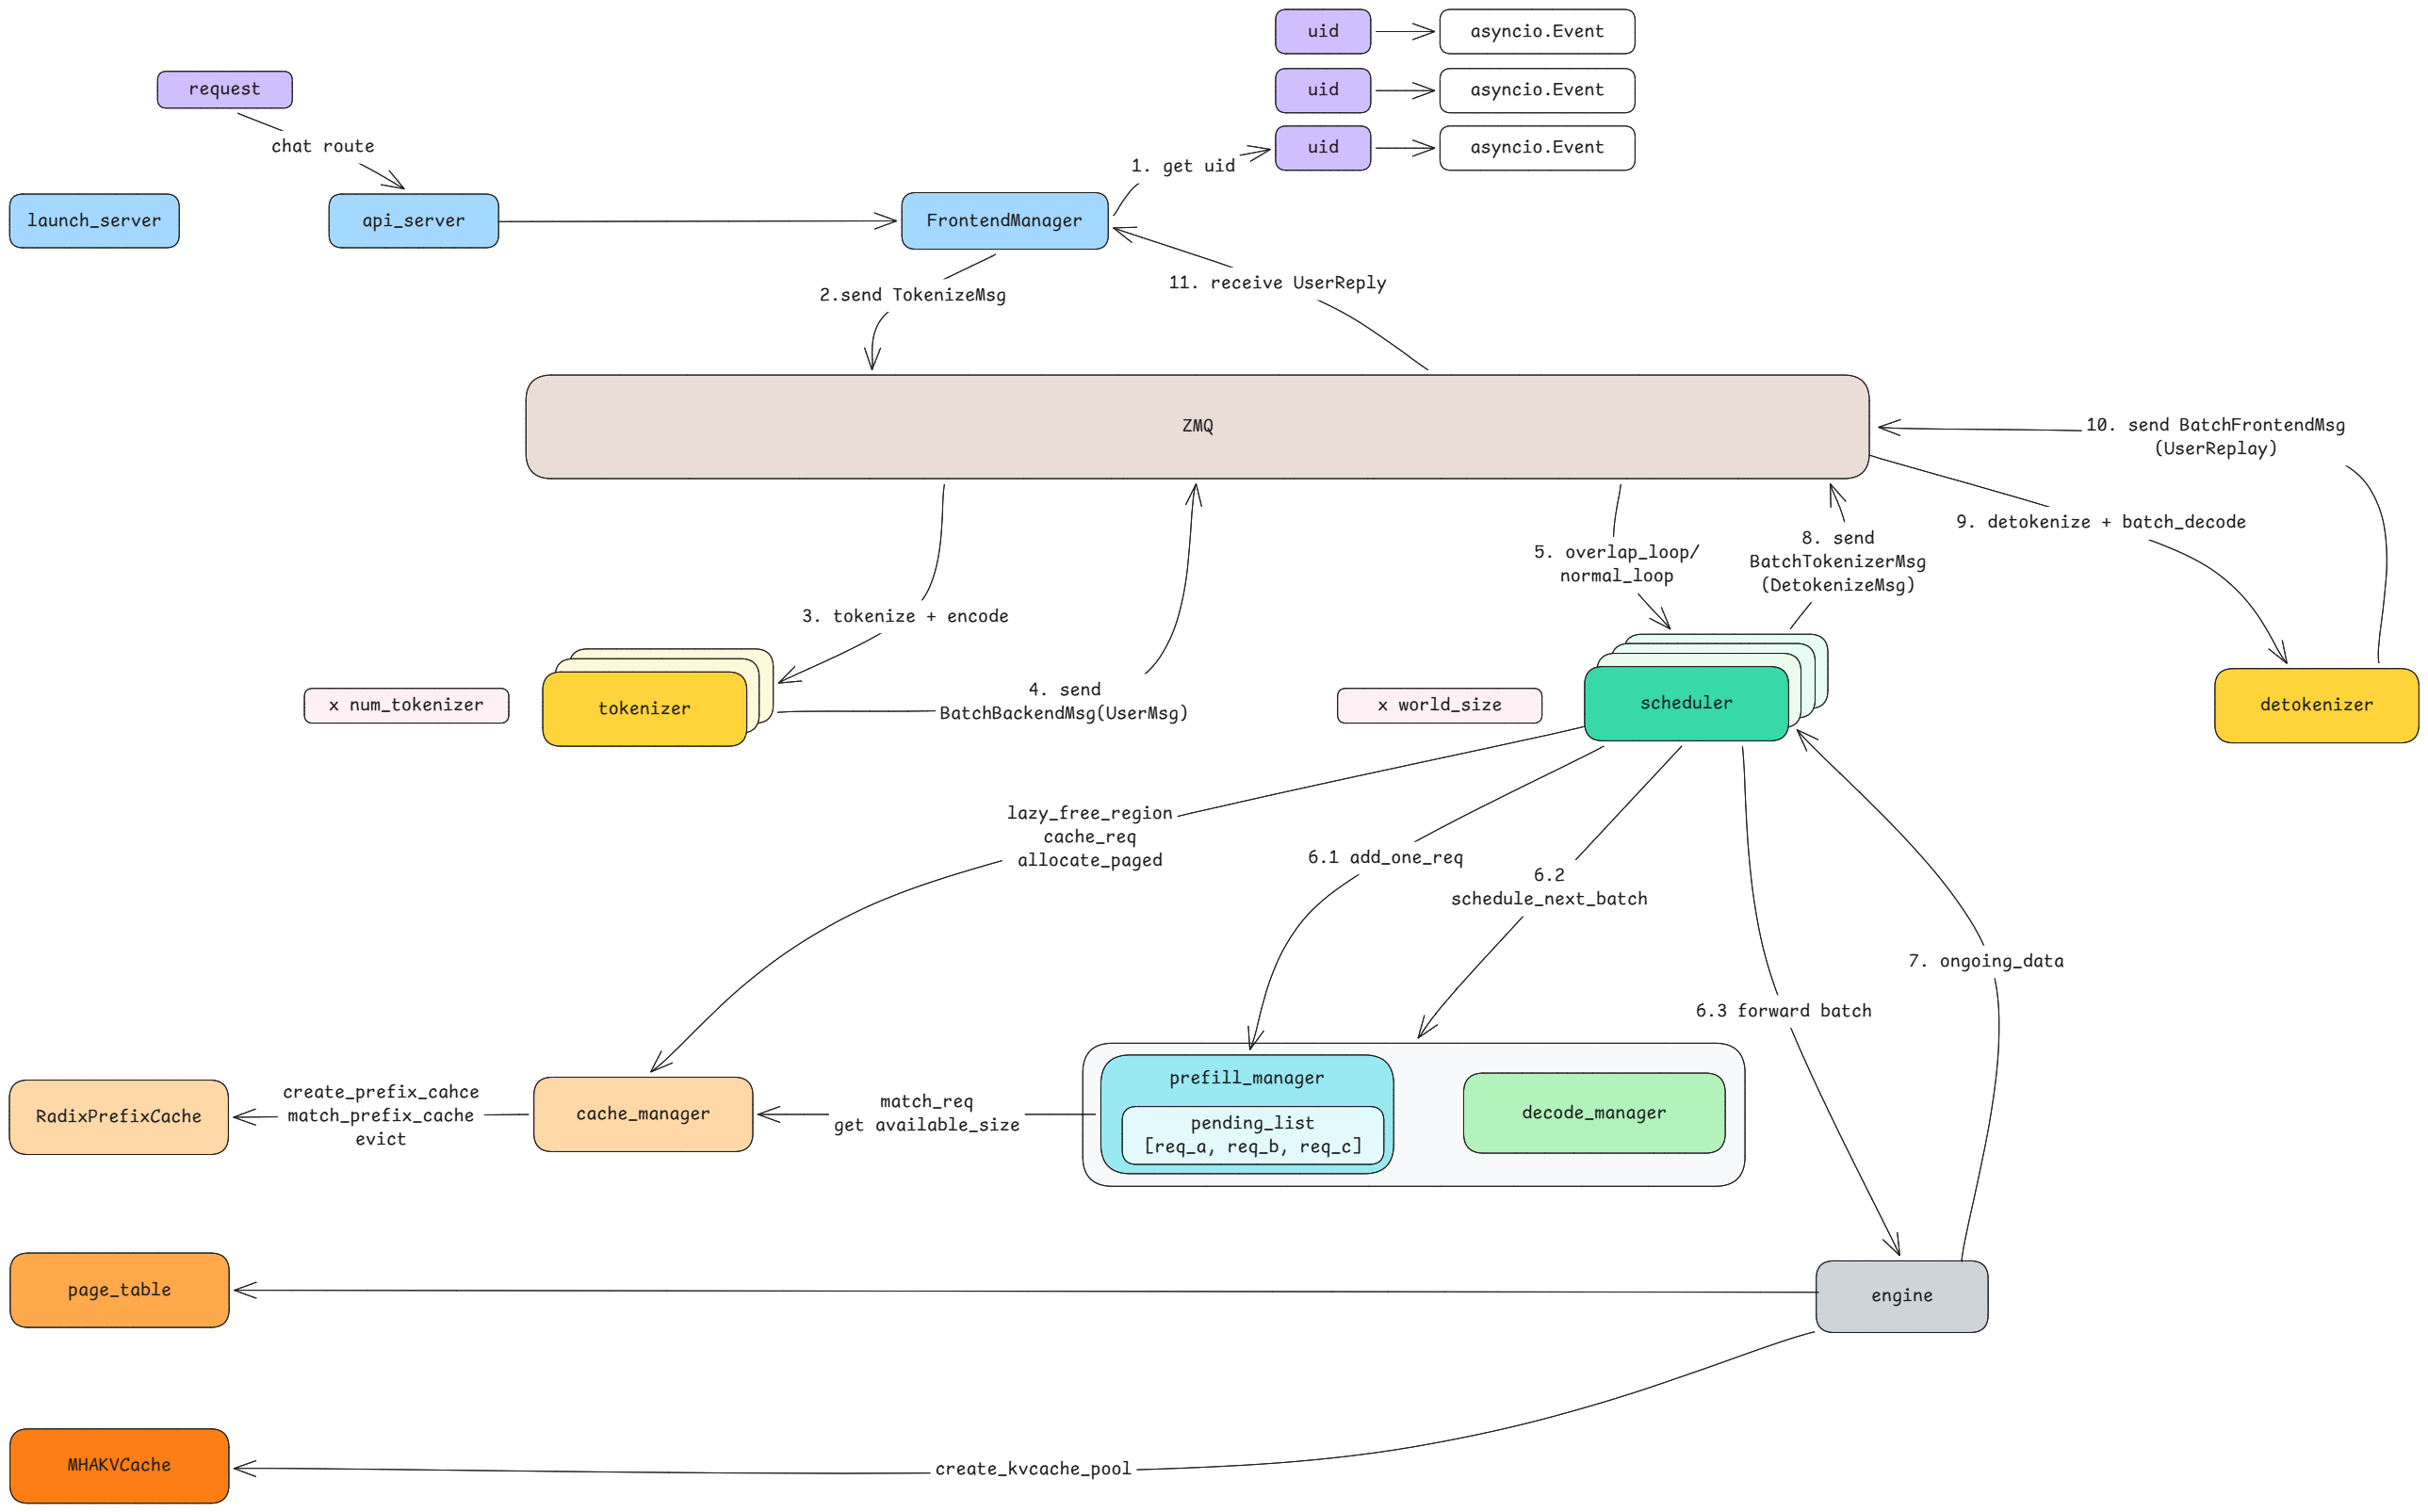
上下两集呢,我们也做了一个内容的拆分,在上集,我们会比较关注下面的这张图所对应的 SGLang 它整体的一个架构和调度的逻辑,而在下集,我们会把里边的 KV Cache 的核心逻辑去讲一下。
因为在 KV Cache 的数据结构设计上 SGLang 和 vLLM 一直是有一个比较大的差异的,vLLM 使用的是以块为单位,也就是 block 为单位的这样的一个管理逻辑,而 SGLang 一直都使用的是一个类似于树状的结构,他们把它称之为 Radix Cache,也就是一个前缀树匹配这样的一个 cache 的设计,看起来会更加的精巧有意思一点,所以我们在下集会重点去展开 Radix Cache 的内部细节。
那在上集的部分我们刚刚提到我们关注的是整体的架构与调度逻辑,那我们在这里边会隐去哪些内容呢,首先我们会隐去跟 vLLM 相似的模型的运行逻辑,因为在 nano-vllm 那期内容里边,其实我们就比较明确地拆解过:一个模型是怎么被运行起来的、GPU 上的数据面逻辑长什么样。
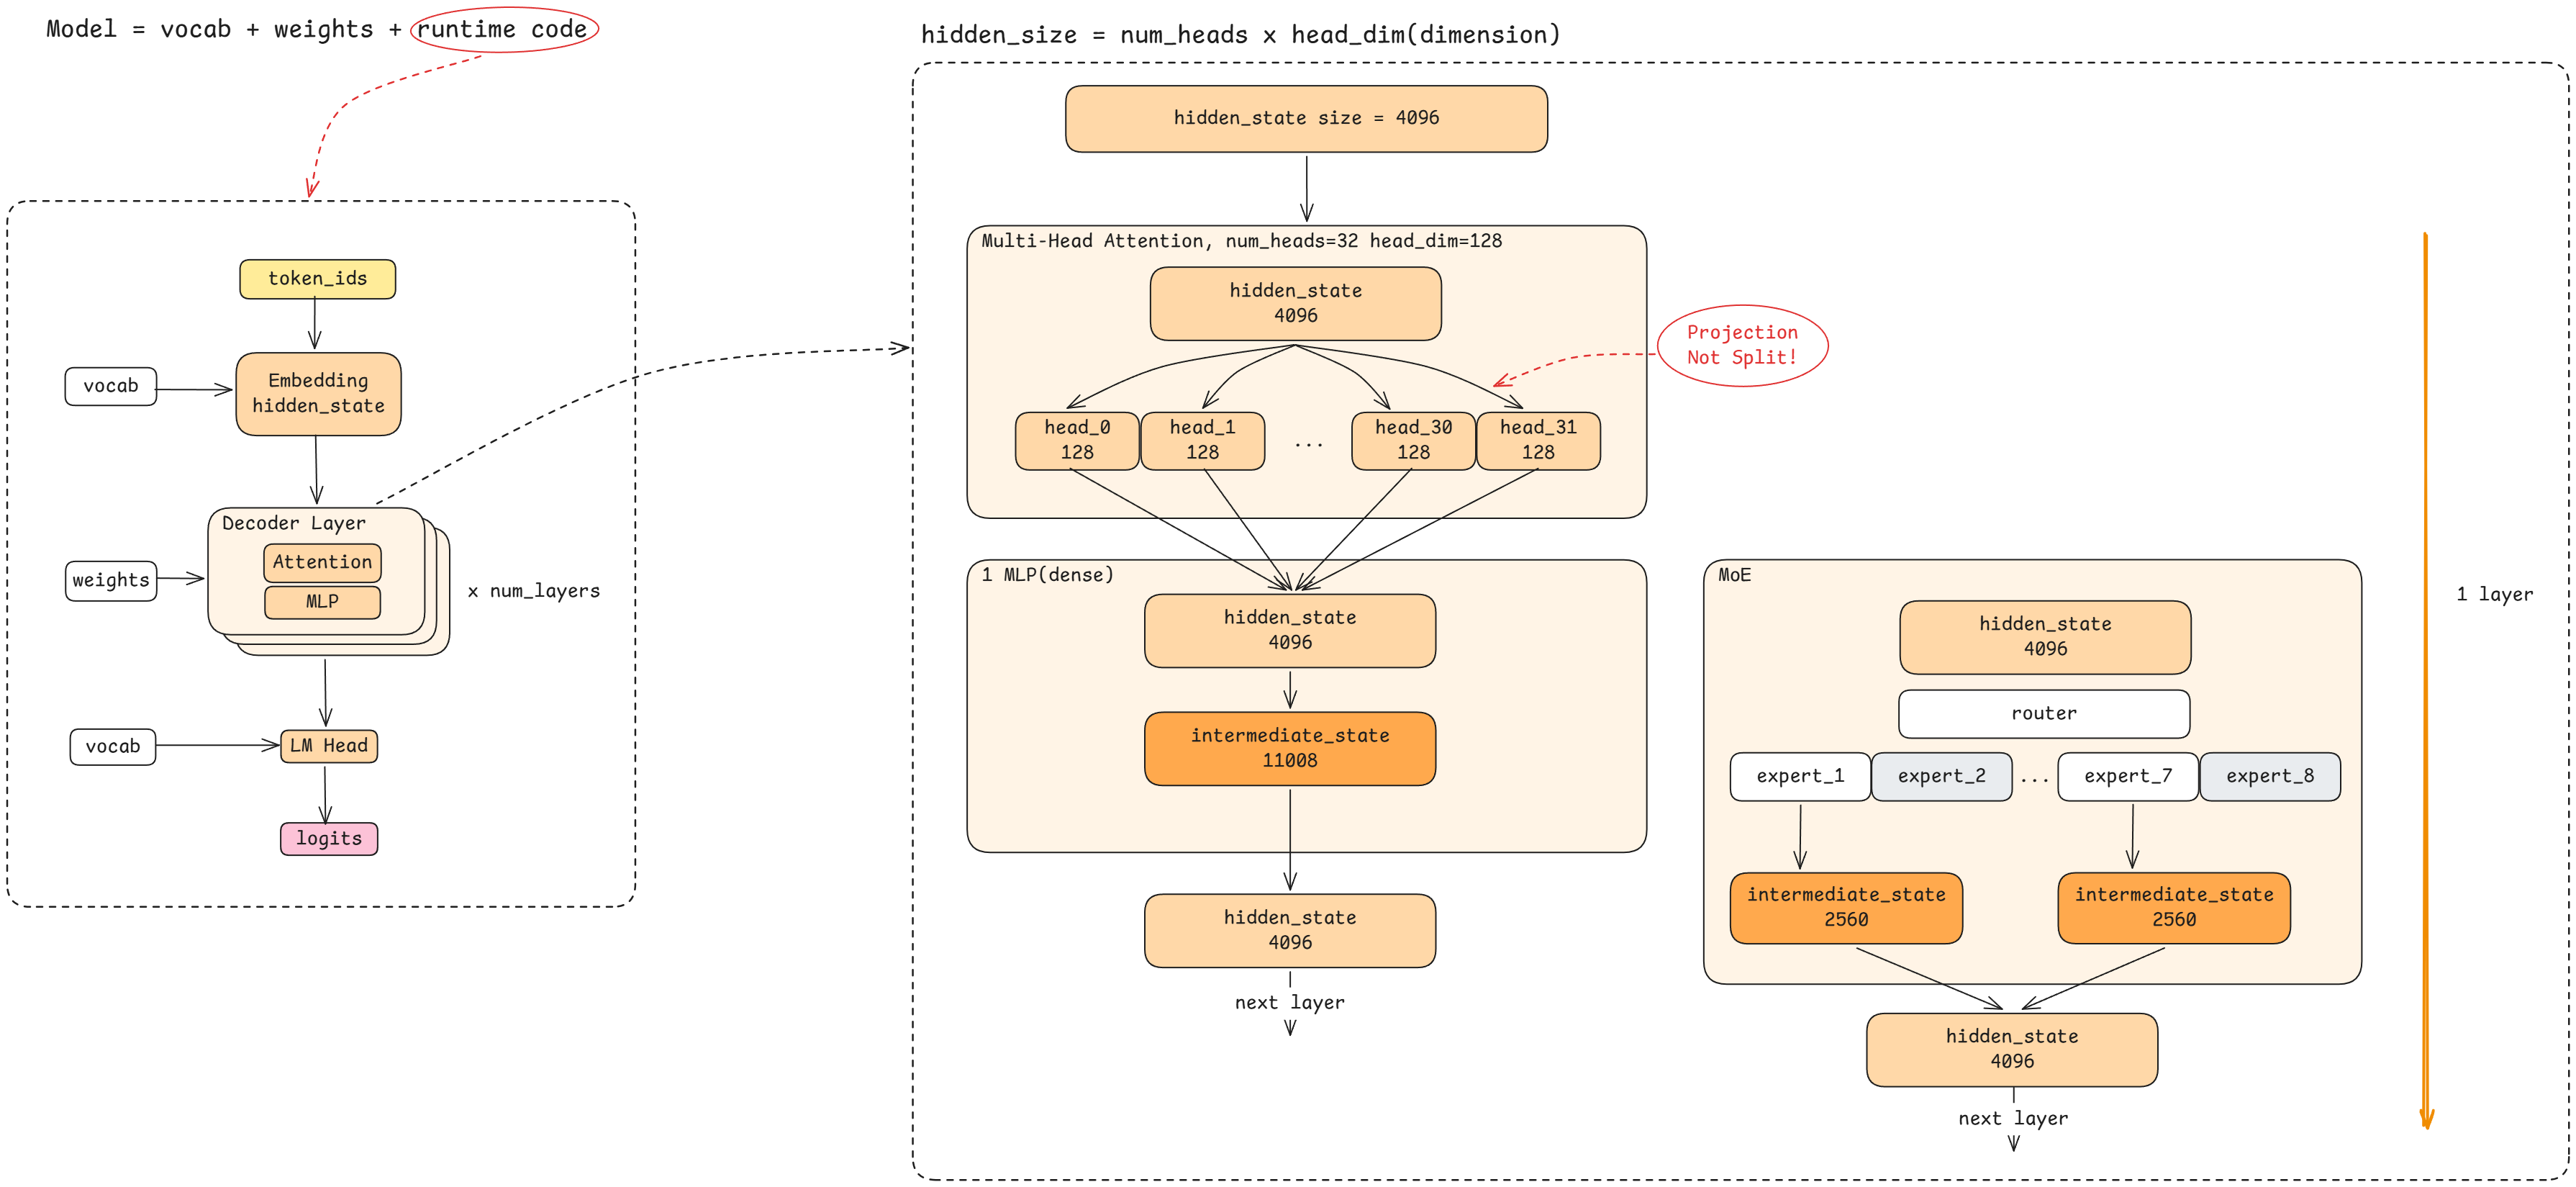
上图就是之前 nano-vllm 那一期对模型运行的拆解,所以这一次呢,我们看到在 SGLang 的实现里边,它虽然代码风格、组织方式不一样,但是核心的逻辑是比较类似的,所以在这里我们就不会对它进行一个展开。
对应的在整个架构的分析上呢,我们只把引擎里负责模型运行的那部分 --- 注意不是整个引擎,而是它 GPU 上的数据面逻辑 --- 包装成一个小的黑盒子,让大家看到有这样的一个组件就可以了,不对它做展开。
第二个呢,就是一个 TP 也就是 tensor parallel 的一个实现,因为我们在 SGLang 里边,你也会看到,它会根据 TP 并行的数量切分出 N 个 scheduler,然后它们之间再做通信,把内容回收到 rank 0 上边,再一起返回。
那整个 TP 的拆分细节,首先它不是特别的复杂,其次呢,它的整体逻辑也跟 vLLM 是相类似的,至于更复杂的并行策略,其实 mini-sglang 里并没有实现;而它的 TP 实现本身也比较常规,这里就不再展开了。
那我们会比较重点展开的是什么呢?我们展开的就是首先是它跟 nano-vllm 的一个最大的差异,在 nano-vllm 里边,虽然它也是一个推理引擎的精简实现,但是它只实现了离线推理的部分,所谓的离线推理,就是通过一个 Python 函数比如说 generate() 去实现一次推理的逻辑。
但是我们也知道,在现实生活中,绝大多数时候我们使用推理服务的时候,它都是一个在线的服务,所以 mini-sglang 很好的补齐了这一点,它有一个 API server 的架构,然后在这里就是整个在线推理的入口,这是它跟 nano-vllm 的第一个差异。
第二个差异,就是在 nano-vllm 的实现中,其实很多时候都是依赖于进程和子进程之间的这种管理关系和通信方式的,而 mini-sglang 在实现的时候,它也跟它的真正的主项目 SGLang 一样是用了一个进程拆分的一个模式,在它的整个进程架构上,就会有很清晰的几个进程。
首先有前台的 API server,其次呢就是后台的三个主要的进程组,一个是 tokenizer,另一个是 scheduler,还有一个就是把生成的 token 重新解码成文本的 detokenizer,这三大组件。我们说的是组件而不是进程,是因为每一个组件,它还可能起多个副本,就对应到多个进程去做负载均衡或者是并行这样的一个逻辑。
好,那进程和进程之间,因为不是简单的这种父子关系了,所以它们之间就存在一个更为完整的通信的需求,那在 mini-sglang 和真正的 SGLang 里边呢,两者使用的都是 ZeroMQ --- 一个轻量级的消息队列组件,下面我们统一简称为 ZMQ。
而且实际上在代码的组织上,我们会看到 ZMQ 给代码组织带来的简化和清晰效果非常明显,因为在整个代码的定义中就定义了多个 ZMQ 传递的数据类型,顺着消息类型,我们很容易看出这条消息由哪个组件处理、由哪个组件消费,所以它这样的一个逻辑拆分,在阅读它代码的时候呢,感受还是非常好的。
所以在宏观上可以看到,刚刚说到的一个前台组件和三个后台组件,它们之间都是通过一个这样的一个轻量级的消息队列来做通信。那在后端组件里边,我们刚才提到它会有三个拆分,分别是 tokenizer、scheduler 和 detokenizer,后面我们就会来讲一下它具体的一个职责和作用。
那在 scheduler 里边,除了常规的一个完整推理请求的后台逻辑我们会一起走一遍之外,我们还会对两个重点的实现做一个详细的分析。
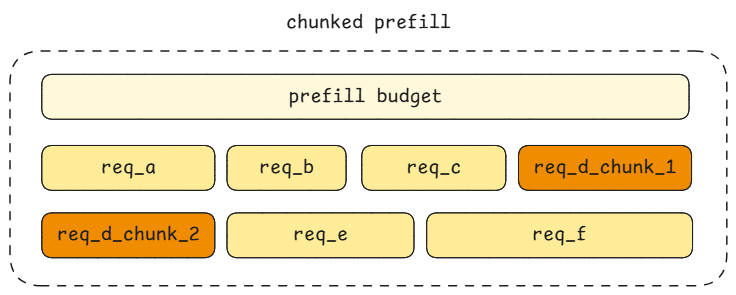
第一个就是叫做 chunked prefill,那这个机制呢,是把一些巨型的请求的前缀的 prefill 阶段做了一个优化,那它的工程价值是什么,它怎么来避免过于庞大的这个 prefill 去占据整个推理的资源,然后怎么样带来一些这个更高级的编排策略的入口,这个是我们会去讲一下的。
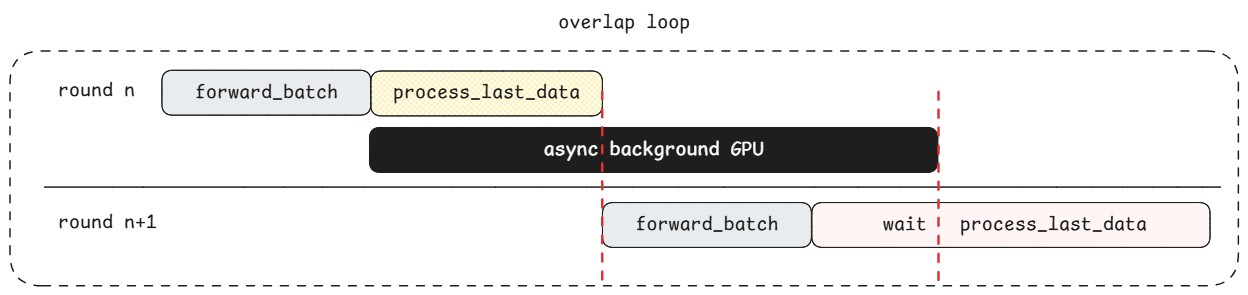
第二个,就是在 SGLang 的这个 scheduler 里边有一个比较有意思的策略,叫做 overlap loop,那这个策略呢,它能够比较好地堆叠 GPU 和 CPU 上的负载,从而带来潜在的性能提升,那它的设计也是比较精巧的,所以我们也会对它的 overlap loop 去做一个分析。
这就是我们整个上集内容的一个大纲。
2. 项目定位与代码风格
回到项目定位的部分,那它的项目定位跟 nano-vllm 略有区别,我们之前也介绍过,nano-vllm 这个项目本质上它是一个社区的项目,当时我们也一起看过那个项目的作者的背景,它的作者是 DeepSeek 的一位工程师。
而 mini-sglang 这个项目,它是直接维护在了 SGLang 的官方的这个代码组织下面的,所以它可以被理解为是一个官方的项目。
而这个项目的作者,也就是 GitHub 上看到的这位研发工程师,他实际上也一直在 SGLang 项目里持续投入,而且比较有意思的一点是,我们看到他的这个有自己的博客网站,然后在这里他也在一篇博客里边写到了他在 mini-sglang 这个项目的一个开端。
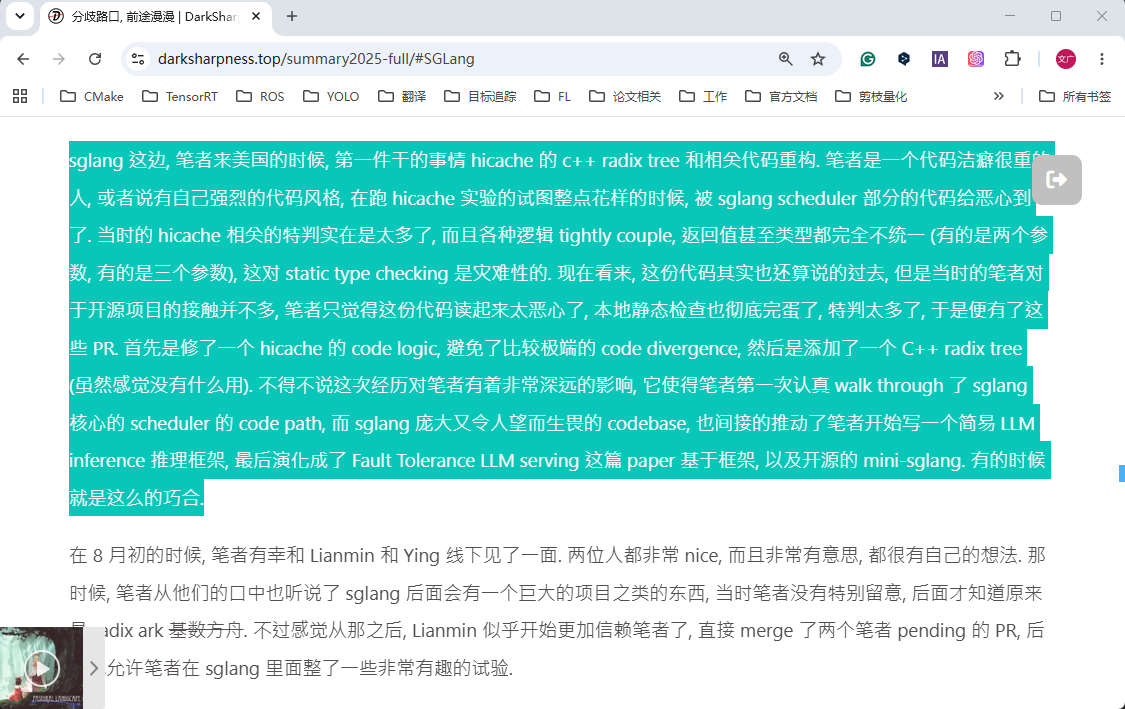
他当时去到美国,然后开始做 SGLang 的相关的一些工作,然后他就发现现代 SGLang 的代码实在是太复杂了,然后里边有各种非常耦合的代码,而且非常的庞大,我们之所以要花点时间看一下这个作者博客里的片段,是因为他描述的感受,和我实际阅读 mini-sglang 这个项目代码时的感受是非常一致的。
他在自己的博客里边写,说他是一个代码洁癖很重的人,觉得主线仓库里的代码看起来比较费劲,于是他非常认真地 work through 了 SGLang 核心的 scheduler 代码路径,最终写了一个简易的 LLM inference 框架,并把它开源成了 mini-sglang --- mini-sglang 这个项目就是这样产生的。
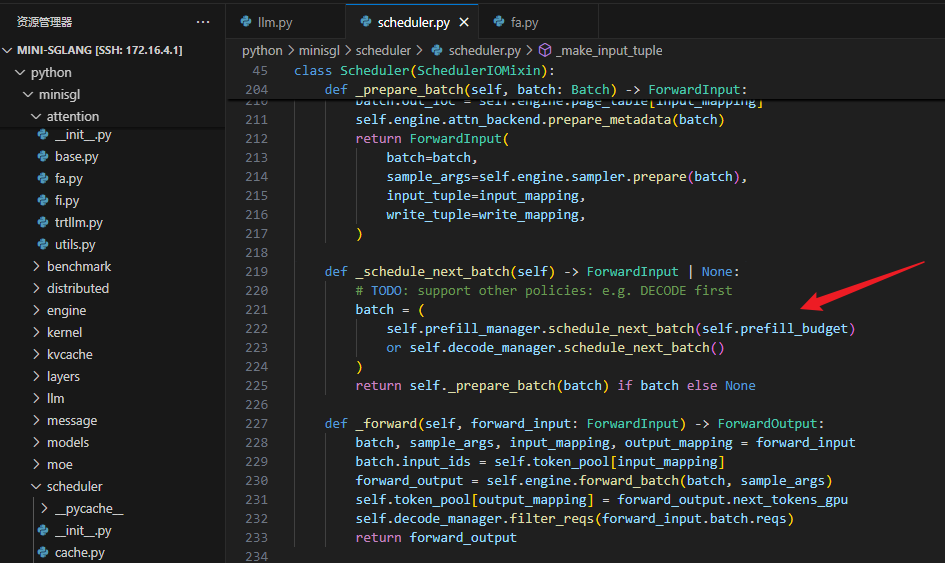
那我们在实际的代码阅读的过程中,也会发现他自己的代码确实有非常鲜明的风格,也很优雅,我们举其中一个非常小的例子,因为我们更多的时候是看它整体的架构实现,但是我们还是可以拿一个几行的代码片段让大家来感受一下。
下面是我在阅读代码的时候看到的一个比较明显的风格化的一个地方,就是它在 scheduler 里边,它是需要去区分这一轮是一个 prefill 还是一个 decode,这个大家应该有所了解,就是现在模型推理的两个核心的步骤。
python
# python/minisgl/scheduler/scheduler.py:L219

class Scheduler(SchedulerIOMixin):

    ...

    def _schedule_next_batch(self) -> ForwardInput | None:
        # TODO: support other policies: e.g. DECODE first
        batch = (
            self.prefill_manager.schedule_next_batch(self.prefill_budget)
            or self.decode_manager.schedule_next_batch()
        )
        return self._prepare_batch(batch) if batch else None
那在这一轮是做 prefill 还是做 decode 呢,在他们的设计里边,这是由 prefill 优先的策略来驱动的,也就是说,如果还有需要 prefill 的内容,那我就优先 prefill,如果 prefill 已经全做完了,我就做 decode,当然它这里也写了一个 TODO: 就是未来可以支持更多的策略,这个在主线仓库里边肯定是有的,比如说是不是 decode 优先,那当前的实现呢,默认就是 prefill 优先。
好,那不管是 prefill 还是 decode,在它的代码实现里边,它都把它在类型上统一了起来,也就是不管下一个 batch 是 prefill 的 batch 还是 decode 的 batch,你返回的东西都是一样的,这样上层的处理就会非常的简洁。
那它不仅在类型上做了一个统一,它还通过返回值让代码看起来非常清晰,因为它的 prefill 优先嘛,所以它就先算 prefill,那 prefill 如果没有要处理的东西,它就会返回一个 None,那当它返回 None 之后,后边这个 or 的操作符自然就转到了去计算 decode 里边的 next batch,然后如果都没有的话,那就说明整体的全都处理完了,就可以结束了。
这几行代码下来,scheduler 的核心判断逻辑,就和我们用自然语言描述出来的策略完全一致:先去调度 prefill,如果没有就调度 decode,它把这段自然语言映射到了一个非常一致的代码结构上。
因为在现在 AI 大量写代码的时代呢,我们在做深度解析的时候已经很少跟大家逐行的来看代码,更多的是看思路,但是这个作者的代码风格,我觉得还是有必要拿这样的一个非常小的片段让大家来感受一下,他对于代码可读性上和简洁性上的一个追求。那大家如果有兴趣的话,可以详细的再去看他的这个代码的原本的实现,还是非常值得学习的。
OK,那除前面两点之外,它们还有一个差异体现在实现的完整度上 --- 在 mini-sglang 的 README 里,它也会讲到自己是一个相对紧凑但也更完整的实现。
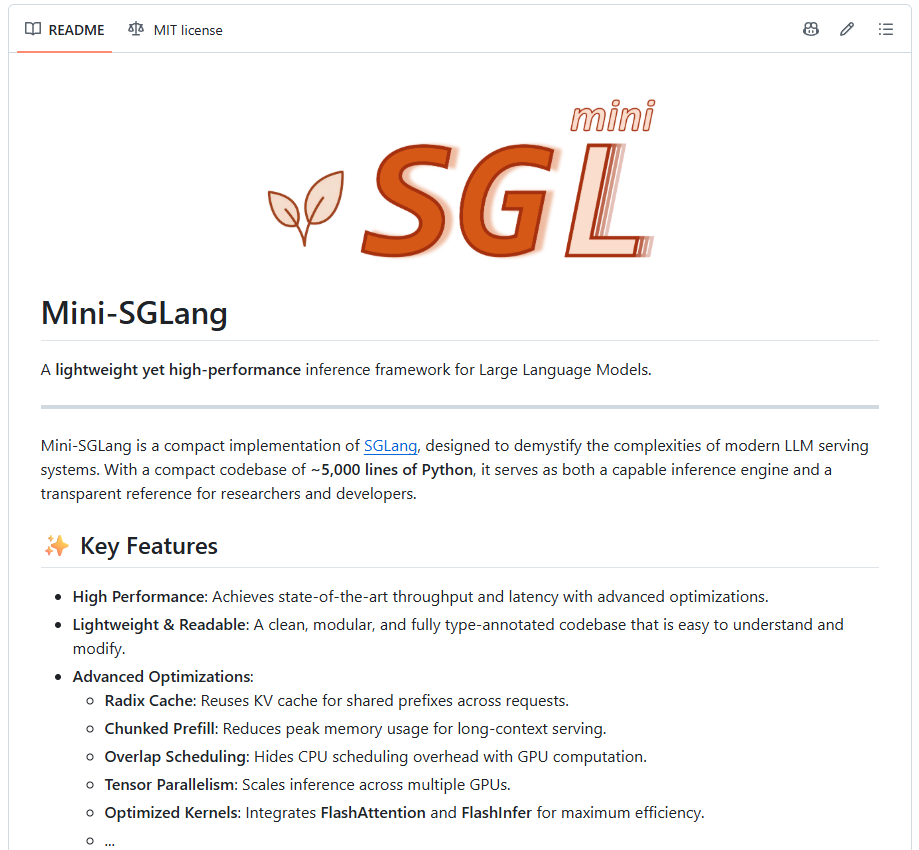
首先它会追求高的性能,所以核心的性能相关的优化它都是做了的,第二个就是它的可读性和轻量级,然后整个项目都用上了类型标注,然后我们刚才也讲到了,其实不仅是类型标注,它在 ZMQ 上的这个消息的传递,也是强类型的,所以非常的可读,很容易追踪到当前的一个执行逻辑的位置。
然后一些关键性的优化,比如说 Radix Cache、Chunked Prefill、Overlap Scheduling、TP 等等,其实也全部都是已经实现了的,其中 Chunked Prefill 和 Overlap Scheduling 会在上集展开,Radix Cache 我们留到下集。
OK,那另一个就是我们刚刚其实提到了 nano-vllm 呢,它是一个只有离线推理的入口的这样的一个逻辑,而 mini-sglang 呢,它是带了在线 API server 的,它倒不是为了差异而差异,而是因为它们整个 SGLang 的真实架构里边,前台和后台就是独立进程,相互之间通过消息队列通信,所以把这一部分做到 mini-sglang 仓库里边也是更合理的,也就自然而然地带上了在线的架构。
那上下两集内容拆分呢我们刚刚其实也讲过了,所以接下来呢我们就会从整体的架构和调度逻辑去具体的开始做我们的解析和讲解了。
3. 环境搭建与调试配置
在正式讲解之前,我们先一起来跟着 mini-sglang 的 README 文档来搭建起整个开发运行环境:
shell
git clone https://github.com/sgl-project/mini-sglang.git
cd mini-sglang && uv venv --python=3.12 && source .venv/bin/activate
uv pip install -e .
运行环境安装好之后就可以执行推理指令了,值得注意的是,mini-sglang 示例中使用的推理模型是 Qwen/Qwen3-0.6B,在代码中会自动从 HuggingFace 下载,但是由于网络不稳定很容易下载失败,因此建议提前下载好到本地。
这里我们使用 ModelScope 平台来下载,指令如下:
shell
cd mini-sglang
pip install -U modelscope
modelscope download --model Qwen/Qwen3-0.6B --local_dir models/Qwen3-0.6B
这里我们将模型下载到本地目录 mini-sglang/models/Qwen3-0.6B 文件夹下,之后推理的时候指定这个目录即可。
mini-sglang 官方提供了 Online Serving 与 Interactive Shell 两种使用方式:
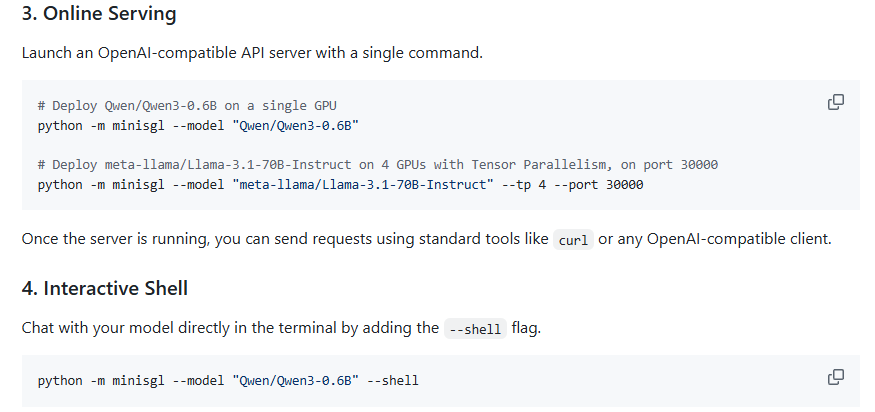
Shell 模式主要用于本地交互与调试,适合快速验证模型效果;而 Online Serving 模式则会启动一个 OpenAI 兼容的 HTTP 推理服务,将模型封装为一个可被外部系统调用的 API 接口。相比之下,Serving 模式更接近真实生产环境,支持多请求并发与系统集成,是推理引擎的核心使用方式。
这两种模式我们都来体验下,我们先来看简单的 Shell 模式,在终端输入如下指令即可:
shell
python -m minisgl --model "models/Qwen3-0.6B" --shellNote:这里的模型路径我们使用刚刚下载好的本地路径即可。
之后它会开启一个终端交互命令窗口,我们直接提问即可,输出如下所示:
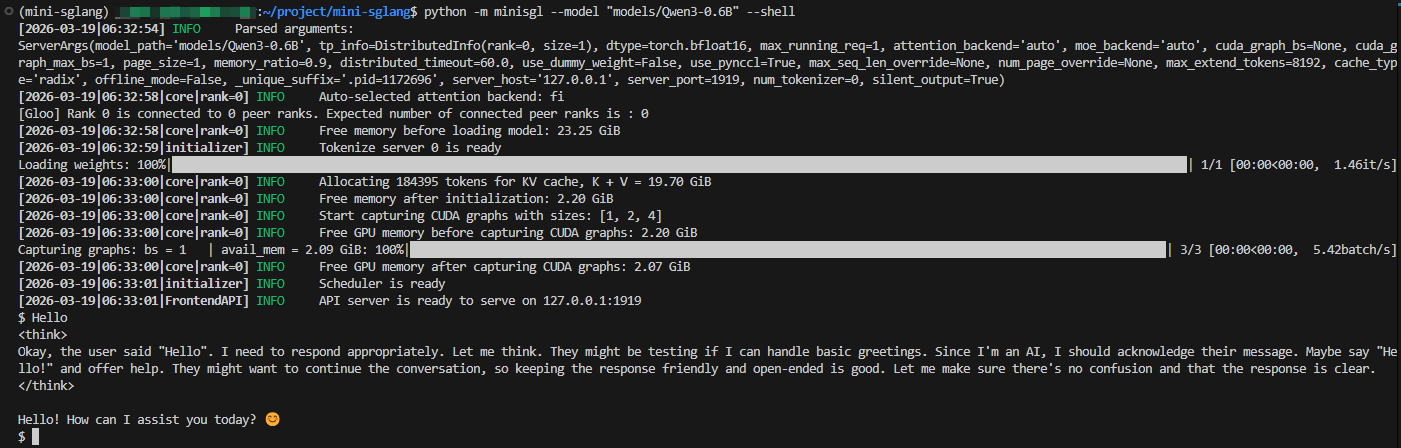
值得注意的是,其终端还支持 /reset 清空当前对话指令和 /exit 退出指令。
我们接着来看下 Online Serving 模式,在终端输入如下指令即可(我们以单 GPU 为例):
shell
python -m minisgl --model "models/Qwen3-0.6B"此时终端会启动一个 mini-sglang 的推理服务,相当于这个服务挂在了后台,所有人都可以请求使用:
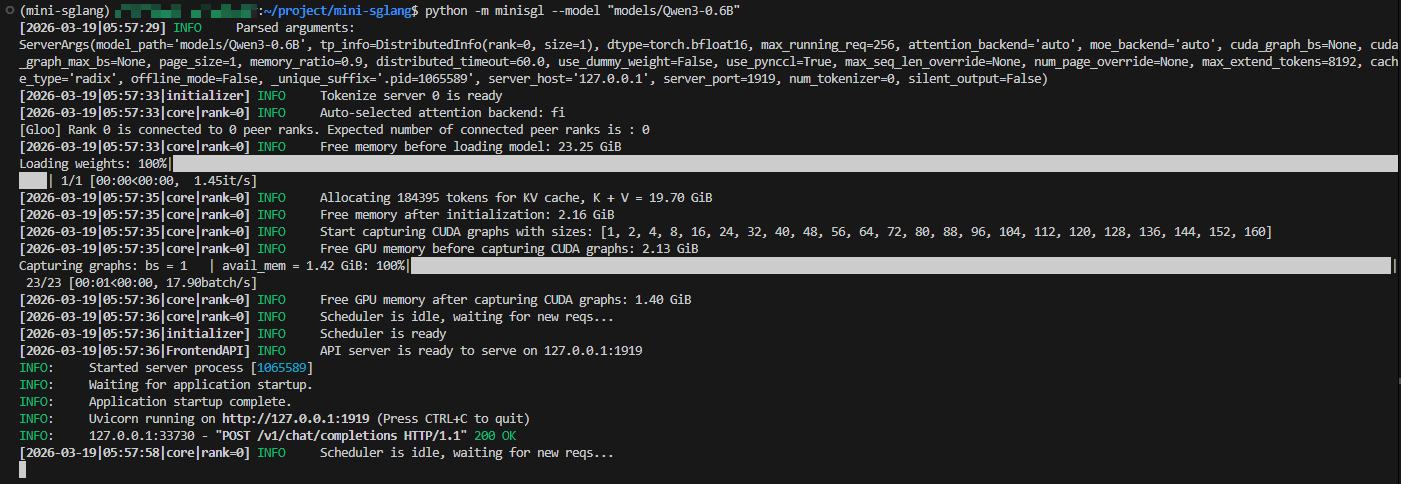
我们接着来试试,最直接的方式是使用 curl,指令如下:
shell
curl http://127.0.0.1:1919/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-0.6B",
    "messages": [
      {"role": "user", "content": "Hello"}
    ],
    "max_tokens": 256,
    "max_completion_tokens": 256,
    "temperature": 0.7
  }'
输出如下:
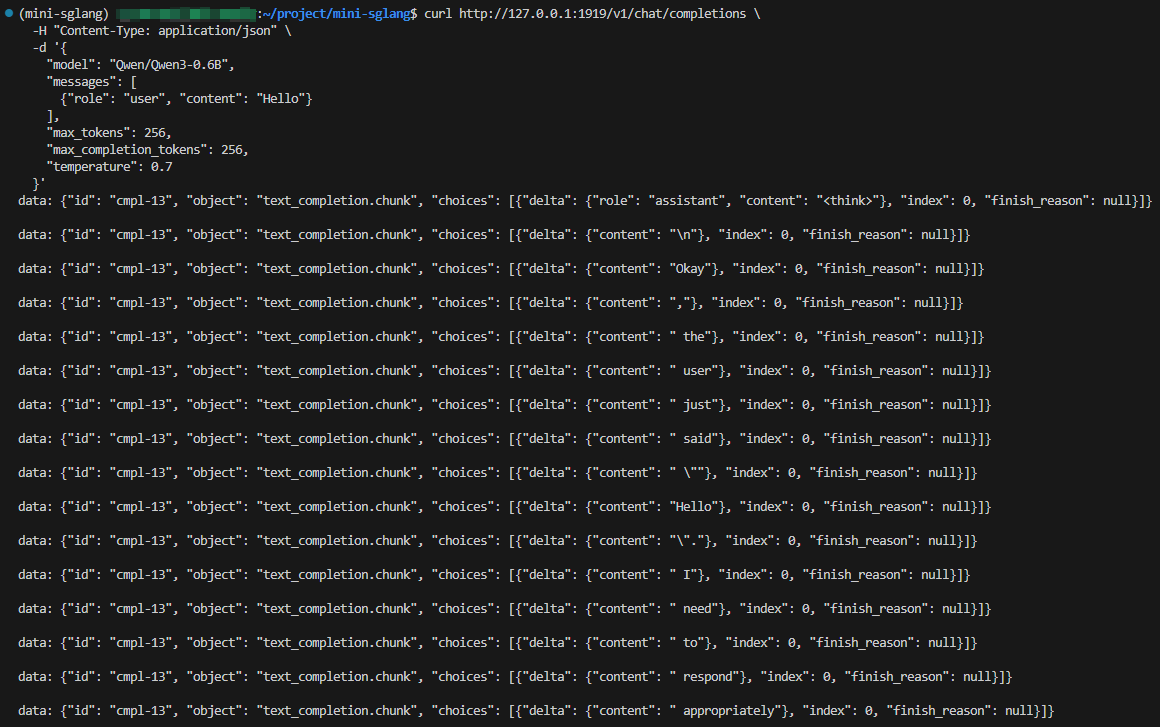
我们得到的其实是流式输出,也就是每个输出 token 单独返回一次,所以我们才会看到上图中这么多的内容。
我们也可以简单写一个 python 脚本来请求推理,示例脚本如下:
python
import json
import requests

URL = "http://127.0.0.1:1919/v1/chat/completions"
MODEL = "models/Qwen3-0.6B"


def chat(prompt: str, max_tokens: int = 256, temperature: float = 0.7) -> str:
    payload = {
        "model": MODEL,
        "messages": [
            {"role": "user", "content": prompt}
        ],
        "stream": True,
        "max_tokens": max_tokens,
        "max_completion_tokens": max_tokens,
        "temperature": temperature,
    }

    full_text = []
    finish_reason = None

    with requests.post(URL, json=payload, stream=True, timeout=300) as resp:
        resp.raise_for_status()

        for raw_line in resp.iter_lines(decode_unicode=True):
            if not raw_line:
                continue

            line = raw_line.strip()
            if not line.startswith("data: "):
                continue

            data_str = line[len("data: "):].strip()
            if data_str == "[DONE]":
                break

            try:
                chunk = json.loads(data_str)
            except json.JSONDecodeError:
                continue

            choices = chunk.get("choices", [])
            if not choices:
                continue

            choice = choices[0]
            if choice.get("finish_reason") is not None:
                finish_reason = choice["finish_reason"]

            delta = choice.get("delta", {})
            piece = ""

            if isinstance(delta, dict):
                if delta.get("content") is not None:
                    piece += delta["content"]
                if delta.get("reasoning_content") is not None:
                    piece += delta["reasoning_content"]

            if not piece:
                message = choice.get("message", {})
                if isinstance(message, dict):
                    if message.get("content") is not None:
                        piece += message["content"]
                    if message.get("reasoning_content") is not None:
                        piece += message["reasoning_content"]

            if piece:
                print(piece, end="", flush=True)
                full_text.append(piece)

    print(f"\n\n[finish_reason={finish_reason}]")
    return "".join(full_text)


if __name__ == "__main__":
    chat("Hello", max_tokens=256)
执行后输出如下:
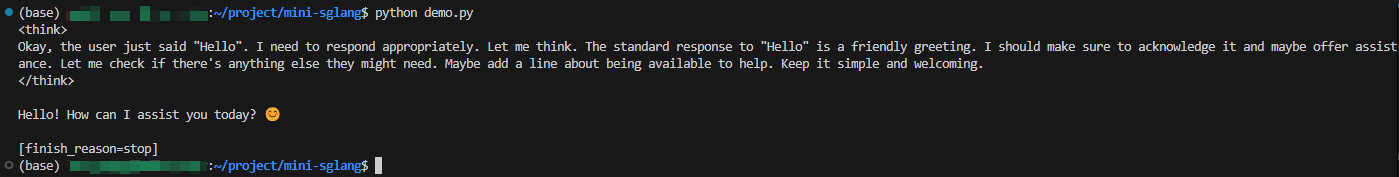
这种方式也能得到和终端 shell 相同的效果。
OK,接下来我们还需要配置下调试的基本环境,因为在后续的学习过程中我们肯定是需要不断地调试 mini-sglang 的源码来理解它内部的核心机制的。这里博主直接让 Claude Code 在 vscode 中进行了配置,launch.json 内容如下:
json
{
    // 使用 IntelliSense 了解相关属性。
    // 悬停以查看现有属性的描述。
    // 欲了解更多信息,请访问: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            // 直接从 launch.py 启动,等价于:
            //   CUDA_VISIBLE_DEVICES=0 python python/minisgl/server/launch.py \
            //     --model models/Qwen3-0.6B --shell-mode --memory-ratio 0.3
            // 用于在 launch_server / 初始化流程里下断点。
            "name": "Python 调试程序: launch.py (GPU0, 小 KV)",
            "type": "debugpy",
            "request": "launch",
            "module": "minisgl.server.launch",
            "cwd": "${workspaceFolder}",
            "python": "${workspaceFolder}/.venv/bin/python",
            "console": "integratedTerminal",
            "env": {
                "CUDA_VISIBLE_DEVICES": "0"
            },
            "args": [
                "--model",
                "models/Qwen3-0.6B",
                "--shell-mode",
                "--memory-ratio",
                "0.3"
            ]
        }
    ]
}
Note :注意你可以通过 CUDA_VISIBLE_DEVICES 来指定在特定的 GPU 上调试。
我们在脚本 python/minisgl/server/launch.py 中打个断点,因为这是整个 mini-sglang 的入口,然后按下 F5 就可以进入调试模式了:
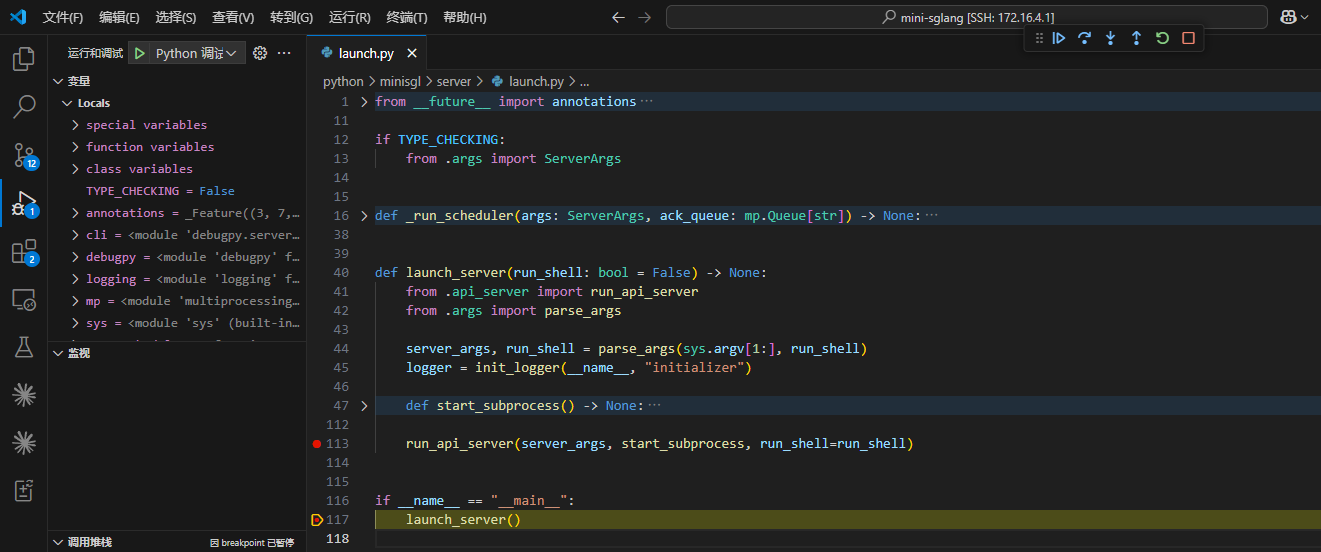
接下来我们就可以愉快的调试 mini-sglang 的源码并进行学习了🤗。
这里有个点需要注意,mini-sglang 启动时会按显卡空闲显存的固定比例,一次性预分配整个 KV Cache 池,默认比例是 90%,因此虽然我们调试的是一个 0.6B 的模型,权重只有 1.2 GiB 左右,但是大家使用 nvidia-smi 指令时仍然可以看到显存占用接近拉满---占掉显存的不是模型,而是 KV Cache。
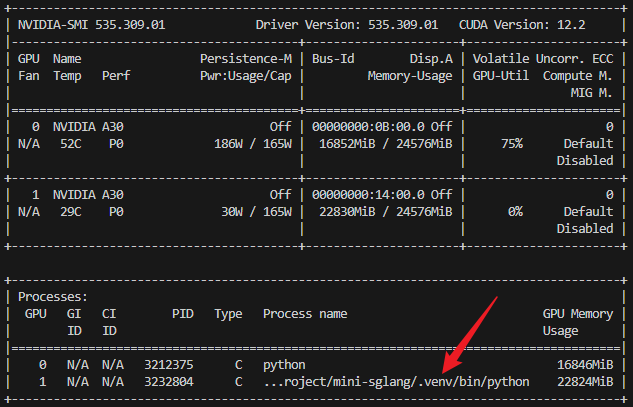
这个设计并非 mini-sglang 独有,vLLM 的 gpu_memory_utilization、SGLang 的 mem-fraction-static 都是同一套思路:paged attention 要求 KV Cache 是一块启动时就固定大小、地址连续的显存,运行期不再申请和释放,从而避免动态分配带来的碎片和抖动。
如果不希望 KV Cache 把所有剩余显存占满,可以使用 memory_ratio 参数(即命令行的 --memory-ratio)手动设置,它的语义是:取启动时(加载权重之前)测得的空闲显存的 memory_ratio 倍,扣掉模型权重的实际开销,剩余部分全部用作 KV Cache,默认是 90%(定义在 python/minisgl/engine/config.py:26),留出的 10% 是给激活值、CUDA graph 捕获、NCCL buffer 和显存碎片的余量。需要注意它乘的是空闲显存而不是总显存,卡上已经有别的进程在跑时,算出来的池子也会相应变小。
具体分配规则代码如下:
python
# python/minisgl/engine/engine.py:L148

def _determine_num_pages(self, old_free_memory: int, config: EngineConfig) -> int:
    new_free_memory = self._sync_get_memory()[1]
    cache_per_page = (
        2 * config.model_config.head_dim
        * div_even(config.model_config.num_kv_heads, config.tp_info.size, allow_replicate=True)
        * config.page_size * self.dtype.itemsize * config.model_config.num_layers
    )
    ...
    if config.num_page_override is None:
        model_memory = old_free_memory - new_free_memory           # 权重实际吃掉多少
        available_memory = int(config.memory_ratio * old_free_memory) - model_memory
        num_pages = available_memory // cache_per_page
时序是:启动时先量一次空闲显存 old_free_memory → 加载权重 → 再量一次,两者之差就是模型的开销 → 然后按上面的公式算出页数,最后用一次 torch.empty 把整个 KV 池申请出来。
所以大家在调试分析源码时,没必要把空闲显存全部占满:如果只是为了跑小模型(如 0.6B)做功能验证,设置一个较小的值(0.2~0.3)即可,把剩下的显存留给别的进程。
4. API server:在线推理入口
OK,那正式进入到我们的上集的内容。
首先我们刚刚已经讲过了,我们会把引擎的部分和 TP 实现的部分都隐去。除此之外,涉及 KV Cache 的部分,在上集也不会展开 --- 不过在架构图上我们会看到,有些步骤里 scheduler 的逻辑会和它内部的 CacheManager 去做交互。
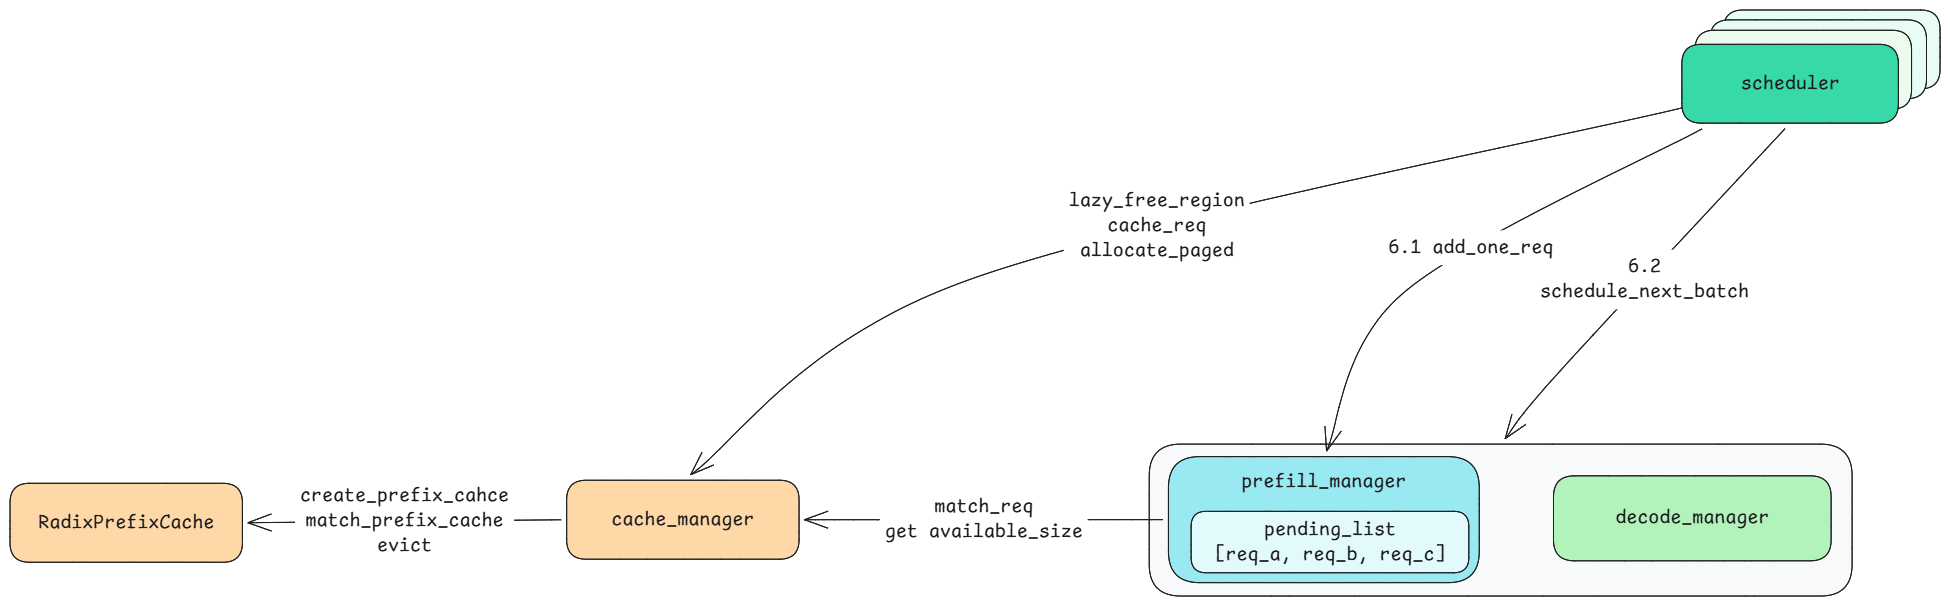
那只要是涉及到 CacheManager 的路径,我们在上集都会先跳过,在下集再详细的展开。那大家可以理解为,在上集我们讲的架构是一个没有 KV Cache 的架构,这样就比较好理解了。
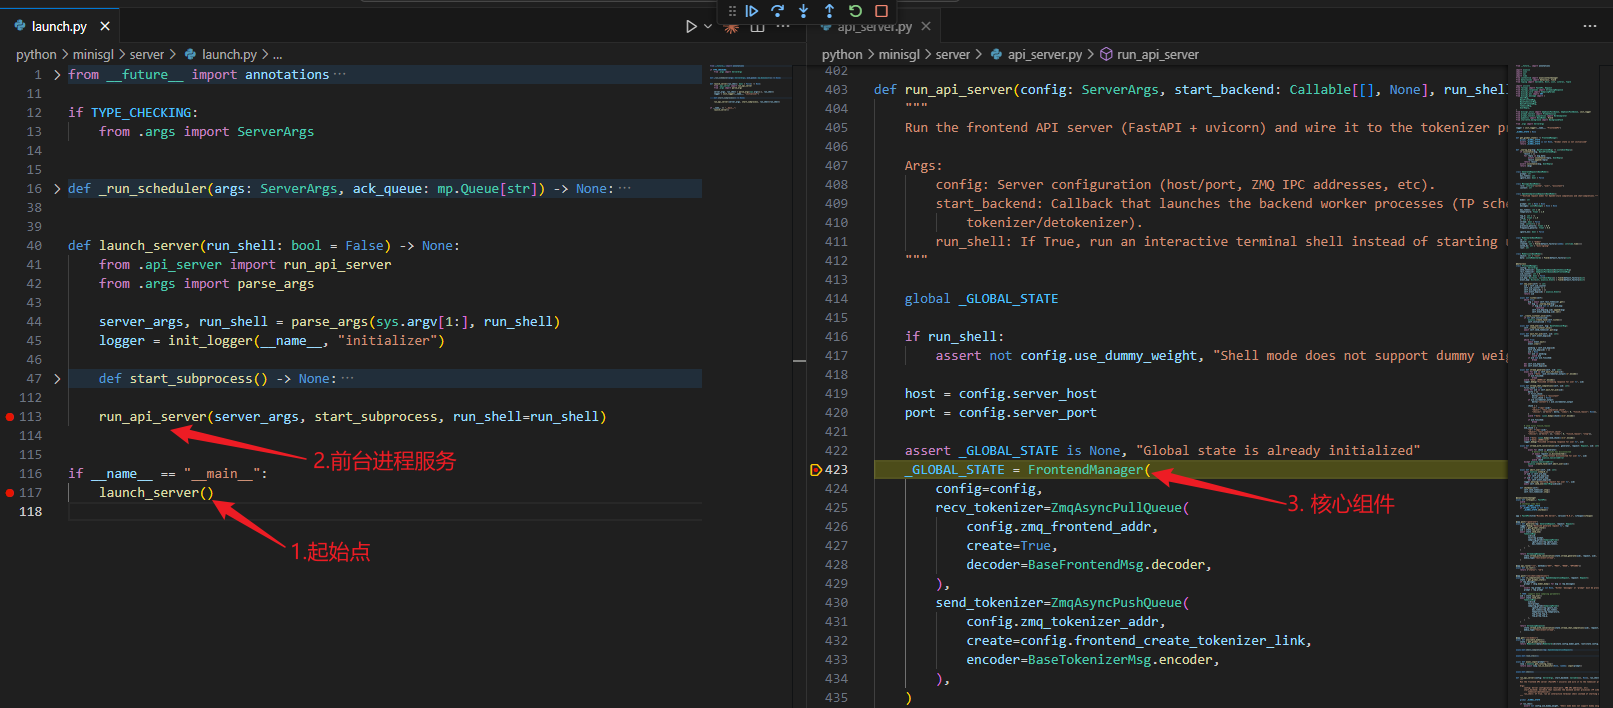
我们在整个架构图上先从左上角进入,也就是 mini-sglang 项目的起点,代码上叫做 launch server。
那这个 launch server 它启动的是什么呢,它启动的就是一个前台的 API server,那它有对外接收请求、提供路由的这样的一个能力,所以 API server 是它启动之后,实际长期运行的这样的一个进程,我们也把它称之为是一个前台进程,那这个前台进程,它就会负责比如说实现一个 OpenAI 接入的接口之类的这样的一个逻辑。
但是那些常规化的处理也不是我们今天的重点,所以在这里呢,我们会从一个推理请求的生命周期开始,完整的看一下它在前台和后台之间,分别怎么样各司其职,去做了什么样的一些逻辑处理。那一个请求的进入 --- 我们这里说的是一个 request 的进入 --- 是通过 chat 这类路由进来的:客户端访问 chat 也好、访问 generate 也好,只要访问到对应的路由,API server 就接收到了这个请求。
那 API server 的内部,它有一个非常重要的组件,叫做 FrontendManager,这个 FrontendManager 它管理的其实就是前台所有的逻辑,那为什么需要一个 FrontendManager
这样的角色呢,这就是我们要展开的第一个设计点。
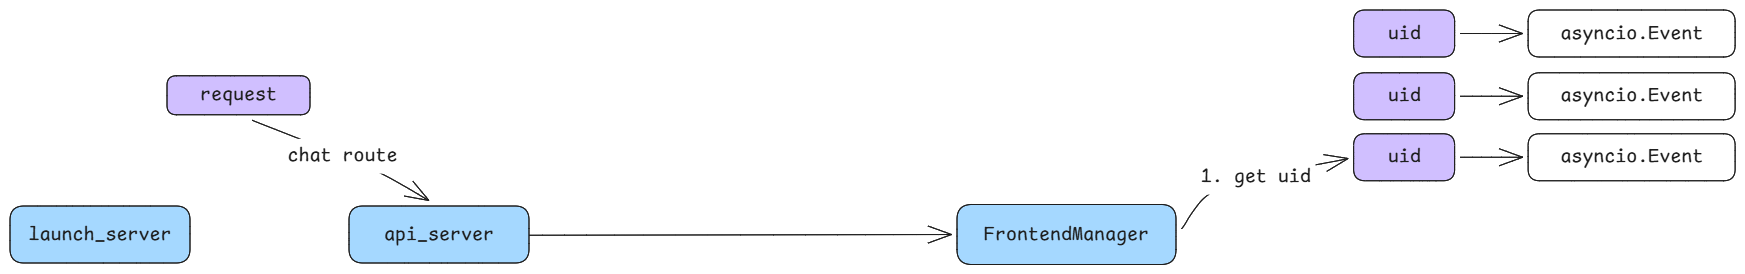
在 FrontendManager 里边,它要管理的对象就是多个同时并行执行的推理请求。API server 是一个进程,这个进程里会同时存在很多个推理请求 --- 并发 10 个请求,这里就有 10 个推理在同时进行。我们后面追踪的其实是单个请求,但对 API server 来说它管理的是多个请求,那谁来维护这个一对多的关系呢?就是 FrontendManager 这个组件。
那每一个请求,在这个 FrontendManager 的视角里边就应该需要一个唯一的标识,这样它在做所有的逻辑处理的时候都可以用这个标识来找到那个请求所处的阶段、所积累的状态等等。那在 SGLang 里边,它把这个标识称之为是 uid,那它的实现呢也比较优雅简洁:
python
# python/minisgl/server/api_server.py:L100

@dataclass
class FrontendManager:
    config: ServerArgs
    send_tokenizer: ZmqAsyncPushQueue[BaseTokenizerMsg]
    recv_tokenizer: ZmqAsyncPullQueue[BaseFrontendMsg]
    uid_counter: int = 0
    initialized: bool = False
    ack_map: Dict[int, List[UserReply]] = field(default_factory=dict)
    event_map: Dict[int, asyncio.Event] = field(default_factory=dict)

    def new_user(self) -> int:
        uid = self.uid_counter
        self.uid_counter += 1
        self.ack_map[uid] = []
        self.event_map[uid] = asyncio.Event()
        return uid
每一个 uid 都是一个全局自增的 ID,用来保持唯一性;而它所对应的运行时实现,也就是 Python 里的一个 asyncio 的 event。
那通过这样的一个 event 的异步机制,后续漫长复杂的前后台进程交互,就可以用统一的方式去等待结果,另外,在它的代码实现里,uid 经常被直接称作 user,但其实这里的 user 跟真实的用户没什么关系,你可以理解为它就是一个推理请求的单位就可以了。
所以 FrontendManager 这里,它的核心其实就是管理了一个一对多的关系,然后把 uid 这个标识去在前后台之间做一个传递和持续的追踪,就做这样的一个事情。
5. ZMQ:前台与后台的通信骨架
OK,那接下来就是 API server 它其实是一个轻量级的实现嘛,那它怎么跟更复杂的、更重的这些后台的调度逻辑以及数据面的这些推理逻辑去做交互呢,就是我们说到的 ZMQ 了。
那这个 ZMQ,它是一个横跨所有进程的通信设施,本身是一个开源的组件,叫做 ZeroMQ,是一个高性能、轻量级的实现,真正的 SGLang 里用的也是它,那在这里,因为它是一个非常成熟的组件,我们就不对它做一个具体的展开了。
在 ZMQ 内部,它传递的消息其实都是类似 Buffer 这样的原始结构;至于这个数据块该被翻译成什么样的业务语义,则由上层来决定。所以在代码里边,我们就会看到所有跟 ZMQ 相关的代码,其实它在 SGLang、mini-sglang 的实现中都是强类型的。
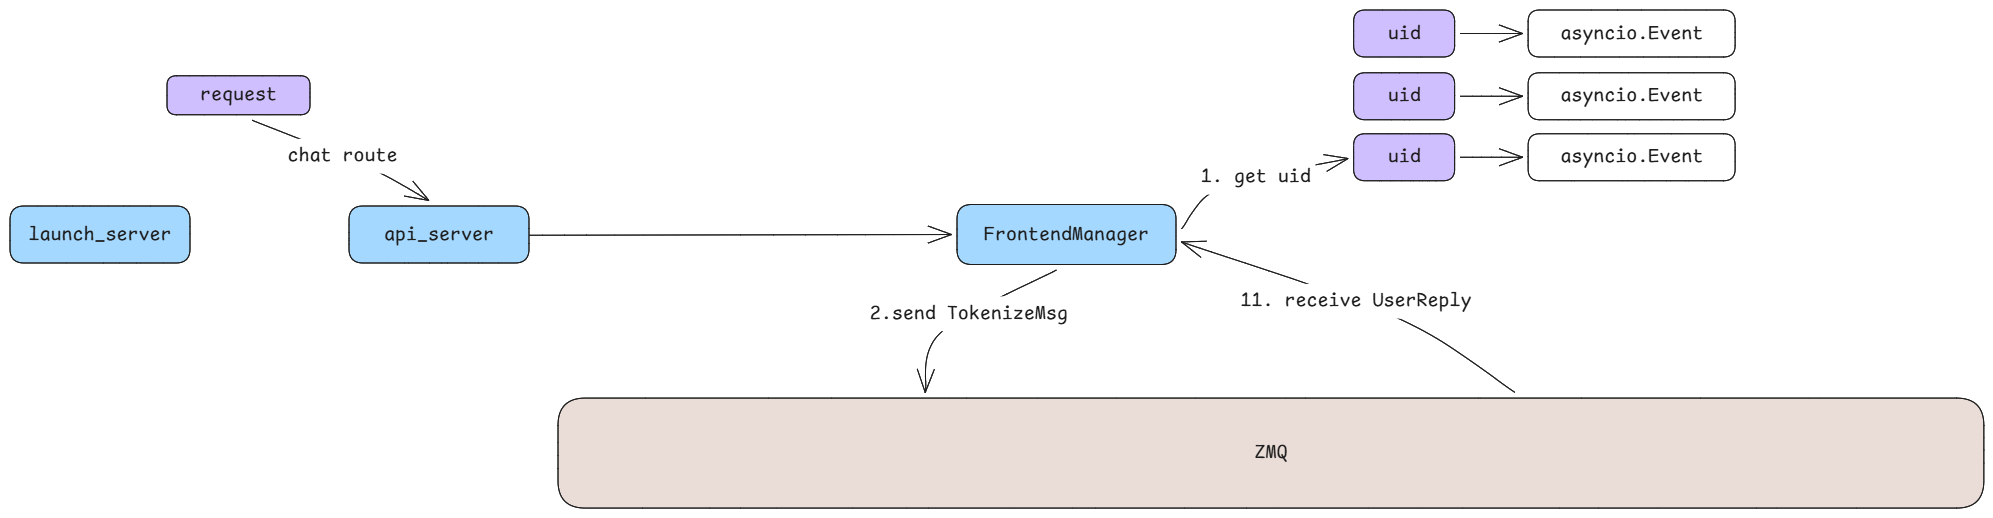
比如说对于 FrontendManager 来说,它只会把一种消息投递到 ZMQ 里边,也就是 TokenizeMsg 这样的一个消息结构,那顾名思义,它投递进去的 TokenizeMsg 就应该由后边的 backend 组件里边的 tokenizer 来处理,所以这就是我们说的这个代码设计上的一个非常优雅的地方,只要看消息的类型,就能知道投递的一方是谁、消费的一方是谁。
在这里 FrontendManager 拿到 uid,把消息一组织 --- 这里的消息,就是指从最上层用户的 request 翻译过来的消息 --- 组织好之后呢,就直接投递到 ZMQ 里了。那在这里其实没有任何的 GPU 相关的操作,所以它可以保持非常的快速、非常的轻量级。
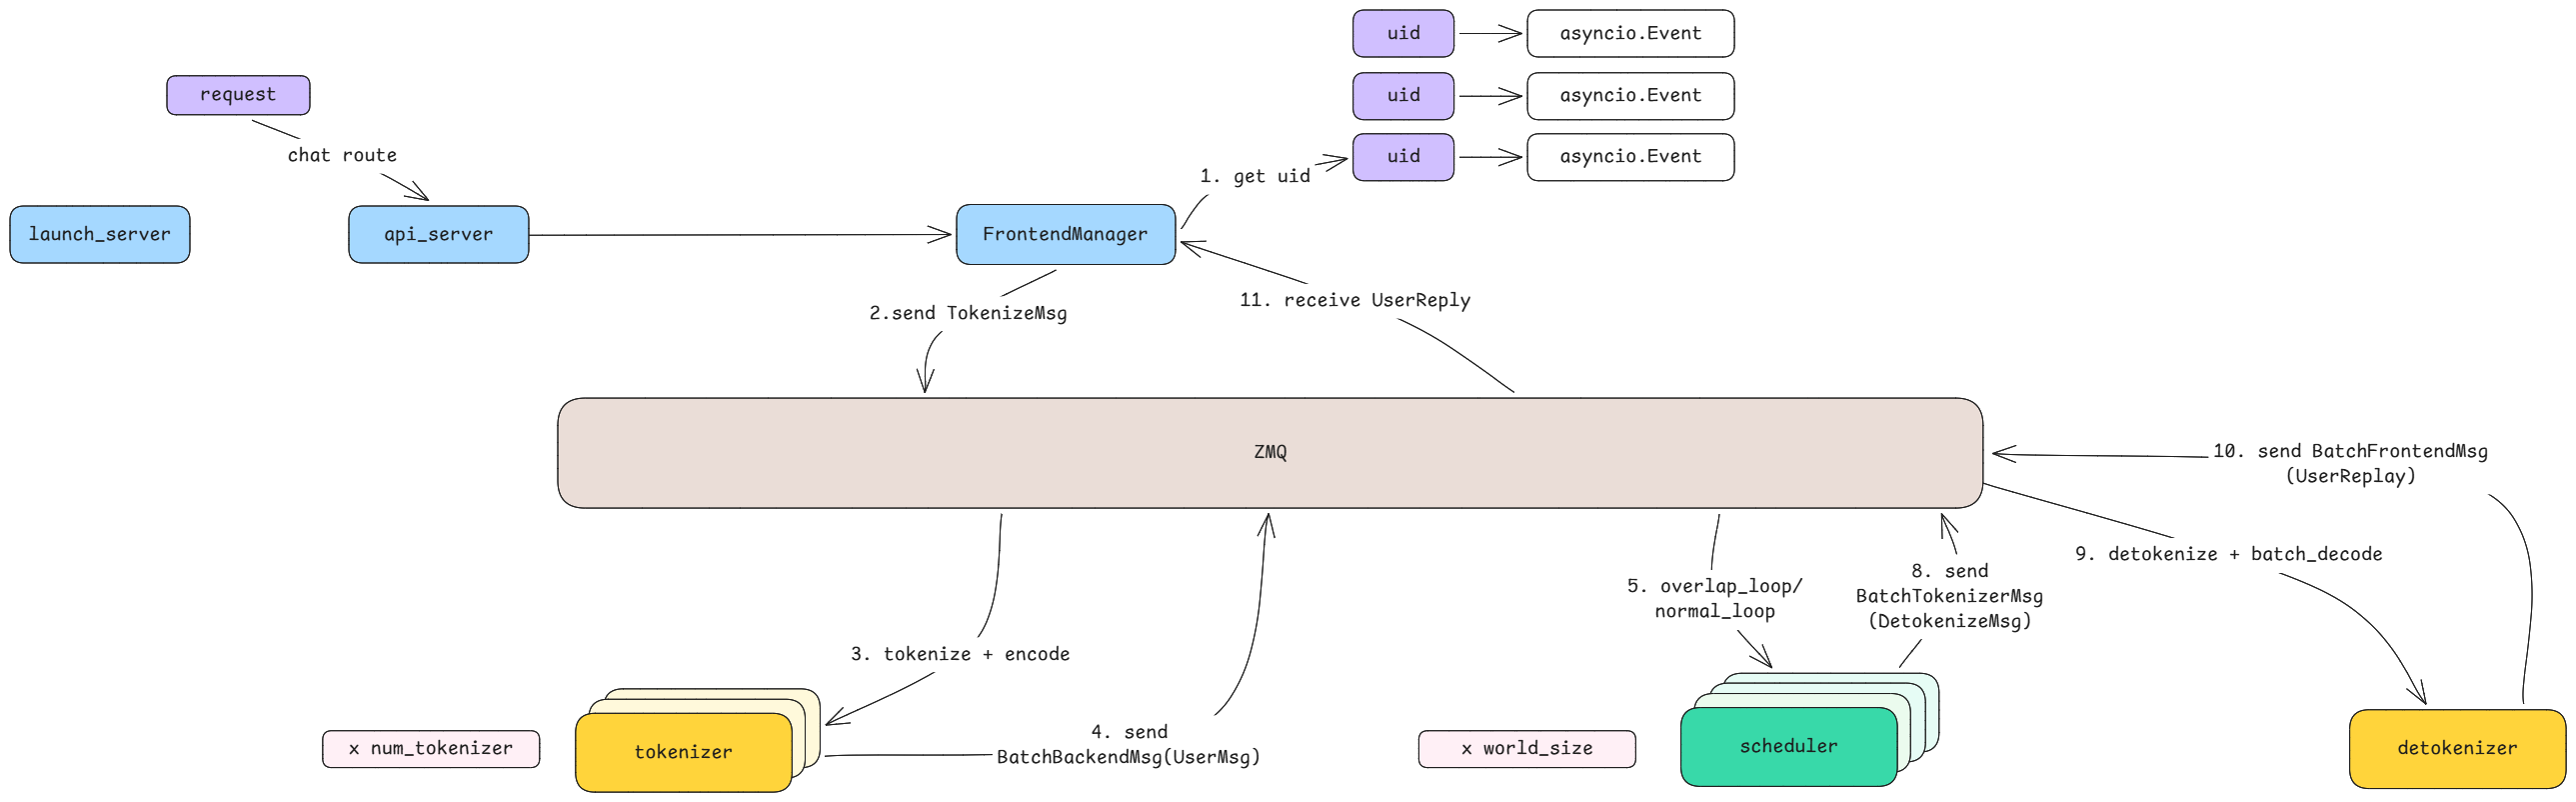
那 ZMQ 收到这个消息之后,其实每一个消费者它都是自己去实现一个拉取的队列来从 ZMQ 里边拉消息的,所以可以看到 ZMQ 它会有多个箭头,比如说有 tokenizer 消费它的箭头,有 scheduler 消费它的箭头,有 detokenizer 消费它的箭头,也包括 FrontendManager 自己也会消费它,因为它投递完消息之后,那个消息在后台转了一圈之后,它也需要消费对吧。
那每一个从 ZMQ 发出来的箭头其实都是一个消费的路径,那这个消费的路径里边,它其实就会声明说我要处理的消息类型是什么。
OK,那我们前面讲过了,每一个投递进 ZMQ 的消息都有一个确定的类型,那每一个拉取它的也有一个确定的类型,而这个 mini-sglang 里边又确保了每一个类型的消息只有一个投递方和一个消费方,所以只要看到一个消息类型,我们就知道它的两端是谁了,就这样的一个好处。
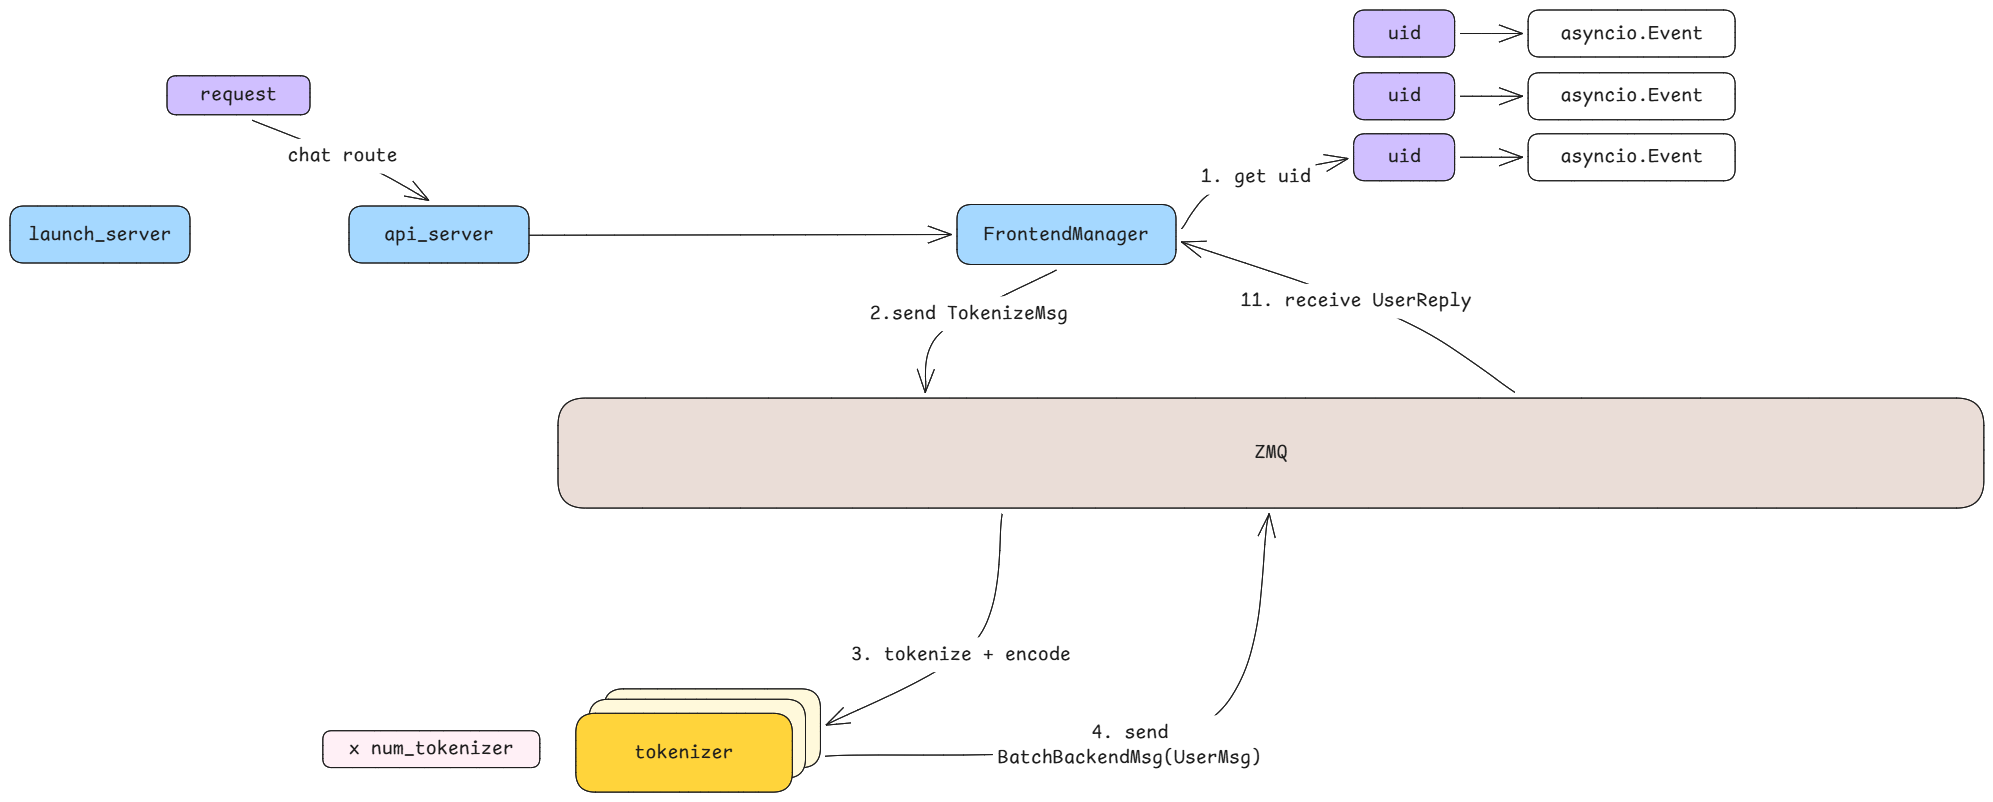
那 FrontendManager 把 tokenize message 投递进来之后就是由 tokenizer 来消费,那 tokenizer 来消费它的目的是什么呢,就是把这个 CPU 上的数据结构给它转换成 tensor 的这样的一个结构,也就是我们所说的 encode 这样的一个过程。
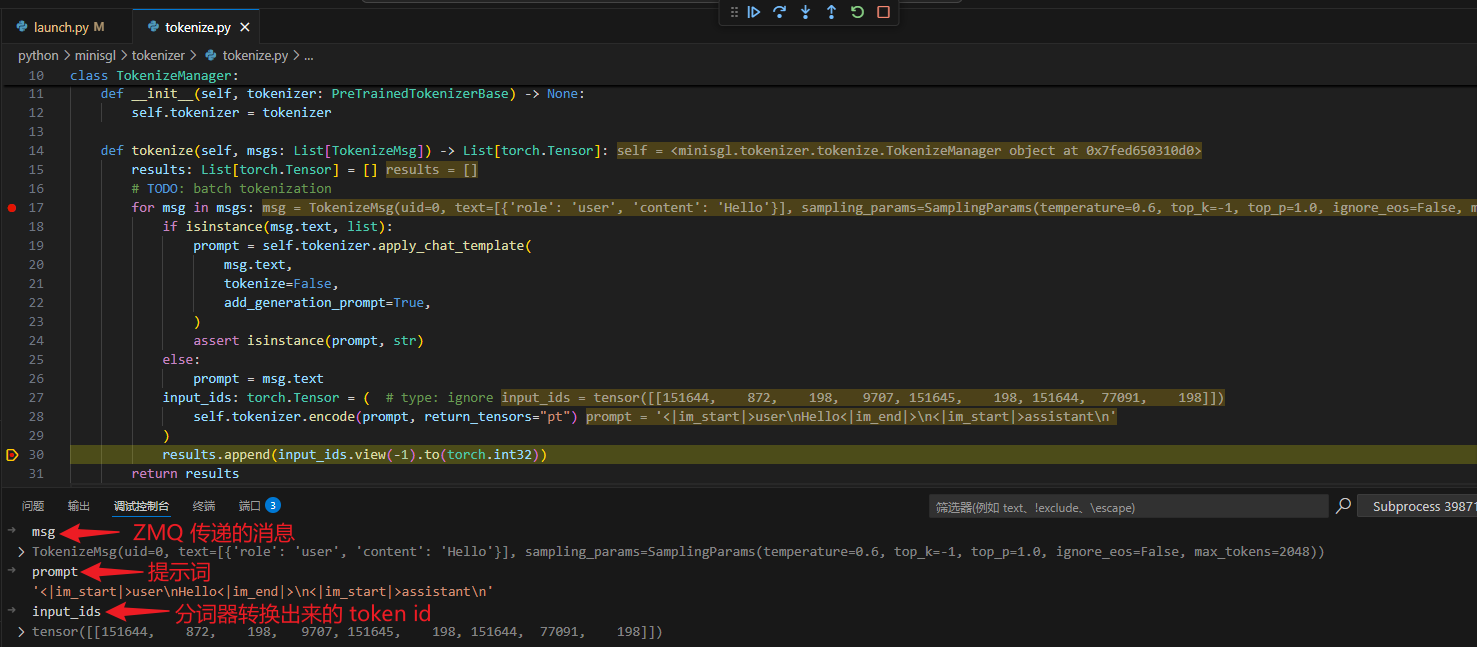
python
# python/minisgl/tokenizer/tokenize.py:L10

class TokenizeManager:
    def __init__(self, tokenizer: PreTrainedTokenizerBase) -> None:
        self.tokenizer = tokenizer

    def tokenize(self, msgs: List[TokenizeMsg]) -> List[torch.Tensor]:
        results: List[torch.Tensor] = []
        # TODO: batch tokenization
        for msg in msgs:
            if isinstance(msg.text, list):
                prompt = self.tokenizer.apply_chat_template(
                    msg.text,
                    tokenize=False,
                    add_generation_prompt=True,
                )
                assert isinstance(prompt, str)
            else:
                prompt = msg.text
            input_ids: torch.Tensor = (  # type: ignore
                self.tokenizer.encode(prompt, return_tensors="pt")
            )
            results.append(input_ids.view(-1).to(torch.int32))
        return results
Note :这里有个小点需要注意,博主在 shell 模式下测试输入的文本内容仅仅是 Hello,那为什么这里的提示词却多了一些内容呢,那其实我们看到的是 chat template 包装后的结果,也就是说用户发送给模型的消息列表还会经过一层对话模板的包装,实际上模型端拿到的是包装后的 prompt。
那这个过程,它跟 vLLM 里边的这个 tokenizer 的逻辑是几乎完全一样的,所以我们在这里也不需要进一步的去展开,大家只需要知道说 tokenizer 这边过完一遍以后,它就变成了一个 tensor 的数据结构了。
那在这里我们会关注的是什么呢,我们会关注的是它的一个 tokenizer 的这种进程的架构设计是比较有趣的,实际上呢,在这个整个的 mini-sglang 的实现里边它有三个后台的进程,就是我们刚刚讲过的,tokenizer 负责把 CPU 上的数据转换成一个真正的 tensor 的对象,然后,这个 scheduler 负责处理这些 token,处理完了之后,最后推理出来是一个新的 token,那我们要把它再转回 CPU 上的字符串之类的结构,这就是一个 detokenizer 的过程,所以这是它的三大后台的进程。
但是,在默认的情况下其实 detokenizer 和 tokenizer 它是一个共享模式,也就是这两者在你不指定 --num-tokenizer 参数时(默认为 0)其实是同一个进程,这是它的一个最极简化的设计。
python
# python/minisgl/server/args.py:L156

def parse_args(args: List[str], run_shell: bool = False) -> Tuple[ServerArgs, bool]:

    ...

    parser.add_argument(
        "--num-tokenizer",
        "--tokenizer-count",
        type=int,
        default=ServerArgs.num_tokenizer,
        help="The number of tokenizer processes to launch. 0 means the tokenizer is shared with the detokenizer.",
    )
但是它在配置上允许你指定 tokenizer 的数量,由此决定它要以几个副本来运行。
配置为 0 时,两者共享进程;配置为 1 时,tokenizer 就会是一个独立的进程;配置为 3 时,它就会起三个副本,而这三个副本通过消息队列的方式来做一个负载均衡,也就是各自去拉需要处理的这个前台的 tokenizer message,把它转换成 token 再放回到消息队列里边去。
所以可以看到,在这个地方通过消息队列的这种分发的机制以及独立进程的这样的一个实现,它是可以对一些潜在的有性能开销的组件做独立的横向扩展的,这是它架构上一个比较有意思的地方。所谓独立横向扩展,是说 tokenizer 在很多场景下并不是瓶颈所在,所以它默认就跟 detokenizer 放在一个进程里,它本身可能根本不是资源消耗的核心。
但是也许你在一些不同的模型任务上或者不同的模型类型上 tokenizer 就变成了一个性能瓶颈,那如果整个后台是一个大进程、要整体扩成多个副本,开销就会比较大,所以这就是他把这个组件拆开的一个好处了。
tokenizer 可以从零扩展到 n 个副本,当 tokenizer 的这个负载比较重的时候它就可以做这样的一个切分了,甚至我们可以想象啊,现在它是通过一个本机的 ZMQ 去做通信,那如果未来真的有一些特殊的场景,它甚至可以把它变成一个分布式的结构,把 tokenizer 跑在一些机器上,把 scheduler 跑在一些机器上,如果真的有那么重的负担。
当然现在来看是没有了,但它的架构天生就已经为这类场景做好了适配,所以这个是它的一个 tokenizer 架构上的一个有趣的地方。
那 tokenizer 它做完 encode 的这个动作之后,我们其实关注的是什么呢,关注的就是它把什么消息放回到 ZMQ 对吧,所以在这里我们还是要再次强调一遍这就是这个架构设计带来的一个优势了,我们看每个组件的时候,在不去深入的看它内部细节的时候,我们关注的就是它从 ZMQ 里边拉什么消息以及反投递什么消息回去,这就是我们关心的一个核心的入口和出口了。
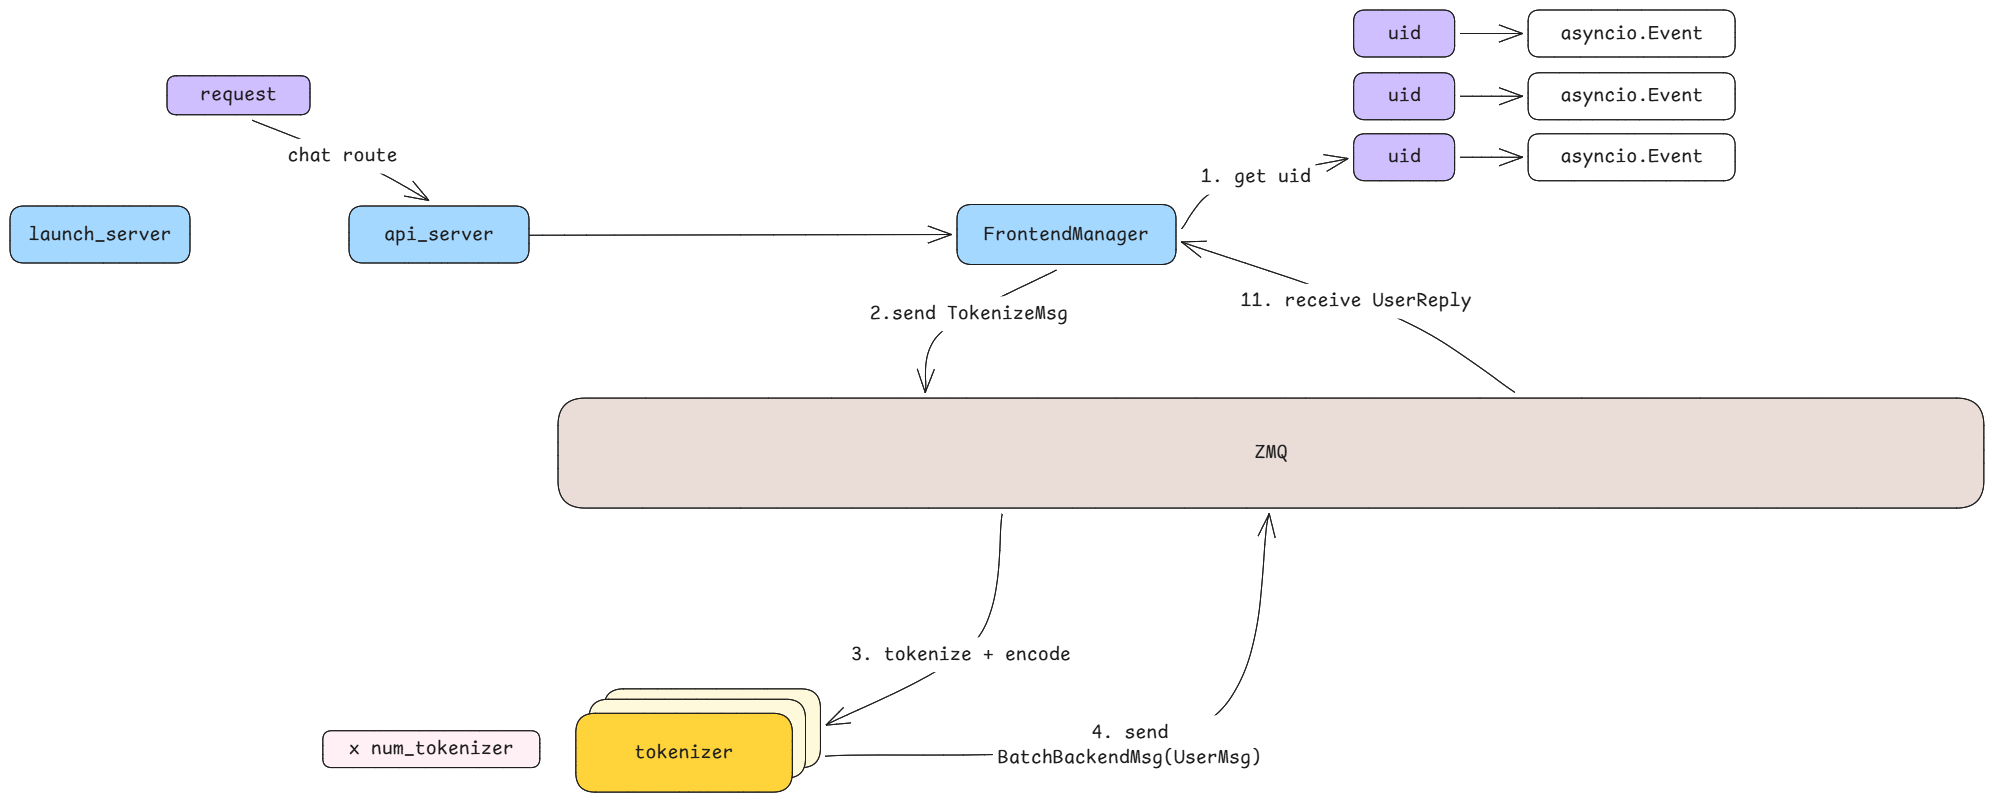
那 tokenizer 它在内部把消息变成 token 之后,它就会发送一个 UserMsg 到 ZMQ 里边,当然它会有一个批量的实现,也就是我们上面看到的 FrontendManager,它会持续不断的把不同请求的这个 request 都投递到消息队列里边来,而 tokenizer 它其实并不关心前台的消息分别属于哪个请求,它一次可能会拉回来多条前台的请求,那它就可以做一个批量化的处理。
python
# python/minisgl/tokenizer/server.py:L89

def tokenize_worker(...):
    ...

    if len(tokenize_msg) > 0:
        tensors = tokenize_manager.tokenize(tokenize_msg)
        batch_output = BatchBackendMsg(
            data=[
                UserMsg(
                    uid=msg.uid,
                    input_ids=t,
                    sampling_params=msg.sampling_params,
                )
                for msg, t in zip(tokenize_msg, tensors, strict=True)
            ]
        )
        if len(batch_output.data) == 1:
            batch_output = batch_output.data[0]
        send_backend.put(batch_output)
因为我们知道在做推理引擎的性能优化的时候,很多时候批量化的处理是一个非常重要的这样的一个入口了。所以 tokenizer 它这里已经做了一轮请求的批量化的初步的处理,那它往 ZMQ 里面放消息的时候,除了放它转换出来的 UserMsg 之外,还会在外面再包一层 BatchBackendMsg 这样的一个包装,让接下来的核心的 scheduler 能够感知到这是一批要一起处理的这个数据,所以它的一个投递回去的内容就是上面这样的。
6. 三大后台组件:各自的入口与出口
那再接下来呢,我们先会看一下 scheduler 的入口和出口,然后我们再展开 scheduler 里边内部的处理。
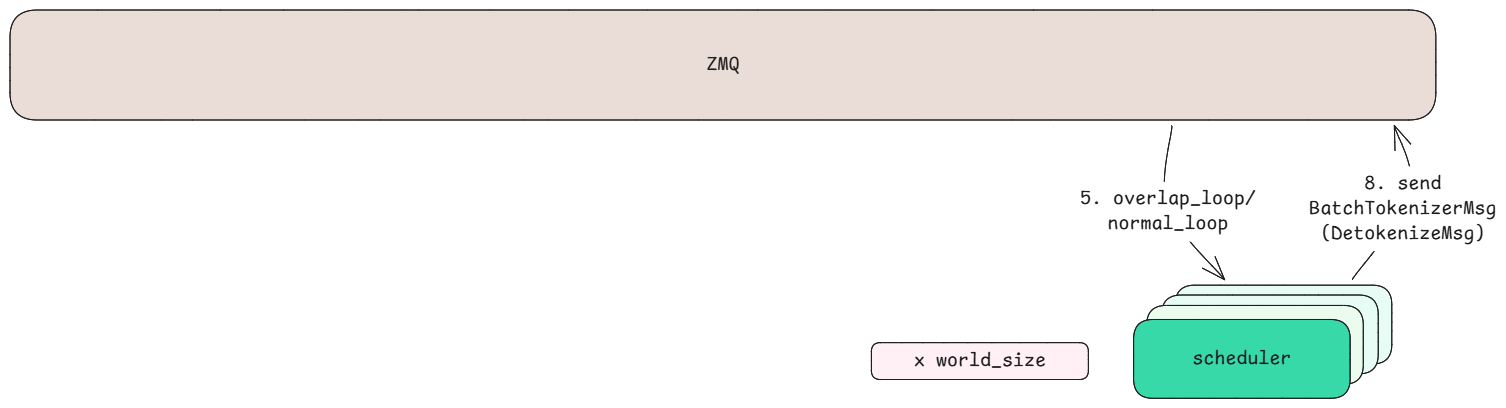
那 scheduler 作为一个独立的进程,它以什么规模去扩展呢,它其实没有必要说让用户来配置它的扩展的数量,比如用户说要扩展到 100 个副本,会不会让后台的 GPU 推理更快呢?其实不会,因为这个是受限于你 GPU 卡的一个拓扑结构和数量的,不是你想怎么扩展就怎么扩展的。
python
# python/minisgl/server/launch.py:L54

def start_subprocess() -> None:

    ...

    world_size = server_args.tp_info.size
    # a multiprocessing queue to receive ack from subprocesses
    # so that we can guarantee all subprocesses are ready
    ack_queue: mp.Queue[str] = mp.Queue()

    for i in range(world_size):
        new_args = replace(
            server_args,
            tp_info=DistributedInfo(i, world_size),
        )
        mp.Process(
            target=_run_scheduler,
            args=(new_args, ack_queue),
            daemon=False,
            name=f"minisgl-TP{i}-scheduler",
        ).start()
所以在这里,它核心的扩展逻辑就是根据 TP 的数量,也就是 world size 这个参数去做一个扩展,如果你不做 TP 的变形,TP 只有一,那它就是一个 scheduler 的进程,如果你有单机四张卡,并且这四张卡都用来做 TP 的并行的话呢,那它就可以起四个 scheduler 的这个进程,每个去对应一个 TP 也就对应一张卡。
OK,那在这里我们刚刚也讲到了,它起多个 TP 的时候怎么样去分发消息,怎么样再把每个 TP 上独自计算完的结果汇集起来,这和 vLLM 里我们之前分享过的 TP 系统设计(如下图)比较接近。
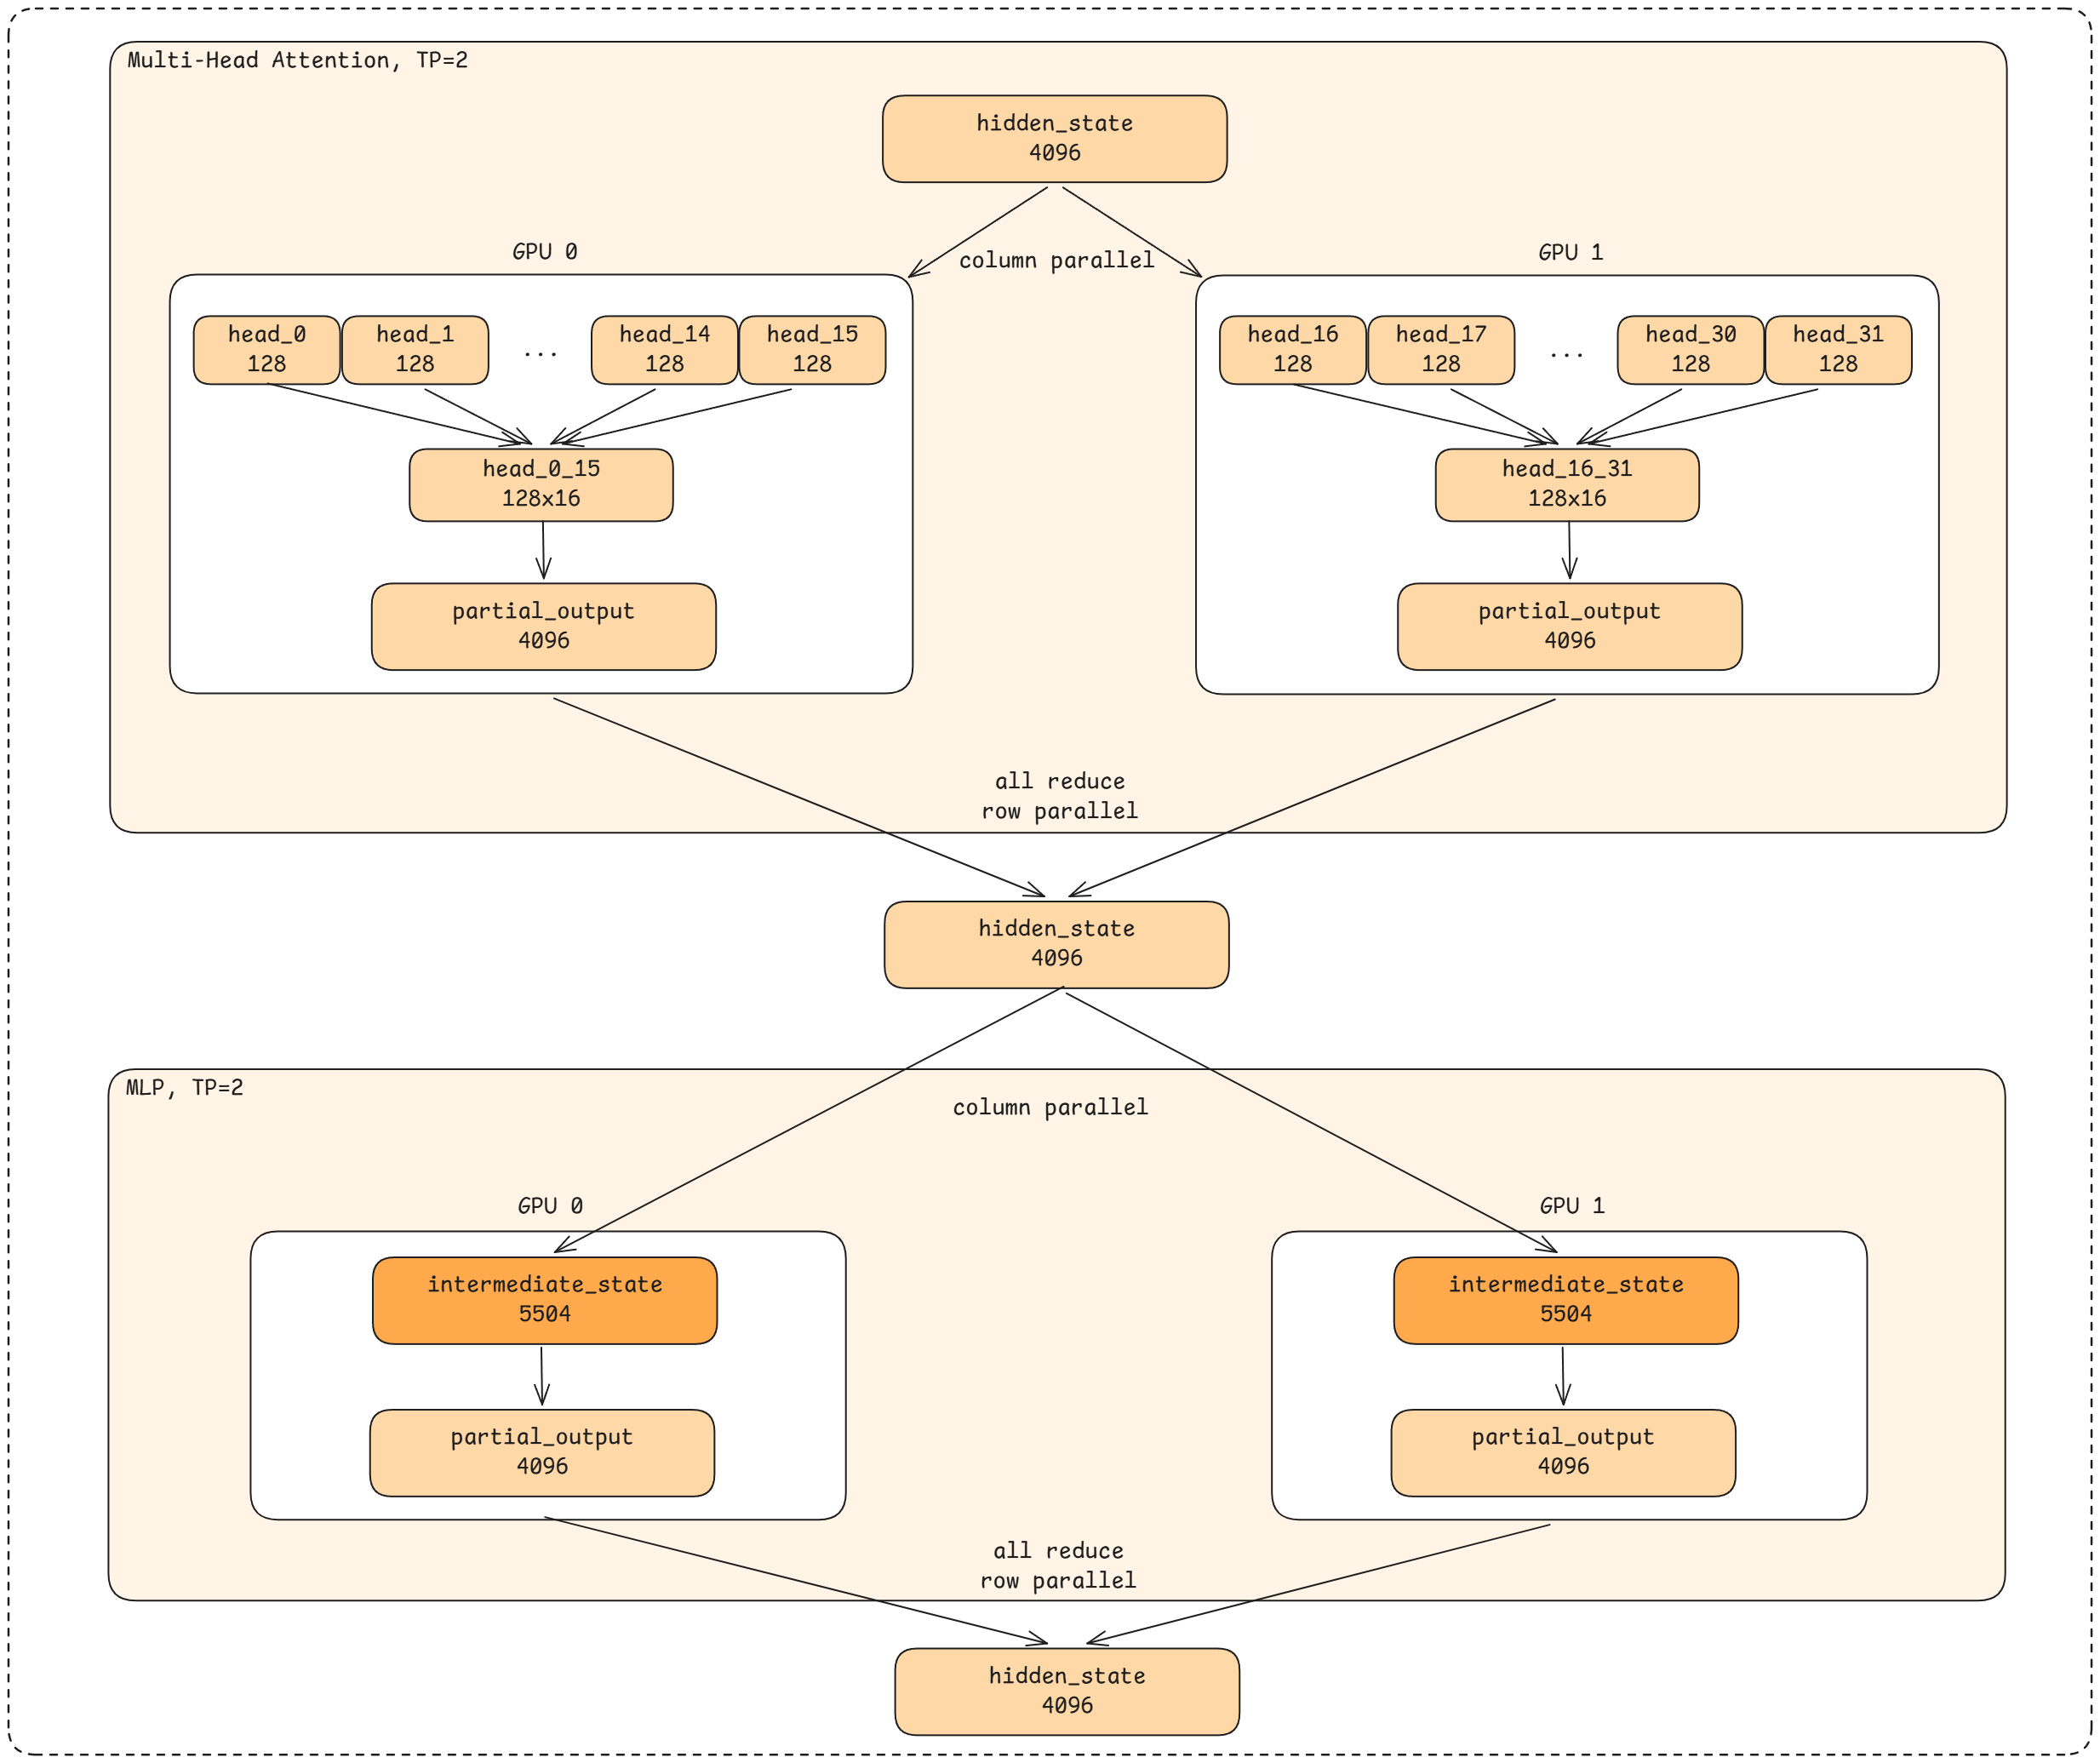
只不过 vLLM 里 TP 的通信机制是 shared memory,而 mini-sglang 里边,它就继续复用它的整个 ZMQ 的这样的一个设施来做通信,那我们在这里就不展开,大家可以认为我们接下来讲的逻辑,都是 world size 等于一这样的一个场景。
那我们先关心它的入口和出口,在入口的地方 scheduler 就会去关注由 tokenizer 投递进来的这样的一个 BatchBackendMsg 这样的结构,它会来消费它,那它就不会对比如说前台投递进来的 TokenizeMsg 去做一个处理了。
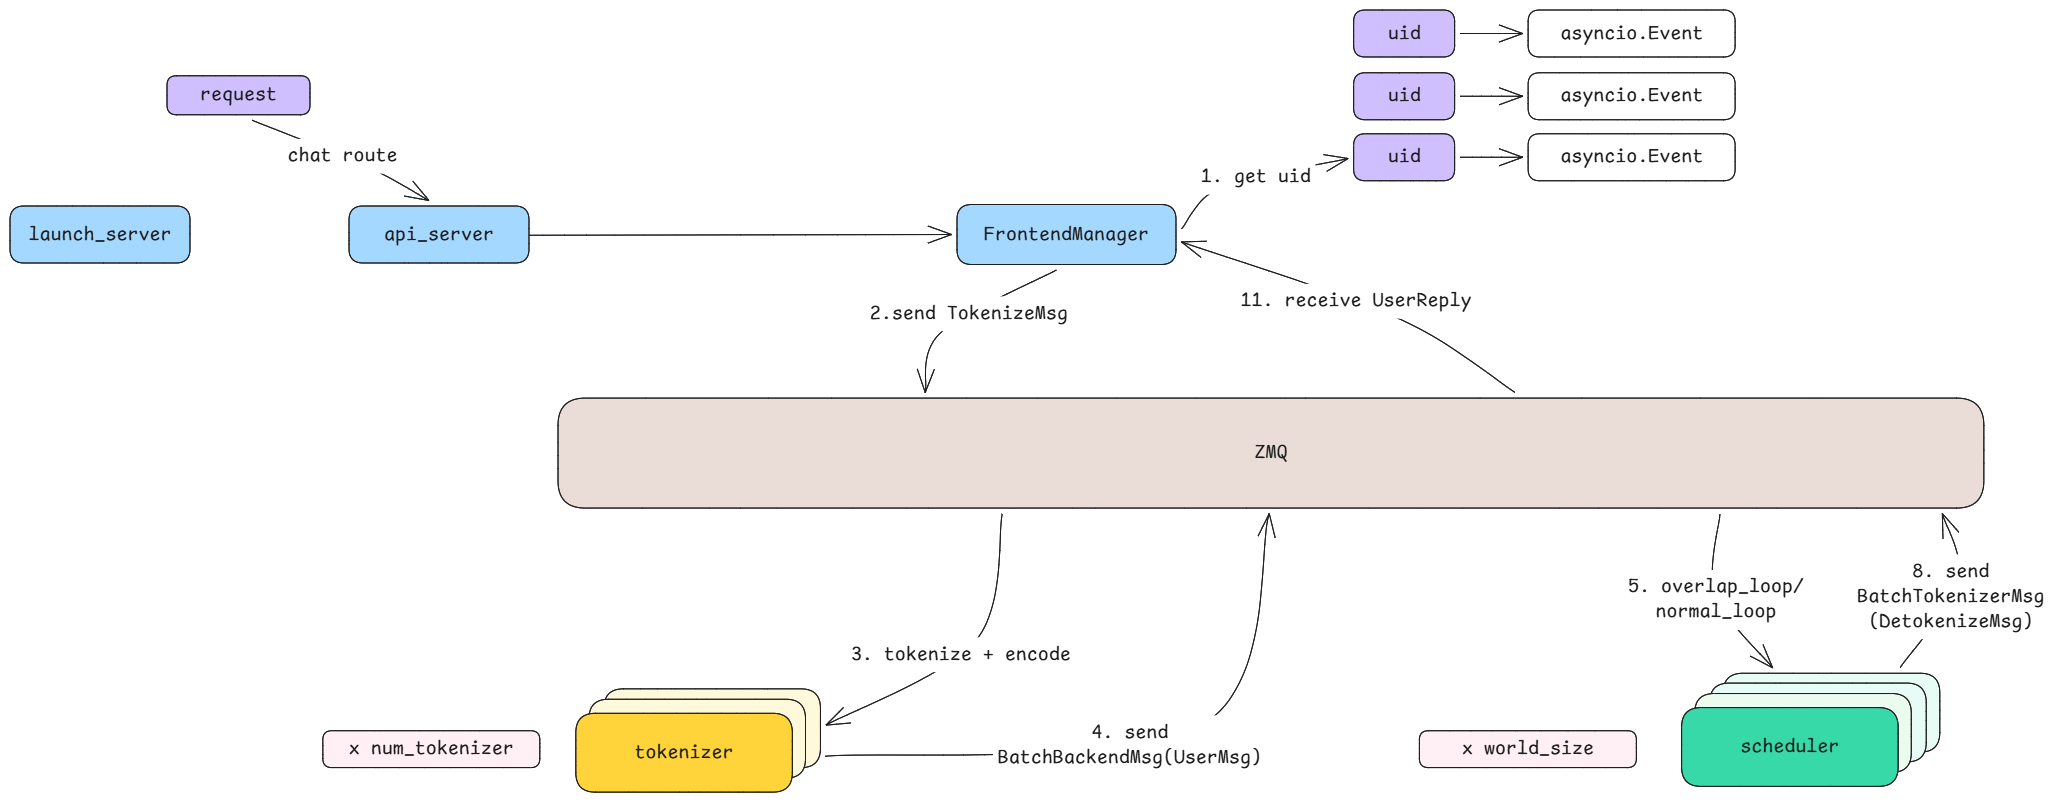
那当它收到这个 BatchBackendMsg 之后,它的处理逻辑核心是一个循环、一个 loop,也就是它会持续不断地从 ZMQ 里边去拉消息消费,如果空闲的话它就进入一个空闲状态,但只要一有新的消息它又被激活起来。
那在它的 loop 里边,它其实有两种 loop 实现,一种是普通的 loop(normal_loop) 另外一个呢就是带有性能优化的 overlap loop,也就是我们后面会讲的一个核心实现之一,它默认启用的也是 overlap loop,只有在一些 debug 场景或者有特殊收益的场景,用户才会手动显式指定 normal loop,因为 overlap 默认的这个性能是更好一些的。
那它通过 overlap 的 loop 拉进来的消息,经过后面会讲到的一系列处理之后,最终它会把这个 scheduler 在 GPU 上完成推理调度之后的这样的一个消息再发回 ZMQ 里边,那这次它再发的是什么呢,它再发的就是一个 DetokenizeMsg 了,因为这个时候,它已经是一个推理出来的 token,它需要做的就是 detokenize。
那同样的,在 scheduler 里边,它也是一个并行的系统,它发回去的 DetokenizeMsg 外面又包了一层 BatchTokenizerMsg。
那谁来消费这个消息呢,那就是由第三个组件也就是 detokenizer。
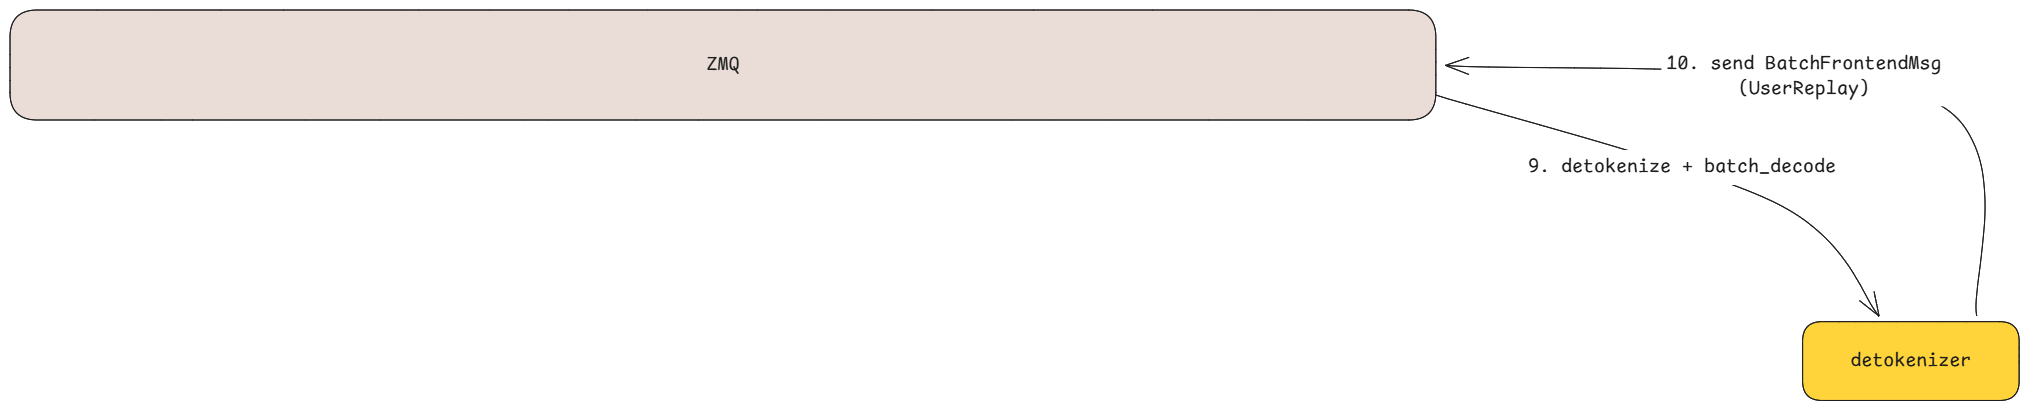
那 detokenizer 也没有太多复杂的内部逻辑,可以看到它不像 Tokenizer 那样支持多副本扩展,连对应的参数都没有,就是固定一个进程,因为它本身的逻辑是比较轻量级的。
那它消费的就是由 scheduler 产生的这个 DetokenizeMsg,那它要做的事情呢其实就是做一个 detokenize,然后也因为在 scheduler 里边已经做了一个 batch 的并行化这个批量的处理,所以 detokenizer 它的 decode 就是一个 batch decode。
那它 batch decode 出来之后,返回回去到 ZMQ 里的消息呢,就是一个叫做 UserReply 这样的一个类型,然后外边因为整体也是批量化的,所以就是一个 BatchFrontendMsg。
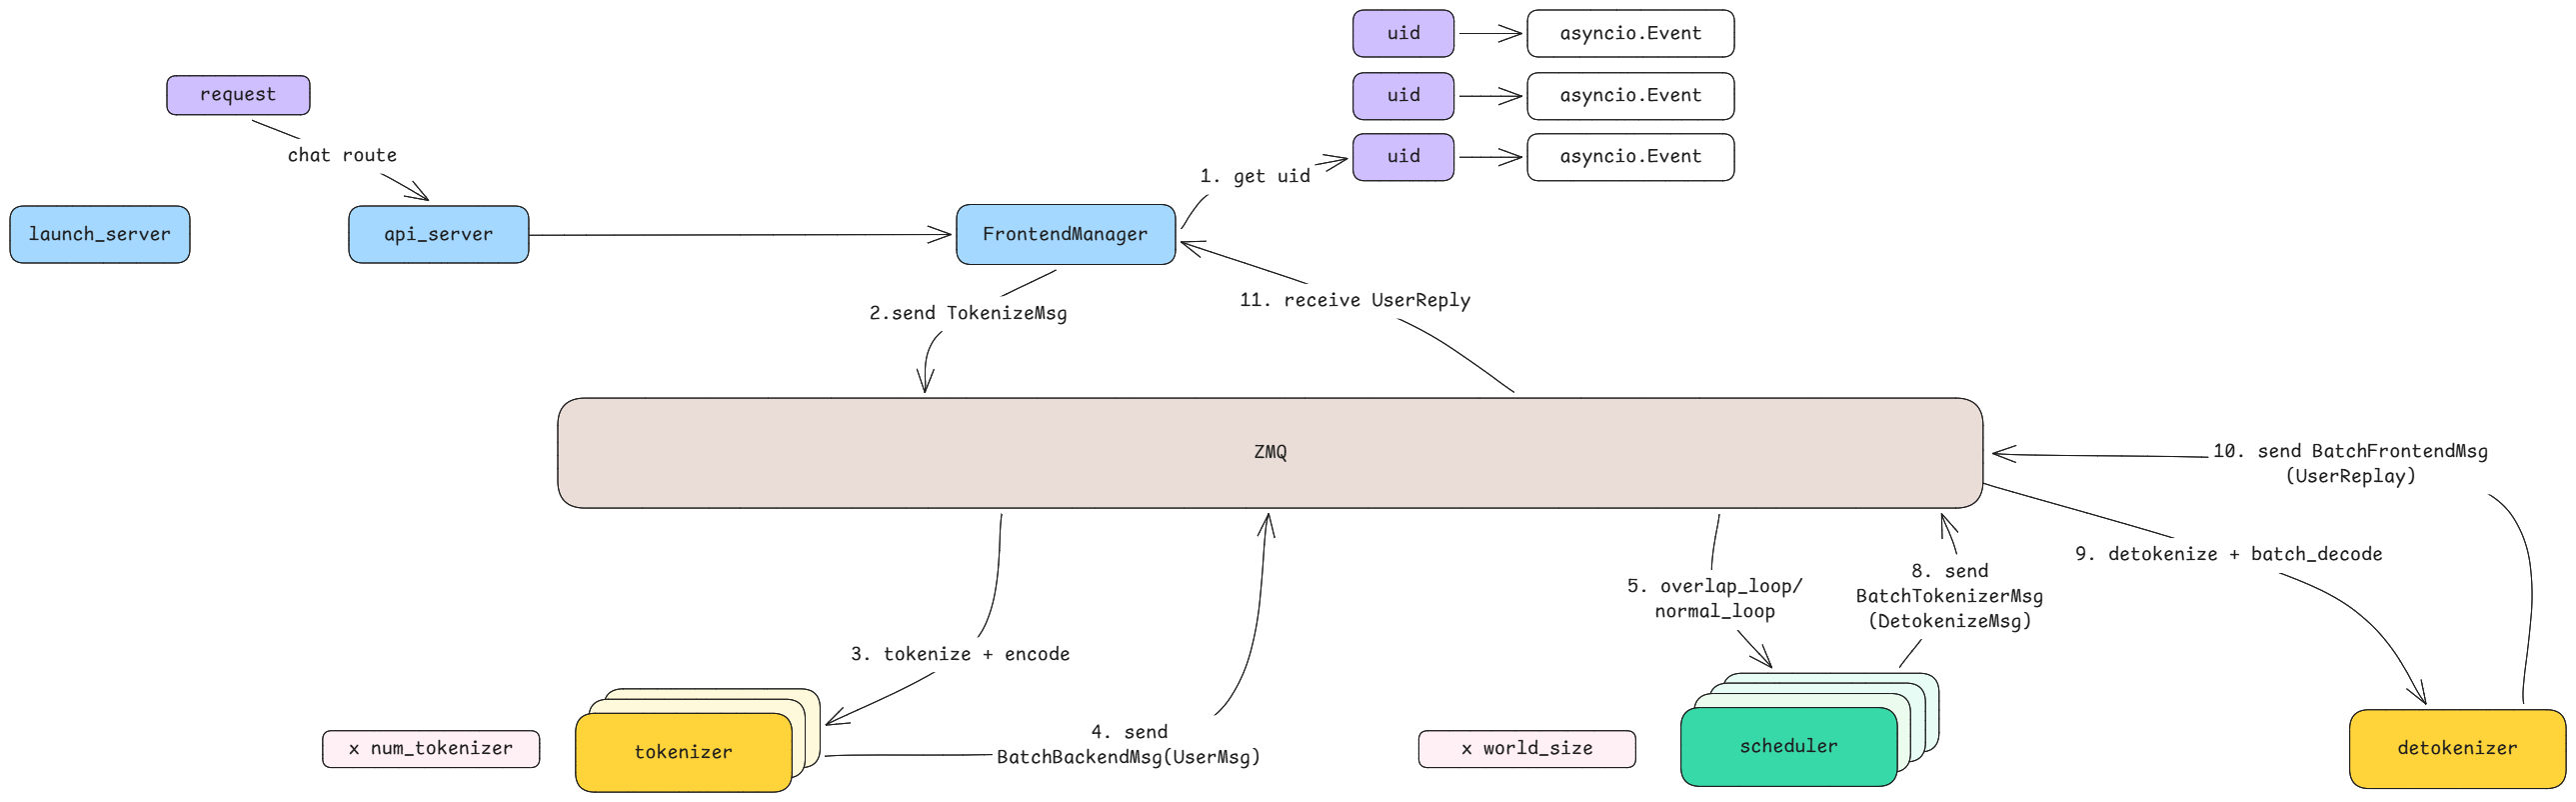
那顾名思义,到了 BatchFrontendMsg 之后谁来消费呢,那又应该 FrontendManager 来消费了,它收到这个 UserReply 之后,就会根据 uid 找到对应的前台的请求的 handler,知道谁在等这个消息。
而且我们也知道在推理里边,很多时候你会使用的是那种 streaming 的模式,也就是一个请求会陆续收到很多切分出来的 token,可能是一个一个往前台吐,它是一个长请求,然后通过 SSE 的协议往前台去推送,所以你既有可能是一个 streaming 的模式,也可能是一个非 streaming 的模式。
然后你不同的模式下,你收到消息之后处理的逻辑是不一样的,有的是要等待所有的数据回来之后一起推送,有的是拿到一个数据就要推送一次,所以在这种复杂的差异化里边,整个刚刚讲到的这样的一个消息队列的模式就显得更为的有价值了,因为它让 streaming 与非 streaming 这两种推理模式得到了很大程度的统一。
对于这个 FrontendManager 来讲,它就不关心你后台做了什么样的进阶的 batch 的处理,也不去关心它里边的一些实现的细节,而是不断的往里边塞前台的这个要 tokenize 的消息,然后最后拿回来的就已经是一个 UserReply,然后它只要去做前台 API 层的一个拼接和协议的推送就可以了,所以就是这样的一个整体的流程。
通过每个组件的入口和出口,我们完成了一次比较完整的走查。
7. Scheduler 核心实现
那我们刚刚跳过的部分是什么呢,就是在核心的 scheduler 里边,因为我们刚刚说了嘛,Tokenizer 和 Detokenizer 都是比较简单的逻辑,而且跟 vLLM 的处理基本一致,所以我们就不用展开去讨论了,但是 scheduler 是有比较大的一个差异化实现的。
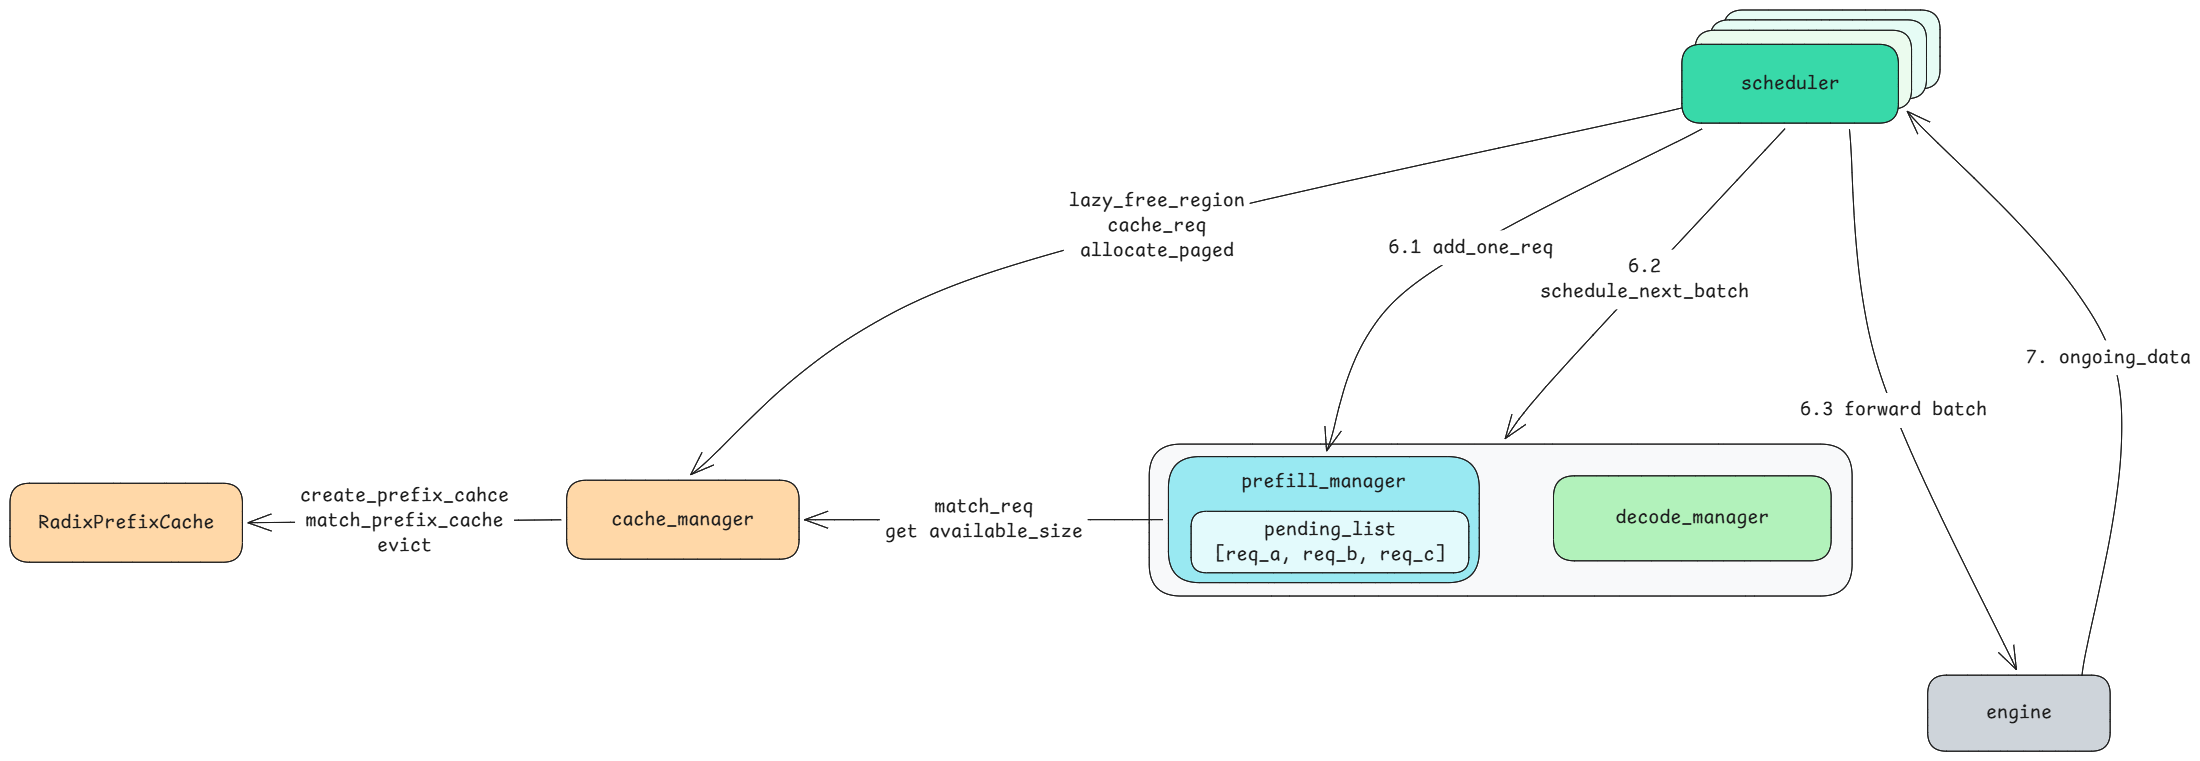
我们刚刚只是看到了,它通过一个 overlap loop 拿进来消息,然后一顿处理之后作为一个 DetokenizeMsg 发回去了,那在第五步和第八步之间 --- 图里我们对每个步骤都编了号 --- 5 到 8 之间到底发生了什么样的细节呢。
7.1 调度主循环:prefill 优先与统一的 ForwardInput
那我们先看一下从 loop 这个入口进来,至于 loop 里边是怎么样做堆叠的,我们一会儿会再展开讲到,但对每个 loop 来说,可以认为它最终一定会取出一条消息去消费,而且这个消息是批量化之后的一组消息。
那对于 scheduler 来说,它拿到的这个请求,它首先就要去决定一下它是要做 prefill 还是要做 decode,因为我们知道这是现在推理的两个核心的逻辑,那对于这个 prefill 阶段来说,其实不管当前在整个 scheduler 里边有没有正在进行的 prefill 或者有没有正在进行的 decode,scheduler 拿到一个请求之后,它都必须做一个动作,就是往 PrefillManager 里边增加一个消息,至少要让 PrefillManager 知道这件事情。
那这里我们说的 PrefillManager 也好,DecodeManager 也好,它都不是独立的进程了,它就是整个 scheduler 进程里边的 Python 的模块而已,所以在这里,我们说投递一个请求,这就没有消息队列的事儿了,只是一个参数的传递。
python
# python/minisgl/scheduler/prefill.py:L117

class PrefillManager:
    cache_manager: CacheManager
    table_manager: TableManager
    decode_manager: DecodeManager
    pending_list: List[PendingReq] = field(default_factory=list)

    def add_one_req(self, req: UserMsg) -> None:
        self.pending_list.append(PendingReq(req.uid, req.input_ids, req.sampling_params))

    ...
而 PrefillManager 的内部其实也相对来讲是比较容易理解的,它就是一个先入先出的这样的一个 pending list 的数据结构,所以在它里边你可能会看到一个空的 pending list,也可能会看到里边已经堆积了一些请求,因为后面可能处理不过来,这里已经积压了一些请求,比如说请求 A、请求 B、请求 C,那你这个时候如果再加入一个新的请求进来,它就会排在最后边一个请求 D。那当它弹出的时候呢,也就是从前面开始,最早加入的就是最先被弹出出去消费,就做这样的一个事情。
但是从 scheduler 的视角,它并不直接从这里取请求,而是始终把请求投递到 pending list 里边。
那第二步做什么呢,第二步它会调一个关键的方法,也就是我们前面看过的那段代码,就是 schedule_next_batch,那这里也是一个关键的批量化处理了,因为 PrefillManager 里边它可能已经积累了一批数据,后边 DecodeManager 它可能也可以一批数据一起做 decode 一起拿回来。
所以在 scheduler 的视角里边,我们之所以把 PrefillManager 和 DecodeManager 封装在一起,就是因为 scheduler 在做这个 schedule_next_batch 调用之前,并不知道这一次要处理的是哪一边。
python
# python/minisgl/scheduler/scheduler.py:L219

def _schedule_next_batch(self) -> ForwardInput | None:
    # TODO: support other policies: e.g. DECODE first
    batch = (
        self.prefill_manager.schedule_next_batch(self.prefill_budget)
        or self.decode_manager.schedule_next_batch()
    )
    return self._prepare_batch(batch) if batch else None
那它调完这个方法之后,就是我们上面看到的这段代码了,PrefillManager 会先说,我有没有一批数据要处理,如果没有的话它就返回一个 None,这个 scheduler 就去问 DecodeManager 你有没有消息要处理,如果也没有的话就代表完全空了。
python
# python/minisgl/scheduler/prefill.py:L126
class PrefillManager:
    ...

    def schedule_next_batch(self, prefill_budget: int) -> Batch | None:
        ...

        self.pending_list = chunked_list + self.pending_list[len(reqs) :]
        return Batch(reqs=reqs, phase="prefill")


# python/minisgl/scheduler/decode.py:L32
class DecodeManager:
    ...

    def schedule_next_batch(self) -> Batch | None:
        if not self.runnable:
            return None
        return Batch(reqs=list(self.running_reqs), phase="decode")
但是不管是 prefill 还是 decode,如果有要处理的消息,它们都会返回一个 Batch 结构,所以两者的返回结构是一样的;区别只在这个结构的内部 --- 它们会通过字段标识一下这是一次 prefill 的 forward 还是一次 decode 的 forward。
所以 6.2 这个步骤(schedule_next_batch)做完之后,两个 manager 返回的 Batch 会由 _prepare_batch 统一转成 ForwardInput,因此 scheduler 拿回来的始终都是一个 forward input,不用它关心这个 input 要投递到哪里、要做哪些组装;标识这个 forward input 的 payload 需要做什么样的处理,是在这两个 manager 模块内部完成的。
而这个 forward input 的这个 payload 被怎么使用呢,就是第三步,有一个叫做 forward batch
这样的一个调用。
python
# python/minisgl/engine/engine.py:L191

def forward_batch(self, batch: Batch, args: BatchSamplingArgs) -> ForwardOutput:
    assert torch.cuda.current_stream() == self.stream
    with self.ctx.forward_batch(batch):
        if self.graph_runner.can_use_cuda_graph(batch):
            logits = self.graph_runner.replay(batch)
        else:
            logits = self.model.forward()

    for req in batch.reqs:
        req.complete_one()

    next_tokens_gpu = self.sampler.sample(logits[: batch.size], args).to(torch.int32)
    next_tokens_cpu = next_tokens_gpu.to("cpu", non_blocking=True)
    copy_done_event = torch.cuda.Event()
    copy_done_event.record(self.stream)
    return ForwardOutput(next_tokens_gpu, next_tokens_cpu, copy_done_event)
这个调用的目标就是我们说的比较黑盒的引擎了,那这个引擎的内部呢,它再去解析这是 prefill 的 input 还是 decode 的 input,然后我去做不同的比较复杂的数据面上的逻辑。
所以这样的一个逻辑的好处,就是让整个 scheduler 的代码就变得非常的简洁,非常的清晰,它不需要去跟数据面紧紧的耦合在一起,它只需要做它真正名称上所说的这个调度的工作就可以了。
那引擎的部分是我们这次内容讲解的一个黑盒。具体到 GPU 上,这个模型是稠密的还是 MoE、它怎么做推理、算子怎么实现,这些就是我们这一个系列不会去讲解的。
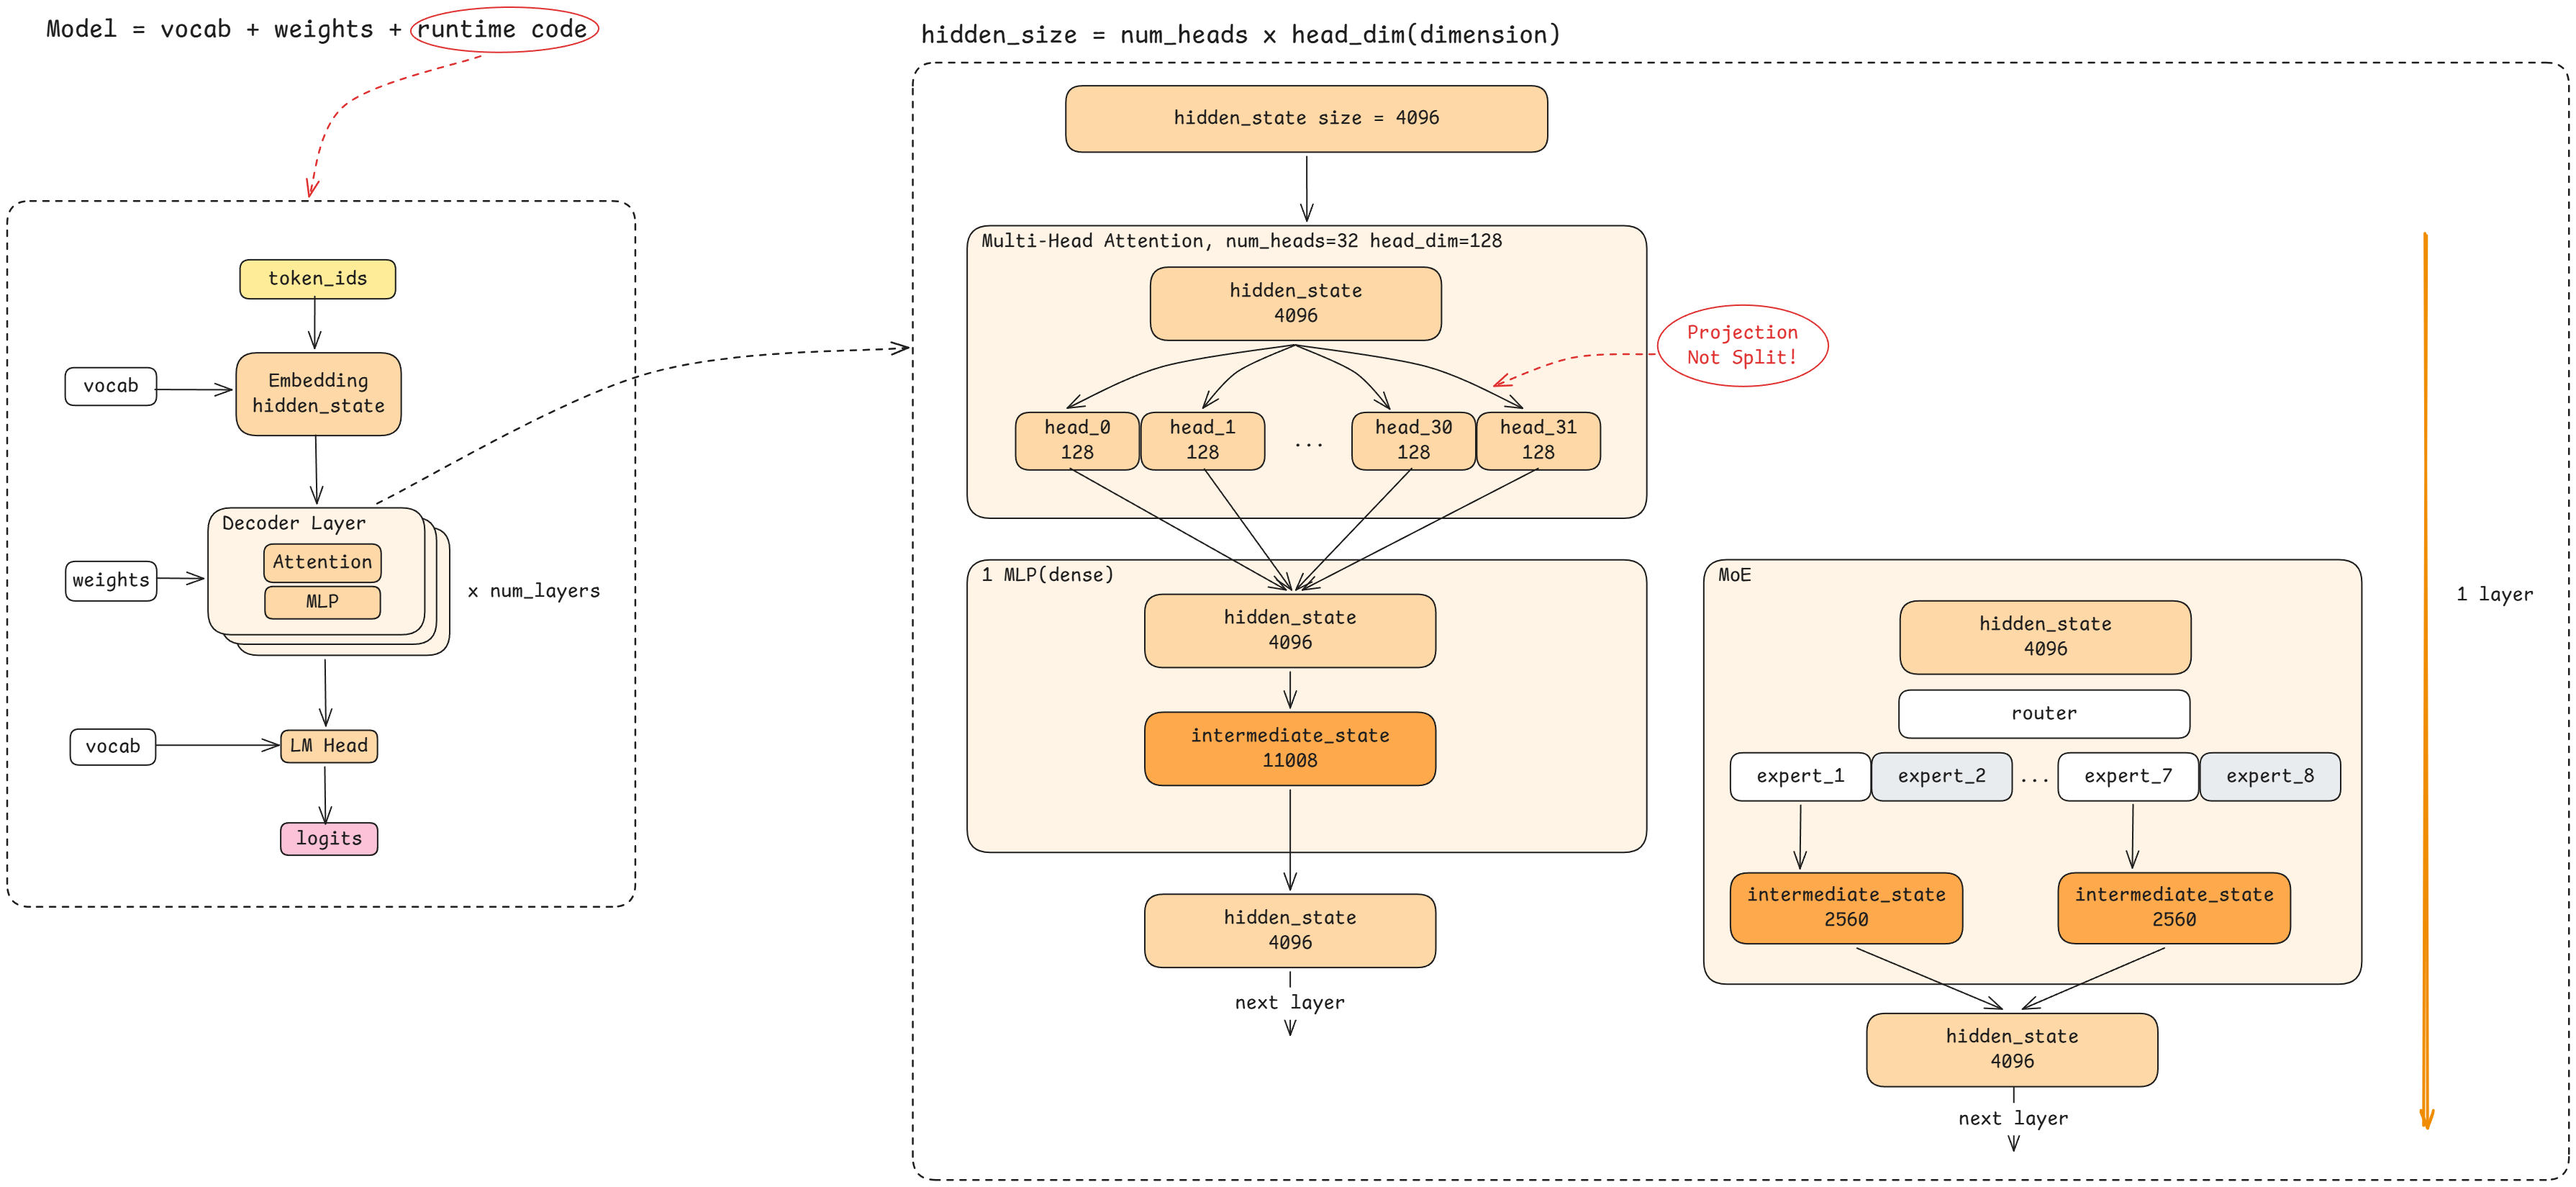
因为我们刚刚也说了,它跟 nano-vllm 里边的 model runner 是相对来讲比较接近的,而我们在 model runner 里边其实已经讲得比较详细了,我们在这里就不重复的去赘述了。
我们就把 engine 理解为一个核心的数据面,它收到的呢是一个 forward 的 input,而它返回回去的呢就是一个 ForwardOutput(在 overlap loop 里被存成 ongoing_data),这样就完成了 GPU 上的工作,并把结果传回给 scheduler。
所以可以看到,当我们把引擎看作一个黑盒的时候,它的整体其实是非常的清晰的,就是专门负责做 GPU 上的工作的一个组件,而 scheduler 就完全不关心里边的细节,甚至连这个消息是一个 prefill 还是一个 decode 它都没有那么的关心了。
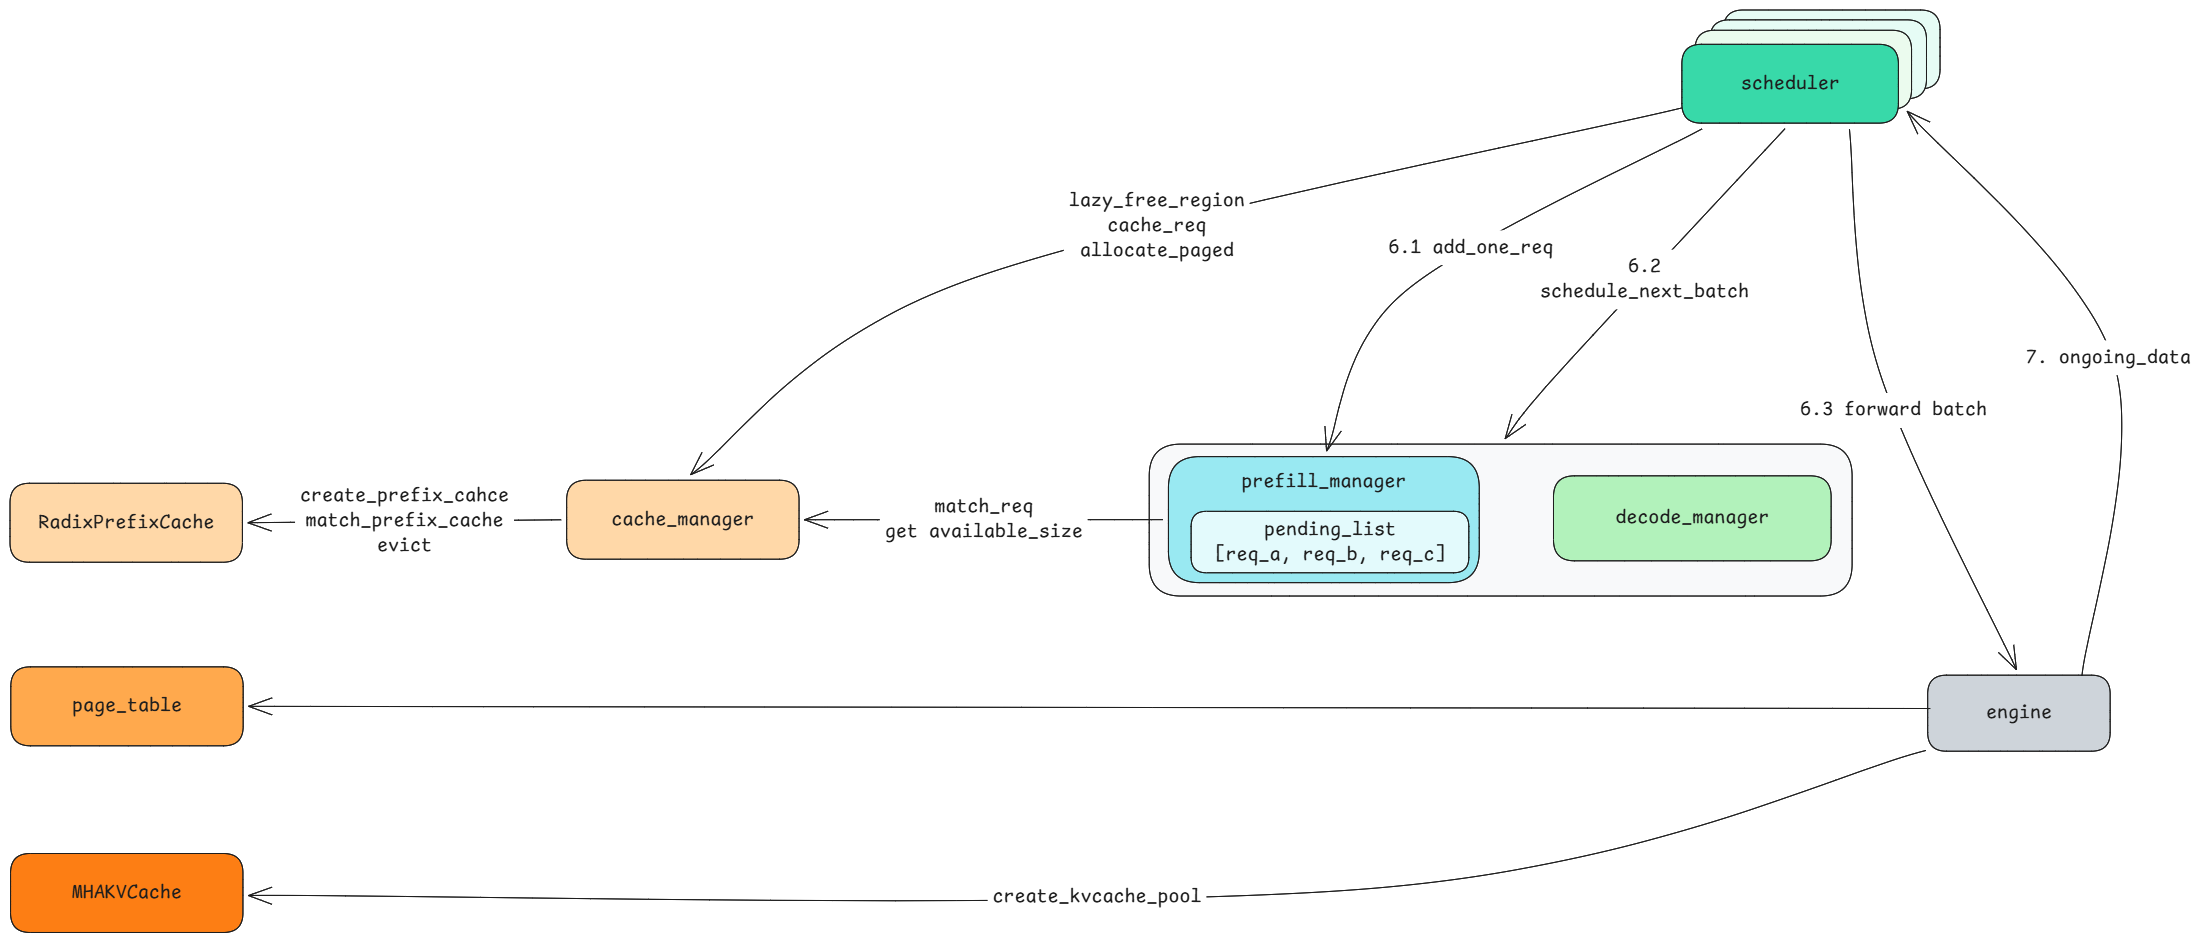
那我们下集要讲的 KV Cache 在什么时候产生效果呢,可以看到我们在刚刚讲的流程里边,你可以假设根本没有 KV Cache 这个组件,整套流程也完全走得通;而 KV Cache 呢,就是一个比较纯粹的、用来优化性能的可插拔组件了。
那对于 KV Cache 来说,在这里我们可以先简单快速地预览一下,在下一集再展开。其实它跟两个组件交互:一个是 PrefillManager --- 因为 KV Cache 优化的是 prefill 这个阶段,所以 PrefillManager 会去跟 KV Cache 交互一下,看看还剩多少空间、当前能命中多少缓存。
另外一个就是引擎,引擎实际会跟 KV Cache 去交互,把那些已经缓存下来的 tensor 给取出来,去加速它内部的计算,所以它们就是这样的一个可插拔的方式去跟我们下集要讲的 KV Cache 交互的,而我们当前也是不涉及。
OK,那这样子拆分之后呢,我们就可以看到在整个 mini-sglang 的后端的三个组件里边其实也都并不复杂,或者说它非常的符合直觉,符合我们对一个推理设施的这样的一个预期,这就是它的架构设计的好的地方。即使我们还没有看到两个比较有意思的实践,也就是 chunked prefill 和 overlap loop,也完全不影响我们理解整体的形态。
而当我们一会儿深入去看这两个性能优化的实现的时候,我们就会发现它也是比较内聚的,它只是把 prefill 又进一步的优化了一下,然后把这个 loop 又进一步的优化了一下,但即使它什么优化都不做它也是可行的,而它做优化的时候它就在具体的地方做优化带来提升就好了,这正是这个架构值得学习的地方。
7.2 chunked prefill
OK,那我们来看一下两个比较有意思的实现吧,第一个是 chunked prefill。
这个 chunked prefill 是什么意思呢,就是因为我们在刚刚说的两个大的流程里边,prefill 和 decode 里边,你是有可能遇到一个非常大块的 prefill 的,你不会遇到一个大块的 decode,因为 decode 默认就是一个一个 token 地往外吐,即使你做了一些 batch 优化,再加上后面的 TP 并行等等,也不太会遇到一次要处理成百上千个 decode token 的场景。
但是 prefill 不一定,尤其现在的大上下文场景,你有可能一下就传进来一个比如 100 万 token 上下文的请求,到了后期的某一次推理的时候,一进来就是一个几十万 token 的 prefill 负载,这完全有可能,所以 prefill 的量级会非常的大。
那它带来的影响是什么呢,它带来的影响就是如果你不做 chunked prefill 这样的一个优化的话,你有可能就会面临说一个非常长的 prefill 的这个请求它完全占据你的 GPU 很长时间,第一,你没有办法做一些优化的调度,第二,如果它一旦出现异常,你重试的成本是非常高的,对吧,因为你就要把这一大段 prefill 整体重算一遍。
那 chunked prefill 它就是来解决这个问题,那它解决这个问题的方法是什么呢,它这里有一个概念叫做 prefill budget,也就是我这个 prefill 有多少预算,那这里的预算指的是一个 token 数量的预算,就在这一次 prefill 里边我最多能处理多少个 token,因为请求之间的长度差异可能非常悬殊:有的请求本身就很大,有的又很小。
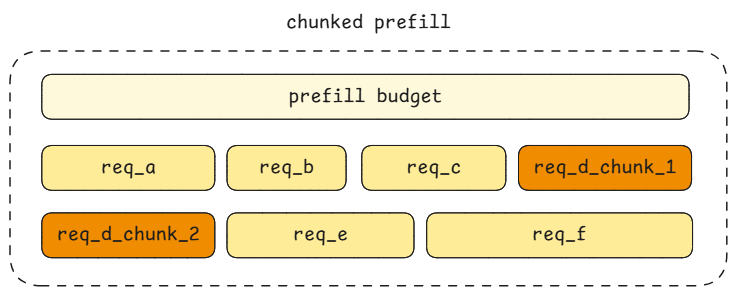
那在 budget 的这个控制之下,它其实关心的就是所有请求加起来、一批能处理的 token 总量,那我们假设它有三个比较小的请求,比如说 a、b、c 三个请求,a 放进来之后离 budget 还有很远,那就尝试往里头放 b,b 也能放下那就继续放 c。
那 a、b、c 都放下之后呢,这时候来了一个比较大的请求 d,而请求 d 它的量级其实是这两个深色的块儿,就是 chunk 1 和 chunk 2 加起来的这个量级,而如果不做切分,请求 d 整体是超过这个 budget 的,所以它没法整个放进来。
那如果你完全不放呢,这个 budget 又空一块,又没有把性能最大化,所以在这里就是所谓的 chunk 做切块的这样的一个处理就发生在这里了。SGLang 里边,它会把这个请求 d 根据 budget 的大小切下一段,所以这里它一次只切出一个 chunk:请求 d 放不下 budget,就按剩余的额度切下前面一段,剩下的部分留到下一轮;如果下一轮还放不下,那就再切一刀---所以一个长请求可能被切成多个 chunk,但每一批里只会带上其中一个。
那它这里,带上了一个 chunk 1 这一批就发出去了,那下一轮呢,下一轮的第一位就应该是被切出来的后半段,也就是请求 d 的 chunk 2,那它如果后半段又塞不满这个 budget 了,那就可以继续往里边放请求 e、放请求 f。
那如果你就那么凑巧,请求 f 正好把 budget 填满了,那它到这里也就一起发出去了,当然,如果这一批没填满,又有新的请求进来,那这里又会发生一次新的切分,所以这就是它所谓的一个 chunked prefill。
具体 chunked 的代码如下:
python
# python/minisgl/scheduler/prefill.py:L65

class PrefillAdder:
    ...

    def _add_one_req(
        self,
        pending_req: PendingReq,
        cache_handle: BaseCacheHandle,
        table_idx: int,
        cached_len: int,
    ) -> Req:
        remain_len = pending_req.input_len - cached_len
        chunk_size = min(self.token_budget, remain_len)
        is_chunked = chunk_size < remain_len
        CLS = ChunkedReq if is_chunked else Req
        self.token_budget -= chunk_size
        self.reserved_size += remain_len + pending_req.output_len
        # NOTE: update the tokens ids only; new pages will be allocated in the scheduler
        _slice = slice(cached_len, cached_len + chunk_size)
        device_ids = self.table_manager.token_pool[table_idx, _slice]
        device_ids.copy_(pending_req.input_ids[_slice].pin_memory(), non_blocking=True)
        return CLS(
            input_ids=pending_req.input_ids[: cached_len + chunk_size],
            table_idx=table_idx,
            cached_len=cached_len,
            output_len=pending_req.output_len,
            uid=pending_req.uid,
            cache_handle=cache_handle,
            sampling_params=pending_req.sampling_params,
        )
那它做这个的目的,我们刚刚也讲到了,它其实核心是为了让它的调度的粒度可以更细,就是避免一个大的请求一直占据着整个这个 prefill 的 scheduler 的这样的一个情况出现。
python
# python/minisgl/scheduler/scheduler.py:L219

def _schedule_next_batch(self) -> ForwardInput | None:
    # TODO: support other policies: e.g. DECODE first
    batch = (
        self.prefill_manager.schedule_next_batch(self.prefill_budget)
        or self.decode_manager.schedule_next_batch()
    )
    return self._prepare_batch(batch) if batch else None
然后我们在代码上呢,也可以看到它标记了一个 TODO:,现在它做了切分之后仍然是持续优先消费 prefill,prefill 全都清空之后才去消费 decode,但是,当做了这个切分之后,它是有能力去实现一些更细粒度的操作的。
比如说,我处理了 N 个 prefill 之后,来了一个高优先级的 decode,那这个时候我就可以先去处理一下 decode 了,我们是可以做这样的一些策略的处理的,具体取决于系统外部用户的实际需求。
OK,所以这就是 chunked prefill 的一个作用。
7.3 overlap loop
那第二个部分呢,就是我们说的 overlap loop 了。
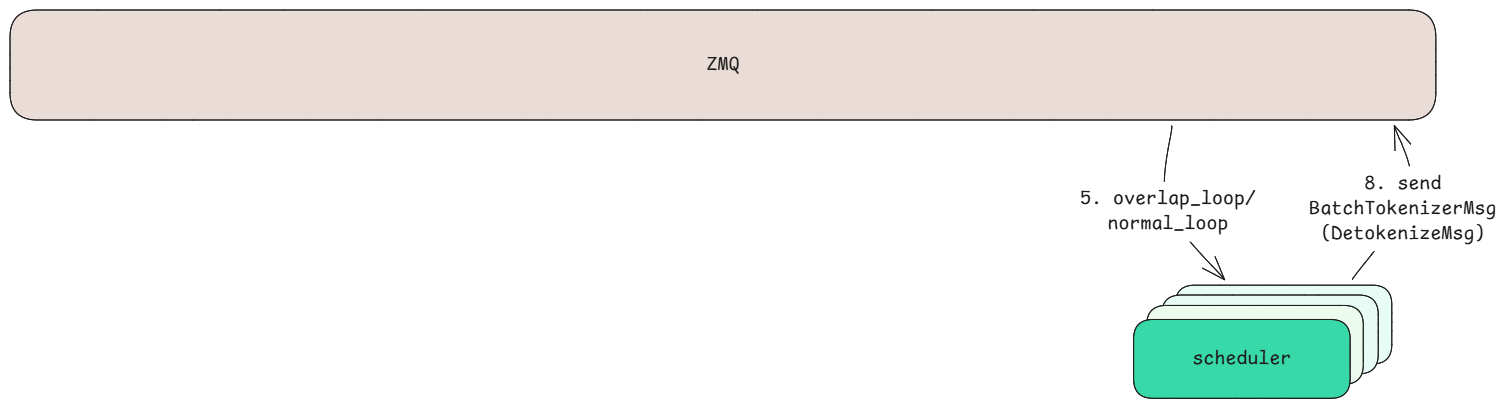
因为对于 loop 来说,它的核心的作用其实就是从 ZMQ 里边去消费 tokenizer 传过来的数据,那 normal loop 就比较朴素:它就是持续不断地拉消息,拉到一个就往 scheduler 里走一轮刚刚说到的所有逻辑。
而 overlap loop 是在做什么事情呢,overlap loop 的核心的思路其实就是要把 GPU 和 CPU 的工作最大程度的并行起来。
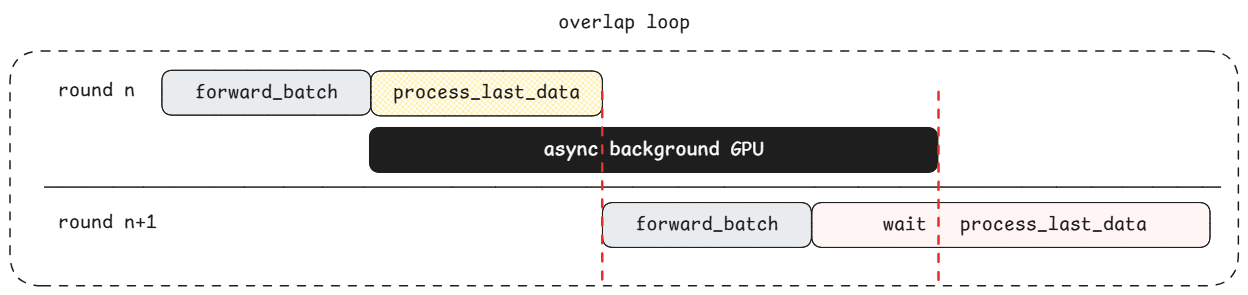
因为我们知道在一个推理引擎的系统里边,其实既有一些 CPU 的工作,也有非常繁重的 GPU 的工作,那你如果完全不做处理的情况下,通常来讲这两部分的工作是不会堆叠的,也就是先处理完 CPU 再处理 GPU,处理完 GPU 又是处理 CPU,它们是串行的一个逻辑。
那如果是一种串行的逻辑呢,那就意味着你处理 CPU 的时候 GPU 是闲着的,你处理 GPU 的时候呢 CPU 是闲着的,那这个资源就没有最大化,对吧。
那 overlap loop 呢,它其实就是通过稍微复杂一点的异步化的处理来让 CPU 和 GPU 可以产生执行上的一些堆叠,然后来尽量减少两者空闲的一个时间就是这样的一个思路。
所以我们看 overlap loop 的设计的时候呢我们需要看两轮,因为它是两轮之间去做堆叠,那我们假设上面一轮是处理到了第 n 条消息,那下一轮呢就是处理第 n+1 条消息了,我们在图中做了一个分割线。
那这个消息的处理发生在什么地方呢,就应该是发生在跟 GPU 有关的地方,因为你是要把 GPU 上的工作跟 CPU 上的工作堆叠,所以我们刚刚代码里面哪个地方跟 GPU 开始交互呢,就是在 forward batch 这个位置才开始交互,然后 forward batch 拿回来之后是一个 ongoing_data,这又回到 CPU 的世界里面对吧,所以这里是 GPU 和 CPU 的一个关键的交接处。
python
# python/minisgl/scheduler/scheduler.py:L83

class Scheduler(SchedulerIOMixin):
    ...

    def overlap_loop(self, last_data: ForwardData | None) -> ForwardData | None:
        """
        The main loop of overlapping scheduling and execution.

        It will overlap the execution of current batch and processing of last batch's results,
        which can effectively hide CPU latency and improve GPU utilization.
        """
        blocking = not (
            last_data is not None  # don't block if we have a batch to be processed
            or self.prefill_manager.runnable
            or self.decode_manager.runnable
        )
        for msg in self.receive_msg(blocking=blocking):
            self._process_one_msg(msg)

        forward_input = self._schedule_next_batch()
        ongoing_data = None
        if forward_input is not None:
            with self.engine_stream_ctx:  # run the batch in the engine's stream
                self.engine.stream.wait_stream(self.stream)
                ongoing_data = (forward_input, self._forward(forward_input))

        self._process_last_data(last_data)
        return ongoing_data
那在代码处理逻辑上,我们就会看到有一个 forward batch 的处理和一个 process last data 的一个处理,那其实这里的 forward batch 它只是把它投递到 GPU 那一侧,比如说在英伟达的卡上它就是投递到 CUDA 的那一侧,它的工作就完成了,所以 forward batch 它不是一个同步的 API。
所以大家可以理解一下,就是在第 n 轮的时候,其实 scheduler 只负责把第 n 轮的这个 payload 扔给 GPU,它就不管了,它就去 process last data 了,那这个所谓的 last data 是什么呢,其实是第 n-1 轮(也就是上一轮)的数据,但是在这里我们还没讲到,所以可以先忽略第 n 轮的 process last data 过程,因为我们在第 n+1 会看到,所以在这里我们可以先忽略黄色的这个框,我们重点还是看第 n 轮的 GPU 的处理。
在第 n 轮里边,scheduler 它把这个 GPU 上的工作投递过去以后呢它就不管了,而这个 GPU 的工作在后台运行,它的耗时通常比 CPU 侧更长。我们在这里用深色的这个 async 的框来标记,所以当第 n 轮结束的时候,完全有可能 process last data 提前结束了,那当它结束之后呢你第 n 轮就整体结束了。
而你第 n 轮它其实还残留了一个更重的 GPU 数据跑在后台的,但是这个时候呢,你的 overlap loop 已经不等了,它不等这个更加繁重的 GPU 工作了,它直接干嘛呢,只要有消息进来,它直接就去开启第 n+1 轮了,那当它开启这个第 n+1 轮的时候,我们可以看到第 n 轮的后台的 GPU 工作还在跑着,但是,第 n+1 轮的这样的一个新的 forward batch 它又开始了。
关键是什么呢,我们可以看到,当第 n+1 轮的工作开始的时候,第 n 轮的 GPU 工作很可能是还没有结束的,而且这个 GPU 工作它可能持续很长,但是在它持续的过程中,第 n+1 轮的前台还是可以去往 GPU 上派发工作,因为这个派发本身就是一个异步的动作,而且派发之前还有一些 CPU 侧的准备工作要做,所以可以看到深色的 GPU 在处理工作的时候,既有上一轮的这里的 CPU 工作,又有下一轮的这里的 CPU 工作,CPU 是不闲着的,CPU 资源是被最大化的利用的。
但是有可能呢,第 n+1 轮的 CPU 的工作做完之后,你上一轮的 GPU 工作还没结束,对吧,所以所谓的 process last data 它这轮要干嘛呢,它要把上一轮的 GPU 结果取出来回投给 ZMQ,这样你才能做后边的 detokenize,所以在这个时候,在 process last data 里边,其实它会先做一个 wait 的动作。
OK,这里是一个核心啊,那 wait 的时机是什么呢,其实这里 wait 等待的就是上一轮的异步的 GPU 工作的完成,然后它在本轮里用 CPU 去消费那个数据,继续往 detokenizer 上边去投递,做的就是这样的一个事情。
所以我们说的堆叠其实就是下一轮的 CPU 工作跟上一轮的 GPU 工作之间的堆叠,这就是它的一个 overlap loop 的一个实现了,也是通过这种实现呢它就进一步地去提升了整个 SGLang 的一个性能的表现。
OK,那我们上集的内容就分享到这里,我们完整地看了一下它的整体架构、它的调度逻辑以及一些内部优化的细节实现,那 KV Cache 的部分,包括它这个很有代表性的 Radix Cache 的数据结构的设计,我们就在下集的内容里边再跟大家分享,我们下期再见。
结语
本篇文章我们主要从整体架构和调度逻辑的角度,对 mini-sglang 这个项目做了一次较为完整的梳理,重点关注了一个在线推理服务从接收请求到返回生成结果,中间都需要经过哪些核心组件,以及这些组件之间是如何通过消息队列协同工作的。
在开头部分,我们先介绍了 mini-sglang 这个项目本身的定位。它虽然和 nano-vllm 一样是一个极简实现,但不同的是它直接维护在 SGLang 官方的代码组织下,并且天然带有在线推理的完整链路。我们也花了一点篇幅聊了项目作者的背景和他的代码风格,这种对可读性与简洁性的追求,在后面阅读它的源码时是能持续感受到的。随后我们对整篇内容做了拆分说明:上集主要关注整体架构与调度逻辑,下集则会继续展开 KV Cache 以及 SGLang 最有代表性的 Radix Cache 的内部细节。
在正式进入源码之前,我们还一起搭建了项目的运行环境,体验了 Shell 模式和 Online Serving 模式两种使用方式,并配置了后续调试所需要的环境。这里值得再提一句的是,mini-sglang 在启动时会按空闲显存的固定比例一次性预分配整个 KV Cache 池,所以即使只跑一个 0.6B 的小模型,显存占用看起来也会接近拉满,这一点在调试时可以通过 memory_ratio 参数来调整。
在整体架构部分,我们从最前台的 API Server 开始,看到了 FrontendManager 是如何用 uid 来管理多个并发的推理请求、并通过 asyncio 的 event 等待后台结果的。接着我们分析了 ZMQ 这一套横跨所有进程的通信设施,以及它强类型的消息设计---正是因为这个设计,我们只要看到一个消息类型,就能知道它由谁投递、又被谁消费。在此基础上,我们又依次梳理了 Tokenizer、Scheduler 和 Detokenizer 这三个后台组件的入口与出口,包括 tokenizer 如何通过多副本做横向扩展,以及它在默认情况下又是如何与 detokenizer 共享同一个进程的。
在 Scheduler 小节中,我们重点梳理了一次推理请求在调度器内部的完整流程:请求如何进入 PrefillManager 的 pending 队列,schedule_next_batch 又是如何按照 prefill 优先的策略取出下一批要执行的数据,以及 prefill 和 decode 两条路径最终如何通过统一的 ForwardInput 收敛到一起、再交给 engine 去执行。这里可以看到,Scheduler 本身并不关心 GPU 上的数据面细节,它只负责它名字里所说的那件事---调度。
接下来我们还看了两个比较有意思的实现。第一个是 chunked prefill,它通过 prefill budget 把一个巨大的 prefill 请求切成多个 chunk,既避免了长请求长时间独占 GPU,也为更细粒度的调度策略留出了入口;第二个是 overlap loop,它让下一轮消息的接收与调度,与上一轮仍在后台执行的 GPU 计算重叠起来,直到处理上一轮结果时再去等待它完成,从而把一部分 CPU 侧的开销隐藏掉。
整体来看,上集的内容虽然没有展开模型在 GPU 上的执行细节,也刻意跳过了 KV Cache 的部分,但已经从一个在线推理服务的视角,把一个推理引擎需要完成的主要工作串联了起来:请求接入、进程间通信、组件拆分、批处理调度,以及在此之上的性能优化。也正因为整个架构把前台与后台、调度与数据面都做了解耦,chunked prefill 和 overlap loop 这两个优化才能像插件一样即插即用。
下一篇文章我们就会把上集里一直当作可插拔组件跳过的 KV Cache 彻底展开,看看 SGLang 为什么会选择 Radix Cache 这样一棵前缀树,而不是 vLLM 那样的 block 管理方式,以及一次请求在缓存命中、插入和淘汰时的具体细节,敬请期待 🤗。