🔥铅笔小新z:个人主页
🎬博客专栏:C语言
💫滴水不绝,可穿石;步履不休,能至渊。
目录
- 深入理解指针(1)
- 内存和地址
- 指针变量和地址
- 指针变量类型的意义
- 指针运算
- 深入理解指针(2)
- const 修饰指针
- 野指针
- assert 断言
- 指针的使用和传址调用
- 深入理解指针(3)
- 数组名的理解
- 使用指针访问数组
- 一维数组传参的本质
- 冒泡排序
- 二级指针
- 指针数组
- 深入理解指针(4)
- 字符指针变量
- 数组指针变量
- 二维数组传参的本质
- 函数指针变量
- 函数指针数组与转移表
- 深入理解指针(5)
- 回调函数
- qsort 使用举例
- qsort 的模拟实现
- 深入理解指针(6)
- sizeof 和 strlen 的对比
- 数组和指针笔试题解析
- 指针运算笔试题解析
一、深入理解指针(1)
这一讲是地基,我们只搞清楚一件事:指针到底是什么,为什么它这么重要。先不急着写复杂代码,把"内存和地址"这个根本问题想明白,后面全是顺理成章。
1. 内存和地址
1.1 内存
先讲一个生活场景。
假设有一栋宿舍楼,楼里住着很多人,你的朋友来找你玩。如果每个房间都没有门牌号,那朋友只能一间一间地敲门,效率极低。可如果给每个房间都编上号:
一楼:101,102,103,104 ...
二楼:201,202,203,204 ...
那朋友只要拿到你的房间号,就能直接找到你,又快又准。
把这件事搬到计算机里,道理一模一样。
我们知道,CPU(中央处理器)在处理数据时,数据是从内存里读出来 的,处理完再放回内存。我们买电脑时看到的 8GB / 16GB / 32GB,说的就是内存的大小。这么大一片内存空间,怎么高效地管理呢?
答案就是:把内存划分成一个个内存单元,每个内存单元的大小是 1 个字节(1Byte),然后给每个单元都编上号。
先把计算机里的单位理清楚(这是基础中的基础):
| 单位 | 换算关系 |
|---|---|
| bit(比特位) | 能存一个二进制位 0 或 1 |
| Byte(字节) | 1 Byte = 8 bit |
| KB | 1 KB = 1024 Byte |
| MB | 1 MB = 1024 KB |
| GB | 1 GB = 1024 MB |
| TB | 1 TB = 1024 GB |
| PB | 1 PB = 1024 TB |
一个内存单元(1 字节)就像一个"八人间宿舍",里面能住 8 个比特位(每个人是一个比特位)。而每个内存单元都有一个编号,这个编号就相当于宿舍的门牌号。
我们把内存单元的编号,叫做 地址(address) 。而 C 语言给"地址"起了一个新的名字,就叫------指针(pointer)。
所以这里有一个非常重要的等式,请牢牢记住:
内存单元的编号 == 地址 == 指针用一张图来表示内存长什么样:
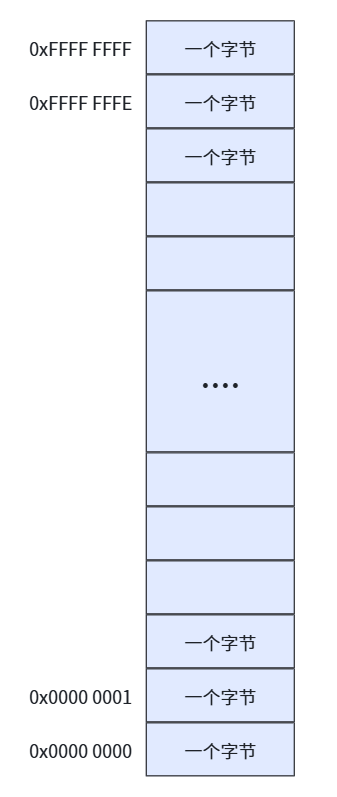
一句话总结:计算机把内存划分成一个个大小为 1 字节的内存单元,每个单元都有一个唯一的编号,这个编号叫"地址";C 语言中地址也叫"指针",所以"内存单元的编号 == 地址 == 指针"。指针本质就是一个编号、一个地址,用来定位内存中的某一块空间。
1.2 究竟该如何理解编址
计算机内部有非常多的硬件单元(CPU、内存、硬盘......),它们要互相协作,就必须能互相传递数据。而硬件之间是各自独立的,怎么通信?用"线"连起来。
CPU 和内存之间有大量的数据交互,所以它们之间也连着很多线。其中有一组线特别关键,叫 地址总线(Address Bus)。
CPU 要访问内存中的某个字节,就必须知道这个字节在内存的哪个位置。因为内存里的字节非常多,所以需要给内存编址------就像宿舍很多,需要给宿舍编号一样。
画一张 CPU 和内存的连接图:
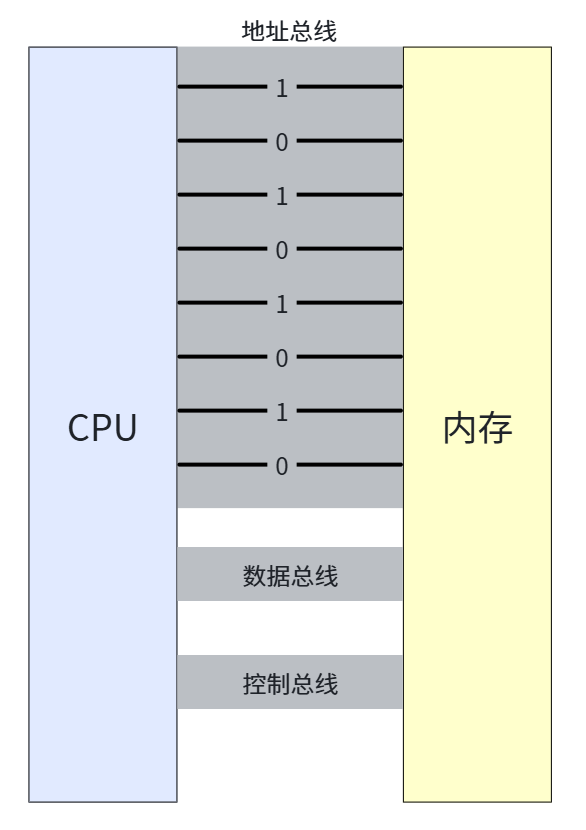
地址总线:告诉内存"我要找哪个编号的空间"
数据总线:真正传输数据
控制总线:传输读写等控制信号
这里有一个很巧妙的设计:编址不是把每个字节的地址用软件记录下来的,而是通过硬件设计完成的。
打个比方:钢琴、吉他上面并没有写着"哆、来、咪、发、唆"这些字,但演奏者照样能准确找到每一根弦、每一个音。为什么?因为制造商已经在硬件层面把位置设计好了,演奏者之间也约定俗成------这本质是一种约定出来的共识。硬件编址也是这样。
以 32 位机器为例:它有 32 根地址总线。每根线只有两种状态,表示 0 或 1(有没有电脉冲)。于是:
- 1 根线 → 2 种含义(0、1)
- 2 根线 → 4 种含义(00、01、10、11)
- 32 根线 → 2^32 种含义
每一种含义,就对应一个地址。所以 32 位机器最多能表示 2^32 个地址(也就是大约 4GB 的寻址空间)。
CPU 把地址信息下达给内存,内存就能根据这个地址找到对应的数据,再通过数据总线把数据传回 CPU 的寄存器。
一句话总结:CPU 和内存之间通过地址总线、数据总线、控制总线相连;给内存编址是硬件层面的约定。32 位机器有 32 根地址线,能表示 2^32 个地址;64 位机器有 64 根地址线,能表示 2^64 个地址。CPU 通过地址总线把地址发给内存,再通过数据总线完成数据的读写。
2. 指针变量和地址
2.1 取地址操作符(&)
回到 C 语言。在 C 语言里创建一个变量,其实就是向内存申请了一块空间。比如:
c
#include <stdio.h>
int main()
{
    int a = 10;   // 创建整型变量 a,向内存申请 4 个字节,用来放整数 10
    return 0;
}
int a = 10; 这行代码,就是让内存腾出 4 个字节(int 占 4 字节)的空间来存放 10。这 4 个字节,每个都有自己的地址,假设分别是:
0x006FFD70
0x006FFD71
0x006FFD72
0x006FFD73(内存地址通常是十六进制,0x 开头表示十六进制数)
那我们怎么拿到变量 a 的地址呢?就要用到 取地址操作符 &:
c
#include <stdio.h>
int main()
{
    int a = 10;
    &a;                   // 取出 a 的地址(单独写没啥意义,一般要存起来或打印)
    printf("%p\n", &a);   // %p 专门用来打印地址(指针)
    return 0;
}
按照上面的图,程序会打印出类似 006FFD70 这样的值。
这里有个关键点:&a 取出来的是 a 占的 4 个字节中地址最小的那个字节的地址。
用图表示变量 a 在内存中的存储:
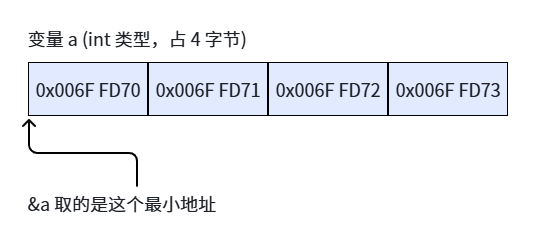
虽然 int 占了 4 个字节,但我们只要知道第一个字节(最低地址)的地址,就能"顺藤摸瓜"访问到这 4 个字节的数据。
一句话总结 :创建变量就是向内存申请空间;用取地址操作符
&可以拿到变量的地址,它取的是该变量所占内存中地址最小的那个字节的地址。用%p可以打印地址。
2.2 指针变量和解引用操作符(*)
2.2.1 指针变量
&a 拿到的是一个地址值,比如 0x006FFD70。这个地址值本身也是一个数据,有时候需要把它存起来,方便以后再用。那这个地址值存到哪里呢?答案是:指针变量。
c
#include <stdio.h>
int main()
{
    int a = 10;
    int * pa = &a;   // 取出 a 的地址,存到指针变量 pa 中
    return 0;
}
指针变量也是一种变量,只不过它是专门用来存放地址的。 存放在指针变量里的值,都会被理解为"地址"。
2.2.2 如何拆解指针类型
看到 int * pa = &a;,这个 int * 类型该怎么理解呢?我们拆开看:
c
int a = 10;
int * pa = &a;   // pa 左边的 * 说明 pa 是指针变量
// 前面的 int 说明 pa 指向的是 int 类型的对象*:说明pa是一个指针变量。int:说明pa这个指针指向的是 int 类型的数据。
那如果有一个 char 类型的变量 ch,它的地址应该放进什么类型的指针变量呢?
c
char ch = 'w';
char * pc = &ch; // pc 指向 char 类型,所以类型是 char*指针的类型要跟它指向的对象的类型匹配,这样才能正确解释它指向的那块内存。
2.2.3 解引用操作符
我们把地址存起来,将来是要用的。怎么用?
现实生活中,拿到门牌号,是为了找到那个房间,进房间去取东西或放东西。C 语言里也一样:拿到地址(指针),就可以通过这个地址找到它指向的对象。这里就需要解引用操作符 *。
c
#include <stdio.h>
int main()
{
    int a = 100;
    int * pa = &a;   // pa 里存的是 a 的地址
    *pa = 0;         // *pa 就是通过 pa 里的地址找到的空间,也就是 a 本身
    return 0;        // 所以 *pa = 0 等价于 a = 0
}
第 7 行的 *pa,意思就是"通过 pa 中存放的地址,找到它指向的那块空间"。因为 pa 指向 a,所以 *pa 其实就是 a。*pa = 0; 就是"把 a 改成 0"。
有同学会想:直接把 a 改成 0 的话,写 a = 0; 不就行了吗?为什么还要绕一圈用指针?
原因是:用指针就把"修改 a"这件事交给了 pa 来操作,这样对 a 的修改就多了一种途径,写代码会更灵活。等到后面讲函数传参、链表、动态内存时,你会越来越感受到这种"间接操作"的强大。
可以用图表示 pa 和 a 的关系:
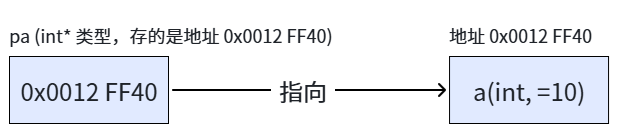
一句话总结 :指针变量是专门存放地址的变量;声明时
int *pa中的*表示 pa 是指针,int表示它指向 int 类型数据。用&取地址,用*(解引用操作符)通过地址找到并操作它指向的对象,*pa就等价于a本身。
2.3 指针变量的大小
前面说过,32 位机器有 32 根地址线,一个地址就是 32 个二进制位(bit),也就是 4 个字节。既然指针变量是专门存放地址的,那么指针变量的大小就必须能装下一个地址,所以是 4 字节。
同理,64 位机器的地址是 64 个 bit,也就是 8 个字节,所以指针变量的大小是 8 字节。
c
#include <stdio.h>
// 指针变量的大小取决于地址的大小
// 32 位平台:地址是 32 个 bit,即 4 字节
// 64 位平台:地址是 64 个 bit,即 8 字节
int main()
{
    printf("%zd\n", sizeof(char *));    // 打印各种指针类型的大小
    printf("%zd\n", sizeof(short *));
    printf("%zd\n", sizeof(int *));
    printf("%zd\n", sizeof(double *));
    return 0;
}
程序的输出结果(根据环境不同):
X86(32位)环境输出:   4 4 4 4
X64(64位)环境输出:   8 8 8 8
结论:
- 32 位平台下,指针变量大小是 4 字节;
- 64 位平台下,指针变量大小是 8 字节;
- 指针变量的大小和它的类型无关 ------不管
char*、int*还是double*,在同一个平台下大小都相同。
一句话总结:指针变量的大小取决于地址的大小,与指针的类型无关。32 位平台是 4 字节,64 位平台是 8 字节,同一平台下所有指针类型大小都一样。
3. 指针变量类型的意义
既然指针大小和类型无关,那为什么还要有 int*、char*、double* 各种各样的指针类型呢?因为指针类型有它特殊的意义,主要体现在两方面:解引用时的权限、加减整数时的步长。
3.1 指针的解引用(权限)
对比下面两段代码,重点是在调试时观察内存的变化。
c
// 代码1
#include <stdio.h>
int main()
{
    int n = 0x11223344;   // n 的 4 个字节分别是 11 22 33 44
    int * pi = &n;
    *pi = 0;              // int* 解引用,能操作 4 个字节
    return 0;             // 结果:n 的 4 个字节全部变成 0
}
c
// 代码2
#include <stdio.h>
int main()
{
    int n = 0x11223344;
    char * pc = (char *)&n;  // 把 &n 强制转换成 char* 存进 pc
    *pc = 0;                 // char* 解引用,只能操作 1 个字节
    return 0;                // 结果:n 只有第 1 个字节变成 0
}
调试时可以看到:代码 1 会把 n 的 4 个字节全部改成 0;而代码 2 只把 n 的第 1 个字节改成 0。
结论:指针的类型决定了,对指针解引用时有多大的权限(一次能操作几个字节)。
char*解引用只能访问 1 个字节;int*解引用能访问 4 个字节。
一句话总结 :指针类型决定了"解引用时的权限",也就是通过这个指针一次能操作几个字节。
char*能操作 1 字节,int*能操作 4 字节。
3.2 指针 ± 整数(步长)
再看一段代码,调试观察地址的变化。
c
#include <stdio.h>
int main()
{
    int n = 10;
    char * pc = (char*)&n;   // pc 指向 n,但类型是 char*
    int * pi = &n;           // pi 指向 n,类型是 int*

    printf("%p\n", &n);      // 打印 n 的地址
    printf("%p\n", pc);      // pc 的值
    printf("%p\n", pc + 1);  // pc+1 跳过 1 个字节
    printf("%p\n", pi);      // pi 的值
    printf("%p\n", pi + 1);  // pi+1 跳过 4 个字节
    return 0;
}
运行结果(地址是示意值):
&n   = 0x00AFF974
pc   = 0x00AFF974
pc+1 = 0x00AFF975   ← 比 pc 大了 1(1 字节)
pi   = 0x00AFF974
pi+1 = 0x00AFF978 ← 比 pi 大了 4(4 字节)可以看到:char* 类型的指针 +1 跳过 1 个字节 ,int* 类型的指针 +1 跳过 4 个字节。
指针 +1,其实跳过的是"1 个它指向的元素"的大小。char 元素占 1 字节,所以 char* +1 走 1 字节;int 元素占 4 字节,所以 int* +1 走 4 字节。指针可以 +1,当然也可以 -1。
结论:指针的类型决定了指针向前或向后走一步的距离(步长)。
一句话总结 :指针类型决定了"指针 ± 整数"的步长,即指针加 1 或减 1 时跳过多少个字节。
char* +1走 1 字节,int* +1走 4 字节,本质是跳过 1 个它指向类型的元素。
3.3 void* 指针
指针类型里有一种特殊类型叫 void*,可以理解为"无具体类型的指针"(也叫泛型指针)。它的特点是:可以接收任意类型的地址 。但它也有局限:void* 类型的指针不能直接进行加减整数和解引用的运算。
举例:
c
#include <stdio.h>
int main()
{
    int a = 10;
    int* pa = &a;
    char* pc = &a;   // 把 int 变量的地址赋给 char*,编译器会给出警告(类型不兼容)
    return 0;
}
上面把 int 变量的地址赋给 char*,VS2022 编译会给出这样的警告:
warning C4133: "初始化": 从 "int *" 到 "char *" 的类型不兼容而使用 void* 类型接收地址,就不会有这种警告:
c
#include <stdio.h>
int main()
{
    int a = 10;
    void* pa = &a;   // void* 可以接收任意类型的地址,不报警告
    void* pc = &a;

    *pa = 10;        // 错误:void* 不能直接解引用
    *pc = 0;         // 错误:void* 不能直接解引用
    return 0;
}
VS 编译这段代码会报错:
error C2100: 非法的间接寻址
warning C4047: "=": "void" 与 "int" 的间接级别不同可以看到:void* 能接收任意类型的地址,但无法直接进行指针运算。
那 void* 到底有什么用呢?它一般用在函数参数里,用来接收不同类型数据的地址,从而实现"泛型编程"的效果------让一个函数能处理多种类型的数据。
一句话总结 :
void*是无具体类型的指针(泛型指针),能接收任意类型地址,但不能直接解引用和加减整数,需要先强制转换成具体类型指针才能用;它主要用于函数参数,实现一个函数处理多种类型数据的泛型编程。
4. 指针运算
指针的基本运算有三种:
- 指针 ± 整数
- 指针 - 指针
- 指针的关系运算
4.1 指针 ± 整数
因为数组在内存中是连续存放的,所以只要知道第一个元素的地址,就能"顺藤摸瓜"找到后面的所有元素。
先看数组元素和下标的关系:
数组 int arr[10] = {1,2,3,4,5,6,7,8,9,10};

元素:  1   2   3   4   5   6   7   8   9   10
下标:  0   1   2   3   4   5   6   7   8   9
地址: arr  arr+1 arr+2 ...               arr+9
c
#include <stdio.h>
// 用指针 +- 整数来访问数组
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    int * p = &arr[0];                  // p 指向数组首元素
    int i = 0;
    int sz = sizeof(arr) / sizeof(arr[0]);  // 计算数组元素个数
    for (i = 0; i < sz; i++)
    {
        printf("%d ", *(p + i));        // p+i 就是指针 + 整数,*(p+i) 取出第 i 个元素
    }
    return 0;
}
4.2 指针 - 指针
两个指针相减,得到的是它们之间相隔的元素个数(前提是两个指针指向同一块空间,比如同一个数组)。
c
#include <stdio.h>
// 用指针 - 指针来求字符串长度
int my_strlen(char * s)
{
    char * p = s;            // p 从字符串开头出发
    while (*p != '\0')       // 只要没到字符串结尾(\0)
        p++;                 // p 一直向后走
    return p - s;            // p 和 s 之间相隔的字符个数,就是字符串长度
}
int main()
{
    printf("%d\n", my_strlen("abc"));   // 输出 3
    return 0;
}
4.3 指针的关系运算
指针也可以用 <、>、== 等比较大小(本质是比较地址的大小),通常用来做边界判断。
c
#include <stdio.h>
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    int * p = &arr[0];
    int sz = sizeof(arr) / sizeof(arr[0]);
    while (p < arr + sz)    // 指针的大小比较:只要 p 没走到数组末尾之后
    {
        printf("%d ", *p);
        p++;
    }
    return 0;
}一句话总结:指针有三大运算:① 指针 ± 整数,表示向前/向后移动若干个元素(步长由类型决定);② 指针 - 指针,得到两个指针相隔的元素个数(要求指向同一块连续空间);③ 指针的关系运算,比较地址大小,常用于循环的边界判断。
二、深入理解指针(2)
这一讲讲指针的"纪律"和安全问题:怎么用 const 保护数据,什么是野指针、怎么避免它,以及指针在函数传参里的大用处。
1. const 修饰指针
1.1 const 修饰变量
变量本来是可以修改的。如果把变量的地址交给一个指针变量,就能通过这个指针去修改那个变量。但如果我们希望某个变量被"保护"起来、不允许被修改,该怎么做呢?这就要用到 const。
c
#include <stdio.h>
int main()
{
    int m = 0;
    m = 20;           // m 可以修改,没问题
    const int n = 0;
    n = 20;           // 错误!n 被 const 修饰,不能被修改
    return 0;
}
上面的 n 本质还是变量,只是被 const 修饰后,在语法上加了限制:只要在代码里直接修改 n,就不符合语法规则,会报错。
但是,如果我们"绕过" n,用 n 的地址去修改它,还是能做到的(虽然这是在打破语法规则):
c
#include <stdio.h>
int main()
{
    const int n = 0;
    printf("n = %d\n", n);   // 打印 0
    int* p = &n;
    *p = 20;                 // 通过指针间接修改 n
    printf("n = %d\n", n);   // 打印 20,n 被改了!
    return 0;
}
程序运行结果:
n = 0
n = 20
可以看到确实被改了。但我们要思考一下:为什么 n 要加 const?就是为了不被修改。如果 p 拿到 n 的地址就能改 n,那就打破了 const 的限制,这不合理。所以我们应该让 p 拿到 n 的地址后也不能修改 n,这就引出了 const 修饰指针变量。
1.2 const 修饰指针变量
const 修饰指针变量时,可以放在 * 的左边,也可以放在 * 的右边,两种写法的意义完全不同。
c
int * p;          // 没有 const 修饰
int const * p;    // const 放在 * 的左边(等于 const int *p)
int * const p;    // const 放在 * 的右边
我们用四段代码来逐个验证:
c
#include <stdio.h>

// 代码1:无 const 修饰
void test1()
{
    int n = 10;
    int m = 20;
    int* p = &n;
    *p = 20;      // ok:可以修改指向的内容
    p = &m;       // ok:也可以修改 p 本身(让它指向别处)
}

// 代码2:const 放在 * 的左边(const int* p)
void test2()
{
    int n = 10;
    int m = 20;
    const int* p = &n;
    *p = 20;      // 报错!const 在 * 左边,指向的内容不能通过 p 修改
    p = &m;       // ok:p 本身可以修改,指向别处
}

// 代码3:const 放在 * 的右边(int * const p)
void test3()
{
    int n = 10;
    int m = 20;
    int * const p = &n;
    *p = 20;      // ok:可以修改指向的内容
    p = &m;       // 报错!const 在 * 右边,p 本身不能被修改
}

// 代码4:* 的左右两边都有 const
void test4()
{
    int n = 10;
    int m = 20;
    int const * const p = &n;
    *p = 20;      // 报错:不能修改内容
    p = &m;       // 报错:也不能修改 p 本身
}

int main()
{
    test1();   // 测试无 const
    test2();   // 测试 const 在 * 左边
    test3();   // 测试 const 在 * 右边
    test4();   // 测试左右都有 const
    return 0;
}
结论:
- const 放在
*的左边 :修饰的是指针指向的内容,保证指针指向的内容不能通过这个指针被改变,但指针变量本身(它存的地址)可以变。 - const 放在
*的右边 :修饰的是指针变量本身,保证指针变量里存的地址不能改,但指向的内容可以通过指针改变。
一个帮助记忆的小技巧:把 * 当成分界线,"const 在 * 左边,锁的是内容;const 在 * 右边,锁的是指针本身"。
一句话总结 :const 修饰指针有两种情况------
const在*左边(如const int *p)修饰的是指针指向的内容,此时内容不能通过指针修改,但指针本身可以指向别处;const在*右边(如int * const p)修饰的是指针变量本身,此时指针不能再指向别处,但指向的内容可以修改。口诀:左锁内容,右锁指针。
2. 野指针
概念:野指针就是指针指向的位置是不可知的(随机的、不正确的、没有明确限制的)。 用野指针去访问内存,是非常危险的。
2.1 野指针成因
成因 1:指针未初始化
c
#include <stdio.h>
int main()
{
    int * p;      // 局部指针变量未初始化,默认是随机值
    *p = 20;      // 危险!p 指向一个随机地址,去访问它可能崩溃
    return 0;
}
局部变量 p 没初始化,里面是随机值。用这个随机值当地址去写数据,相当于"把 20 写到不知道哪里的内存",可能引发程序崩溃。
成因 2:指针越界访问
c
#include <stdio.h>
int main()
{
    int arr[10] = {0};
    int * p = &arr[0];
    int i = 0;
    for (i = 0; i <= 11; i++)   // 注意:循环条件写成了 <= 11,超出了数组范围
    {
        *(p++) = i;             // 当 p 越出数组 arr 时,p 就是野指针
    }
    return 0;
}
数组只有 10 个元素(下标 0~9),循环却访问到了下标 10、11,越界了。越界后的 p 就是野指针。
成因 3:指针指向的空间被释放
c
#include <stdio.h>
int* test()
{
    int n = 100;
    return &n;      // n 是局部变量,函数结束就销毁了,返回它的地址是危险的
}
int main()
{
    int* p = test();
    printf("%d\n", *p);   // p 指向的空间已经被释放,此时 p 就是野指针(悬空指针)
    return 0;
}
n 是 test 函数里的局部变量,函数一返回,n 所占的内存就被释放了。返回 &n 后,main 里的 p 指向的是一块已经"作废"的空间,这时 p 也叫"悬空指针",是野指针的一种。
2.2 如何规避野指针
(1)指针初始化
- 如果明确知道指针该指向哪里,就直接赋给它一个有效的地址;
- 如果暂时不知道指向哪里,就给它赋
NULL。
NULL 是 C 语言定义的一个标识符常量,值就是 0。0 也可以看作地址,但这个地址是不能使用的,读写它会报错。
c
#ifdef __cplusplus
    #define NULL 0            // C++ 中 NULL 就是 0
#else
    #define NULL ((void *)0)  // C 中 NULL 是 (void*)0
#endif
初始化示例:
c
#include <stdio.h>
int main()
{
int num = 10;
int * p1 = # // 知道指向哪里,直接赋值有效地址
int * p2 = NULL; // 不知道指向哪里,赋 NULL
return 0;
}(2)小心指针越界
程序向内存申请了哪些空间,指针就只能访问哪些空间,不能超出范围。超出了就是越界访问。
(3)指针不再使用时及时置 NULL,使用前检查有效性
当指针不再用来访问某块空间时,及时把它置为 NULL。约定俗成的规则是:只要是 NULL 指针就不去访问,同时使用指针前先判断它是否为 NULL。
这里有一个非常形象的比喻:把野指针想象成野狗 。野狗放任不管非常危险,所以我们可以找一棵树把它拴起来,就相对安全了。给指针及时赋 NULL,就像把野狗拴起来------把野指针暂时管理起来。
不过,野狗即使拴起来了,我们也要绕着走,不能去挑逗它。对于指针也一样:使用之前先判断是否为 NULL,如果是(被拴住的野狗),就不能直接用;如果不是,才去使用。
c
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    int * p = &arr[0];
    int i = 0;
    for (i = 0; i < 10; i++)
    {
        *(p++) = i;   // 使用 p 访问数组
    }
    // 此时 p 已经越界了,把它置为 NULL
    p = NULL;

    // 下次使用时,先判断 p 是否为 NULL,再使用
    p = &arr[0];      // 重新让 p 获得有效地址
    if (p != NULL)    // 使用前检查有效性
    {
        // 安全地使用 p ...
    }
    return 0;
}
(4)避免返回局部变量的地址
也就是成因 3 里的例子,不要返回局部变量的地址。
一句话总结:野指针是指针指向了不可知的位置,成因主要有三种:指针未初始化、指针越界访问、指针指向的空间已释放。规避方法:① 指针要初始化(不知道指向哪里就赋 NULL);② 小心越界;③ 指针不用时及时置 NULL、用前先判断是否为 NULL;④ 不要返回局部变量的地址。
3. assert 断言
assert.h 头文件里定义了一个宏 assert(),用于在运行时确保程序符合指定条件。如果条件不符合,就报错并终止运行。这个宏常被称为"断言"。
c
assert(p != NULL); // 断言 p 不等于 NULL程序运行到这一行时,会验证 p 是否等于 NULL:
- 如果 p 确实不等于 NULL,assert 什么都不做,程序继续运行;
- 如果 p 等于 NULL(条件为假),assert 会报错,在标准错误流 stderr 里写出一条错误信息,显示没通过的表达式 ,以及包含这个表达式的文件名和行号。
assert 对程序员非常友好,好处有:能自动标识出问题和行号,而且还有一种无需改代码就能开关 assert 的机制。如果已经确认程序没问题,不想再做断言,就在 #include <assert.h> 的前面定义一个宏 NDEBUG:
c
#define NDEBUG          // 定义了 NDEBUG 后,编译时就会禁用所有 assert
#include <assert.h>
重新编译,编译器就会禁用文件里所有的 assert() 语句。如果程序又出问题了,删掉这行 #define NDEBUG(或注释掉)再编译,就重新启用了 assert。
assert 的缺点是:引入了额外检查,会增加程序运行时间。
一般我们会在 Debug(调试)版本 里使用 assert,在 Release(发布)版本里禁用 assert。在 VS 这类集成开发环境中,Release 版本会直接把 assert 优化掉。这样,Debug 版本有利于排查问题,Release 版本不影响用户使用时的效率。
一句话总结:assert 是断言宏(在 assert.h 中),用于在运行时检查条件是否为真,为假就报错终止并提示文件名和行号。定义 NDEBUG 可以一键禁用所有 assert。通常 Debug 版本开启、Release 版本关闭,方便调试又不影响性能。
4. 指针的使用和传址调用
4.1 strlen 的模拟实现
库函数 strlen 的功能是求字符串长度,统计的是字符串中 \0 之前字符的个数。
c
size_t strlen ( const char * str );参数 str 接收字符串的起始地址,然后向后逐个统计 \0 之前的字符个数,最后返回长度。
模拟实现:从起始地址开始向后逐个遍历字符,只要不是 \0 就让计数器 +1,直到遇到 \0 停止。
c
#include <stdio.h>
#include <assert.h>

int my_strlen(const char * str)
{
    int count = 0;
    assert(str);            // 使用前断言 str 不为 NULL,防止野指针
    while (*str)            // *str 非 0(不是 '\0')就继续
    {
        count++;            // 每遇到一个字符,计数 +1
        str++;              // 指针向后移动一位
    }
    return count;           // 返回统计到的字符个数
}

int main()
{
    int len = my_strlen("abcdef");   // 计算字符串长度
    printf("%d\n", len);             // 输出 6
    return 0;
}
4.2 传值调用和传址调用
学习指针的目的是用指针解决问题。那什么问题,非用指针不可呢?
举个例子:写一个函数,交换两个整型变量的值。
一番思考后,我们可能先写出这样的代码:
c
#include <stdio.h>
void Swap1(int x, int y)   // 传值调用:把 a、b 的值拷贝给 x、y
{
    int tmp = x;
    x = y;
    y = tmp;               // 这里交换的是 x、y,不是 a、b
}

int main()
{
    int a = 0;
    int b = 0;
    scanf("%d %d", &a, &b);                 // 输入 a 和 b,比如 10 20
    printf("交换前:a=%d b=%d\n", a, b);    // 交换前:a=10 b=20
    Swap1(a, b);
    printf("交换后:a=%d b=%d\n", a, b);    // 交换后:a=10 b=20(没交换成功)
    return 0;
}
运行结果:
10 20
交换前:a=10 b=20
交换后:a=10 b=20我们发现,根本没产生交换的效果。为什么?调试一下看看:
在 main 函数里创建了 a 和 b,假设:
- a 的地址是
0x00cffdd0 - b 的地址是
0x00cffdc4
调用 Swap1 时,把 a、b 的值传给了 Swap1,Swap1 内部创建了形参 x、y 来接收 a、b 的值。但是:
- x 的地址是
0x00cffcec - y 的地址是
0x00cffcf0
x、y 确实收到了 a、b 的值,但 x 的地址和 a 不一样,y 的地址和 b 也不一样。也就是说,x、y 是两块独立的空间。在 Swap1 内部交换 x、y,自然影响不到 a、b。等 Swap1 调用结束回到 main,a、b 还是老样子。
像 Swap1 这样,把变量本身直接传给函数,就叫做传值调用。
结论:实参传给形参时,形参会单独创建一份临时空间来接收实参的值,对形参的修改不影响实参。 所以 Swap1 失败了。
那怎么解决呢?我们希望调用 Swap 时,Swap 内部操作的就是 main 里的 a、b。这时就要用指针了:在 main 里把 a、b 的地址传给 Swap,Swap 里通过地址间接操作 main 里的 a、b,就能完成交换。
c
#include <stdio.h>
void Swap2(int* px, int* py)   // 传址调用:把 a、b 的地址传给 px、py
{
    int tmp = 0;
    tmp = *px;   // tmp = *px,也就是 tmp = a
    *px = *py;   // *px = *py,也就是 a = b
    *py = tmp;   // *py = tmp,也就是 b = tmp
}
int main()
{
    int a = 0;
    int b = 0;
    scanf("%d %d", &a, &b);                 // 输入 10 20
    printf("交换前:a=%d b=%d\n", a, b);    // 交换前:a=10 b=20
    Swap2(&a, &b);                          // 传地址
    printf("交换后:a=%d b=%d\n", a, b);    // 交换后:a=20 b=10
    return 0;
}
运行结果:
10 20
交换前:a=10 b=20
交换后:a=20 b=10
成功交换了!
像 Swap2 这样,把变量的地址传给函数,就叫做传址调用。
传址调用可以让函数和主调函数之间建立真正的联系,在函数内部就能修改主调函数里的变量。
所以今后写函数时记住这条原则:
- 函数只需要用到主调函数里的变量值 来做计算,就用传值调用;
- 函数内部要修改 主调函数里的变量的值,就必须用传址调用。
一句话总结:传值调用时,形参是实参的一份临时拷贝,两者是独立空间,所以修改形参不影响实参;传址调用时,把变量的地址传给函数,函数通过指针解引用就能直接操作主调函数里的变量。当函数需要修改主调函数里的变量时,必须用传址调用。
三、深入理解指针(3)
这一讲开始把指针和数组结合,还会讲到二级指针和指针数组,是指针进阶的关键一步。
1. 数组名的理解
前面我们用指针访问数组时,写过这样的代码:
c
int arr[10] = {1,2,3,4,5,6,7,8,9,10};
int *p = &arr[0];   // 用 &arr[0] 拿到数组首元素的地址
这里用 &arr[0] 拿到了数组第一个元素的地址。但其实数组名本身就是地址,而且是数组首元素的地址。我们来测试一下:
c
#include <stdio.h>
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    printf("&arr[0] = %p\n", &arr[0]);   // 首元素地址
    printf("arr     = %p\n", arr);       // 数组名
    return 0;
}
输出结果(地址是示意值):
&arr[0] = 004FF9CC
arr = 004FF9CC结果一模一样,说明数组名就是数组首元素(第一个元素)的地址。
这时有同学会问:如果数组名就是首元素的地址,那下面的代码怎么解释?
c
#include <stdio.h>
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    printf("%d\n", sizeof(arr));   // 输出 40
    return 0;
}
输出结果是 40。如果 arr 是首元素的地址,那 sizeof(arr) 应该是 4 或 8 才对(一个指针的大小)。为什么是 40 呢?
原来,"数组名就是首元素地址"这个说法是对的,但有两个例外:
sizeof(数组名):sizeof 里单独放数组名,这里的数组名表示整个数组 ,计算的是整个数组的大小 (单位字节)。所以sizeof(arr)是 10 个 int = 10×4 = 40。&数组名:这里的数组名表示整个数组 ,取出的是整个数组的地址(整个数组的地址和首元素的地址是有区别的)。
除了这两个例外,任何地方使用数组名,数组名都表示首元素的地址。
有好奇的同学可能再试一下这段代码:
c
#include <stdio.h>
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    printf("&arr[0] = %p\n", &arr[0]);
    printf("arr     = %p\n", arr);
    printf("&arr    = %p\n", &arr);
    return 0;
}
三个打印结果一模一样!那 arr 和 &arr 到底有什么区别呢?继续往下看:
c
#include <stdio.h>
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    printf("&arr[0]   = %p\n", &arr[0]);
    printf("&arr[0]+1 = %p\n", &arr[0]+1);
    printf("arr       = %p\n", arr);
    printf("arr+1     = %p\n", arr+1);
    printf("&arr      = %p\n", &arr);
    printf("&arr+1    = %p\n", &arr+1);
    return 0;
}
输出结果:
&arr[0]   = 0077F820
&arr[0]+1 = 0077F824    ← 相差 4 字节
arr       = 0077F820
arr+1     = 0077F824    ← 相差 4 字节
&arr      = 0077F820
&arr+1    = 0077F848    ← 相差 40 字节!
分析:
&arr[0]和arr都是首元素的地址 ,+1 就是跳过一个元素(4 字节),所以&arr[0]与&arr[0]+1差 4,arr与arr+1也差 4。&arr是整个数组的地址 ,+1 操作是跳过整个数组 (10×4 = 40 字节),所以&arr与&arr+1相差 40。
虽然 arr、&arr、&arr[0] 打印出来的地址值一样,但它们的类型不一样,所以 +1 的步长不一样。
一句话总结 :数组名在绝大多数情况下表示数组首元素的地址,只有两个例外------
sizeof(数组名)计算的是整个数组的大小,&数组名取出的是整个数组的地址。虽然arr、&arr、&arr[0]的地址值相同,但类型不同,导致它们 +1 的步长不同:首元素地址 +1 走一个元素,数组地址 +1 走整个数组。
2. 使用指针访问数组
有了前面的知识,再结合数组连续存放的特点,就能很方便地用指针访问数组了。
c
#include <stdio.h>
int main()
{
    int arr[10] = {0};
    int i = 0;
    int sz = sizeof(arr) / sizeof(arr[0]);   // 元素个数

    // 输入:用指针给数组赋值
    int* p = arr;                            // arr 就是首元素地址,赋给 p
    for (i = 0; i < sz; i++)
    {
        scanf("%d", p + i);                  // p+i 是第 i 个元素的地址
        // 也可以写成 scanf("%d", arr + i);
    }

    // 输出
    for (i = 0; i < sz; i++)
    {
        printf("%d ", *(p + i));             // *(p+i) 取出第 i 个元素
    }
    return 0;
}
把这个代码搞明白后,我们再思考:数组名 arr 是首元素地址,可以赋给 p,说明在这里 arr 和 p 是等价的 。那我们能用 arr[i] 访问数组元素,那 p[i] 能访问吗?
c
#include <stdio.h>
int main()
{
    int arr[10] = {0};
    int i = 0;
    int sz = sizeof(arr) / sizeof(arr[0]);
    int* p = arr;
    for (i = 0; i < sz; i++)
    {
        scanf("%d", p + i);
    }
    for (i = 0; i < sz; i++)
    {
        printf("%d ", p[i]);   // 用 p[i] 代替 *(p+i),也能正常打印
    }
    return 0;
}
把 *(p+i) 换成 p[i] 也能正常打印。这说明本质上是等价的:
p[i]  ==  *(p + i)
arr[i] == *(arr + i)
其实数组元素的访问,在编译器处理时,也是转换成"首元素地址 + 偏移量"求出元素地址,再解引用来访问的。所以 [] 运算符本质上就是一种指针运算。
一句话总结 :用指针访问数组时,
p[i]和*(p+i)完全等价,arr[i]和*(arr+i)也等价。数组元素访问本质就是"首元素地址 + 偏移量再解引用",[]运算符底层就是指针运算。
3. 一维数组传参的本质
数组是可以传给函数的。这一小节讨论数组传参的本质。
先从一个问题开始:我们之前在函数外部计算数组元素个数,那能不能把数组传给函数后,在函数内部求数组元素个数呢?
c
#include <stdio.h>
void test(int arr[])                       // 形参写成数组形式
{
    int sz2 = sizeof(arr) / sizeof(arr[0]);  // 在函数内部求元素个数
    printf("sz2 = %d\n", sz2);
}
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    int sz1 = sizeof(arr) / sizeof(arr[0]);  // 在函数外部求元素个数
    printf("sz1 = %d\n", sz1);
    test(arr);
    return 0;
}
输出结果(X86 环境下):
sz1 = 10
sz2 = 1
在函数外部 sz1 正确算出了 10,但在函数内部 sz2 却是 1(因为指针是 4 字节,int 是 4 字节,4/4=1)。这说明在函数内部无法正确获得数组元素个数。
为什么?这就要学数组传参的本质了。
上一节我们学过:数组名是数组首元素的地址。那么数组传参时,传递的是数组名,本质上就是传递数组首元素的地址。
所以函数形参部分,理论上应该用指针变量 来接收首元素的地址。在函数内部写 sizeof(arr),计算的是一个地址的大小(单位字节),而不是整个数组的大小。正是因为函数的参数部分本质是指针,所以在函数内部没法求数组元素个数。
c
#include <stdio.h>
void test(int arr[])              // 参数写成数组形式,本质上还是指针
{
    printf("%d\n", sizeof(arr));  // 计算的是指针变量的大小
}
void test2(int* arr)              // 参数写成指针形式
{
    printf("%d\n", sizeof(arr));  // 同样计算的是指针变量的大小
}
int main()
{
    int arr[10] = {1,2,3,4,5,6,7,8,9,10};
    test(arr);
    test2(arr);
    return 0;
}
总结:一维数组传参,形参部分可以写成数组形式,也可以写成指针形式,本质都是指针。
一句话总结 :一维数组传参时,传递的其实是数组首元素的地址,形参本质上是指针。所以形参可以写成数组形式(
int arr[])也可以写成指针形式(int* arr),并且在函数内部用sizeof求不到数组大小,只能得到指针大小。这就是数组传参的本质。
4. 冒泡排序
冒泡排序的核心思想是:两两相邻的元素进行比较,把较大的往后"冒"。
比如要对数组从小到大排序:每一轮从头开始,比较相邻两个元素,如果前面的比后面的大,就交换。这样一轮下来,最大的元素就"冒"到了最后。然后对剩下的元素重复这个过程。
c
#include <stdio.h>
// 方法1:基本冒泡排序
void bubble_sort(int arr[], int sz)   // sz 是数组元素个数
{
    int i = 0;
    for (i = 0; i < sz - 1; i++)      // 一共需要 sz-1 轮
    {
        int j = 0;
        for (j = 0; j < sz - i - 1; j++)  // 每轮比较 sz-i-1 次
        {
            if (arr[j] > arr[j + 1])   // 前一个比后一个大,就交换
            {
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
            }
        }
    }
}
int main()
{
    int arr[] = {3,1,7,5,8,9,0,2,4,6};
    int sz = sizeof(arr) / sizeof(arr[0]);  // 元素个数
    bubble_sort(arr, sz);                   // 排序
    int i = 0;
    for (i = 0; i < sz; i++)
    {
        printf("%d ", arr[i]);              // 打印排序后的数组
    }
    return 0;
}
方法 2(优化版):如果某一轮比较下来一次都没交换,说明数组已经有序了,后面的轮次就可以提前结束,节省时间。
c
#include <stdio.h>
// 方法2:优化版冒泡排序
void bubble_sort(int arr[], int sz)
{
    int i = 0;
    for (i = 0; i < sz - 1; i++)
    {
        int flag = 1;              // 假设这一轮已经有序了
        int j = 0;
        for (j = 0; j < sz - i - 1; j++)
        {
            if (arr[j] > arr[j + 1])
            {
                flag = 0;          // 一旦发生交换,说明还没排好序
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
            }
        }
        if (flag == 1)             // 这一轮没交换,说明已经有序
            break;                 // 提前退出
    }
}
int main()
{
    int arr[] = {3,1,7,5,8,9,0,2,4,6};
    int sz = sizeof(arr) / sizeof(arr[0]);
    bubble_sort(arr, sz);
    int i = 0;
    for (i = 0; i < sz; i++)
    {
        printf("%d ", arr[i]);
    }
    return 0;
}一句话总结:冒泡排序的核心是"两两相邻元素比较,大的往后冒"。共进行 sz-1 轮,每轮比较 sz-i-1 次相邻元素并交换,时间复杂度 O(n²)。可以加一个 flag 标记,若某轮没有发生交换则提前结束,减少不必要的比较。
5. 二级指针
指针变量也是变量,是变量就有地址。那指针变量的地址存放在哪里呢?答案就是二级指针。
先看一张图:
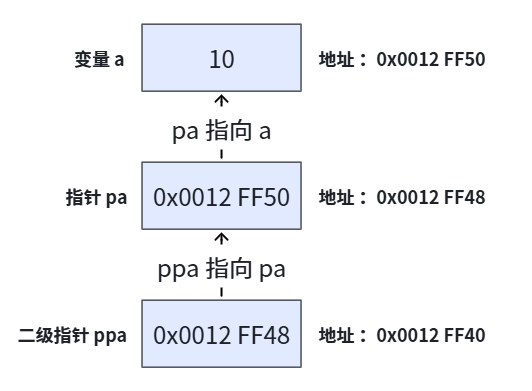
c
#include <stdio.h>
int main()
{
    int a = 10;
    int * pa = &a;      // pa 是一级指针,存 a 的地址
    int ** ppa = &pa;   // ppa 是二级指针,存 pa 的地址
    return 0;
}
二级指针的运算:
*ppa:对 ppa 里的地址解引用,找到的是 pa,所以*ppa访问的就是 pa。
c
int b = 20;
*ppa = &b; // 等价于 pa = &b**ppa:先通过*ppa找到 pa,再对 pa 解引用(*pa),找到的就是 a。
c
**ppa = 30;   // 等价于 *pa = 30
              // 等价于 a = 30
一句话总结 :二级指针就是"指向指针的指针",用来存放指针变量的地址。
*ppa得到它指向的一级指针,**ppa通过两次解引用最终得到原始变量。二级指针常用来在函数中修改一级指针本身。
6. 指针数组
指针数组,是数组还是指针?答案是:数组。
类比一下:整型数组是存放整型的数组,字符数组是存放字符的数组。那指针数组,就是存放指针的数组。
整型数组:  int arr[5]     ------ 每个元素是 int
字符数组:  char arr[5]    ------ 每个元素是 char
指针数组:  int* arr[5]    ------ 每个元素是 int*(指针)
指针数组的每个元素都是用来存放地址(指针)的,每个元素又是一个地址,可以指向一块区域。
一句话总结 :指针数组本质是数组,数组的每个元素都是指针。比如
int* arr[5]就是一个存放 5 个int*指针的数组,其中每个元素都可以指向一个 int(或一块 int 内存)。
7. 指针数组模拟二维数组
c
#include <stdio.h>
int main()
{
    int arr1[] = {1,2,3,4,5};
    int arr2[] = {2,3,4,5,6};
    int arr3[] = {3,4,5,6,7};

    // 三个数组名分别是各自首元素地址,类型是 int*
    // 把它们都存进指针数组 parr 里
    int* parr[3] = {arr1, arr2, arr3};

    int i = 0;
    int j = 0;
    for (i = 0; i < 3; i++)       // 3 行
    {
        for (j = 0; j < 5; j++)   // 每行 5 个元素
        {
            printf("%d ", parr[i][j]);   // 打印第 i 行第 j 个元素
        }
        printf("\n");
    }
    return 0;
}
parr 数组的结构可以画成:
parr(int* 类型的数组)
┌─────────┐
│ parr[0] │──────→ arr1:  1 2 3 4 5
├─────────┤
│ parr[1] │──────→ arr2:  2 3 4 5 6
├─────────┤
│ parr[2] │──────→ arr3:  3 4 5 6 7
└─────────┘
parr[i] 访问的是 parr 数组的元素,parr[i] 找到的数组元素指向了一个整型一维数组,parr[i][j] 就是那个一维数组里的第 j 个元素。
上面的代码模拟出了二维数组的效果,但要注意:它实际上并非真正的二维数组,因为每一行在内存中并不是连续的(arr1、arr2、arr3 是三块独立的空间)。
一句话总结 :指针数组可以用来模拟二维数组------用一个
int* parr[3]存放三个一维数组的首地址,再用parr[i][j]访问第 i 行第 j 个元素。但要注意这只是在模拟二维数组,因为各行之间在内存中并不连续。
四、深入理解指针(4)
这一讲是指针的高阶篇:字符指针、数组指针、函数指针、函数指针数组,以及它们的经典应用------转移表。
1. 字符指针变量
在指针类型中,有一种类型叫字符指针 char*。
一般用法:
c
int main()
{
    char ch = 'w';
    char * pc = &ch;   // pc 指向字符变量 ch
    *pc = 'w';         // 通过 pc 修改 ch
    return 0;
}
还有一种用法:
c
int main()
{
    const char* pstr = "hello bit.";   // 这里是把整个字符串放进 pstr 了吗?
    printf("%s\n", pstr);              // 打印 hello bit.
    return 0;
}
代码 const char* pstr = "hello bit."; 特别容易让人误以为是把字符串 hello bit. 放进了 pstr 里。其实本质是把字符串 hello bit. 首字符的地址放进了 pstr。
也就是说,pstr 里存的是常量字符串 hello bit. 中第一个字符 h 的地址。
用图表示:
pstr(const char*)
┌──────────────┐
│ 0x0030012F44 │──────→ "hello bit."(常量字符串,内存中连续存放)
└──────────────┘
下面是一道和字符串相关的经典笔试题(出自《剑指offer》):
c
#include <stdio.h>
int main()
{
    char str1[] = "hello bit.";           // 数组,各自独立开辟空间
    char str2[] = "hello bit.";           // 数组,各自独立开辟空间
    const char * str3 = "hello bit.";     // 指向常量字符串
    const char * str4 = "hello bit.";     // 指向常量字符串

    if (str1 == str2)
        printf("str1 and str2 are same\n");
    else
        printf("str1 and str2 are not same\n");

    if (str3 == str4)
        printf("str3 and str4 are same\n");
    else
        printf("str3 and str4 are not same\n");

    return 0;
}
程序运行结果:
str1 and str2 are not same
str3 and str4 are same
分析:str3 和 str4 指向的是同一个常量字符串 。C/C++ 会把常量字符串单独存储到一块内存区域,当多个指针指向同一个字符串时,它们实际上会指向同一块内存 。但用相同的常量字符串去初始化不同的数组 时,就会开辟出不同的内存块。所以 str1 和 str2 不同,str3 和 str4 相同。
(注意:这里比较的是地址值,不是字符串内容。str1、str2 是两个不同数组的首地址,所以不等;str3、str4 都指向同一块常量字符串,所以相等。)
一句话总结 :字符指针
char*可以指向字符,也可以指向字符串常量;const char* p = "hello"本质是把字符串首字符的地址存进 p。多个指针指向同一个字符串常量时地址相同;但用字符串常量初始化多个数组时,每个数组会各自开辟独立空间,地址不同。
2. 数组指针变量
2.1 数组指针变量是什么?
之前学过指针数组(本质是数组,存的是指针)。那数组指针变量是数组还是指针?答案是:指针变量。
我们已经熟悉:
- 整型指针变量:
int * pint;存放整型变量的地址,能指向整型数据。 - 浮点型指针变量:
float * pf;存放浮点型变量的地址,能指向浮点型数据。
那数组指针变量应该是:存放数组的地址,能够指向数组的指针变量。
下面两个哪个是数组指针变量?
c
int * p1[10];     // 指针数组:p1 是数组,每个元素是 int*
int (*p2)[10];    // 数组指针:p2 是指针,指向一个含 10 个 int 的数组
数组指针变量的写法:
c
int (*p)[10];解释:p 先和 * 结合,说明 p 是一个指针变量 ;然后它指向的是一个大小为 10 个整型的数组。所以 p 是一个指针,指向一个数组,叫"数组指针"。
这里要特别注意:[] 的优先级高于 * ,所以必须加上 () 来保证 p 先和 * 结合。如果不加括号,int *p[10] 就变成指针数组了。
2.2 数组指针变量怎么初始化
数组指针变量是用来存放数组地址的,那怎么获得数组的地址呢?就是我们之前学的 &数组名。
c
int arr[10] = {0};
&arr;   // 得到的就是整个数组的地址
要存放整个数组的地址,就得用数组指针变量:
c
int (*p)[10] = &arr; // p 指向整个数组 arr调试时也能看到 &arr 和 p 的类型是完全一致的(都是 int[10]* 类型,即指向 int10 的指针)。
数组指针类型解析:
int  (*p)  [10] = &arr;
 |     |     |
 |     |     └── p 指向的数组的元素个数(10 个)
 |     └──────── p 是数组指针变量名
 └────────────── p 指向的数组的元素类型(int)
一句话总结 :数组指针是指向数组的指针,写法是
int (*p)[10]。因为[]优先级比*高,所以必须加括号让 p 先和*结合。int (*p)[10] = &arr;表示 p 指向一个含 10 个 int 的数组,类型是"指向 int10 的指针"。区分记忆:int (*p)[10]是数组指针(是指针),int *p[10]是指针数组(是数组)。
3. 二维数组传参的本质
有了数组指针的理解,我们就能讲清二维数组传参的本质了。
以前二维数组需要传参给函数时,我们这样写:
c
#include <stdio.h>
void test(int a[3][5], int r, int c)   // 形参写成二维数组形式
{
    int i = 0;
    int j = 0;
    for (i = 0; i < r; i++)
    {
        for (j = 0; j < c; j++)
        {
            printf("%d ", a[i][j]);
        }
        printf("\n");
    }
}
int main()
{
    int arr[3][5] = {{1,2,3,4,5}, {2,3,4,5,6}, {3,4,5,6,7}};
    test(arr, 3, 5);
    return 0;
}
这里实参是二维数组,形参也写成了二维数组形式。那还有其他写法吗?
先重新理解一下二维数组:二维数组可以看作"每个元素是一维数组"的数组。也就是说,二维数组的每个元素本身是一个一维数组。
那么二维数组的首元素 就是第一行(一个一维数组)。
画出二维数组 arr35 的结构:
arr 的每一行都是一个 int[5] 的一维数组
┌─────────────────────────────┐
│ 第0行: 1  2  3  4  5  (int[5]) │  ← 这是二维数组的"首元素"
├─────────────────────────────┤
│ 第1行: 2  3  4  5  6  (int[5]) │
├─────────────────────────────┤
│ 第2行: 3  4  5  6  7  (int[5]) │
└─────────────────────────────┘根据"数组名是数组首元素的地址"这个规则,二维数组的数组名表示的就是第一行的地址(一个一维数组的地址)。
第一行的一维数组类型是 int[5],所以第一行地址的类型就是数组指针类型 int(*)[5]。
这就意味着:二维数组传参本质上也是传递地址,传递的是第一行这个一维数组的地址。所以形参也可以写成指针形式:
c
#include <stdio.h>
void test(int (*p)[5], int r, int c)   // 形参写成数组指针形式
{
    int i = 0;
    int j = 0;
    for (i = 0; i < r; i++)
    {
        for (j = 0; j < c; j++)
        {
            printf("%d ", *(*(p + i) + j));   // *(*(p+i)+j) 等价于 a[i][j]
        }
        printf("\n");
    }
}
int main()
{
    int arr[3][5] = {{1,2,3,4,5}, {2,3,4,5,6}, {3,4,5,6,7}};
    test(arr, 3, 5);
    return 0;
}
总结:二维数组传参,形参部分可以写成数组形式,也可以写成指针(数组指针)形式。
一句话总结 :二维数组可以看成"元素是一维数组的数组",它的数组名表示第一行(一个一维数组)的地址,类型是数组指针。所以二维数组传参本质是传递第一行的地址,形参既可以写成
int a[3][5],也可以写成数组指针int (*p)[5],两者等价。
4. 函数指针变量
4.1 函数指针变量的创建
什么是函数指针变量呢?类比整型指针、数组指针,不难得出结论:函数指针变量是用来存放函数地址的,未来通过地址就能调用函数。
那函数有地址吗?测试一下:
c
#include <stdio.h>
void test()
{
    printf("hehe\n");
}
int main()
{
    printf("test:  %p\n", test);    // 打印函数名
    printf("&test: %p\n", &test);   // 打印 &函数名
    return 0;
}
输出结果:
test:  005913CA
&test: 005913CA确实打印出了地址!所以函数是有地址的,函数名就是函数的地址 ,当然也可以通过 &函数名 得到函数的地址。
要把函数的地址存起来,就得创建函数指针变量。函数指针的写法和数组指针非常类似:
c
void test()
{
    printf("hehe\n");
}
void (*pf1)() = &test;          // pf1 指向 test 函数
void (*pf2)() = test;           // 函数名就是地址,这样写也行

int Add(int x, int y)
{
    return x + y;
}
int (*pf3)(int, int) = Add;         // pf3 指向 Add
int (*pf3)(int x, int y) = &Add;    // 参数名 x、y 写上或省略都可以
函数指针类型解析:
int  (*pf3)  (int x, int y)
 |     |       ------------
 |     |            |
 |     |            └── pf3 指向函数的参数类型和个数(int, int)
 |     └─────────────── 函数指针变量名
 └───────────────────── pf3 指向函数的返回类型(int)

int (*) (int, int)   // pf3 这个函数指针变量的类型
4.2 函数指针变量的使用
通过函数指针调用它指向的函数:
c
#include <stdio.h>
int Add(int x, int y)
{
    return x + y;
}
int main()
{
    int (*pf3)(int, int) = Add;   // pf3 指向 Add

    printf("%d\n", (*pf3)(2, 3)); // 通过函数指针调用:先解引用再调用,得 5
    printf("%d\n", pf3(3, 5));    // 也可以直接写 pf3(...),得 8
    return 0;
}
输出结果:
5
8两种写法都可以:(*pf3)(2,3) 或 pf3(2,3)。
4.3 两段有趣的代码
代码 1:
c
(*(void (*)())0)();这段代码出自《C陷阱和缺陷》。它把 0 强制转换成 void (*)() 类型(函数指针类型),然后解引用,得到地址为 0 处的"函数",再调用它。实际含义是"调用地址为 0 处的函数"(这是一个危险的示范,说明 C 语言指针表达力的强大)。
代码 2:
c
void (*signal(int , void(*)(int)))(int);这也是个"天书"般的声明:signal 是一个函数,参数是 int 和 void(*)(int)(一个函数指针),返回值是一个 void(*)(int)(函数指针)。理解起来很绕,所以需要 typedef 来简化。
4.4 typedef 关键字
typedef 是用来给类型重命名的,可以把复杂的类型简单化。
比如,你觉得 unsigned int 写起来不方便,想写成 uint,就可以:
c
typedef unsigned int uint; // 把 unsigned int 重命名为 uint指针类型也能重命名,比如把 int* 重命名为 ptr_t:
c
typedef int* ptr_t; // 之后 ptr_t 就代表 int*但对于数组指针和函数指针,稍微有点区别:新的类型名必须写在 * 的右边。
比如把数组指针类型 int(*)[5] 重命名为 parr_t:
c
typedef int(*parr_t)[5]; // parr_t 就是 int(*)[5] 类型函数指针类型的重命名也一样,把 void(*)(int) 类型重命名为 pf_t:
c
typedef void(*pfun_t)(int); // pfun_t 就是 void(*)(int) 类型这样,上面"天书"般的代码 2 就可以简化为:
c
typedef void(*pfun_t)(int);
pfun_t signal(int, pfun_t);   // 清晰多了:signal 返回 pfun_t,参数是 int 和 pfun_t
一句话总结 :函数指针是存放函数地址的指针,函数名就是函数的地址。写法如
int (*pf)(int,int),用(*pf)(...)或pf(...)调用。typedef 可以给类型重命名来简化复杂类型,重命名函数/数组指针时,新类型名要放在*的右边。
5. 函数指针数组
数组是存放相同类型数据的存储空间。我们已经学过指针数组:
c
int * arr[10]; // 数组的每个元素是 int*那要把函数的地址存到一个数组里,这个数组就叫函数指针数组。怎么定义呢?看下面三个:
c
int (*parr1[3])();   // 正确:parr1 是函数指针数组
int *parr2[3]();     // 错误写法
int (*)() parr3[3];  // 错误写法
答案是 parr1。
parr1 先和 [] 结合,说明 parr1 是数组;数组里存的内容是 int (*)() 类型的函数指针。
6. 转移表
函数指针数组的一个经典用途就是转移表。
举例:实现一个计算器。一般的实现方式是用 switch 分支:
c
#include <stdio.h>
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int div(int a, int b) { return a / b; }

int main()
{
    int x, y;
    int input = 1;
    int ret = 0;
    do
    {
        printf("*************************\n");
        printf("  1:add           2:sub  \n");
        printf("  3:mul           4:div  \n");
        printf("  0:exit                 \n");
        printf("*************************\n");
        printf("请选择:");
        scanf("%d", &input);
        switch (input)
        {
        case 1:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = add(x, y);
            printf("ret = %d\n", ret);
            break;
        case 2:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = sub(x, y);
            printf("ret = %d\n", ret);
            break;
        case 3:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = mul(x, y);
            printf("ret = %d\n", ret);
            break;
        case 4:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = div(x, y);
            printf("ret = %d\n", ret);
            break;
        case 0:
            printf("退出程序\n");
            break;
        default:
            printf("选择错误\n");
            break;
        }
    } while (input);
    return 0;
}
可以看到 switch 里每个 case 都有大量重复代码。使用函数指针数组(转移表)可以大大简化:
c
#include <stdio.h>
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int div(int a, int b) { return a / b; }

int main()
{
    int x, y;
    int input = 1;
    int ret = 0;
    // 转移表:下标 1~4 对应 add/sub/mul/div 四个函数的地址
    int (*p[5])(int x, int y) = { 0, add, sub, mul, div };
    do
    {
        printf("*************************\n");
        printf("  1:add           2:sub  \n");
        printf("  3:mul           4:div  \n");
        printf("  0:exit                 \n");
        printf("*************************\n");
        printf("请选择:");
        scanf("%d", &input);
        if ((input <= 4 && input >= 1))
        {
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = (*p[input])(x, y);   // 用转移表调用对应函数
            printf("ret = %d\n", ret);
        }
        else if (input == 0)
        {
            printf("退出计算器\n");
        }
        else
        {
            printf("输入有误\n");
        }
    } while (input);
    return 0;
}
这里 p 是一个函数指针数组,下标 1~4 分别存放 add、sub、mul、div 的函数地址。用户输入的数字直接作为下标,p[input] 就找到对应的函数并调用,省去了一堆重复的 switch 分支。这种"根据输入查表调用函数"的数组就叫转移表。
一句话总结 :函数指针数组是存放函数地址的数组(如
int (*p[5])(int,int)),它的经典应用是转移表------用一个数组把多个函数地址按序号存起来,用户输入一个序号,直接通过下标找到对应函数调用,从而取代大量重复的 switch 分支,让代码更简洁。
五、深入理解指针(5)
这一讲讲指针的"高级用法"------回调函数,以及 C 标准库里的排序神器 qsort,最后手把手模拟实现一个 qsort。
1. 回调函数是什么?
回调函数就是一个通过函数指针调用的函数。
具体说:如果你把函数的指针(地址)作为参数传递给另一个函数,当这个指针被用来调用它所指向的函数时,被调用的函数就是回调函数。
回调函数不是由它自己的实现方直接调用的,而是在特定事件或条件发生时,由另外一方调用的,用于对该事件或条件做出响应。
在上一讲计算器的 switch 实现里,每个 case 里都有大量重复的代码:虽然执行的计算逻辑不同(add/sub/mul/div),但"输入操作数、调用函数、打印结果"这套输入输出操作是冗余的。
因为只有"调用哪个函数"这一处有差异,我们可以把要调用的函数的地址以参数形式传过去,用函数指针接收。函数指针指向哪个函数,就调用哪个函数。这里用的就是回调函数的思想。
改造前(switch 版,重复代码多):
c
#include <stdio.h>
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int div(int a, int b) { return a / b; }

int main()
{
    int x, y;
    int input = 1;
    int ret = 0;
    do
    {
        printf("*************************\n");
        printf("  1:add           2:sub  \n");
        printf("  3:mul           4:div  \n");
        printf("*************************\n");
        printf("请选择:");
        scanf("%d", &input);
        switch (input)
        {
        case 1:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = add(x, y);
            printf("ret = %d\n", ret);
            break;
        case 2:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = sub(x, y);
            printf("ret = %d\n", ret);
            break;
        case 3:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = mul(x, y);
            printf("ret = %d\n", ret);
            break;
        case 4:
            printf("输入操作数:");
            scanf("%d %d", &x, &y);
            ret = div(x, y);
            printf("ret = %d\n", ret);
            break;
        case 0:
            printf("退出程序\n");
            break;
        default:
            printf("选择错误\n");
            break;
        }
    } while (input);
    return 0;
}
改造后(回调函数版,把重复逻辑抽成一个 calc 函数):
c
#include <stdio.h>
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int div(int a, int b) { return a / b; }

// calc 接收一个函数指针 pf,输入操作数,然后调用 pf 指向的函数
void calc(int (*pf)(int, int))
{
    int ret = 0;
    int x, y;
    printf("输入操作数:");
    scanf("%d %d", &x, &y);
    ret = pf(x, y);              // 通过函数指针调用(这里调用的就是回调函数)
    printf("ret = %d\n", ret);
}

int main()
{
    int input = 1;
    do
    {
        printf("*************************\n");
        printf("  1:add           2:sub  \n");
        printf("  3:mul           4:div  \n");
        printf("*************************\n");
        printf("请选择:");
        scanf("%d", &input);
        switch (input)
        {
        case 1:
            calc(add);           // 把 add 的地址传给 calc,add 就是回调函数
            break;
        case 2:
            calc(sub);
            break;
        case 3:
            calc(mul);
            break;
        case 4:
            calc(div);
            break;
        case 0:
            printf("退出程序\n");
            break;
        default:
            printf("选择错误\n");
            break;
        }
    } while (input);
    return 0;
}
这样,switch 分支里只剩一行 calc(add) 之类的调用,重复代码大大减少。被传进去的 add、sub、mul、div,就是在 calc 内部被"回调"的函数。
一句话总结:回调函数就是通过函数指针调用的函数------把某个函数的地址作为参数传给另一个函数,由后者在需要时通过这个指针调用它。回调函数的本质是"把函数当作参数传递",可以实现代码复用(如统一处理逻辑、事件响应、排序时让使用者自定义比较规则)。
2. qsort 使用举例
qsort 是 C 标准库提供的一个通用的快速排序函数,可以给任意类型的数据排序。它内部就大量使用了回调函数(比较函数)和 void*(泛型指针)。
qsort 的函数原型(大致)是:
c
void qsort(void *base,       // 待排序数组的首地址
           size_t num,       // 元素个数
           size_t size,      // 每个元素的大小(字节)
           int (*cmp)(const void*, const void*));  // 比较函数的指针
使用者需要自己实现一个"比较函数" cmp,告诉 qsort 两个元素谁大谁小。qsort 会根据 cmp 的返回值排序:返回负数表示 e1 排在 e2 前,返回 0 表示相等,返回正数表示 e1 排在 e2 后。
2.1 使用 qsort 排序整型数据
c
#include <stdio.h>
#include <stdlib.h>

// 比较函数:使用者实现,告诉 qsort 两个整数怎么比
int int_cmp(const void * p1, const void * p2)
{
    // void* 不能直接解引用,先强转成 int* 再解引用
    return (*(int *)p1 - *(int *)p2);
}

int main()
{
    int arr[] = { 1, 3, 5, 7, 9, 2, 4, 6, 8, 0 };
    int i = 0;

    qsort(arr, sizeof(arr) / sizeof(arr[0]), sizeof(int), int_cmp);
    //    数组首地址  元素个数                  每个元素大小  比较函数

    for (i = 0; i < sizeof(arr) / sizeof(arr[0]); i++)
    {
        printf("%d ", arr[i]);   // 打印排序后的结果:0 1 2 3 4 5 6 7 8 9
    }
    printf("\n");
    return 0;
}
2.2 使用 qsort 排序结构体数据
c
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

struct Stu   // 学生结构体
{
    char name[20];   // 名字
    int age;         // 年龄
};

// 按年龄比较
int cmp_stu_by_age(const void* e1, const void* e2)
{
    return ((struct Stu*)e1)->age - ((struct Stu*)e2)->age;
}

// strcmp 是库函数,专门用来比较两个字符串的大小
// 按名字比较
int cmp_stu_by_name(const void* e1, const void* e2)
{
    return strcmp(((struct Stu*)e1)->name, ((struct Stu*)e2)->name);
}

// 按年龄排序
void test2()
{
    struct Stu s[] = { {"zhangsan", 20}, {"lisi", 30}, {"wangwu", 15} };
    int sz = sizeof(s) / sizeof(s[0]);
    qsort(s, sz, sizeof(s[0]), cmp_stu_by_age);
}

// 按名字排序
void test3()
{
    struct Stu s[] = { {"zhangsan", 20}, {"lisi", 30}, {"wangwu", 15} };
    int sz = sizeof(s) / sizeof(s[0]);
    qsort(s, sz, sizeof(s[0]), cmp_stu_by_name);
}

int main()
{
    test2();
    test3();
    return 0;
}
可以看到,qsort 配合不同的比较函数,就能对整型、结构体等各种数据排序,非常灵活。这正是 void*(接收任意类型地址)和回调函数(把比较逻辑交给使用者)结合的威力。
一句话总结:qsort 是通用排序函数,参数包括数组首地址、元素个数、每个元素大小和一个比较函数指针。使用者只需自定义比较函数(返回负数/0/正数表示大小关系),qsort 就能给任意类型的数据排序,这是 void* 泛型指针和回调函数的典型应用。
3. qsort 函数的模拟实现
我们用回调函数,模拟实现一个 qsort(采用冒泡的方式,所以也叫通用冒泡排序)。
这里也是第一次真正用 void* 指针,重点理解 void* 的作用。
c
#include <stdio.h>

// 比较函数:比较两个整数
int int_cmp(const void * p1, const void * p2)
{
    return (*(int *)p1 - *(int *)p2);
}

// 交换函数:按字节逐个交换两个元素(size 是每个元素的字节数)
void _swap(void *p1, void *p2, int size)
{
    int i = 0;
    for (i = 0; i < size; i++)
    {
        // 把 p1、p2 看成 char*,按字节逐个交换
        char tmp = *((char *)p1 + i);
        *((char *)p1 + i) = *((char *)p2 + i);
        *((char *)p2 + i) = tmp;
    }
}

// 通用冒泡排序:base 是数组首地址,count 是元素个数,size 是每个元素大小,cmp 是比较函数
void bubble(void *base, int count, int size, int (*cmp)(void *, void *))
{
    int i = 0;
    int j = 0;
    for (i = 0; i < count - 1; i++)
    {
        for (j = 0; j < count - i - 1; j++)
        {
            // (char*)base + j*size 是第 j 个元素的地址
            // (char*)base + (j+1)*size 是第 j+1 个元素的地址
            if (cmp((char *)base + j * size, (char *)base + (j + 1) * size) > 0)
            {
                // 如果前面元素比后面大,就交换
                _swap((char *)base + j * size, (char *)base + (j + 1) * size, size);
            }
        }
    }
}

int main()
{
    int arr[] = { 1, 3, 5, 7, 9, 2, 4, 6, 8, 0 };
    int i = 0;
    bubble(arr, sizeof(arr) / sizeof(arr[0]), sizeof(int), int_cmp);
    for (i = 0; i < sizeof(arr) / sizeof(arr[0]); i++)
    {
        printf("%d ", arr[i]);   // 输出 0 1 2 3 4 5 6 7 8 9
    }
    printf("\n");
    return 0;
}
关键点解释:
- 因为不知道要排序的数据是什么类型,所以用
void* base接收任意类型的数组首地址。 void*不能直接做加减运算,所以要先把 base 强转成char*,再按元素大小 × 下标的偏移量找到每个元素。(char*)base + j*size就是第 j 个元素的起始地址。- 交换时因为不知道元素占几字节,就按字节逐个交换(把两个元素都当成
char数组,逐字节交换)。 - 比较时调用使用者传入的 cmp 回调函数,cmp 内部再强转回真正的类型去比较。
一句话总结 :模拟 qsort 的关键是通用化------用
void* base接收任意数组首地址,用size记录每个元素大小,把 base 强转成char*后按j*size的偏移定位第 j 个元素;比较逻辑交给使用者传入的回调函数,交换则按字节逐字节进行,从而实现对任意类型数据的通用排序。
六、深入理解指针(6)
这一讲是"大杂烩"和"压轴题":先讲清 sizeof 和 strlen 的区别,再集中解析一堆数组、指针相关的经典题目。这些题目是检验指针功力的试金石。
1. sizeof 和 strlen 的对比
1.1 sizeof
sizeof 是操作符,用来计算变量(或类型)所占内存空间的大小,单位是字节。如果操作数是类型,计算的就是用该类型创建的变量所占内存的大小。
sizeof 只关注占用内存空间的大小,不在乎内存里存的是什么数据。
c
#include <stdio.h>
int main()
{
    int a = 10;
    printf("%d\n", sizeof(a));    // 4:变量 a 的大小
    printf("%d\n", sizeof a);     // 4:sizeof 是操作符,变量名可以不带括号
    printf("%d\n", sizeof(int));  // 4:int 类型的大小(类型必须带括号)
    return 0;
}
1.2 strlen
strlen 是 C 语言库函数,功能是求字符串长度。函数原型:
c
size_t strlen(const char * str);它统计的是从参数 str 这个地址开始向后,\0 之前字符串中字符的个数。
strlen 会一直向后找 \0 字符,直到找到为止,所以可能存在越界查找(如果字符串里没有 \0)。
c
#include <stdio.h>
#include <string.h>
int main()
{
    char arr1[3] = {'a', 'b', 'c'};   // 没有 \0
    char arr2[] = "abc";              // 等价于 {'a','b','c','\0'},有 \0

    printf("%d\n", strlen(arr1));   // 随机值:找不到 \0,一直越界往后找
    printf("%d\n", strlen(arr2));   // 3:找到 \0 之前有 3 个字符

    printf("%d\n", sizeof(arr1));   // 3:数组本身大小,3 个 char
    printf("%d\n", sizeof(arr2));   // 4:'a','b','c','\0' 共 4 个字节
    return 0;
}
1.3 sizeof 和 strlen 的对比
| 对比项 | sizeof | strlen |
|---|---|---|
| 本质 | 操作符 | 库函数(需包含 string.h) |
| 功能 | 计算操作数所占内存大小,单位字节 | 求字符串长度,统计 \0 之前的字符个数 |
| 关注点 | 只关心占多大空间,不管存什么 | 关心是否有 \0,没有就会一直往后找,可能越界 |
一句话总结 :sizeof 是操作符,在编译期就能确定结果,计算的是变量或类型所占内存的字节数,不关心内容;strlen 是库函数,在运行时从给定地址向后逐个找字符,统计
\0之前的字符个数,若没有\0会越界查找、结果是随机值。
2. 数组和指针笔试题解析
做题前,请先记住数组名的三条意义(这是解所有题目的核心):
sizeof(数组名):数组名表示整个数组,计算整个数组的大小。&数组名:数组名表示整个数组,取出整个数组的地址。- 除此之外,所有的数组名都表示首元素的地址。
以下题目默认在 X86(32 位)环境下,指针大小为 4 字节;X64 环境下指针相关结果翻倍(8 字节)。
2.1 一维数组
c
int a[] = {1,2,3,4};
printf("%d\n", sizeof(a));        // 16:整个数组,4 个 int = 4*4
printf("%d\n", sizeof(a+0));      // 4:a+0 是首元素地址(指针)
printf("%d\n", sizeof(*a));       // 4:*a 是首元素 a[0],int 类型
printf("%d\n", sizeof(a+1));      // 4:a+1 是第二个元素的地址(指针)
printf("%d\n", sizeof(a[1]));     // 4:a[1] 是 int 类型
printf("%d\n", sizeof(&a));       // 4:&a 是整个数组的地址(也是指针)
printf("%d\n", sizeof(*&a));      // 16:*&a 就是 a,整个数组
printf("%d\n", sizeof(&a+1));     // 4:&a+1 是跳过一个数组后的地址(指针)
printf("%d\n", sizeof(&a[0]));    // 4:首元素地址(指针)
printf("%d\n", sizeof(&a[0]+1));  // 4:第二个元素地址(指针)
2.2 字符数组
代码 1(sizeof):
c
char arr[] = {'a','b','c','d','e','f'};   // 6 个字符,没有 \0
printf("%d\n", sizeof(arr));        // 6:整个数组,6 个 char
printf("%d\n", sizeof(arr+0));      // 4:首元素地址(指针)
printf("%d\n", sizeof(*arr));       // 1:首元素 'a',char 类型
printf("%d\n", sizeof(arr[1]));     // 1:'b',char 类型
printf("%d\n", sizeof(&arr));       // 4:整个数组的地址(指针)
printf("%d\n", sizeof(&arr+1));     // 4:跳过一个数组后的地址(指针)
printf("%d\n", sizeof(&arr[0]+1));  // 4:第二个元素地址(指针)
代码 2(strlen):
c
char arr[] = {'a','b','c','d','e','f'};   // 没有 \0
printf("%d\n", strlen(arr));        // 随机值:找不到 \0,越界查找
printf("%d\n", strlen(arr+0));      // 随机值:同上
printf("%d\n", strlen(*arr));       // 错误:*arr 是 'a'(ASCII 97),被当地址用,非法访问
printf("%d\n", strlen(arr[1]));     // 错误:arr[1] 是 'b'(ASCII 98),同上
printf("%d\n", strlen(&arr));       // 随机值:&arr 的值等于首地址,从这往后找 \0(有类型警告)
printf("%d\n", strlen(&arr+1));     // 随机值:从跳过整个数组后的位置往后找
printf("%d\n", strlen(&arr[0]+1));  // 随机值:从第二个元素往后找
代码 3(sizeof,字符串带 \0):
c
char arr[] = "abcdef";   // 等价于 {'a','b','c','d','e','f','\0'}
printf("%d\n", sizeof(arr));        // 7:6 个字符 + 1 个 \0
printf("%d\n", sizeof(arr+0));      // 4:首元素地址(指针)
printf("%d\n", sizeof(*arr));       // 1:首元素 'a'
printf("%d\n", sizeof(arr[1]));     // 1:'b'
printf("%d\n", sizeof(&arr));       // 4:整个数组的地址(指针)
printf("%d\n", sizeof(&arr+1));     // 4:地址
printf("%d\n", sizeof(&arr[0]+1));  // 4:地址
代码 4(strlen,字符串带 \0):
c
char arr[] = "abcdef";
printf("%d\n", strlen(arr));        // 6:\0 之前 6 个字符
printf("%d\n", strlen(arr+0));      // 6:同上
printf("%d\n", strlen(*arr));       // 错误:'a'(97)被当地址
printf("%d\n", strlen(arr[1]));     // 错误:'b'(98)被当地址
printf("%d\n", strlen(&arr));       // 6:&arr 值等于首地址(有类型警告)
printf("%d\n", strlen(&arr+1));     // 随机值:跳过整个数组后往后找
printf("%d\n", strlen(&arr[0]+1));  // 5:从 'b' 开始到 \0,共 5 个字符
代码 5(sizeof,字符指针):
c
char *p = "abcdef";                  // p 指向常量字符串首字符 'a'
printf("%d\n", sizeof(p));          // 4:p 是指针变量
printf("%d\n", sizeof(p+1));        // 4:p+1 是地址(指向 'b')
printf("%d\n", sizeof(*p));         // 1:*p 是 'a',char 类型
printf("%d\n", sizeof(p[0]));       // 1:p[0] 等价于 *p,是 'a'
printf("%d\n", sizeof(&p));         // 4:&p 是 p 这个指针变量的地址(二级指针)
printf("%d\n", sizeof(&p+1));       // 4:地址
printf("%d\n", sizeof(&p[0]+1));    // 4:&p[0]+1 是 'b' 的地址
代码 6(strlen,字符指针):
c
char *p = "abcdef";
printf("%d\n", strlen(p));          // 6:从 'a' 到 \0
printf("%d\n", strlen(p+1));        // 5:从 'b' 到 \0
printf("%d\n", strlen(*p));         // 错误:'a'(97)被当地址
printf("%d\n", strlen(p[0]));       // 错误:'a'(97)被当地址
printf("%d\n", strlen(&p));         // 随机值:&p 是 p 变量的地址,p 里存的是字符串地址,
                                    //        从这个二级指针指向的字节往后找 \0,结果不确定
printf("%d\n", strlen(&p+1));       // 随机值:同上
printf("%d\n", strlen(&p[0]+1));    // 5:从 'b' 到 \0
2.3 二维数组
c
int a[3][4] = {0};
printf("%d\n", sizeof(a));          // 48:整个二维数组 3*4*4
printf("%d\n", sizeof(a[0][0]));    // 4:a[0][0] 是 int
printf("%d\n", sizeof(a[0]));       // 16:a[0] 是第一行(int[4]),4*4
printf("%d\n", sizeof(a[0]+1));     // 4:a[0]+1 是第一行第二个元素的地址(指针)
printf("%d\n", sizeof(*(a[0]+1)));  // 4:*(a[0]+1) 是第一行第二个元素,int
printf("%d\n", sizeof(a+1));        // 4:a+1 是第二行的地址(数组指针)
printf("%d\n", sizeof(*(a+1)));     // 16:*(a+1) 是第二行(int[4])
printf("%d\n", sizeof(&a[0]+1));    // 4:第二行的地址(指针)
printf("%d\n", sizeof(*(&a[0]+1))); // 16:*(&a[0]+1) 是第二行(int[4])
printf("%d\n", sizeof(*a));         // 16:*a 是第一行(int[4])
printf("%d\n", sizeof(a[3]));       // 16:a[3] 是 int[4] 类型;sizeof 只按类型算大小,
// 不真正访问越界空间,所以是 4*4=16一句话总结:解这类题的核心是分清"数组名"和"指针"------sizeof(数组名) 是整个数组大小,&数组名 是整个数组地址,其余数组名都是首元素地址(指针)。而 sizeof 只看类型算字节数、不真正求值(所以越界下标如 a3 也能算出大小),strlen 则是从地址开始实际找 \0,字符本身当地址会非法访问。
3. 指针运算笔试题解析
3.1 题目 1
c
#include <stdio.h>
int main()
{
    int a[5] = { 1, 2, 3, 4, 5 };
    int *ptr = (int *)(&a + 1);     // &a 是数组地址,+1 跳过整个数组,指向 a[4] 之后
    printf("%d,%d", *(a + 1), *(ptr - 1));
    return 0;
}
// 结果:2,5
解析:
&a是整个数组的地址,&a + 1跳过整个数组(5 个 int = 20 字节),指向数组末尾之后的位置。ptr指向数组末尾之后,ptr - 1就指回最后一个元素 a4,*(ptr-1)= 5。*(a+1)= a1 = 2。
所以输出 2,5。
3.2 题目 2
c
// X86 环境下,假设结构体大小是 20 字节
struct Test
{
    int Num;          // 4
    char *pcName;     // 4
    short sDate;      // 2
    char cha[2];      // 2
    short sBa[4];     // 8
    // 考虑内存对齐,整个结构体共 20 字节
} *p = (struct Test*)0x100000;

int main()
{
    printf("%p\n", p + 0x1);                  // 0x100014
    printf("%p\n", (unsigned long)p + 0x1);   // 0x100001
    printf("%p\n", (unsigned int*)p + 0x1);   // 0x100004
    return 0;
}
// 结果:0x100014、0x100001、0x100004
解析:
p是struct Test*类型,p+1 跳过整个结构体 20 字节,所以0x100000 + 20 = 0x100014。(unsigned long)p是把地址当整数,整数 +1 就是 +1,所以0x100000 + 1 = 0x100001。(unsigned int*)p是 int 指针,+1 跳过 4 字节,所以0x100000 + 4 = 0x100004。
3.3 题目 3
c
#include <stdio.h>
int main()
{
    int a[3][2] = { (0, 1), (2, 3), (4, 5) };  // 注意:这是逗号表达式!
    // 逗号表达式的结果是最后一个值,所以实际初始化是 {1, 3, 5}
    int *p;
    p = a[0];        // a[0] 是第一行,p 指向 a[0][0]
    printf("%d", p[0]);
    return 0;
}
// 结果:1解析:(0,1) 是逗号表达式,值为 1;(2,3) 值为 3;(4,5) 值为 5。所以数组实际是 {1, 3, 5},p[0] = 1。
3.4 题目 4
c
// 假设环境是 x86 环境
#include <stdio.h>
int main()
{
    int a[5][5];
    int (*p)[4];    // p 是指向 int[4] 的数组指针
    p = a;          // 类型不匹配(a 是 int[5] 每行),但强制赋值
    printf("%p,%d\n", &p[4][2] - &a[4][2], &p[4][2] - &a[4][2]);
    return 0;
}
// 结果:FFFFFFFC,-4
解析:
- p 每行按 4 个 int 走,
p[4][2]相对 p 的偏移是4*4 + 2 = 18个 int。 - a 每行按 5 个 int 走,
a[4][2]相对 a 的偏移是4*5 + 2 = 22个 int。 - 两者地址差 = 18 - 22 = -4(个 int)。
%d打印出 -4;%p把 -4 的补码按地址打印,32 位下是FFFFFFFC。
所以输出 FFFFFFFC,-4。
3.5 题目 5
c
#include <stdio.h>
int main()
{
    int aa[2][5] = { 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 };
    int *ptr1 = (int *)(&aa + 1);      // &aa 是整个二维数组地址,+1 跳到末尾之后
    int *ptr2 = (int *)(*(aa + 1));    // aa+1 是第二行地址,*(aa+1) 是第二行首元素地址
    printf("%d,%d", *(ptr1 - 1), *(ptr2 - 1));
    return 0;
}
// 结果:10,5
解析:
&aa + 1跳过整个二维数组,指向末尾之后;ptr1 - 1指回最后一个元素 aa14 = 10。*(aa+1)是第二行首元素地址(aa10 的地址);ptr2 - 1指向前一行最后一个元素 aa04 = 5。
所以输出 10,5。
3.6 题目 6
c
#include <stdio.h>
int main()
{
    char *a[] = {"work", "at", "alibaba"};   // 指针数组,存三个字符串首地址
    char **pa = a;                           // 二级指针,指向 a[0]
    pa++;                                    // pa 指向 a[1]
    printf("%s\n", *pa);                     // *pa = a[1] = "at"
    return 0;
}
// 结果:at
3.7 题目 7
这是一道非常经典的"多级指针连环题",需要一步步跟踪指针的变化。
c
#include <stdio.h>
int main()
{
    char *c[] = {"ENTER", "NEW", "POINT", "FIRST"};
    char **cp[] = {c + 3, c + 2, c + 1, c};
    char ***cpp = cp;

    printf("%s\n", **++cpp);        // POINT
    printf("%s\n", *--*++cpp + 3);  // ER
    printf("%s\n", *cpp[-2] + 3);   // ST
    printf("%s\n", cpp[-1][-1] + 1);// EW
    return 0;
}
// 结果:POINT、ER、ST、EW
初始状态:
c 数组:  c[0]="ENTER"  c[1]="NEW"  c[2]="POINT"  c[3]="FIRST"
cp 数组: cp[0]=c+3     cp[1]=c+2    cp[2]=c+1     cp[3]=c
cpp 一开始指向 cp[0]
逐步解析:
-
**++cpp:++cpp让 cpp 指向 cp1;**cpp=*(cp[1])=*(c+2)= c2 = "POINT" 。(此时 cpp 指向 cp1)
-
*--*++cpp + 3:++cpp让 cpp 指向 cp2;*cpp得到 cp2(即 c+1);--(*cpp)让 cp2 自减,变成 c(即 cp2 = c);*(*cpp)=*(cp[2])=*c= c0 = "ENTER";+3后从 'E' 往后 3 位,输出 "ER" 。
(此时 cpp 指向 cp2,且 cp2 已被改成 c)
-
*cpp[-2] + 3:cpp[-2]= cp0(cpp 指向 cp2,往前 2 个是 cp0);cp[0]= c+3;*(c+3)= c3 = "FIRST";+3后输出 "ST"。
-
cpp[-1][-1] + 1:cpp[-1]= cp1(cpp 指向 cp2,往前 1 个是 cp1);cp[1]= c+2;(c+2)[-1]=*(c+2-1)=*(c+1)= c1 = "NEW";+1后输出 "EW"。
所以最终输出:POINT、ER、ST、EW。
一句话总结 :指针运算题的关键是分清"指针本身"和"指针指向的内容":
p++、++p改的是指针本身,*p取的是指向内容,p[i]等价于*(p+i),而&数组名 + 1跳过的是整个数组。遇到多级指针连环题,就一步步画图跟踪每个指针当前指向的位置,切忌跳步。
结尾:给小白的三句话
- 指针不可怕 :它就是一个"门牌号",记住
编号 == 地址 == 指针,后面的一切都围绕这句话展开。 - 动手比看懂更重要:文中的每一段代码,都建议你自己敲一遍、调试一遍,观察内存的变化。
- 多画图:遇到二级指针、指针数组、多级指针时,先在纸上画出"谁指向谁",答案自然就出来了。
指针是 C 语言的灵魂。把这六讲吃透,你不仅指针过关了,对"内存"的理解也会上一个大台阶------这恰恰是 C 语言和其他高级语言最根本的区别。