Redis 8 的官方镜像里已经带着这几个能力:嵌套对象、监控曲线、相似检索。
本次导航
- JSON:按路径读写,不用整段反序列化
- 时序:
TS.ADD打点,规则帮你做降采样 - 向量:
VADD/VSIM,搭一个最小的问答检索 - 什么场景值得开,什么场景别硬上
发车前提醒:redis:8.6.2 启动之后,JSON、TimeSeries、Bloom、Search 都已经加载好了,不用再拼 Redis Stack。老版本没有这些命令,先看一眼 MODULE LIST。
按惯例,开启 Redis 客户端,方便后续执行命令:
bash
docker exec -it redis-demo redis-cli一、JSON:对象别再当一整段字符串塞
以前把商品详情 SET 成一段 JSON 字符串,改个价格要取出整段、改完再写回去。
Hash 能改单个字段,但数组、嵌套对象就别扭。
Redis JSON 按路径动手:
bash
127.0.0.1:6379> JSON.SET product:1001 $ '{"name":"手机壳","price":29,"sku":"sku_1001","tags":["phone","case"]}'
OK

127.0.0.1:6379> JSON.GET product:1001
"{\"name\":\"手机壳\",\"price\":29,\"sku\":\"sku_1001\",\"tags\":[\"phone\",\"case\"]}"

127.0.0.1:6379> JSON.GET product:1001 $.price
"[29]"

127.0.0.1:6379> JSON.NUMINCRBY product:1001 $.price 10
"[39]"
路径 $ 是根,$.price 返回的是 JSON 数组,因为 JSONPath 可能命中多个位置,一个字段也会带方括号。
改名字、往标签数组里追加,在 redis-cli 里值本身要是合法 JSON(字符串记得加引号):
bash
JSON.SET product:1001 $.name '"手机壳Pro"'
JSON.ARRAPPEND product:1001 $.tags '"sale"'
JSON.OBJKEYS product:1001 $
价格这种加减,不必把整个对象拉到应用里:
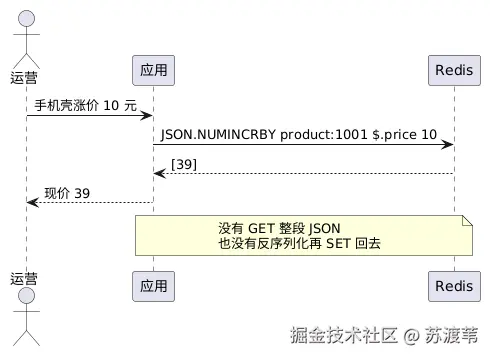
扁平、字段少、经常 HINCRBY 的,Hash 仍然合适,文档带数组、嵌套、要按路径改,再用 JSON。
两者可以一起出现:库存用 String 或 Hash,详情正文用 JSON。
二、时序:别用 List 硬堆监控点
接口耗时、CPU、库存水位,这种"时间 + 一个数字"用 List 或 Sorted Set 能凑合,聚合、保留时长、按标签批量查就得自己写。
TimeSeries 就是干这个的。
bash
127.0.0.1:6379> TS.CREATE cpu:app-order RETENTION 86400000 LABELS host gw-1 service order
OK

127.0.0.1:6379> TS.ADD cpu:app-order * 12.5
(integer) 1789635861788
127.0.0.1:6379> TS.ADD cpu:app-order * 18.2
(integer) 1789635861861

127.0.0.1:6379> TS.GET cpu:app-order
1) (integer) 1789635861861
2) 18.2
RETENTION 单位是毫秒,86400000 就是只留一天。更老的点会被丢掉,不用自己 LTRIM。时间戳用 * 表示服务器当前时间。
按标签捞一组序列:
bash
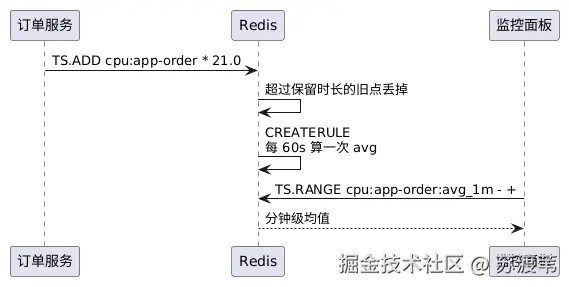
TS.MGET FILTER service=order原始点留得太密,磁盘和内存都难受。可以再建一条粗粒度序列,让 Redis 按窗口帮你算平均:
bash
TS.CREATE cpu:app-order:avg_1m RETENTION 604800000
TS.CREATERULE cpu:app-order cpu:app-order:avg_1m AGGREGATION avg 60000
源序列每来点,1 分钟窗口的平均值会写到 cpu:app-order:avg_1m。看盘、看图去读降采样之后的 Key 就行。
Redis 8.6 允许写入 NaN,表示这一拍还没采到,后面再补。
聚合时普通的 avg / sum 会跳过 NaN,不会把曲线拉成 0。
这套适合本机或单集群的指标、业务计数,已经在用 Prometheus + 远程存储的,没必要把 Redis 再当成第二套监控库。
三、向量:先能搜到相似的几段文字
Redis 8 有原生的 Vector Set:一个 Key 里放很多带向量的元素,VSIM 找最近邻。下面用 4 维凑数,线上常见是 768 或 1536,命令一样。
知识库里先放三条:
bash
127.0.0.1:6379> VADD kb VALUES 4 0.12 0.88 0.05 0.21 doc:refund
(integer) 1
127.0.0.1:6379> VADD kb VALUES 4 0.11 0.90 0.04 0.22 doc:return
(integer) 1
127.0.0.1:6379> VADD kb VALUES 4 0.91 0.08 0.85 0.02 doc:shipping
(integer) 1

127.0.0.1:6379> VCARD kb
(integer) 3
用户问"怎么退款",应用把问题编成向量(这里手工写一个接近 refund/return 的):
bash
127.0.0.1:6379> VSIM kb VALUES 4 0.12 0.87 0.06 0.20 COUNT 2 WITHSCORES
1) "doc:return"
2) "1"
3) "doc:refund"
4) "0.9995913505554199"
元素名只是 ID,正文放 JSON 里,搜到 ID 再取内容:
bash
JSON.SET rag:doc:refund $ '{"title":"如何退款","body":"订单支付后可在个人中心申请退款"}'
JSON.GET rag:doc:refund $.title
整段问答长这样:
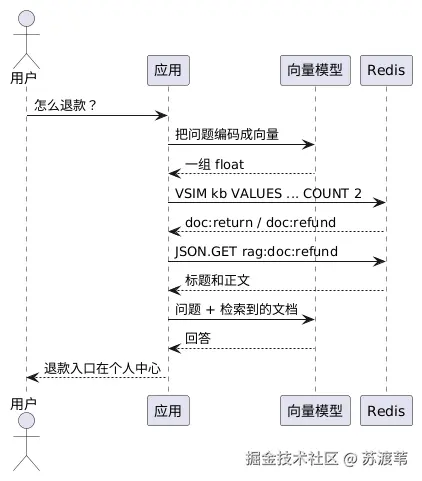
向量从哪来:调用你们现成的 embedding 接口,写入前算好,查询时再算一次问题向量。Redis 不管模型,它只存向量、做近邻。
还要按类目、价格过滤,再用 Query Engine:FT.CREATE 在 JSON 上建 VECTOR + TAG 字段,FT.SEARCH 做混合检索。
Vector Set 没有那套过滤语法,换来的是命令短、不用先建索引。
原型、内部知识库,Set 够用;商城里"相似商品 + 只要 100 元以下",再上 FT.CREATE。
四、这几个模块值不值得用
| 你在干嘛 | 可以 | 大材小用 |
|---|---|---|
| 商品详情带规格数组 | JSON | 三个扁平字段,Hash 就够 |
| 接口耗时、库存水位曲线 | TimeSeries | 已经有 Prometheus,别再抄一份 |
| 客服 FAQ、RAG 召回 | Vector Set + JSON | 没有 embedding 服务,硬塞随机数没意义 |
| 相似商品还要筛品牌、价格 | FT.CREATE 向量字段 | 只做 TopK 相似,Set 更省事 |
模块跟核心命令共享这一个 Redis 进程,内存、持久化、淘汰策略仍然是那一套。
向量和 JSON 文档很容易把内存抬上去,maxmemory 和 Key 过期该设还是要设。
老集群还是 6.x / 7.x,没有这些命令,升级到 8,或单独评估要不要为这一项去迁版本,别在业务 Redis 上先 MODULE LOAD 一个来路不明的 so。
五、练手
bash
MODULE LIST能看到 ReJSON、timeseries、vectorset 就可以往下敲,如图所示:
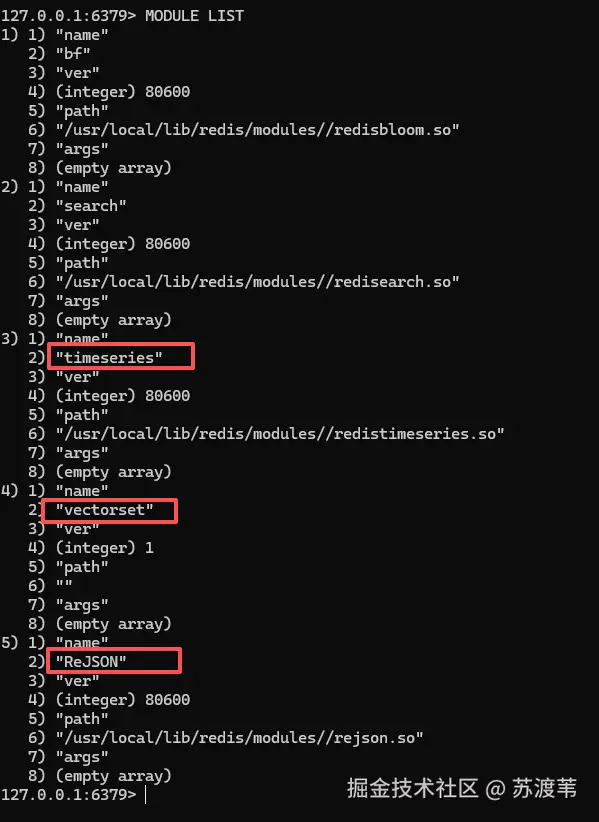
JSON.SET一个product:1001,对$.price做两次JSON.NUMINCRBY,确认不用改其他字段。TS.CREATE一条 1 小时保留的序列,TS.ADD三个点,TS.RANGE key - +能看到。VADD三个文档向量,用接近其中一条的向量做VSIM COUNT 1,看是不是你想的那个 ID。- 把第 3 步的 ID 对应一篇
JSON.SET rag:doc:...,JSON.GET把正文取出来。能走通,最小 RAG 的存储层就齐了。
下期预告:面试常问的 Redis 题,比如 单线程 / I/O 线程、过期删除、淘汰策略 ,RDB 与 AOF、分布式锁、Cluster 槽 ,事务与 Pipeline、穿透击穿雪崩、Cache-Aside 等。
本次导航结束,欢迎 关注、点赞、转发。