RAG评测体系保姆级教程:生产级实践指南
实证案例:heart-net 个人知识库 RAG(41 篇文档 / 约 4000 chunks / 100 题评测集 / 两阶段检索)
本文档整理自 2026-10-12 一整天从零建设评测体系到调参定稿的完整实践, 所有数字均为真实跑分数据(run #1 ~ #5),所有方法论均有实测验证。
0. 这份文档讲什么、给谁看
一句话定位:怎么给一个 RAG 系统建一套"能定位根因、能指导调参、能守住发布"的评测体系------从个人项目的 8 道负例,讲到生产 10 万题库的分布式跑批。
贯穿全文的实证对象:heart-net 是一个个人知识库 RAG------pgvector 余弦检索(HNSW 索引)+ qwen3-rerank 两阶段精排 + Spring AI 生成。它的规模是"小"的,但它踩过的坑、走通的闭环,与生产系统同构。
写作约定:每个抽象概念都配一个"通俗例子"框(类比先行);每个方法论都配实测数据(有据可依);关键流程配图。
1. 为什么必须有评测:一个修不动的吐槽
1.1 归因困境:一切从"答案是对的,但很散"开始
真实用户对 RAG 的吐槽往往是这样的:
"答案是对的,但很散。"
这句话没法直接修。因为"散"可能来自两个完全不同的地方:
arduino
                ┌─ 检索召回本身就散(捞回来的材料就东一块西一块)→ 检索的问题
"答案散" ───────┤
└─ 检索没问题,生成模型没把好材料组织好 → 生成的问题通俗例子:病人跟医生说"我难受"。医生不检查就开药,是庸医。 "难受"要拆成"哪里难受、什么性质的难受"才能对症下药------ 评测就是 RAG 的检查科:把"答案散"这句吐槽翻译成"哪一层、什么病灶"。
如果你只有一个端到端的"答案好不好"的感觉,那你每次改动都是在赌: 改了 prompt,检索坏没坏?不知道。换了模型,分数涨了是它真的强还是题太简单?不知道。
1.2 分层是解药:把一条链拆成两间考室
解法是把链路拆开、分别度量------这就是分层评测(L1/L2/L3)的全部动机:
| 层 | 评什么 | 隔离了什么 |
|---|---|---|
| L1 检索评测 | 给定 query,正确文档有没有被捞回来、排第几 | 把"生成"隔离出去------纯评检索 |
| L2 生成评测 | 给定相同的召回材料,答案质量如何 | 把"检索"隔离出去------材料固定,纯评生成 |
| L3 端到端评测 | Agent 全链(工具决策 + 检索 + 生成) | 不隔离,评真实用户路径 |
L3 为什么暂缓(heart-net 拍板):L1/L2 的基线还没立稳时上 L3,只增加复杂度、不给诊断价值。这和健身一个道理------还没学会标准深蹲,别上复合重量。
两个被否掉的方案:
- 只做端到端评测 ------ 被否:无法归因。分数掉了你不知道该修检索还是修 prompt。
- L1+L2+L3 一次全做 ------ 被否:战线太长。评测体系的价值在"尽早出现第一份可对比的报告",不在"一次做全"。
1.3 控制变量:评测科学性的三根柱子
评的是"当前生产配置",不是理想化的玩具:
- L1 走真实检索链路(含 rerank 精排)------不是 mock 一份检索结果,就是生产那条链;
- L2 用固定生成模板(不走 Agent 的 ReAct 循环)------评"给定相同材料下谁答得好",把工具决策隔离出去;
- config_snapshot 记录每轮全部参数------改任何参数重跑一轮,和基线对比就是 A/B 证据。
通俗例子:控制变量就是"对照实验"------药物试验要安慰剂组。 没有 config 快照的评测,就像没有记录剂量的药物试验:结果无法解释,也无法复现。
2. 评什么:指标字典与读法
2.1 全景:一轮评测 = 一次检索 + 两份成绩单
很多人问"L1 评测怎么跑?要不要单独发起?"------不需要。每轮评测天然产出 L1+L2 全部指标:
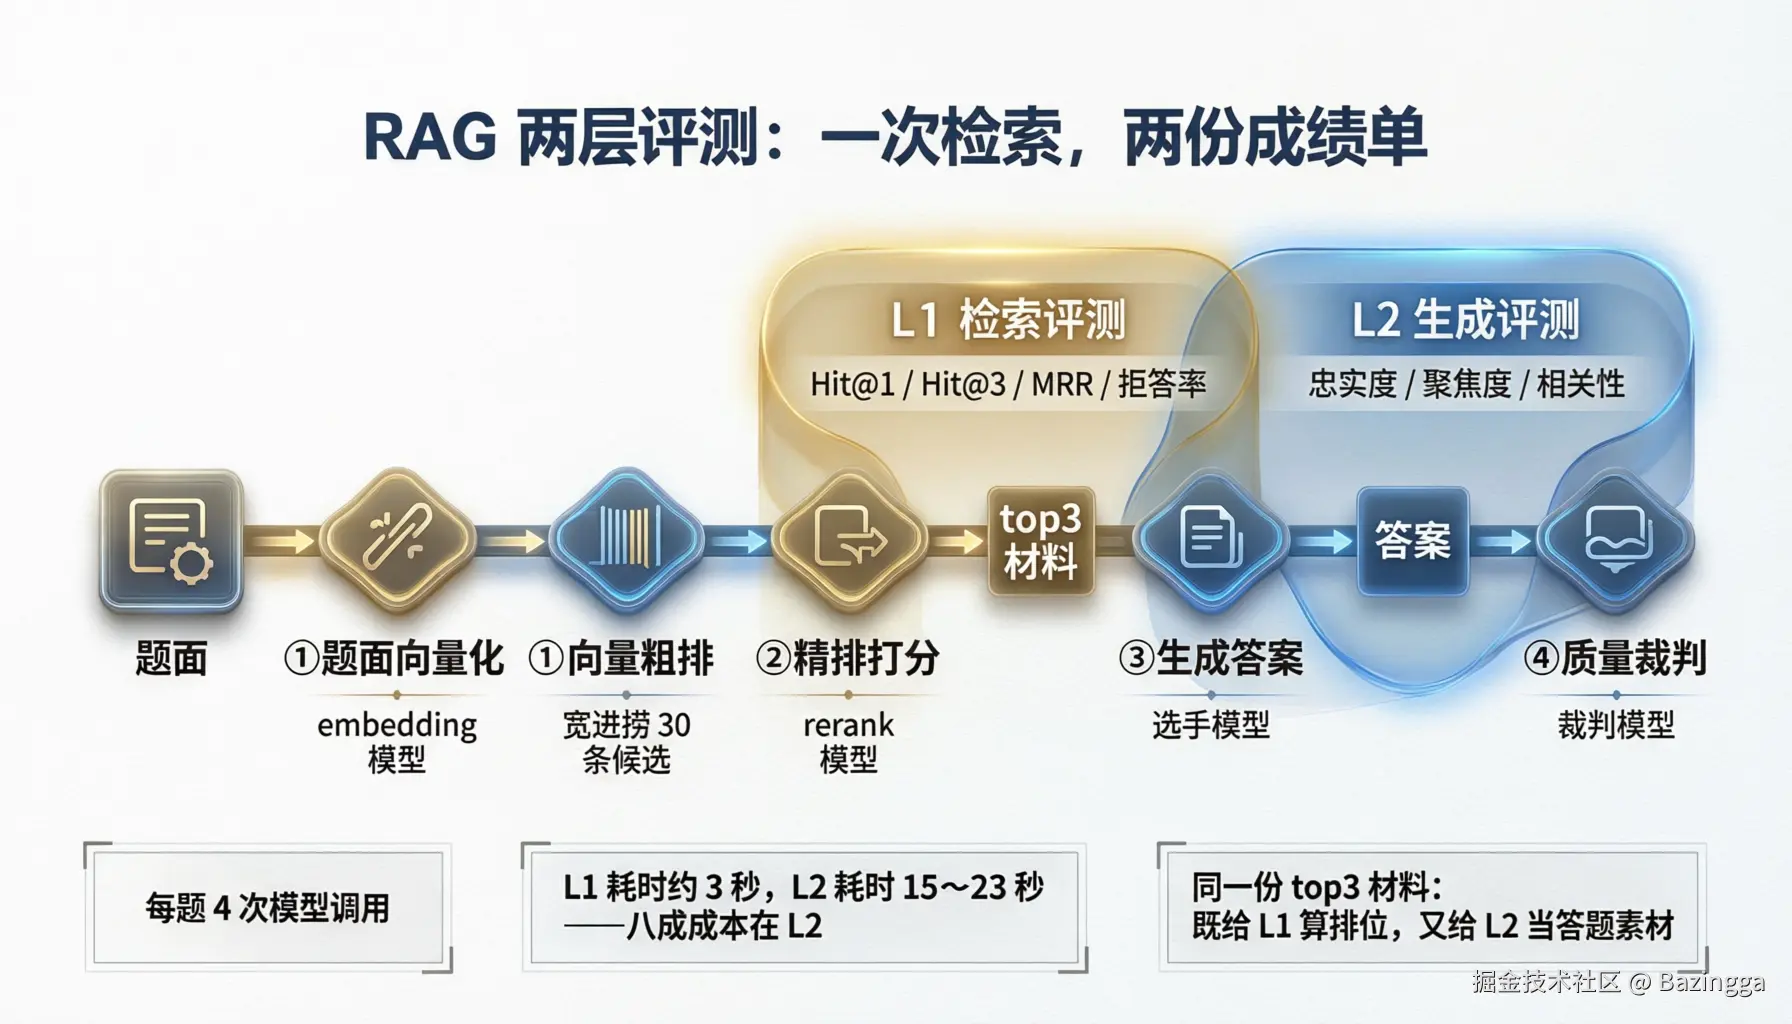
题面经过检索链路得到 top3 材料:这 3 条材料既被 L1 拿去算排位,又被原样喂给生成模型当素材------一次流水线,两份成绩单。
2.2 L1 指标:同一批排位数字的三种读法
L1 的原始数据只有一个:每道题的 hitRank(gold 文档在最终结果里排第几)。三个指标全是它的函数:
| 指标 | 定义 | 严格程度 |
|---|---|---|
| Hit@1 | gold 恰好排第 1 位的题占比 | 最严:必须登顶 |
| Hit@3 | gold 进了前 3 的题占比 | 宽松:进圈就算 |
| MRR | 平均排位倒数(排第 1 得 1 分,第 2 得 0.5,第 3 得 0.33...) | 精细:排第 2 和第 3 也区分开 |
| 负例拒答率 | 库外问题被"空召回"拒绝的比例 | 专考"该不该说不知道" |
通俗例子:三个指标 = 同一次赛跑的三张榜单: Hit@1 是"金牌数"(只认冠军)、Hit@3 是"领奖台数"(前三都算)、 MRR 是"平均名次分"(第 2 名和第 3 名也不一样值钱)。
heart-net 实算(run #1,11 道 cross 题):
- 6 题排第 1、2 题排第 2、3 题排第 3
- Hit@1 = 6/11 ≈ 55%
- Hit@3 = 11/11 = 100%
- MRR = (6×1.0 + 2×0.5 + 3×0.33) / 11 ≈ 0.73
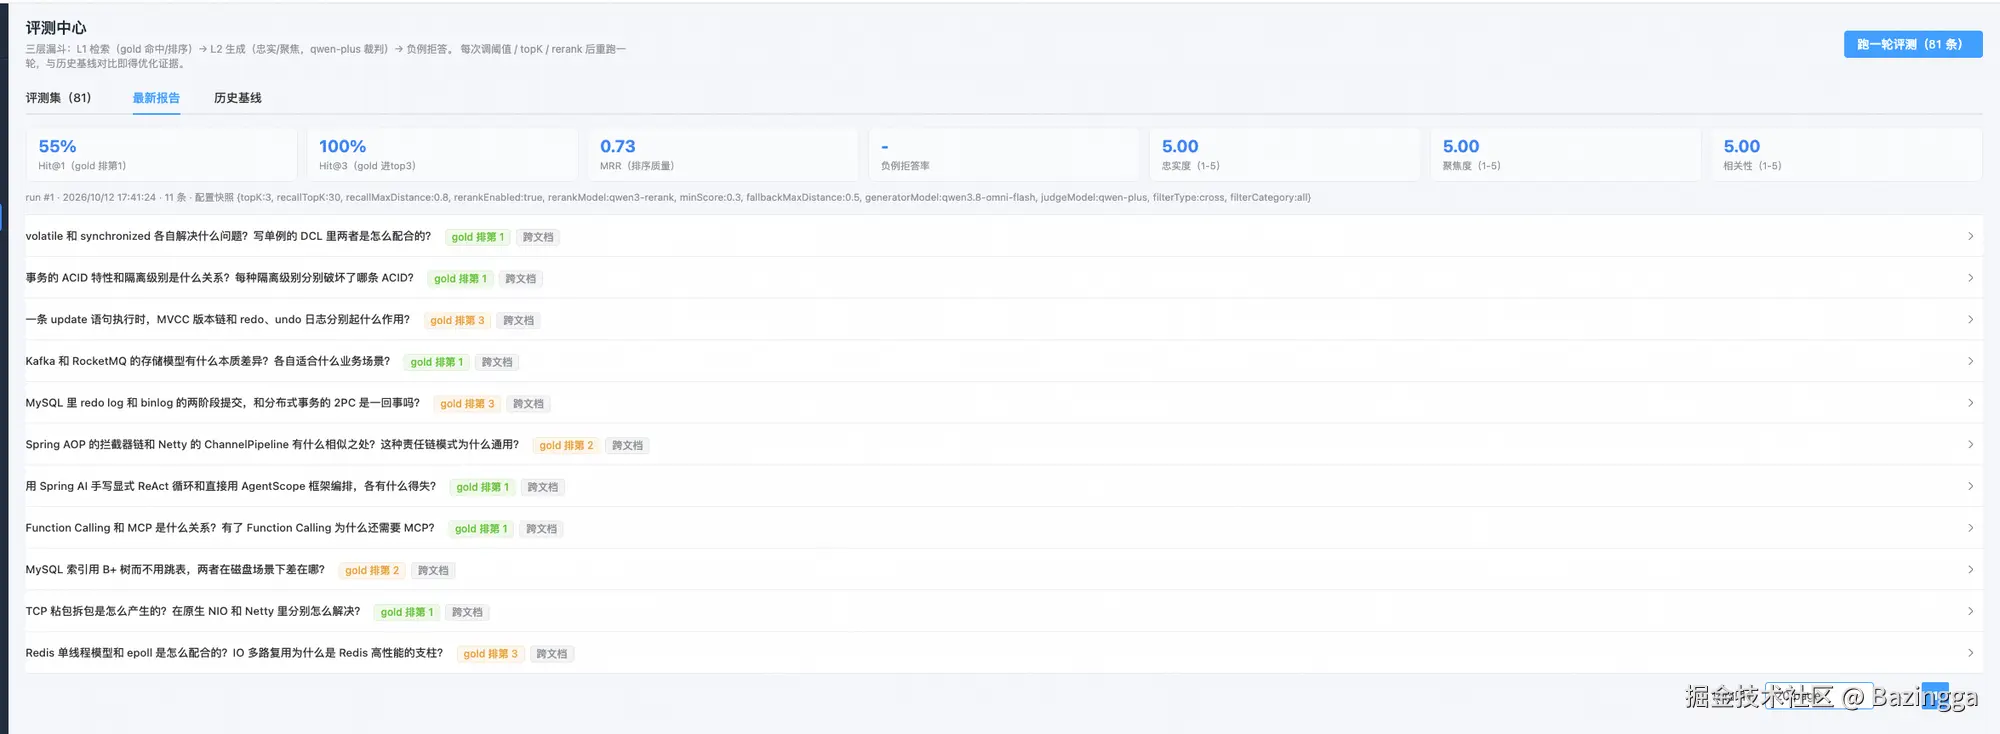
现场证据(2026-10-12 评测中心实测界面):七项指标卡逐项可见------55% / 100% / 0.73 三张 L1 卡、拒答率显示「−」、L2 三维 5.00;下方逐题挂着「gold 排第 1 / 2 / 3」标签(6/2/3 的分布一目了然),底部一行配置快照(run #1 · 11 条 · minScore:0.3 · filterType:cross...)。注意拒答率那格的「−」------全正例题集练不出闸门指标,正是 §5.4 要讲的现场写照。
这三个数可以手工验算出来------写评测报告时现场验算给读者看,比讲十句指标定义都有说服力,它同时证明了两件事:指标没算错,你也真懂了指标。
2.3 L2 指标:三维病历,不是一个总分
L2 由裁判模型(独立于选手,避免自评偏差)按三个维度打 1~5 分,每个维度抓一种病:
| 维度 | 裁判口径(prompt 原文) | 抓的病 |
|---|---|---|
| 忠实度 | 答案内容有多少能被检索资料支撑(5=全部有出处,1=基本是编造) | 幻觉:材料里没有的,答案里编了 |
| 聚焦度 | 答案前 1~2 句是否直接回应问题核心(5=开门见山,1=铺垫冗长绕远) | 散:答对了但绕远、不直击要点 |
| 相关性 | 答案整体与问题的相关程度(5=完全切题,1=答非所问) | 答偏:整篇答的是另一道题 |
为什么拆三维而不是打一个总分?因为"答案不好"至少有三种不同的不好,拆开才知道修哪里。聚焦度这一维尤其值得注意------它就是 1.1 节那句"答案对但很散"吐槽的量化刻度,整个评测体系就是从那句话起家的。
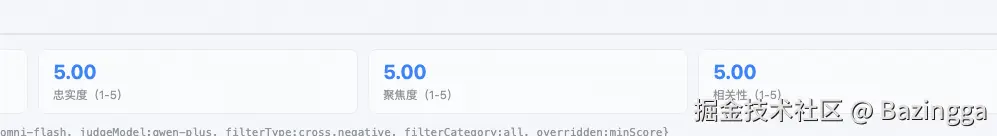
现场证据(评测中心实测界面):忠实度 / 聚焦度 / 相关性三张 5.00 记分卡与底部配置行------三个分由独立裁判模型 judgeModel:qwen-plus 打出,与选手 qwen3.8-omni-flash 分离。至于全 5.00 该怎么读,先卖个关子:见 §6.2「满分是警报」。
裁判还有一个分数之外的隐藏产出 :幻觉句清单------把答案中无资料支撑的句子逐句揪出来列成清单。分数是判决书,清单是呈堂证物:忠实度哪天掉分,点开明细直接看到具体哪几句在编,不用猜。
三维要交叉读,单看一个数没有信息量:
| 读数组合 | 诊断 | 修哪里 |
|---|---|---|
| 忠实度低 + 相关性高 | 一本正经答这道题,但内容是编的 | 生成 prompt 收紧"仅依据材料";或材料不够 |
| 忠实度高 + 相关性低 | 句句有出处,但答的是另一道题 | 先回看 L1 的 Hit@3------材料拿错了 |
| 忠实高 + 相关高 + 聚焦低 | 答得对且真,但铺垫绕远 | "散"实锤------修生成模板,与检索无关 |
| 忠实度低 + Hit@3=100%(跨层) | 材料明明全对,生成时还编 | 纯 L2 的锅 |
| 忠实度低 + Hit@3=0(跨层) | 检索空转,硬着头皮编 | 该拒答没拒答------L1 的锅 |
最后两行是分层评测最大的价值:同一个"忠实度低",配不同的 L1 读数,锅在不同层。不分层你只能看到"答案质量差"一个现象。
2.4 负例拒答率:RAG 评测最容易被漏的一环
绝大多数自建评测只考"能不能答对",不考"该不该闭嘴"。但 RAG 的第一信任问题是:库里没有的知识,系统会不会硬编?
- 负例题的构造:题面问的是知识库根本没有的东西(heart-net 实例:Go 语言 GMP 调度、React Fiber、量子比特、光线追踪------对一个 Java 知识库全是库外题)
- 判定标准:检索空召回 = 拒答成功;捞回来任何东西 = 误召回(扣分)
通俗例子:知识库是你的仓库,检索是仓管员。 考仓管员的问题不止"让他找的东西能不能快速找到"(正例), 还要考"仓库里根本没有的东西,他会不会随便拿个别的糊弄你"(负例)。 一个"仓库里没有也说没有"的仓管员,才值得托付。
2.5 一轮评测的完整成本账:每题 4 次模型调用
评测不是查库对答案,是全程调真实模型。每道题的调用账:
| 次 | 层 | 模型 | 干什么 | 耗时量级 |
|---|---|---|---|---|
| ① | L1 | text-embedding-v3 | 题面 → 1024 维向量 | ~1s |
| ② | L1 | qwen3-rerank | 给 30 条候选逐条打相关性分 | ~2s |
| ③ | L2 | qwen3.8-omni-flash | 拿 top3 当材料写答案(选手) | 10~15s |
| ④ | L2 | qwen-plus | 三维打分 + 幻觉句清单(裁判) | 5~8s |
耗时结构 :L1 两次合计 3s,L2 两次合计 15 23s------每题 20~30s 里约八成耗在 L2。这个数字是后面所有成本策略(L1 全量 L2 抽样、skipL2 扫参)的物理依据。
一个高频误区:文档向量和 query 向量的区别
- 库内 chunks 的向量:摄入时一次性算好,检索时零成本复用
- query 的向量:每次现场算------没人能预知下次问什么,每句新题面的向量都不存在
- rerank 分:query × 候选的组合现场打分,无法预算(候选池还随参数变)
通俗例子:图书馆的书都编好了索引卡(文档向量,一次性成本), 但读者每来问一个新问题,管理员都得先"听懂问题"(query 向量化,每次成本) 才能去翻索引卡。书的索引可以提前做完,问题的理解做不了提前。
三条"少调模型"的路,各归其位(容易混):
| 路 | 性质 | 省多少 | 用途 |
|---|---|---|---|
| 停用 rerank | 改变量(A/B 测 rerank 净贡献) | ~10% | 实验旋钮,指标本来就要动 |
| skipL2 开关 | 改流程(L1-only 扫参提速) | ~80% | 省钱开关,口径变窄;与生产"L1 全量 L2 抽样"同族 |
| query 向量缓存 | 改实现(纯优化) | 同题面重跑免 embedding |
误区警告:停用 rerank 不是省钱跑法------停了 rerank,生成+裁判照样全跑(L2 不知道检索内部发生了什么),省的 2 秒在 25 秒里看不见。它是给"rerank 到底值不值"这个 A/B 实验用的。
2.6 一轮评测的交接链(谁把什么给谁)
① embedding:题面 → 向量
② rerank:30 候选 → top3 材料
③ 考生输入 = 题面 + top3 材料 → 输出答案
④ 裁判输入 = 题面 + top3 材料 + 答案 → 输出三维分 + 幻觉句清单裁判看的是三样全看 :忠实度要拿答案逐句对照材料(不然没法判断哪句是编的)、相关性要拿答案对照题面。四个模型各管一段、互不认识------考生不调 embedding 也不调 rerank,embedding 和 rerank 也不知道自己服务的是评测还是线上对话(同一条链)。
评测调的模型 = 生产链路的模型(同 yml 同 key)。这是有意设计:评的就是"当前生产配置",分数才代表真实对话质量。
3. 评测集工程:题库是评测的地基
3.1 题型配比:为什么是 80 fact / 12 cross / 8 negative
heart-net 100 题的配比与理由:
| 题型 | 数量 | 考什么 | 为什么需要它 |
|---|---|---|---|
| fact 事实题 | 80 | 单文档单知识点召回 | 基本盘:主流问答场景的形态 |
| cross 跨文档题 | 12 | 多文档综合(如"Kafka 和 RocketMQ 消息模型差异") | 检索最难、最暴露排序问题的题型 |
| negative 负例题 | 8 | 库外问题该拒答 | 2.4 节:信任问题的考卷 |
通俗例子:一张好考卷不能全是送分题。 事实题是"基础题"(验基本功)、跨文档题是"压轴题"(验综合能力)、 负例题是"陷阱题"(验"知不知道自己不会")------三类题测的是三种不同能力。
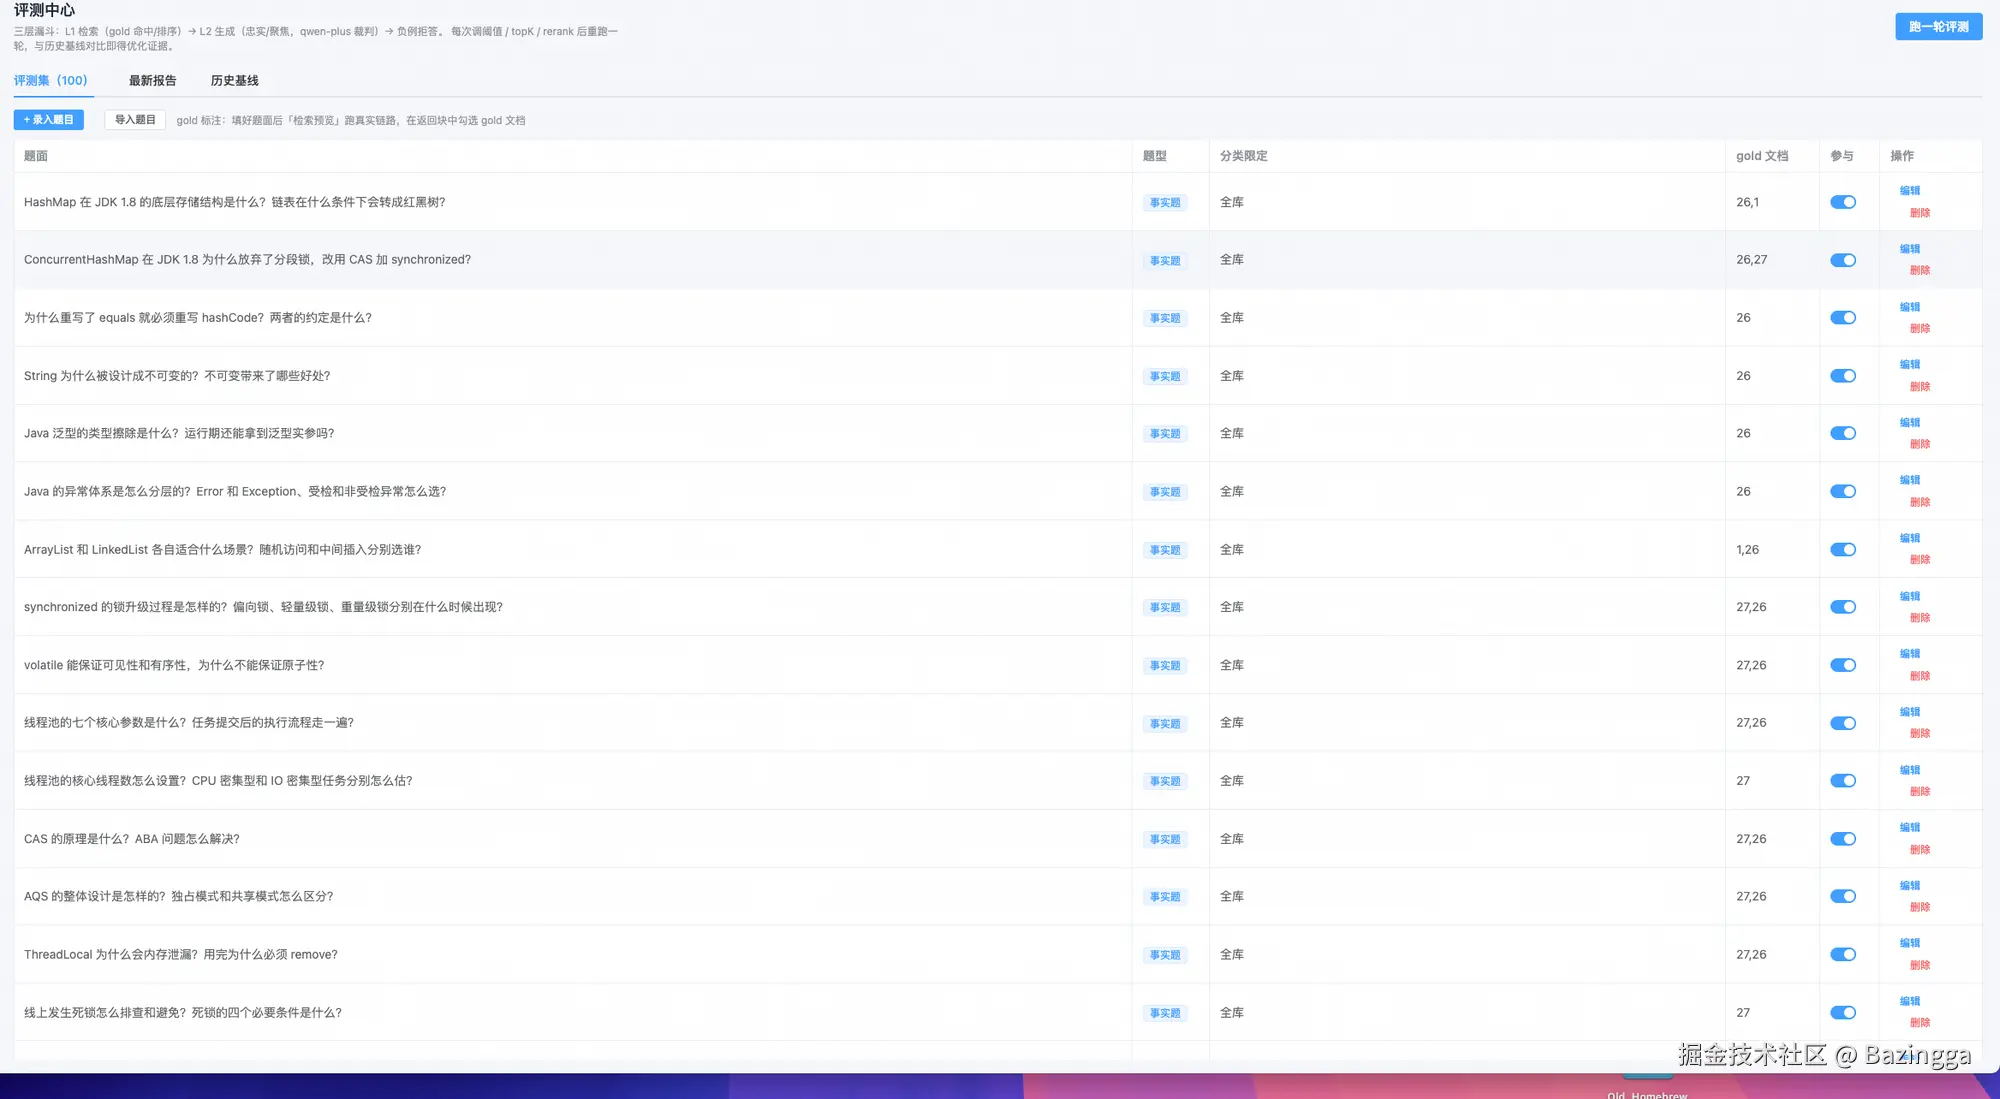
现场证据(评测中心实测界面):100 题评测集的管理列表------题面 / 题型标签 / 分类限定(全库)/ gold 文档数 / 参与开关逐列可管理,配「录入题目」「导入题目」两个入口。§3.4 说"题库是活的",这张页面就是那句话的产品载体。
3.2 gold 标注:标准答案怎么写
- gold 用文档标题 表达(
goldTitles,人类友好),导入时解析成 docId------不用维护 ID 映射表,文档标题改了肉眼可查 - 跨文档题多标 gold:命中任一 gold 即算 hit,横跨多主题的题把相关篇都标上
- 命中判定口径:"任一 gold 即算 hit"------这条直接决定 Hit@1 的可抬升空间
出题纪律(防考卷污染,详见 §6.2) :出题凭记忆里的知识点想问题、gold 凭"答案物理上在哪篇文档"判定,然后再跑检索------不要看着系统检索结果勾选 gold。后者是"看着学生答案出考卷",题目天然偏向系统已能召回的模式。
交付前自检 :出完题用脚本模拟导入解析器全量自检(100 题 0 失配才敢入库)。heart-net 实践中这个自检直接抓住过一个致命 bug:md 解析器的二级标题判断写在了 # 规则之后,所有题目被吞、解析出 0 题------没有自检这批题就是一次交付事故。
3.3 分层题库金字塔:生产从来不"每次跑全部题"
核心认知:题库是分层的,跑的频率与层级反相关。
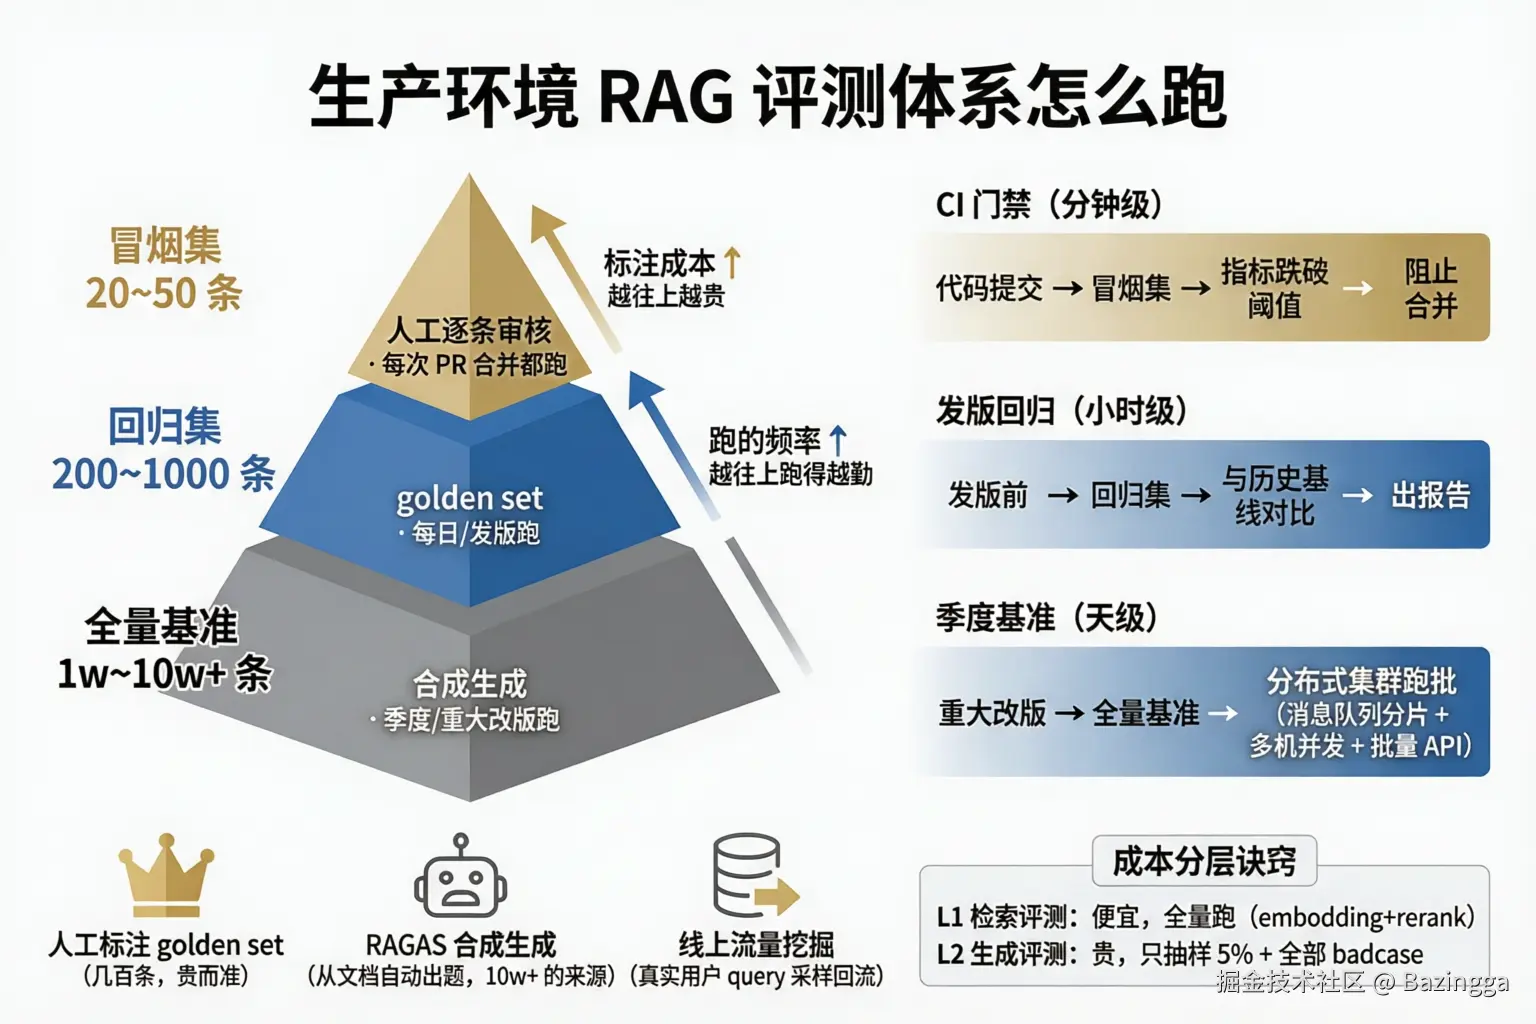
| 层 | 规模 | 来源 | 频率 |
|---|---|---|---|
| 冒烟集 | 20~50 条 | 人工逐条审核 | 每次 PR 合并,分钟级 |
| 回归集 golden set | 200~1000 条 | 人工标注 + 流量采样回流 | 每日/发版,小时级 |
| 全量基准 | 1w~10w+ | 机器合成生成 | 季度/重大改版,天级 |
通俗例子 :运动员的训练计划。 日常训练(冒烟集):每天的小强度课表,动作不对立刻纠正; 阶段测验(回归集):月考,跟历史成绩比有没有退步; 大赛选拔(全量基准): quarterly 的大考核,全面体检。 没有运动员每天跑一次全马------用跑的频率换层的深度。
关键事实:10w+ 题几乎不是人写的 。人工标一条 L2 题 5~15 分钟,10 万条 = 一个标注团队干一年。全量层的题是合成生成的:每篇文档喂给 LLM 自动生成"问题 + 期望出处 + 参考答案",按线上流量比例混 simple / multi-hop(多跳)/ hypothetical(假设性)题型。
heart-net 对照定位 :100 题全指标 ≈ 标准回归集规模(个人库 41 篇文档,100 题覆盖密度足够);冒烟集可从 100 题里挑 30 条标记出来;10w 级在 40 篇文档的问题域下不存在(合成上限几千题)------不用为不存在的量级上分布式基建。
3.4 题库是活的:三类进化 + 在线回流
静态题库会"过期"------系统进步了,考卷还在考老掉牙的东西。保持题库活性:
- 对抗性负例:找系统"擦边会错"的题(术语撞车、同域不同物、大杂烩文档擦边------§5.3 的 33 号文档案例就是负例扫出来的)
- 口语化变体:给重点题配"那篇讲 GC 的帮我总结下"这种真实问法(工整考卷 ≠ 随口提问,问法漂移是离线分数与线上体感脱节的主因)
- 在线回流 :生产坏例不是离线扫出来的,是用户行为喂回来的------点踩、追问、低采纳的 query 回流入题库变成新考题
通俗例子 :错题本。好学生的错题本不是一次抄完的, 是每次考试(每次线上出 badcase)往里添的------评测集 = 系统的错题本。
3.5 统计置信:你的"95%"可能不是 95%
小样本的数学底线------rule of three :n 道负例全部拒答正确时,真实拒答率的 95% 置信下限约为 1 − 3/n:
| 负例数 | 全对时能宣称的下限 |
|---|---|
| 8 道 | 仅 63% |
| 30 道 | 90% |
| 60 道 | 95% |
| 300 道 | 99% |
通俗例子 :抛 3 次硬币全是正面,你不能说"这枚硬币 100% 出正面"。 8 道负例全对的"100% 拒答率",统计上只配说"不低于 63%"------ 想让"95%"这三个字有统计意义,先问分母够不够。
4. 跑批工程化:从 30 分钟到 4 分钟
4.1 执行模型五阶段演进(每步一个真实瓶颈驱动)
| 阶段 | 形态 | 瓶颈驱动 |
|---|---|---|
| 0 | 设计拍板:Java 内嵌评测(不引 Python+RAGAS 技术栈)、裁判独立成模、@Profile("local") 只在本地暴露 | 个人项目的最小依赖原则 |
| 1 | 手工 5 题试跑:先证明"query → 召回明细 → L1 → L2 → 报告"漏斗成立再铺量 | 链路未验证前不投入题库 |
| 2 | 100 题库 + 三格式批量导入(md/xlsx/docx) | 手工录题不可持续 |
| 3 | 列表真分页 + 筛选圈范围跑批(题型/分类筛选与跑分范围同源,跨页全集) | 全量数组撑爆页面;"题目多了不可能每次全量跑" |
| 4 | 异步 + 8 路并行:串行 100 题要 30~50 分钟 | 实测 20~30s/题 × 100 |
| 5 | 沙箱调参面板:调参从"改 yml→重启→跑"的分钟级缩到秒级 | 调参实验频次上来后重启循环太重 |
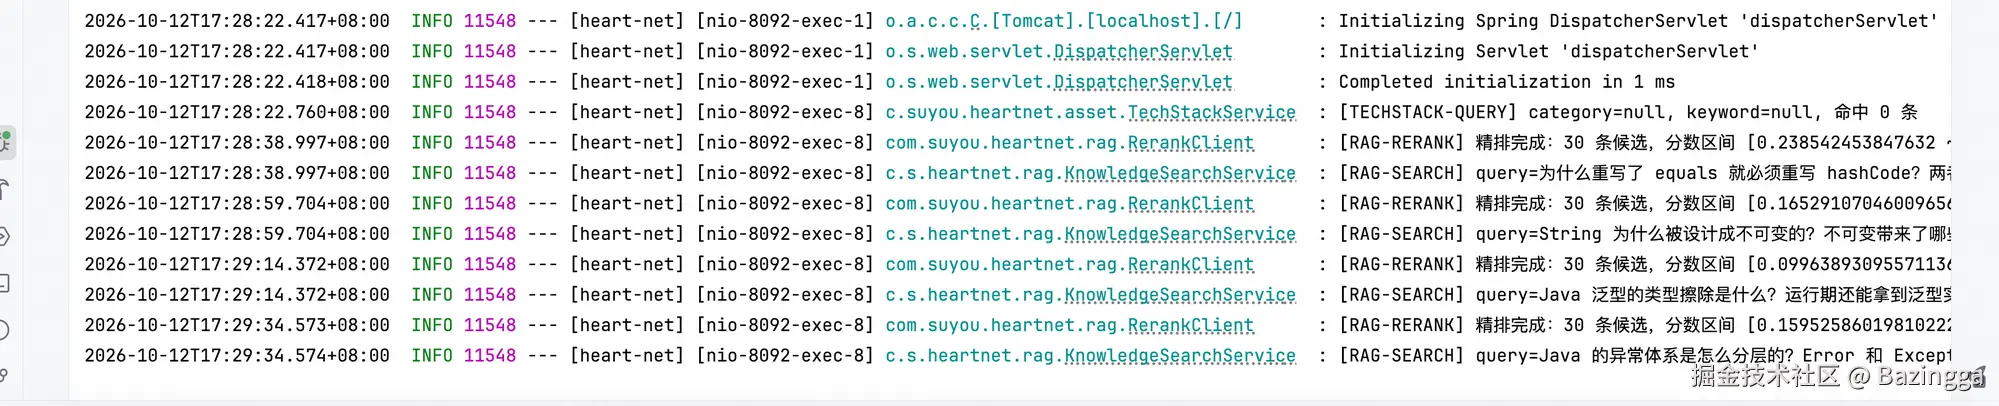
现场证据(后端日志实测):串行跑批时相邻两条 RAG-RERANK 日志间隔 1620 秒------每题 4 次模型调用排队执行,"平均 2030s 一条"的体感在日志里逐行可数。这就是阶段 4(异步 8 路并行)的直接动因。
4.2 异步并行架构(阶段 4 细节)
bash
POST /run ──→ 双跑防护(已有评测在跑则拒)──→ 异步秒回 {started, total}
                                                      │
                    ┌─────────────────────────────────┘
                    ▼
             eval-runner(单线程:串行提交 + 按完成序回收)
                    │
                    ▼
             workerPool(固定 8 路工作线程,rag.eval.parallelism 可调)
                    │  每题:embedding → rerank → 生成 → 裁判
                    ▼
             单条容错:一条炸了记 error 明细,不炸整轮
                    │
                    ▼
             汇总落库(指标口径与串行版完全一致)

GET /run/progress ←── 前端 3s 轮询:done/failed/elapsed + 进度条
                      (刷新页面可恢复进度,onUnmounted 停轮询)
关键取舍:
- 为什么异步:同步等待下刷新页面就失去可见性;进程内进度对象 + 轮询端点能低成本做到"不中断、回来续看"
- 为什么单消费者 + 多工人:汇总侧串行(按完成序回收,指标口径稳定),执行侧并行(各题相互独立------检索只读、生成/裁判无状态,并行化是唯一正解)
- 单条容错:一条题的模型调用失败只记 error 明细按 miss 计,不炸整轮------评测的可观测性优先
- 配套扩容:8 路并发必须同步扩连接池(hikari 5→10),再调大并行度必须再扩池
- 预期收益 :100 题从 30
50 分钟 → 46 分钟(8 倍上界,瓶颈在生成 RTT)
4.3 成本两板斧:L1 全量、L2 抽样
面对 1000+ 题的回归集,成本策略不是"全都省",是按层分配:
- L1 全量跑:embedding + rerank 便宜(每题 ~3s),全跑
- L2 只抽 5% + 全部 L1 badcase :L1 都没命中的题,L2 必然烂,这些必须全评------专抓"检索改了把答案带歪"的跨层回归;其余 L2 随机抽样即可
- 裁判分级:小裁判模型粗筛,异常/低分的再上贵模型精评
通俗例子 :体检。血常规便宜,每次都做(L1 全量); 核磁共振贵,血常规异常的才加做(badcase 全评), 健康人群抽样做(L2 抽样)。贵的检查对准异常信号,便宜的检查铺满全员。
4.4 面向 10w+ 的分布式跑批(了解即可)
规模到万级以上时,单机并行不够用,换技术栈:
- 消息队列分片:题库切片投队列,多 worker 消费
- 批量 API:Batch API 半价(24 小时时效------天级任务正好等得起)
- 断点续跑:checkpoint 机制,跑挂了从断点继续,不重烧已完成的题
heart-net 量级用不上,但要知道存在这条路径------基建跟着量级走,不提前上。
4.5 config 快照:评测的可观测性(一个取证故事)
每轮评测落库一条 config_snapshot:记录本轮全部生效参数(topK / recall宽度 / 粗排闸 / rerank 模型与分数闸 / 降级闸 / 选手与裁判模型 / 筛选范围 / 被沙箱覆盖的键)。
快照必须是"运行时实跑值",不是"配置声明值"------heart-net 用一次事故证明了这条的价值:
run #1 跑完,快照里
recallTopK:3------但 yml 写的 30、Java 默认值也是 30。 三方对照锁定:跑分时刻进程里生效的就是 3(某处配置链路把它顶掉了)。 含义:粗排只捞 3 条给 rerank 排------"宽进窄出"退化成"窄进窄出", rerank 根本没有候选池可选,Hit@3 100% 其实只证明了向量粗排自己能进前 3。如果没有快照,这个坑永远不会被发现------你会一直以为自己在测"宽召回 + 精排"的两阶段。
快照的两大用途:
- A/B 证据:改任一参数重跑,新旧快照对照即得归因------"这轮分数是在什么条件下跑出来的"的完整档案
- 防子集基线误用 :
filterType:cross记在案,55% 的 Hit@1 是 11 题子集分,不会被误当全量基线对比
通俗例子 :实验记录本。每次实验记全试剂批号、温度、仪器参数------ 半年后结果对不上,翻本子就知道是哪变了。没做记录的实验,出了结果也无法解释。
5. 调参方法论:本指南最厚的一章
5.1 依赖链四道关:先知道每个参数管哪段
检索链路上的指标(尤其 Hit@1)是四道关串联的结果,谁挂谁背锅:
markdown
题面 → ① 向量粗排(进候选池 = 资格线)→ ② rerank 精排(登顶之战)→ ③ topK 截断(排位定格)→ hitRank
④ 题库与切块质量在背后托底(模型救不了的部分)| 关 | 谁负责 | 这关挂了的表现 |
|---|---|---|
| ① 资格线 | embedding 模型 + 余弦距离粗排闸 | hitRank=null------gold 根本没进候选池,Hit@3 都没份 |
| ② 登顶之战 | rerank 模型 + 分数闸 | 排第 2/3------过了资格线,输在排序 |
| ③ 排位定格 | topK | gold 排第 4 以后,明细里看不到 |
| ④ 托底 | 出题人 + chunking | gold 标错 / 题面措辞离文档太远 / 最相关段落被切碎------①②再强也白搭 |
通俗例子 :选秀节目。 ①初选(进 30 强海选池)→ ②评委排序(谁能站 C 位)→ ③只签前 3 名。 一个选手没出道,先看他是没进海选 (召回问题)还是进了海选但排名不够(排序问题) ------修法完全不同。④是"选手本身的实力底子"(语料质量),节目组(模型)救不了。
5.2 旋钮经济学:先参数,后模型
发现瓶颈在某个模型之后,本能反应是"换更强的模型"。顺序反了:
| 层 | 是不是"模型" | 抓手 | 成本 |
|---|---|---|---|
| 模型选型 | 是(判断力本身) | 换更强 rerank | 贵,见效大 |
| 模型周边参数 | 不算(闸门配置) | 分数闸/召回宽度/topK------沙箱面板直接 A/B | 便宜,不动代码不换模型 |
| 题库与切块 | 模型救不了 | gold 标注 / 题面措辞 / 切块参数 | 兜底排查项 |
正确顺序:先拧便宜的旋钮(参数),红利吃尽再动贵的旋钮(模型)。反过来的代价:换了模型,你不知道新分数是在什么参数配置下跑的------归因全乱。
两个必须内化的提醒:
- 模型强 ≠ 分数必然高。换了顶级 rerank 分数反而降,第一反应是翻明细查 gold 标注/切块质量,而不是怀疑模型------分层评测的意义就是能区分"模型之过"还是"数据之过"。
- 每个旋钮都要配得上自己的存在。动一个参数前,先能回答"它管哪道关、动了它会动什么指标"。
5.3 完整案例:三次指标不动 → 分离带取证 → 闸值定稿
这是本指南最重要的实操案例,一次走完"调参科学化"全过程。背景:11 道 cross 题基线 Hit@1 55% / Hit@3 100% / MRR 0.73,用沙箱面板做单变量实验。
第一幕:三次"指标纹丝不动"(run #2/#3/#4)
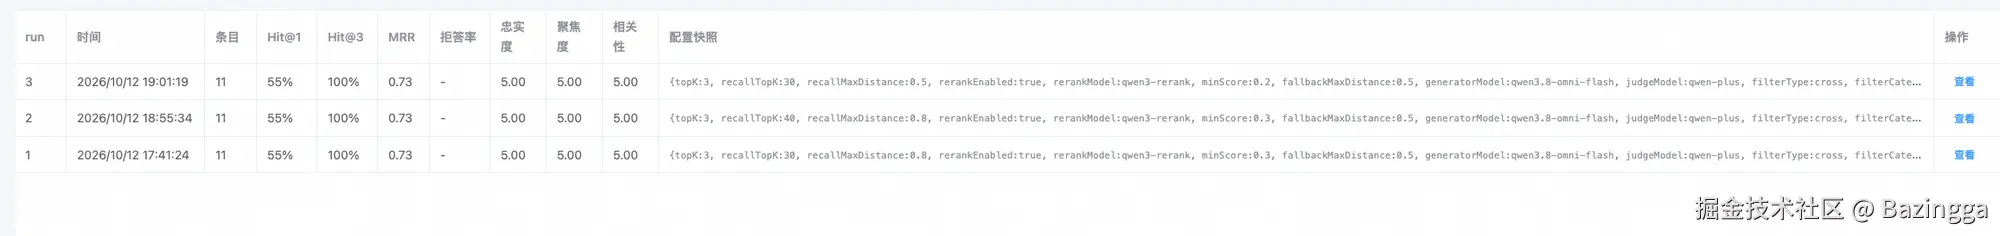
现场证据(历史基线页实测):run #1 / #2 / #3 三行记录的配置快照各不相同(召回宽度、粗排闸分别动过------参数确实生效了),但七项指标逐字不动。下表的每一行,都是从这三行基线里读出来的。
| 轮 | 单变量改动 | 结果 |
|---|---|---|
| run #2 | 召回宽度 30→40(扩候选池) | 三指标全不动 |
| run #3 | 粗排闸 0.8→0.5(收严) | 三指标全不动 |
| run #4 | 分数闸 0.3→0.2(放松)+ 加跑 8 道负例 | 正例指标不动;负例拒答率 63%(3 道误召回) |
参数生效了吗? 生效了------快照如实记录了每轮新值,明细里候选池确有微变(run #2 的某题第 2 名从 9 号文档 chunk 换成了 8 号文档 chunk)。只是变化没强到翻转任何一题的 top3 排位。逐参数解释:
- 扩池零效果:这批题的 gold 全在粗排前 3 附近,新放进来的第 31~40 名全是弱相关------对已经"近登顶"的题,扩池只给了 rerank 更多陪跑的候选
- 收粗排闸不伤正例:这批正例的向量距离全在 0.5 以内,闸收到 0.5 还在安全区
- 放分数闸不治排序:分数闸只管"谁被丢弃",不管"谁排第一"------放松它只会让更多弱分候选幸存,它们分数低永远进不了 top3
价值重估:指标不变 ≠ 白跑 。这三轮免费做了三次稳健区间验证------证明当前排序结论对门参数(池宽/粗排闸/分数闸)稳健,怎么拧都不动。生产要的正是这种"平台区",不是单点尖峰。
第二幕:负例误召回取证(run #4 的 63%)
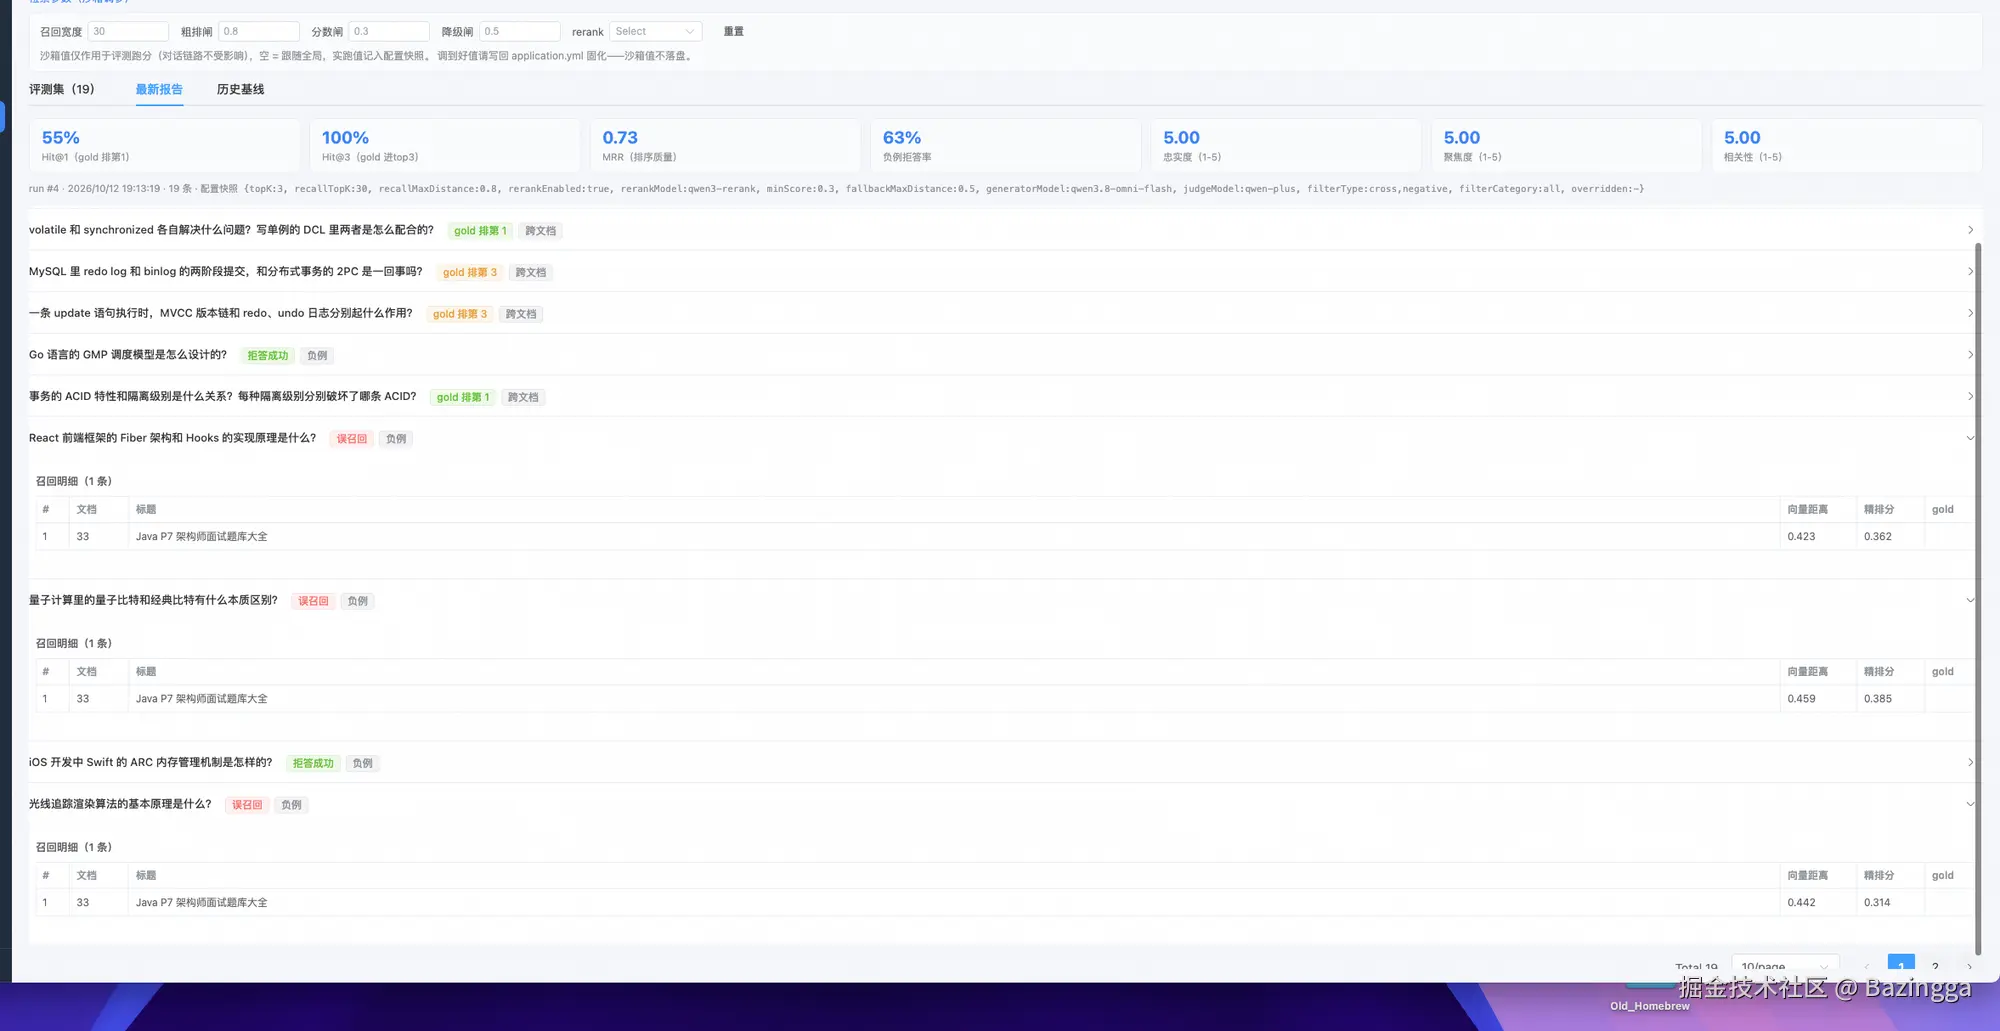
现场证据(run #4 报告页实测):拒答率 63%;React Fiber、量子比特、光线追踪三道负例全部误召回,且召回块明细指向同一篇文档《Java P7 架构师面试题库大全》------本幕全部取证由此展开。
8 道负例:5 道拒答成功(空召回),3 道误召回------React Fiber、量子比特、光线追踪,三条全部命中同一篇文档:《Java P7 架构师面试题库大全》(1085+ chunks、16 个主题卷的大杂烩)。
擦边机制(查库取证):文档里根本没有 React/量子/光线的内容------搜 "React" 只命中 "Reactor 模型与 Netty"(字面撞车);而这篇文档上千个 chunk 的标题路径全是"XX 本质与底层原理/架构"------任何"......的基本原理是什么?"句式的题面都能在它身上蹭出浅相似。
第三幕:两空间分辨力对比------处方只能开在精排闸
| 向量距离(粗排空间) | rerank 分(精排空间) | |
|---|---|---|
| 三条误召回 | 0.423 / 0.442 / 0.459 | 0.314 / 0.362 / 0.385 |
| 正例候选 | ~0.35 ~ 0.55(与负例完全重叠) | 第 3 名最低 0.612、top1 最低 0.676 |
| 分得开吗 | 分不开------收闸拦负例必然误杀正例,此路不通 | 0.39~0.61 是一条干净分离带 |
结论清晰:模型没有错(它已经把负例打到了低分区),是闸太松放行。粗排闸无药可救(几何空间正负例混居),处方只能是提高精排分数闸。
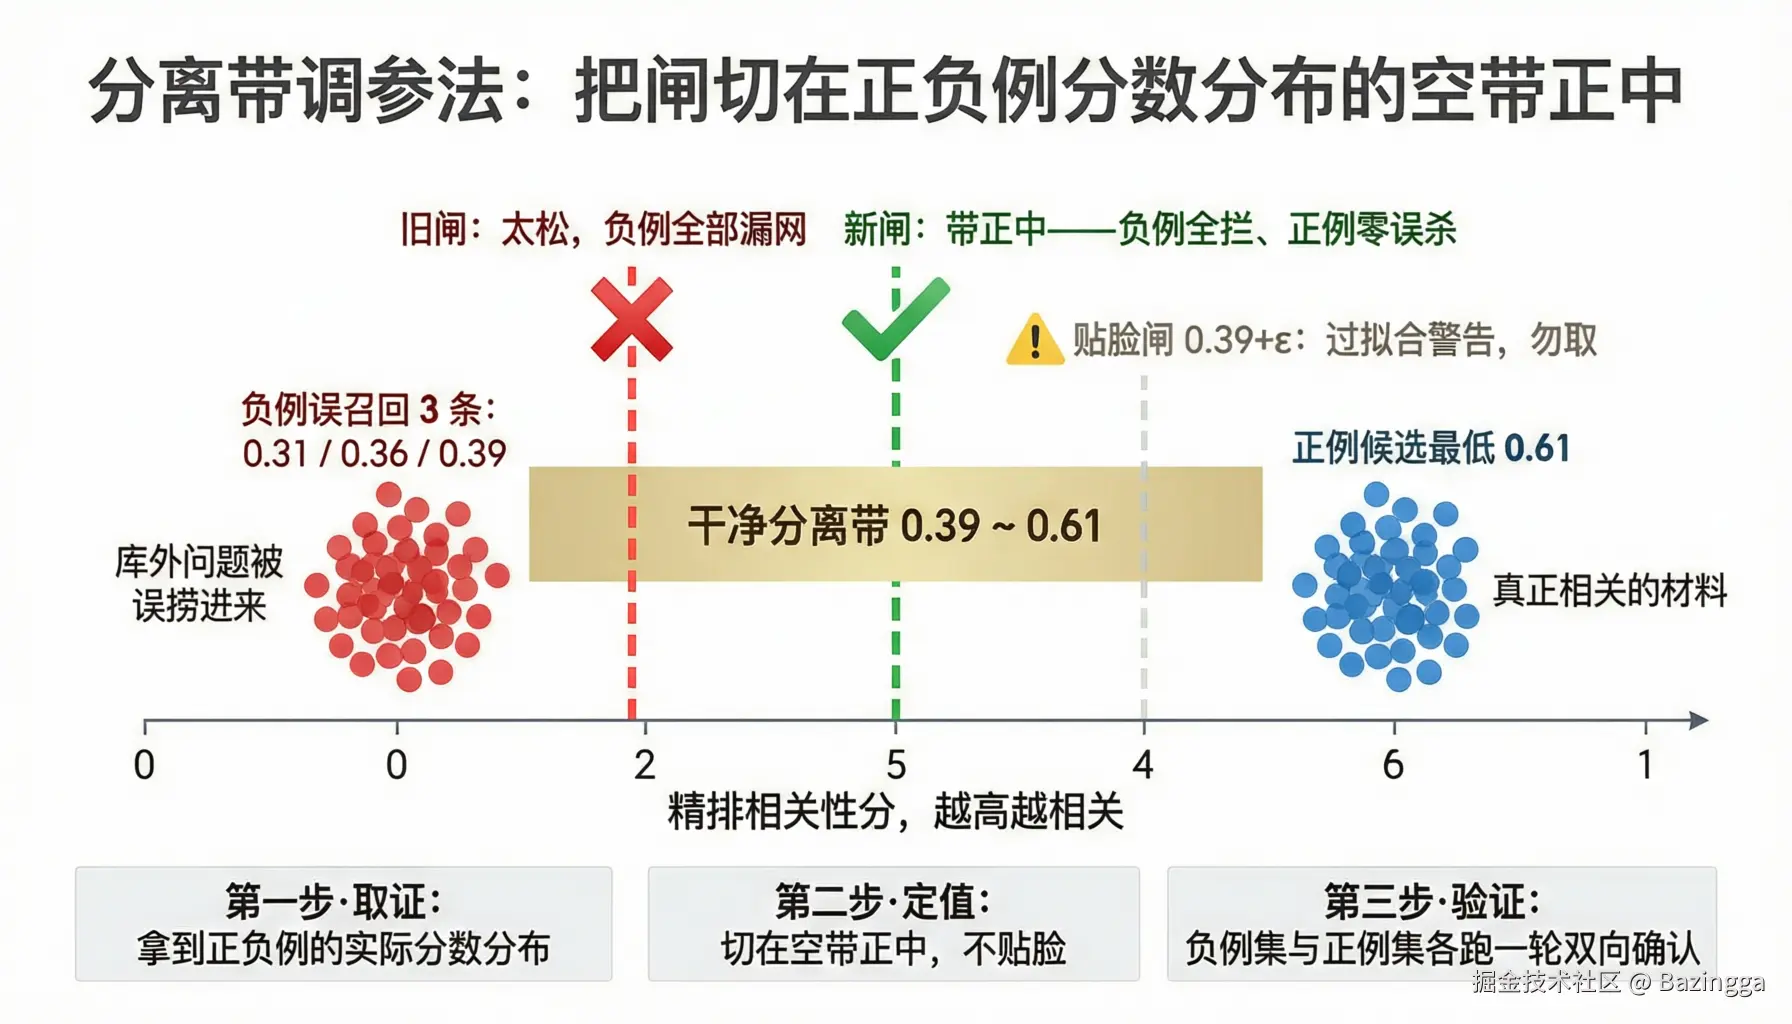
处方:分数闸 0.3 → 0.5(分离带正中)。两个取值纪律:
- 不取贴脸值(0.385+ε 刚好卡住最高分负例)------那是对着 8 道题的分数分布过拟合,换批负例就塌
- 取带正中:稳健区间 0.45~0.55 都在带内,取居中 0.5
第四幕:预测四中(run #5 验证闭环)
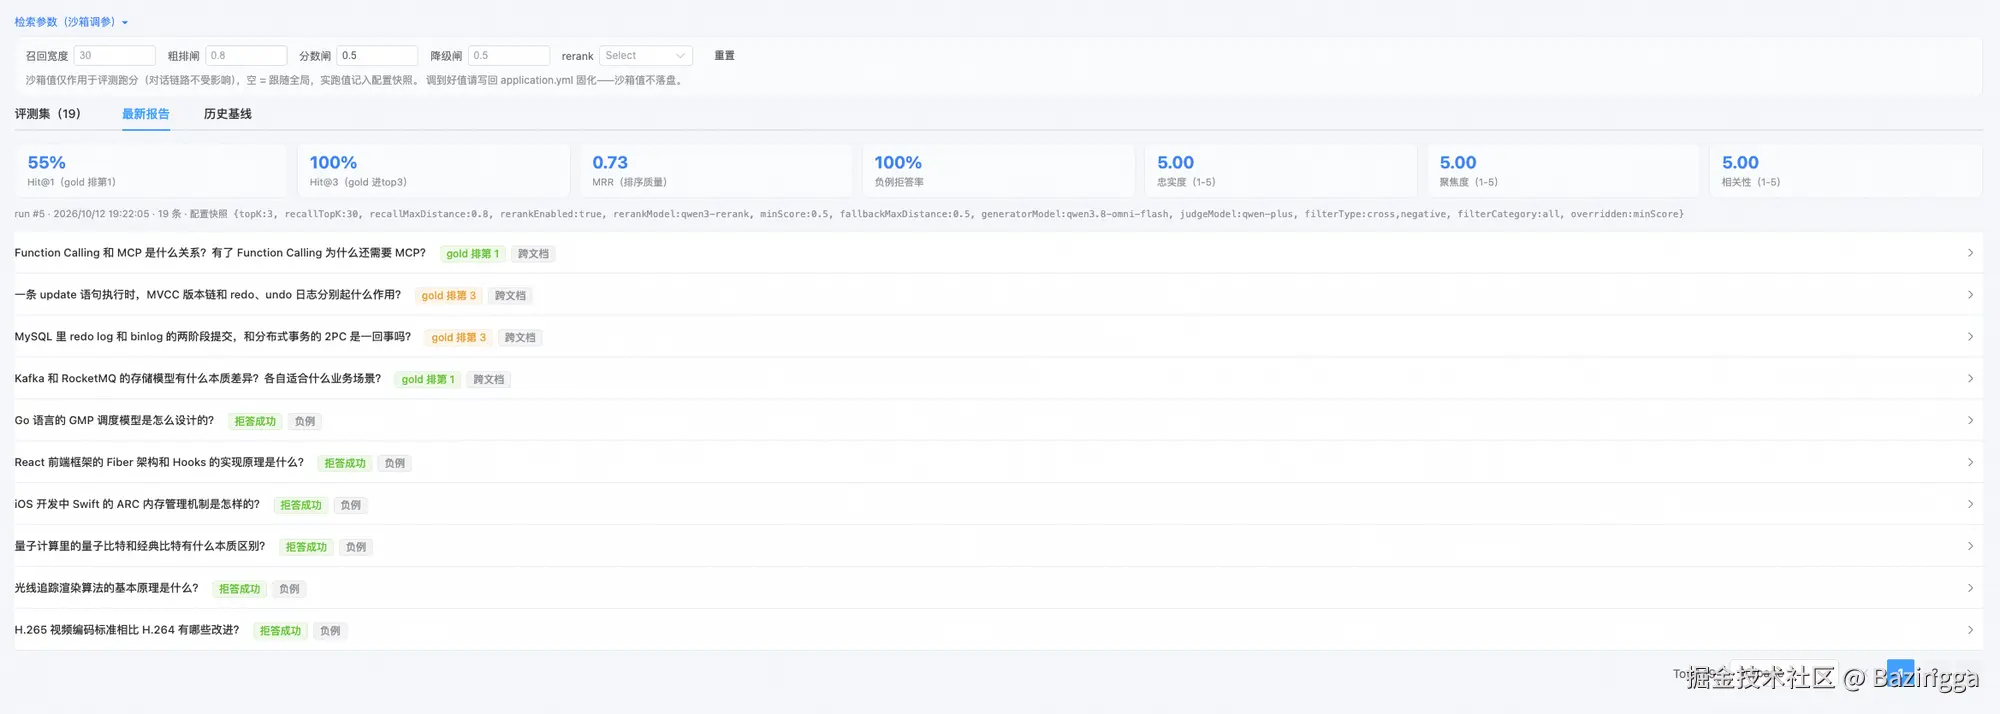
现场证据(run #5 报告页实测):分数闸收至 0.5 的定稿轮------拒答率 63% → 100%,正例侧 Hit@1 / Hit@3 / MRR 与 L2 三维全部纹丝不动。下方对账表的四行预测,在界面上一一对上。
改 0.5 之前,基于取证数据先写下预测;跑完对账:
| 预测(基于取证) | 实测 | 结果 |
|---|---|---|
| 负例三条分全 < 0.5 → 全拦 | 拒答率 63% → 100% | ✓ |
| 正例最低分 0.612 > 0.5 → 零误杀 | Hit@3 100% 纹丝不动 | ✓ |
| 闸只管丢弃不管排位 | Hit@1 55% / MRR 0.73 不动 | ✓ |
| L2 拿到的材料没变 | 忠实度/聚焦度/相关性 5.00 不动 | ✓ |
19 题合跑一轮同时完成"负例全拦 + 正例零伤"双向验证,单变量纪律守住(除分数闸外什么都没动)。
这个案例的方法论名称:分离带调参法 。 与"拍脑袋试几个值看哪个指标好"的区别,就像循证医学和偏方的区别: 先取证(拿到正负例实际分数分布)→ 确认分离带存在 → 带正中定值 → 写下预测 → 实测对账。 每一步都有证据,每个值都有出处。调参是 5 分钟的事,知道往哪调是 5 小时的事------ 分离带法就是把那 5 小时的"知道"变成可复制的流程。
5.4 双集合轮换:排序实验和闸门实验不能共用一个考场
一个容易踩的盲区:全正例的题集练不了闸门 。heart-net 用 11 道 cross 练排序时,拒答率永远是 -(没有负例,闸门效果不可见)------分数闸调了也看不见任何变化(run #4 之前的三轮不动,部分原因就是这个)。
正确做法------双集合轮换:
- 排序实验(召回宽度 / rerank 开关 / rerank 模型)→ 跑 cross 集(正例,看 Hit@1/MRR)
- 闸门实验(分数闸 / 粗排闸 / 降级闸)→ 跑 negative 集(看拒答率 + 正例误杀)
- 各自归因,各自验证------跑子集前先想清楚:这轮能不能产出你要的那个指标(单指标缺失是子集跑批的隐藏成本)
5.5 稳健区间:追平台,不追尖峰
扫参扫出一堆值后怎么选:
- 单点最优的陷阱 :minScore=0.53 独占 100% 而周围都是 80% ------这个 0.53 是过拟合评测集的尖峰,换一套题就塌
- 正确姿势:找"平台区"(一段区间内表现都好),取居中值------平台区才泛化
通俗例子 :买鞋。鞋码 42 穿着刚好、41 和 43 都挤脚------这双 42 是"贴脸值", 脚肿一点(题库换血/语料增长)就穿不了。要买 42 附近都合脚的那双。
5.6 拒答率目标:行业没有及格线,错误成本给线
紧接着"100% 了然后呢"的问题。行业现状:主流评测框架(RAGAS/DeepEval)只把负例拒答列为四大必测能力之一,只测不设线------目标由业务错误成本决定:
| 业务画像 | 目标 | 逻辑 |
|---|---|---|
| 高风险(法律/医疗/金融) | 95%+,越高越好 | 幻觉成本 >> 漏答成本------实证:法律 AI 工具幻觉率 17~33% 被当众点名;宁可让用户多问一次,不能编 |
| 平衡型(企业知识库/个人助手) | 90~95% | 两头都伤:答非所问损信任,该答不答损效用 |
| 开放型(闲聊/导购/推荐) | 85~90% | 漏答更伤------"我不知道"本身就是差评 |
三条永不追 100% 的理由:
- 对偶压力 :拒答率和正例误杀率是同一道闸的一体两面(反例:分数闸拧到 0.9,拒答率 100%,正例全灭)------所以永远联控 :拒答率 ≥90% 且 正例误杀 ≤5%
- 统计置信:rule of three(§3.5)------8 道全对的 100% 只配宣称 63%
- 贴脸过拟合:为了 100% 把闸拧到刚好卡住最高分负例 = 应试调参
5.7 生产调参三阶梯:参数怎么找的规模化路径
| 阶梯 | 形态 | 适用 |
|---|---|---|
| 1. 人工单变量 | 固定评测集,人肉改一个参数跑一轮归因一次 | 当前 heart-net 形态;撑到十几组实验没问题 |
| 2. 自动化网格扫参 | 脚本遍历参数组合落库画热力图;L1-only 先筛 top 参数组,少数决赛组再上 L2 验证(L1 比 L2 便宜两个数量级) | 实验频次上来后;组合爆炸逼的 |
| 3. CI 门禁 + 定时回归 | 参数锁进 yml 进版本管理;代码/参数/语料变更自动触发评测,跌破阈值拦发布 | 调参收敛后的守护形态 |
单变量纪律 (贯穿所有阶梯):改一个参数 → 跑 → 与历史基线 diff → 归因写一句话。评测记录表本质是 experiment tracker,config 快照是变量声明------两行基线的差异必须能一句话解释,解释不了就说明你没守住单变量。
6. 读报告的科学:指标之外的三个学科
6.1 数学蕴含链:三个满分其实是一个事实
「每题 gold 都排第 1」这一个事实,同时蕴含三个满分:
ini
Hit@1 = 100% ⟹ Hit@3 = 100% ∧ MRR = 1 (反之不成立)三张指标卡是同一把尺子的三种刻度精度 :Hit@3 是及格线(资料拿到没有)、Hit@1 是优秀线(资料在最优雅的位置)、MRR 是细腻刻度(平均排位连续量化)。追求顺序天然是:先保 Hit@3、再攻 Hit@1、MRR 跟随 Hit@1 走------Hit@3 都没保住就去抠 Hit@1 是本末倒置。
读数组合诊断表(比单指标阈值更有用):
| 读数组合 | 诊断 | 药方 |
|---|---|---|
| Hit@1 低 + Hit@3 高 | "捞得进来、排不对"------排序问题 | rerank / 召回宽度,排序优化 |
| Hit@1 / Hit@3 双低 | 召回层问题 | 粗排闸 / embedding / gold 标错排查 |
| rerank A/B 时 Hit@3 差值小 | 健康信号(粗排捞得到,rerank 只管摆位置) | 关注 Hit@1 差值即可 |
6.2 满分辩证:满分是警报,不是喜报
看到全满分报告,第一反应不是庆祝,是三连问:
警惕一:考卷污染(evaluation contamination) gold 是"看着系统检索结果勾选"标的 = 看着学生的答案出考卷------题目天然偏向系统已能召回的模式。满分可能说明考卷太贴学生,不是学生太强。 独立考法:出题凭记忆里的知识点想问题、gold 凭"答案物理上在哪篇文档"判定,然后再跑。 (heart-net 佐证:11 道自己出的题 Hit@3 100% 一条不漏------干净得可疑。)
警惕二:满分失去诊断梯度 指标的价值在变化量 ,不在绝对值。到了顶,改任何参数它只能持平或跌------它再也无法告诉你改动是好是坏。解药:题库难度始终压着系统能力半头(对抗性负例、口语化变体、指代模糊题),题库跟着系统成长。
警惕三:考卷满分 ≠ 对话满分 评测集是工整出题,真实使用是随口问(错别字/口语/上下文指代)------问法漂移。对策:给重点题配口语变体条目;这也是 L3 留位置的原因。
健康形态表(比满分更有意义的"最佳报告"):
| 指标 | 健康区间 | 原因 |
|---|---|---|
| Hit@3 | 95%+ | 召回是底线,丢了 gold 后面全白搭 |
| Hit@1 | 85~95% | 留难度给跨文档题;100% 先怀疑考卷 |
| MRR | ≥ 0.9 | 跟随 Hit@1 的排序细密度 |
| 负例拒答率 | 90%+ | 与 Hit@1 是对偶压力,满分常意味着另一头失衡 |
| L2 三项 | 4.2~4.8 且有分布 | 全 5.00 = 裁判无信号;有 4 有 5 才说明裁判在区分好坏答案 |
金句 :满分时第一反应是往题库加 20 条难的、gold 换成独立标注,再看能不能守住------ 守住的高分才是真强,守不住说明之前的满分是舒适区错觉。
6.3 度量科学:噪声、漂移、系统性效应
评测分数不是客观测量------测量值 = 信号 + 噪声,而且"尺子"本身也会动。三个必须分清的概念:
| 概念 | 特征 | 通俗例子(体重秤) |
|---|---|---|
| 噪声 | 随机、无方向、幅度固定;多次平均可压小,单次压不掉 | 同一人连称三次:70.2 / 70.4 / 70.3 |
| 漂移 | 尺子本身有方向地动 | 秤的弹簧疲劳,一个月来越称越重 |
| 系统性效应 | 条件变了结果必然跟着变;可解释、可复现,根本不是随机 | 穿着外套称,稳定高 0.8kg |
heart-net 实测修正 (值得记录的一课):曾把三轮 rerank 分数不完全复现当成"噪声的证据"------复查明细后发现等效条件下(run #1 vs run #3)11 题的 rerank 分数小数点后 16 位逐位一致 :L1 是确定性管道 ,喂相同候选池就吐相同分数;run #2 分数变化是召回宽度改了候选池的系统性效应 。这个修正有个好消息:分离带是稳定可复现的,0.5 的闸钉在一个不会自己动的刻度上------不是运气好,是取证方法的功劳。
推论:L1 阈值可以贴得紧 (逐位复现不需要大容差);L2 阈值必须留容差------噪声全在 L2(生成 temperature 采样抖动 + 裁判未钉温度),等分数落到有分布的区间就会现形。
噪声三板斧(治不了根,只能管理):
- 压:把噪声源关小------裁判 temperature 钉 0(生产 L2 门禁的标配)
- 容 :阈值留容差 ≥ 噪声幅度------门禁线贴着基线设,一半红灯是抖动不是回归;天天误报的门禁会被关掉,这是监控领域的经典死亡螺旋
- 均:样本量按 √n 压噪------8 道负例置信下限只有 63% 就是样本压不住噪声的账
噪声可量化 :同一道题、同一配置跑 N 次(如 10 次),裁判分数的标准差 σ 就是这套"选手×裁判×题"的噪声幅度。门禁容差应 ≥ 2~3σ;σ 特别大的题送修复(题面歧义/生成不稳)或剔出冒烟集。上门禁之前,先测量你的测量仪。
6.4 漂移防护:两种漂移 + 四件套
L2 分数是裁判模型的主观判断------主观判断的尺子会变。两种漂移变的环节不同:
裁判漂移 = 换法官 裁判模型底层被供应商静默升级,打分风格变了。同一份答案、同一套材料,新裁判给出不同的分------你的代码一行没动,门禁却报"质量显著提升/回归"。两个方向都是误判:夸大提升让你放松警惕,误报回归让你白查一晚。
评分标准漂移 = 规则手册改版 打分 prompt 的文字变了(例如"5 分 = 答案与材料完全一致 "改成"5 分 = 基本 忠于材料")------刻度缩水,同批历史答案平均分从 4.1 涨到 4.6。这 0.5 的"进步"纯属分数通胀,跨版本的成绩全部不可比。
通俗例子:体操比赛。换了一批打分习惯不同的裁判 = 裁判漂移; 国际体联改了难度表和评分规则 = 评分标准漂移。 老将的历史 10 分和新规则下的 10 分不是一个含金量------跨版本比较成绩,必须先问"规则变没变"。
防护四件套:
| 手段 | 防哪种 | 做法 |
|---|---|---|
| pin 裁判/选手版本号 | 裁判漂移 | API 指定具体版本(如 qwen-plus-2026-xx),不用会漂移的 alias |
| 打分 prompt 版本化 | 评分标准漂移 | 改 prompt = 一次正式提交,必须重立基线 |
| 裁判温度 = 0 | 抽样噪声 | 消除同题两次打分不同的方差 |
| 季度人工校准 | 所有漂移的最后防线 | 抽 100 条比对裁判分与人工分,一致率 < 80% → 历史基线全部作废重立 |
金句 :门禁分数 = 被告表现 × 裁判刻度。被告随便换(那是你要测的), 刻度必须焊死------否则每次判决都在冤枉好人或放走坏人。
7. 生产化:门禁与回归
7.1 门禁原理:钉死的考场,每次只审一个被告
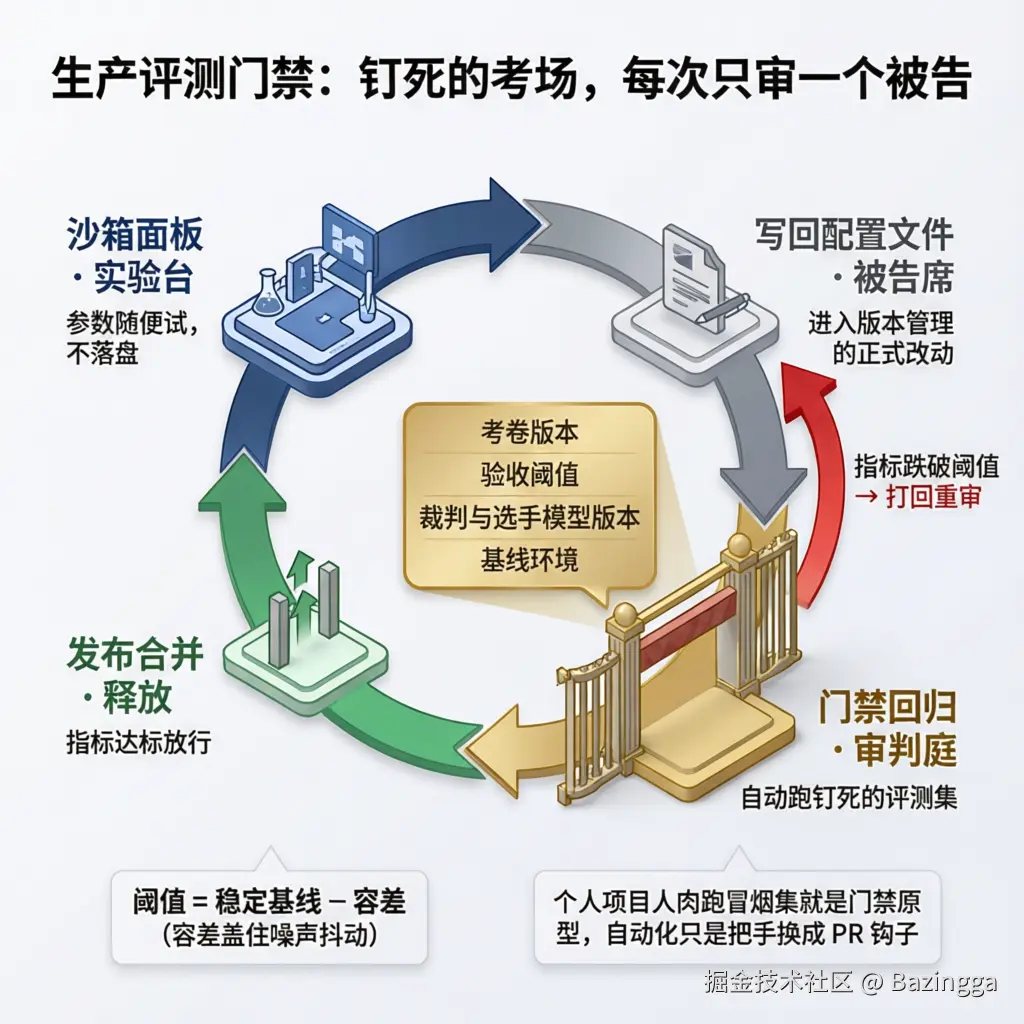
门禁哲学一句话:考场里一切变量全部钉死,每次只放进一个被告------本次改动。
要钉的四样:
| 钉死项 | 为什么 |
|---|---|
| 考卷(golden set 版本化) | 题一换,分数就没有可比性 |
| 验收阈值 | 评分标准跟着被告走 = 考官收被告的钱(goal-post moving) |
| 裁判/选手模型版本 | 裁判悄悄升级会分数漂移、门禁误报(§6.4) |
| 基线环境 | 库规模/依赖变了,分数不可比 |
被告闭环:
markdown
沙箱面板(实验台:随便试,不落盘)
    ↓ 好值写回
配置文件 yml(被告席:进入版本管理的正式改动)
    ↓ 自动触发
门禁回归(审判:钉死的考场 + 钉死的阈值,自动跑评测集)
    ↓ 指标达标
发布/合并(释放)        指标跌破 → 红色箭头打回被告席
heart-net 已经手工走过这个闭环的原型:分数闸 0.3→0.5 定稿那轮的 19 题双向验证,就是一次人肉门禁。自动化不过是把人手换成 PR hook,把脑内判断换成阈值表。
通俗例子:海关。海关不查你行李箱里装了什么牌子的衣服(参数怎么调是工程师的自由), 只查有没有违禁品(指标达不达标)。但每次过境都要过安检(每次提交都要受审), 而且安检标准不能因为"这次的人看起来面善"就放松(阈值不跟着被告走)。
7.2 两种"参数":固定性完全不同(先拆词)
"门禁的参数是固定的吗"这个问题里藏着两个不同的"参数":
| 例子 | 固定吗 | |
|---|---|---|
| 被测系统参数 | 分数闸 / 召回宽度 / rerank 模型 | 锁定但可变------每次变都是一次提交,必须过门禁审判 |
| 门禁自身参数(阈值) | Hit@3 ≥ 95%、拒答率 ≥ 90% | 近乎合同------只有业务期望升级或规模质变时才正式调(带评审的治理动作,与调参是两个流程) |
"通过率达标就行"的三条纪律(少了哪条门禁都会被玩坏):
- 多指标联控达标,不是单一通过率------反例:分数闸拧到 0.9,拒答率 100% 达标,正例全灭。指标是一组不是一颗
- 参数改动每次都当场重新受审------今天达标 ≠ 明天免检
- 禁应试调参:把参数拧到"刚好让这套题全过"= 参数版的考卷污染。分离带取居中值而不是贴脸值(§5.3),就是在守这条纪律
7.3 阈值从哪来:基线喂出来,不是拍出来
- 第一轮基线没资格立门禁:练兵期参数在动、题库在长,立的阈值几天就过时。先把参数固化、题库定型,跑稳基线
- 正确公式:阈值 = 稳定基线 − 容差。例:稳态 Hit@3 = 98% → 门禁定 95%,3 分容差盖住 rerank 波动与抽样噪声
- 阈值也会升级,但那叫治理:季度基线上移(比如换了强 rerank 稳态到 99%),把门禁 95%→97% 是一次带评审的治理决策
通俗例子 :体检报告的参考范围。你换了个更健康的生活方式(系统变好了), 参考范围不会跟着你变------阈值定的是质量下限 ,不是当前水平。 变的只有"你够不够得着"这一件事。
7.4 heart-net 的落地路线(个人项目的门禁最小实现)
现状(沙箱调参完成)
  → ① 分数闸 0.5 写回 yml 固化(沙箱值不落盘,好值手动定稿)
  → ② 全量 100 题跑稳基线(负例从 8 扩到 30+,让拒答率有统计意义)
  → ③ 立门禁:从 100 题里挑 30 道标记为冒烟集 + 阈值表
  → ④ 触发时机先手动化:每次改 yml / 动文档库后跑冒烟集
  → ⑤ 哪天忘了跑吃了亏,再上自动化(PR hook)------按需引入基建
8. 评测的职责边界与岗位归属
8.1 评测的产出不是分数,是处置决策
一个常见窄化理解:"评测就是找出有问题的分块,修掉或删掉。"------因果和职责都偏了。
正确的因果链:跑评测 → 归因到层 → 处置分流 → 回归复跑验证。评测是法庭,判决有四种处方(调参和修块是并列的两种,不是手段和目标):
| 处方 | 适用 | heart-net 实例 |
|---|---|---|
| 调参数 | 机制没坏,阈值跟不上模型分辨力 | 分数闸 0.3→0.5(§5.3) |
| 修语料(重写/重切块/拆分) | 内容本身是污染源、擦边源 | 33 号大杂烩文档拆成 16 篇主题文档(待拍板) |
| 删语料 | 无保留价值的污染源------最重处方,慎用 | 暂无 |
| 修考卷(gold 标错) | "系统没错,是考卷错了" | 评测初期最常见的处置------很多"检索问题"最后查明是 gold 标歪了 |
通俗例子 :医生看病。拿到检查报告(评测分数)不是治疗的结束,是治疗的开始: 开药(调参)、手术(拆文档)、截肢(删语料)、误诊重判(修考卷)------ 四种医嘱对应四种病因,其中"误诊"这种自我怀疑能力恰恰最容易被忽略。
职责比"找坏块"大两圈:
- 回归门禁是主业------防"修好一处坏三处":语料改动会挪动整个向量空间(大文档一拆,分数闸与全部基线都要复测)
- 在线回流是活水------生产坏例是用户行为(点踩/追问/低采纳)喂回来的,不是离线扫参扫出来的;评测集是活的
- 趋势监控------语料膨胀/问法漂移让基线缓慢下移,定期跑才看得见慢变量
8.2 这活归谁干:行业分工现状
| 岗位 | 干不干评测调参 | 说明 |
|---|---|---|
| RAG/算法工程师 | 主责,约 90% | 出题、标 gold、跑评测、调参、维护基线------行业默认是本职,不另设岗 |
| Agent 开发 | 基本不管 | 编排/工具/记忆是他们的 KPI;检索质量对他们是下游指标 |
| 数据/知识库运营 | 语料侧 | 文档治理、摄入管道------评测归因出的语料问题交这侧闭环 |
| 测试/QA | 自动化尾巴 | 接 CI、跑批基建;但阈值定多少、分离带怎么读------不懂链路干不了 |
| MLE/平台工程 | 基建 | 评测平台是全公司用的工具,不是替你调参 |
为什么没有"专职调参工程师":调参没法从链路里剥离------调分数闸要懂 rerank 分数语义、会读分离带、知道哪些题擦边。这跟数据库行业类似:有"性能调优专家",但没人设"只管调 buffer pool、不管库架构"的岗。
8.3 真实动作分布:调参只占 10%
打破"这活全是调参"的错觉(heart-net 一天的真实时间分布,与行业经验一致):
erlang
出题/标 gold/维护题库      ████████ 35%(持续活,题库是活的)
归因诊断(读明细/分离带)   ██████   25%(取证是主要智力劳动)
调参数                     ██       10%(频率低------参数稳定期很长)
语料治理(修块/修考卷)     ███      15%
回归基建(CI/门禁) ███ 15%一句话:调参是 5 分钟的事,知道往哪调是 5 小时的事------后者没法外包。 这也解释了为什么这活归 RAG 工程师本体:归因诊断需要的链路知识不可剥离。
三个正在成形的趋势:
- Evals Engineer 职位化 :AI Native 公司开始设岗专管 evals 基建、golden set 维护、裁判校准------核心是管好尺子,不是替链路调参
- evals 基建化:评测做成平台服务(CI 里一个步骤),跑批/报告/门禁的基建被平台收走,调参决策仍在链路侧
- 粗调自动化:网格扫参、分离带定位交给 agent 跑,人退到"审实验结果、做处置决策"------沙箱面板 + 快照 diff 已经是这个形态的雏形(机器跑实验,人做拍板)
9. 实证档案:heart-net run #1 ~ #5 全数据
所有数字来自 heart_net_eval_run 表真实落库记录,可复算、可追溯。
| run | 范围 | 单变量改动 | Hit@1 | Hit@3 | MRR | 拒答率 | L2 三维 | 结论 |
|---|---|---|---|---|---|---|---|---|
| #1 | cross 11 题 | (基线,快照取证发现召回宽度实跑值=3) | 55% | 100% | 0.73 | - |
5.00/5.00/5.00 | 首条基线:召回有货、排序有空间 |
| #2 | cross 11 题 | 召回宽度 30→40 | 55% | 100% | 0.73 | - |
不变 | 扩池零效果(gold 已近登顶) |
| #3 | cross 11 题 | 粗排闸 0.8→0.5 | 55% | 100% | 0.73 | - |
不变 | 正例距离全在 0.5 内,安全区 |
| #4 | cross+negative 19 题 | 分数闸 0.3→0.2 | 55% | 100% | 0.73 | 63% | 不变 | 3 道负例误召回 → 取证出 33 号文档 |
| #5 | cross+negative 19 题 | 分数闸 0.3→0.5(定稿) | 55% | 100% | 0.73 | 100% | 不变 | 预测四中:负例全拦、正例零伤 |
现场截图索引:本章五行数据每一行都有界面现场佐证------run #1 报告页见 §2.2、L2 三维记分卡见 §2.3、串行慢日志见 §4.1、三轮不动的历史基线见 §5.3 第一幕、run #4 负例误召回见 §5.3 第二幕、run #5 定稿报告见 §5.3 第四幕。
档案价值:这五行构成了一个完整的 experiment tracker 案例------每行一个变量、每行一个结论、相邻两行的差异都能一句话解释。config 快照记下了每轮的实跑参数(含沙箱覆盖键),任何一行都可以被复查。
链路确定性佐证 (从这份档案里挖出的方法论):run #1 与 run #3 等效条件下,11 题 rerank 分数小数点后 16 位逐位一致 ------L1 是确定性管道;run #2 的分数变化是候选池变化的系统性效应。先分清噪声与系统性效应,再谈容差设计。
10. 踩坑实录(六个,全部实测抓出)
-
md 解析顺序坑 :二级标题
##的判断写在了一级标题#跳过规则之后 ------所有题目被吞、解析出 0 题。靠"用脚本模拟导入解析器全量自检"抓出来(自检习惯直接救了一次交付事故)。教训:批量数据管道必须先建自检,再产出数据。 -
selectCount 复用带 ORDER BY 的 wrapper 在 PostgreSQL 报聚合语法错 :count 必须在 orderBy 之前执行。教训:ORM 的"复用便利"遇到方言会反噬。
-
含逗号标题的 gold 歧义 :《Java 基础深度篇(完整版,含 JUC)》这类标题被 goldTitles 的逗号分隔符拆碎------修复为两级拆分(先分号后逗号,段内整串精确匹配优先)。教训:人类友好的数据格式要预设"内容含分隔符"的情况。
-
前端构建产物目录残留 :构建工具对 root 外的 outDir 不清空,静态目录积累旧 hash chunk------改完前端必须"清空 → build → 同步产物"三步固化流程。教训:构建缓存的陈旧产物会造成"改了没生效"的假象,浪费排查时间。
-
召回宽度疑云(取证故事,§4.5 详述) :快照里的召回宽度与配置文件不符------快照忠实记录了运行时实跑值,反而成为发现"宽进没生效"的取证证据。修复代价为零(快照机制本来就对)。教训:快照必须与实际生效值一致,否则基线对比会归因错向。
-
负例误召回的"病灶直觉"陷阱(§5.3 详述) :第一直觉是收粗排闸------取证后发现向量空间里正负例混居,收闸必误杀正例;真正的分离在精排分数空间。教训:调参前先取证两个空间的分辨力,别对着直觉拧旋钮。
11. 附录
附录 A:config_snapshot 参数字典
快照示例:{topK:3, recallTopK:30, recallMaxDistance:0.8, rerankEnabled:true, rerankModel:qwen3-rerank, minScore:0.5, fallbackMaxDistance:0.5, generatorModel:qwen3.8-omni-flash, judgeModel:qwen-plus, filterType:all, filterCategory:all, overridden:-}
markdown
query → 向量粗排 ──宽进──→ rerank 精排 ──严出──→ 最终 3 条
        recallTopK:30        minScore 闸           topK:3
        recallMaxDistance 粗闸
└─ rerank 关闭/失败时降级 → fallbackMaxDistance ──→ topK:3| 参数 | 定稿值 | 含义 |
|---|---|---|
| topK | 3 | 最终返回条数(严出);gold 排位决定 Hit@1/Hit@3/MRR |
| recallTopK | 30 | 粗排召回宽度(宽进):rerank 在 30 条里挑前 3 |
| recallMaxDistance | 0.8 | 粗排闸:只拦完全跑题候选(余弦距离 = 1 − 相似度,越小越像) |
| rerankEnabled | true | 精排开关;关闭/失败时降级纯向量链路 |
| rerankModel | qwen3-rerank | 精排模型(选型时 gte-rerank v1 已下线,勿配回) |
| minScore | 0.5(2026-10-12 由 0.3 定稿) | 精排分数闸:低于此值丢弃。分数是请求内相对值非绝对刻度 |
| fallbackMaxDistance | 0.5 | 降级闸:回退纯向量时的距离底线 |
| generatorModel | qwen3.8-omni-flash | L2 选手,与生产对话链路同源 |
| judgeModel | qwen-plus | L2 裁判,独立成模避免自评偏差 |
| filterType / filterCategory | all / all | 本轮跑分范围;all = 未筛选。子集跑分必须记,防基线误用 |
| overridden | - 或键清单 | 沙箱面板覆盖键;快照永远打实跑值 |
一句话:这串参数 = "这轮分数是在什么条件下跑出来的"的完整档案------没有它,评测数字就是无上下文的裸分。
附录 B:通俗例子速查表(讲解/写博客直接取用)
| 概念 | 例子 |
|---|---|
| 归因困境 | 病人说"我难受",医生不检查就开药是庸医 |
| 分层评测 | 开卷考试拆成两科:先考"找资料"、再考"写作文" |
| L1 三指标 | 赛跑三张榜单:金牌数 / 领奖台数 / 平均名次分 |
| 负例拒答 | 考仓管员"仓库里没有的东西会不会拿别的糊弄你" |
| 文档向量 vs query 向量 | 图书馆索引卡是一次性成本,"听懂问题"是每次成本 |
| 分层题库金字塔 | 运动员:日常训练 / 阶段测验 / 大赛选拔------没有运动员每天跑全马 |
| rule of three | 抛 3 次硬币全正,不能说硬币 100% 出正面 |
| 食堂多窗口 | 异步并行 = 多窗口打饭,一个窗口卡住不堵全食堂 |
| 分离带调参 | 安检门灵敏度:调到"危险品全拦、日用品全过"的带正中 |
| rerank 相对分 | 矮子里拔将军------分数是这一批候选里的相对名次,不是绝对置信度 |
| 稳健区间 | 买鞋买"42 附近都合脚"的,不买"只有 42 刚好卡脚"的 |
| 噪声 / 漂移 / 系统性 | 体重秤:连称三次数字乱跳 / 秤越称越重 / 穿外套称 |
| 裁判漂移 | 体操比赛换了一批打分习惯不同的裁判 |
| 评分标准漂移 | 国际体联改了规则手册------老将的历史 10 分和新人的 10 分不是一个含金量 |
| 门禁 | 海关:不查衣服牌子(参数自由),只查违禁品(指标达标),每次过境都安检 |
| 阈值 | 体检参考范围:不随你换生活方式而变------那是质量下限不是当前水平 |
| 题库活性 | 错题本:好学生的错题本是每次考试往里添的 |
| 四种处方 | 医嘱:开药(调参)/ 手术(拆文档)/ 截肢(删语料)/ 误诊重判(修考卷) |
| 在线回流 | 用户点踩就是系统的新错题 |