用 Codex 的 Plan 模式(/plan)写代码,最有价值的往往不是计划本身,而是计划过程中定下来的那几个选择:失败了要不要重试、配置走参数还是环境变量、哪些文件不许动。这些选择通常只存在于对话里。过两周再看 PR,评审人看到的是代码,看不到"当时为什么这样选";代码有没有超出当初说好的范围,也没有东西可以对照。
codex-plan-ledger 做的就是这两件事:
- 决策账本。 把 Plan 模式里的决策写成仓库里的
docs/plans/<id>/decisions.json:Codex 自己问过你的问题和你的回答、计划里还待定的选择、计划写明的默认,全在里面。它和代码在同一个 PR 里,能 diff,能 review。 - 范围偏离检查。 代码写完,
plan-ledger check --base main对照改动文件和计划:计划外被改的文件、决策里列了却一个都没碰的文件,都会报出来。
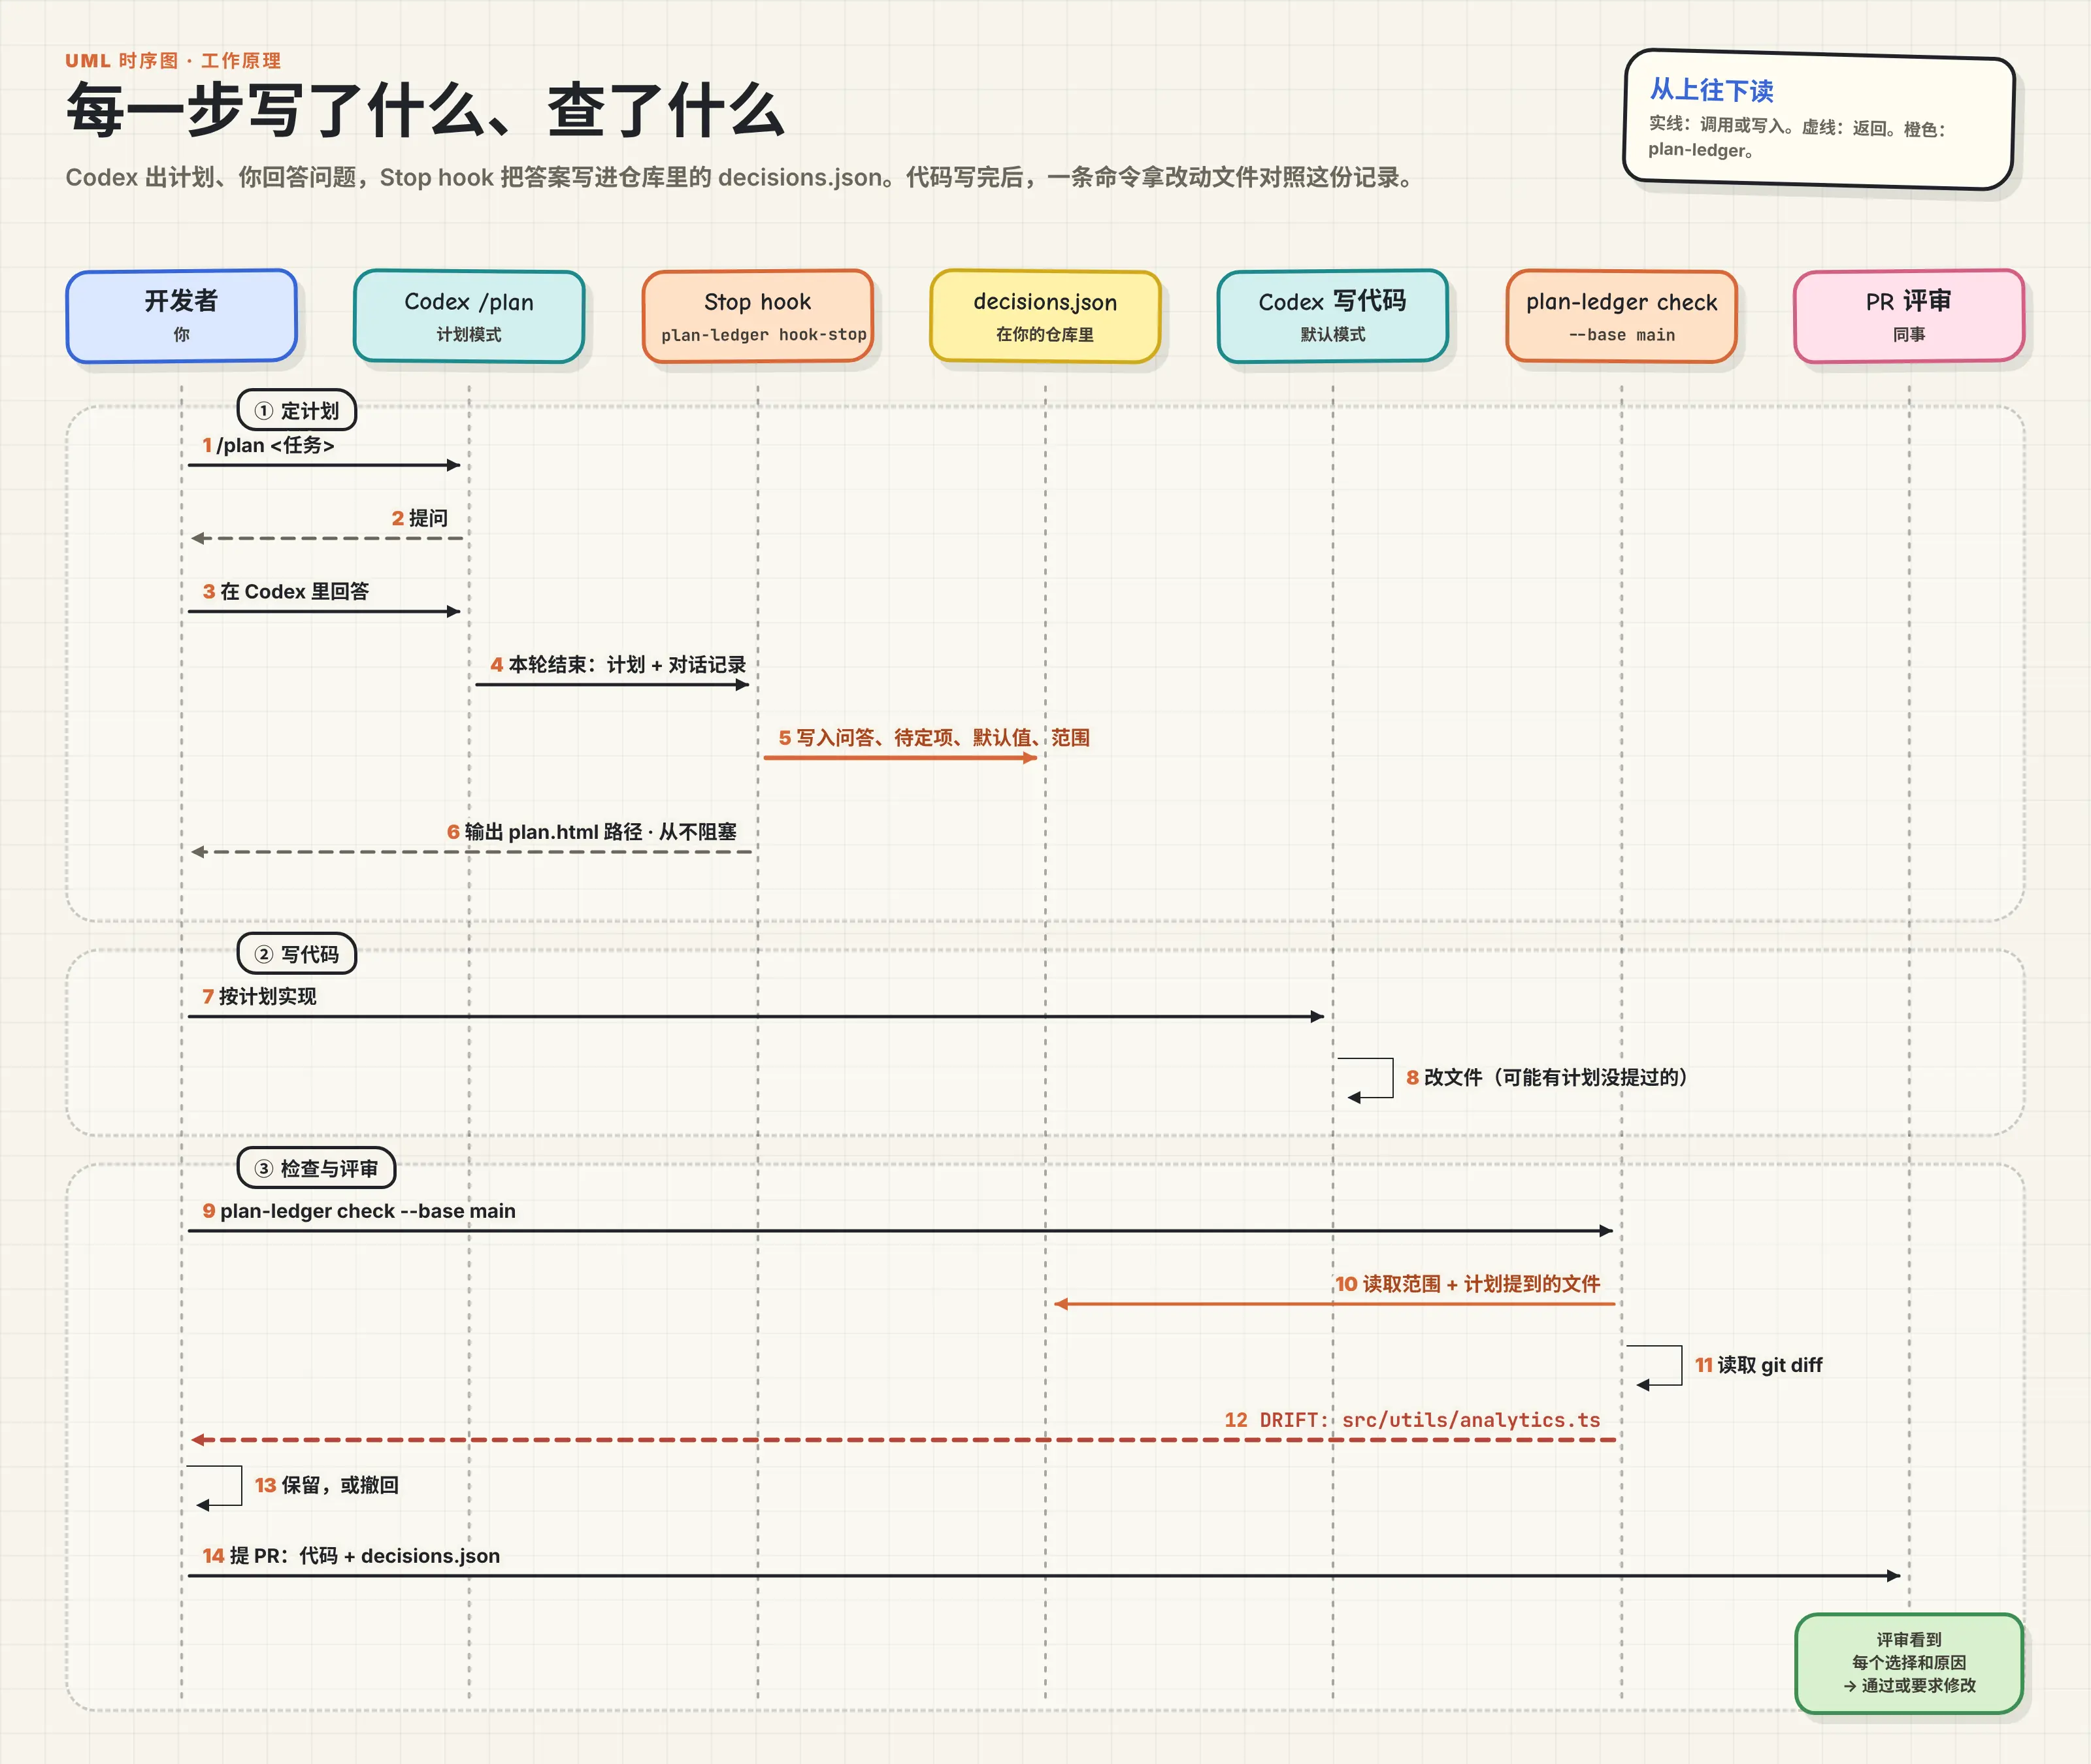
工作原理
怎么用
sh
npm i -g github:miniLV/codex-plan-ledger
plan-ledger init --write   # 写入 Codex hooks 配置
之后照常在 Codex 里 /plan,Codex 问问题就照常在 Codex 里答。计划出来时,Stop hook 做三件事:解析计划、写账本、生成一页离线 HTML。终端里多一行,比如:
ini
plan-ledger: nothing to answer; 2 answered in Codex → file://.../plan.html这页上可以复核所有决策:Codex 里已经答过的标"Codex 里已回答";计划写明的默认标"默认,可复核",不算待答项;还没定的项,一次选完,点按钮生成回传 JSON,粘到下一条消息里。没选的项记为"未作答,保留默认",不算同意。
代码写完:
sh
plan-ledger check --base main          # 可读报告
plan-ledger check --base main --strict # 有偏离时 exit 1,可以放进 CI
几个设计上的约束:
- 渲染全程是纯模板,不额外调用模型,零依赖,单个 HTML 文件,不联网。
- hook 从不阻塞这一轮,也不等你。计划格式认不出来时原样放行,只多一条提示。
- 页面里的回答只当数据存,不会被执行。
账本长什么样
jsonc
{
  "id": "n-selection",
  "title": "Selection",
  "question": "How should users select the greeting language?",
  "source": "codex-native",        // Codex 自己问的,你在 Codex 里答的
  "options": [
    { "id": "a", "label": "Named flag", "recommended": true },
    { "id": "b", "label": "Second positional argument", "recommended": false },
    { "id": "c", "label": "Environment variable", "recommended": false }
  ],
  "chosen": "a",
  "status": "answered"
}
这一段来自一次真实的 Plan 模式会话(codex-cli 0.156.0):Codex 用 request_user_input 问了 2 个问题,真实的 Stop hook 从会话记录里读出问答,写进了账本。这次会话整轮约 4.3 万 token。需要说明:这次的提示词明确要求 Codex 先提问,它是功能检查,不是效果测量。
实测:老实说,轮数没有变少
一开始的设想是"把所有决策放在一页一次答完,比 Codex 一轮轮提问更省事"。我在 vercel/ms@2.1.3 上做了配对实验:同一任务、同一模型和设置,原生 Plan 模式和加了 plan-ledger 各跑一次,问题由脚本按隐藏的标准答案回答。一共两轮、2 个任务、n = 3 对,只能算方向性数据:
| 轮 / 任务 | 定稿前轮数(原生 / plan-ledger) | 总 token(原生 / plan-ledger) | 验收 |
|---|---|---|---|
| 1 / strict-option | 1 / 2 | 717,487 / 586,971 | 都通过 |
| 2 / strict-option | 1 / 2 | 180,208 / 205,644 | 都通过 |
| 2 / month-unit | 1 / 1 | 179,053 / 140,020 | 都通过 |
- 轮数没有改善:3 对里输 2、平 1。token 有高有低,没有一致方向(两轮用的运行配置不同,token 只能在同一轮内比较)。
- 范围偏离 3/3 抓到:实现之后在副本上埋入计划外新文件、把计划内文件改回原样,3 次运行都报出来了;干净时 3/3 没有误报。
- 文件内和决策相反的改动 0/3 抓到:在计划内的文件里写和所选方案相反的代码,检查发现不了。它只看"改了哪些文件",不读代码内容,这是已知局限。
所以项目的定位从"一页答完、省轮次"改成了现在的"决策账本 + 范围偏离检查"。实验还暴露了两点,已经改掉:Codex Plan 模式即使被要求列出决策,也会先用自带的 request_user_input 提问,所以现在直接把这些问答记进账本,不再重复问;计划末尾的 "Chosen defaults" 之前被当成待答项,现在记为默认、可复核,不算待答。这些改动之后还没有重新测。
完整数据和脚本都在仓库里:第 1 轮、第 2 轮、实测计划。
现在的状态和下一步
早期原型 v0.1,有测试覆盖。实验性的部分:UserPromptSubmit hook,以及从会话记录读原生问答(会话记录格式不是公开约定,读不到就跳过)。Windows 没测过。
下一步:
- 按内容核对决策(也就是上面那个 0/3)。
- 更多任务、每组至少 3 次重复,测账本对一次会话里决策的覆盖程度和偏离检测。
欢迎试用、提 issue:github.com/miniLV/code... · 主页和在线演示:minilv.github.io/codex-plan-...
思路上受到 html-plan 和 answer-me-with-html 的启发,没有复用代码。