TOP 10 大模型实测:发两个字母,被计了 4223 个 token
本文部分内容在 AI 辅助下完成,全部数据、代码与结论均由作者实际运行并逐条核对。
撰写日期:2026 年 10 月 12 日。 榜单与实测数据均采集于同日。模型榜单和服务商在售清单变动很快,阅读时请先核对日期。
这篇能解决什么问题
接入大模型时最省事的做法,是打开排行榜选第一名。
但榜单回答的是「哪个模型综合分最高」,你要回答的是「我这份活该交给谁」。这两个问题的答案经常不一样。
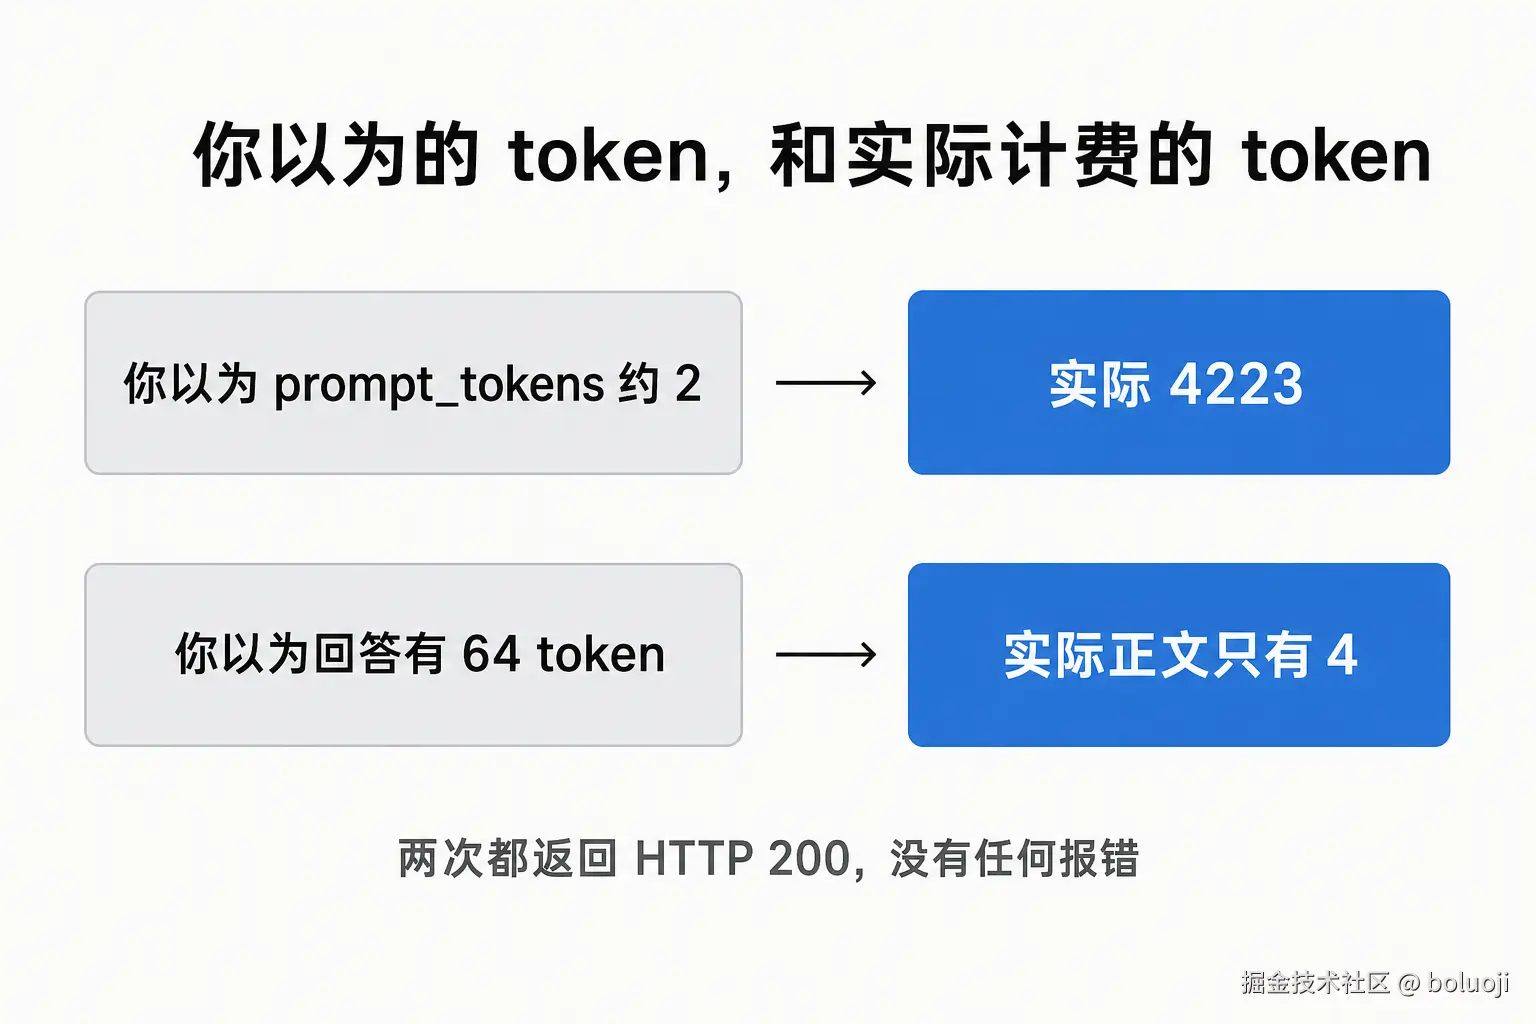
本文记录的是一次完整的选型过程:先拉公开榜单,再把榜上能调到的模型挨个发真实请求,最后根据 usage 返回的字段做判断。过程中有两个坑是榜单上看不出来的,都会导致账单或功能出问题,而且接口返回 200、不报任何错。
适用环境
| 项目 | 版本 / 值 |
|---|---|
| OS | Windows 10 Pro 10.0.19045 |
| curl | 8.13.0(libcurl/8.13.0 Schannel) |
| PowerShell | 7.6.6 |
| 接口形态 | OpenAI 兼容 /v1/chat/completions |
| 实测日期 | 2026-10-12 |
| 覆盖模型 | 榜单前 11 款中可调用的 8 款,外加 2 款补充,共 10 款 |
榜单数据来自 Artificial Analysis Intelligence Index v4.3.2,权重为 Agent 30% + 编程 20% + 科学推理 20% + 通用 30%。
一、先看榜单给了什么
| 排名 | 模型(评测配置) | 能力指数 | 任务成本(美元) | 输出速度 tok/s | 首字延迟 |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5(max with fallback) | 58 | 5.98 | 96 | 748.61 秒 |
| 2 | Claude Sonnet 5.5(max with fallback) | 56 | 5.46 | 137 | 484.09 秒 |
| 并列 3 | Claude Fable 5.1(max with fallback) | 53 | 7.63 | 65 | 250.30 秒 |
| 并列 3 | GPT-6 Astra(max) | 53 | 3.26 | 64 | 383.62 秒 |
| 并列 3 | Gemini 4 Argon(high) | 53 | 1.99 | 未报告 | 未报告 |
| 6 | GPT-6.1 Sol(max) | 52 | 0.72 | 65 | 330.58 秒 |
| 7 | Muse Spark 1.3(max) | 48 | 1.60 | 121 | 48.89 秒 |
| 并列 8 | Grok 4.7(xhigh) | 46 | 3.74 | 83 | 88.14 秒 |
| 并列 8 | MiMo-V2.6-Pro | 46 | 0.13 | 48 | 3.51 秒 |
| 并列 10 | Qwen3.8 Max(0902) | 45 | 5.41 | 36 | 2.82 秒 |
| 并列 10 | GLM-5.3(max) | 45 | 2.01 | 66 | 3.36 秒 |
同分并列,所以「TOP 10」实际是 11 款。
这张表里最该注意的不是名次,是最后一列。 分数从 58 到 45,跨度 13 分;首字延迟从 748.61 秒到 2.82 秒,跨度 265 倍。
第一名在它拿到第一名的那个配置下,首字延迟是 748 秒------十二分钟才出第一个字。这个量级不是前端加个 loading 动画能遮掩的。
还有一件事:榜上有 3 款我根本调不到 。Gemini 4 Argon 和 Muse Spark 1.3 在服务商的在售清单里查不到;Grok 更典型------榜上是 4.7(xhigh) ,在售的是 4.6,两个版本,不是别名。所以 4.7 那组分数不能拿来判断 4.6。
照榜单抄型号,最常见的失败就是这个:名字抄下来了,调用时返回模型不存在 。正确顺序是倒过来------先确认自己能调到哪些型号,再去榜上找这些型号的成绩。在售清单和计费档位可以在模型与价格页查,接口也公开免密钥,可以自己拉一份核对。
二、实测方案:只看三个字段
密钥放环境变量,不要写进代码,也不要出现在任何提交物里。
ini
export API_KEY="你的密钥"最小验证请求:
arduino
curl -s -X POST https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-haiku-5-5",
    "messages": [{"role": "user", "content": "Reply with exactly: OK"}],
    "max_tokens": 512
  }'
实际返回,耗时 2.69 秒(只摘关键字段):
css
{
  "model": "claude-haiku-5-5",
  "choices": [{"message": {"content": "OK"}, "finish_reason": "stop"}],
  "usage": {
    "prompt_tokens": 42,
    "completion_tokens": 4,
    "total_tokens": 46,
    "completion_tokens_details": {"reasoning_tokens": 0}
  }
}接下来只做一件事:把 model 换掉,同一个 body 发给所有候选,每次打印三个字段。
| 字段 | 为什么必须看 |
|---|---|
prompt_tokens |
和你实际发送的长度比。差太多说明有固定协议开销 |
reasoning_tokens |
有多少额度花在了你看不见的推理上 |
completion_tokens |
如果等于你设的 max_tokens,说明被截断,正文可能不完整甚至为空 |
不需要评测框架,一个循环就够。10 款全部返回 HTTP 200,耗时 1.80 秒到 7.80 秒不等。
下面两个坑,就是靠这三个字段抓出来的。
三、坑一:发两个字母,被计 4223 个输入 token
给 gpt-6.1-sol 发一条正文只有 hi 的请求,返回:
yaml
"prompt_tokens": 4223同一时间给 claude-sonnet-5-5 发一条 18 token 的请求,prompt_tokens 就是 18。复测两次,稳定在 4223--4227。
也就是说,调用这个模型存在一个约 4200 token 的固定输入开销。
什么时候无所谓,什么时候要命:
- 单次输入本来就有几千 token 的长文档任务 ------ 可以忽略
- 每次输入几十 token、一天几十万次的高频短请求 ------ 这个开销就是你账单的主体
讽刺的是,gpt-6.1-sol 在榜单上是性价比最突出的一款:52 分、任务成本 0.72 美元,是全表唯一「50 分以上 + 成本低于 1 美元」的组合。单看榜单你会选它做高频场景,而这恰恰是它最不划算的用法。
怎么查: 把你自己最短的那条典型请求发一次,打印 usage.prompt_tokens,和预期长度对一下。十秒钟的事,但能避免上线后才发现量级不对。
四、坑二:max_tokens 不是回答长度上限,是总预算
给 glm-5.3 设 max_tokens=64,返回的正文几乎是空的。看 usage 才知道原因:
json
"completion_tokens": 64,
"completion_tokens_details": { "reasoning_tokens": 60 }
64 个输出 token 里,60 个被推理吃掉了,留给正文的只有 4 个。
改成 max_tokens=512 重发:输出 34 token、推理占 32,正文正常返回。同一组请求发给 claude-sonnet-5-5,reasoning_tokens 是 0。
所以这个模型默认开启推理,而推理 token 占用 max_tokens 的额度 。如果你按「预期回答长度」来设这个值,拿到的就是空内容------而且接口返回 200,没有任何错误提示。
这是个典型的静默失败:日志里一切正常,只有业务侧发现结果是空的。
怎么查: 把 usage.completion_tokens_details.reasoning_tokens 打出来。所有默认开推理的模型都该过一遍这个检查。
五、复盘:推理档位比选哪个模型更关键
两个坑其实指向同一件事------推理是个开关,但很多时候它默认是开的,而你没意识到。
榜单展示的是各模型已测的最高分配置。把档位降一级看看:
| 模型 | 推理档位 | 能力指数 | 任务成本(美元) | 首字延迟 |
|---|---|---|---|---|
| Claude Opus 5.5 | max | 58 | 5.98 | 748.61 秒 |
| Claude Opus 5.5 | high | 54 | 1.82 | 44.34 秒 |
| Claude Opus 5.5 | medium | 51 | 1.34 | 21.61 秒 |
| GPT-6.1 Sol | max | 52 | 0.72 | 330.58 秒 |
| GPT-6.1 Sol | medium | 48 | 0.21 | 7.55 秒 |
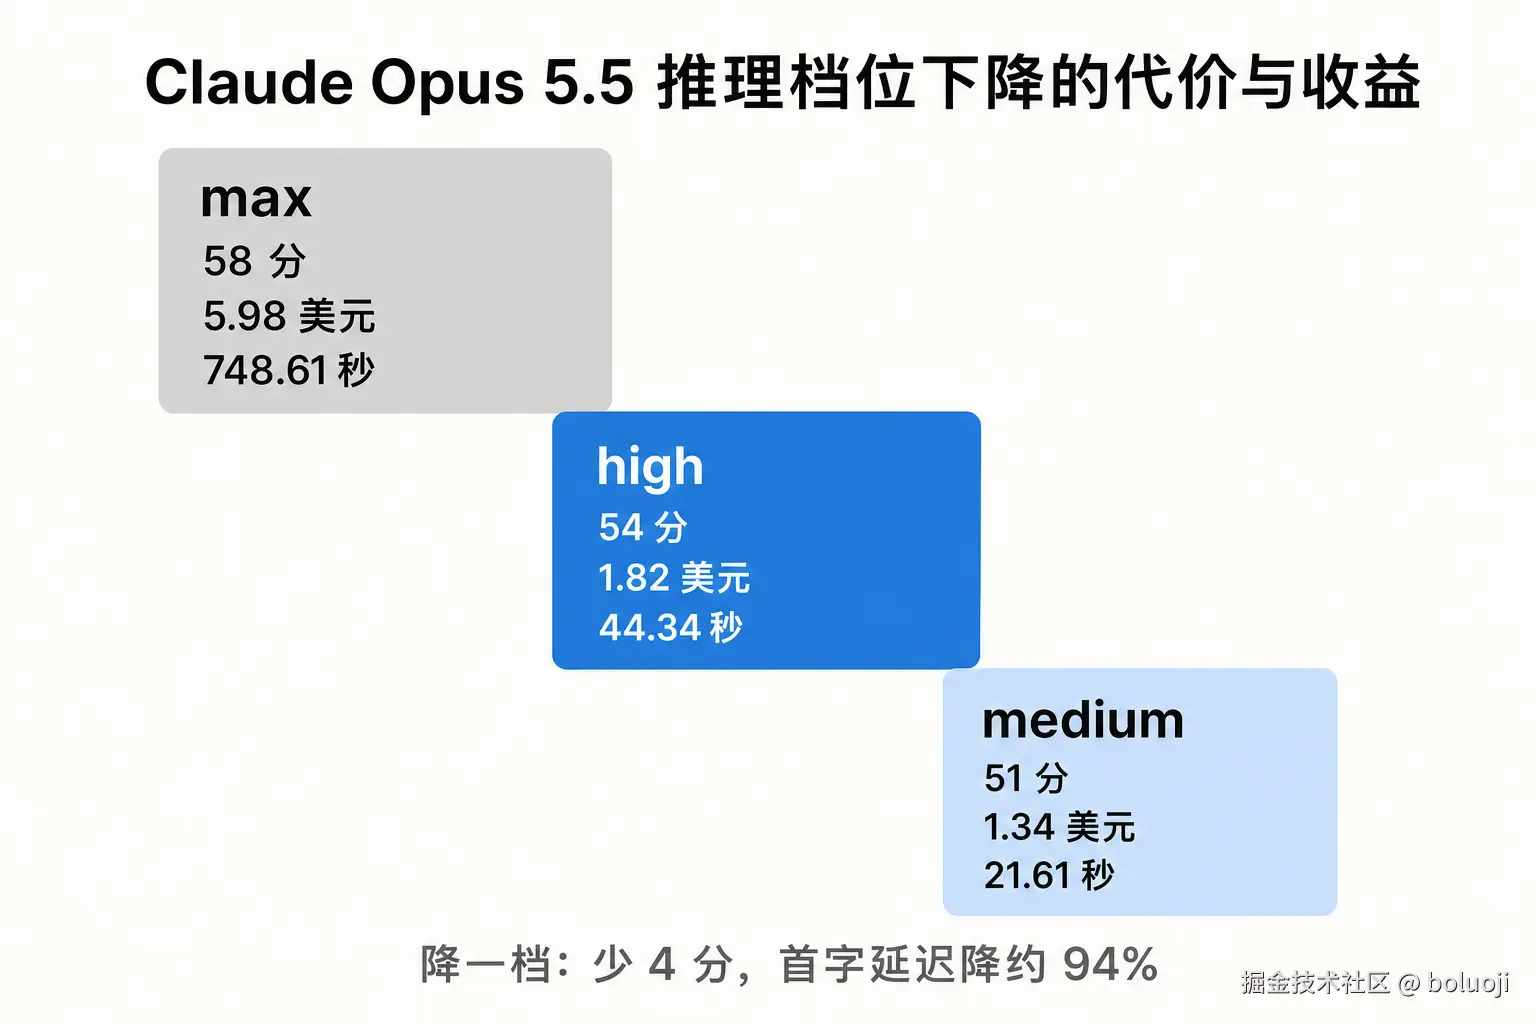
- Opus 5.5 从 max 降到 high:掉 4 分,成本降约 70%,首字延迟从 748 秒降到 44 秒(降约 94%)
- GPT-6.1 Sol 从 max 降到 medium:掉 4 分,成本降约 71%,首字延迟降约 98%
少 4 分,省掉十二分钟的等待------对线上服务来说,这笔账基本没有犹豫的余地。
结论不是「永远用低档位」,而是:上线前把推理档位当成需要测试的参数,而不是用默认值。 坑二本质上就是推理在一个不需要推理的任务上被默认打开了。
六、选型总结
| 你在做什么 | 候选 | 理由 | 交付前必须做的检查 |
|---|---|---|---|
| 架构评审、关键重构(离线) | claude-opus-5-5 |
指数 58,本期最高 | 先用 high 跑同一批,过了就别用 max |
| 日常编码、交互式、有人等结果 | claude-sonnet-5-5 |
137 tok/s,medium 档首字延迟 0.87 秒 | 测 P95 延迟,不是平均值 |
| 编码 Agent、多轮调工具 | claude-fable-5-1 |
Agent 类评测位置高于综合名次 | 必须放进自己的 harness 测 |
| 夜间批处理、要省输出 | gpt-6-astra |
单任务输出约 27K token,Opus 5.5 约 119K | 统计完成任务的总输出,不是单次长度 |
| 预算敏感的高能力离线任务 | gpt-6.1-sol |
唯一「50 分以上 + 成本低于 1 美元」 | 先验 prompt_tokens(坑一) |
| 大批量分类打标、要自托管 | mimo-v2.6-pro |
0.13 美元、3.51 秒延迟、开放权重 | 先定验收门槛,别因排名靠后直接排除 |
| 中文短输出、要首屏快 | qwen3.8-max |
首字延迟 2.82 秒最低,但输出速度最慢 | 首字延迟和完整耗时分开测 |
| 中文通用、要调工具 | glm-5.3 |
三项指标都无明显短板 | max_tokens 给够(坑二) |
| 工单分类、高并发简单任务 | claude-haiku-5-5 |
235 tok/s、0.21 美元,没进 TOP 10 | 用真实并发压一轮 |
最后一行是这篇最想说的:一个 43 分的模型,在特定工作上可以完胜 58 分的那个。
七、边界
- 分数、成本、速度、延迟来自公开榜单,不是我自己跑的完整基准测试。我实际测的只有连通性和 token 计量,覆盖 10 款。
- 采集日期 2026-10-12,该日期不等于各模型的测试日期。
- 该指数以英文、纯文本任务为主,图像、语音和多语言能力另有评测,不能当中文写作榜用。
- 榜上 3 款查不到在售记录,本文不对它们做适配判断。
- 任务成本是第三方评测口径的加权平均值,不是每百万 token 单价,也不是你发一次请求的费用。
数据来源
- Artificial Analysis:LLM Leaderboard ------ 分数、配置、任务成本、输出速度、首字延迟
- Artificial Analysis:Benchmarking Methodology ------ token 统一按 o200k_base 计,指标为 72 小时滚动窗口中位数
- Anthropic:Introducing Claude Opus 5.5 ------
with fallback的默认回退机制说明 - 在售型号与计费档位:服务商公开定价接口,2026-10-12 取值,免密钥可读
本文代码均为实际执行,prompt_tokens 与 reasoning_tokens 的两项发现各复测两次。配图为依据上述数据绘制。