欢迎转载文章
1. 在线体验
2. 仓库地址(欢迎 star)
GitHub:github.com/lmn1919/dom...
在前端做导出,PDF 是绕不过去的一块。发票、报告、简历,这类需求干了这么多年早就不新鲜,单页也好,几十页的业务报表也好,现成的库基本都能应付。
真正麻烦的是量级往上跳的时候。比如业务方某天提出来:
历史流水档案要一次性导出,大概一万页,纯前端能做吗?
我第一反应跟大多数人一样:这得上无头浏览器吧。
但把话说清楚,纯前端能做,前提是你手上那套方案得换。而且这不只是慢几分钟的问题,是多数方案从原理上就到不了这个量级。
下面我把前端导 PDF 的几条常见路线挨个拆开看,说说它们各自卡在哪,以及我开源的 dompdf.js(v2.0 换成了 Rust + WASM + Worker 架构)是怎么把一万页PDF生成出来的。
测试环境说明:下面所有数据都来自同一台普通开发机,Chromium 149,纯前端环境。A4 规格,每个 section 固定 1123px 高度对应一页,内容包含中文文本与复杂表格。换台机器数字会有浮动,但量级上的结论不变。
3. 一万页对导出方案的四个硬要求
想在浏览器里一次性导出这么长的文档,有四件事必须同时成立,缺一样都无法实现。
第一,不能经过 Canvas。Canvas 的单边尺寸和像素面积都有硬上限,这不是加内存能绕过去的,是底层图形上下文直接拒绝分配。
第二,不能长时间占着主线程。一万页的排版和绘制如果全压在 JS 主线程上,页面立刻假死,浏览器随后会以页面无响应为由把它处理掉。
第三,内存不能跟着页数线性涨。如果中间产物是每页一张位图,一万页就是一万张高分辨率图片,堆内存很快见底。
第四,产物体积得控制住。每页 100 KB 的话,一万页就是 1 GB,不管是浏览器存 Blob 还是用户下载打开都很难看。
4. 几条主流路线,各自卡在哪
为了看清楚卡点在哪,我把几种主流方案都拉出来试了一遍。
4.1 html2canvas + jsPDF(html2pdf.js):58 页左右到顶
这大概是前端最流行的方案,npm 周下载量超过 80 万。它的做法是递归遍历 DOM,算出每个元素的位置和样式,全部画到一张超长 Canvas 上,再把这张 Canvas 贴进 PDF。
问题就出在 Canvas 这一步:整篇文档被塞进同一张画布,而画布的尺寸是有物理上限的。以 Chromium 实测:
text
A4 单页高度(96 DPI 标准) : 1123 px
Canvas 单边最大高度限制    : 65535 px
理论最大承载页数          : 65535 / 1123 ≈ 58.3 页
58 页左右就到顶了。真实项目里还要考虑显存配额和总像素面积,不少项目三十来页就开始静默失败,表现是后面的页整片空白,而且没有任何报错。
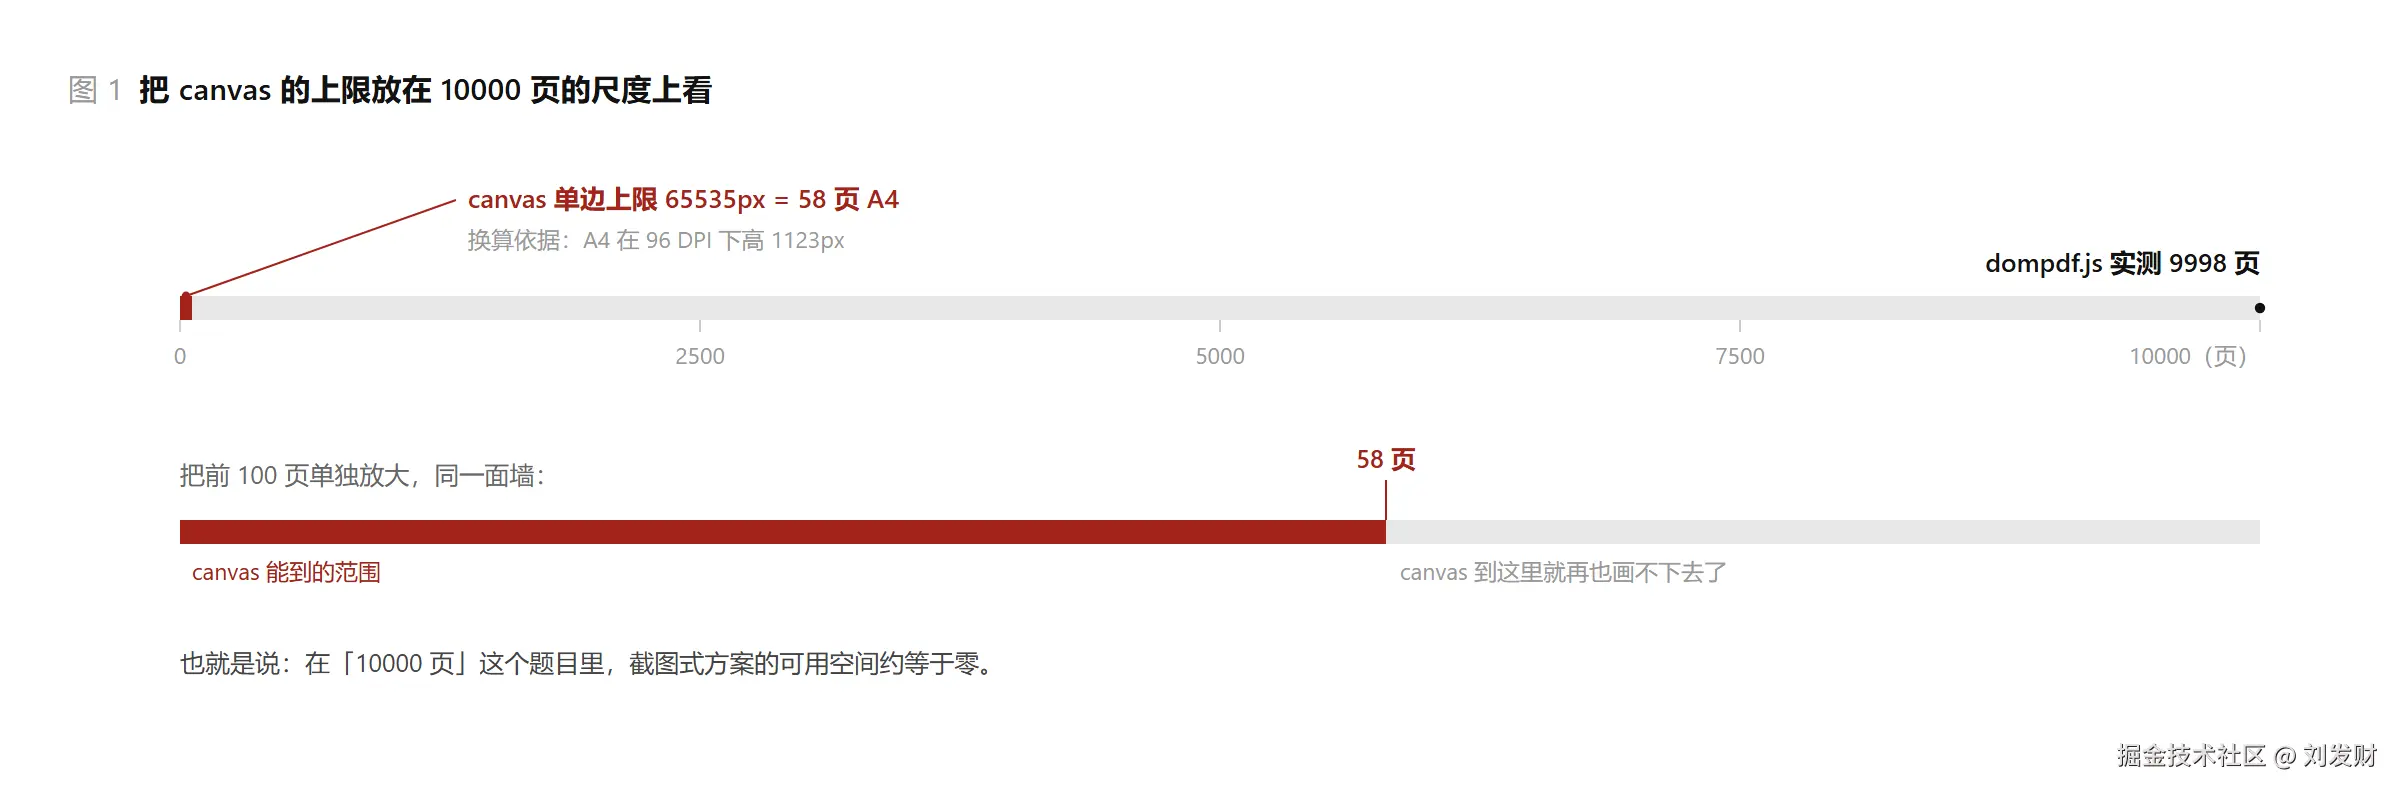 图 1:上面是 0 到 10000 页的全量空间,下面是前 100 页放大后的样子。58 页这条线,放在一万页的尺度里几乎看不见。
一百页都过不去,一万页就不用谈了。截图式方案的天花板就在这里。
4.2 jsPDF / PDFKit 手写绘制:理论能到,但开发成本劝退
这类库让你用指令直接画 PDF,比如 doc.text()、doc.rect()、doc.addImage()。
单看页数,它确实有可能撑到一万页,无非是往内容流里连写一万组矢量绘制指令。但放到真实业务里有两点过不去:
一是它不认 HTML。现成页面上的复杂表格、CSS 边框、圆角、背景渐变、中文折行,全都得自己算。
二是手写的代码量太大:
js
const doc = new jsPDF();
doc.setFontSize(16);
doc.text("Chinese Text Support Demo", 20, 30);
doc.setFillColor(255, 182, 193);
doc.rect(20, 90, 60, 30, "F");
doc.text("Pink Rectangle", 25, 108);
// ...这仅仅是一个最简 Demo,就要几十行
doc.save("example.pdf");
要用它撑起一万页的企业报表,等于在自己项目里重写一套排版器、分页引擎、表格跨页处理、页眉页脚和总页数计算。dompdf.js 干的那部分活,你得先自己干一遍。
能做,但成本不划算。它是用来「用代码画 PDF」的,不是用来「把已有页面导出成 PDF」的。
4.3 PDFMake / @react-pdf:做报表合适,一样吃不了 HTML
这类库有声明式 DSL,配置表格和表头跨页重复都挺方便,做结构化报表很舒服。但放到超大文档的场景就不太够用:
- 已有的 DOM 结构复用不了,界面得按它的规则重写成一套 DSL
- 一万页意味着先在 JS 内存里构建一棵庞大的文档描述树,全部驻留之后才开始编译,很容易把内存吃满
- 复杂 CSS 的支持有限
适合生成小体量的新报表,不适合把已有复杂业务页面大批量导出。
4.4 Puppeteer / Playwright:效果最好,但已经不是纯前端
在前端碰壁之后,很多人会转向这条路,把页面丢给 Node 服务端的 Chromium 去打印。
排版效果跟浏览器完全一致,代价也很明确:要搭服务器并且长期维护,处理并发和沙箱隔离;业务数据得传到服务端,有合规和带宽压力;就算在服务端,单次一万页的 Chromium 打印也是很重的任务,同样得分片。
真把它当成一条生产链路来搭,麻烦会比这句话具体得多:
- 内存要放大几倍 。
Page.printToPDF默认走 base64 通道,整个 PDF 先在浏览器进程里成型,再 base64(体积 +33%)过 WebSocket,最后在 Node 侧解析成 Buffer。峰值内存大约是产物的三到四倍,一万页很容易把单条消息顶到传输层直接失败。 - 耗时是分钟级。打印模式会把整篇文档重新布局一遍,比屏幕布局更慢,协议超时和反向代理的空闲超时都得跟着放大,否则任务在快跑完的时候被掐断。
- 十万级 DOM 这个瓶颈跑不掉。第 7 节说的开销在这里一样存在,只是表现从主线程假死换成了服务端进程崩溃,而且崩在别人的机器上,排查成本更高。
- 产物通常更大 。为了让背景和装饰不掉,
printBackground一般得打开,背景图、边框、阴影会按 Chromium 自己的策略嵌入,字体嵌入策略也不如矢量库可控,体积这块基本交给引擎,能调的余地很小。 - 运行环境不省心 。容器里
/dev/shm默认只有 64 MB,最常见的崩溃原因就是它;再加上并发限流、任务队列、进度上报、失败续传、临时文件清理,这些都是纯前端不需要写的东西。 - "完全一致"要打个折扣。它成立的前提是服务端的 Chromium 和用户浏览器同一版本,且页面已经按打印模式适配过。服务端镜像半年不更新,同一份 HTML 在两边排出来的断页位置就可能不一样。
效果没得说,但它已经离开了纯前端这个前提。如果架构上要求只能由前端出文件,这条可以直接排除。
4.5 window.print():分页免费,但拿不到文件
直接调 window.print(),让浏览器自己的打印模块去分页。
浏览器原生打印的能力其实很强,几千页不在话下,@media print 也不用额外准备。但它有个业务上过不去的坎:你拿不到 PDF 文件。
它只会弹出系统打印窗口,让用户自己点另存为。想静默下载不行,想拿 ArrayBuffer 传后端归档不行,想在代码里再做点后置处理也不行。
给用户自己打印预览可以用,程序化生成和交付用不了。
5. 横向对比
| 方案 | 能否支撑 10000 页 | 关键问题 | 产物形态 |
|---|---|---|---|
| html2canvas + jsPDF | 不能,58 页左右触顶 | Canvas 单边 65535px 限制,后面整片空白 | 位图贴图 |
| jsPDF / PDFKit 手写 | 理论可以 | 不认 HTML,排版与分页都得自己写 | 矢量指令 |
| PDFMake / @react-pdf | 容易 OOM | 不认 HTML,文档描述树全量驻留内存 | 矢量指令 |
| Puppeteer 等后端渲染 | 可以 | 要服务端和运维,不是纯前端方案 | 矢量 |
window.print() 原生 |
可以 | 拿不到 PDF 二进制,无法静默下载或上传 | 系统打印 |
| dompdf.js (v2.0) | 实测 9998 页(近万页) | 纯前端,下文有实测拆解 | 矢量文本与图形 |
6. dompdf.js:一万页是怎么实现的
我开源的 dompdf.js 走的是另一条路:整个过程不生成任何位图。
做法是在前端读取浏览器已经算好的 DOM 几何和 CSS 样式,交给内部的矢量排版管道,直接生成 PDF 指令。
业务代码还是几行:
javascript
import { renderToBytes } from "dompdf.js";
// 一行代码调用,返回标准的 Uint8Array 二进制字节
const bytes = await renderToBytes(document.querySelector("#capture"), {
format: "a4",
pagination: true,
compress: true, // 导出大规模文档时强烈建议开启!
onProgress({ stage, currentPage, totalPages }) {
if (stage === "rendering") {
console.log(`正在导出:${currentPage} / ${totalPages}`);
}
},
});
// 静默下载或上传后端
const blob = new Blob([bytes], { type: "application/pdf" });
const url = URL.createObjectURL(blob);
const a = document.createElement("a");
a.href = url;
a.download = "10000-pages-report.pdf";
a.click();
URL.revokeObjectURL(url);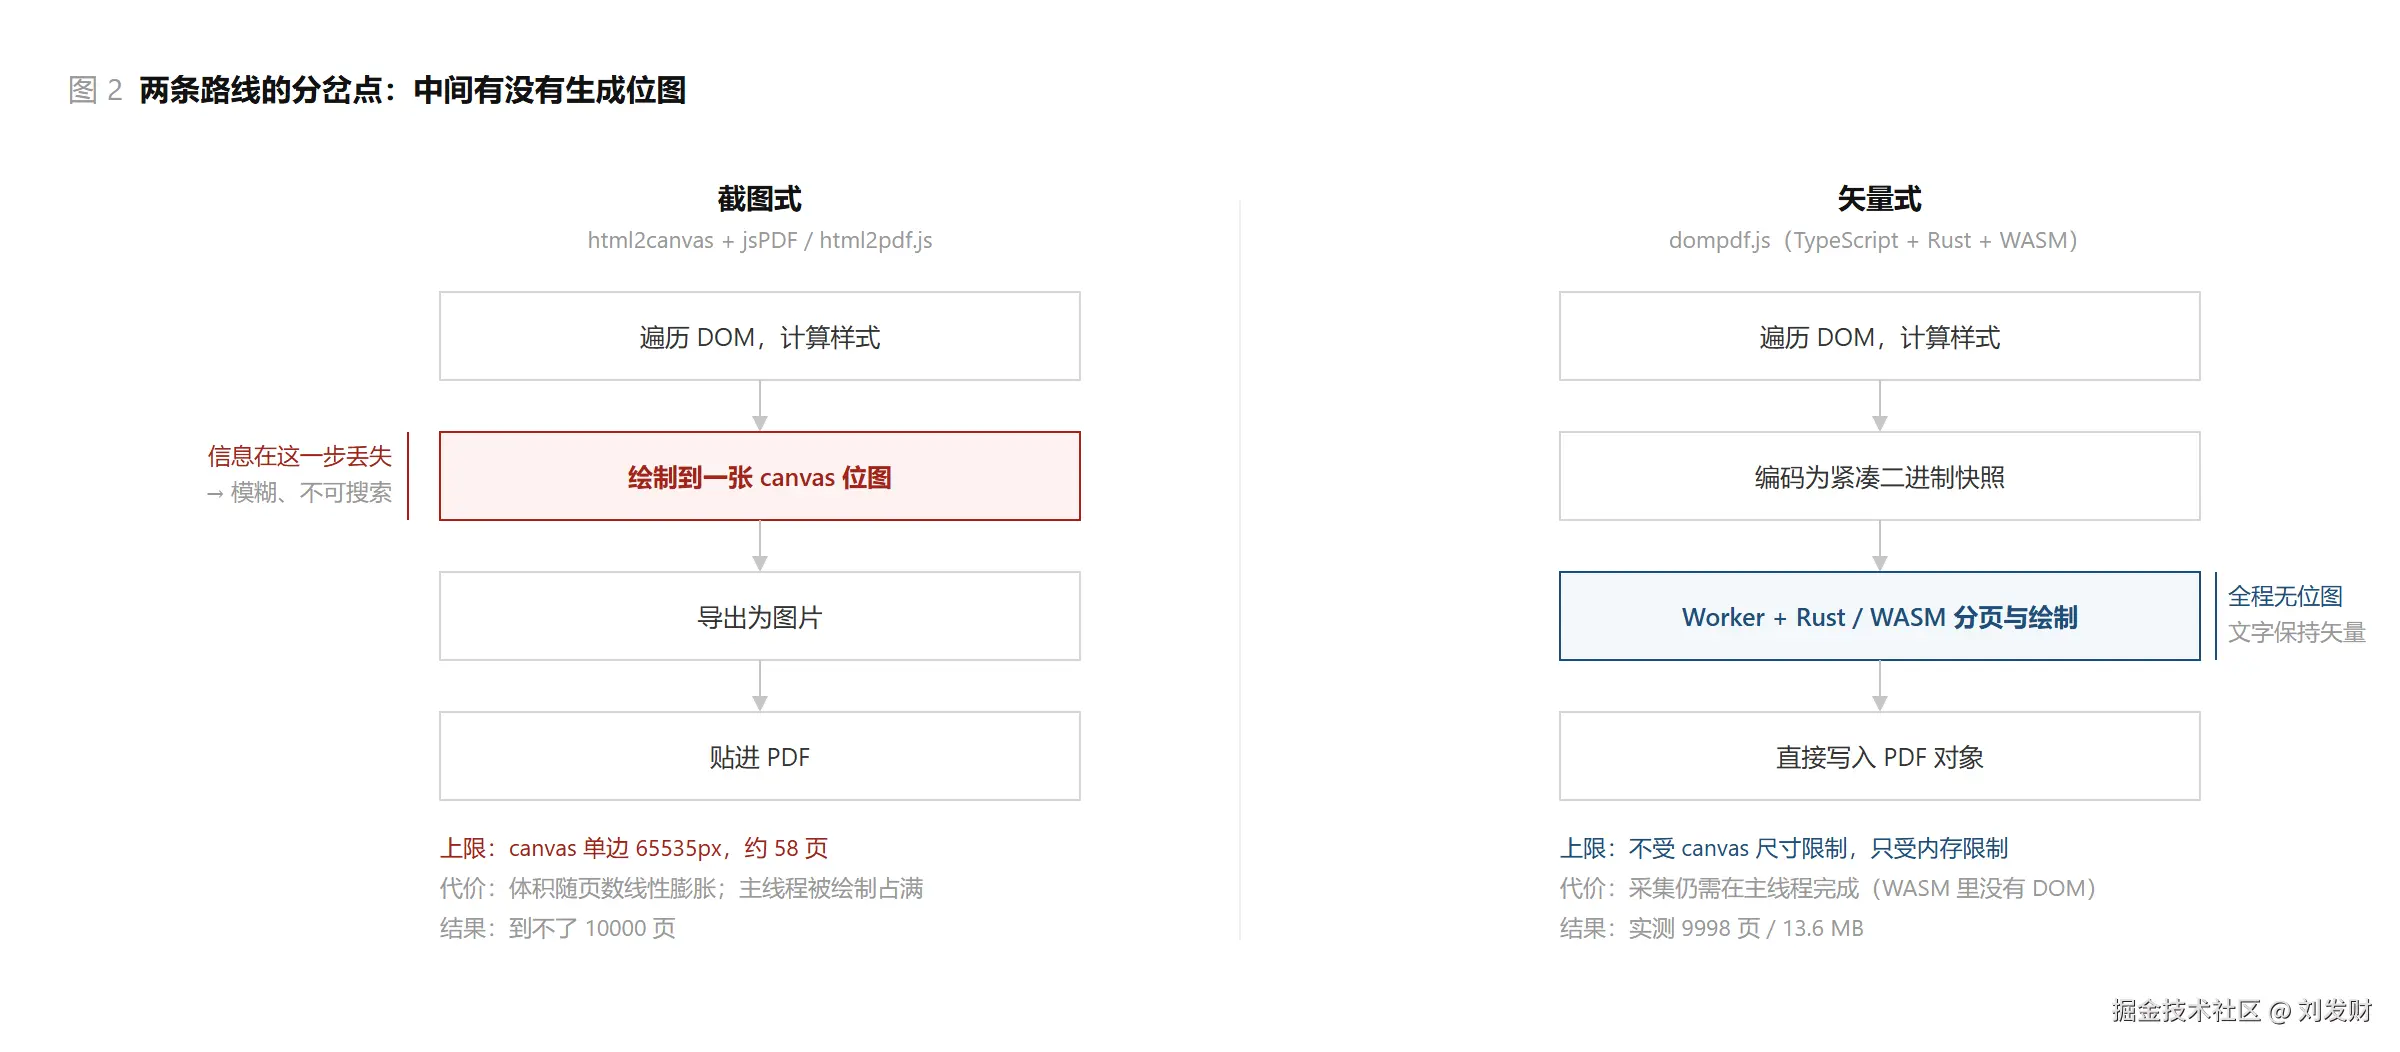 图 2:两条路线的分岔点在于中间有没有生成位图。截图方案在第二步就锁死了清晰度、体积和性能的上限,矢量方案直接跳过这一步。
实测数据
测试对象是 dompdf.js v2.0.x 的最新发布包,单文件 502 KB,没有第三方运行时依赖。同一台机器、同一份脚本,逐档加大页数压力:
关闭压缩(compress: false):
| 页数 | 渲染耗时 | PDF 体积 | 单页均摊耗时 |
|---|---|---|---|
| 495 页 | 0.86 s | 3.99 MB | 1.74 ms |
| 989 页 | 1.71 s | 7.99 MB | 1.73 ms |
| 1980 页 | 5.06 s | 16.0 MB | 2.56 ms |
开启压缩(compress: true):
| 页数 | 渲染耗时 | PDF 体积 | 单页均摊耗时 |
|---|---|---|---|
| 495 页 | 0.90 s | 663 KB | 1.81 ms |
| 990 页 | 1.85 s | 1.33 MB | 1.87 ms |
| 1976 页 | 4.73 s | 2.67 MB | 2.39 ms |
| 4950 页 | 17.5 s | 6.71 MB | 3.54 ms |
| 9998 页(近万页) | 66 ~ 103 s | 13.6 MB | ~9.2 ms |
有几处值得单独说。
开启压缩之后体积差得很明显。同样是近 2000 页,不压缩 16.0 MB,压缩后降到 2.67 MB,小了 6 倍,耗时基本没变。文档超过百页的话,compress: true 直接开就行。
一万页的产物只有 13.6 MB,摊下来每页 1.4 KB 左右,跟很多人印象里「万页文件得上百兆」差得比较远。原因是输出的是矢量文本和几何对象,不是像素图,体积自然压得住。
体积是稳定的,时间不是。一万页这一档我连续跑了 5 轮,每次生成的字节数(13,561,097)和页数(9998)完全一致,但整机耗时在 66 秒到 103 秒之间浮动,中位数 92 秒左右。原因是每轮都要在浏览器里实时构建一棵约十万节点的 DOM 树,CPU 降频和 GC 都会带来扰动。
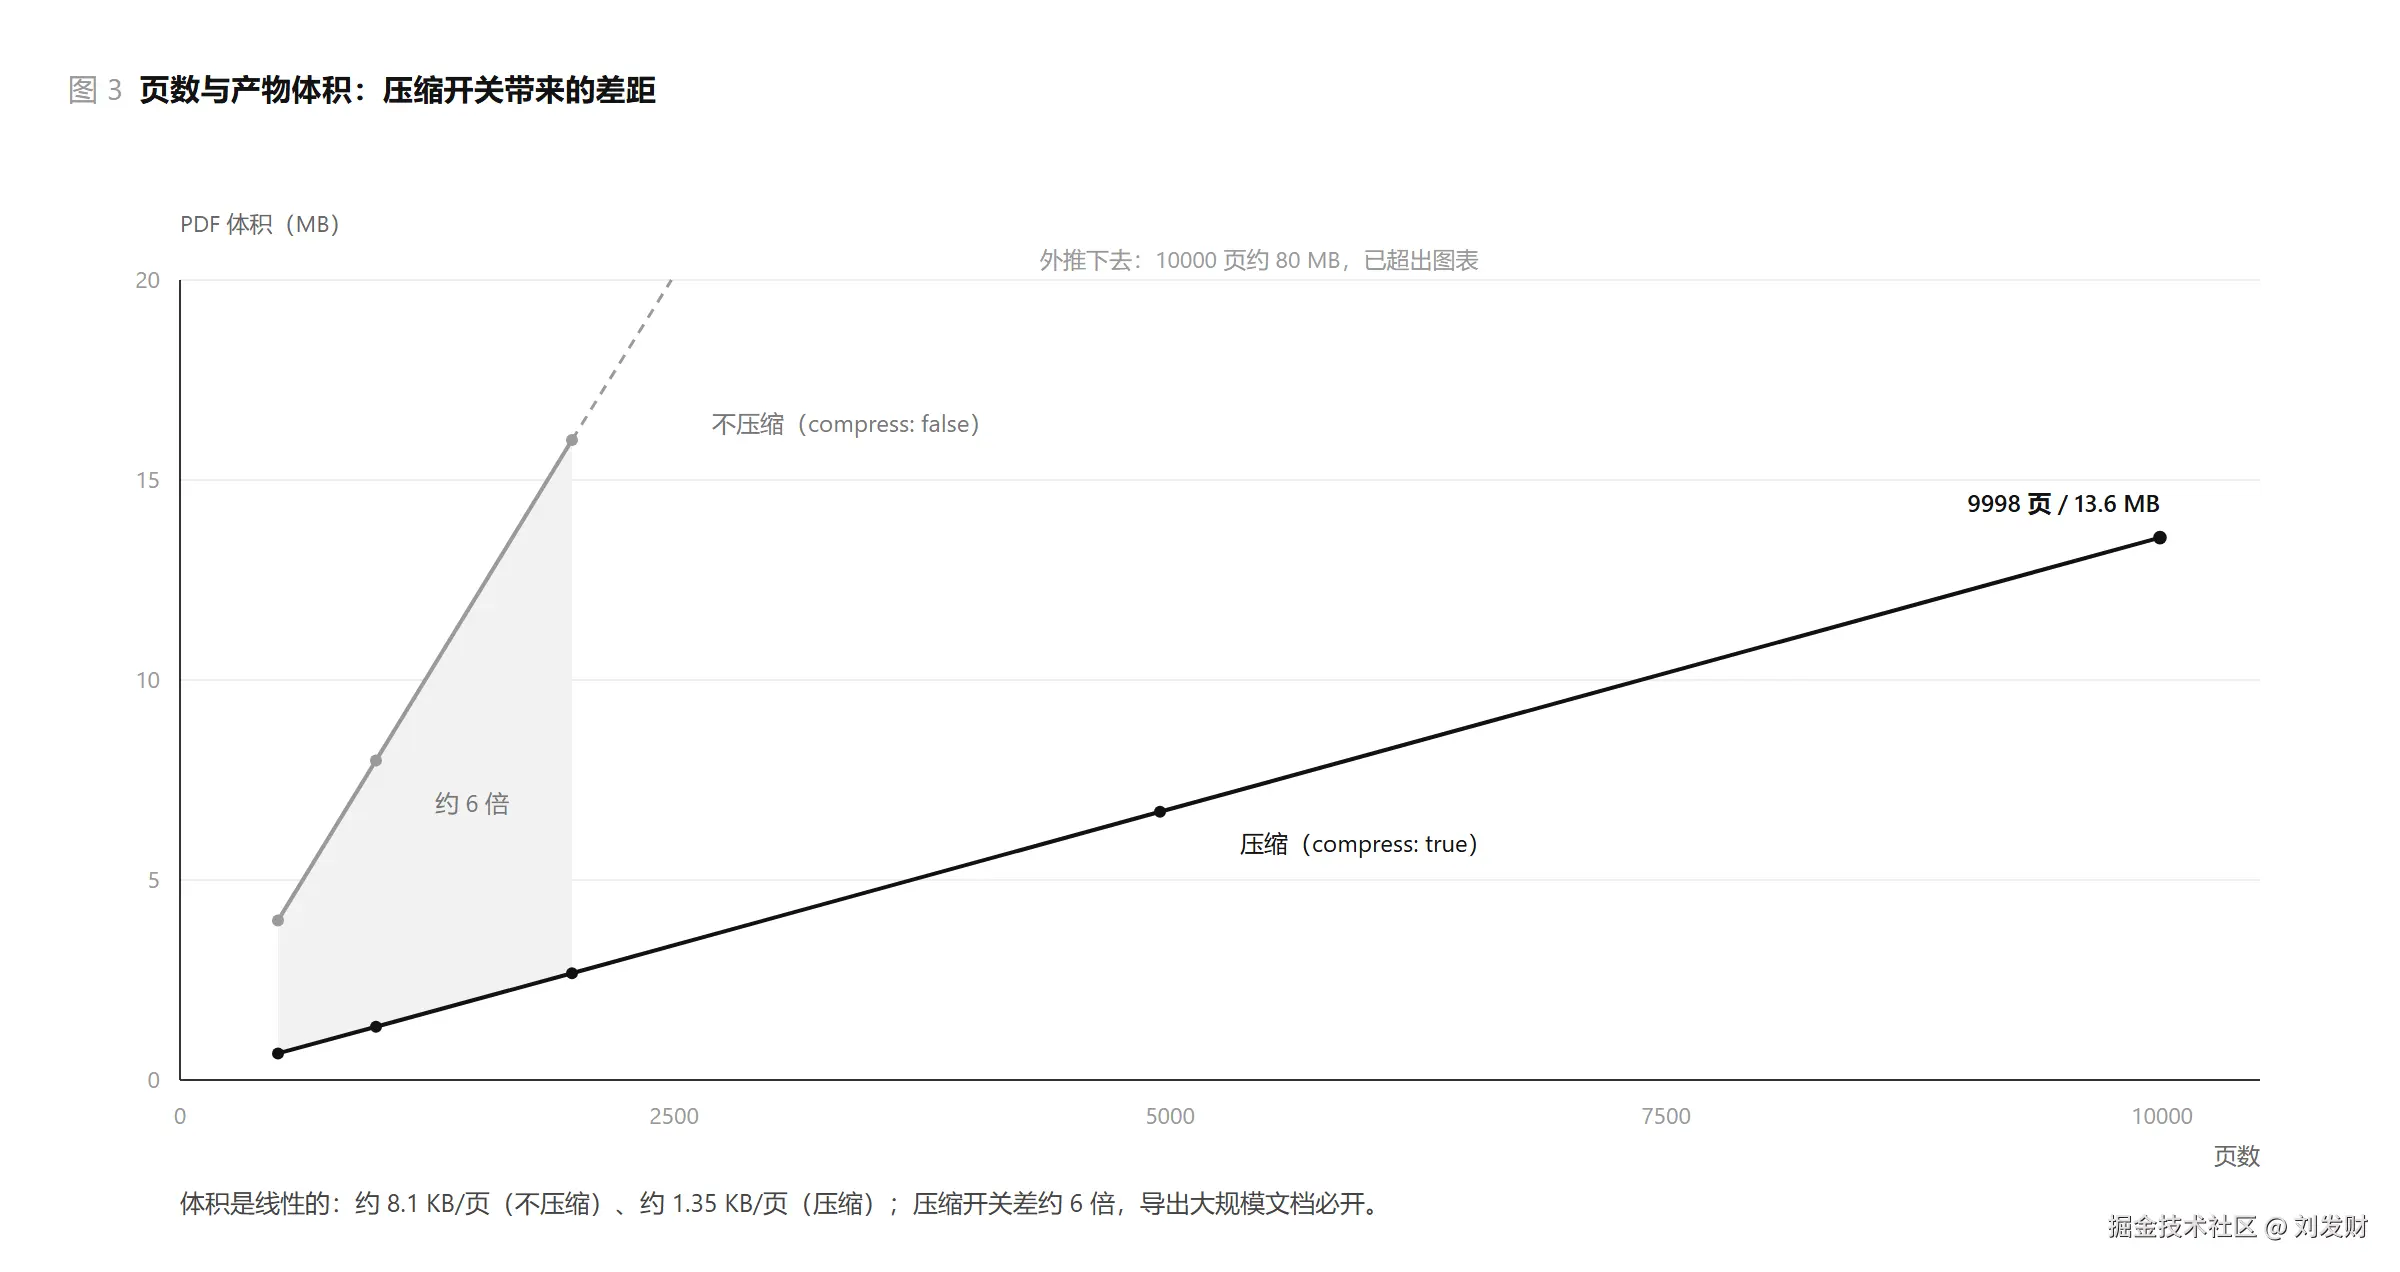 图 3:页数和体积基本是线性关系,开了压缩之后斜率降下来,一万页也就 13.6 MB。
为什么它能扛住一万页
回到前面那四条要求,dompdf.js 的处理方式是这样的。
不走 Canvas。文字直接映射成矢量字形写进 PDF 内容流,不受 65535px 单边限制。
主线程只负责采集 DOM 几何与样式快照,然后以二进制形式转给 Worker。分页计算、字体子集化、坐标变换、PDF 字节编译都在 Worker 里做,用的是 Rust/WASM。所以从开始到结束,页面都不会卡死。
写入是流式的。PDF 本身支持追加,内部按逐页排版、逐页 DEFLATE、逐页追加到缓冲区的流程处理,中文字体子集化只在全量字符表上做一次,内存不会随页数二次放大。
跨页偏移做了累计校准。几千页的长文档里,截断误差累积几百页就会明显错位,这个校准是敢跑一万页的前提。
单页耗时并不是线性的
把耗时摊到每页:
text
495 页   → 约 1.81 ms/页
990 页   → 约 1.87 ms/页
1976 页  → 约 2.39 ms/页
4950 页  → 约 3.54 ms/页
9998 页  → 约 9.20 ms/页
页数涨了 20 倍,单页成本涨了近 5 倍。拟合下来,总耗时大致正比于页数的 1.5 次方。
所以文档里写的「500 页约 2 秒」在中小场景下是成立的,这次实测甚至只要 0.9 秒,但不能顺着推「一万页 40 秒」,实测中位数是 92 秒左右。
这段数据放进文章里,主要是想避免一种情况:有人拿着「500 页 2 秒」去跟老板保证「万页半分钟搞定」,然后在上线的时候翻车。
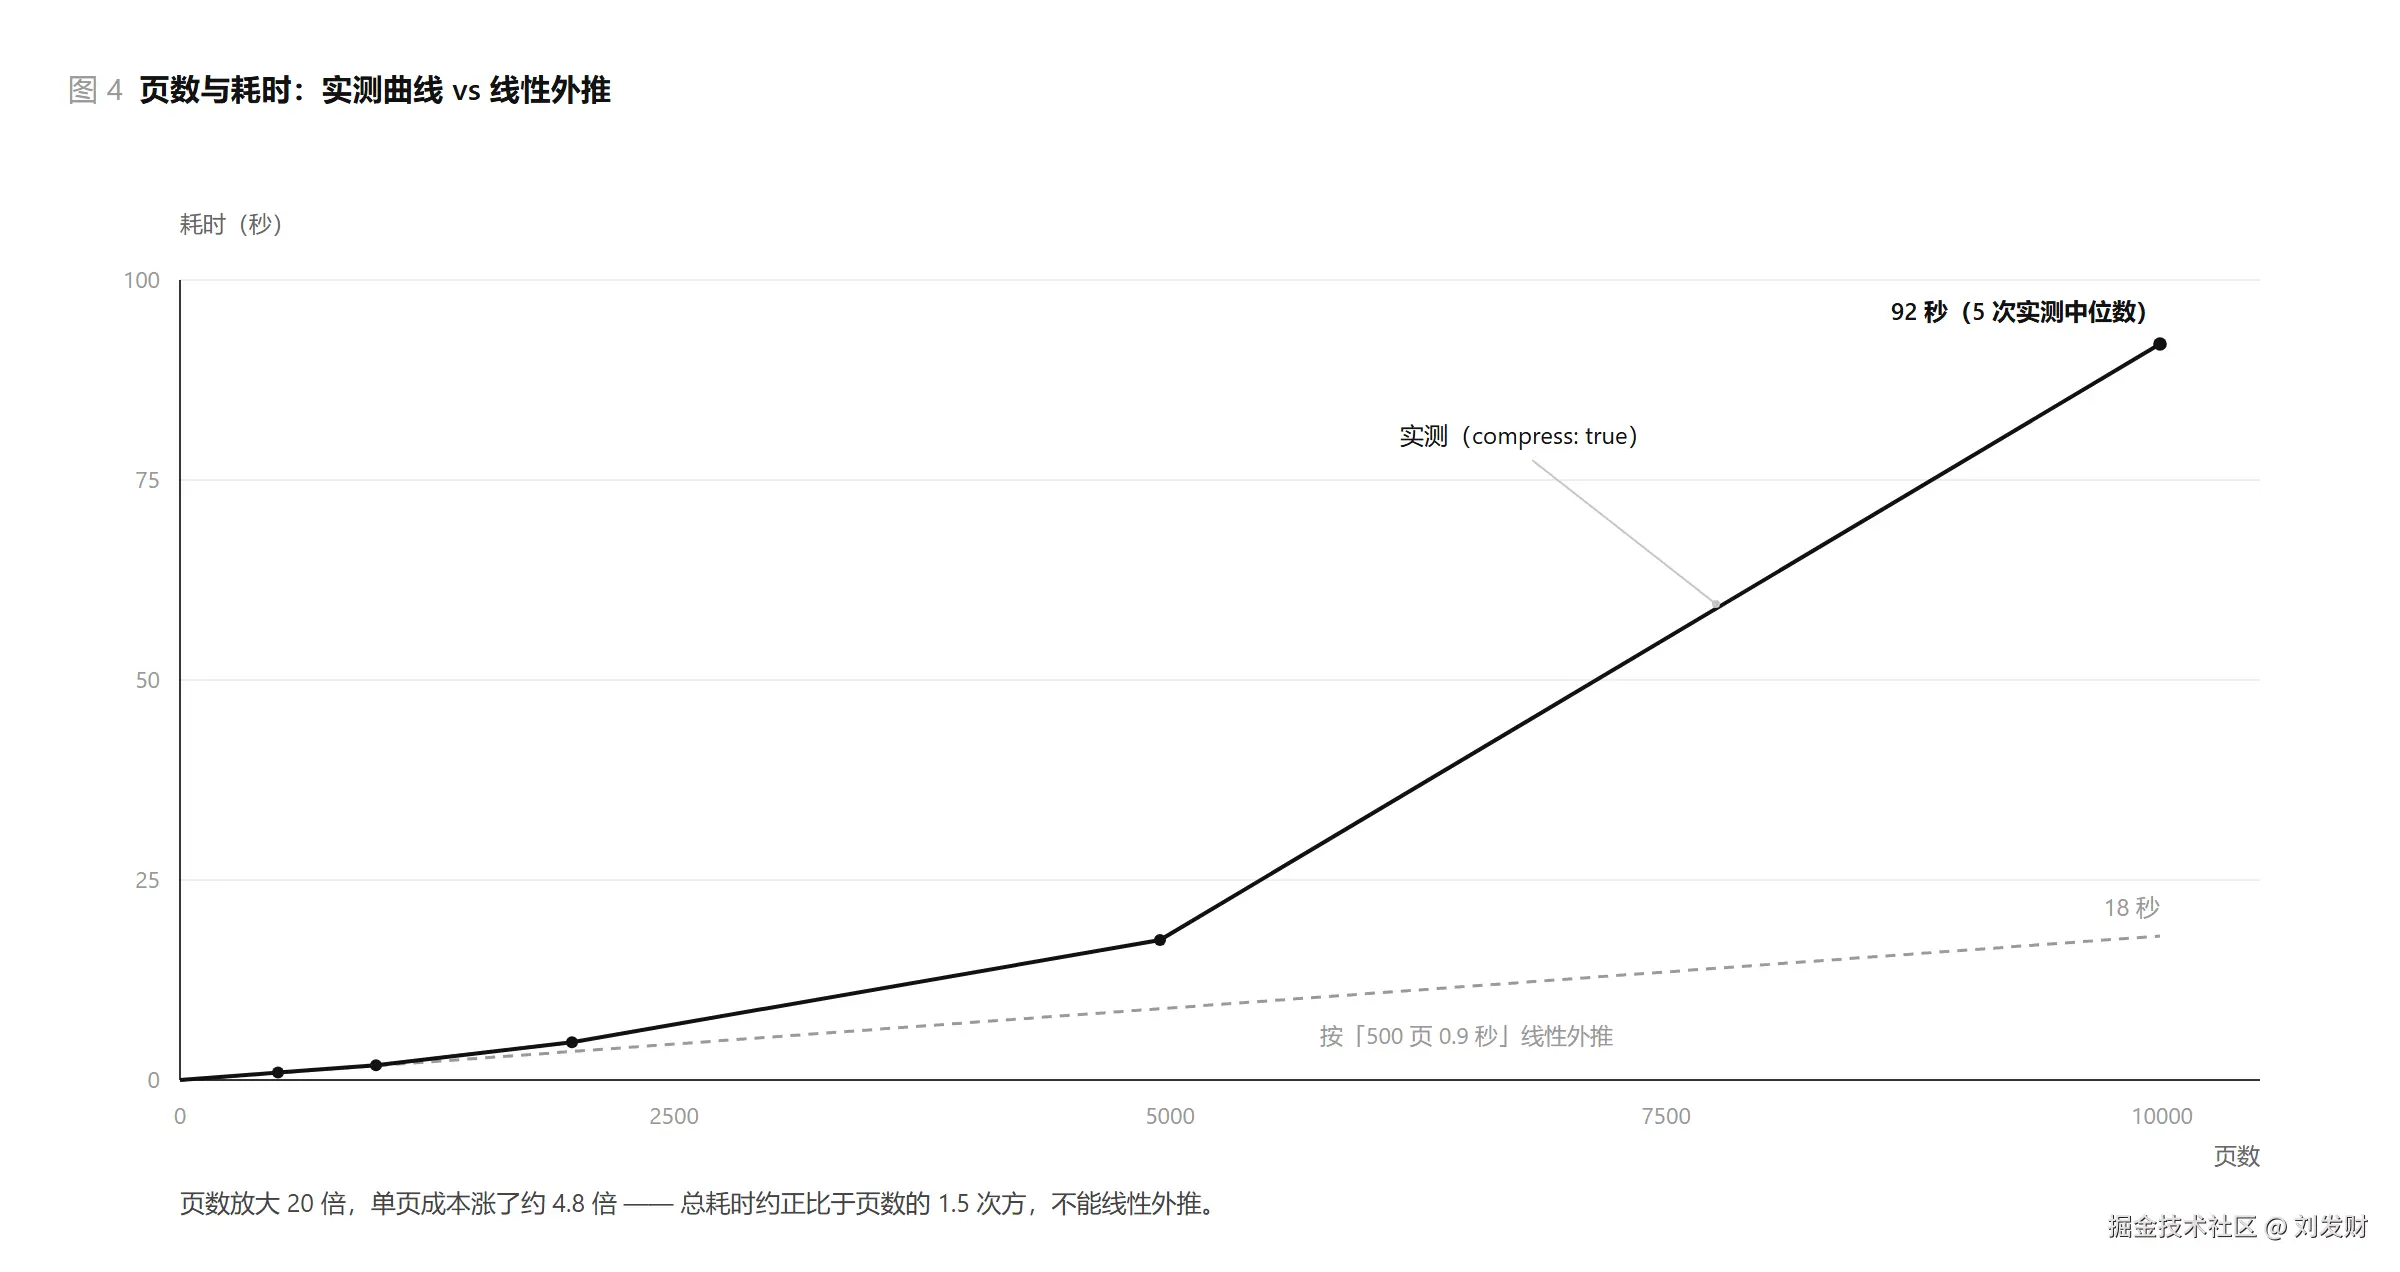 图 4:实测耗时曲线和线性外推的对比,线性推导会低估万页后期的计算量。
7. 真正的瓶颈可能不在 PDF 引擎
做完这组压测,我最想说的是这一点。
前面所有推导都建立在「你已经有一个一万页的 HTML 页面」这个前提上。但在浏览器里,这个页面本身从哪来?
哪怕按最克制的单页 10 个节点算,一万页就是十万个真实 DOM 节点。浏览器要布局这十万个节点、计算级联样式、在内存里维护它们,开销本身就不小。测试脚本里那九千多个 section,光是浏览器构建 DOM 和采集样式的时间,就快追上 Worker 里渲染的总时间了。
所以生产环境真遇到上万页的导出需求,比较稳的做法不是把一万页全堆在一个页面里硬扛,而是配合下面几种:
- 分段导出再合并字节。每批只在页面里渲染 500 到 1000 页,拿到 PDF 字节存进临时数组,然后清空 DOM 释放内存,最后把多个字节流合成一个完整文件。这样 DOM 和 WASM 的内存水位都压得住。
- 数据按需拉取。配合导出进度在内容侧做游标分页,不用一次把全部数据拉到前端。
- 精简单页 DOM。同样是一万页,单页 5 个节点和单页 50 个层层嵌套的卡片,性能差得很远。
引擎扛得住一万页,不代表页面结构扛得住。
8. 最后
回到开头的问题,前端能不能生成一万页的 PDF。
能,但前提是别再用截图方案。
文档只有几页,也不在乎文字能不能复制,html2canvas + jsPDF 依旧是最省事的选择。但体量上到几百、几千甚至上万页,全链路矢量化、不落地中间位图、编译放到独立线程,这几件事就不再是优化项,而是能不能跑起来的门槛。
dompdf.js 是目前纯前端里比较少见的现成方案:单文件 502 KB,无第三方运行时依赖,矢量文本与样式还原,实测近万页导出,产物 13.6 MB。
也说下它的边界。它依赖宿主浏览器提取样式,所以跑不了纯 Node.js 或 SSR;复杂的 CSS 滤镜和 Mask 遮罩在排版时会被降级;中文需要显式通过 fontConfig 配置 TTF 文件,库内自带运行时字体子集化,不用担心字体文件随页数膨胀。
在线体验:dompdfjs.lisky.com.cn
GitHub:github.com/lmn1919/dom...