在audio DSP这类低算力、低memory的处理器上,只有算力要求低、参数量小的模型才能部署。在语音降噪领域,以前的模型参数通常都大于500k,很难在audio DSP上落地。近两年出了一个GTCRN(Grouped Temporal Convolutional Recurrent Network)的语音降噪模型,参数量只有48.2k(其中要训练的有23.7k,不需要训练的有24.5k),与同样是小参数量的RNNoise模型相比,降噪效果有明显的提升,也能在audio DSP上部署。低算力、小参数量以及降噪效果好,让我对其产生浓厚的兴趣,利用github上开源的推理等代码进行了一番学习,基本上搞明白了原理。我决定出一个GTCRN学习笔记系列,详细介绍GTCRN的细节。本文先对其作一番概述。
GTCRN在github上的地址是https://github.com/Xiaobin-Rong/gtcrn。文件目录如下图所示,对主要的做一简要介绍。
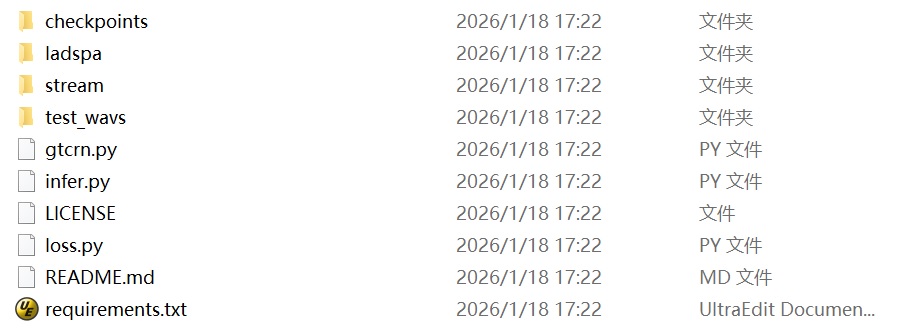
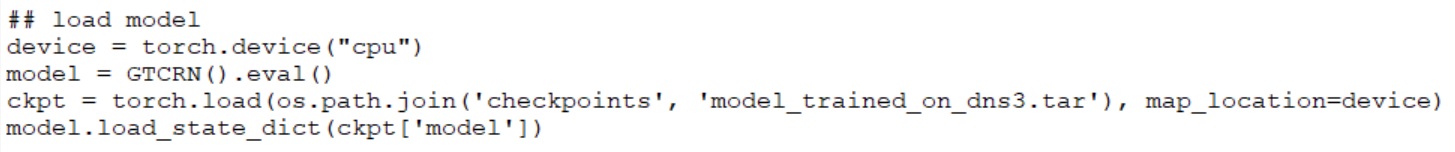
1)checkpoints里面放的是分别基于DNS3和VCTK数据集训练好的两个模型。在推理代码里把想要的模型做load后就可用相应的模型了。下图load的是DNS3的模型。
2)stream里放的是流式推理实现。开源里给了两个推理实现,一个是离线实现,一个是流式实现。对实时降噪来说,离线实现主要用于理解模型,真正用的是流式实现
3)test_wavs里放的是降噪前和降噪后的音频文件
4)gtcrn.py是GTCRN的模块代码实现
5)infer.py是推理的代码实现
6)README.md是一些说明,方便用户使用
7)Requirement.txt是pytorch等版本的指定。具体如下图:
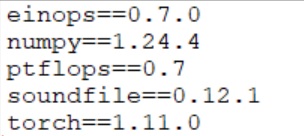
运行推理代码前要建一个conda环境,根据指定的版本把pytorch等安装上。
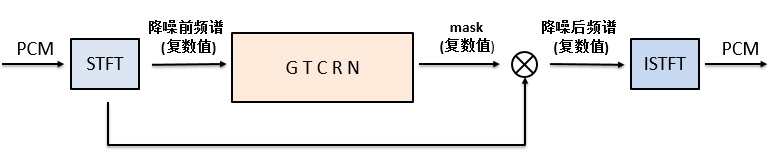
先看降噪过程,上图给出了示意图。音频的PCM值做完STFT(短时傅里叶变换)后得到的是频谱复数值。复数值作为模型的输入,模型运算后的输出值依旧是复数值,叫mask。Mask可以看作是gain,即经过GTCRN模型得到的是一个gain值,只不过这里的gain是复数值。将STFT后的频谱复数值与mask复数值相乘,得到的依旧是复数值,这个值就是降噪后的频谱复数值,再经过ISTFT(短时傅里叶逆变换)后就得到了降噪后的PCM值。我在前面的文章(webRTC中语音降噪模块ANS细节详解(一))讲webRTC ANS时讲了是用维纳滤波来做降噪的,维纳滤波得到的也是gain,跟这里的mask意思是一样的。GTCRN可以看作是神经网络版的维纳滤波。
再来看GTCRN模型内部有哪些模块。它包括ERB(equivalent rectangular bandwidth,等效矩形带宽)、SFE(subband feature extraction,子带特征提取)、编码器(encoder)、分组双路径RNN(GDPRNN)和解码器(decoder),如下图所示:
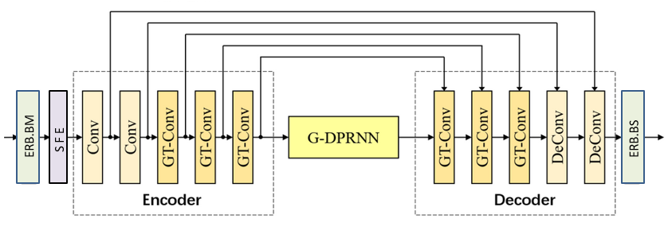
数据进入模型后先经过ERB.BM模块,把数据从257维压到129维,这大大地减少了参数量。由于维数压缩后频带变宽,相邻频带之间的局部频谱关系变弱,因此要经过SFE模块,来加强相邻频带之间的局部频谱关系。后面就是传统的CRN架构,包括encoder、decoder和RNN,为了减少参数量做了些改进。最后经过ERB.BS模块,把数据从129维变回257维,得到复数的mask值。本文先对这些模块做个简单的介绍,后续学习笔记中具体讲。
首先看ERB模块。模型的输入是做完STFT后的频谱。STFT帧长32毫秒,帧移 16毫秒,PCM采样率为16KHz,所以FFT长度为512。做完STFT后得到的是257个bin的频谱复数值。特征维度为257,有点大。为了减少模型参数,用ERB来减少输入特征的维度。ERB是心理声学中用于模拟人耳听觉滤波器(Auditory Filter)特性的重要度量。在257个子带中,保持65个低频带不变,将192个高频带映射到64个ERB带,从而得到一个129维的压缩特征。模型中有ERB两个子模块,分别是BM(band merging)和BS(band splitting)。BM模块在模型的开始处,根据ERB将257个频带变成129个频带。BS模块在模型的结尾处,是BM的逆过程,即把129个频带变成257个频带。
再看SFE模块。ERB.BM把频率维压缩后,band变得更粗、更局部独立,但也把相邻频带之间的局部频谱关系压弱了。SFE就是学习频带之间的局部相关性。在进入主干网络之前,把相邻频带的局部频谱关系重新编码进来, 让后面的GTConv和GRU等在更"好学"的频带特征上工作。模型的输入是做完STFT后的复数频谱,频谱的实数、虚数和幅值形成3维数据。SFE就是在每一维数据上把当前频带的左右相邻频带也各形成一维数据,这样就得到了3维数据。由于有实数、虚数和幅值3维,所以总共就是9维数据作为后续模块的输入。这样相邻频带的局部频谱关系就建立了。
最后看CRN。CRN包括CNN(encoder以及decoder)和RNN。CNN学局部特征,RNN学长期时间依赖。Encoder作用是压缩频率维度,提取局部频谱特征,它由两个卷积(Conv)和三个分组时序卷积(GT-Conv)块组成。Decoder作用是恢复频率分辨率,它是encoder的镜像,其中每个Conv块被一个DeConv替换,该块具有与Conv块相同的组件。GDPRNN是DPRNN (Dual-Path RNN) + GRNN(Grouped RNN)的结合,既保留 Dual-Path 的长时序建模能力,又把 GRU 参数减少了一半左右,非常适合嵌入式。
后续文章将陆续讲GTCRN模型中的模块,ERB、SFE、encoder、decoder、GDPRNN等。