> 系列:《VeapAI 自然语言操作实战》第 1 篇(核心篇)
> 相关源码:`veap-ui/src/views/ai/agentDesign/`(画布编排器)、`veap-ui/src/components/AiAgentEngine/`(执行器:节点处理器与调度)、`veap-cloud/DB/veap.sql`(`ai_agent_` 表族)
一、先说结论:这条链路为什么长这样
第一版原型其实很短。命令进来,调一次大模型,让它直接输出要执行的 SQL 或者接口,跑完返回结果。
跑了两周我们就放弃了。原因有三个:
第一,一次调用要模型同时干四件事------判断用户想干嘛、找到对应的表、确定字段与条件、挑出要调的接口。任何一件事判断偏了,输出整体作废,而且不知道错在哪一步。
第二,模型的输出是非确定性的,但我们要执行的东西是确定性的。中间没有一道确定性的闸门,等于把不确定直接灌进了数据库。
第三,改需求很疼。想加一种意图,得回头改那段巨大的提示词,改完还要重新验证另外三件事没被带偏。
所以最终形态是:**拆成四段模型调用,每段后面跟一个脚本做校验;整条链路画在一张画布上。**
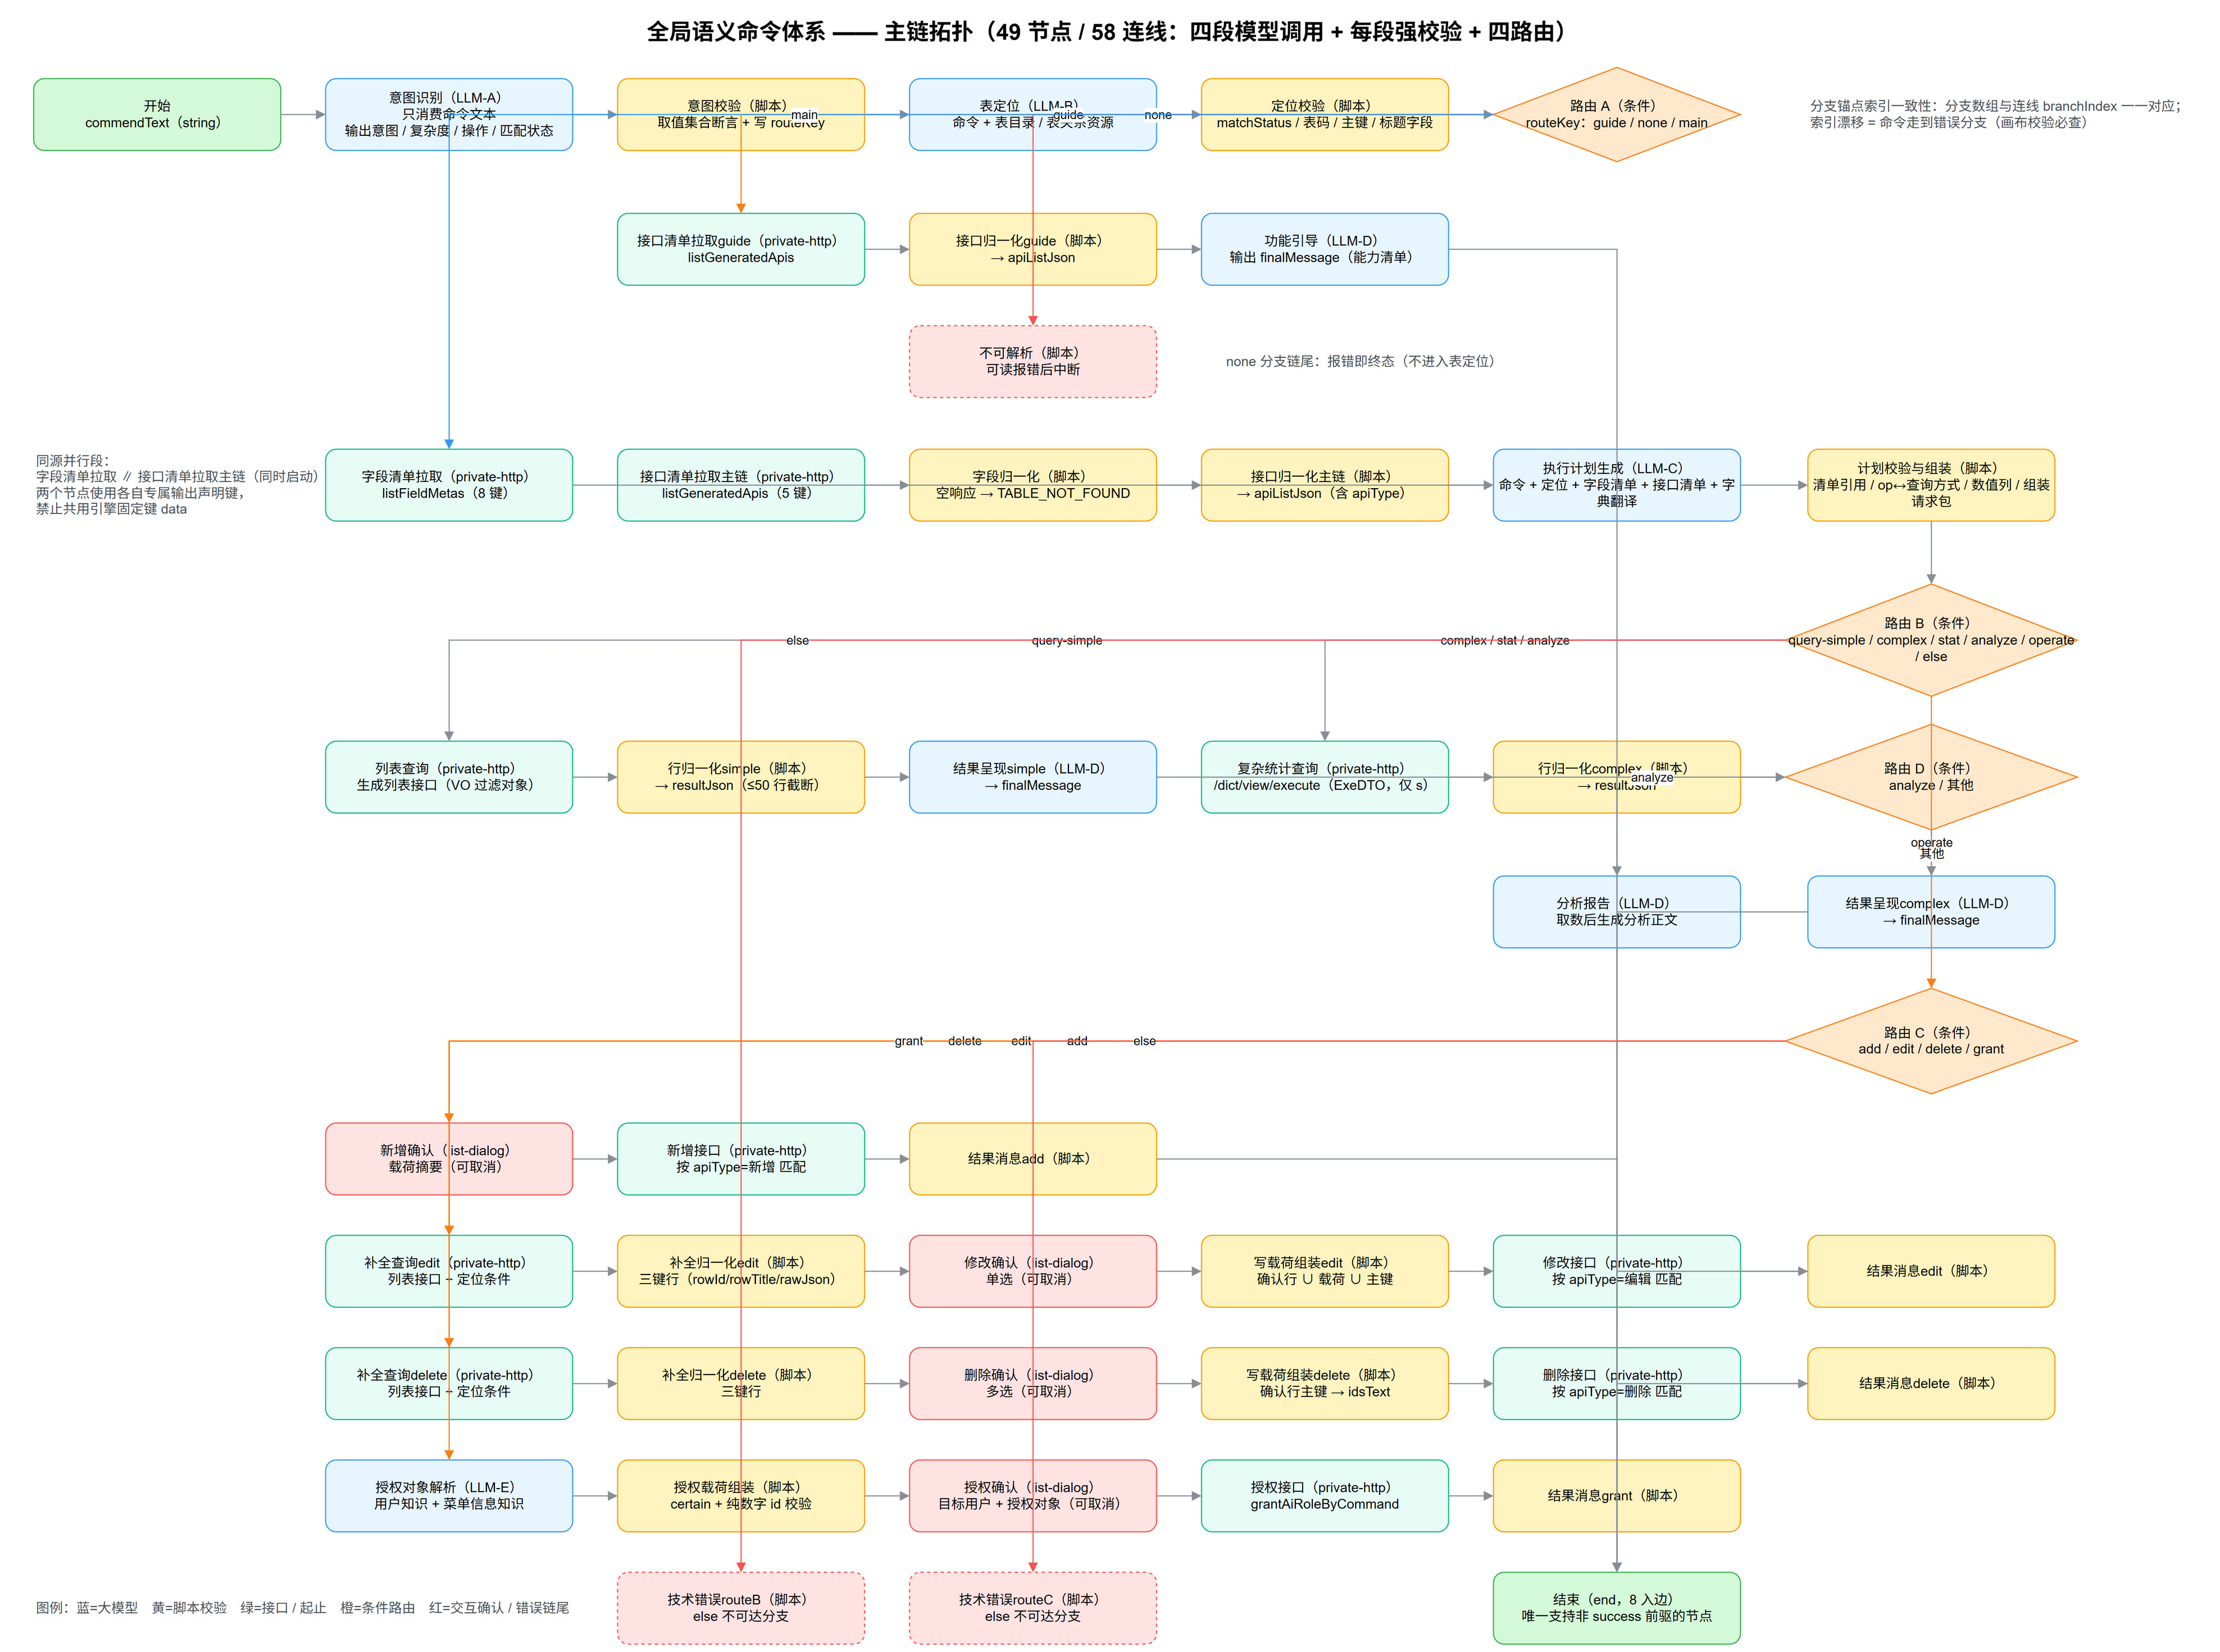
这条链路现在是 49 个节点、58 条连线。数量听着吓人,摊开看并不复杂:真正做判断的节点只有五个,其中四个是大模型节点;其余大部分是脚本校验、路由分支、接口调用和确认弹窗。
整条链路长这样:
!命令解析主链拓扑:49 个节点与四组路由
二、为什么把判断拆成四段
四个大模型节点,各干一件事:
| 节点 | 它要看的东西 | 它要输出什么 |
| --- | --- | --- |
| 意图识别 | 只有用户命令 | 意图、复杂度、操作类型、匹配状态 |
| 表定位 | 用户命令 + 表目录资源 + 表关系资源 | 目标表编码、表标题、主键字段、标题字段 |
| 执行计划 | 用户命令 + 目标表定位 + 字段清单 + 接口清单 + 字典翻译资源 | 过滤条件、排序、条数、聚合、分组、接口选择、载荷 |
| 结果呈现 | 用户命令 + 查询结果 | 给用户看的那段话 |
后面还有第五个:授权命令里负责解析「给谁授权、授什么权」的节点。它只在授权链上出现,这里先不展开。
拆开带来的第一个好处是**每段输出都很短,短到可以逐字校验**。
意图识别的输出就是一个 JSON 对象,含五个键。其中四个的值来自固定集合:意图五选一(查询、统计、分析、操作、引导),复杂度二选一,操作类型四选一,匹配状态三选一。校验脚本把它们挨个对一遍,不在集合里就报错。报错文案也是可读的,比如提示「意图识别输出 matchStatus 非法(必须为 certain/ambiguous/none)」。
第二个好处是**意图识别不依赖任何清单数据**。
这一点直接影响链路形态。表定位需要表目录,执行计划需要字段清单和接口清单,这些都要数据。但意图识别只需要用户那句话。所以它可以和后面的数据准备并行跑,关键路径因此变短。
第三个好处是**错误定位变准了**。
四段模型调用之间有三道脚本闸门,加上字段归一化和接口归一化,一共五道。命令失败时,报错文案会告诉你卡在哪一段:是没识别出意图,是没定位到表,还是计划里引用了不存在的字段。这比一句「模型执行失败」有用得多。
三、每段模型输出后面都要有一道闸门
这是整套设计里我们最坚持的一条规矩:**大模型节点的输出,必须由紧随其后的脚本节点解析一遍,脚本是这段输出的唯一解析点。**
理由很朴素。模型的输出是文本,文本可能不是合法 JSON,可能是合法 JSON 但取值越界,可能是取值合法但引用了不存在的东西。这三种情况必须在执行之前拦下。
以执行计划这一段为例,闸门要检查的东西排下来有这么多:
-
输出是不是字符串,空不空(类型契约第一道);
-
能不能解析成 JSON 对象,是不是数组;
-
过滤条件引用的字段,在字段清单里存在吗;
-
过滤条件的操作符,在允许集合里吗(等值、不等、模糊、包含、区间共八种);
-
排序字段存在吗,方向是升序还是降序;
-
聚合函数的取值在允许集合里吗(COUNT、SUM、AVG、MAX、MIN 五种);
-
条数是不是正整数,超没超过硬顶;
-
过滤字段配置了查询方式吗,操作符与查询方式是否精确对应;
-
过滤字段的 Java 属性映射有没有缺失;
-
数值列有没有被塞进文本值。
最后两条看着琐碎,但它们是真实事故留下的。有一次删除命令的目标表是 `veap_role`,模型把角色编码 `temp01` 映射到了一个数值主键字段上。前面所有校验都过了------字段存在、查询方式配置了、操作符也对得上------只在最后的数值转换里被拦下来。报错写得很直白:「定位条件值类型与字段类型不匹配(数值列不能承载非数字值)」。
所以我们后来的做法是:**闸门内能想到的坑,都在闸门里挡一次,不要指望下一段会兜住。**
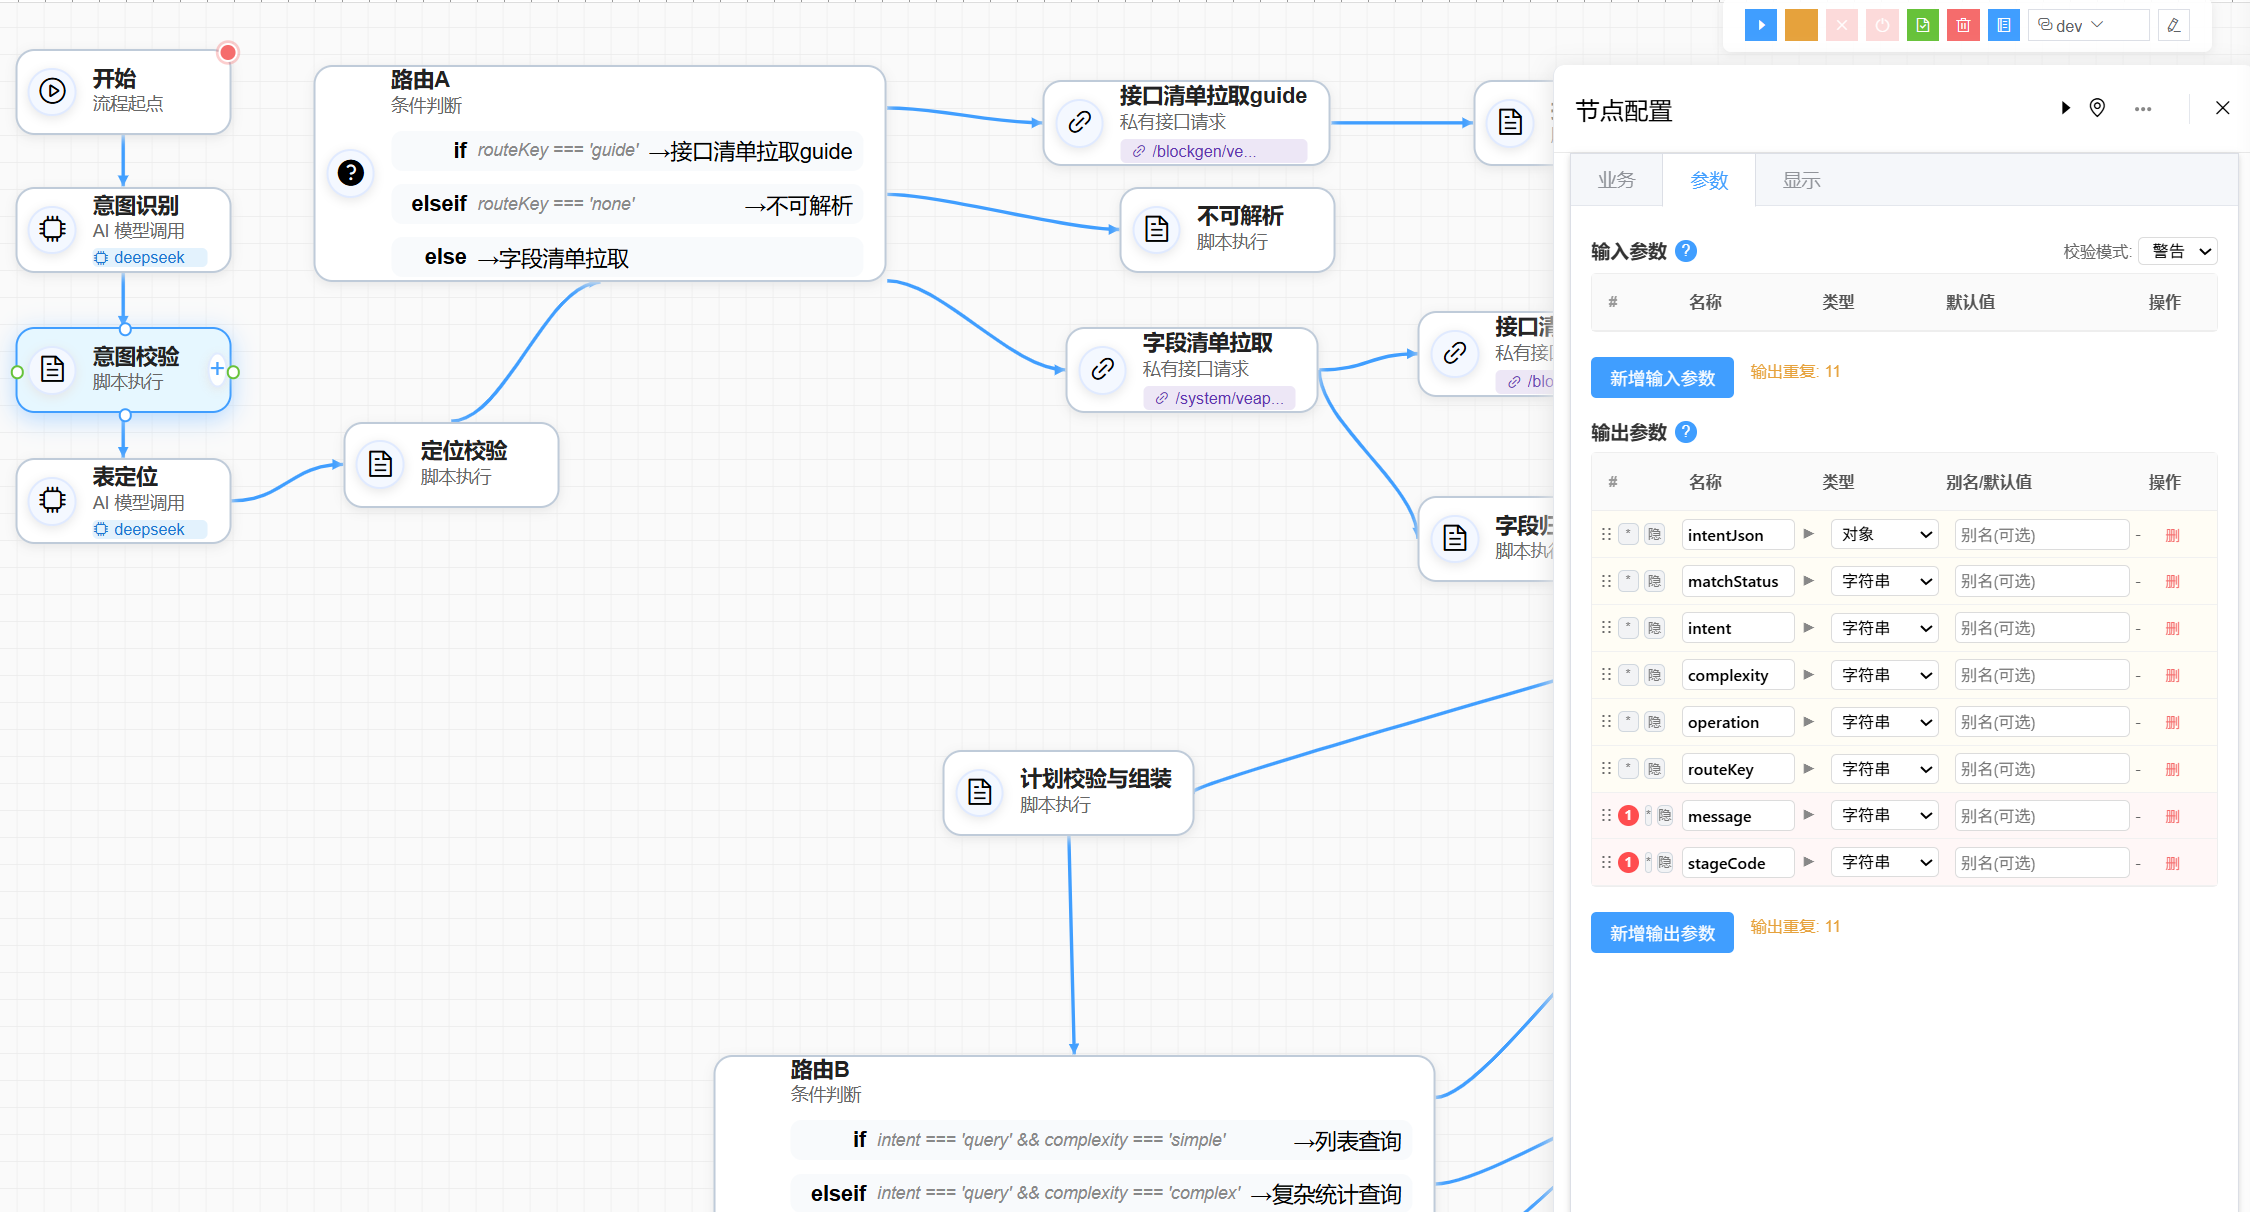
闸门长这样,就是画布上一个普通的脚本节点,只是里面的断言写得很死:
!校验脚本节点配置:取值集合与清单引用断言
四、节点分类:49 个节点其实只有五类活
把 49 个节点按职责分一下,会清晰很多:
| 类别 | 节点 | 干什么 |
| --- | --- | --- |
| 理解类 | 意图识别、表定位、执行计划、授权对象解析 | 四段模型调用,各自负责一层判断 |
| 校验类 | 意图校验、定位校验、字段归一化、接口归一化、计划校验与组装、行归一化、补全归一化、写载荷组装、授权载荷组装、结果消息、不可解析、技术错误 | 确定性边界:解析、断言、组装请求包 |
| 取数类 | 字段清单拉取、接口清单拉取、接口清单拉取(引导分支)、列表查询、结构化查询、补全查询 | 调接口拿数据 |
| 交互类 | 新增确认、修改确认、删除确认、授权确认 | 写操作前的确认弹窗 |
| 路由与收尾 | 路由 A/B/C/D、结果呈现、分析报告、开始、结束 | 分流与输出 |
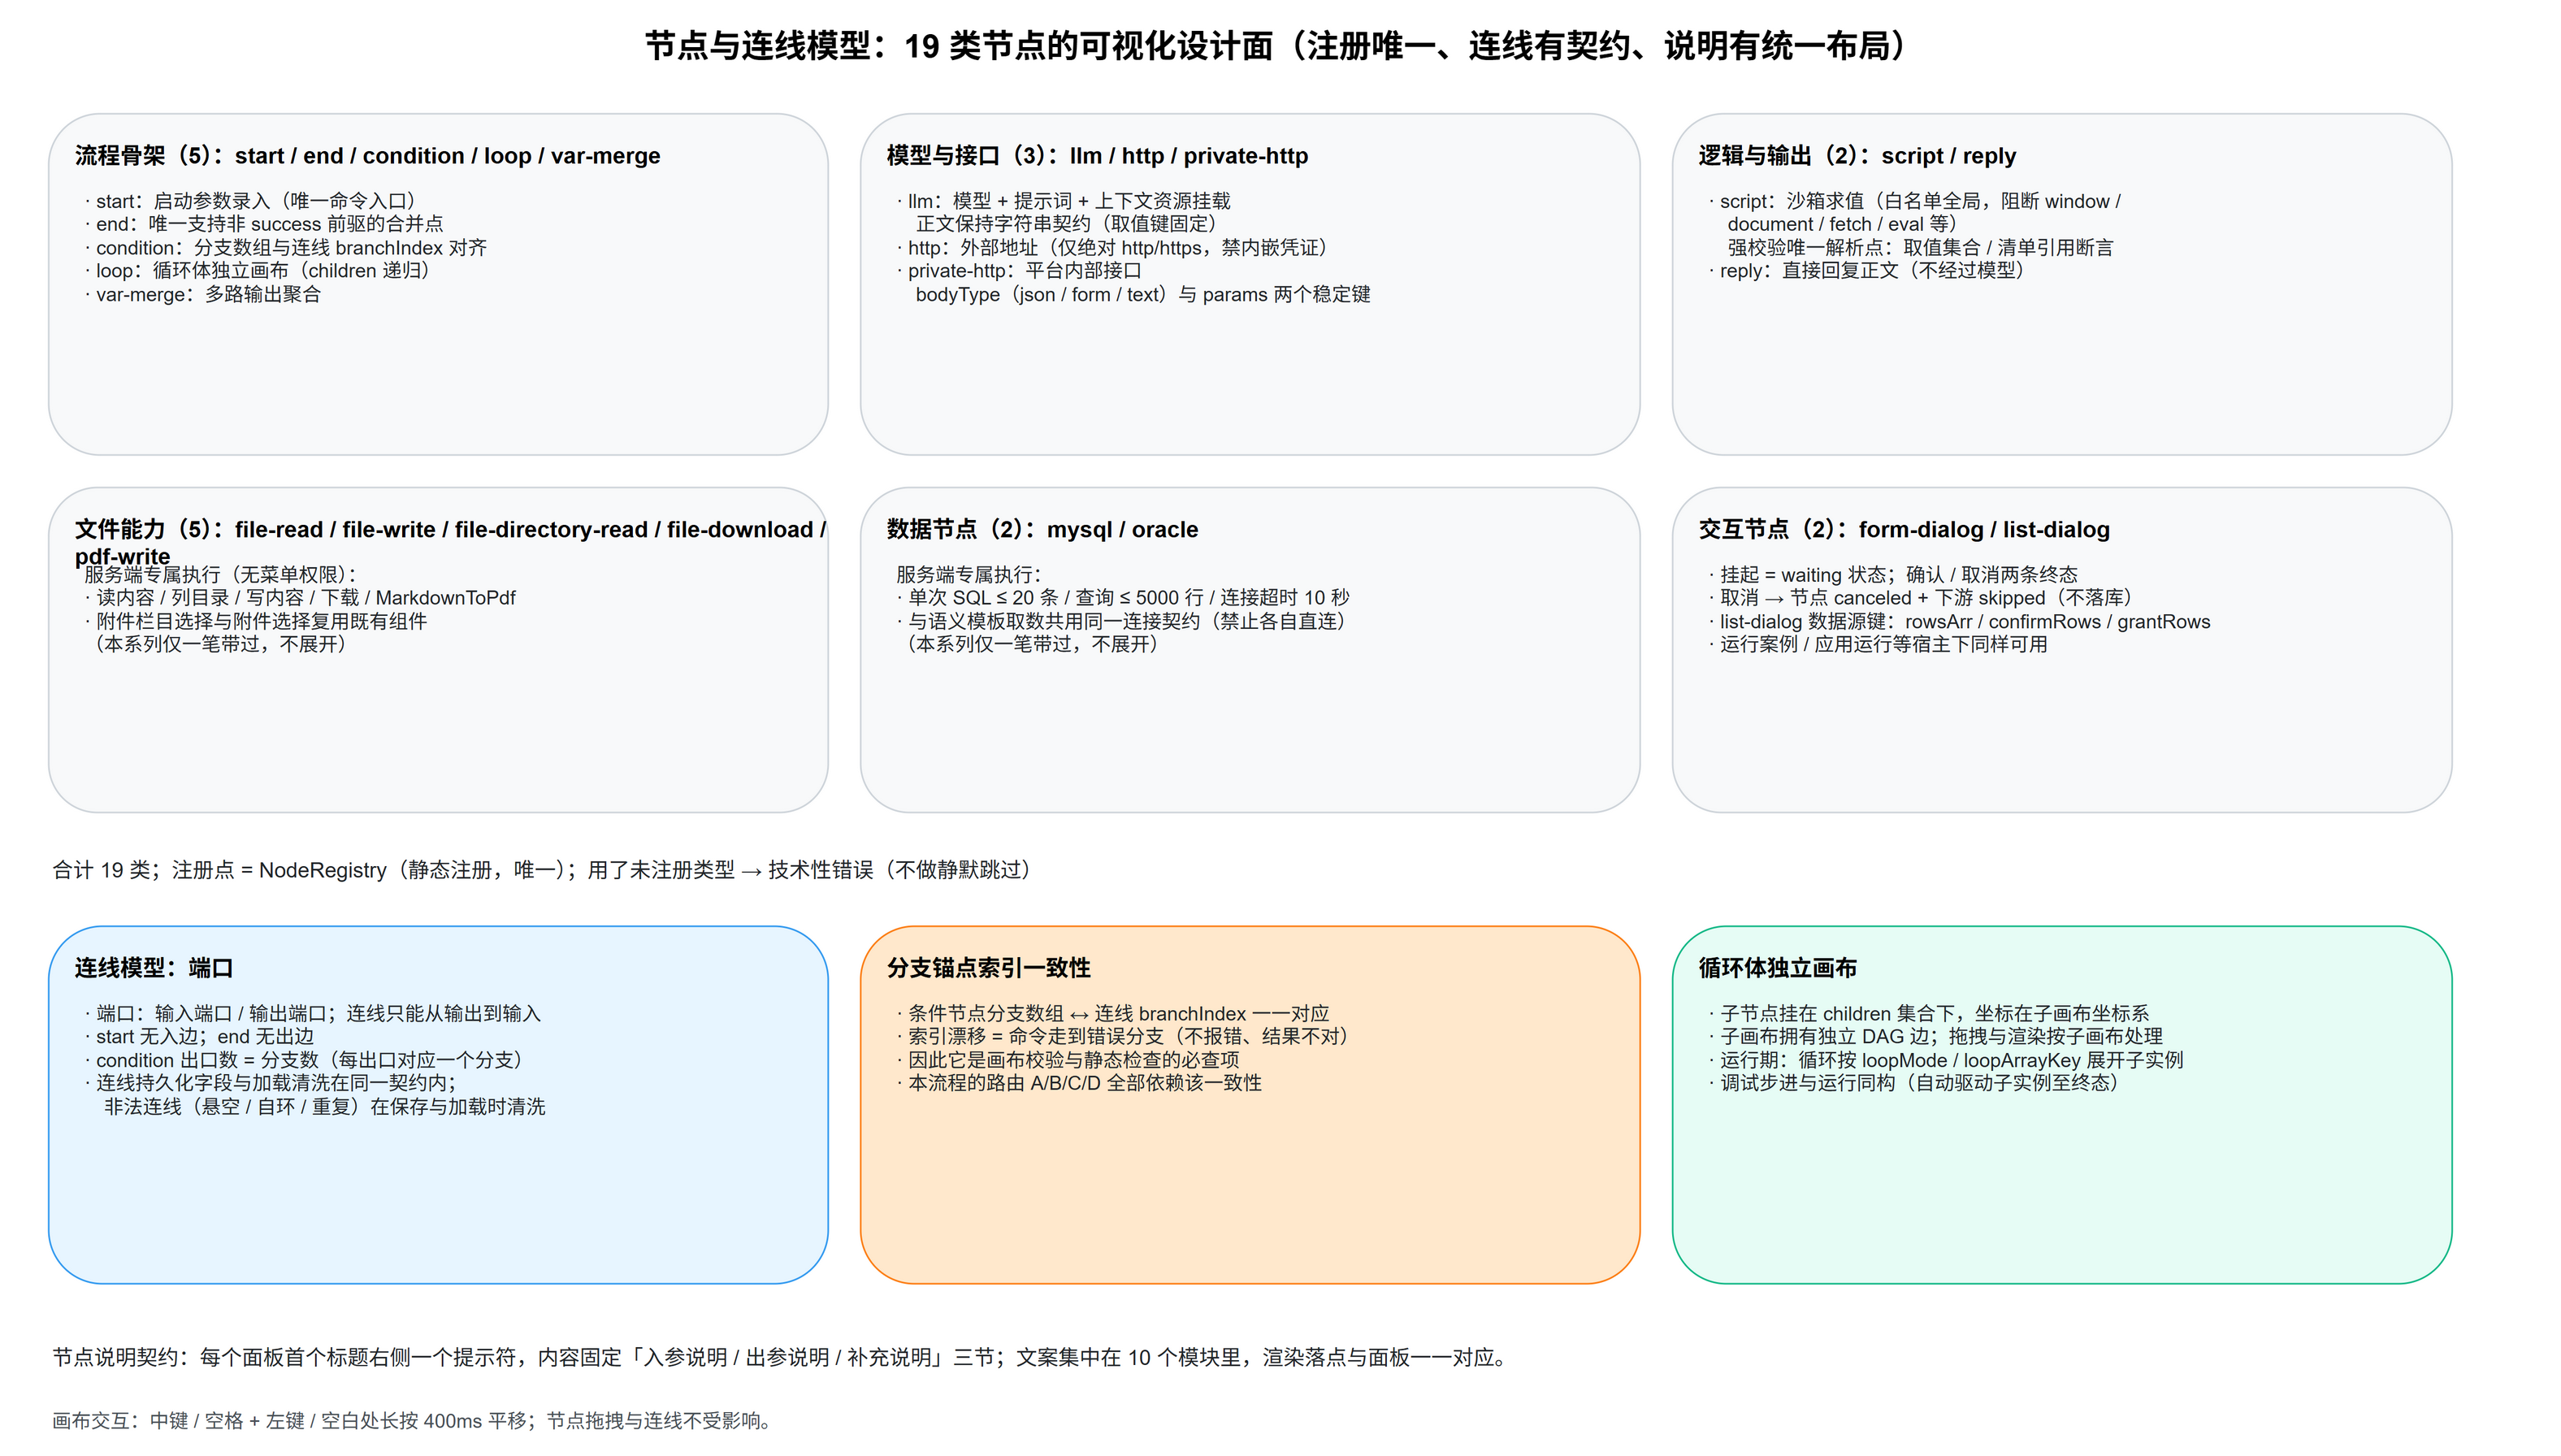
节点类型本身是受限的。平台注册的节点类型一共 19 种,注册点在 `NodeRegistry` 这个静态文件里,执行时按类型取处理器。用了没注册的类型会直接抛技术性错误,不会当作未知节点跳过。
节点实例落库在 `ai_agent_node_instance` 表,关键字段如下:
| 字段 | 注释原文 | 说明 |
| --- | --- | --- |
| `node_exec_order` | 节点执行顺序 | 与实例 id 组成索引 `idx_instance_order`,按序查执行链 |
| `prev_node_id` | 前序节点 id(节点 id 为雪花字符串) | 记录紧邻前驱,起点节点为空 |
| `node_id` | 流程定义中的节点 id | 与画布上的节点一一对应 |
| `node_type` | 节点类型 | 19 种取值之一 |
| `exec_status` | 节点状态 | 九态:等待、执行中、待交互、成功、失败、跳过、终止、错误、已取消 |
| `input_data` / `process_data` / `output_data` | 输入 / 过程 / 输出数据 JSON | 排查问题时的第一手材料 |
| `duration` | 耗时(ms) | 单节点耗时 |
| `exec_metadata` | 执行元数据 JSON | 扩展信息 |
两个索引对应两种最常见的排查动作:`idx_instance` 按流程实例查,看这次运行跑了哪些节点;`idx_instance_order` 按实例加执行顺序查,看某个节点的前后发生了什么。
节点与连线的整体模型(19 类节点的分组,以及端口与分支锚点)如下:
!节点与连线模型:19 类节点的可视化设计面
五、分支与并发:这张图怎么保证不死锁
链路里有四组路由。
-
**路由 A** 按意图校验脚本写下的路由键分流,三个出口:引导、无法识别、主链;
-
**路由 B** 按意图与复杂度分六路:简单查询直连列表接口,复杂查询、统计、分析走结构化查询,操作类进入操作子链,剩下一个出口是逻辑上不可达的兜底;
-
**路由 C** 在操作子链里再分四路:新增、修改、删除、授权;
-
**路由 D** 在复杂查询结果出来后分流:需要写分析报告的走报告节点,其余走结果呈现。
并发则只有一段:字段清单和接口清单这两个节点同时启动。它们互不依赖,引擎每轮调度「所有依赖已满足的节点」,自然就跑在一起了。
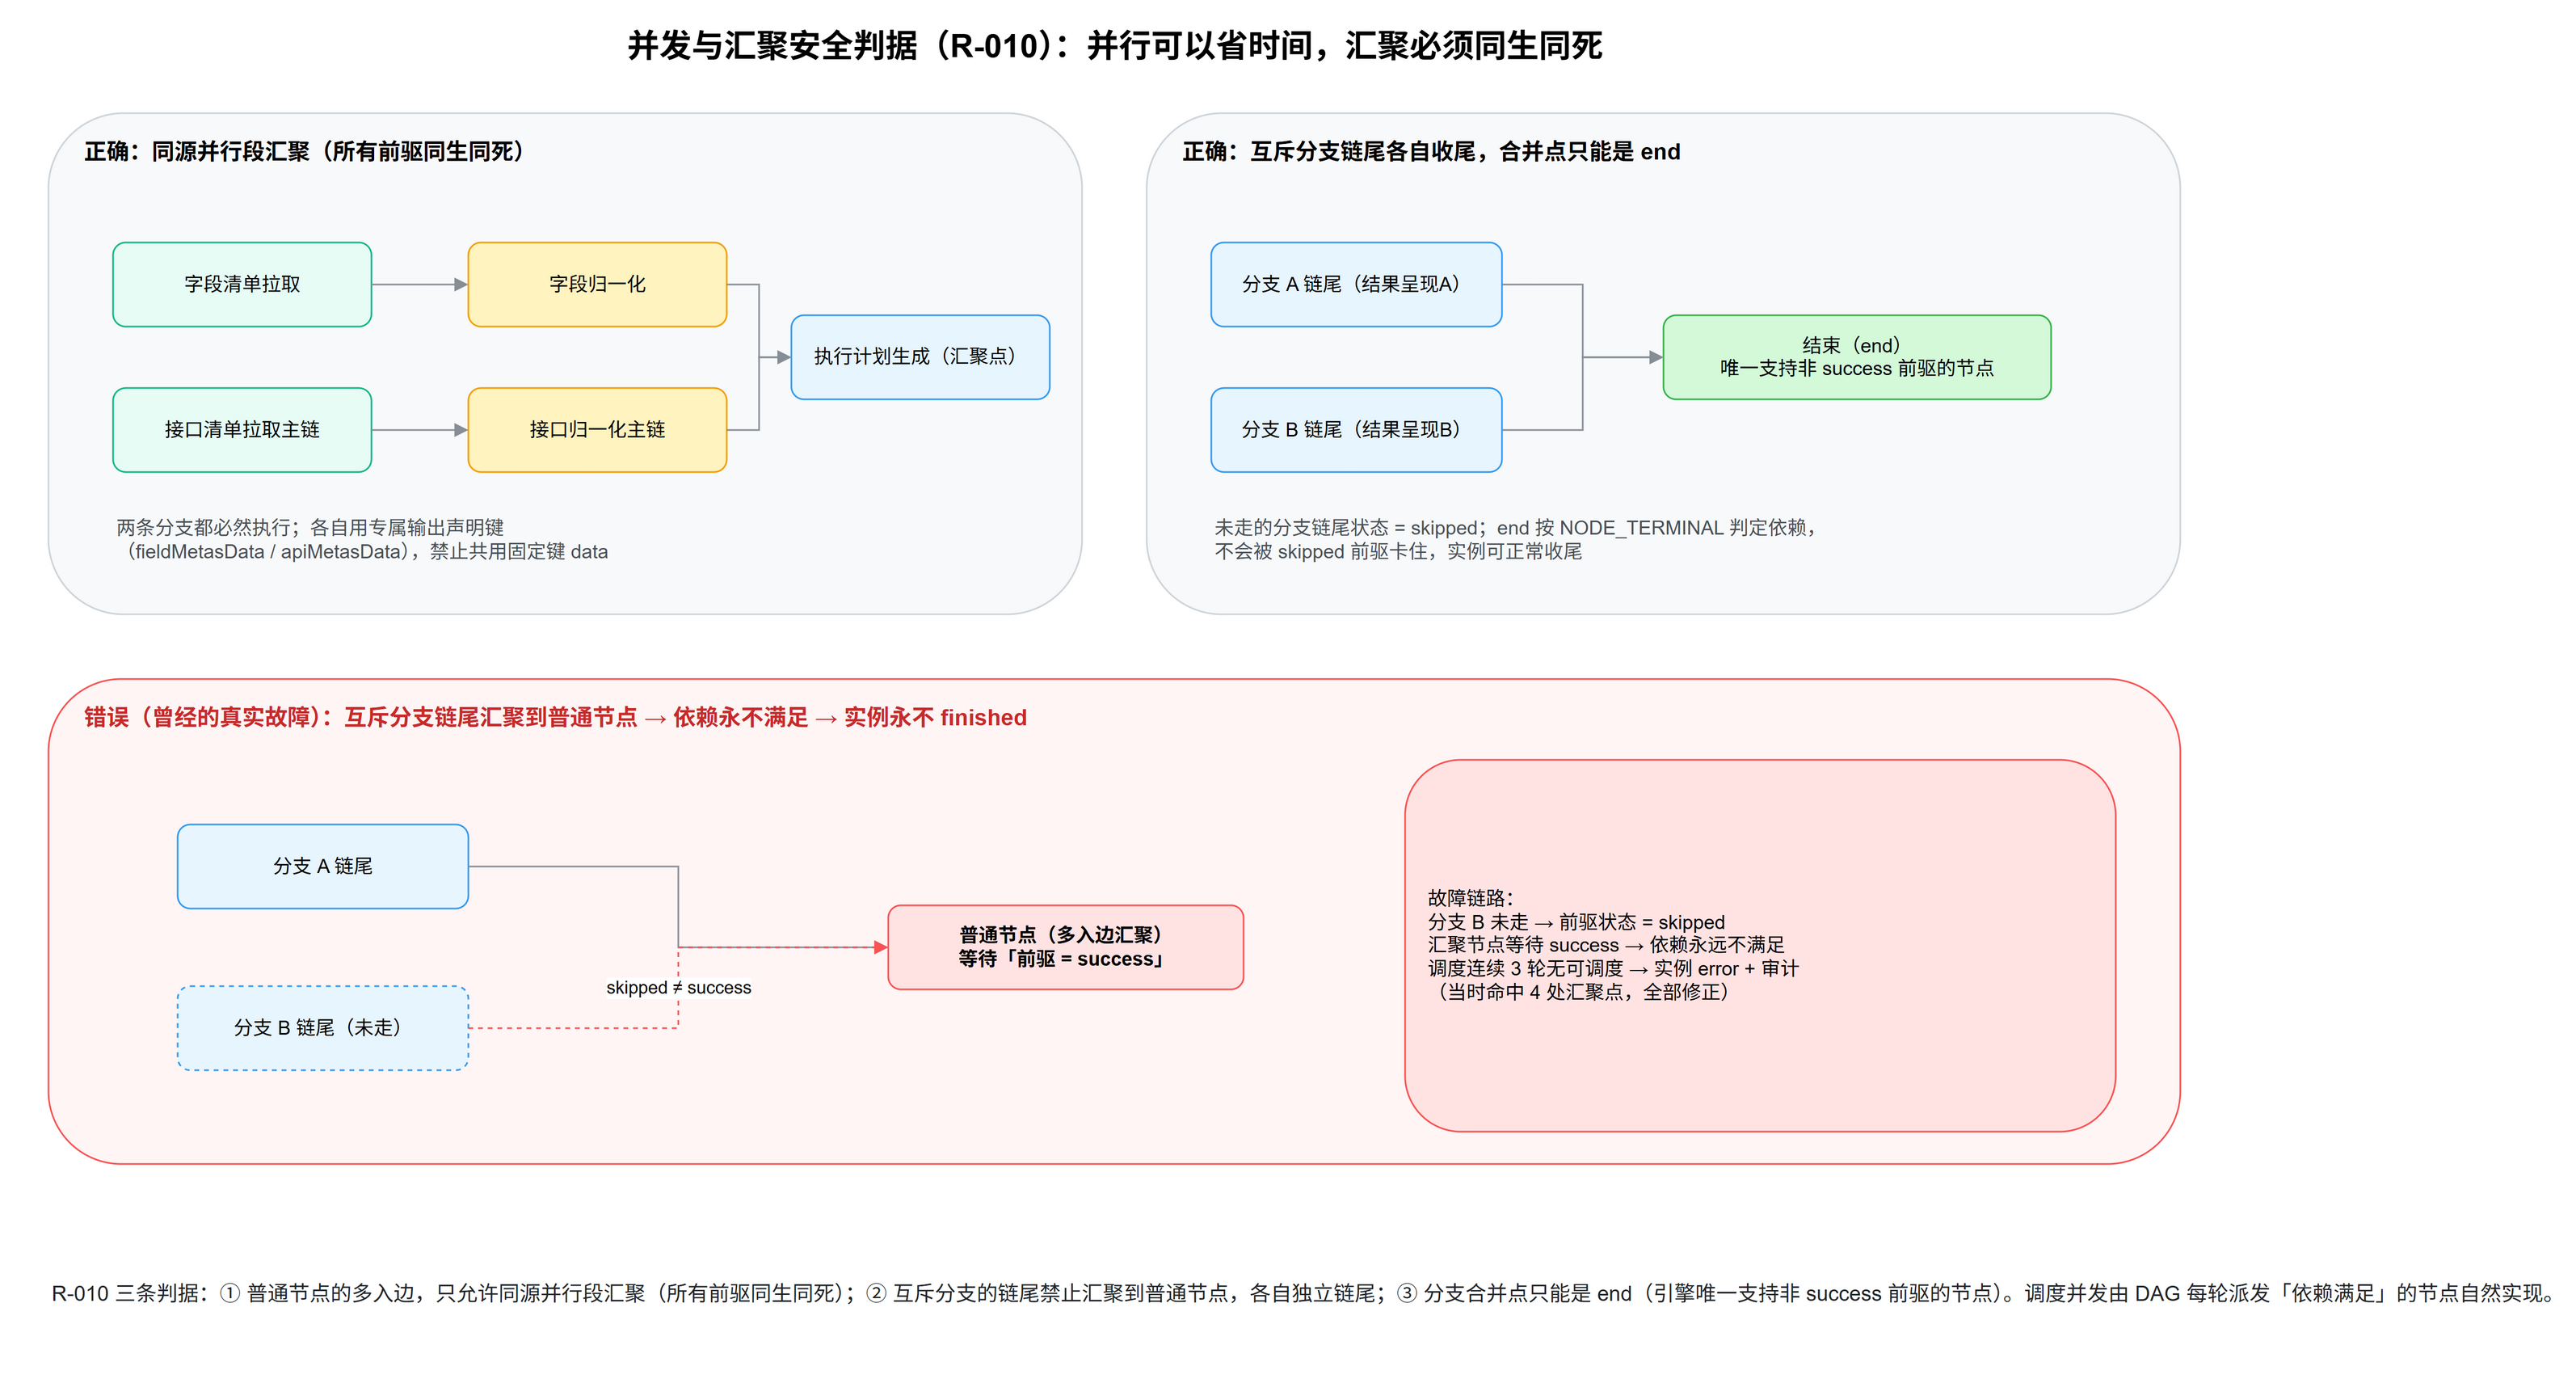
这里有一条后来写成硬规矩的判据------**普通节点的多入边,只允许汇聚同生同死的并行段;互斥分支的链尾不许汇聚到同一个普通节点,合并点只能是结束节点。**
这条规矩是被一个死锁逼出来的。最早版本里有四处把互斥分支的链尾连到了同一个普通节点上。看着没问题,跑起来就出事了:分支没走的那条边,前驱节点的状态是「跳过」,而普通节点等待的是「成功」,于是这个节点的依赖永远不满足,实例永远到不了终态。
结束节点不一样,它在引擎里是唯一支持「非成功前驱」的节点。所以正确做法是把互斥分支的链尾各自连到结束节点,让结束节点做那个合并屏障。
修完之后,四处汇聚点被拆开,每条互斥分支都有自己的链尾,死锁消失。这条判据后来成了画布设计的硬规矩,每次改拓扑都要重新过一遍。
!并发与汇聚安全判据:正确汇聚与曾经的死锁拓扑对比
六、画布上的可视化:改什么,看到什么
这套链路不是代码,是画布上的一张图。
!画布全貌:节点按职责分列排布
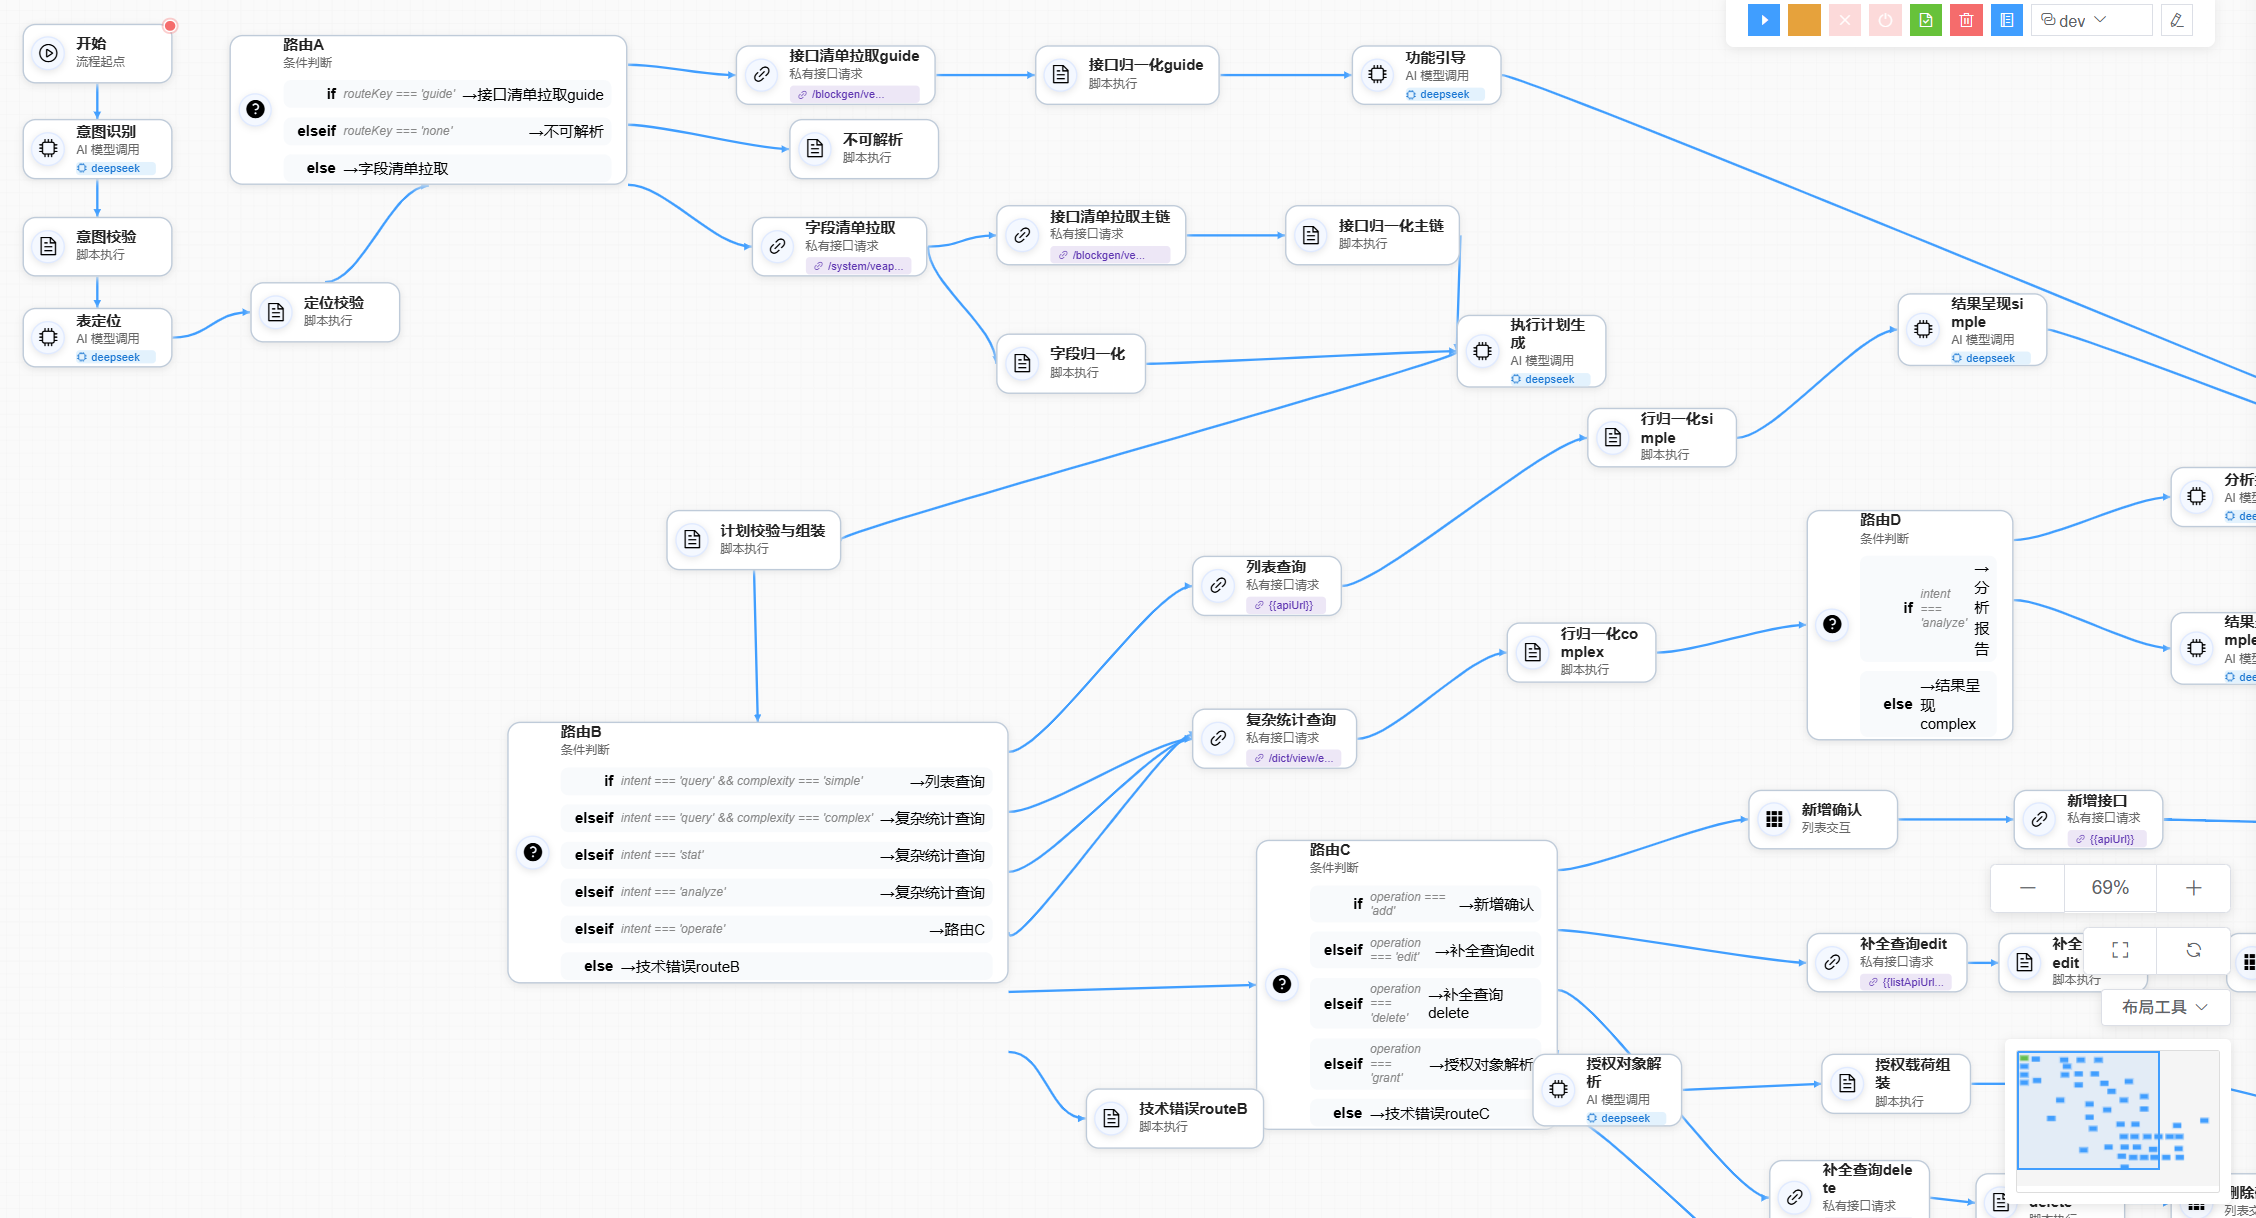
打开流程定义页,节点按类别排在画布上,连线标着分支索引。点击任意节点,右侧面板展开它的配置------大模型节点是模型与提示词,脚本节点是语言与代码,接口节点是地址与请求体。
左侧的节点面板是本流程能用的类型集合(19 类,未注册的类型不会出现在这里):
!节点面板:19 类节点
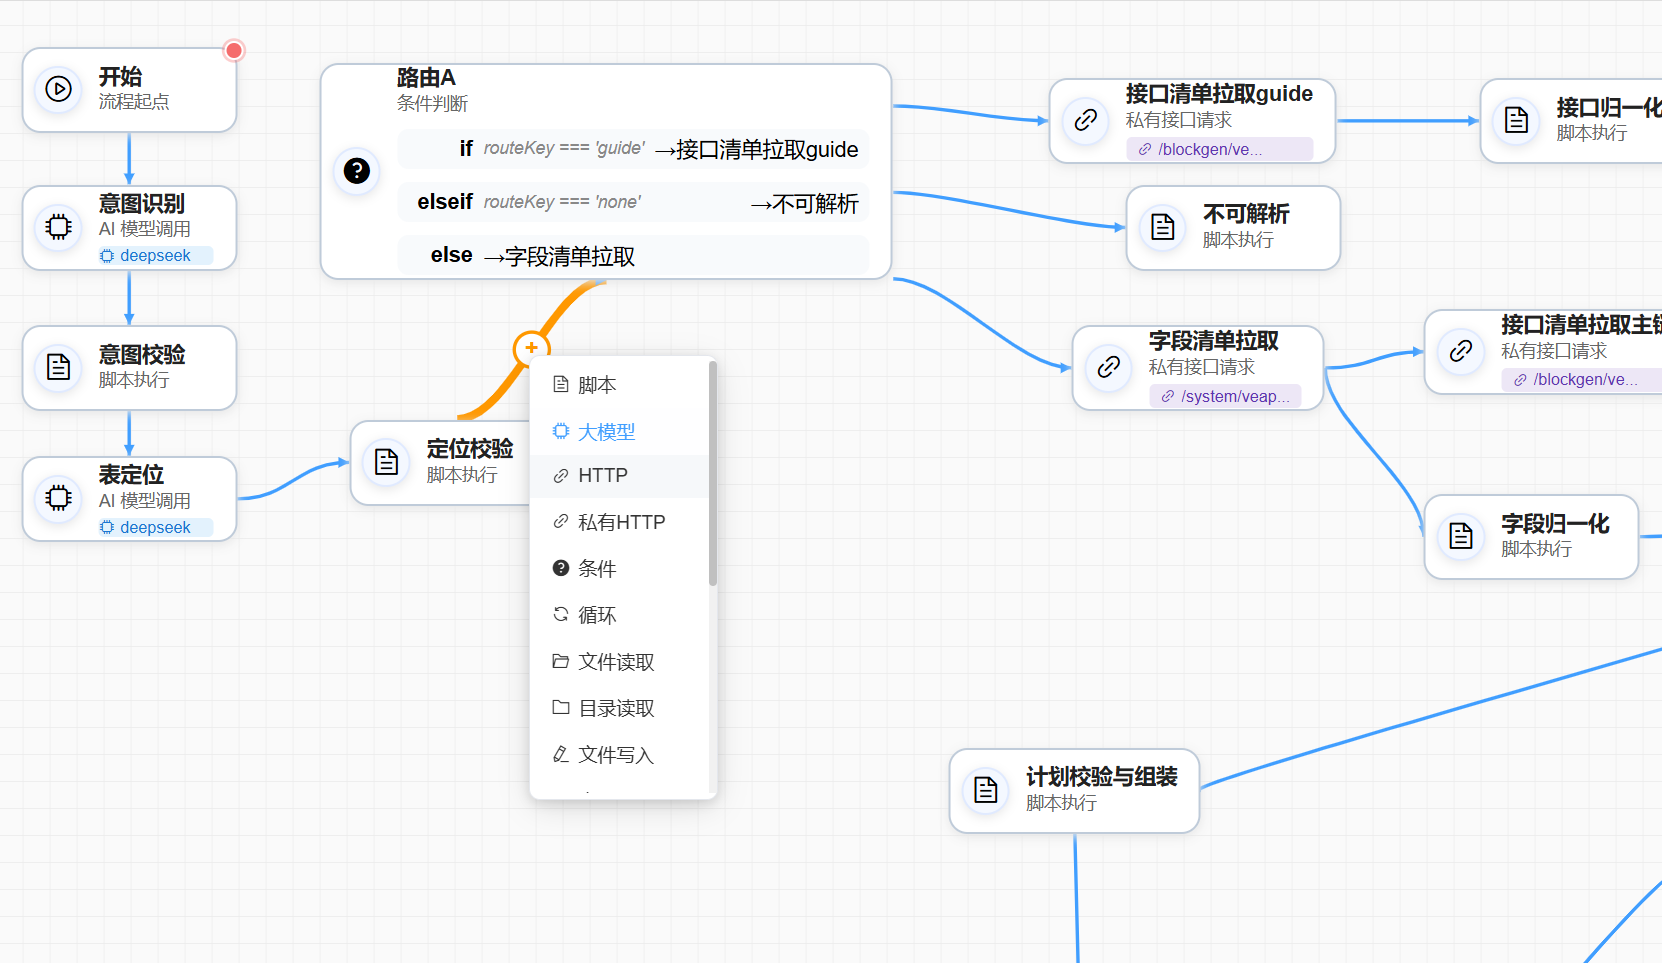
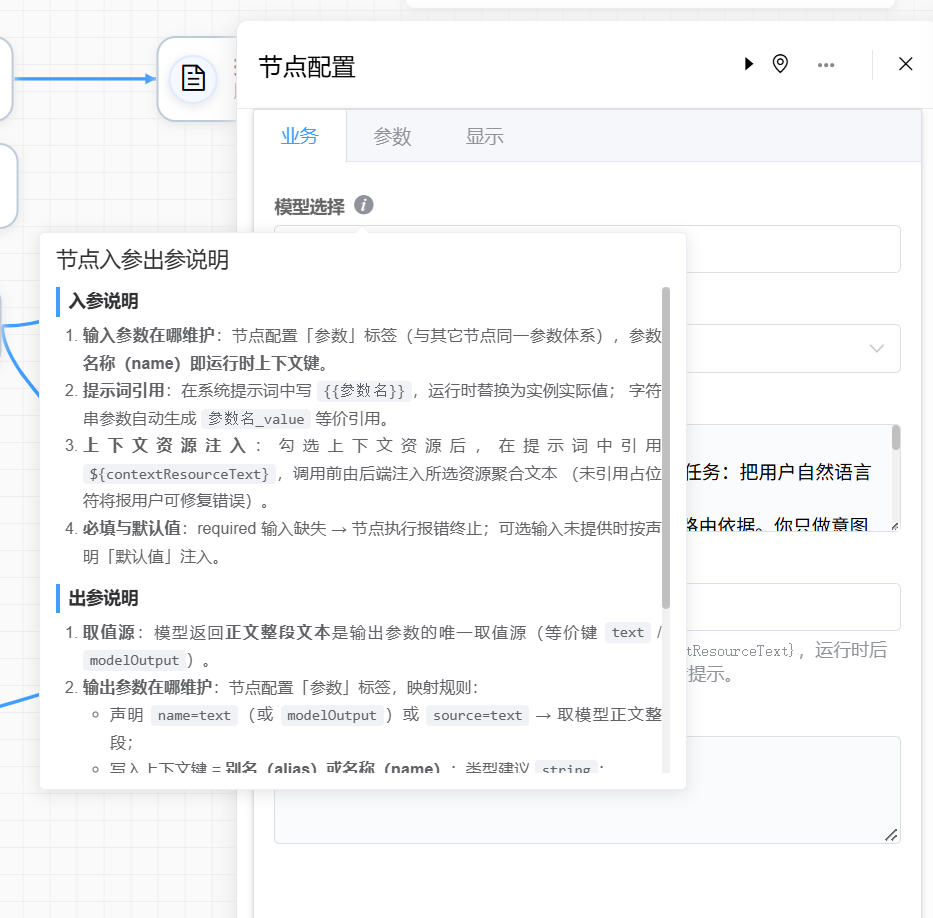
节点面板上有个细节我们花了心思:每个面板第一个标题右侧都有一个信息提示符,点开是三节内容------入参说明、出参说明、补充说明。这套说明不是随手写的,它有统一契约:文案集中在十个模块里,每个模块对应一个面板组件,改文案改的是模块而不是各处粘贴。比如脚本节点的说明里会单独列一节脚本 API。
!节点入参 / 出参说明:面板首标题右侧的提示符
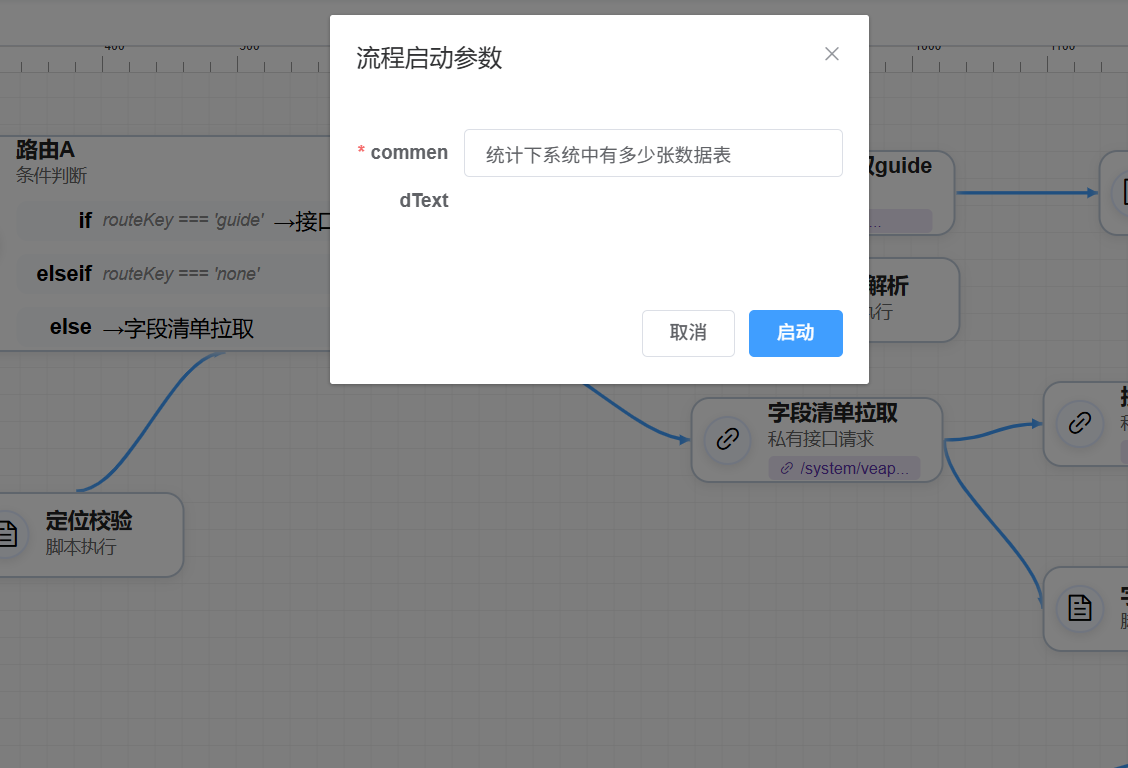
启动参数是另一个配置面。开始节点上声明的输入项,运行时以表单形式呈现;结构化的值(数组、对象)有统一的编辑器,必填与空值的判定也收敛到同一个实现里,避免出现「这里认为空字符串是没填,那里认为空数组是没填」这种分歧。
!启动参数录入:开始节点声明的输入项在运行时呈现为表单
流程本身的使用次数控制也在配置里:`allow_edit` 为 0 表示不允许编辑,此时 `max_usage` 必须大于 0;创建实例时如果已用次数达到上限,直接拒绝并给出可读提示,同时在使用次数上做事务递增。
写操作的四条子链在画布上是四段长得差不多的结构:补全查询、行归一化、确认弹窗、写载荷组装、写接口、结果消息。它们的共同点很关键------**确认弹窗之前不会有任何写操作**。
七、几条踩过的坑
前面零散提了几个,这里集中说四个,都是真实发生过的。
**并行段的固定键覆盖。** 字段清单和接口清单并行执行时,两个节点都把输出写进引擎的固定键 `data`,后完成的把先完成的覆盖了。表现是计划校验报「执行计划引用未知字段:status」------根因和字段毫无关系。修法是把两个节点的输出声明改成专属键 `fieldMetasData` 和 `apiMetasData`,脚本按专属键读,禁止读 `data`。
**模型输出的类型契约。** 有一版所有查询命令都在第一个节点就失败,报「意图识别输出非字符串文本」。原因是节点的输出声明里取值的键配错了,正文落成了空串。这类问题排查起来很绕,因为提示词、模型、脚本看起来都没问题。我们把结论写进契约:大模型节点的正文输出要保持字符串契约,取值键固定。
**请求体的两个键。** 接口节点最早只有「说明快照」和「请求体」两个配置,结果两件事同时出问题:一是请求体发出去是表单编码,打到要求 JSON 的接口上报 415;二是接口声明的查询参数从未真正发送,导致必填参数校验失败。后来补了两个稳定配置键:一个控制请求体类型,一个承载查询参数。
**分支索引漂移。** 分支与连线是按索引对齐的,画布上拖动连线时如果索引对不上,命令会走到错误的分支上。这类错误不会报错,只会「结果不对」,排查成本很高,所以它成了画布校验的必查项。
四个坑看着杂,共同的教训只有一句:**编排层的错误往往不报在出错的地方**。这也是为什么我们把并行段输出键、节点输出类型、请求体类型都写进了契约,而不是留在某个人的经验里。
八、动手看一遍
在仓库里可以这样对照着看:
-
画布定义:流程保存后落在 `ai_agent_process.definition_json` 字段里,49 个节点与 58 条连线都在里面,导入后可在画布上直接打开;
-
节点与状态集合:`veap-ui/src/components/AiAgentEngine/nodeRegistry.js` 是 19 类节点的注册点,`runtimeStatus.js` 是运行与节点状态的唯一来源;
-
调度与写回:`veap-ui/src/components/AiAgentEngine/scheduler.js` 负责每轮派发,`nodeExecutor.js` 负责单节点执行与终态写回;
-
编排器与画布交互:`veap-ui/src/views/ai/agentDesign/`;
-
数据落库:`veap-cloud/DB/veap.sql` 里 `ai_agent_` 开头的表族(流程、实例、节点实例、会话变量、审计日志、测试案例)。
运行界面在 `veap-ui`。
想看效果,最快的路径是在画布上把这张图导入,用「运行」跑一条 `查询状态为启用的用户`,然后在运行时间线上看节点一个个亮起来。中间产物(意图 JSON、定位结果、执行计划、查询结果)都能在参数面板里展开看------这是我们把它们做成可观测的原因,出了偏差能立刻定位到是哪一段。
下一层要解决的是另一个问题:模型知道该查哪张表之后,怎么知道某个字段能不能这么用。这块内容我单独写一篇,因为它的坑比想象中多。