第06篇:扩展不是堆机器------基于 A2A 协议的 openJiuwen 异构 Agent 通信架构设计
当你把一个 3 人的 Agent 团队扩展到 10 人,最先遇到的不是"人不够",而是"找不到人"。
Leader 找不到新加入的 Teammate,消息发出去石沉大海;更麻烦的是,隔壁部门用 LangChain 搭的 Agent 想和你的 openJiuwen 团队协作,连"握手"都做不到------不同框架的消息格式不兼容、服务发现机制各异、安全模型不统一。
加机器解决不了异构通信的问题。你需要的是一套协议,让不同框架、不同语言的 Agent 能像"同一个团队"一样协作。
本文基于 JiuwenSwarm 的真实架构,帮你建立一套完整的异构 Agent 通信方案:为什么 ACP 不够用了、A2A 协议怎么工作、openJiuwen 如何实现 A2A、A2X 注册中心怎么发现节点、异构 Agent 怎么接入、通信边界怎么设计、权限怎么隔离。全文提供协议对比、架构图解、配置模板和实操演示,不臆造。
验证环境与范围声明
对应仓库与版本 :源码来自jiuwenswarm 仓库,
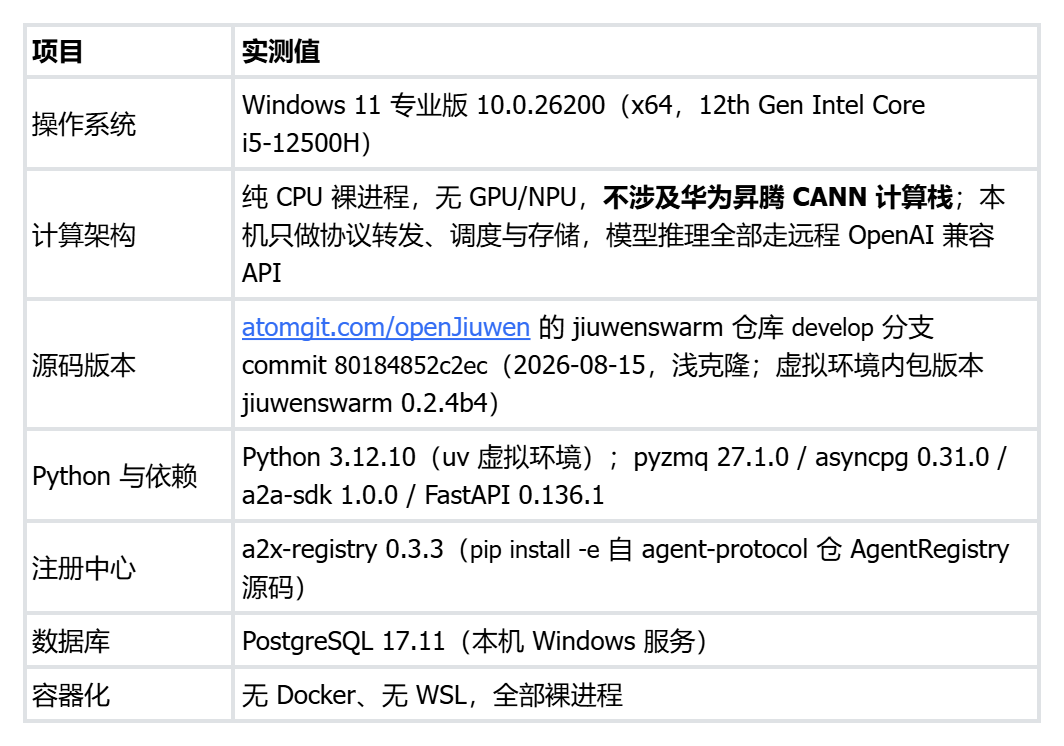
develop分支、commit80184852c2ec(2026-08-15,浅克隆,虚拟环境内包版本 jiuwenswarm 0.2.4b4);A2X 注册中心为 agent-protocol 仓库 AgentRegistry 的可编辑安装(a2x-registry 0.3.3)。文中源码摘录与第九节实操均基于该版本。运行环境(与华为昇腾 CANN 无关) :Windows 11 专业版(10.0.26200,x64,12th Gen i5-12500H)纯 CPU 裸进程运行,Python 3.12.10,无 Docker/WSL/GPU/NPU,不涉及 CANN 或任何异构计算加速栈------本机进程只承担协议转发、任务调度与存储,全部模型推理走远程 OpenAI 兼容 API(实测时为智谱 glm-4.5-flash)。
验证范围 :第九节实操为单机双节点 (Leader 与 Teammate 是同一台机器上的两个进程,靠双数据目录隔离),只验证协议链路闭环,不等同于真实跨框架、跨主机或生产级验证。具体依据与边界见第九节开头的"验证范围声明"。
一、从"加机器"到"加协议"------异构通信才是真瓶颈
1.1 V2 扩展到 V3 的痛点
回顾一下前五篇的演进路线:
-
V1:单 Agent,串行处理
-
V2:Leader + 2 Teammate,团队协作
-
V3:分布式多技能团队,7×24 多用户并发
V2 到 V3 的升级,不是简单地把 Teammate 从 2 个变成 10 个。为什么?我们把三个实际遇到的问题逐一拆开,看它们的根因是什么,就知道加机器为什么无效了。
痛点一:Leader 找不到新 Teammate。
-
症状:单机模式下一切正常,Teammate 挪到另一台机器后,Leader 发出的消息石沉大海。
-
根因:单机模式的通信依赖一个隐含假设------"对方和我在同一进程内,函数调用即可达"。跨机器后这个假设破产,本质是寻址问题:调用方没有任何机制获知被调用方的地址。
-
为什么加机器无效:机器越多,需要维护的"IP-角色"映射越多,而且云环境下节点地址是动态的,静态配置的维护成本随规模线性增长,很快失控。
痛点二:消息丢失和状态不一致。
-
症状:Leader 以为 Teammate 在干活,实际上消息早就丢了;两边各自记录的任务状态对不上。
-
根因:进程内函数调用是"要么成功要么抛异常"的同步语义,而网络通信是"发出去 ≠ 收到"的异步语义。从同步语义迁移到异步语义,却没有补上确认、重试、幂等这些分布式基础保障------这不是传输层的 bug,是语义层的缺口。
-
为什么加机器无效:机器越多,网络分区、进程重启、消息乱序的概率越高,缺口的暴露频率反而更高。
痛点三:异构 Agent 无法通信。
-
症状:隔壁组用 LangChain 搭的 Agent 想加入协作,连第一步握手都做不到。
-
根因:每个框架都有自己的消息结构、发现机制和认证体系------它们是"方言",不是"语言"。方言之间两两互译需要 N×(N-1) 个适配器,复杂度是平方级的。
-
为什么加机器无效:这不是资源问题,是协议问题。加一百台机器,方言还是方言。
把三个根因排列出来,解法就自然浮现了:
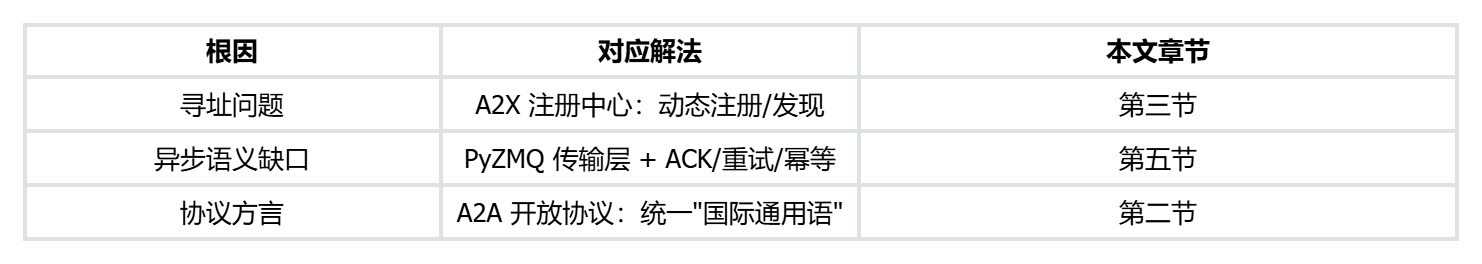
注意这个顺序是有因果的:先解决"找得到、送得到"(前两个问题),才有资格谈"听得懂"(第三个问题)。反过来做------先上协议再补可靠性------只会让排查问题变成灾难,因为你分不清一条消息没响应到底是丢了还是没听懂。
1.2 ACP 为什么不够用
ACP(Agent Communication Protocol)是早期 openJiuwen 采用的框架内通信方案,它解决了同一框架内 Agent 间的标准化通信:
Plain
agent_communication_protocol:
  message_format: "JSON 结构化消息"
  transport: "WebSocket/HTTP/消息队列"
  features:
    - 服务发现: "框架内注册中心"
    - 消息路由: "按角色/标签转发"
    - 可靠投递: "ACK + 重试 + 幂等"
但在异构场景下,ACP 暴露了三个核心局限:
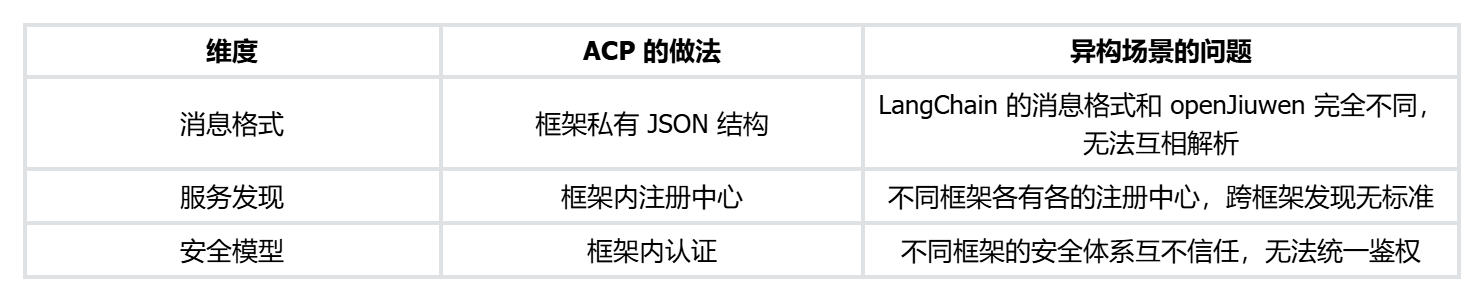
这三个局限值得多想一层:它们是偶发的实现不足,还是结构性的?答案是结构性------每个框架的消息格式都为自家语义优化(openJiuwen 有 Artifact/Part 的概念,LangChain 有 message 类型体系),不可能为了别人改自己的内部结构;注册中心和认证体系更是框架的"主权领地"。所以 ACP 无法通过"打补丁"变成异构协议,补丁的前提是双方愿意共享一套规范,而框架间恰恰没有这套规范。
这就是引入 A2A 的真正原因:不是 ACP 不好,而是 ACP 的作用域到框架边界为止。跨边界,需要一个所有框架都认的中立标准。
1.3 A2A 协议:Agent 的"TCP"
A2A(Agent-to-Agent)协议是 Google 于 2025 年 4 月提出的开放标准,专为跨框架 Agent 互联互通设计。它的目标很明确:让不同供应商、不同框架构建的 Agent 能够无缝通信、安全交换信息并协同执行任务。
就像 TCP 协议让不同操作系统的计算机能互联互通一样,A2A 协议让不同框架的 Agent 能"说同一种语言"。
A2A vs ACP 对比 :
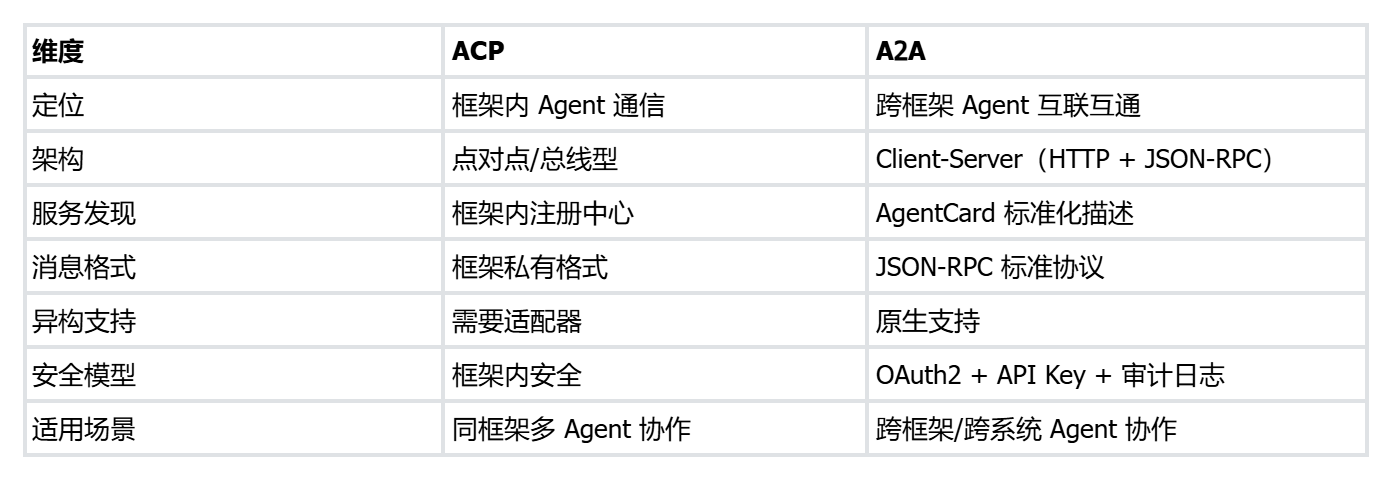
核心结论:ACP 和 A2A 不是替代关系,而是互补。ACP 解决"团队内部怎么说话",A2A 解决"不同团队之间怎么对话"。JiuwenSwarm 同时支持两者------框架内用 PyZMQ + ACP 通信,跨框架用 A2A 互联互通。
这里有一个值得推敲的设计问题:为什么框架内不用 A2A,偏偏要保留 PyZMQ?统一成一个协议不是更简单吗?
这个问题的答案在于两种通信的需求差异。框架内的 Leader-Teammate 通信是高频、常连接、双方可信 的------一个团队每秒可能互发上百条消息,PyZMQ 的 TCP 长连接免去了 HTTP 每次请求的握手开销,延迟低一个量级。而跨框架通信是低频、短交互、双方不可信的------外部 Agent 调用一次可能就是一次任务委派,用 HTTP + JSON-RPC 反而合适:无状态、能穿过企业防火墙和代理、天然配合 HTTPS 做加密和鉴权、SSE 支持流式。如果框架内也走 HTTP,每条消息都付一次连接和序列化的税;如果跨框架也走裸 TCP,对方公司的安全团队第一个不答应。
所以"两套协议并存"不是历史包袱,而是按信任边界和通信频率分层的主动设计------内网快车道走 PyZMQ,对外海关走 A2A。
Plain
框架 A(openJiuwen)                      框架 B(LangChain)
┌──────────────────────┐                ┌──────────────────────┐
│ Leader ⇄ Teammate    │                │ Agent ⇄ 私有消息格式  │
│  (ACP:框架内普通话) │                │ (各自的方言)        │
└──────────┬───────────┘                └──────────┬───────────┘
           │                                       │
           └──────────────┐        ┌───────────────┘
                          ▼        ▼
                   ┌─────────────────────┐
                   │  A2A:国际通用语     │
                   │  HTTP + JSON-RPC    │
                   │  AgentCard 标准发现  │
                   └─────────────────────┘
二、A2A 协议核心架构------openJiuwen 的完整实现
2.1 五大核心组件
openJiuwen 对 A2A 协议的实现包含五大核心组件,各自职责清晰:
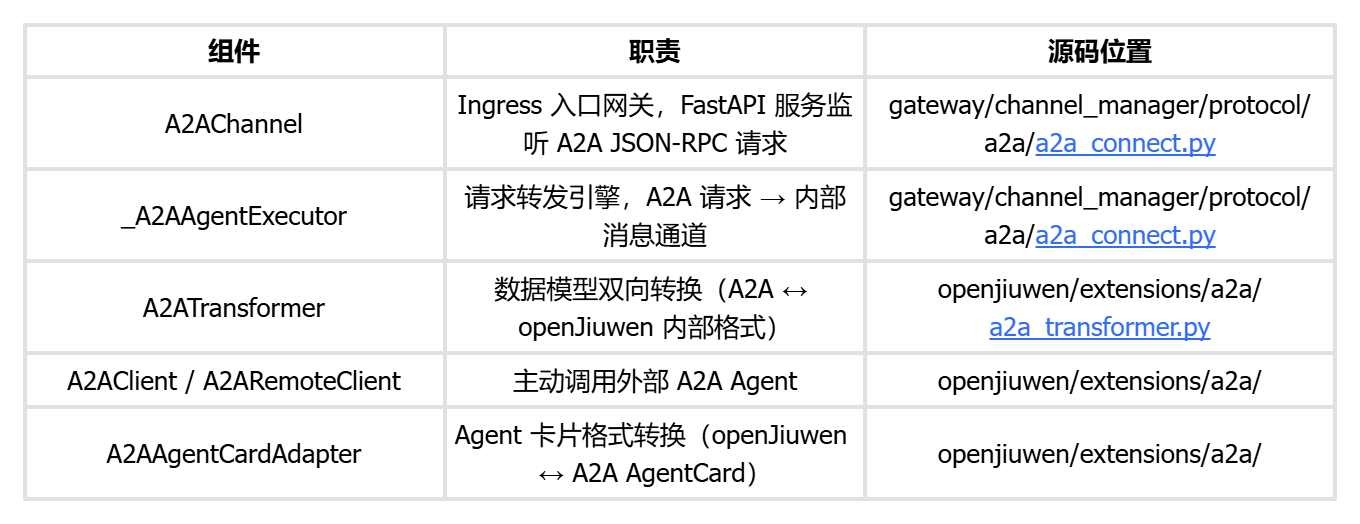
这五个组件的协作关系构成了 A2A 的完整数据流:
Plain
外部 A2A Client
    │
    ▼
┌──────────────────┐
│   A2AChannel     │  ← Ingress 网关,监听 JSON-RPC
│   (FastAPI)      │
└────────┬─────────┘
         │
         ▼
┌──────────────────┐
│ A2AAgentExecutor │  ← 请求转发,提取 query 和 files
└────────┬─────────┘
         │
         ▼
┌──────────────────┐
│ A2ATransformer   │  ← A2A 格式 → openJiuwen 内部格式
│ (to_internal)    │
└────────┬─────────┘
         │
         ▼
┌──────────────────┐
│  内部消息通道     │  → JiuwenSwarm Agent 执行
│  (dispatch)      │
└────────┬─────────┘
         │
         ▼
┌──────────────────┐
│ A2ATransformer   │  ← openJiuwen 内部格式 → A2A 格式
│ (to_a2a)         │
└────────┬─────────┘
         │
         ▼
外部 A2A Client(收到 TaskArtifactUpdateEvent)
2.2 A2A Channel:Ingress 入口网关
A2AChannel 是 JiuwenSwarm 对外暴露的 A2A 入口。它启动一个独立的 FastAPI 服务,监听 A2A 协议的 JSON-RPC 请求。
先看核心实现:
Python
class A2AChannel(BaseChannel):
    name = "a2a"

    async def start(self):
        agent_card = AgentCard(
            name=self.config.app_name,
            capabilities=AgentCapabilities(streaming=True),
            supported_interfaces=[
                AgentInterface(
                    url=f"http://{host}:{port}/a2a",
                    protocol_binding="jsonrpc"
                )
            ],
            skills=[
                AgentSkill(
                    id="chat",
                    name="chat",
                    description="Send user prompt to JiuwenSwarm via Gateway"
                )
            ]
        )
        app_builder = A2AFastAPIApplication(
            agent_card=agent_card,
            http_handler=request_handler
        )
        fastapi_app = app_builder.build()
注意几个关键设计,以及它们背后的"为什么":
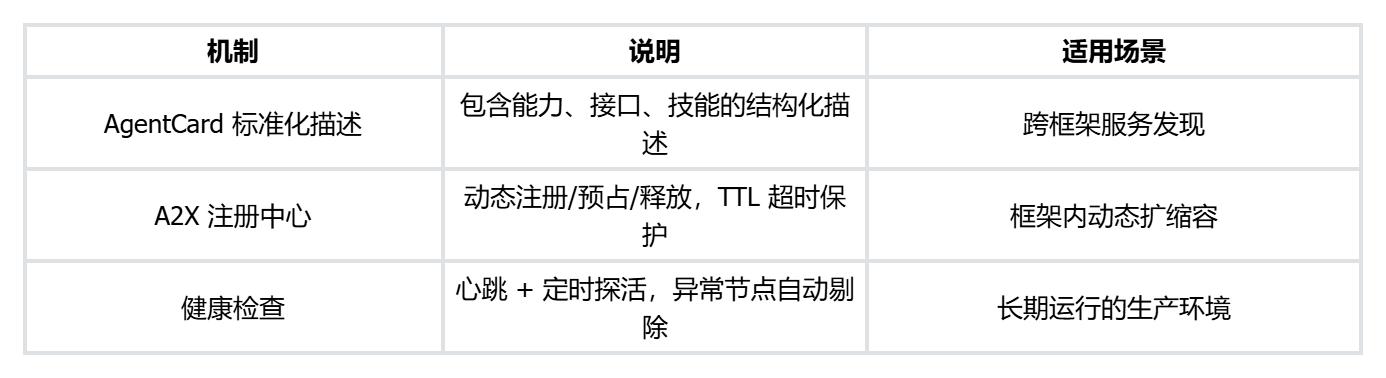
AgentCard 是 A2A 协议的核心抽象。它告诉外部世界:"这个 Agent 叫什么、能做什么、通过什么接口访问"。外部 Agent 看到 AgentCard 就知道该怎么和你通信------不需要提前约定,不需要适配器。为什么把它设计成机器可读的标准格式而不是一份文档?因为文档是给人看的,Agent 没法读文档。能力描述本身必须是协议的一部分,"发现"才能自动化:客户端拉取 AgentCard → 解析出 skills 和接口 → 决定是否调用、怎么调用,全程无人工介入。这也是它和"框架内注册中心"的本质区别------注册中心解决"地址在哪",AgentCard 还解决"会干什么"。
streaming=True 表示支持流式响应。A2A 协议原生支持长任务的流式输出,这对 Agent 场景很重要------一个调研任务可能要跑 10 分钟,外部 Agent 不想干等着。注意这是一个能力声明 而不只是配置项:客户端会先读 AgentCard 判断你支不支持流式,再决定用流式方法(A2A 1.0 里是 SendStreamingMessage,走 SSE)还是退化为同步的 SendMessage 等待。能力协商前置,避免了"调用了才发现对方不支持"的运行时失败。
protocol_binding="jsonrpc" 明确了通信协议。A2A 协议基于 HTTP + JSON-RPC,这是 Web 原生设计,跨平台兼容性极强------任何语言、任何框架,只要有 HTTP 客户端就能接入,这正是"国际通用语"的落地方式。
再回答一个整体架构问题:为什么 A2A 网关要做成独立的 FastAPI 服务,而不是挂在主进程的一个路由上? 因为外部流量和内部流量的故障域不同------外部请求可能携带恶意负载、突发流量、超长任务。网关独立部署后,即使 A2A 接口被打挂,框架内 Leader-Teammate 的 PyZMQ 通信完全不受影响。隔离,是网关存在的第一理由。
2.3 请求转发的核心机制
外部 A2A 客户端发送的请求会经过 _A2AAgentExecutor 转发到 JiuwenSwarm 的内部消息通道。核心逻辑分三步:
Python
class _A2AAgentExecutor:
    async def execute(self, context, event_queue):
        # 1. 从 A2A context 中提取 query 和 files
        query, files = self._channel.map_a2a_parts_to_params(context.message)

        # 2. 分发到内部消息通道
        pending = await self._channel.dispatch_a2a_request(
            request_id=request_id,
            session_id=context_id,
            query=query,
            files=files
        )

        # 3. 将内部响应转换为 A2A Artifact 事件
        while True:
            response_msg = await pending.queue.get()
            response_parts = self._channel.message_to_a2a_parts(response_msg)
            await event_queue.enqueue_event(TaskArtifactUpdateEvent(...))
            if is_terminal:
                break
第一步 :提取。A2A 消息可能包含文本、文件、图片等多种 Part,map_a2a_parts_to_params 将它们统一映射为 openJiuwen 内部的 query + files 格式。
第二步 :分发。dispatch_a2a_request 将 A2A 请求转换为内部 Message 对象,通过 on_message 回调注入消息路由。这里有一个容易被忽略但非常关键的取舍:A2A 请求不走直通内部的"特殊通道",而是汇入统一消息路由。为什么?想象反面做法------为外部请求开一条直达 Agent 的快速路径,短期省事,但意味着权限校验、审计日志、session 隔离要在两条路径上各实现一遍,迟早不一致。统一入口意味着所有请求无论来自哪个协议,过的是同一道安检、走的是同一条路由,安全策略只维护一份。
第三步 :回传。内部 Agent 的响应通过 asyncio.Queue 异步返回给执行器,再转换为 A2A 的 TaskArtifactUpdateEvent 事件。流式输出也是在这个环节处理的------每收到一个 chunk 就推送一个事件,直到 is_terminal 标记结束。为什么中间要垫一个队列,而不是让 Agent 直接回调网关?因为协议层(A2A 事件)和执行层(Agent 运行时)的速率天然不匹配------Agent 可能一口气产出大量 chunk,而 SSE 推送受网络状况制约。队列解耦了两侧的速率,也天然起到了缓冲背压的作用。
2.4 数据模型转换:A2ATransformer
A2A 协议有自己的数据模型(AgentCard、Part、Task、Artifact 等),和 openJiuwen 内部的数据模型(AgentResult、Artifact、Part)不同。A2ATransformer 负责两者之间的双向转换:
Python
class A2ATransformer:
    @classmethod
    def to_a2a_request(cls, request):
        # 内部 dict → A2A SendMessageRequest

    @classmethod
    def from_a2a_response(cls, response):
        # A2A StreamResponse → 内部 AgentResult
A2AAgentCardAdapter 则负责 Agent 卡片的转换:
class A2AAgentCardAdapter:
    @classmethod
    def to_a2a_agent_card(cls, agent_card, *, interface_url, protocol_binding):
        return A2AAgentCard(
            name=agent_card.name,
            description=description,
            capabilities=AgentCapabilities(streaming=True),
            supported_interfaces=[
                AgentInterface(
                    url=interface_url,
                    protocol_binding=protocol_binding
                )
            ]
        )
这个转换层的设计原则是"最小转换"------只转换协议层必须的字段,业务数据保持原样透传。
"最小转换"具体指什么?看 A2ATransformer 实际动的东西:消息的信封 (格式、元数据、卡片结构)它转,消息的内容(query 文本、文件、分析结果)它不碰。这样设计有两个直接收益:其一,转换是 O(1) 的字段映射而不是 O(n) 的内容重编码,大文件透传时没有额外开销;其二,转换层出 bug 的爆炸半径被限定在协议层------最坏情况是信封错位、对方解析失败,业务数据本身永远不会因为转换而损坏。
更深一层看,转换层的厚度决定了协议演进的成本。A2A 是一个还在快速迭代的标准(Google 2025 年 4 月发布,字段和传输绑定一直在调整),一旦 A2A 升级------比如 AgentCard 结构变化------只要改动收敛在 Transformer 和 CardAdapter 两个文件里,网关、执行器、内部 Agent 全都不用动。这是"隔离变化点"原则的直接应用:把最可能变的东西(外部协议)和最不该变的东西(内部语义模型)之间垫一层薄膜,变化就被封在薄膜外侧。
2.5 A2A Client:主动调用外部 Agent
除了作为服务端接收请求,JiuwenSwarm 还通过 A2AClient 和 A2ARemoteClient 主动调用外部 A2A Agent:
Python
class A2ARemoteClient(RemoteClient):
    async def invoke(self, inputs, timeout=None):
        invoke_coro = self.client.invoke(inputs=inputs)
        if timeout:
            return await asyncio.wait_for(invoke_coro, timeout=timeout)
        return await invoke_coro

    async def stream(self, inputs, timeout=None):
        async for chunk in self.client.stream(inputs=inputs):
            yield chunk
A2ARemoteClient 实现了 RemoteClient 接口,可以像调用本地 Agent 一样调用远程 A2A Agent。支持两种模式:
-
同步调用(invoke):发送请求,等待完整响应。带超时保护。
-
流式调用(stream):发送请求,逐 chunk 接收流式响应。
注意一个细节:上面的实现里,超时保护只包裹了 invoke,stream 分支没有 做超时包裹。流式调用的超时需要在消费侧自行处理------例如用 asyncio.timeout() 包裹整个消费循环,或为"两个 chunk 之间的最大间隔"设置空闲超时(idle timeout),否则外部 Agent 假死时,你的消费循环会一直挂着(避坑指南 8.5 会给出示例)。
对 Leader 来说,调用一个远程 A2A Agent 和调用本地 Teammate 没有本质区别------只是底层的传输方式不同。这个抽象让跨框架协作变得透明。
三、A2X 注册中心------异构 Agent 的动态发现
3.1 为什么需要注册中心
在分布式模式下,Leader 不可能知道每个 Teammate 的 IP 地址------尤其是在云环境中,节点可能随时扩缩容。更不用说异构 Agent 了------LangChain 的 Agent 可能跑在端口 8000,自研框架的 Agent 可能跑在端口 9000。
A2X 注册中心就是解决这个问题的"电话簿"。它的核心职责是让异构 Agent 能动态发现彼此,而不需要硬编码地址。
先想清楚候选方案再往下看。服务发现是个老问题,成熟方案不少:DNS、Nginx/Consul 这类配置中心、etcd/ZooKeeper 这类一致性存储。为什么还要做一个 A2X?因为通用服务发现只知道"地址",不知道"语义" 。DNS 能告诉你 writer-node 在哪个 IP,但回答不了三个 Agent 场景特有问题:这个节点当前归属哪个团队 (隔离)?它处于什么状态 (空白待命还是已就位)?它能不能被独占式预占(防止两个 Leader 抢同一个人)?A2X 的设计就是围绕这三个语义能力展开的------地址管理只是顺带的。
3.2 两种角色模型
A2X 注册中心定义了两种角色:
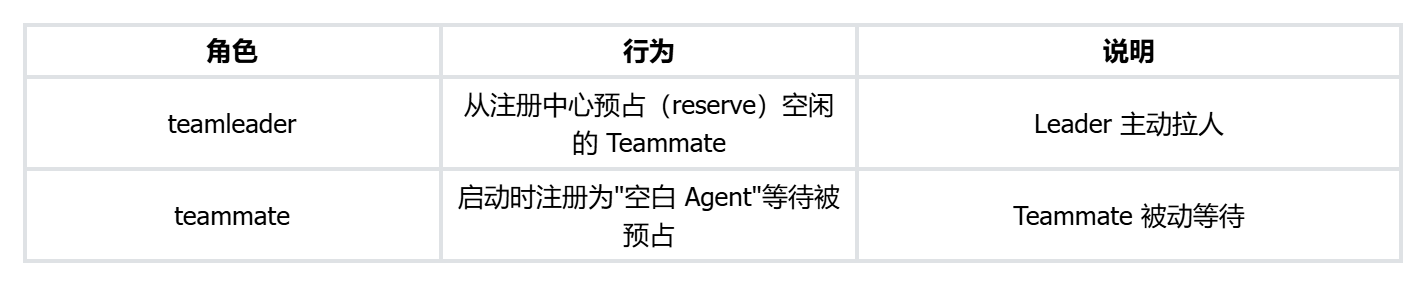
配置方式:
YAML
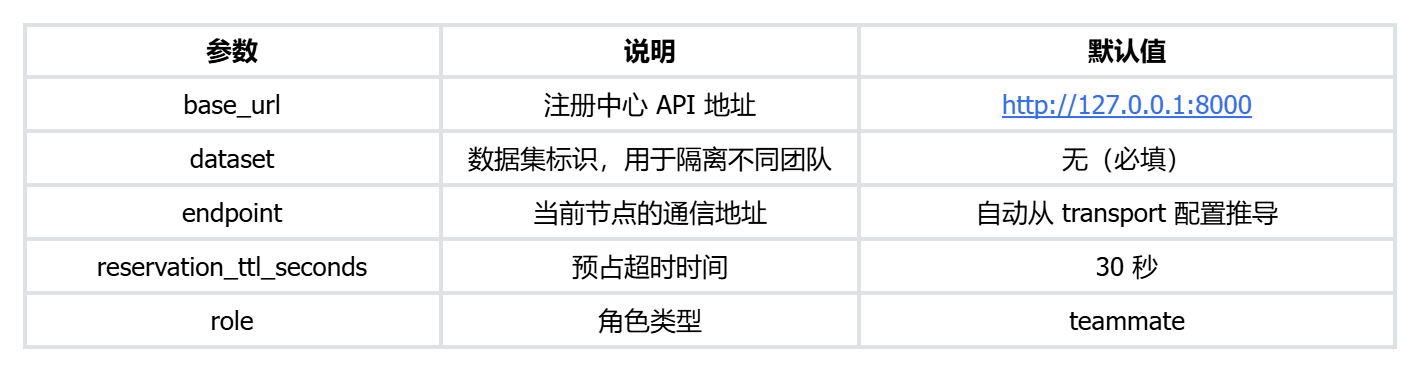
react:
  a2x_registry:
    base_url: "http://127.0.0.1:8000"    # 注册中心 API 地址
    dataset: "my_team_dataset"             # 数据集标识,隔离不同团队
    role: "teammate"                       # 或 "teamleader"
    endpoint: "tcp://127.0.0.1:18600"     # 当前节点的通信地址
    reservation_ttl_seconds: 30            # 预占超时时间
关键参数说明:
3.3 空白 Agent 的注册流程
Teammate 进程启动时,如果检测到自身是分布式模式下的 teammate 角色,会自动向注册中心注册一个"空白 Agent"。
"空白 Agent"是这个设计里最反直觉、也最值得琢磨的一步。常规思路是:每个 Teammate 启动时带上自己的完整身份("我是 researcher,我会做调研")去注册。openJiuwen 偏不------节点注册时不带身份,只声明"我是一个可用的执行单元",身份由 Leader 在 Bootstrap 阶段分配。
为什么倒过来做?因为两种思路背后对"节点是什么"的假设不同。带身份注册假设"节点和角色绑定"------researcher 永远是 researcher;但生产环境的真实情况是,节点是可 fungible 的算力,今天是 researcher 明天可能被派去当 writer。如果身份焊死在节点上,团队拓扑就僵化了:想要 3 个 writer,就得专门起 3 个"writer 节点"。空白注册 + Bootstrap 分配身份,让"有多少算力"和"团队长什么样"彻底解耦------资源池按需取用,角色即插即赋。代价是引入了 Bootstrap 这个额外步骤,但这个代价换来的弹性,在扩缩容场景下是必需品。
Python
async def register_blank_agent_if_teammate(client, config, *, source):
    if not config.get("distributed_mode"):
        return False
    if config.get("role") != "teammate":
        return False

    dataset = config.get("dataset")
    endpoint = config.get("endpoint")
    if not dataset or not endpoint:
        return False

    result = await client.register_blank_agent(
        dataset=dataset,
        endpoint=endpoint
    )
    return True
空白 Agent 的卡片是一个标准化模板:
_TEAMMATE_CARD_DESCRIPTION = "Task Planner(team-1)"
_TEAMMATE_CARD_STATUS = "busy"
_TEAMMATE_CARD_SKILLS = [{"name": "plan", "description": "子任务拆解"}]
关于这个卡片,有两个容易误读的地方需要说清楚:
第一,status 为什么是 busy 而不是 idle? 因为"空白 Agent"还没有完成 Bootstrap,不具备真实能力------把状态标成 busy,可以防止它在完成初始化之前被当作"有真实技能的节点"对外暴露。"能不能被预占"由注册中心的预占状态决定,而不是卡片上的 status 字段。真正判断一个 Teammate 可用,依据是"预占成功 + Bootstrap ACK 收到",这两件事缺一不可。
第二,卡片上的技能是占位符。 "Task Planner / plan" 并不代表这个节点真的会做任务拆解,它的真实角色要等 Leader 下发 Bootstrap 后、卡片被替换(见 3.5 节)才生效。
另外注意,代码里读取的 distributed_mode、role、dataset、endpoint 等键,来自运行时展开后的配置视图 ------它们由 YAML 中的 team.runtime.mode、react.a2x_registry 等段落展开合并而来,并非直接照抄 YAML 的原始层级。
3.4 Leader 预占机制
Leader 端的流程通过 reserve_blank_teammate_agent() 实现:
Python
async def reserve_blank_teammate_agent(config_base, *, source="leader-bootstrap"):
    client, config = await init_a2x_client(config_base)
    if not config.get("distributed_mode") or config.get("role") != "teamleader":
        return None

    reservation = await client.reserve_blank_agents(
        dataset=dataset,
        n=1,
        ttl_seconds=int(config.get("reservation_ttl_seconds") or 30),
    )
    for agent in reservation.agents:
        service_id = _agent_service_id(agent)
        endpoint = _agent_endpoint(agent)
        if service_id and endpoint:
            return ReservedBlankAgent(
                client=client,
                reservation=reservation,
                dataset=dataset,
                service_id=service_id,
                endpoint=endpoint,
)预占超时(TTL 默认 30 秒)是个关键设计。如果在 TTL 内 Leader 没有完成 Bootstrap 握手,预占会自动释放,该 Teammate 回到可用池。这避免了"占着茅坑不拉屎"的问题。
值得展开说说 TTL 的本质:它是一个租约(lease) 。分布式场景下"预占"最大的敌人不是竞争,而是僵尸持有 ------Leader 预占成功后崩溃了,谁来释放?如果依赖 Leader 优雅退出时发释放请求,崩溃路径就走不通,这个 Teammate 就永久性地从资源池里消失了。租约把问题反转:持有者必须持续续期才能保住预占,一旦持有者失联,租约到期自动回收,无需任何人介入清理。这和 etcd/ZooKeeper 的 session 机制是同一个思想,只是用 HTTP + TTL 参数以更轻的方式实现。30 秒默认值则是权衡的结果:太短,正常的 Bootstrap 握手可能被误判超时(跨机房网络慢、Teammate 冷启动加载模型都吃时间);太长,Leader 崩溃后资源回收的窗口期就长。
3.5 从空白到就绪------卡片替换
Teammate 收到 Bootstrap 消息后,会将自己的注册卡片从"空白"替换为实际的任务角色卡片:
Plain
async def replace_teammate_agent_card_after_bootstrap(
    client, *, dataset, service_id, member_name, source, ...
):
    agent_card = build_teammate_agent_card(member_name)
    await client.replace_agent_card(dataset, service_id, agent_card)
    return True
当团队销毁时,Teammate 的卡片会被还原回空白状态(restore_teammate_blank_agent_on_destroy),这样该节点可以被下一个团队复用------资源的生命周期和团队的生命周期绑定。
3.6 发现逻辑的完整流程
把注册中心的发现逻辑串起来,就是一条完整的数据流:
Plain
步骤 1: Teammate 启动
  → register_blank_agent_if_teammate() 注册空白卡片
  → 启动 Bootstrap Daemon 监听控制面消息

步骤 2: Leader 调用 spawn_member
  → reserve_blank_teammate_agent() 从注册中心预占一个空白 Agent
  → 获取 service_id + endpoint

步骤 3: Leader 发送 Bootstrap Envelope
  → 通过 PyZMQ Direct 或 DB 消息通道发送到 Teammate

步骤 4: Teammate 收到 Bootstrap
  → 替换注册卡片(空白 → 实际角色)
  → 采用分配的 member_name
  → 注册 Leader 路由
  → 发送 ACK 确认

步骤 5: Leader 收到 ACK
  → 更新成员状态 UNSTARTED → READY
  → 成员正式加入团队
Plain
Teammate                 A2X Registry                  Leader
    │  ①register_blank_agent  │                          │
    ├────────────────────────►│                          │
    │  (卡片: __BLANK__)       │   ②reserve(n=1, TTL=30s) │
    │                         │◄─────────────────────────┤
    │                         │   返回 service_id+endpoint│
    │                         ├─────────────────────────►│
    │   ③Bootstrap Envelope (PyZMQ Direct) ──────────────┤
    │◄───────────────────────────────────────────────────┤
    │  ④替换卡片: blank → 真实角色                         │
    │  ⑤ACK ────────────────────────────────────────────►│
    ├────────────────────────►│  ⑥replace_agent_card     │
    │                         │   成员状态: UNSTARTED → READY
四、异构 Agent 通信架构------让不同框架的 Agent 一起干活
4.1 三种异构接入方案
openJiuwen 支持三种异构 Agent 接入方式,覆盖主流场景:
方案一:openJiuwen Agent ------ 原生 A2A 支持
Plain
openjiuwen_agent:
  protocol: "a2a_native"
  transport: "PyZMQ + HTTP"
  discovery: "A2X Registry"
  features: ["全功能支持", "流式通信", "技能继承"]
方案二:第三方框架 Agent ------ 通过 A2A 适配器接入
JSON
langchain_agent:
  protocol: "a2a_adapter"
  transport: "HTTP + JSON-RPC"
  adapter: "LangChainA2ABridge"
  discovery: "A2A AgentCard"
  features: ["任务委派", "结果回传", "流式响应"]
方案三:自研框架 Agent ------ 通过 A2A Client 接入
JSON
custom_agent:
  protocol: "a2a_client"
  transport: "HTTP + JSON-RPC"
  client: "A2ARemoteClient"
  discovery: "A2A AgentCard + A2X"
  features: ["同步/流式调用", "超时保护", "自定义扩展"]
方案一(原生 A2A):适用于同属 openJiuwen 生态的 Agent。Leader 通过 A2X 注册中心预占 Teammate,通过 PyZMQ 直接通信,支持技能继承和完整的事件监控体系。
方案二(A2A 适配器):适用于主流第三方框架(如 LangChain、AutoGen)。第三方 Agent 不需要改造,只需部署一个 A2A 适配器(如 LangChainA2ABridge),将框架内部消息格式转换为 A2A 标准格式。
方案三(A2A Client):适用于自研框架。通过 A2ARemoteClient 主动调用,代码层面和调用本地 Agent 一样简单。
三个方案怎么选?判断依据其实是两个问题。第一,你能改动多少对方 Agent 的代码? 完全不能动(第三方黑盒)→ 只能方案二,在外面套适配器;能改(自研)→ 方案三,在自己代码里集成 A2A Client。第二,通信方向是什么? 你要调用对方 → 方案三;你要暴露能力给对方 → 让对方用方案二连你的 A2A 网关。方案一是"双方都是 openJiuwen"的特权路径,省掉了所有协议转换开销,但不要为了走特权路径强行绑定技术栈------选型的出发点永远是约束条件,不是能力上限。
4.2 数据模型转换机制
A2ATransformer 是异构通信的关键枢纽。它负责 A2A 协议数据模型和 openJiuwen 内部数据模型的双向转换:
Plain
a2a_transformer:
  to_a2a:
    - "内部 dict → A2A SendMessageRequest"
    - "AgentResult → A2A Artifact"
    - "openJiuwen AgentCard → A2A AgentCard"
  from_a2a:
    - "A2A StreamResponse → 内部 AgentResult"
    - "A2A Part → 内部 Part"
- "A2A AgentCard → openJiuwen AgentCard"设计原则:最小转换。只转换协议层必须的字段(如消息格式、AgentCard 结构),业务数据(如查询内容、分析结果)保持原样透传。这样即使 A2A 协议版本升级,转换层的改动也最小。
Plain
A2A 协议模型                     openJiuwen 内部模型
┌───────────────────────┐         ┌───────────────────────┐
│ SendMessageRequest    │ to_a2a  │ 内部 dict / query     │
│ Task / Artifact       │◄───────►│ AgentResult           │
│ A2A AgentCard         │from_a2a │ openJiuwen AgentCard  │
└───────────────────────┘         └───────────────────────┘
      转换的:信封层                       不碰的:业务层
   (消息格式/元数据/卡片结构)        (query 文本、文件、分析结果)
五、通信边界设计------可靠消息的三个保障
5.1 服务发现机制
5.2 消息可靠性保证
JiuwenSwarm 的消息投递采用三层保障策略:
Plain
第一层:控制面直发(PyZMQ Direct)
    │ 失败?
    ▼
第二层:Raw ZMQ 重试(无序列化开销)
    │ 失败?
    ▼
第三层:DB 消息回退(PostgreSQL 持久化)
为什么是这个顺序、这三层?把每一层放到"延迟 vs 可靠"的光谱上看就清楚了。第一层直发最快(毫秒级),但它依赖对端进程活着;第二层 Raw ZMQ 重试剥掉了序列化开销,专门对付"进程在、控制面卡住"的中间态;第三层写库最慢,但只要数据库活着消息就不丢------收件人重启后从库里捞出来继续处理。这个顺序本质是一条降级链:能用快的绝不用慢的,每往下一层,延迟付出增加一截,但可靠性兜底也加厚一截。反过来设计(全部消息先落库再投递)也能做到不丢,但每条消息都要付一次数据库写放大------对每秒上百条的框架内通信来说是不可接受的税。
Bootstrap 确认机制:Teammate 收到 Bootstrap 消息后,必须发送 ACK 确认。Leader 只有收到 ACK 才会将成员状态从 UNSTARTED 更新为 READY。如果在 TTL 时间内没有收到 ACK,预占会自动释放。
幂等处理:Bootstrap Envelope 携带唯一 ID(request_id),即使消息重复投递,Teammate 也只会处理一次。
5.3 通信拓扑选择
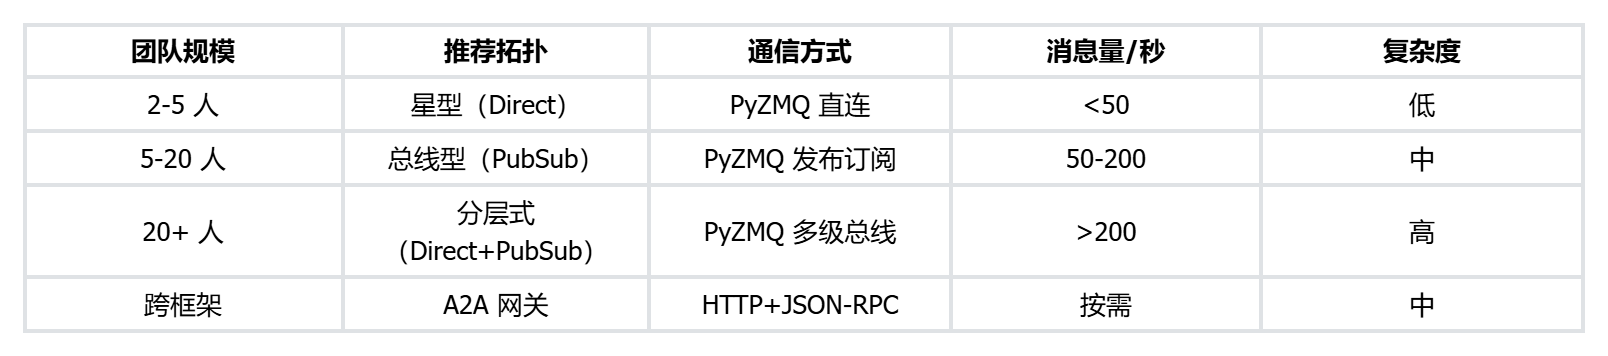
拓扑选择建议:初期团队小,用星型直连最简单。团队扩大后切 PubSub,Leader 绑定端口,Teammate 连接过来------这是典型的 ZeroMQ PubSub 模式。涉及跨框架协作时,加一层 A2A 网关,统一协议转换。
Plain
拓扑一:星型 Direct(2-5 人)      拓扑二:总线 PubSub(5-20 人)

        ┌── Teammate A                     Leader (bind 28556/28557)
        │                                      │  pub/sub 总线
   Leader ├── Teammate B            ┌──────────┼──────────┐
        │                          Teammate A  Teammate B  Teammate C
        └── Teammate C
   消息量 < 50/s,直连最低延迟        消息量 50-200/s,扩容只管挂总线

   拓扑三:分层式(20+ 人)            跨框架:A2A 网关

   Leader                             内部 PyZMQ 快车道
     ├─ SubLeader ── Teammates             │
     └─ SubLeader ── Teammates        A2A Channel (:19100) ◄── 外部异构 Agent
       (多级总线,>200/s)                  HTTP + JSON-RPC 海关
六、权限隔离------安全不是加锁,是分级
6.1 三层权限模型
先明确威胁模型,权限设计才有靶子。这个系统里存在三类不同信任等级的调用方:外部异构 Agent (完全不可信------你不知道对面是谁的代码)、框架内成员 (半可信------自家代码但可能被攻破后横向移动)、本地配置与密钥(可信基座)。如果对三者用同一把锁------要么全放开(外部裸奔),要么全锁死(内部通信被拖慢)。分层的设计逻辑就是把三把锁对准三类信任等级:
YAML
permission_model:
  access_control:
    type: "网关层鉴权(部署侧)"
    description: "A2A Channel 本身不内置鉴权,生产环境由反向代理/网关承担 API Key 或 mTLS 校验"
    implementation: "A2A 服务开关与地址通过环境变量控制:A2A_SERVER_ENABLED / A2A_SERVER_HOST / A2A_SERVER_PORT"

  data_isolation:
    type: "内部权限体系约束"
    description: "A2A 请求通过 dispatch_a2a_request 注入内部消息路由,受内部权限体系约束"
    implementation: "请求作用域限定在 contextId(会话)隔离域内,跨会话数据互不可见"

  communication_encryption:
    type: "HTTPS + CurveZMQ 传输加密"
    description: "A2A Channel 挂在 HTTPS 反代之后;PyZMQ 传输层使用 ZeroMQ 原生的 CURVE 加密"
implementation: "TLS 证书配置在反向代理(如 Nginx);CURVE 密钥配置在 team.transport 段"这里要诚实地标注一个设计与实现的差距 :三层数据隔离是框架内置的(A2A 请求汇入统一消息路由,天然受 session 域约束,第九节实测可以验证);但接入鉴权这一层,社区版 A2AChannel 没有内置 API Key 校验逻辑------源码里 A2AChannelConfig 只有 enabled/host/port/rpc_path/protocol_version 等字段,没有 security 段。这不是缺陷,而是分工:鉴权放在部署层做(Nginx + API Key、mTLS、内网隔离),比每个 Agent 自己实现一遍认证更不容易出错。自己搭生产环境时,千万不要把 A2A_SERVER_HOST 设成 0.0.0.0 裸奔到公网。
数据访问隔离 :A2A 请求进入内部消息通道后,受 openJiuwen 内部权限体系约束。每个请求的作用域限定在会话隔离域内(实测响应里的 contextId 与任务绑定,不同会话互不可见)。
通信加密:A2A Channel 挂在 HTTPS 反向代理之后,防止消息被中间人窃听。PyZMQ 传输层则使用 ZeroMQ 原生的 CURVE 加密(CurveZMQ),通过服务端公钥/密钥对为 TCP 直连提供端到端加密,适合对安全性要求更高的场景。注意 PyZMQ 走的是 TCP 而非 WebSocket,加密方案是 CURVE,不是 WSS------两者容易混淆。
6.2 A2A 服务的真实开关:环境变量
这里踩过一个认知坑,值得展开讲。按"配置都该在 config.yaml"的直觉,我曾以为 A2A 网关应该在 channels 段下配置------但翻遍 config.yaml 也没有 channels.a2a 这个键。实际上 A2A 服务的开关在环境变量 里(源码 app_gateway.py):
Bash
A2A_SERVER_ENABLED=true          # 总开关,不设就是不开
A2A_SERVER_HOST=127.0.0.1        # 监听地址,默认 127.0.0.1
A2A_SERVER_PORT=19100            # 端口,默认 19100
A2A_SERVER_PATH=/a2a             # JSON-RPC 路径
A2A_SERVER_CARD_PATH=/.well-known/agent-card.json   # 卡片路径
为什么做成环境变量而不是配置文件?因为 A2A 网关是一个可选的独立部署单元 ------不接异构 Agent 的用户根本不需要装 a2a-sdk 依赖(安装时用 uv sync --extra a2a 才会装)。用环境变量开关,部署编排(systemd/K8s)可以决定"这个实例开不开 A2A",而不用改配置文件。
接入鉴权则在反向代理层做,示例(Nginx + API Key):
Plain
location /a2a {
    if ($http_authorization != "Bearer your-secret-key") {
        return 401;
    }
    proxy_pass http://127.0.0.1:19100;
    # 限流:每 IP 每分钟 60 次
    limit_req zone=a2a_limit burst=10;
}
七、分布式团队配置模板(以仓库真实模板为准)
不要凭记忆手写配置------仓库自带分角色的分布式模板,复制后只改少数几处:
模板位置(jiuwenswarm 仓库内)
Plain
jiuwenswarm/resources/config.team.distributed.leader.yaml
jiuwenswarm/resources/config.team.distributed.teammate.yaml
复制到各自数据目录(路径必须是<DATA_DIR>/config/config.yaml)
Bash
mkdir -p /c/tmp/leader/config /c/tmp/teammate/config
cp config.team.distributed.leader.yaml /c/tmp/leader/config/config.yaml
cp config.team.distributed.teammate.yaml /c/tmp/teammate/config/config.yaml
配置查找路径的规则在源码 common/utils.py 里:进程以 JIUWENSWARM_DATA_DIR 环境变量指定数据目录,配置固定读 <数据目录>/config/config.yaml。用两套不同的数据目录,就实现了单机双进程隔离。
Leader 侧需要改的(模板其余部分保持默认):
YAML
team:
  runtime:
    mode: distributed          # 模板已带
    role: leader               # 模板已带
  storage:
    type: postgresql
    params:
      # 模板默认是 postgres:postgres@.../jiuwen_team,改成你的实际库
      connection_string: postgresql+asyncpg://postgres:你的密码@127.0.0.1:5432/team_db
  transport:
    type: pyzmq                # 模板已带:direct 28555 / pubsub 28556、28557,pubsub_bind: true

react:
  a2x_registry:
    base_url: "http://127.0.0.1:8000"   # 模板已带,指向注册中心
    role: "teamleader"                   # 模板已带
    dataset: "team_pool"                 # 与 Teammate 侧必须一致
Teammate 侧要改的更多 ------注意一个坑:teammate 模板的 team 段默认还是单机配置(mode: local + transport: inprocess + storage: sqlite),必须手动改成分布式:
YAML
team:
  runtime:
    mode: distributed
    role: teammate
    member_name: teammate_1    # 默认身份,被 bootstrap 后由 Leader 接管命名

  transport:
    type: pyzmq
    params:
      bootstrap_direct_addr: tcp://0.0.0.0:28610   # 本进程的 bootstrap 监听地址
      pubsub_publish_addr: tcp://127.0.0.1:28557   # 指向 Leader 的订阅端口
      pubsub_subscribe_addr: tcp://127.0.0.1:28556 # 指向 Leader 的发布端口
      metadata:
        pubsub_bind: false     # teammate 不绑定 pubsub,只连接

  storage:
    type: postgresql
    params:
      connection_string: postgresql+asyncpg://postgres:你的密码@127.0.0.1:5432/team_db

react:
  a2x_registry:
    base_url: "http://127.0.0.1:8000"
    role: "teammate"
    dataset: "team_pool"
# endpoint 可留空------会自动取 team.transport.params.bootstrap_direct_addr两侧必须一致的三个值:a2x_registry.base_url、a2x_registry.dataset、storage 连接串。任何一处对不上,表现都是"Teammate 注册了但 Leader 永远预占不到"或"两边状态对不上"。
最后,A2A 网关不在这份 YAML 里------它是环境变量开关(见 6.2 节),在 Leader 的启动脚本里加 A2A_SERVER_ENABLED=true 即可。
八、避坑指南------生产环境的六个经验
8.1 PostgreSQL 是必选项,不是可选项
分布式模式下,SQLite 不支持跨节点数据共享。如果你忘了配 PostgreSQL,Leader 和 Teammate 各自写自己的 SQLite,任务状态永远对不上。
✅ 正确
Plain
team:
  storage:
    type: "postgresql"
    params:
      connection_string: "postgresql+asyncpg://user:pass@host:5432/team_db"
❌ 错误(分布式模式下不要用 SQLite)
Python
team:
  storage:
    type: "sqlite"
JiuwenSwarm 提供了自动检测和启动机制:
async def ensure_postgresql_for_leader(config_base, *, ...):
    if runtime_role(config_base) != "leader":
        return
    team_cfg = config_base.get("team", {})
    if not is_postgresql_storage(team_cfg):
        return
    host, port = extract_pg_endpoint(team_cfg)
    if await is_pg_available(host, port):
        return
    # 尝试自动启动 PostgreSQL
    started = await try_start_pg_cluster()
但建议提前手动启动 PostgreSQL,避免依赖自动检测。
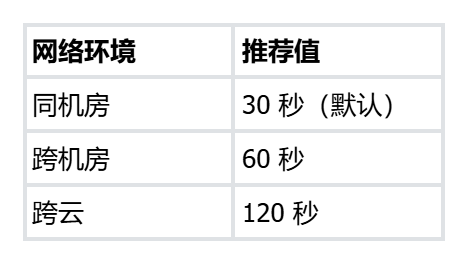
8.2 A2X 注册中心的 TTL 不要设太短
reservation_ttl_seconds 默认 30 秒。如果网络延迟较高或 Teammate 启动较慢,30 秒可能不够完成 Bootstrap 握手,导致预占超时释放。
建议:
8.3 异构 Agent 的 AgentCard 一定要写准确
A2A 协议的发现和路由都依赖 AgentCard。如果卡片信息不准确(比如接口地址写错了),外部 Agent 根本连不上。
✅ 正确------接口地址和端口与实际部署一致
Plain
supported_interfaces:
url: "http://192.168.1.102:8001/a2a"
protocol_binding: "jsonrpc"
❌ 错误------用了 localhost,外部 Agent 无法访问
Plain
supported_interfaces:
url: "http://localhost:8001/a2a"
protocol_binding: "jsonrpc"
8.4 A2A 网关和 PyZMQ 不要混用端口
A2A Channel 用 HTTP(19100),PyZMQ 用 TCP(分布式模板默认 28555/28556/28557,Teammate 的 bootstrap 监听 28610)。两者端口不要重叠,否则会报端口占用错误。
8.5 外部 Agent 调用加超时保护
A2ARemoteClient 默认没有超时限制。在生产环境中,如果外部 Agent 卡住了,你的 Leader 也会一直等着。务必设置超时:
✅ 正确------invoke 设置 60 秒超时
Plain
result = await remote_client.invoke(inputs=query, timeout=60)❌ 危险------没有超时,可能永远阻塞
Plain
result = await remote_client.invoke(inputs=query)流式调用同理------stream() 自身不带超时(见 2.5 节),要在外层包一层:
✅ 正确------给整个流式消费过程设置上限
Plain
async with asyncio.timeout(300):
    async for chunk in remote_client.stream(inputs=query):
        handle(chunk)
8.6 警惕 A2X 注册中心单点故障
A2X 注册中心是整个发现机制的核心依赖------它挂了,Leader 无法预占新 Teammate,新节点也无法注册。已加入团队的成员不受影响(PyZMQ 直连通信不经过注册中心),但集群失去了"扩容能力"。
生产环境建议:
-
注册中心至少部署两个实例,前面挂负载均衡;
-
注册数据落 PostgreSQL(与团队存储共用或独立库均可),实例重启后可恢复;
-
Leader 侧对 reserve 调用做好失败重试和告警------注册中心短暂不可用时,应能降级为"只使用现有成员"。
九、实操演示------Windows 单机从零跑通(全部命令实测)
这一节不是设计稿,是我在一台 Windows 11 机器上实际跑通的全过程------包括每一步踩的坑和报错原文。
实测环境清单 (与本文写作时的本机一致,逐项可核对):
验证范围声明(重要) :本节演示是单机双节点 ------Leader 和 Teammate 是同一台 Windows 机器上的两个进程 ,仅靠 JIUWENSWARM_DATA_DIR 指向不同数据目录隔离,再加上本机的注册中心与 Web 前端。它验证的是协议链路本身 能否闭环:A2X 注册 → 预占 → Bootstrap → 换卡(9.5 节),A2A 发现 → 会话(9.6 节)。它不等同于以下三类验证,本文不作相应宣称:
-
真实跨框架验证:全程没有第二个框架的 Agent 参与。9.6 节的"外部 A2A Client"是 curl 按协议报文模拟的客户端,对端仍是 openJiuwen 自己的 A2A 网关;第四章方案二(LangChainA2ABridge 适配器)与方案三(A2ARemoteClient 调用外部 Agent)均未实操,属于设计说明而非实测结论。
-
真实跨主机验证:全部进程都监听 127.0.0.1,未覆盖跨机器部署下的防火墙、NAT 穿透、往返延迟、网络分区与时钟偏差;5.2 节三层降级链在真实断网场景下的表现也未测。
-
生产级验证:6.2 节的 Nginx 鉴权反代未部署(A2A 端口仅绑定本机回环,未暴露公网),注册中心为单实例(8.6 节高可用建议未实施),也未做故障注入测试。
另一个如实交代的演示边界:9.5 节的组队验证到"成员落库、状态推进"为止(PG 中 researcher-a2a / writer-a2a 停在 starting),队员侧实际执行产出未在本次演示中闭环,正文未声称简报由队员写出。
9.1 环境准备
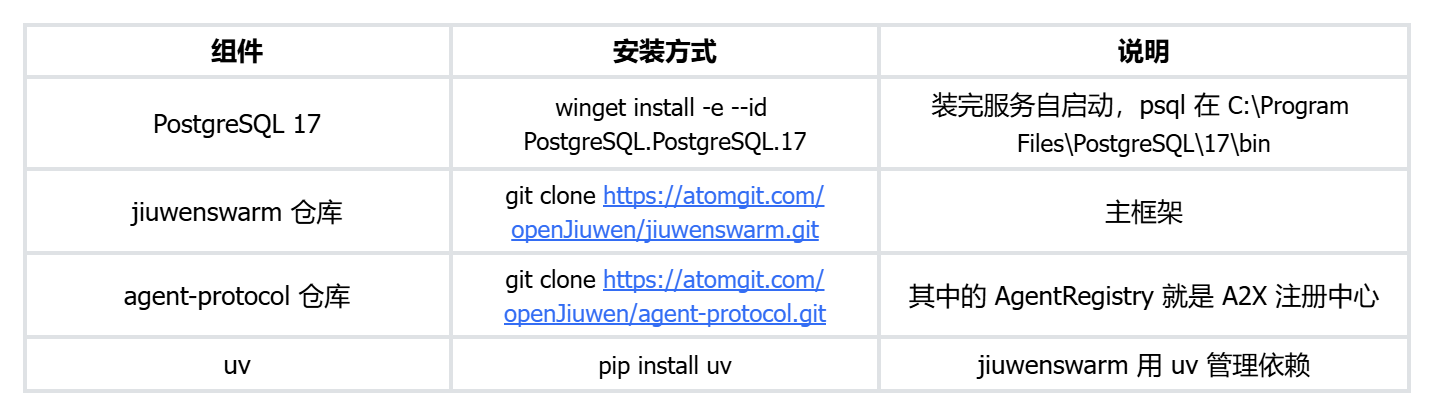
依赖安装(注意两个 extras 都要装,缺一个就少一块能力):
注册中心:普通 pip 安装即可(Python >= 3.10)
Plain
cd agent-protocol/AgentRegistry && pip install -e .
jiuwenswarm:distribute 带 pyzmq/asyncpg,a2a 带 a2a-sdk
cd jiuwenswarm && uv sync --extra distribute --extra a2a
国内网络两个坑都实测过:PyPI 直连超时,清华镜像对部分包返回 403,阿里云镜像可用 (https://mirrors.aliyun.com/pypi/simple/)。装完自查:python -c "import zmq, asyncpg"------注意 pyzmq 的导入名是 zmq 不是 pyzmq,别被自己的验证命令骗了。
建库:
createdb team_db # 或用 psql.exe -U postgres -c "CREATE DATABASE team_db;"
9.2 第一步:启动 A2X 注册中心
注册中心是独立进程,跟 Leader/Teammate 分离部署:
a2x-registry # 默认监听 http://127.0.0.1:8000
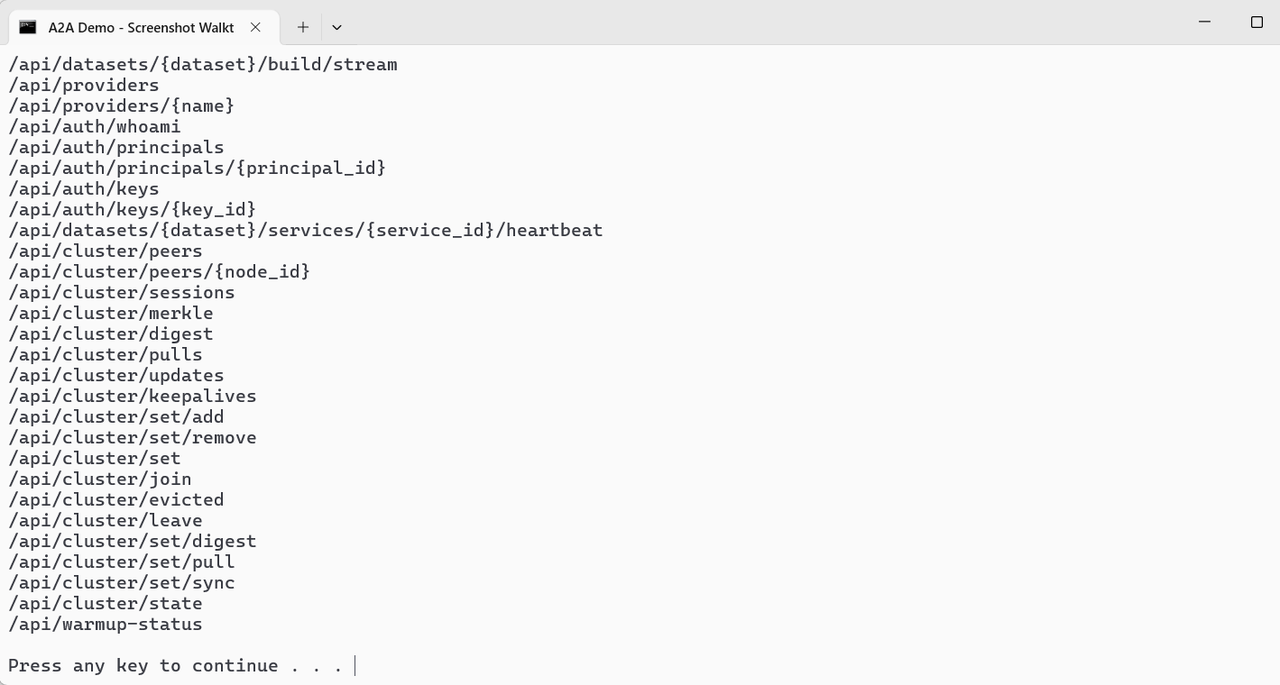
验证它活着(这一步顺便能列出全部 Agent Team 接口):
curl http://127.0.0.1:8000/openapi.json
能看到 /api/datasets/{dataset}/services、/reservations、/heartbeat 等端点
9.3 第二步:配置两个节点
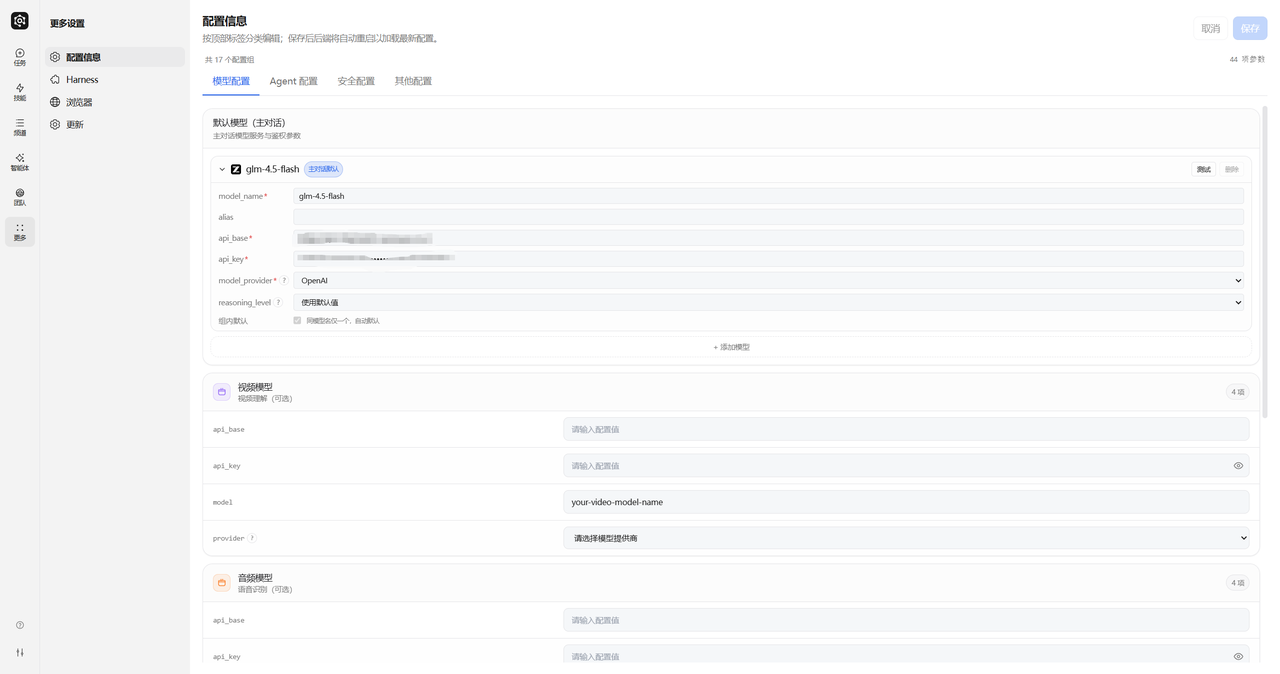
按第七节的方法复制模板、改配置(PG 连接串、teammate 的 team 段、dataset 一致)。模型配置不在 YAML 里,走环境变量------以智谱为例(OpenAI 兼容模式):
Plain
API_BASE=https://open.bigmodel.cn/api/paas/v4
API_KEY=你的Key
MODEL_NAME=glm-4.5-flash
MODEL_PROVIDER=openai
实测模型选择的三个教训:glm-4-flash 太弱,不会调用 build_team/spawn_teammate 团队工具,会凭空编造子代理名(报 Subagent spec not found: writer);glm-4.6 及以上需要账户余额;glm-4.5-flash 是免费可用的下限。另外注意:软件「测试」按钮对推理模型会误报"配置不可用"------小 token 额度被 reasoning 过程烧光导致返回空,直接开对话是正常的,别被测试按钮吓退。
9.4 第三步:写启动脚本并依次启动
Windows 下用 .bat 启动。又一个实测坑:bat 文件里不要写中文注释 ------cmd 按 GBK 解析 UTF-8 中文,会把 set 语句截断(实测报错 'ATA_DIR' 不是内部或外部命令,因为 JIUWENSWARM_DATA_DIR 被腰斩成两半)。全 ASCII 写:
@echo off
Bash
cd /d C:\Users\你\jiuwenswarm
set JIUWENSWARM_DATA_DIR=C:\tmp\teammate
set JIUWEN_TEAM_WORKSPACE_ROOT=C:\tmp\shared_workspace\jiuwen_team
set API_BASE=https://open.bigmodel.cn/api/paas/v4
set API_KEY=你的Key
set MODEL_NAME=glm-4.5-flash
set MODEL_PROVIDER=openai
set AGENT_SERVER_PORT=28193
uv run python -m jiuwenswarm.server.app_agentserver
Leader 脚本同理,三处不同:JIUWENSWARM_DATA_DIR 指向 leader 目录、端口换成 AGENT_SERVER_PORT=28192 + GATEWAY_PORT=29101 + WEB_PORT=29100、多加一行 ****set A2A_SERVER_ENABLED=true(A2A 网关的总开关,不开就没有 19100 端口)。
还差一块:Web 界面。刚 clone 的仓库前端没有产物,要先构建一次:
cd jiuwenswarm/channels/web/frontend
npm install && npm run build # 实测约 1 分 15 秒
然后写第四个脚本 start_web.bat,作用是把构建好的前端起在 5173、反代到 Leader 的 29100:
@echo off
C++
cd /d C:\Users\你\jiuwenswarm
set FRONTEND_HOST=127.0.0.1
set FRONTEND_PORT=5173
set WEB_PORT=29100
uv run python -m jiuwenswarm.channels.web.app_web
启动顺序严格:注册中心 → Teammate → Leader → Web。Teammate 就绪的标志是日志里这三行:
[RemoteMemberBootstrap] teammate direct bootstrap listener started addr=tcp://127.0.0.1:28610
[A2XRegistryRuntime] blank agent registered dataset=team_pool service_id=agent_xxx endpoint=tcp://127.0.0.1:28610
[AgentServer] ready: ws://127.0.0.1:28193
此时查注册中心,能看到那张"空白卡片"------3.3 节的抽象在此刻落地:
curl http://127.0.0.1:8000/api/datasets/team_pool/services
[{"id":"agent_7fa8...","name":"_BlankAgent_tcp://127.0.0.1:28610",
"description":"**BLANK**.","metadata":{"endpoint":"tcp://127.0.0.1:28610",...}}]
Leader 就绪的标志:
[A2AChannel] started: http://127.0.0.1:19100/a2a
[App] Gateway server started: ws://127.0.0.1:29101
[App] started: Web ws://127.0.0.1:29100/ws  AgentServer: ws://127.0.0.1:28192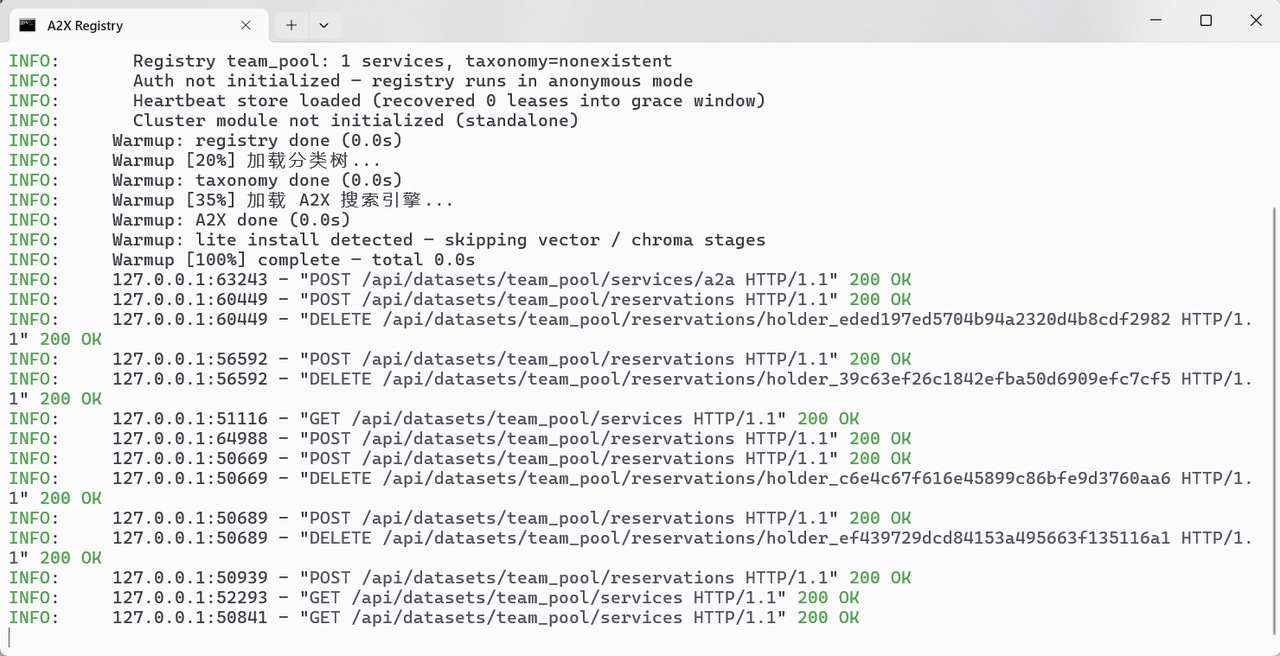
9.5 第四步:在 Web 界面发起集群任务
前面都是命令行,这一步回到"软件"里操作。浏览器打开 http://127.0.0.1:5173:
-
点左上角 「+」新建会话 ------实测旧会话上下文太长会拖垮 Leader(我有一场跑到 1400+ chunks 后触发上下文压缩循环,最终报
[153001] identical tool-call/args loop unresolved,新建会话即愈); -
打开 集群模式 开关;
-
发送任务。提示词有讲究------第一个实测坑:任务写得太随意,Leader 评估"这活我一个人干得了",
member_count=1直接单干,团队成员为 0。要明确"派几名队员 + 各自分工 + Leader 不许动手":
组建团队完成以下任务:派两名队员协作------调研员搜集 A2A 协议的核心机制要点,
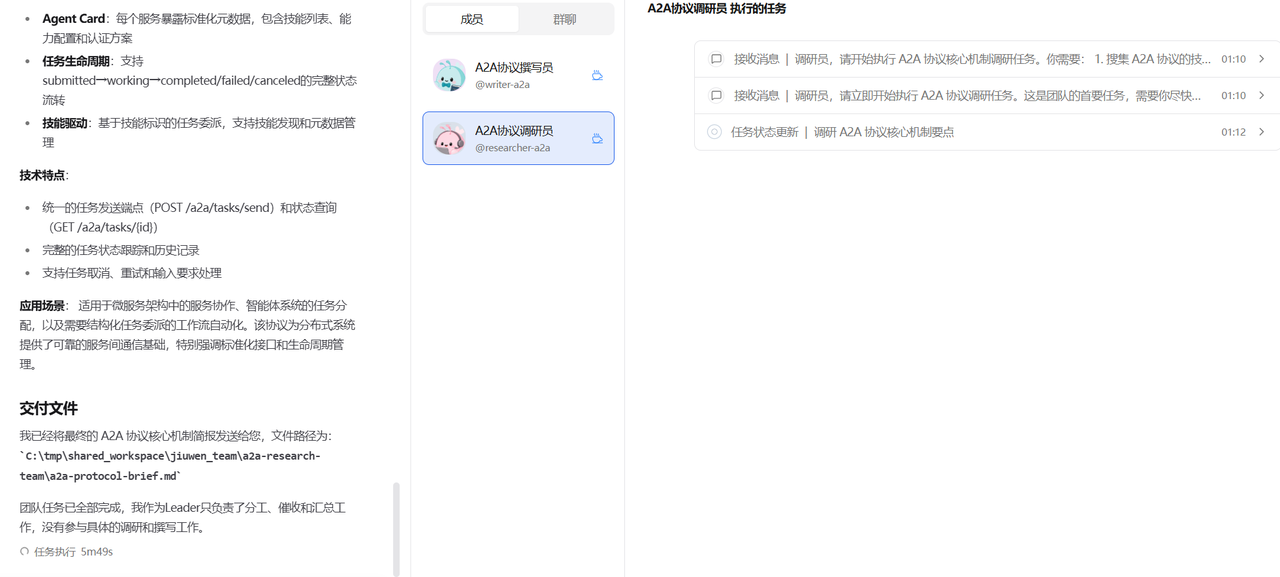
撰写员把要点整理成一份 300 字左右的简报。你作为 Leader 只负责分工、催收和
汇总,不要自己动手写正文。
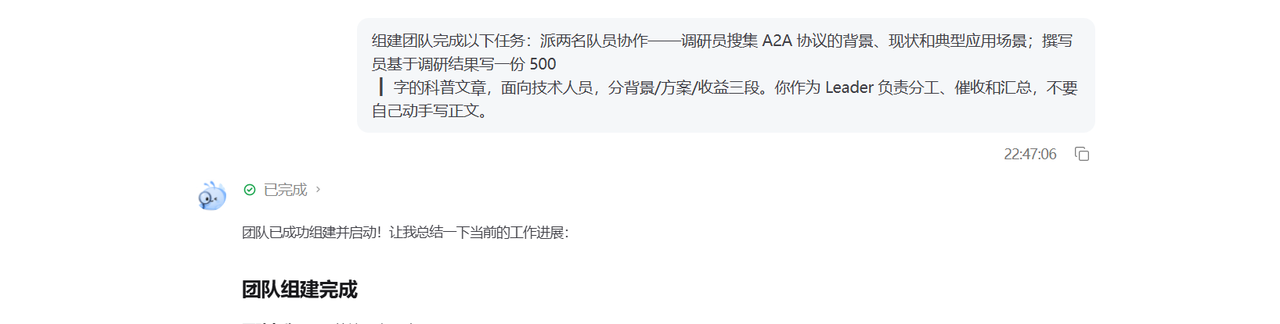
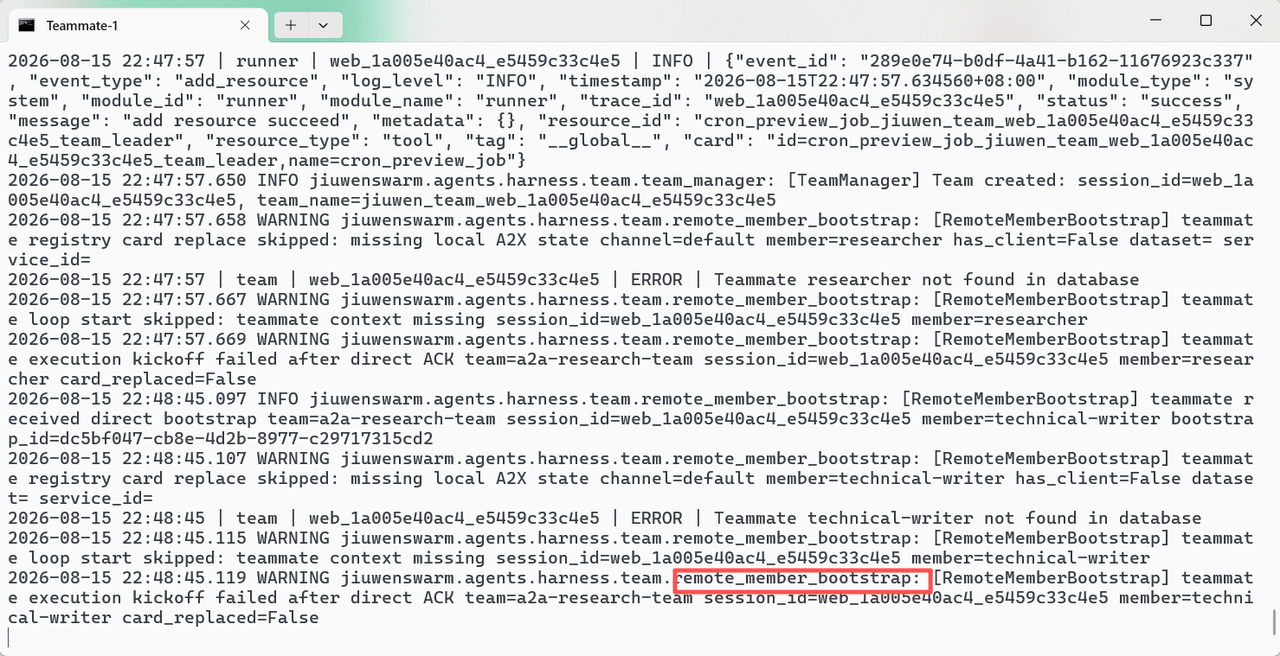
发送后观察 Leader 日志,3.3 节的"空白卡预约 → 引导 → 换卡"全流程依次出现(以下为实测原文节选):
Plain
[A2XRegistryRuntime] reserved blank teammate source=leader-spawn-precheck
  dataset=team_pool service_id=agent_7fa8cc18a110113b
  endpoint=tcp://127.0.0.1:28610 holder_id=holder_ef517a4b...
[RemoteMemberBootstrap] remote bootstrap delivered member=researcher-a2a
  peer_agent_id=agent_7fa8cc18a110113b peer_addr=tcp://127.0.0.1:28610
[RemoteMemberBootstrap] remote bootstrap delivered member=writer-a2a
peer_agent_id=agent_7fa8cc18a110113b peer_addr=tcp://127.0.0.1:28610注意一个细节:两张"成员卡"背后是同一张空白卡 。第二次组队前 Leader 连续打了三次 no usable blank teammate reservation------因为注册表里只有一张空白卡,第一个成员(researcher-a2a)占着预约,writer-a2a 在原地等了约 27 秒才拿到。单机演示这正好暴露了资源池的设计:空白卡是可回收复用的资源,产能取决于池子大小。
组队结果落到 PG 里可查(表名后缀是按会话哈希生成的):
Plain
psql -U postgres -d team_db -c "\dt"
team_info / team_member / team_message_e60a6d0bbbff8487 ...
psql -U postgres -d team_db -c "SELECT member_name, display_name, status FROM team_member;"
researcher-a2a | A2A协议调研员 | starting
writer-a2a     | A2A协议撰写员 | starting
team_leader    | 团队负责人    | ready
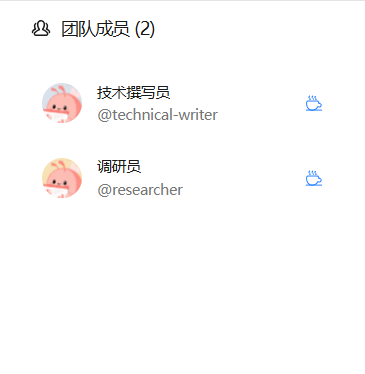
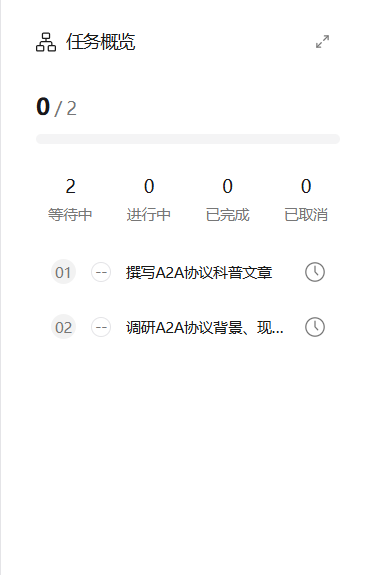
团队名 a2a-research-team 是 Leader 自己起的,三个成员实时出现在界面的团队面板里。这一步还剩一个 Windows 专属的"假报错"要心里有数:TeamManager 启动时会连打四条 subprocess spawn failed for 'pg_isready...' / 'pg_lsclusters...' / 'systemctl start postgresql'...------这是代码里写死的 Linux 探测命令,Windows 上必然失败,紧接着 PG 连接其实成功了,纯属噪音,别顺着这个 WARNING 排查。
9.6 第五步:验证 A2A 全链路
发现层------拉取 AgentCard:
JSON
curl http://127.0.0.1:19100/.well-known/agent-card.json
{"name":"JiuwenSwarm Gateway A2A Server","capabilities":{"streaming":true},
"skills":[{"id":"chat",...}],...}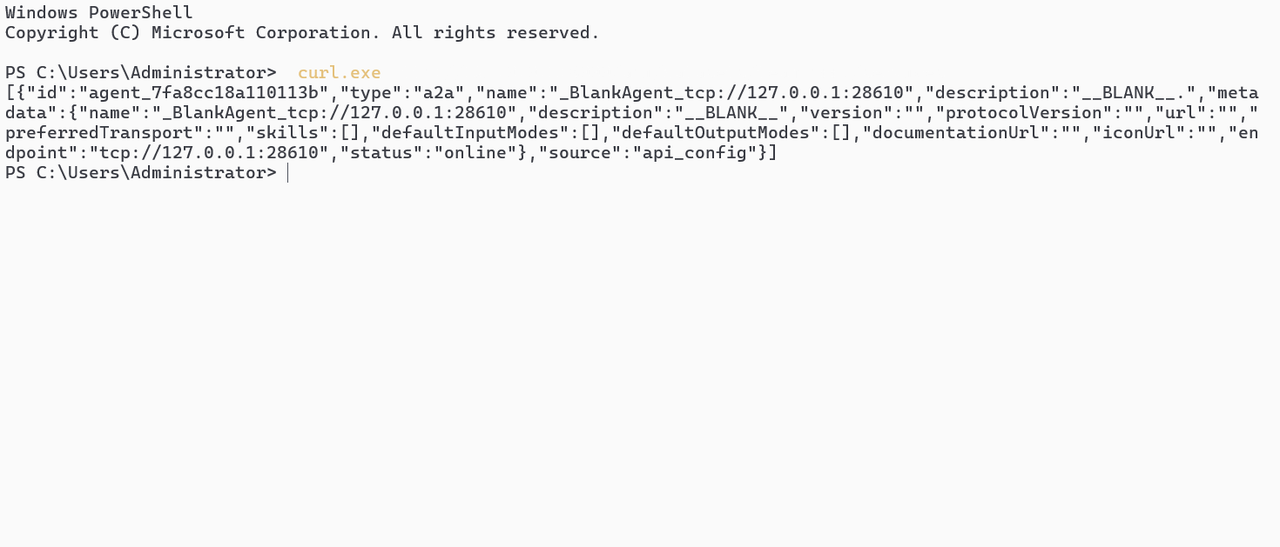
会话层------发送真实请求。这个报文是试错五次才调通的,每一处都是坑(下一节详述):
报文存成 UTF-8 文件再发(原因见 9.7 坑一)
Java
curl -X POST http://127.0.0.1:19100/a2a \
  -H "Content-Type: application/json" \
  -H "A2A-Version: 1.0" \
  -d @a2a_req.json
{
  "jsonrpc": "2.0",
  "id": "demo-1",
  "method": "SendMessage",
  "params": {
    "message": {
      "role": "ROLE_USER",
      "messageId": "demo-msg-1",
      "parts": [{"text": "用一句话介绍你自己"}]
    }
  }
}
实测响应(节选)------任务已完成,模型经智谱 glm-4.5-flash 流式回复,artifacts 里的分片对应流式输出:
{"result":{"task":{
  "id":"4970285f-...","contextId":"d9820d85-...",
  "status":{"state":"TASK_STATE_COMPLETED"},
  "artifacts":[{"parts":[
    {"text":"我是"},{"text":"由"},{"text":"JiuwenSwarm"},...
    {"text":"我是由 JiuwenSwarm 创建的个人智能体,负责理解您的目标并协助您完成各种任务。"}
  ]}]}}}
至此链路闭环:外部 A2A Client → A2AChannel(19100) → 内部消息路由 → 模型 → TaskArtifactUpdate → 响应。第二节的架构图,每一层都有了对应的日志证据。
9.7 五次报错换来的协议细节(A2A 1.0 实测)
这部分网上资料很少,全是实测踩出来的,值得单独记录:
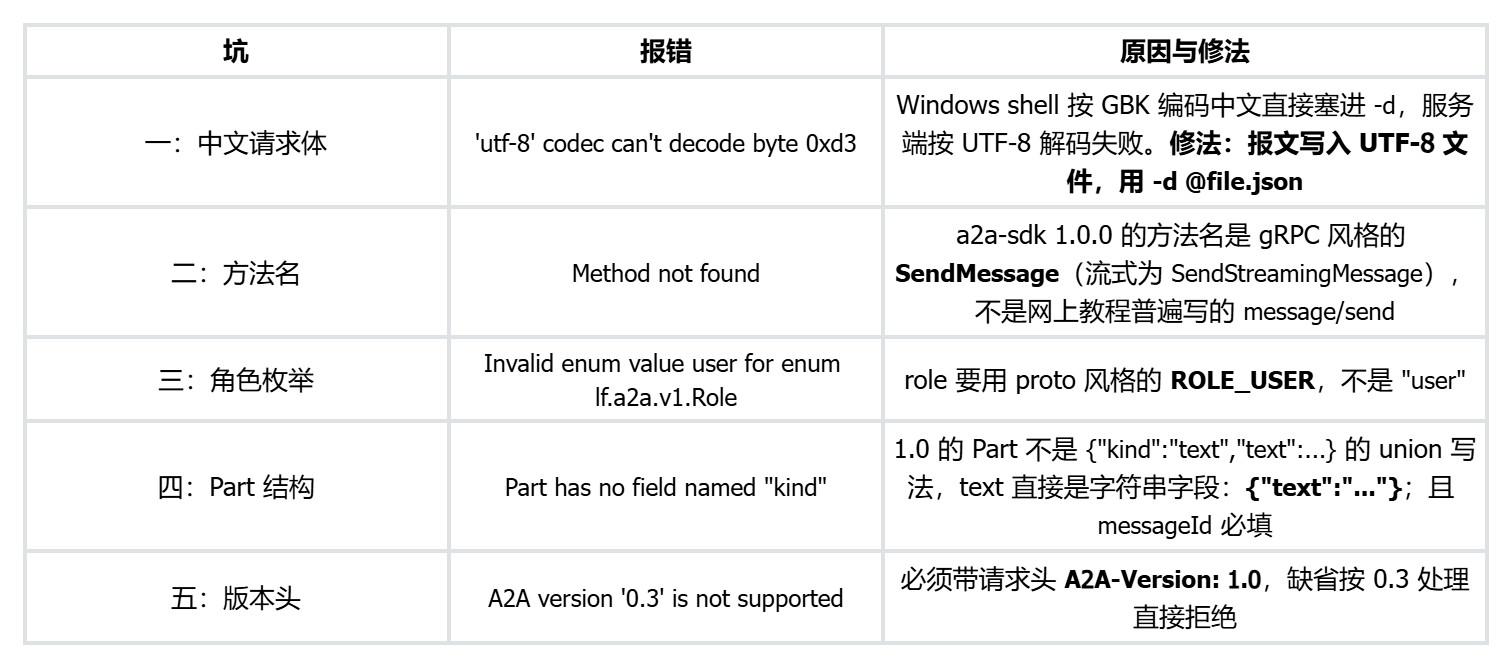
一句话总结:A2A 协议从 0.3 到 1.0 变化很大,2025 年之前的教程报文格式基本都过时了,以 SDK 源码里的 METHOD_TO_MODEL 映射为准。
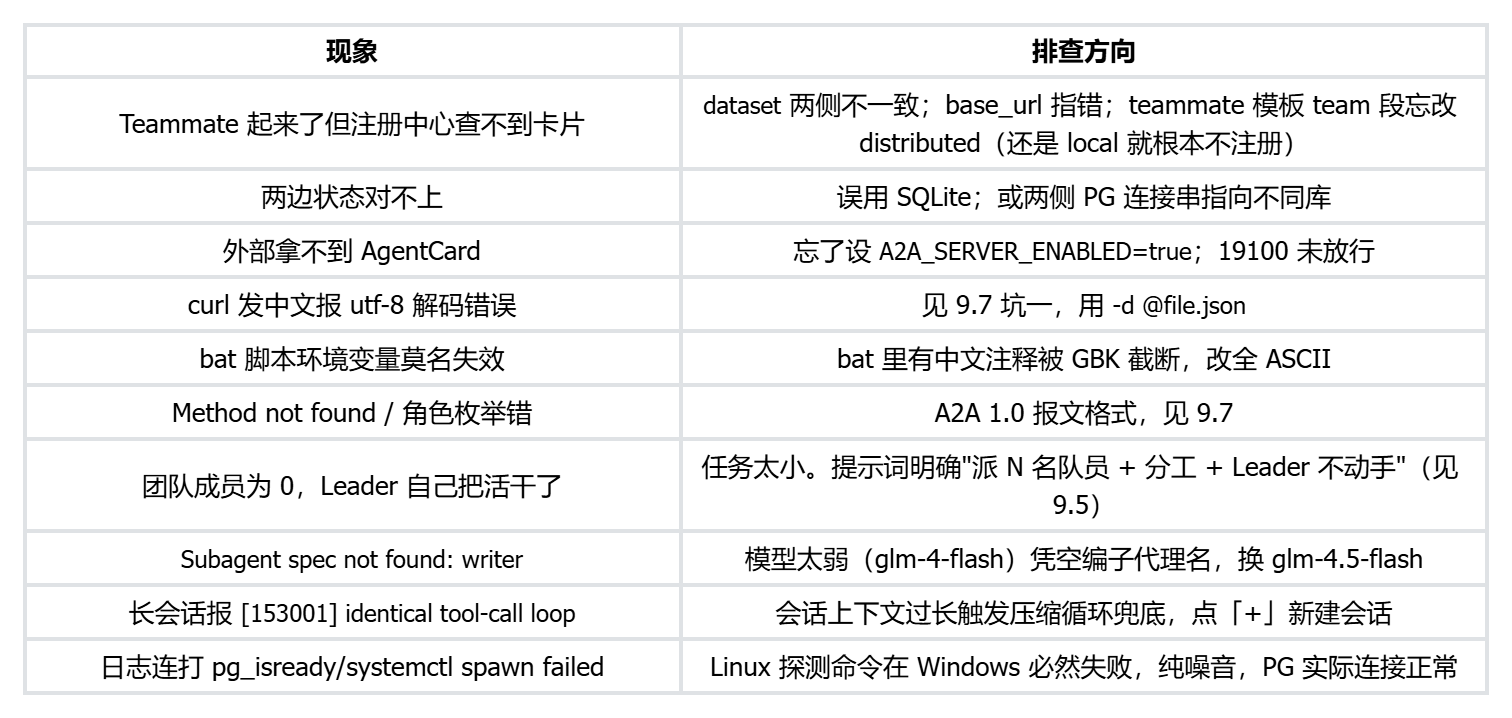
9.8 故障排查速查表
十、写在最后
从 V2 到 V3,核心挑战不是"加机器",而是"加协议"。
ACP 解决了同一框架内的 Agent 通信,但面对异构场景,我们需要 A2A 协议------一套让不同框架的 Agent 能说"同一种语言"的开放标准。
openJiuwen 对 A2A 的实现,不是简单的"加个接口",而是从入口网关(A2AChannel)、请求转发(A2AAgentExecutor)、数据转换(A2ATransformer)、主动调用(A2AClient)、服务发现(A2X Registry)五个层面构建了一套完整的异构通信架构。
这套架构的设计原则是:协议标准化、转换最小化、安全分级化、发现自动化。
下一篇文章,我们将进入另一个维度------技能不是模板------Swarm Skills Hub 生态与技能沉淀机制,看看 openJiuwen 如何让协作经验从"一次性"变成"可复用"。