知识库在接收到用户查询问题后,按照预设的检索方式在已有的文档内查找相关内容,提取出高度相关的信息片段供语言模型生成高质量答案。
选定内容的分段模式后,接下来设定对于结构化内容的索引方法 与检索设置。
1 设定索引方法
正如搜索引擎通过高效索引算法匹配与用户问题最相关网页内容,索引方式是否合理,直接影响 LLM 对知识库内容检索效率及回答准确性。
提供:
- 高质量
- 经济
两种索引方法,分别提供不同检索设置项:
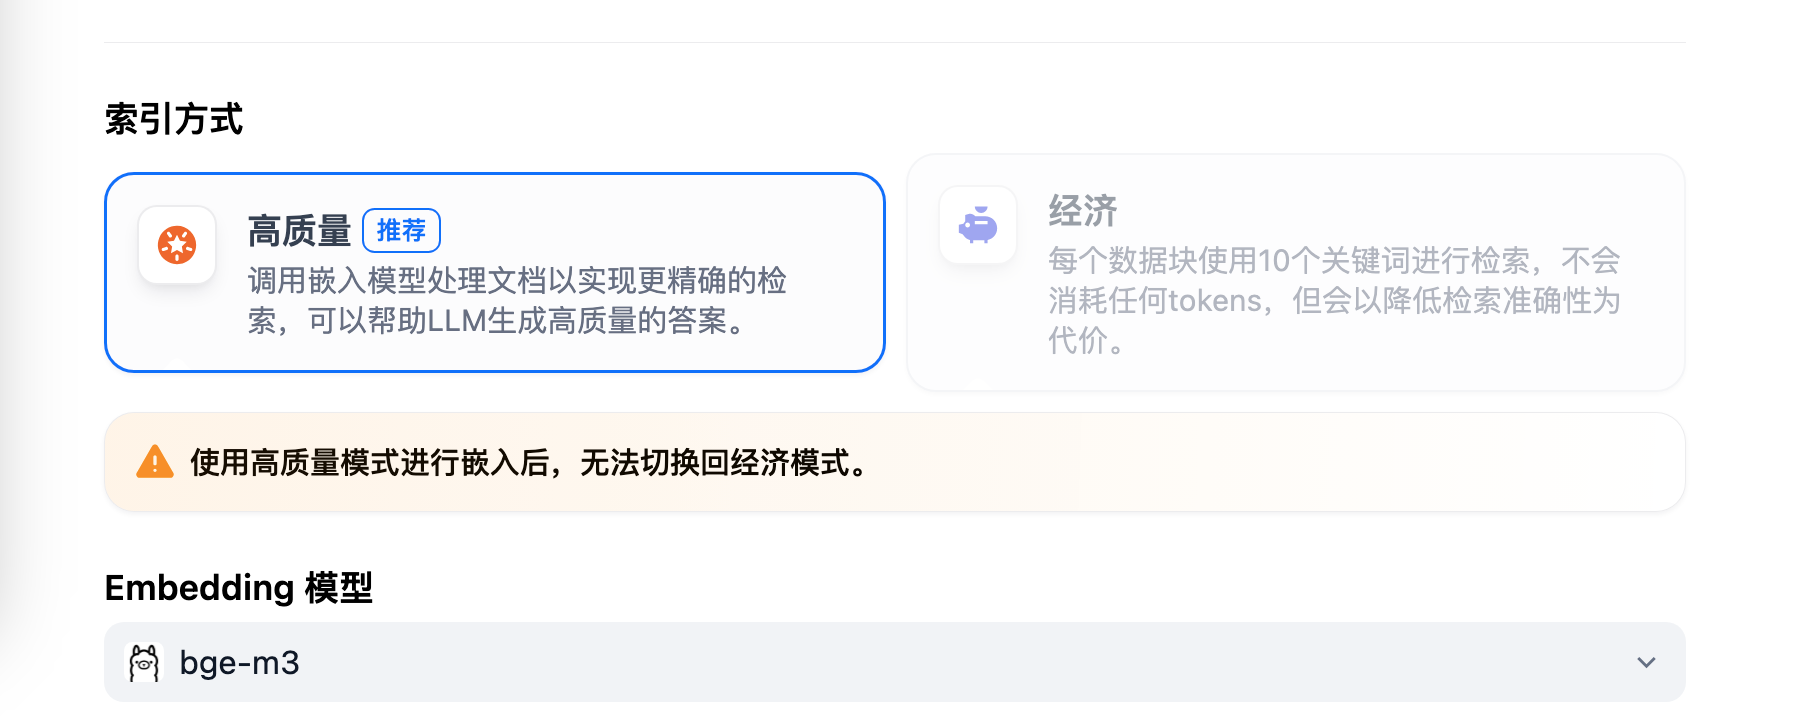
1.1 高质量
使用Embedding模型将已分段的文本块转换为数字向量,助更有效压缩与存储大量文本信息;使用户问题与文本之间的匹配更精准。
将内容块向量化并录入至数据库后,需通过有效检索方式调取与用户问题相匹配的内容块。高质量模式提供向量检索、全文检索和混合检索。各设置详细说明阅读检索设置。
选择高质量模式后,当前知识库的索引方式无法后续降级为 "经济"索引模式。如需切换,建议重新创建知识库并重选索引方式。
更多嵌入技术与向量说明《Embedding 技术与 Dify》。
高质量模式:
启用 Q&A 模式(可选,仅适用于社区版)
开启该模式后,系统将对已上传的文本进行分段。总结内容后为每个分段自动生成 Q&A 匹配对。与常见的 「Q to P」(用户问题匹配文本段落)策略不同,QA 模式采用 「Q to Q」(问题匹配问题)策略。
因为 「常见问题」 文档里的文本通常是具备完整语法结构的自然语言,Q to Q 模式会令问题和答案的匹配更加清晰,并同时满足一些高频和高相似度问题的提问场景。
Q&A 模式仅支持 「中英日」 。启用该模式后可能消耗更多 LLM Tokens,且无法用经济型索引方法。
Q&A Chunking
当用户提问时,系统会找出与之最相似问题,再返回对应分段作答案。这更精确,因为直接针对用户问题进行匹配,可更准确助用户检索真正需要信息。
1.2 经济
经济模式下,每个区块内用 10 个关键词进行检索,降低了准确度但无需产生费用。对检索到的区块,仅提供倒排索引方式选择最相关的区块,详细说明下文。
选择经济型索引方式后,若感实际效果不佳,可在知识库设置页升级为 "高质量"索引方式。
2 指定检索方式
知识库接收到用户查询问题后,按预设的检索方式在已有文档内查找相关内容,提取出高度相关的信息片段供语言模型生成高质量答案。这决定 LLM 所能获取的背景信息,从而影响生成结果的准确性和可信度。
常见检索方式包括:
- 基于向量相似度的语义检索,将文本内容块和问题查询转化为向量,通过计算向量相似度匹配更深层次的语义关联
- 基于关键词的精准匹配,通过倒排索引,即搜索引擎常用的检索方法,匹配问题与关键内容
不同索引方法对应差异化的检索设置。
2.1 高质量索引
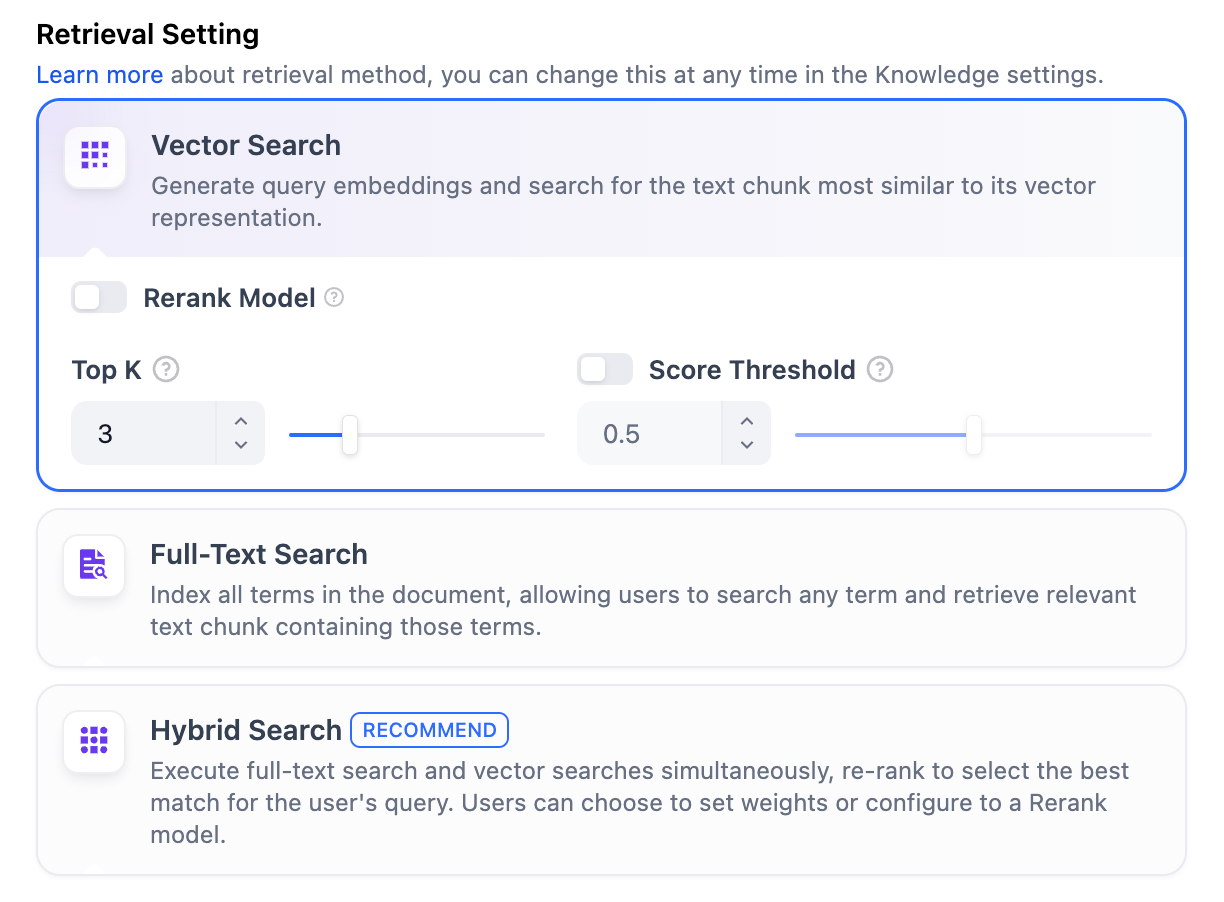
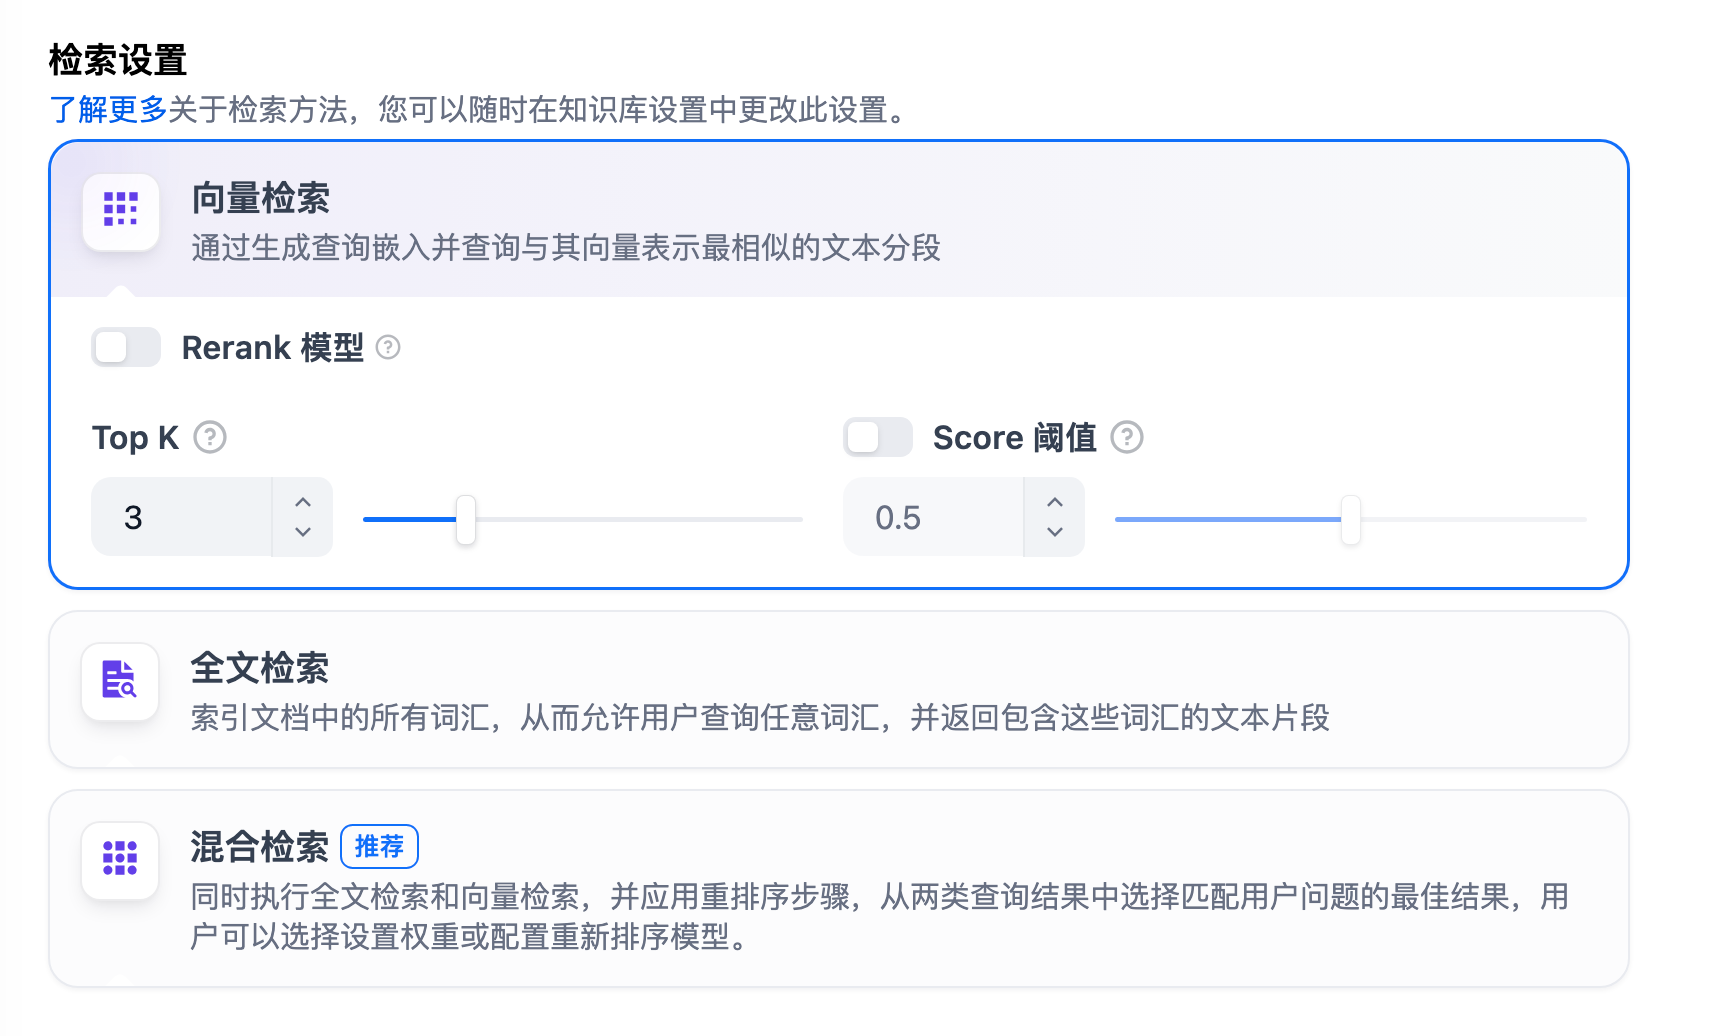
Dify 提供向量检索、全文检索与混合检索设置:
2.1.1 向量检索
向量化用户输入的问题并生成查询文本的数学向量,比较查询向量与知识库内对应的文本向量间的距离,寻找相邻的分段内容。
向量检索的设置项:
Rerank模型
默认关闭。开启后将用第三方Rerank模型再次重排序由向量检索召回的内容分段,以优化排序结果。助LLM获取更精确内容,辅助其提升输出的质量。
开启该选项:前往"设置" → "模型供应商",配置Rerank模型API KEY。
TopK
用于筛选与用户问题相似度最高的文本片段。系统同时会根据选用模型上下文窗口大小动态调整片段数量。默认值为 3,数值越高,预期被召回的文本分段数量越多。
Score 阈值
用于设置文本片段筛选的相似度阈值,只召回超过设置分数的文本片段,默认值为 0.5。数值越高说明对于文本与问题要求的相似度越高,预期被召回的文本数量也越少。
TopK 和 Score 设置仅在 Rerank 步骤生效,因此需要添加并开启 Rerank 模型才能应用两者中的设置参数。
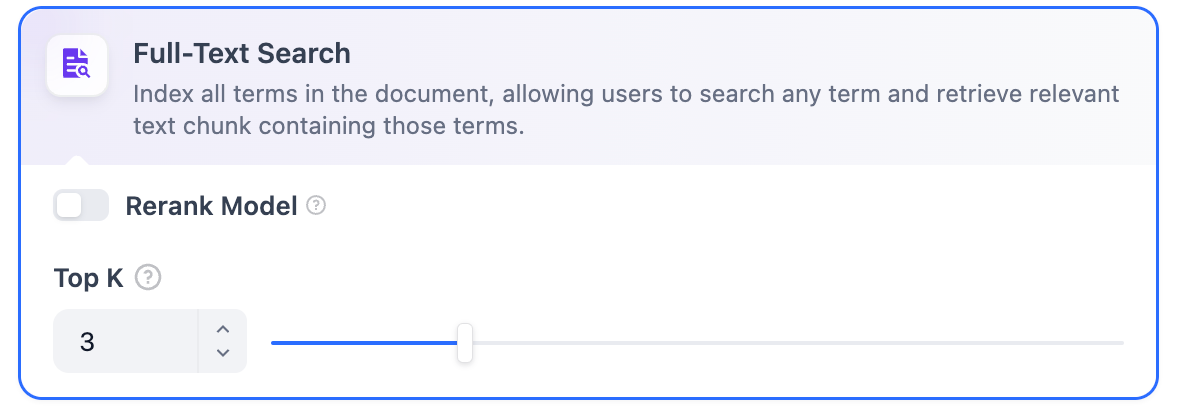
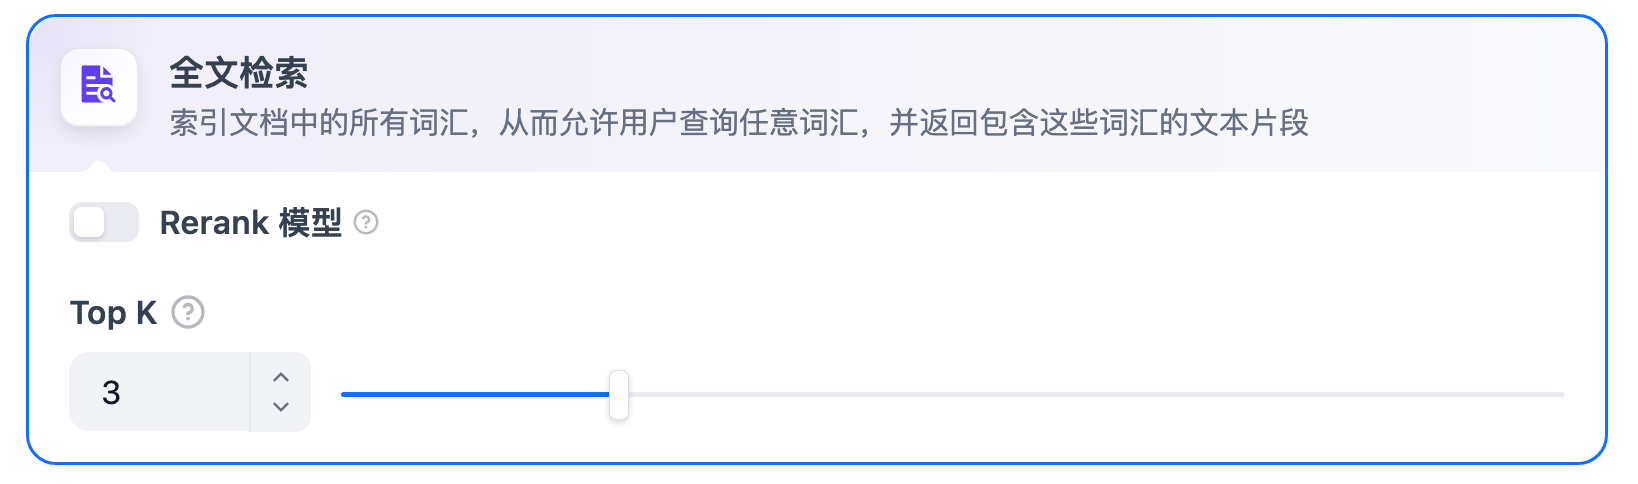
2.1.2 全文检索
关键词检索,即索引文档中的所有词汇。用户输入问题后,通过明文关键词匹配知识库内对应的文本片段,返回符合关键词的文本片段;类似搜索引擎中的明文检索。
2.1.3 混合检索
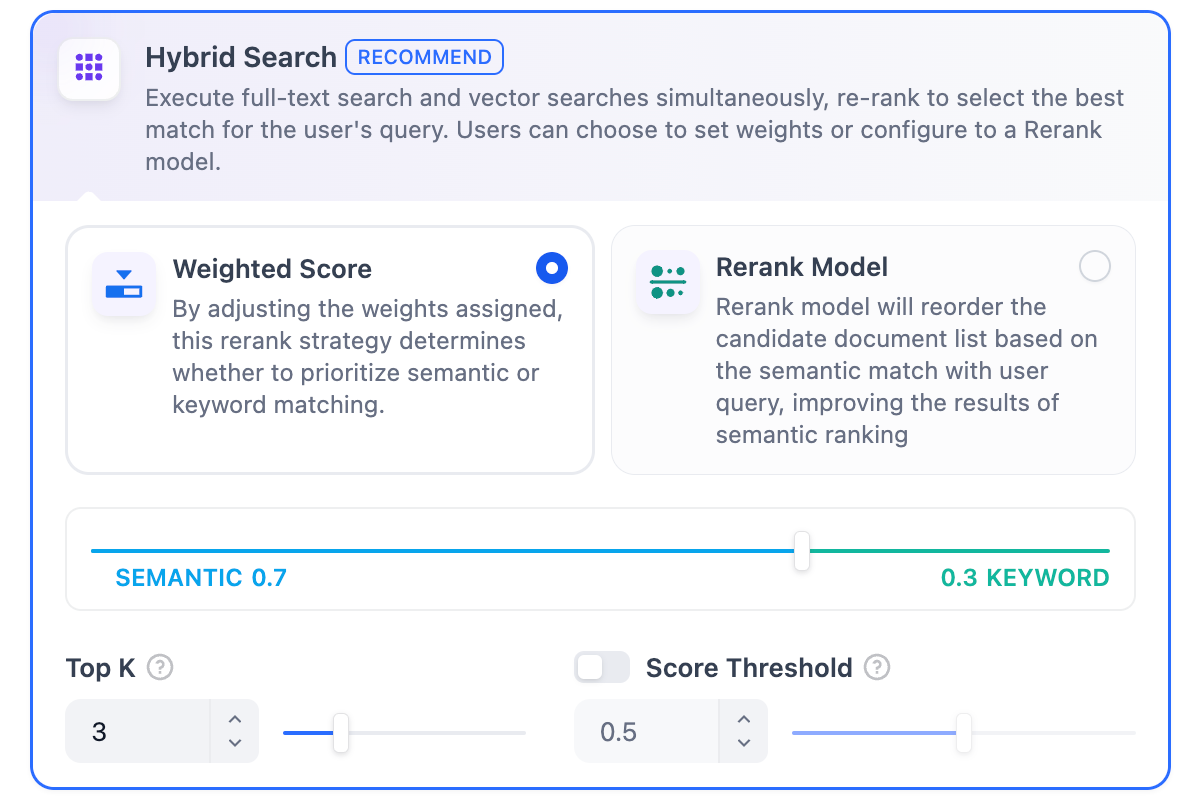
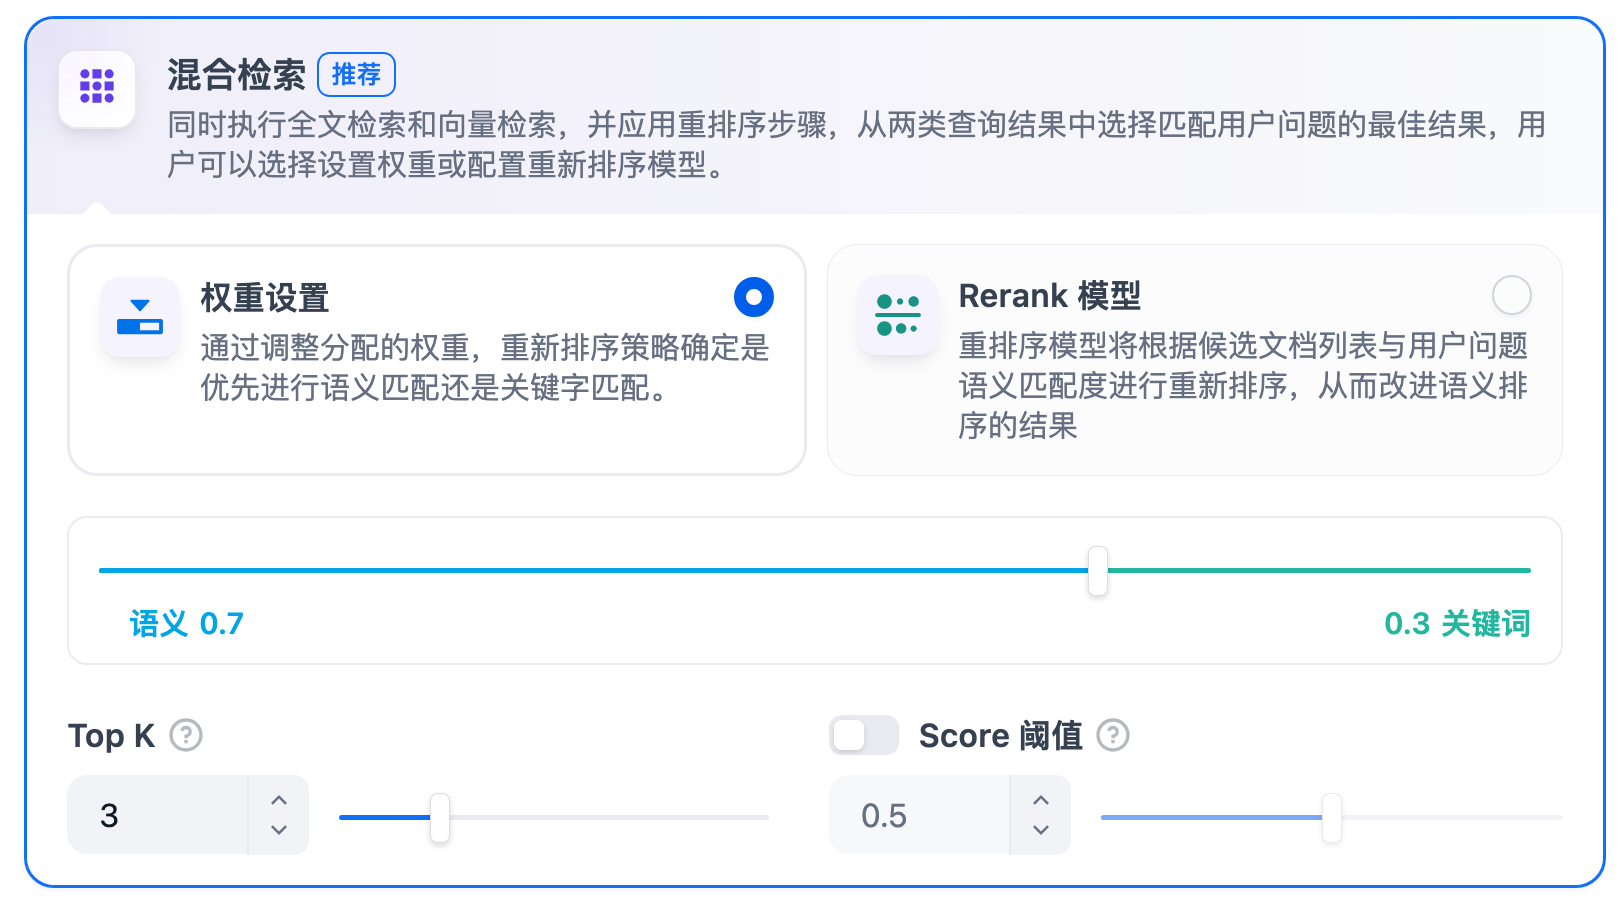
同时执行全文检索和向量检索,或 Rerank 模型,从查询结果中选择匹配用户问题的最佳结果。
权重设置
允许用户赋予语义优先和关键词优先自定义的权重。关键词检索指的是在知识库内进行全文检索(Full Text Search),语义检索指的是在知识库内进行向量检索(Vector Search)。
将语义值拉至 1:仅启用语义检索模式。借助 Embedding 模型,即便知识库中没有出现查询中的确切词汇,也能通过计算向量距离的方式提高搜索的深度,返回正确内容。需处理多语言内容时,语义检索能够捕捉不同语言之间的意义转换,提供更加准确的跨语言搜索结果。
将关键词的值拉至 1:仅启用关键词检索模式。通过用户输入的信息文本在知识库全文匹配,适用于用户知道确切的信息或术语的场景。该方法所消耗的计算资源较低,适合在大量文档的知识库内快速检索。
自定义关键词和语义权重:除了将不同的数值拉至 1,还可不断调试二者的权重,找到符合业务场景的最佳权重比例。
语义检索指比对用户问题与知识库内容中的向量距离。距离越近,匹配的概率越大。参考阅读:《Dify:Embedding 技术与 Dify 知识库设计/规划》。
2.2 经济索引
倒排索引
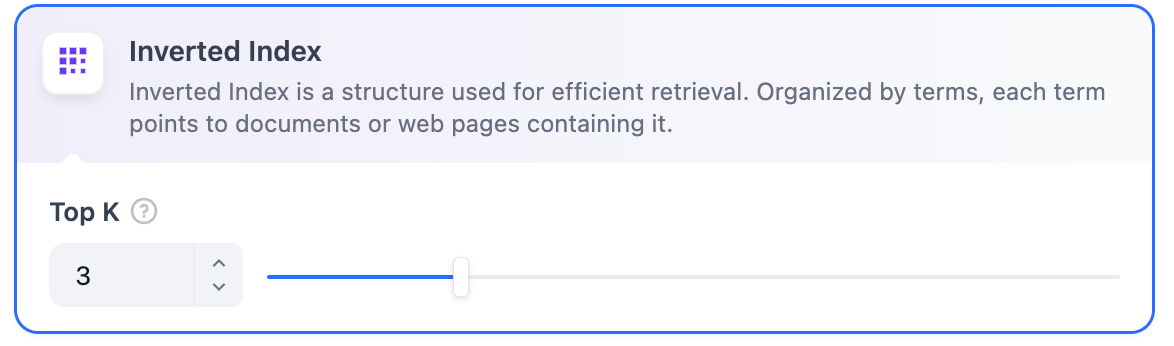
在经济索引方式下,仅提供倒排索引方式 。这是一种用于快速检索文档中关键词的索引结构,常用于在线搜索引擎。倒排索引仅支持 TopK 设置项。
TopK:
用于筛选与用户问题相似度最高的文本片段。系统同时会根据选用模型上下文窗口大小动态调整片段数量。系统默认值为 3 。数值越高,预期被召回的文本分段数量越多。
静候分段嵌入过程...
3 完成上传
在应用内关联知识库并使用。
参考在应用内集成知识库,搭建出能基于知识库进行问答的 LLM 应用
如需修改或管理知识库,请参考知识库管理与文档维护
完成知识库的创建:
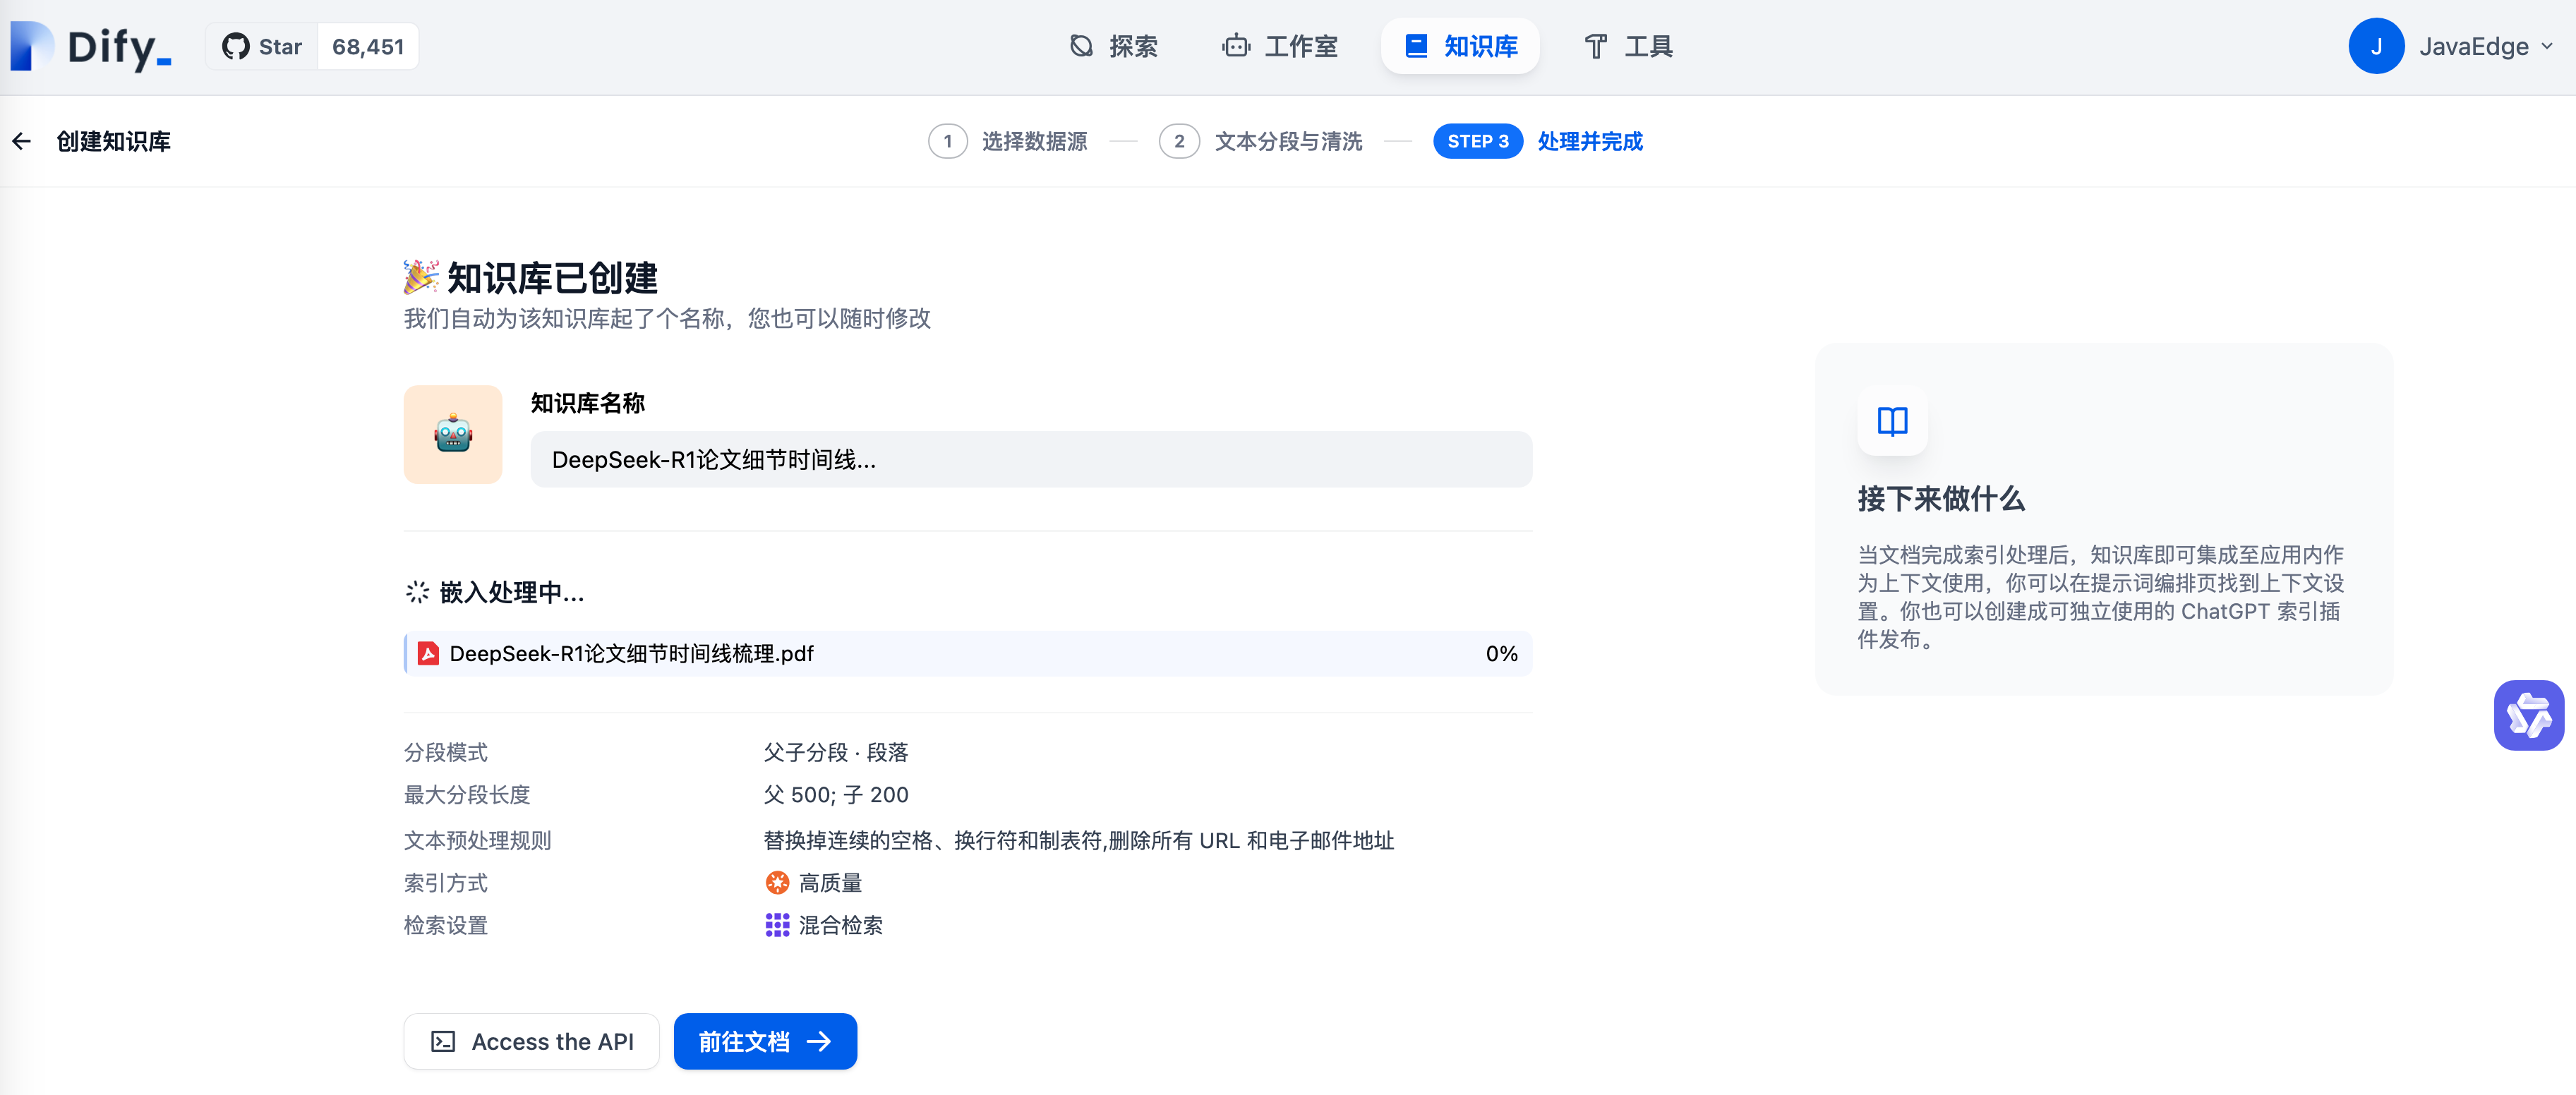
点击"前往文档":