大文件分片上传
说明:前后端文件分片上传逻辑代码,文中已贴。不是整体,需根据需要自行调整。
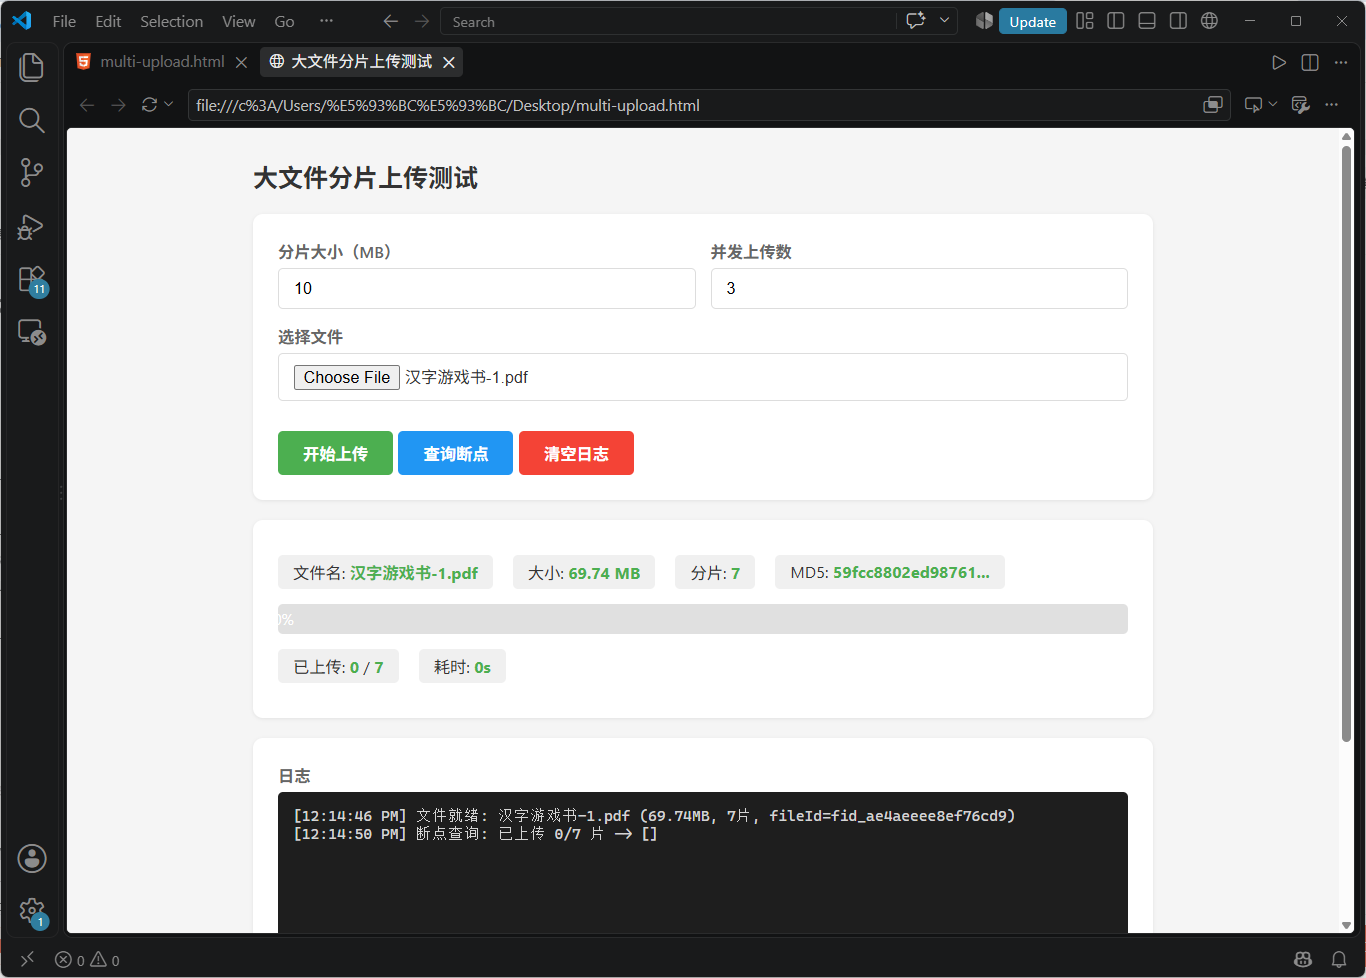
一、整体架构
Frontend                Gateway                     OSS/MinIO         Redis

┌──────────┐      ┌─────────────────────────┐      ┌──────────┐      ┌─────────┐
│  Browser │─────▶│  POST /api/upload/chunk  │─────▶│  PutObject│      │         │
│  (JS)    │      │  GET  /getUploadedChunks│      │  (临时前缀)│      │ SMembers│
│          │◀─────│  POST /api/upload/merge  │◀─────│  Compose  │      │ SAdd    │
└──────────┘      └─────────────────────────┘      └──────────┘      └─────────┘
                          │
                    CORS + Logger + RateLimit + Auth
存储后端抽象
| 组件 | 文件 | 职责 |
|---|---|---|
| Storage 接口 | common/chunkupload/storage.go |
5 方法抽象:GetUploadedChunks / ChunkExists / SaveChunk / MergeChunks / CleanExpiredRedis。编译期断言确保 minio + oss 都实现 |
| MinIO 后端 | common/chunkupload/uploadminio/ |
临时桶 + ComposeObject 合并,本地 dev 用 |
| OSS 后端 | common/chunkupload/uploadoss/ |
单 bucket + 前缀模型,UploadPartCopy 服务端拷贝合并,生产用 |
相关代码:
storage.go
go
package chunkupload

import (
	"context"
	"io"

	"mall/common/chunkupload/uploadminio"
	"mall/common/chunkupload/uploadoss"
)

// Storage 抽象分片上传的存储后端。uploadminio.Uploader 与 uploadoss.Uploader 均实现该接口。
// ServiceContext 按配置 Storage.Type 选择具体后端,gateway 业务逻辑(uploadChunkLogic)
// 只依赖此接口,后端切换对业务无感。
type Storage interface {
	// GetUploadedChunks 查询已上传分片下标(断点续传)。
	GetUploadedChunks(ctx context.Context, fileId string) ([]int, error)
	// ChunkExists 判断分片是否已上传(幂等去重)。
	ChunkExists(ctx context.Context, fileId string, chunkIndex int) (bool, error)
	// SaveChunk 保存单个分片到对象存储临时区 + Redis 记录索引。
	SaveChunk(ctx context.Context, fileId string, chunkIndex int, r io.Reader) error
	// MergeChunks 合并全部分片为最终文件并做整体 MD5 校验,返回最终对象名。
	MergeChunks(ctx context.Context, fileId string, totalChunks int, originFileName string, expectMd5 string) (string, error)
	// CleanExpiredRedis 清理过期元信息(对象存储侧用生命周期策略兜底)。
	CleanExpiredRedis(ctx context.Context) error
}

// 编译期断言:两个后端必须实现 Storage,方法签名漂移时编译即失败。
var (
	_ Storage = (*uploadminio.Uploader)(nil)
	_ Storage = (*uploadoss.Uploader)(nil)
)
uploader.go
go
package uploadoss

import (
	"context"
	"crypto/md5"
	"errors"
	"fmt"
	"io"
	"strconv"
	"time"

	"github.com/aliyun/aliyun-oss-go-sdk/oss"
)

// GetUploadedChunks 查询已上传分片下标(断点检查)。纯 Redis SMembers,逻辑与 uploadminio 一致。
func (u *Uploader) GetUploadedChunks(ctx context.Context, fileId string) ([]int, error) {
	key := u.cfg.RedisPrefix + fileId
	members, err := u.cfg.RedisClient.RDB().SMembers(ctx, key).Result()
	if err != nil {
		return nil, err
	}
	res := make([]int, 0, len(members))
	for _, s := range members {
		if idx, e := strconv.Atoi(s); e == nil {
			res = append(res, idx)
		}
	}
	return res, nil
}

// ChunkExists 判断分片是否已上传(Redis SIsMember)。
func (u *Uploader) ChunkExists(ctx context.Context, fileId string, chunkIndex int) (bool, error) {
	key := u.cfg.RedisPrefix + fileId
	return u.cfg.RedisClient.RDB().SIsMember(ctx, key, chunkIndex).Result()
}

// SaveChunk 保存分片到 OSS 单 bucket 的临时前缀下 + Redis 记录索引。
// 临时对象 key = TempPrefix + "{fileId}/{chunkIndex}.part",如 "mall-seckill-chunk-tmp/{fileId}/0.part"。
// Redis 写失败直接返回 err(与 uploadminio 行为一致),由 logic 层决定降级策略。
func (u *Uploader) SaveChunk(ctx context.Context, fileId string, chunkIndex int, r io.Reader) error {
	objName := u.cfg.TempPrefix + fmt.Sprintf("%s/%d.part", fileId, chunkIndex)
	bkt, err := u.cfg.OSSClient.Bucket(u.cfg.Bucket)
	if err != nil {
		return fmt.Errorf("resolve bucket: %w", err)
	}
	if err := bkt.PutObject(objName, r); err != nil {
		return err
	}

	key := u.cfg.RedisPrefix + fileId
	expDur := time.Hour * time.Duration(u.cfg.ExpireHour)
	pipe := u.cfg.RedisClient.RDB().Pipeline()
	pipe.SAdd(ctx, key, chunkIndex)
	pipe.Expire(ctx, key, expDur)
	_, err = pipe.Exec(ctx)
	return err
}

// MergeChunks 合并全部分片为最终文件(单 bucket 内跨前缀服务端拷贝)。
// OSS 无 MinIO ComposeObject,改走原生 Multipart Upload:
//  1. SetNX 锁防并发合并(60s,同 minio);
//  2. SMembers 校验分片完整;
//  3. InitiateMultipartUpload 发起合并(最终对象 key = FinalPrefix + originFileName);
//  4. 逐分片 UploadPartCopy(从临时前缀拷贝为 part,不下载重传);UploadPartCopy 走 CopySourceRange(start,size),需先 GetObjectMeta 取每片字节大小;
//  5. CompleteMultipartUpload 提交合并;
//  6. 整体 MD5 校验(下载最终对象流式 hash),不匹配删最终对象;
//  7. 批量 DeleteObjects 清理临时分片 + Del Redis。
//
// 任一分片拷贝失败立即 AbortMultipartUpload,避免遗留未完成的 multipart 资源计费。
// 返回最终对象 key(FinalPrefix + originFileName)。
func (u *Uploader) MergeChunks(ctx context.Context, fileId string, totalChunks int, originFileName string, expectMd5 string) (string, error) {
	lockKey := u.cfg.LockPrefix + fileId
	ok, err := u.cfg.RedisClient.RDB().SetNX(ctx, lockKey, "1", 60*time.Second).Result()
	if err != nil {
		return "", err
	}
	if !ok {
		return "", errors.New("file merging, please wait")
	}
	defer u.cfg.RedisClient.RDB().Del(ctx, lockKey)

	key := u.cfg.RedisPrefix + fileId
	members, err := u.cfg.RedisClient.RDB().SMembers(ctx, key).Result()
	if err != nil {
		return "", err
	}
	if len(members) != totalChunks {
		return "", errors.New("chunks not complete")
	}

	bkt, err := u.cfg.OSSClient.Bucket(u.cfg.Bucket)
	if err != nil {
		return "", fmt.Errorf("resolve bucket: %w", err)
	}

	finalObj := u.cfg.FinalPrefix + originFileName

	// 1. 发起 multipart upload
	imur, err := bkt.InitiateMultipartUpload(finalObj)
	if err != nil {
		return "", fmt.Errorf("initiate multipart: %w", err)
	}

	// 2. 逐分片服务端拷贝(同一 bucket 内跨前缀拷贝)
	parts := make([]oss.UploadPart, 0, totalChunks)
	tempObjKeys := make([]string, 0, totalChunks)
	for i := 0; i < totalChunks; i++ {
		srcKey := u.cfg.TempPrefix + fmt.Sprintf("%s/%d.part", fileId, i)
		tempObjKeys = append(tempObjKeys, srcKey)

		// 取分片字节大小(UploadPartCopy 的 CopySourceRange 需要精确 size)
		header, err := bkt.GetObjectMeta(srcKey)
		if err != nil {
			_ = bkt.AbortMultipartUpload(imur)
			return "", fmt.Errorf("get part meta idx=%d: %w", i, err)
		}
		size, err := strconv.ParseInt(header.Get("Content-Length"), 10, 64)
		if err != nil || size < 0 {
			_ = bkt.AbortMultipartUpload(imur)
			return "", fmt.Errorf("parse part size idx=%d: %w", i, err)
		}

		// partNumber 从 1 开始;startPosition=0 拷贝整片;源 bucket 即本 bucket
		part, err := bkt.UploadPartCopy(imur, u.cfg.Bucket, srcKey, 0, size, i+1)
		if err != nil {
			_ = bkt.AbortMultipartUpload(imur)
			return "", fmt.Errorf("upload part copy idx=%d: %w", i, err)
		}
		parts = append(parts, part)
	}

	// 3. 提交合并
	if _, err := bkt.CompleteMultipartUpload(imur, parts); err != nil {
		_ = bkt.AbortMultipartUpload(imur)
		return "", fmt.Errorf("complete multipart: %w", err)
	}

	// 4. 整体 MD5 校验:下载最终对象流式计算
	rc, err := bkt.GetObject(finalObj)
	if err != nil {
		_ = bkt.DeleteObject(finalObj)
		return "", fmt.Errorf("get merged object for md5: %w", err)
	}
	defer rc.Close()
	hash := md5.New()
	if _, err := io.Copy(hash, rc); err != nil {
		_ = bkt.DeleteObject(finalObj)
		return "", err
	}
	calcMd5 := fmt.Sprintf("%x", hash.Sum(nil))
	if calcMd5 != expectMd5 {
		_ = bkt.DeleteObject(finalObj)
		return "", errors.New("file md5 check failed")
	}

	// 5. 清理临时分片 + Redis;清理失败不阻断主流程(OSS 生命周期策略兜底)
	if _, err := bkt.DeleteObjects(tempObjKeys); err != nil {
		// 不返回错误:合并已成功,临时分片清理可由桶生命周期策略兜底
	}
	_ = u.cfg.RedisClient.RDB().Del(ctx, key).Err()

	return finalObj, nil
}

// CleanExpiredRedis 只清理 redis;OSS 临时前缀配生命周期策略自动删过期分片(同 uploadminio 做法)。
func (u *Uploader) CleanExpiredRedis(ctx context.Context) error {
	return nil
}
二、三个 HTTP 端点
| 端点 | 方法 | Content-Type | 鉴权 | 说明 |
|---|---|---|---|---|
/api/upload/chunk |
POST | multipart/form-data | Bearer JWT | 上传单个分片,返回已上传分片列表(断点续传) |
/api/upload/getUploadedChunks |
GET | --- | Bearer JWT | 查询已上传分片索引,前端跳过已传分片 |
/api/upload/merge |
POST | application/json | Bearer JWT | 合并全部分片为最终文件,MD5 校验 + 清理临时分片 |
请求/响应结构
json
// POST /api/upload/chunk (multipart/form-data)
fileId      = "fid_ae4aeeee8ef76cd9"   // 客户端生成,全分片一致
chunkIndex  = "0"                      // 从 0 开始
totalChunks = "7"
fileName    = "汉字游戏书-1.pdf"
fileMd5     = "59fcc8802ed9..."        // 整体文件 MD5,合并时校验
file        = <binary blob>           // 分片二进制

// Response
{"code":0,"msg":"ok","data":{"fileId":"...","chunkIndex":0,"uploaded":[0,1,3]}}

// POST /api/upload/merge (application/json)
{"fileId":"fid_ae4aeee...","totalChunks":7,"fileName":"汉字游戏书-1.pdf","fileMd5":"59fcc880..."}

// Response
{"code":0,"msg":"ok","data":{"fileId":"...","fileUrl":"mall-seckill-final/汉字游戏书-1.pdf"}}
鉴权
路由层叠加 AuthMiddleware,请求头需携带 Authorization: Bearer <access_token>。Logic 层二次取 auth.ClaimsFromContext(ctx) 做审计/隔离,claims 为 nil 返回 401。
三、完整上传时序
 前端                    网关                         OSS                      Redis
  │                       │                           │                          │
  │ ① 选择文件            │                           │                          │
  │ 计算 MD5 (SparkMD5    │                           │                          │
  │   流式 2MB 分片读取)  │                           │                          │
  │ 生成 fileId (SHA-256  │                           │                          │
  │   of name+size+mtime) │                           │                          │
  │                       │                           │                          │
  │ ② GET getUploadedChunks?fileId=xxx ──────────────────────────────▶ SMembers │
  │ ◀───────────────── 返回 [0,1,3] ────────────────────────────── 返回已上传 │
  │                       │                           │                          │
  │ ③ 跳过 0,1,3           │                           │                          │
  │   并发上传 2,4,5,6    │                           │                          │
  │   (并发度=3)          │                           │                          │
  │                       │                           │                          │
  │ POST chunk idx=2 ───▶ │                           │                          │
  │   (Bearer JWT)       │                           │                          │
  │                       │ ChunkExists ─────────────────────────────▶ SIsMember │
  │                       │ ◀── false ─────────────────────────────── 不存在    │
  │                       │ SaveChunk ────▶ PutObject("tmp/{fid}/2.part")        │
  │                       │ SAdd(fileId,2) ──────────────────────────▶ 记录索引  │
  │ ◀──── {uploaded:[0,1,2,3]} ─                                    │              │
  │                       │                           │                          │
  │ ④ 全部分片完成        │                           │                          │
  │ POST merge ─────────▶ │                           │                          │
  │   (Bearer JWT)       │                           │                          │
  │                       │ SetNX(merge_lock) ──────────────────────▶ 防并发合并  │
  │                       │ SMembers ──────────────────────────────▶ 完整性校验  │
  │                       │ InitiateMultipartUpload ─▶                            │
  │                       │ UploadPartCopy × N ──────▶ 服务端拷贝(不下载重传)   │
  │                       │ CompleteMultipartUpload ─▶ 合并                     │
  │                       │ GetObject + MD5 ─────────▶ 整体校验                  │
  │                       │ DeleteObjects ───────────▶ 清理临时分片             │
  │                       │ Del(fileId) ───────────────────────────▶ 清理 Redis │
  │ ◀──── {fileUrl:"final/xxx"} ─                                                  │
四、断点续传 & 幂等设计
| 机制 | 实现 | 场景 |
|---|---|---|
| fileId 稳定性 | 前端用 SHA-256(name+size+lastModified) 生成 fileId,同一文件多次上传复用同一 fileId | 用户中断后重选同一文件,已上传分片不重传 |
| 上传前查询 | GET /getUploadedChunks 返回 Redis SMembers 结果,前端跳过已上传分片 | 网络中断恢复后继续 |
| 分片级幂等 | SaveChunk 前先 SIsMember 检查,已存在直接返回成功 + 列表,不重复写 OSS | 前端重试同一分片不产生重复对象 |
| 合并并发锁 | MergeChunks 内 SetNX(60s TTL) 防多请求并发合并同一文件 | 用户连续点"合并"按钮 |
Redis 故障降级策略:ChunkExists 失败不阻断上传(记日志后继续 SaveChunk),保证可用性优先。GetUploadedChunks 失败返回空列表。遵循项目约束"Redis 写失败必须记日志,不静默忽略"。
五、OSS 后端关键设计
单 Bucket + 前缀模型
yaml
# gateway-api.yaml
Storage:
  Type: oss
  OSS:
    Bucket: "mall-hg"                      # 单 bucket
    TempPrefix: "mall-seckill-chunk-tmp/" # 临时分片前缀(必须含尾斜杠)
    FinalPrefix: "mall-seckill-final/"    # 最终文件前缀(必须含尾斜杠)

# 临时分片对象 key
mall-seckill-chunk-tmp/{fileId}/0.part
mall-seckill-chunk-tmp/{fileId}/1.part
...

# 最终文件对象 key
mall-seckill-final/汉字游戏书-1.pdf
合并流程(UploadPartCopy)
| 步骤 | OSS API | 说明 |
|---|---|---|
| 1. 发起 | InitiateMultipartUpload(finalObj) |
创建 multipart upload session |
| 2. 逐片拷贝 | UploadPartCopy(srcBucket, srcKey, range, partNum) |
服务端拷贝,不下载重传;先 GetObjectMeta 取每片字节大小 |
| 3. 提交 | CompleteMultipartUpload(parts) |
合并为最终对象 |
| 4. MD5 校验 | GetObject(finalObj) → io.Copy(md5.New) |
流式计算整体 MD5,不匹配删最终对象 |
| 5. 清理 | DeleteObjects(tempKeys[]) |
批量删除临时分片 |
失败回滚 :任一 UploadPartCopy 失败立即
AbortMultipartUpload,避免残留 multipart 资源计费。清理失败不阻断主流程(OSS 生命周期策略兜底)。
六、网关配置要点
yaml
MaxBytes: 16777216  # 16MB,与 handler maxChunkSize 对齐(go-zero 默认 1MB 会 413)
Timeout: 60000      # 60s,单分片上传到 OSS 耗时 2-3s(go-zero 默认 3s 会 503 误杀)

Storage:
  Type: oss
  OSS:
    Endpoint: "oss-cn-hangzhou.aliyuncs.com"
    AccessKey: "<RAM AccessKey>"
    SecretKey: "<RAM SecretKey>"           # 必须完整,尾随空格会导致签名不匹配
    Bucket: "mall-hg"
    TempPrefix: "mall-seckill-chunk-tmp/"  # 必须含尾斜杠
    FinalPrefix: "mall-seckill-final/"     # 字段名是 FinalPrefix 不是 FinalBucket
七、中间件链
| 顺序 | 中间件 | 职责 |
|---|---|---|
| 1 | CorsMiddleware | 处理浏览器 CORS 预检(OPTIONS)+ 实际请求跨域头 |
| 2 | LoggerMiddleware | 请求/响应日志,慢请求告警 |
| 3 | RateLimitMiddleware | 集群维度令牌桶限流(Redis 共享) |
| 4 | AuthMiddleware | JWT Bearer 鉴权,解析 claims 注入 context |
不叠加 BreakerMiddleware:上传走 OSS + Redis,无下游 RPC 调用,熔断无意义且 OSS 抖动会导致误熔断影响同组其他上传请求。
八、Handler 关键实现
UploadChunksHandler
go
package uploadfile

import (
	"errors"
	"net/http"
	"strconv"

	"github.com/zeromicro/go-zero/rest/httpx"
	"mall/gateway/internal/logic/uploadfile"
	"mall/gateway/internal/svc"
	"mall/gateway/internal/types"
)

// maxChunkSize 单分片大小上限 16MB:分片过大易导致网关内存峰值、MinIO PutObject 超时。
const maxChunkSize = 16 << 20

// UploadChunksHandler 大文件分片上传------单分片落 MinIO 临时 bucket + Redis 记录索引。
// 断点续传:Uploader.ChunkExists 命中则直接返回已上传列表,不重复写。
// 本端点不需要鉴权(路由层无 AuthMiddleware)。
//
// 不用 httpx.Parse:它会对 multipart body 做二次解析,与已 ParseMultipartForm 的 body 争用,
// 导致 r.FormFile("file") 取不到分片文件。改用 r.FormValue 直接取已解析的 form 字段。
func UploadChunksHandler(svcCtx *svc.ServiceContext) http.HandlerFunc {
	return func(w http.ResponseWriter, r *http.Request) {
		// multipart 解析:限速单分片体积,避免单请求 OOM
		if err := r.ParseMultipartForm(maxChunkSize); err != nil {
			httpx.ErrorCtx(r.Context(), w, err)
			return
		}

		// 分片二进制走 form 字段 "file",必须在 ParseMultipartForm 之后取
		file, _, err := r.FormFile("file")
		if err != nil {
			httpx.ErrorCtx(r.Context(), w, err)
			return
		}
		defer file.Close()

		// 直接从已解析的 form 取元信息,避免 httpx.Parse 二次解析 body
		chunkIndex, err := strconv.Atoi(r.FormValue("chunkIndex"))
		if err != nil {
			httpx.ErrorCtx(r.Context(), w, errors.New("chunkIndex 参数错误"))
			return
		}
		totalChunks, err := strconv.Atoi(r.FormValue("totalChunks"))
		if err != nil {
			httpx.ErrorCtx(r.Context(), w, errors.New("totalChunks 参数错误"))
			return
		}

		req := types.ChunksReq{
			FileId:      r.FormValue("fileId"),
			ChunkIndex:  chunkIndex,
			TotalChunks: totalChunks,
			FileName:    r.FormValue("fileName"),
			FileMd5:     r.FormValue("fileMd5"),
		}

		l := uploadfile.NewUploadChunkLogic(r.Context(), svcCtx)
		resp, err := l.UploadChunk(&req, file)
		if err != nil {
			httpx.ErrorCtx(r.Context(), w, err)
		} else {
			httpx.OkJsonCtx(r.Context(), w, resp)
		}
	}
}

// MergeChunksHandler 合并全部分片为最终文件(application/json)。
// 全部分片上传完成后由前端发起,Uploader.MergeChunks 内部完成
// 分布式锁 + 完整性校验 + ComposeObject 合并 + 整体 MD5 校验 + 临时分片清理。
func MergeChunksHandler(svcCtx *svc.ServiceContext) http.HandlerFunc {
	return func(w http.ResponseWriter, r *http.Request) {
		var req types.ChunkMergeReq
		if err := httpx.Parse(r, &req); err != nil {
			httpx.ErrorCtx(r.Context(), w, err)
			return
		}

		l := uploadfile.NewUploadChunkLogic(r.Context(), svcCtx)
		resp, err := l.MergeChunks(&req)
		if err != nil {
			httpx.ErrorCtx(r.Context(), w, err)
		} else {
			httpx.OkJsonCtx(r.Context(), w, resp)
		}
	}
}

//获取已上传的分片列表
func GetallUploadedChunksHandler(svcCtx *svc.ServiceContext) http.HandlerFunc {
	return func(w http.ResponseWriter, r *http.Request) {
		fileId := r.URL.Query().Get("fileId")
		if fileId == "" {
			httpx.ErrorCtx(r.Context(), w, errors.New("fileId is required"))
			return
		}

		l := uploadfile.NewUploadChunkLogic(r.Context(), svcCtx)
		resp := l.GetAllUploadedChunks(fileId)
		httpx.OkJsonCtx(r.Context(), w, resp)
	}
}
UploadChunkLogic
go
package uploadfile

import (
	"context"
	"io"
	"time"

	"go.uber.org/zap"

	"mall/common/logger"
	"mall/gateway/internal/auth"
	"mall/gateway/internal/svc"
	"mall/gateway/internal/types"
)

type UploadChunkLogic struct {
	*zap.SugaredLogger
	ctx    context.Context
	svcCtx *svc.ServiceContext
}

func NewUploadChunkLogic(ctx context.Context, svcCtx *svc.ServiceContext) *UploadChunkLogic {
	return &UploadChunkLogic{
		SugaredLogger: logger.WithContext(ctx),
		ctx:           ctx,
		svcCtx:        svcCtx,
	}
}

// UploadChunk 保存单个分片:
//  1. 鉴权(路由层 AuthMiddleware 已校验,这里二次取 claims 用于审计/隔离);
//  2. 参数校验(防越界 chunkIndex 与空 fileId);
//  3. 幂等:分片已存在直接返回成功 + 已上传列表(断点续传);
//  4. SaveChunk 落 MinIO 临时 bucket + Redis 记录分片索引;
//  5. 返回最新已上传分片列表。
//
// Redis 故障降级:ChunkExists 失败不阻断上传(仅记日志后继续),保证可用性优先;
// GetUploadedChunks 失败则返回空列表,不阻断主流程。
func (l *UploadChunkLogic) UploadChunk(req *types.ChunksReq, reader io.Reader) (*types.ChunksResp, error) {
	claims := auth.ClaimsFromContext(l.ctx)
	if claims == nil {
		return &types.ChunksResp{Code: 401, Msg: "未认证"}, nil
	}

	// 参数校验:fileId 必填、chunkIndex 必须落在 [0, totalChunks) 内
	if req.FileId == "" || req.TotalChunks <= 0 || req.ChunkIndex < 0 || req.ChunkIndex >= req.TotalChunks {
		return &types.ChunksResp{Code: 400, Msg: "参数错误"}, nil
	}

	// 幂等:分片已存在则跳过重复上传,返回断点续传列表
	if exists, err := l.svcCtx.Uploader.ChunkExists(l.ctx, req.FileId, req.ChunkIndex); err != nil {
		// Redis 故障降级:记录日志后继续上传,不阻断主流程(可用性优先)
		l.Errorf("check chunk exists error: fileId=%s idx=%d err=%v", req.FileId, req.ChunkIndex, err)
	} else if exists {
		uploaded, _ := l.svcCtx.Uploader.GetUploadedChunks(l.ctx, req.FileId)
		return &types.ChunksResp{
			Code: 0,
			Msg:  "chunk already exists",
			Data: types.ChunksData{
				FileId:     req.FileId,
				ChunkIndex: req.ChunkIndex,
				Uploaded:   uploaded,
			},
		}, nil
	}

	// 保存分片到 MinIO 临时 bucket + Redis 记录索引
	if err := l.svcCtx.Uploader.SaveChunk(l.ctx, req.FileId, req.ChunkIndex, reader); err != nil {
		l.Errorf("save chunk error: fileId=%s idx=%d err=%v", req.FileId, req.ChunkIndex, err)
		return nil, err
	}

	// 返回最新已上传分片列表;GetUploadedChunks 失败则降级空列表,不阻断主流程
	uploaded, err := l.svcCtx.Uploader.GetUploadedChunks(l.ctx, req.FileId)
	if err != nil {
		l.Errorf("get uploaded chunks error: fileId=%s err=%v", req.FileId, err)
		uploaded = []int{}
	}

	return &types.ChunksResp{
		Code: 0,
		Msg:  "ok",
		Data: types.ChunksData{
			FileId:     req.FileId,
			ChunkIndex: req.ChunkIndex,
			Uploaded:   uploaded,
		},
	}, nil
}

// MergeChunks 合并全部分片为最终文件:
//  1. 鉴权(路由层 AuthMiddleware 已校验,这里二次取 claims 用于审计);
//  2. 参数校验(fileId 必填、totalChunks > 0、fileName 与 fileMd5 必填);
//  3. 委托 Uploader.MergeChunks:内部含分布式锁(防并发合并)、分片完整性校验、
//     ComposeObject 合并、整体 MD5 校验、临时分片 + Redis 清理。
//
// 幂等说明:MergeChunks 内部用 SetNX 锁防并发;但合并成功后临时分片与 Redis 已清理,
// 重试会得到 "chunks not complete"。此处不再额外做 final bucket 存在性探测,
// 前端遇到该错误应视为"可能已合并成功"而非重传全部分片。
func (l *UploadChunkLogic) MergeChunks(req *types.ChunkMergeReq) (*types.ChunkMergeResp, error) {
	claims := auth.ClaimsFromContext(l.ctx)
	if claims == nil {
		return &types.ChunkMergeResp{Code: 401, Msg: "未认证"}, nil
	}

	// 参数校验
	if req.FileId == "" || req.TotalChunks <= 0 || req.FileName == "" || req.FileMd5 == "" {
		return &types.ChunkMergeResp{Code: 400, Msg: "参数错误"}, nil
	}

	// 外部调用加超时保护,防止 MinIO ComposeObject 在大文件场景长时间阻塞 goroutine
	ctx, cancel := context.WithTimeout(l.ctx, 5*60*time.Second)
	defer cancel()

	finalObj, err := l.svcCtx.Uploader.MergeChunks(ctx, req.FileId, req.TotalChunks, req.FileName, req.FileMd5)
	if err != nil {
		l.Errorf("merge chunks error: fileId=%s total=%d err=%v", req.FileId, req.TotalChunks, err)
		return nil, err
	}

	return &types.ChunkMergeResp{
		Code: 0,
		Msg:  "ok",
		Data: types.ChunkMergeData{
			FileId:  req.FileId,
			FileUrl: finalObj,
		},
	}, nil
}

func (l *UploadChunkLogic) GetAllUploadedChunks(fileId string) *types.ChunksResp {
	uploaded, _ := l.svcCtx.Uploader.GetUploadedChunks(l.ctx, fileId)
	return &types.ChunksResp{
			Code: 0,
			Msg:  "chunk already exists",
			Data: types.ChunksData{
				FileId:     fileId,
				Uploaded:   uploaded,
			},
		}
}
九、前端核心逻辑
| 步骤 | 实现 | 关键点 |
|---|---|---|
| 文件选择 | change 事件 → 计算 MD5 + 生成 fileId + 算分片数 | SparkMD5 流式 2MB 读取,避免大文件一次性加载内存 |
| 分片大小变更 | input 事件 → 重算 totalChunks + 清空 uploadedSet | 旧分片边界失效,断点续传不再适用 |
| 开始上传 | 先查断点 → 找 pending 分片 → 并发上传 → 合并 | workerIdx 每次上传前重置=0 |
| 并发控制 | N 个 worker 从 pending 队列取分片,JS 单线程无竞态 | 默认并发度=3,可配 |
| 鉴权 | 每个请求头携带 Authorization: Bearer <token> |
token 从登录接口获取 |
| 错误处理 | resp.ok 检查 + resp.text() 兜底非 JSON 响应 |
超时/503 返回纯文本,不能直接 .json() |
十、前端代码
html
<!DOCTYPE html>
<html lang="zh-CN">

<head>
    <meta charset="UTF-8">
    <title>大文件分片上传测试</title>
    <style>
        * {
            margin: 0;
            padding: 0;
            box-sizing: border-box;
        }

        body {
            font-family: -apple-system, "Segoe UI", sans-serif;
            background: #f5f5f5;
            padding: 24px;
            color: #333;
        }

        .container {
            max-width: 720px;
            margin: 0 auto;
        }

        h1 {
            font-size: 20px;
            margin-bottom: 16px;
        }

        .card {
            background: #fff;
            border-radius: 8px;
            padding: 20px;
            margin-bottom: 16px;
            box-shadow: 0 1px 3px rgba(0, 0, 0, .08);
        }

        label {
            display: block;
            font-size: 13px;
            color: #666;
            margin-bottom: 4px;
            font-weight: 600;
        }

        input[type="text"],
        input[type="file"],
        input[type="number"] {
            width: 100%;
            padding: 8px 12px;
            border: 1px solid #ddd;
            border-radius: 4px;
            font-size: 13px;
            margin-bottom: 12px;
        }

        .row {
            display: flex;
            gap: 12px;
        }

        .row>div {
            flex: 1;
        }

        button {
            padding: 8px 20px;
            border: none;
            border-radius: 4px;
            cursor: pointer;
            font-size: 13px;
            font-weight: 600;
        }

        .btn-primary {
            background: #4CAF50;
            color: #fff;
        }

        .btn-primary:disabled {
            background: #ccc;
            cursor: not-allowed;
        }

        .btn-secondary {
            background: #2196F3;
            color: #fff;
        }

        .btn-danger {
            background: #f44336;
            color: #fff;
        }

        .progress-bar {
            width: 100%;
            height: 24px;
            background: #e0e0e0;
            border-radius: 4px;
            overflow: hidden;
            margin: 12px 0;
        }

        .progress-fill {
            height: 100%;
            background: #4CAF50;
            transition: width .3s;
            display: flex;
            align-items: center;
            justify-content: center;
            font-size: 12px;
            color: #fff;
        }

        #log {
            width: 100%;
            height: 240px;
            background: #1e1e1e;
            color: #d4d4d4;
            padding: 12px;
            border-radius: 4px;
            font-family: "Cascadia Code", Consolas, monospace;
            font-size: 12px;
            overflow-y: auto;
            white-space: pre-wrap;
        }

        .stats {
            display: flex;
            gap: 16px;
            font-size: 13px;
            margin: 8px 0;
            flex-wrap: wrap;
        }

        .stat {
            padding: 4px 12px;
            background: #f0f0f0;
            border-radius: 4px;
        }

        .stat b {
            color: #4CAF50;
        }
    </style>
</head>

<body>
    <div class="container">
        <h1>大文件分片上传测试</h1>

        <div class="card">
            <div class="row">
                <div>
                    <label>分片大小(MB)</label>
                    <input type="number" id="chunkSize" value="5" min="1" max="16" />
                </div>
                <div>
                    <label>并发上传数</label>
                    <input type="number" id="concurrency" value="3" min="1" max="10" />
                </div>
            </div>

            <label>选择文件</label>
            <input type="file" id="file" />

            <div style="margin-top:12px;">
                <button class="btn-primary" id="startBtn" disabled>开始上传</button>
                <button class="btn-secondary" id="resumeBtn" disabled>查询断点</button>
                <button class="btn-danger" id="clearBtn">清空日志</button>
            </div>
        </div>

        <div class="card">
            <div class="stats">
                <div class="stat">文件名: <b id="statName">-</b></div>
                <div class="stat">大小: <b id="statSize">-</b></div>
                <div class="stat">分片: <b id="statChunks">-</b></div>
                <div class="stat">MD5: <b id="statMd5">-</b></div>
            </div>
            <div class="progress-bar">
                <div class="progress-fill" id="progress" style="width:0%">0%</div>
            </div>
            <div class="stats">
                <div class="stat">已上传: <b id="statUploaded">0</b> / <b id="statTotal">0</b></div>
                <div class="stat">耗时: <b id="statTime">0s</b></div>
            </div>
        </div>

        <div class="card">
            <label>日志</label>
            <div id="log"></div>
        </div>
    </div>

    <!-- SparkMD5 用于流式计算大文件 MD5 -->
    <script src="https://cdn.jsdelivr.net/npm/spark-md5@3.0.2/spark-md5.min.js"></script>
    <script>
        const API_BASE = "http://0.0.0.0:8888";
        const $ = id => document.getElementById(id);

        let currentFile = null;
        let currentFileId = null;
        let currentMd5 = null;
        let totalChunks = 0;
        let chunkSize = 5 * 1024 * 1024; // 5MB
        let uploadedSet = new Set();
        let startTime = 0;
        let timerId = null;

        // ---- 日志 ----
        function log(msg) {
            const time = new Date().toLocaleTimeString();
            $("log").innerHTML += `[${time}] ${msg}\n`;
            $("log").scrollTop = $("log").scrollHeight;
        }
        function updateTimer() {
            const sec = ((Date.now() - startTime) / 1000).toFixed(1);
            $("statTime").textContent = sec + "s";
        }
        function updateProgress() {
            const pct = totalChunks > 0 ? (uploadedSet.size / totalChunks * 100).toFixed(1) : 0;
            $("progress").style.width = pct + "%";
            $("progress").textContent = pct + "%";
            $("statUploaded").textContent = uploadedSet.size;
        }

        $("clearBtn").onclick = () => { $("log").innerHTML = ""; };

        // ---- 文件选择 ----
        $("file").addEventListener("change", async (e) => {
            currentFile = e.target.files[0];
            if (!currentFile) return;

            const sizeMB = (currentFile.size / 1024 / 1024).toFixed(2);
            $("statName").textContent = currentFile.name;
            $("statSize").textContent = sizeMB + " MB";

            // 生成本次上传的唯一 fileId(同一文件重传用同一个 fileId 才能断点续传)
            currentFileId = await generateFileId(currentFile);
            $("statMd5").textContent = "计算中...";

            // 先算分片数
            chunkSize = parseInt($("chunkSize").value) * 1024 * 1024;
            totalChunks = Math.ceil(currentFile.size / chunkSize);
            $("statChunks").textContent = totalChunks;
            $("statTotal").textContent = totalChunks;

            // 计算整体 MD5(异步,不阻塞 UI)
            computeFileMd5(currentFile).then(md5 => {
                currentMd5 = md5;
                $("statMd5").textContent = md5.substring(0, 16) + "...";
                $("startBtn").disabled = false;
                $("resumeBtn").disabled = false;
                log(`文件就绪: ${currentFile.name} (${sizeMB}MB, ${totalChunks}片, fileId=${currentFileId})`);
            });
        });

        // 分片大小变化时重算分片数(文件已选则同步更新)
        $("chunkSize").addEventListener("input", () => {
            if (!currentFile) return;
            chunkSize = parseInt($("chunkSize").value) * 1024 * 1024;
            if (chunkSize <= 0) return;
            totalChunks = Math.ceil(currentFile.size / chunkSize);
            $("statChunks").textContent = totalChunks;
            $("statTotal").textContent = totalChunks;
            // 重置已上传进度(分片大小变了,之前的断点失效)
            uploadedSet.clear();
            workerIdx = 0;
            updateProgress();
            log(`分片大小变更: ${$("chunkSize").value}MB → ${totalChunks} 片(已重置进度)`);
        });

        // 用文件名+大小+修改时间生成稳定 fileId(同一文件重传可复用断点)
        async function generateFileId(file) {
            const info = `${file.name}-${file.size}-${file.lastModified}`;
            const buf = new TextEncoder().encode(info);
            const hash = await crypto.subtle.digest("SHA-256", buf);
            return "fid_" + Array.from(new Uint8Array(hash)).slice(0, 8).map(b => b.toString(16).padStart(2, "0")).join("");
        }

        // 流式计算大文件 MD5(分片读取,避免一次性加载到内存)
        async function computeFileMd5(file) {
            return new Promise((resolve) => {
                const spark = new SparkMD5.ArrayBuffer();
                const reader = new FileReader();
                let offset = 0;
                const readSize = 2 * 1024 * 1024; // 每次读 2MB

                reader.onload = (e) => {
                    spark.append(e.target.result);
                    offset += e.target.result.byteLength;
                    if (offset < file.size) {
                        readNext();
                    } else {
                        resolve(spark.end());
                    }
                };
                function readNext() {
                    const slice = file.slice(offset, offset + readSize);
                    reader.readAsArrayBuffer(slice);
                }
                readNext();
            });
        }

        $("resumeBtn").onclick = async () => {
            if (!currentFile) return;
            const uploaded = await checkUploaded(currentFileId);
            uploadedSet = new Set(uploaded);
            log(`断点查询: 已上传 ${uploaded.length}/${totalChunks} 片 -> [${uploaded.join(", ")}]`);
            updateProgress();
        };

       // ---- 开始上传 ----
        $("startBtn").onclick = async () => {
            try {
            if (!currentFile || !currentMd5) { log("ERROR: 文件未就绪"); return; }

            $("startBtn").disabled = true;
            startTime = Date.now();
            timerId = setInterval(updateTimer, 1000);
            // 1. 先查断点
            log("步骤1: 查询已上传分片...");
            const uploaded = await checkUploaded(currentFileId);
            uploadedSet = new Set(uploaded);
            log(`断点: 已上传 ${uploadedSet.size}/${totalChunks}`);
            updateProgress();

            // 2. 找出待上传的分片
            const pending = [];
            for (let i = 0; i < totalChunks; i++) {
                if (!uploadedSet.has(i)) pending.push(i);
            }
            log(`步骤2: 待上传 ${pending.length} 片,开始并发上传...`);

            // 3. 并发上传(去掉 Authorization 头,路由已不需鉴权)
            const concurrency = parseInt($("concurrency").value) || 3;
            workerIdx = 0;  // 每次上传前重置
            const workers = [];
            for (let w = 0; w < concurrency; w++) {
                workers.push(uploadWorker(pending));
            }
            await Promise.all(workers);

            log(`步骤3: 全部分片上传完成 (${uploadedSet.size}/${totalChunks})`);

            // 4. 合并
            log("步骤4: 发起合并请求...");
            await mergeChunks();

            clearInterval(timerId);
            updateTimer();
            $("startBtn").disabled = false;
            } catch (e) {
                 log("JS异常: " + e.message);
                console.error(e);
                $("startBtn").disabled = false;
            }
        };

        // 并发上传 worker
        let workerIdx = 0;
        async function uploadWorker(pending) {
            while (workerIdx < pending.length) {
                const chunkIdx = pending[workerIdx];
                workerIdx++;

                const start = chunkIdx * chunkSize;
                const end = Math.min(start + chunkSize, currentFile.size);
                const blob = currentFile.slice(start, end);

                const formData = new FormData();
                formData.append("fileId", currentFileId);
                formData.append("chunkIndex", chunkIdx);
                formData.append("totalChunks", totalChunks);
                formData.append("fileName", currentFile.name);
                formData.append("fileMd5", currentMd5);
                formData.append("file", blob, `${currentFile.name}.part${chunkIdx}`);

                log(`  ↑ 分片 ${chunkIdx}/${totalChunks} 上传中...`);
                try {
                    const resp = await fetch(`${API_BASE}/api/upload/chunk`, {
                        method: "POST",
                        body: formData  // 不带 headers,multipart/form-data 是简单请求,不触发 CORS 预检
                    });
                    if (!resp.ok) {
                        const text = await resp.text();
                        throw new Error(`HTTP ${resp.status}: ${text.substring(0, 200)}`);
                    }
                    const data = await resp.json();
                    if (data.code !== 0) {
                        log(`  ✗ 分片${chunkIdx}失败: ${data.msg}`);
                        throw new Error(`chunk ${chunkIdx} failed: ${data.msg}`);
                    }
                    uploadedSet.add(chunkIdx);
                    if (data.data.uploaded) {
                        data.data.uploaded.forEach(i => uploadedSet.add(i));
                    }
                    updateProgress();
                    log(`  ✓ 分片 ${chunkIdx}/${totalChunks} 完成`);
                } catch (err) {
                    log(`  ✗ 分片${chunkIdx}: ${err.message}`);
                    throw err;
                }
            }
        }

        // 查询断点
        async function checkUploaded(fileId) {
            const resp = await fetch(`${API_BASE}/api/upload/getUploadedChunks?fileId=${encodeURIComponent(fileId)}`);
            const data = await resp.json();
            if (data.code !== 0) {
                log(`查询断点失败: ${data.msg}`);
                return [];
            }
            return data.data.uploaded || [];
        }

        // 合并
        async function mergeChunks() {
    const resp = await fetch(`${API_BASE}/api/upload/merge`, {
        method: "POST",
        headers: { "Content-Type": "application/json" },
        body: JSON.stringify({
            fileId: currentFileId,
            totalChunks: totalChunks,
            fileName: currentFile.name,
            fileMd5: currentMd5
        })
    });
    const data = await resp.json();
    if (data.code === 0) {
        log(`✅ 合并成功! 最终对象: ${data.data.fileUrl}`);
    } else {
        log(`❌ 合并失败: ${data.msg}`);
    }
}
    </script>
</body>

</html>