RLVR 里最贵的不是梯度更新,是采样:一个训练步里有 78%--87% 的墙钟时间花在 rollout 上。但这条昂贵的 rollout 有两种死法------第一种,它压根没产生任何梯度(一组 rollout 奖励全一样,组归一化把优势算成了 0);第二种,它产生了梯度,却被 PPO/GRPO 的裁剪机制按错误的权重喂给了模型:该学的正确解被饿死,该压的错误解主导更新。最近两篇论文各自补了一个洞,而且补的位置完全不同------一个是"信号生成",一个是"信号加权"。
一、先算清这笔账:为什么必须复用 rollout
RLVR(Reinforcement Learning from Verifiable Rewards,可验证奖励强化学习)的标准循环长这样:
采样 π_old 生成 G 条回答 → 验证器打分 → 组归一化算优势 → 策略梯度更新 → π_θ 前进一步问题在这个循环的第一步。前沿模型的一条长思维链动辄上万 token,而策略一次更新只往前挪一小步。根据 SRD 论文实测的单步墙钟分解,rollout 阶段占到整个训练步的 78%--87%(不同配置的 s/step 从 197 到 279 秒不等);另有中文技术报道给出"在线 on-policy 采样消耗集群 80% 以上算力"的说法,量级一致。
于是工程上的选择只有一个:把同一批 rollout 复用于多次更新。这在 RLVR 系统里是标准做法------DAPO、verl 都支持把一个 rollout 批切成若干个 mini-batch 连续更新。代价是数据立刻变成 off-policy:当前策略 π_θ 已经不再是生成它的 π_old。
从这里往后,账就分成了两笔,而且两笔各漏各的。
| 漏点 | 发生位置 | 直接原因 | 后果 | 谁在补 |
|---|---|---|---|---|
| ① 信号归零 | 优势估计 | 组归一化要求组内奖励有方差,全同则归零 | 这条 rollout 一个梯度都不贡献 | SRD(arXiv:2610.08077) |
| ② 信号错配 | 重要性加权 | off-policy 漂移 + 裁剪对正/负优势不对称 | 正确解被压制,错误解被放大 | ReSPO(arXiv:2609.35433) |
二、漏点①:一组全对或全错,梯度就是零
2.1 数学上是干脆的:这一项恒等于零
GRPO 的组归一化优势是:
scss
Â(τᵢ) = (rᵢ − mean_j r_j) / (std_j r_j + ε)如果一个 prompt 的 G 条 rollout 奖励全部相同 ------全 0 或全 1------那么分子为 0、分母为 0,标准实现对这组直接输出 Â ≡ 0。这是逐点为零,不是"数值很小":任何标量缩放都救不回来。
这不是边缘情况。一个大小为 G 的组,其奖励"混合"(可用)的概率是:
css
q_G(p) = 1 − p^G − (1−p)^G p = 该 prompt 的成功率这个函数在 p = 0.5 时最大,在 p → 0(太难)和 p → 1(太简单)两端都塌向 0。模型太弱学不会,模型太强全做对,两头都没有对比度。
2.2 实测:这道坎比你想象的厚得多
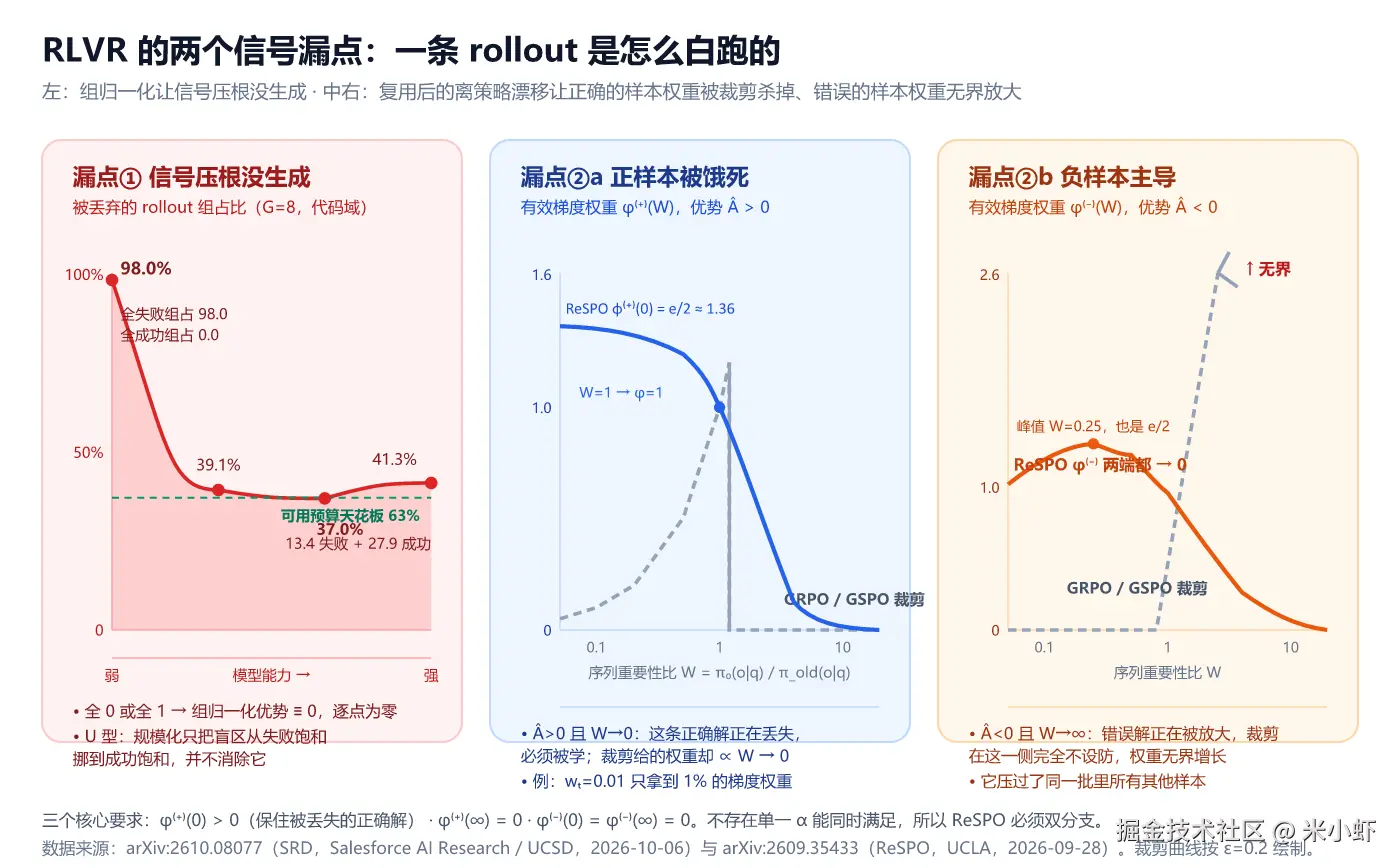
SRD 论文在代码域关闭动态采样,跨四个 Qwen3.5 规模统计了 rollout 组的构成,结果很难看:
| 模型规模(弱 → 强) | 被丢弃的组占比 | 其中全失败 | 其中全成功 |
|---|---|---|---|
| 最小规模 | 98.0% | 98.0 | 0.0 |
| ↑ | 39.1% | --- | --- |
| ↑ | 37.0% | --- | --- |
| 最大规模 | 41.3% | 13.4 | 27.9 |
三条要命的事实:
- 可用预算的天花板只有 63%。也就是说,哪怕你选择了最好的模型规模,仍有 37% 的采样预算连一个梯度都换不到。
- 丢弃占比是 U 型的,不是单调下降的。随着策略变强,全失败组从 98.0 单调降到 13.4,但全成功组同步从 0.0 涨到 27.9 ------ 规模化不会消灭这个盲区,只是把它从"失败饱和"挪到"成功饱和"。
- 理论下限被打穿了 。若假设题目难度均质,G=8 时任何 p ∈ 0.3, 0.7 的成功率预测丢弃率不到 6%;而实测地板是 37%。由凸性,这个超额部分证明了任务层面的异质性------真实训练集里总有大批"对当前模型而言太难或太简单"的题。
2.3 极限情形:RLVR 直接训练失败
在最小的 2B 规模上,98% 的组是全失败。结果是:纯粹 RLVR 的训练峰值成功率只有 1.6%,最终收敛到 0.0% ------跑了完整预算,模型一个字没学到。同样的采样预算,加上 SRD 之后是 60.6%。
从样本复杂度看这也是结构性的:估计奖励方向到相对误差 ε² 需要 n_R = Ω((G·π(p)·ε²)^-1) 个组(π(p) = min{p, 1−p}),因为它只活在"混合结果"这个事件上;而事后(prospective)方向是 n_H = O(1 + (G_eff·ε²)^-1),不背 π(p)^-1 这项门控代价。模型越接近两端,这个差距放大得越狠。
三、漏点②:同一批 rollout 复用多次,梯度就被喂歪了
3.1 重要性比的四个象限
当同一批 rollout 被复用于 N 次更新后,序列重要性比
scss
W = π_θ(o | q) / π_old(o | q)就开始偏离 1。W 小说明这条响应在漂移后变得"不太可能生成"了;W 大说明变得"太可能生成"了。 把优势符号的正负和 W 的两侧交叉,得到四个象限,每个象限的正确处理方式都不一样:
| W → 0(当前策略下更不可能) | W → ∞(当前策略下更可能) | |
|---|---|---|
| Â > 0 正样本 | ↑ 必须保留:正确解正在被丢失 | ↓ 已强化过了,不必再推 |
| Â < 0 负样本 | ↓ 已抑制了,不必再压 | ↓ 必须压制:错误解正在被放大 |
3.2 而 GRPO/GSPO 的裁剪,正好!反着来
在未被裁剪的区域内,GRPO 和 GSPO 的梯度幅值都和 ρ 成线性关系:
c
∇J_GRPO ∝ Â · w_t · ∇log π_θ问题出在两侧:
- 正样本被饿死(starved positive update) :Â > 0 且 W → 0 时,梯度权重 ∝ ρ → 0。论文举的例子很直白------
w_t = 0.01的样本相比w_t = 1只拿到 百分之一 的权重。这些恰恰是长而稀有、但在策略漂移后概率略微下降的正确推理轨迹。模型在训练早期就把它们当噪声扔了。 - 负样本主导(dominating negative update) :Â < 0 且 W → ∞ 的一侧,裁剪对这一侧 完全不设防,权重无界增长。严重过生成的错误轨迹在多轮 off-policy 更新里压过所有其他样本。
把尾极限写成表,几种做法的差别一目了然(元组是 (W→0, W→∞) 的极限值):
| 方法 | φ⁽⁺⁾(正样本权重) | φ⁽⁻⁾(负样本权重) |
|---|---|---|
| Clipping(GRPO / GSPO) | (0, 0) | (0, ∞) ← 发散 |
| VESPO | (0, 0) ← 也饿死正样本 | (0, 0) |
| ReSPO | (1.36, 0) | (0, 0) |
注意 VESPO 把负样本两端都修好了,却在 W→0 处把正样本一起饿死------问题只修了一半。不存在单一参数能同时满足正负两侧的需求,所以必须做双分支。
四、补丁 A:ReSPO 用 α-散度重塑加权核
4.1 从"换核"而不是"裁剪"出发
ReSPO 的思路很干净:不裁剪,而是把重要性比 W 换成一个核函数 φ(W),让 φ 自己长出需要的尾部形状。推导分两步。
第一步:α-散度变分目标。 在两个极端之间做邻近插值------β=0 回到行为策略 μ(零方差但有偏),β=1 走向当前策略 π(无偏但高方差):
scss
min_τ (1−β)·D_f(τ‖μ) + β·D_f(τ‖π)取 α-散度的 Bregman 生成元 f(x) = x^α / (α(α−1)),一阶条件解出无约束核:
scss
φ₀(W) = [ (1−β) + β·W^(α−1) ]^(1/(α−1))第二步:指数方差倾斜。 为控制二阶矩,把 τ₀* 在 KL 几何下投影到矩约束集上,KKT 给出乘性 tilt:
scss
φ(W) = φ₀(W) · exp( λ·(1 − φ₀(W)) )这一步把"硬边界"换成了"平滑惩罚"------这正是它比硬裁剪稳的原因。
4.2 两个分支的具体形状
取 β=0.5、λ=2(由 φ′(0)=0 与两侧斜率连续的解析条件定出):
scss
φ⁽⁺⁾(W) = ((1+W)/2) · exp(1−W)      ← α⁽⁺⁾ = 2 使得 power-mean 退化为算术平均
φ⁽⁻⁾(W) = √W · exp( 2·(1−√W) )      ← α⁽⁻⁾ = 1 的连续极限
性质非常漂亮:
- 正分支 φ⁽⁺⁾(0) = e/2 ≈ 1.36:即使重要性比小到几乎为零,这个正确解依然拿到比"正常权重的 1.36 倍"还多的梯度系数。并且对 W>0 严格递减,φ⁽⁺⁾(∞)=0。
- 负分支 φ⁽⁻⁾(0) = φ⁽⁻⁾(∞) = 0,峰值出现在 W = 1/4,峰值大小同样是 e/2。两侧都不放过。
- 两支在 W=1 处取值都为 1、斜率都是 −1/2,on-policy 点连续无缝衔接 。这也意味着:W=1 时 ReSPO 退化为标准序列级 REINFORCE------没有漂移就没有饥饿问题,方法自动失效(不添乱)。
一句话点破它和已知事物的关系:ReSPO 本质上是把 PPO 的"硬裁剪"换成了"软倾斜",并把"对称处理正负样本"改成了"按符号分别定形状的双重核"。 VESPO 是单方向的特例。
4.3 实测数字
设置:DAPO-MATH-17k,Qwen3-1.7B-Base(密集)与 Qwen3-30B-A3B-Base(MoE),每个 rollout 批复用于 N ∈ {8, 16, 32} 次更新,共六种「模型 × 复用次数」组合,每 run 固定 1024 次策略更新。对照 GRPO、GSPO、VESPO。
后期训练分(最后 128 次更新均值) :ReSPO 在全部 6 个设置 上超过所有裁剪式基线 4.2--8.4 个百分点。在最激进的 N=32 下:
| 模型 | GRPO | GSPO | VESPO | ReSPO |
|---|---|---|---|---|
| Qwen3-1.7B | 0.197 | 0.184 | 0.230 | 0.276 |
| Qwen3-30B-A3B | 0.504 | 0.493 | 0.523 | 0.588 |
留出集(六基准平均 pass@1) :N ∈ {16, 32} 时,四种组合全部最高 。30B 在 AIME25+AIME24+AMC23 三榜合并上分别提升 +6.3 / +5.8 / +3.4 pp(对应 N=8/16/32)。
三 seed 稳定性 :两模型合并的三个竞赛榜平均分 41.94% ± 0.47pp,对比 VESPO 38.77%、GRPO 38.43%、GSPO 34.70%------跨 seed 标准差远小于相对所有基线的提升。
按响应长度分箱 :在 30 个「模型×复用次数×长度分位」单元里,ReSPO 在其中 24 个 pooling 准确率最高;N=32 时在第 1--7 长度分位上相对最强基线分别高出 8.4 / 16.0 / 24.4 / 21.6 / 20.8 / 15.1 / 8.5 pp。收益主要集中在中长长度的推理轨迹上------正是被裁剪机制误杀的那个区域。
口径提示:部分中文技术解读给出"早期有效梯度吞吐提升 2.4 倍""采样成本降低 50%""提升 3.6--5.2 分"等说法,与论文正文可核对的口径(N ∈ {8,16,32};后期训练分 +4.2--8.4pp;竞赛榜 +3.4--6.3pp)不完全一致。引用时请以论文正文为准,上述二手数字可作为量级参考。
五、补丁 B:SRD 用"事后复盘"监督"事前预判"
5.1 换个监督目标
过去几年 hindsight(事后信息)的用法只有一种:拿它去改进行为策略 。自蒸馏的教师看到标准答案,然后监督学生的 action 分布。SRD 问了一个反过来可以并行成立的问题:这条已经跑完的轨迹,能不能教会模型"在动手之前就该知道什么"?
形式化地:
ini
p_fore = π_θ( · | x, e )                    ← 交互前视野,看不到任何轨迹
p_hind = π_θ̄( · | x, e, z_hind )           ← 交互后视野,带特权 hindsight(停止梯度的自老师)
L_pro  = E[ D( p_hind ‖ p_fore ) ]
训练时用的散度是 广义 Jensen--Shannon 散度 JSD_β (比反向 KL 稳,不会塌模式),作为辅助损失以 λ = 0.01 的权重加到原目标上。
5.2 奖励决定"教什么",不再决定"教不教"
SRD 的两个通道设计得很有意思:reward=1 的成功轨迹提供 Knowledge(可能需要什么知识)监督,reward=0 的失败轨迹提供 Pitfall(可能踩什么坑)监督。 两条类型不同但走同一套蒸馏流程。
于是出现了论文里那句我很喜欢的话:
奖励决定一条轨迹教的是哪一课,而不是决定它教不教课。
而且学生在自己生成的 foresight rollout 上 被打分(self-teacher 读取同一个 prefix),所以不引入外部教师、不需人类标注。推理时完全不需要生成 foresight,因此这份监督是零推理开销的。
5.3 实测数字
10 个基准(Math: AIME24/AIME26/AMO;Code: LCB-v6/OJBench;Search: HotpotQA/2Wiki/BrowseComp-Plus;Agentic: ALFWorld/WebShop),Qwen3.5-4B-Thinking 与 9B-Thinking:
| 组合 | 提升幅度 |
|---|---|
| 4B GRPO + SRD | Math 平均 +10.03pp,Code +8.33pp,Search +8.05pp,ALFWorld +3.25pp,WebShop +5.92pp |
| 9B OPSD + SRD | Math 平均 39.70% → 56.92%(+17.22pp),Search +10.31pp |
| 9B RLSD + SRD | ALFWorld 66.25% → 77.25%(+11.00pp) |
| 单点最大 | AIME26 @ 9B OPSD:52.92% → 77.08%(+24.16pp) |
顺带治了一个已知病:纯自蒸馏在 9B 上会崩到低于未训练的策略 (HotpotQA −5.50pp、2Wiki −3.76pp、LCB-v6 −2.18pp),且 Math 平均分随规模倒挂(9B 39.70% < 4B 41.81%)。加上 SRD 后倒挂消失,各 Math 基准恢复单调;那三个低于 Vanilla 的列变成高出 10.75 / 11.75 / 8.54 pp。
还有一个值得单独拎出来的观察:RQ2 做了逐 token 类别的重分配统计。加 SRD 后策略在一条 rollout 里:连接性散文 +8.6 个期望 token、显式规划词(we/need/think)+3.7、命名问题结构的词(key/insight/constraint)+1.4;同时行内数学记号 −6.7、标点 −4.3、数字 −4.1、变量名 −3.0;工具调用语法 +0.03(不变)。总和只有 +0.6。
它没有让模型多说话,它把固定的 token 预算从"当场心算"挪到了"先命名问题再规划"。 这是解释全部提升的最经济的一条线。
六、理想丰满,现实骨感
这部分决定了这篇文章值不值得读。
6.1 ReSPO 的边界
- on-policy 极限下自动失效。 W=1 时双分支都退化为 φ=1,梯度变成标准序列级 REINFORCE。如果你没有复用 rollout、没有 off-policy 漂移,换 ReSPO 不会有收益------它没有 bug,只是无事可做。
- 必须作用在未归一化的序列比 W 上,不能换成 GSPO 的长度归一化比 s = W^(1/|o|)。 论文在附录明确指出长度归一化会引入 length-dependent bias 并扭曲散度几何。这意味着直接用 GSPO 代码改一个核是不够的,得分清楚比值的定义。
- 验证规模有限。 只做了两个模型规模、每种组合 1024 次更新、六个「模型×N」设置;超参数是按解析条件推出来的(
β=0.5, λ=2),没有做大规模超参搜索。论文自己在局限性里点明了这两点。 - 双分支是硬要求。 用单一 α 或用 0<α<1 的负分支都会破坏尾极限,等于没改。
6.2 SRD 的边界------这些坑更值得留意
- Knowledge 通道基本是负债。 这是论文自己承认的:训练过程中 pitfall 通道的散度稳定下降 47% 和 30% (两次不同 domain-shuffle 的运行),而 knowledge 通道几乎平在 ~0.0045 和 ~0.003 不动 ------它学不进去。加上它在 rollout 阶段更贵(rollout 占单步 78--87%),所以主结果表里全部只用了 pitfall 单通道。更糟的是,knowledge 是唯一会掉到基线以下的配置(4B 上 AMO-Bench 低 4pp;9B 上 AIME26 62.92% vs 无 SRD 的 65.42%)。
- 不是全绿。 主结果表里有四处回归:9B OPSD+SRD 的 WebShop −3.61pp、4B RLSD+SRD 的 OJBench −0.97pp、9B GRPO+SRD 的 BrowseComp-Plus −0.51pp、9B OPSD+SRD 的 2Wiki −0.84pp。别把"+24.2pp"当成普遍值,那是单列最大值。
- 把 foresight 在推理时显式说出来,基本没用。 RQ5 做了这件事:四个 checkpoint 里只有一个 +5.00pp,另外三个在 800 条 rollout 里只变动了 2、3、11 条(即"无变化")。更要命的是没有任何一个 arm 在 ALFWorld 全部六类任务上都提升 ------每个 arm 都在做交换:Look 任务跨八个 arm 从 −20.13pp 到 +40.28pp。"平均提升"掩盖了任务间的取舍。 而且显式的 foresight 可能是错的:论文给的案例里,模型把一个"两物体任务"的错误预判安到了目的地而不是智能体上,直接污染了整个 episode。训练时用错的 foresight 还能被后续更新纠正;说出来就 conditioning 了整段交互。
- 损失权重 λ=0.01 只给了一个值,也没有做扫描。换一个 base objective / 模型规模要不要调?论文没回答。
- 和已有自蒸馏目标会抢容量。 RQ4 的方向分解显示:在 RLSD(已经含自蒸馏项)下加 Knowledge,是在加第二个自指目标,会相互竞争。这也解释了为什么 RLSD+SRD 的提升普遍小于 GRPO+SRD。
6.3 两者都只在 RLVR 成立
两条补丁都依赖可验证的标量奖励 + 组相对优势。换到 RLHF / DPO 这类偏好学习场景,既不出现"组全同导致优势归零",也不出现同样形式的序列重要性比漂移,这两个方法的动机都不成立。
七、能不能叠加?会不会打架?
正交,但要小心。
- ReSPO 修的是时间维度:同一条 rollout 在被复用 N 次的过程中,权重如何随漂移演化。
- SRD 修的是信息维度:一条 rollout(尤其是无法产出对比信号的那条)里还能榨出多少监督。
一个不再卡的对照组动态采样、一个不再在乎组内方差------理论上可直接叠加。不过有两点提示:
- SRD 的 RQ4 分解(
E = α·Â + E_⊥,在 Fisher 度量下,held-out 代码集 626,992 个位置)显示:面对稀疏信用的 RL,加 SRD 让位移延长(0.39 → 0.86,α/‖A‖ = 1.30,且正交分量占 ‖E_⊥‖/‖E‖ = 0.49,cos(A,E) = +0.81);面对本身已经稠密的自蒸馏,它反而是锚(1.97 → 0.57)。 换言之:它给弱监督加放大,给强自监督加刹车。 - ReSPO 论文已验证了与 MoE 的 Routing Replay(R3)正交叠加:30B/N=16 下把后期 penalized training accuracy 从 56.32% 提到 58.16%(+1.84pp)。这是一个"能叠加"的正例,但 SRD 的叠加实验两篇论文都没做。
八、自检修一条:开工前先做三个统计
先别急着换算法,先用一次便宜的离线统计定位你漏在哪:
markdown
① 统计 reward-uniform 组占比
   关闭动态采样,跑 200 个 step,记录
     · 全 Success 组占比 / 全 Failure 组占比 / 混合组占比
   判据:混合组 < 70%  → 漏点①严重,优先 SRD/事后监督路线
        且 U 型两端都要看:你的题到底是太难还是太简单?

② 统计序列重要性比 W 的分布
   复用 N 次之后,记录 log W 的直方图
   判据:发现 Ê>0 的样本大量落在 W < 0.3 → 漏点②在杀伤正样本
        Ê<0 的样本出现 W > 3 → 漏点②在放大错误解

③ 统计 W 的相关性长度 vs 你的 N
   漂移越快(长度越长、学习率越大、N 越大),②的危害越大
九、选型决策树
ini
你的 RLVR 卡在哪?
│
├─ 训练分长期不涨 / 早期就被丢弃大量组
│   ├─ reward-uniform 组占比 > 30% ─────────► 【先补 SRD】
│   │                                        只开 pitfall 单通道,λ=0.01
│   │                                        不要加 knowledge,不要推理时显式生成
│   └─ 占比正常 ─────────────────────────► 往下看
│
├─ 复用 N 较大(≥ 8)且观察到右尾/左尾堆积
│   ├─ 正样本卡在 W→0 ────────────────────► 【换 ReSPO 双分支核】
│   │                                        必须用未归一化 W,超参先用默认
│   └─ 负样本在 W→∞ 主导 ─────────────────► 【同上,负分支 e/2 峰值在 W=0.25】
│
└─ on-policy、N≈1、无漂移 ─────────────► 【都别换】
                                           ReSPO 退化为 REINFORCE,无收益
三条实践建议:
- 先做上面的三个统计,再决定动哪一刀。 这两篇论文的增益都是有条件的,不是普遍适用的免费午餐。
- SRD 默认只开 pitfall,且不要期待在 WebShop/OJBench 这类上一定涨。
- ReSPO 接的时候确认你的 trainer 用的到底是
prod_t w_{i,t}(GRPO 风格)还是s = W^{1/|o|}(GSPO 风格)。后者需要先改回去。
十、我的判断
RLVR 过去两年的大部分创新都在"策略优化目标"这一层打转,而这两篇论文同时指向了一个更朴素的命题:我们为每条 rollout 付了真金白银的算力,却连它携带的信息都没有榨干净。
分层看会更清楚:
markdown
信息榨取层   ← SRD 在这:一条轨迹除了标量奖励还有什么可教的
    ↓
加权整形层   ← ReSPO 在这:这些信息按什么权重进梯度
    ↓
系统调度层 ← 异步 RL / rollout 流水线(另一个话题)真正的结论其实很直白:我们把绝大部分算力花在生产代理信号上,却连这些代理信号的提取和加权都是错的------两个洞加在一起,接近一半的采样预算没有变成有效的梯度方向。
下一个值得盯的信号有两条:
- 值得变成 checklist 的一条:会不会出现一个不依赖组内方差的、统一的事后监督目标,作为新的默认 aux loss,而不是只在信号淹没时才补丁式地加上去。SRD 现在 λ=0.01 是"佐料"而不是"主食"。
- 开源训练框架会不会把 ReSPO 的核作为默认选项。 这是一个纯重要度加权的改动,代码量很小、但会直接改变大家的数据复用习惯。如果 verl / OpenRLHF 默认集成,大概率会迅速变成默认配置。
数据来源:arXiv:2610.08077(Self-Retrospection Distillation,Salesforce AI Research / UCSD / Stanford / Texas A&M,2026-10-06,v2 2026-10-08);arXiv:2609.35433(ReSPO,UCLA,2026-09-28)。文中所有实验数字均引自论文正文与表格。部分中文二手解读给出的概括性数字(如"2.4× 梯度吞吐""采样成本降低 50%")未能与论文正文对上,已在文中标注说明。本文不构成任何训练配方建议,实际收益请以你自己的 reward-uniform 占比与重要性比分布为准。