VLM 里视觉 token 通常是输入序列的主体,过去两年大家攒了一整套压缩经验:看 softmax 注意力分数(FastV)、看特征相似度(DART)、混合策略(SparseVLM / VisionZip)。这些方法全都针对 softmax attention 设计。把它们直接搬到 Qwen3.5 这种混合线性注意力 架构上会发生什么?arXiv:2610.11251 给出的答案很残酷:连随机丢弃 token 的基线都打不过。这不是调参问题------背后是一个可以用数据处理不等式写出来的信息论必然。而同一份分析又翻出了硬币的另一面:线性注意力的"选择性遗忘"本身就是一个免费的 token 重要性传感器。阿里巴巴团队据此做了 V-CoLA,保留一半视觉 token 拿到 99.5% 的平均性能。
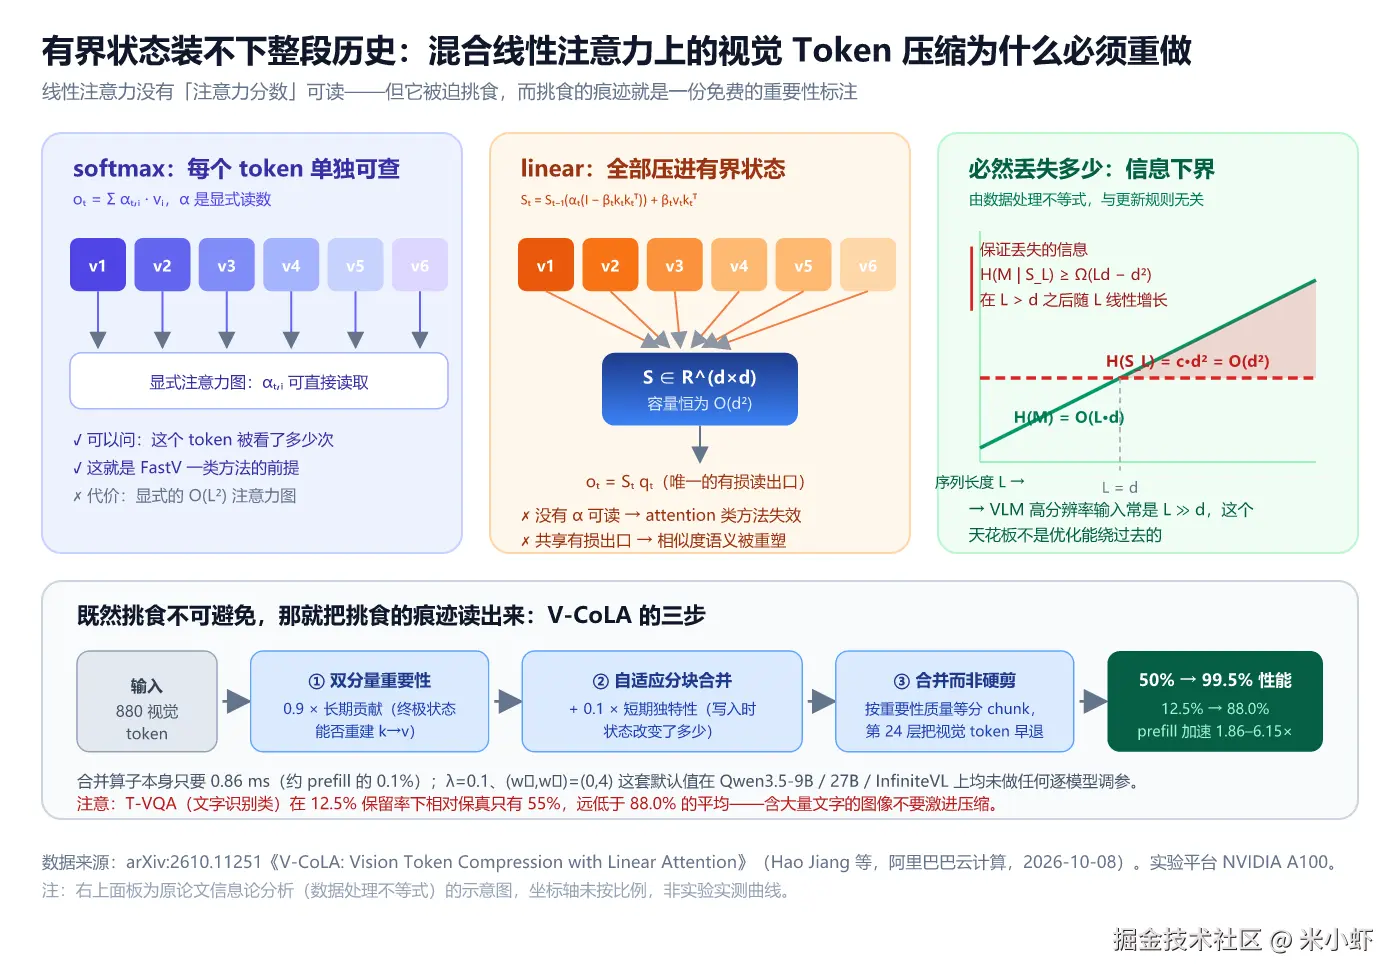
一、先看清两种注意力在"记什么"
Softmax attention 的输出是一个加权和:
arduino
o_t = Σ_{i≤t} α_{t,i} · v_i α_{t,i} = exp(q_tᵀk_i) / Σ_j exp(q_tᵀk_j)关键性质:每个历史 token 都保持独立可寻址。α_{t,i} 是一个显式的、token 级别的"o_t 有多依赖 v_i"的读数。代价是全注意力图,O(L²)。
Linear attention(以 Gated DeltaNet 为代表)换了思路,把整个历史压进一个固定大小的循环状态 S ∈ R^(d×d):
arduino
S_t = S_{t−1} · ( α_t (I − β_t k_t k_tᵀ) ) + β_t v_t k_tᵀ
o_t = S_t q_t
α_t 是 decay 门、β_t 控制写入强度。这个更新可以解释成对 per-token 重建目标做一步在线梯度下降:
arduino
L_t(S) = ½ ‖ S k_t − v_t ‖²一句话点破两者的差别:softmax attention 是一个可精确查阅的 KV 表;线性注意力是一个带擦写机制的容量固定的矩阵。 前者你可以问"这个 token 被看了几次",后者你只能问"它的信息还剩多少"。
二、为什么老方法集体失效:两条被同时打断的假设
2.1 attention-based(FastV 系):假设"浅层的注意力会集中"
这类方法的核心动作是:在浅层读注意力分数,扔掉没人看的 token。前提是------"谁重要"这件事在浅层就已经明朗。
论文用 Figure 3 打了脸:对比 Qwen3-VL(纯 softmax)与 Qwen3.5(混合架构)各层分配给视觉 token 的注意力占比,Qwen3-VL 在浅层就迅速衰减,而 Qwen3.5 一直到中间层都还在持续关注视觉内容,直到更深层才降到低位。
换个说法就是:在混合架构里,模型把"看视觉内容"这件事推迟到了中间层。你在第 2 层就去读注意力分数,等于在模型还没开始认真看图的时候替它决定了看哪里。
2.2 similarity-based(DART 系):假设"隐特征的相似度是可区分的"
这类方法二等兵 benefits believe 是软件的第二项 leave:不看注意力,改看 token 特征空间的相似度去重。前提是------相似度高 = 冗余。
论文在 Figure 4 里做了一个控制实验:固定 pivot token 不变,只换模型 ,然后在 Qwen3.5 上重跑 DART 的冗余识别。结果是识别出来的冗余 token 明显不可靠了。而且这个结论毫不含糊:不是 pivot 选错了,是"特征相似度"这个量本身的语义被 state-recurrent 更新改变了。
原因在第三部分:所有 token 的输出都是从同一个压缩状态里读出来的。 既然大家一起从一个有损瓶颈里被榨出来,那么它们两两之间的相似度就不再反映"信息是否重复",而更多地反映"它们在这个有损读出里掉进了同一个坑"。
2.3 结局:连随机基线都不如
把两类代表方法放到 Qwen3.5-9B 上和随机丢弃做对比(Figure 2),结果是:几乎没有优势。MME / MMB / GQA / SQA / T-VQA / POPE / VizWiz / MMStar 八个基准里大量emblazoned随机基线之下。。
这不是"分数低一点",这是方法论层面的失效:你精心挑出来的"重要 token",还不如随手随机抽一把。
三、根因:一个有界的 d×d 矩阵,装不下 L·d 的信息
论文的归因为什么这块硬,因为它只用了一个数据处理不等式。
把 S_L 看成对 token 序列 M = {(k_i, v_i)}_{i=1..L} 的一个有损编码器,每个条目 c 比特,则:
scss
I(M; S_L) ≤ H(S_L) = c · d² = O(d²)          ← 互信息不可能超过状态本身的熵
H(M) = L · h(k, v) = O(Ld) ← 源信息随序列长度线性增长两式合并,得到状态必然丢失的信息量下界:
scss
H(M | S_L) ≥ H(M) − H(S_L) = Ω(Ld − d²)一旦 L > d,这个下界就随 L 线性增长。 而在 VLM 里,高分辨率多模态输入经常是 L ≫ d。作者把这个叫 information ceiling(信息天花板)。
这个天花板带来两个直接后果,正好对应前面两类方法的失效:
| 后果 | 打断了谁 | 机制 |
|---|---|---|
| 状态容量紧张 → 模型被迫把视觉信息的处理推后到中间层 | attention-based | 浅层注意力不再集中 |
| 所有 token 共享一个有损读出口 → 隐特征的相似度结构被重塑 | similarity-based | token 可区分性下降 |
重要的是:这个论证只依赖数据处理不等式和"状态容量与 L 无关"这两条,不依赖 Gated DeltaNet 的具体更新规则,因此适用于 Mamba-2、RWKV 等一切有界状态递归骨干。
硬币的另一面
但同一段推导里藏着一个礼物:正因为状态容量有限,模型才被迫让 decay 门和写入强度 β 做"选择性更新"------而这个选择性本身,就是 token 重要性的签名。
换个说法:为了不撑爆这个 d×d 的瓶颈,模型每天被迫"挑食"。它挑食的痕迹,就是免费的 token 重要性标注。
这不只是一个比喻,论文的 Figure 6 给出了三条支持性观察:
- 保留率随深度快速下降 :浅层高,深层掉到 20% 以下。视觉信息主要参与浅层推理,越深越边缘。
- 保留率随序列长度下降:状态已经压力很大,只能更有选择地保留------正是信息天花板的直接体现。
- 相邻层保留率排序的 Pearson 相关系数在浅层很高,深层才衰减:说明在视觉推理阶段,不同层对"哪些 token 重要"的偏好是一致的。这是个好消息------意味着你可以在浅层一次性做完压缩。
四、V-CoLA:把状态递推当成重要性指示计来读
基于上面的洞察,V-CoLA 做了三件事。全部 training-free,且实现层全部对齐线性注意力的 chunk-wise parallelism。
4.1 双分量重要性:长期贡献 + 短期独特性
分量一:长期贡献(ℛ^imp)。既然状态递推的目标是把 (k, v) 写进去并能读回来,那么"重建误差小"就说明这个 token 的信息被忠实保留了:
css
ℛ^imp_t = 1 − ψ( S_L · k_t , v_t )
ψ(a, b) = (1 − cos(a, b)) / 2 ∈ [0, 1]
但只用 ℛ^imp 有两个偏:
- 偏向显著区域,容易挑出一堆彼此重复的 token(这是 top-k 剪枝的老毛病);
- 只看最终状态 S_L,会漏掉那些"重要但走的是长程路径"的 token------它们的贡献可能被累积的 gated decay 衰减掉了,或者根本没沿序列传播到 S_L,而是在写入后就直接层间传走了。
分量二:短期独特性(ℛ^uni)。补上后者:看 token 写入状态时到底造成了多大变化。冗余 token 跟上来更新状态时,目标的梯度会变小,对状态的影响也变小。于是用一组伪查询探针来测这个变化:
arduino
ℛ^uni_t = ψ( S_t · Q*_tᵀ , S_{t−1} · Q*_tᵀ )
Q*_t = Q[t+w₁ : t+w₂)       默认 (w₁, w₂) = (0, 4)
注意这里的实现很取巧 :多查询注入几乎是无代价的------注入的查询只参与算输出、不参与状态递推,所以代价极小;伪查询直接来自平移过的 key,一次前向就能拿到伪输出矩阵 U*,再错位相减即可:ℛ^uni_t = ψ(U*_{t,δ}, U*_{t−1,δ+1})。这让整个重要性计算可以被塞进 chunk-wise 并行里。
最终加权:
arduino
ℛ_t = (1 − λ) · ℛ^imp_t + λ · ℛ^uni_t 默认 λ = 0.1为什么 λ 这么小也能起作用?看消融就明白了:λ = 0(只有长期项)MME 2360.5;λ = 0.1 MME 2398.5;λ = 0.9 反而掉到 2333.1。长期项是主菜,独特性项是纠错用的盐------它只需要把"集中在显著区重复采样"这个偏纠回来。
窗口方向也有讲究:(0, 4)(只看未来 4 个)最好,(−4, 0)(只看过去 4 个)最差,(−4, 4) 居中。因为**"这个 token 对刚刚更新的状态有没有新贡献"要在它被读出来的时候才知道**。
4.2 自适应分块合并:不是 top-k
top-k 保留的毛病是它加剧了"偏向显著区"。V-CoLA 改成 token merging(合并而非丢弃),而且是按重要性质量等分而非按 token 数等分地分块:
arduino
目标:把 token 序列切成 L′ = L·γ 个 chunk,使得每块的 ℛ 之和尽量接近
   {C*_i} = argmin Σ_i | R̄ − Σ_{t=t_i}^{t_{i+1}} ℛ_t |        R̄ = 每块的期望重要性质量

块内加权合并:
o′_i = Σ_t w_t · o_t w_t = exp(ℛ_t/τ) / Σ_k exp(ℛ_k/τ) τ = 1.0效果是:重要的区域被切成细粒度的块(合并强度低、保真度高),不重要的区域被并成粗块(狠压)。 局部压缩率随语义密度自适应,而不是全图一刀切。
消融验证了两个分量的互补性:在 ↓75% 压缩下,去掉自适应合并 MME 从 2268.7 掉到 2197.4、MMStar 从 47.2 掉到 44.3;在 ↓87.5% 下差距更大(2012.0 → 1913.4,MMStar 41.4 → 36.5)。压得越狠,合并相对硬剪枝的收益越大。
顺带一提,合并权重里的温度 τ 是可调的------调低它就退化回硬剪枝。这个旋钮留给用户,算是很实用。
4.3 视觉 token 早退:深层干脆不要了
前面 Figure 6 已经说了深层保留率 <20%。论文用 PPL 扰动验证:逐层把所有视觉 token 拿掉,PPL 在某一层之后急剧下降并进入平台------具体是在 Qwen3.5-9B 的第 24 层之后。
MME/MMB/SQA 的结果更直观:
| 退出层 | MME | MMB | SQA |
|---|---|---|---|
| 1 | 967.3 | 22.6 | 83.7 |
| 12 | 2169.5 | 80.4 | 90.6 |
| 24 | 2401.6 | 85.2 | 92.3 |
| 32(不早退) | 2398.2 | 85.6 | 92.2 |
在第 24 层把视觉 token 全扔掉,MME 反而比不早退还高一点点(2401.6 vs 2398.2)。 深层视觉 token 在这个混合架构里就是纯负债。
五、数据:三个压缩档,八基准,五个基线
主表(Qwen3.5-9B,8 基准平均相对性能,上界 880 token = 100%):
保留 50%(440 token)
| 方法 | MME | MMB | GQA | SQA | T-VQA | POPE | VizWiz | MMStar | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| FastV | 2351.6 | 84.8 | 60.4 | 92.1 | 79.5 | 88.8 | 67.6 | 45.3 | 97.5 |
| SparseVLM | 2333.1 | 84.7 | 60.1 | 92.2 | 80.1 | 88.7 | 67.5 | 45.6 | 97.5 |
| DART | 2220.4 | 83.3 | 59.6 | 91.7 | 69.3 | 88.9 | 67.0 | 48.3 | 95.5 |
| VisionZip | 2376.5 | 84.7 | 60.7 | 92.6 | 80.6 | 89.4 | 68.0 | 48.9 | 99.0 |
| DTP(也是为线性注意力设计的) | 2197.2 | 81.6 | 58.7 | 91.0 | 71.5 | 87.3 | 67.6 | 45.0 | 94.2 |
| V-CoLA | 2398.5 | 85.0 | 61.0 | 92.7 | 80.6 | 89.8 | 68.3 | 49.6 | 99.5 |
保留 25%(220 token):V-CoLA 94.8,VisionZip 94.5,SparseVLM 91.1,FastV 90.9,DART 88.4,DTP 86.3。
保留 12.5%(110 token) :V-CoLA 88.0 ,VisionZip 86.4,DART 79.2,DTP 75.7,SparseVLM 69.7,FastV 63.9。
真正的加速(语言模型 prefill 墙钟时间,ms):
| 视觉 token | 不压缩 | 保留 50% | 保留 25% | 保留 12.5% |
|---|---|---|---|---|
| 2K | 269 | 145(1.86×) | 88(3.06×) | 61(4.41×) |
| 4K | 511 | 273(1.87×) | 153(3.34×) | 94(5.44×) |
| 8K | 1034 | 542(1.91×) | 289(3.58×) | 168(6.15×) |
这套东西本身贵不贵? 组件级分解:改造后的 Extended Gated DeltaRule 在多查询场景(8K×4)把 135.1 ms 压到 35.1 ms(3.85×) ------因为把多花 query 塞进了同一次 chunk 计算;而 Adaptive Token Merging 本身只花 0.86 ms,约占整个模型 prefill 成本的 0.1%。
口径提示:摘要里说"剪枝带来的额外开销只占前向传播成本的 1.6%",而正文 Table 3 说"自适应合并在等的范围内花了 0.86 ms,约占 prefill 成本的 0.1%"。两者说的不是同一件事------前者是全链路(含重要性计算)相对前向成本,后者只算合并算子相对整段 prefill。引用时别混用。
泛化性(固定 ↓75%,同超参没做任何 per-model 调整):
| 模型 / 方法 | MME | SQA | POPE | MMStar |
|---|---|---|---|---|
| Qwen3.5-27B 上界 | 2517.4 | 97.0 | 90.5 | 58.1 |
| ├ DART | 2173.0 | 91.9 | 82.4 | 44.5 |
| ├ VisionZip | 2405.2 | 96.0 | 88.4 | 53.3 |
| ├ DTP | 1798.2 | 89.2 | 70.2 | 43.1 |
| └ V-CoLA | 2414.5 | 96.1 | 88.8 | 53.7 |
| InfiniteVL 上界 | 1998.9 | 86.0 | 87.9 | 53.7 |
| ├ DART | 1885.5 | 84.7 | 85.0 | 49.0 |
| ├ VisionZip | 1883.8 | 84.8 | 86.8 | 48.4 |
| └ V-CoLA | 1893.1 | 85.8 | 86.3 | 49.3 |
超参沾光 robustness 也不错:λ ∈ [0.05, 0.10] 表现接近,只有极端值才明显退化;(w₁,w₂) 取 (0,4) 和 (−4,4) 结果相近。而且同一套默认值在 9B、27B、InfiniteVL 三个模型上都是最优------没有 per-model 调参。
六、理想丰满,现实骨感
这部分是本文最该读的一节。
6.1 论文自己承认的两条
- 架构覆盖 :只验证了"交错线性注意力与 softmax 注意力"的混合 VLM。纯 Mamba 或全线性注意力的 VLM 没测。作者明确指出,无周期性的 softmax 层可能会改变重要性准则的行为。
- 线性注意力形式局限:分析与方法都锚在 Gated DeltaNet 形式上。理论上重建视角可以推广,但没有系统研究。
6.2 我在数据表里读出来的三条
① TextVQA 是重灾区,而且 V-CoLA 在这里并不占优。
看 12.5% 那一档:V-CoLA 的 T-VQA 是 46.0,上界是 83.2------相对保留率只有 55%,远低于 88.0% 的平均值 。而且它和 VisionZip 的 45.7 几乎打平。更尴尬的是在 ↓75% 那一档:V-CoLA 的 T-VQA 是 63.4,反而低于 VisionZip 的 65.7。
结论很明确:涉及文字识别(OCR 类)的任务,不要用激进的视觉 token 压缩。 文字是 token 密度最高、冗余度最低的信息,合并/丢弃会直接毁掉它。这一点适用于所有方法,不只是 V-CoLA。
② 优势集中在激进压缩区,温和压缩时和最强基线几乎持平。
50% 那一档,V-CoLA 99.5 vs VisionZip 99.0,只差 0.5pp 。真正的差距在 12.5%:V-CoLA 88.0 vs VisionZip 86.4 vs DART 79.2 vs FastV 63.9。你的收益有多大,取决于你想压多狠。 如果你只需要压到 50%,换方法的收益很有限;如果你要做 8× 压缩,那才是 V-CoLA 的主场。
③ 12.5% 档的 MME 上,VisionZip 反而更好。
V-CoLA 2012.0 vs VisionZip 2036.0。平均值上的领先是靠 GQA(57.5 vs 56.7)、POPE(88.3 vs 84.1)、VizWiz(68.3 vs 65.3)拉出来的。没有哪个方法在极端压缩下是全能的。
6.3 工程落地的三条硬约束
④ 它不是一个"拿来即用"的插件,它需要改 kernel。
V-CoLA 要能真的跑快,必须改造 Gated DeltaNet 算子本身(Extended Gated DeltaRule,支持多查询注入),并把重要性计算和 adaptive merging 全部塞进 chunk-wise 并行里。这意味着它和你使用的 kernel 库深度耦合:换一个 Triton/Flaggems 实现、换一个注意力后端的版本,都要重新适配。这是相对 FastV/VisionZip(纯 Tensor 操作,随便换后端)最大的落地成本。
⑤ training-free 是双刃剑。 好处是零训练成本、直接套在现成模型上;坏处是它拿不到任何训练期的适配------模型不会因为知道"后面会被压缩"而学会把信息集中到少数 token。
⑥ 评测尺度偏温和。 主表的八个基准都是短答案 VQA / 选择题,上界 880 个视觉 token。多轮长对话和小目标识别放在附录。真正在高分辨率文档、长视频(数万 token)上的表现,主实验没有直接回答------延迟表虽然做到了 8K token,但准确率只在 ~880 token 的尺度上验证过。
6.4 什么时候别用
erlang
✗ OCR / 图表 / 含大量文字的图像(T-VQA 相对保留率只有 55%)
✗ 只需要温和压缩(50% 时相对最强基线只差 0.5pp,不值得改 kernel)
✗ 纯 Mamba / 全线性注意力 VLM(论文明确没测)
✗ 你的 kernel 栈不允许改 Gated DeltaNet 算子
✗ 期望"零适配、直接 pip install"
七、决策树
erlang
你的 VLM 骨干是什么?
│
├─ 纯 softmax(Qwen3-VL / InternVL 系)
│   └─► 老方法继续用。FastV / VisionZip / SparseVLM 仍是性价比最高的选择
│       (注意:混合架构的结论不能反向套用到纯 softmax 上)
│
└─ 混合线性注意力(Qwen3.5 / Kimi-Linear / InfiniteVL 系)
    │
    ├─ 你的任务是 OCR / 文档 / 图表? ────► 【别激进压缩】先测 T-VQA 类的保真度
    │
    ├─ 目标压缩率?
    │   ├─ ≤ 50%(2×)  ─────────────────► 收益有限,先用 VisionZip 打基线
    │   ├─ ~75%(4×)   ─────────────────► 【值得上 V-CoLA】注意 T-VQA 上 VisionZip 可能更好
    │   └─ ~87.5%(8×) ─────────────────► 【强烈建议 V-CoLA】此档拉开最大差距(88.0 vs 79.2/63.9)
    │
    └─ 能改 kernel 吗?
        ├─ 能 ─────────────────────────► 上 Extended Gated DeltaRule,拿 1.86--6.15× prefill
        └─ 不能 ───────────────────────► 只有算法收益、拿不到系统收益,性价比大打折扣
三条实践建议:
- 先用你自己的 OCR/文字类子集过一遍,再决定全局压缩率。平均分会骗人,T-VQA 是照妖镜。
- 早退层(论文默认 24)一定要按你自己的模型重新标定。 用"逐层移除视觉 token 看 PPL 平台"这个便宜的办法在新模型上重跑一遍,成本很低。
- 把每次上线压缩的收益来源分开记账:合并策略的收益、早退的收益、kernel 改造的收益是三笔独立的钱,别混在一起算 ROI。
八、我的判断
这篇论文真正的价值不在那个 "99.5%"------它在宣告一个范式迁移的信号:
softmax 时代:token 重要性 = 注意力分数(一个显式的、逐对的读数)
线性注意力时代:没有这个读数了,重要性必须重新定义而新定义的来源很优雅------不是再找一个外部指标,而是读模型自己在压缩瓶颈下的取舍行为。这个思路不止能用在 token 压缩:
- KV cache 驱逐:有界状态的模型该按什么丢?
- 长上下文分片 / 检索:哪些 chunk 的信息真的还在状态里?
- 可解释性:重建误差能不能当(token, layer)粒度的"记忆强度图"来读?
从这个角度看,V-CoLA 是"把 compressive bottleneck 当成 instrument"这条线的一个漂亮样本。同一份卡脖子,既是故障诊断书,也是最好的传感器。
三个待验证的开放问题:
- 这条重要性准则在多大程度上迁移到其他有界状态骨干(Mamba-2 / RWKV / MesaNet / DeltaNet 变体)?论文自己说没做,这是个明显的空位。
- 训练期感知压缩能不能翻盘 training-free ?如果模型在预训练/后训练阶段就知道会被压缩,
L ≫ d的天花板能不能部分绕过去? - 87.5% 之后是什么曲线? 主表只到 12.5%,长尾(5%?2.5%?)会不会出现相变------如果有,那才是真正划出"哪些任务可以极限压缩"的边界。
数据来源:arXiv:2610.11251《V-CoLA: Vision Token Compression with Linear Attention》(Hao Jiang et al.,阿里巴巴云计算,2026-10-08)。实验平台 NVIDIA A100,评测框架 LMMs-Eval。文中所有数字均引自论文正文表格;摘要与正文关于剪枝开销的两个不同口径已在文中标注。本文不构成工程选型建议,实际收益请以上述三条硬约束(OCR 任务、压缩率、kernel 可改性)的自测为准。