pdf版下载链:https://pan.quark.cn/s/9cc742e9c2a8
01 LLM 基础概念:Token、上下文窗口与幻觉
更新: 2026-10-12
1. Token 是什么?
图解:Token 如何影响一次 LLM 调用
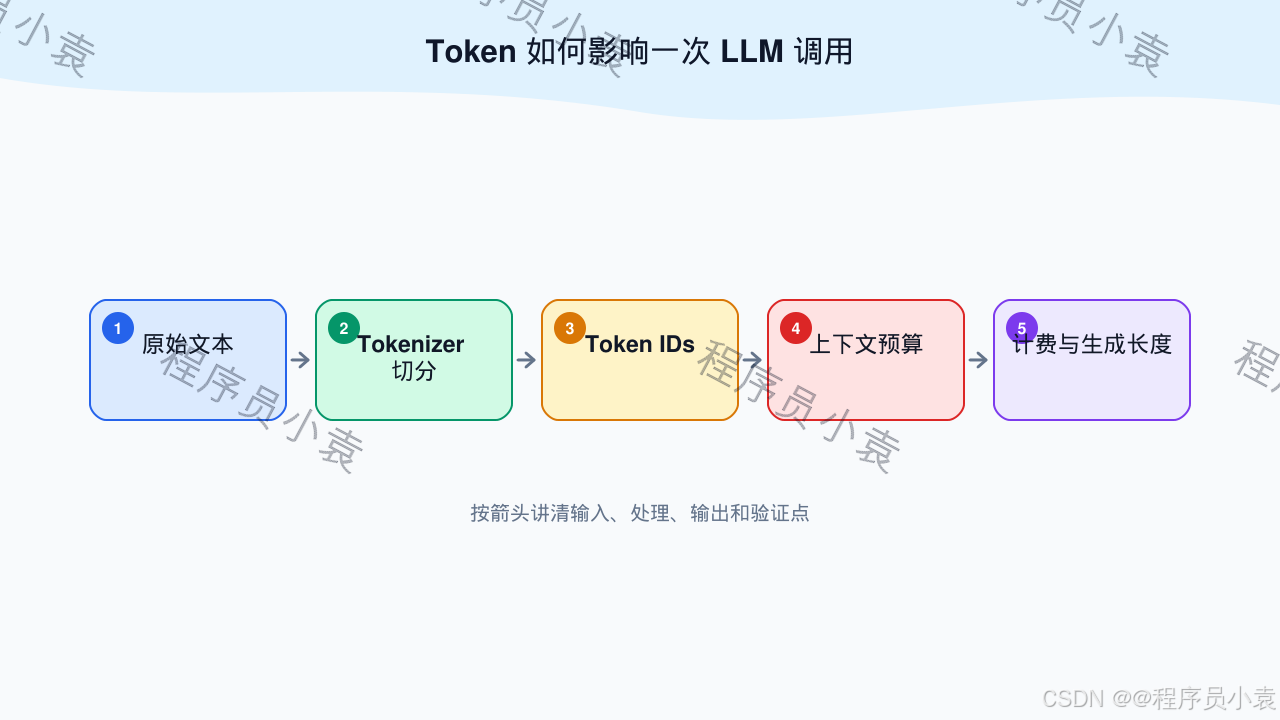
Token 是 LLM 处理文本的基本单位(不是字,也不是词)。
| 语言 | 粗略换算(仅用于估算) |
|---|---|
| 英文 | 常见 tokenizer 下约 1 token ≈ 4 个字符,但代码、数字和特殊符号差异很大 |
| 中文 | 一个汉字可能对应一个或多个 token,不能固定按 1:1 或 1:2 计算 |
例子:
text
"你好世界"、"Hello World" 的 token 数取决于具体模型的 tokenizer影响:
- 计费按 token 计算
- 上下文限制按 token 计算
- 生成长度按 token 计算
生产中应调用供应商 tokenizer 或计数 API,不要用字符换算做限流、截断或计费结算。同一文本换模型后 token 数也可能变化。
2. Temperature、Top-P、Top-K
图解:采样参数如何共同决定输出
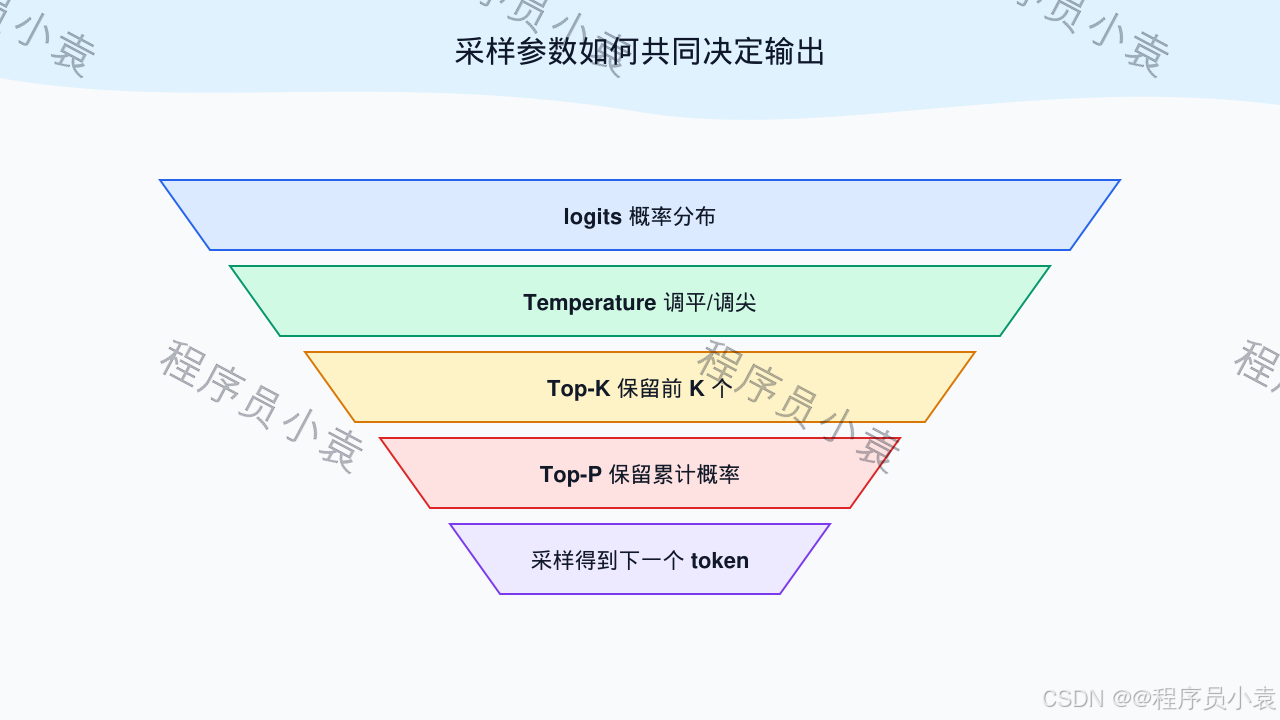
Temperature(温度)
控制输出的随机性:
| 值 | 效果 | 适用场景 |
|---|---|---|
| 接近 0 | 分布更尖锐,通常更稳定 | 问答、代码生成 |
| 0.3-0.7 | 适度随机 | 通用对话 |
| 0.7-1.0 | 高随机性 | 创意写作 |
Top-P(核采样)
按概率从高到低选择累计概率达到 P 的最小候选集合,再从中采样:
- Top-P = 0.9:保留累计概率约为 90% 的动态候选集合,不是固定保留 90% 的词
- 比 Top-K 更灵活
Top-K
只从概率最高的 K 个词里采样:
- Top-K = 50:只从前 50 个候选词里选
推荐配置
python
# RAG/问答
temperature = 0.1

# 创意写作
temperature = 0.8

# 代码生成
temperature = 0.2
参数名、范围和是否支持
top_k因供应商而异。通常先固定评测集,只调 Temperature 或 Top-P 中的一个。即使 Temperature 为 0,服务端实现、模型快照和并行计算也可能使结果并非逐字可复现。
3. Context Window(上下文窗口)
定义:一次请求可容纳的 token 预算,通常涉及输入、工具结果、推理状态和输出;具体计数规则以模型文档为准。
截至 2026-10 的模型与长上下文格局
| 生态(当前代际) | 官方公开信息 | 面试时应强调 |
|---|---|---|
| OpenAI GPT-6 系列 | GPT-6 Sol/Luna 已进入产品与 API;官方建议用 Responses API 的缓存与 compaction 管理长任务 | 上下文管理不再只是"截断",还包括服务端压缩、缓存和 reasoning 状态延续 |
| Anthropic Claude 5 / 4.5 | Fable 5.1、Opus 5、Sonnet 5 为 1M;Haiku 4.5 为 200K | 标称窗口不等于有效召回,仍要评测信息位置、输出预算和成本 |
| Google Gemini 3.8 | Gemini 3.8 Flash 输入上限 1,048,576,输出上限 65,536 | 原生多模态、工具、搜索 grounding 与结构化输出是选型维度 |
| DeepSeek V4.1 | deepseek-flash 为 1M 上下文,支持 thinking、工具调用和视觉输入 |
API 别名可能路由到新版本,生产应锁快照或做回归 |
| Qwen 3.8 | 官方开源系列支持 262,144 上下文和可调 reasoning effort | 开放权重便于私有化,但部署吞吐和显存必须实测 |
| Meta Llama 4 | Maverick 为 1M,Scout 声明支持 10M | 超长窗口能力要结合训练长度、检索测试和硬件成本理解 |
以上均为截至 2026-10的官方公开信息,详见文末来源。不要把窗口数字直接解释为"能无损理解这么多 token",也不要只凭 Needle-in-a-Haystack 单点召回决定生产选型。
超出限制的解决方案
- 预算预留:先为输出、工具结果和推理状态预留空间
- 滑动窗口:只保留最近 N 轮,适合局部连续对话
- 结构化摘要/压缩:保留目标、约束、决策和未完成事项,并检测摘要漂移
- 检索式记忆:事实与历史按需召回,同时做权限、时效和去重控制
- 服务端 compaction:供应商支持时用原生压缩延续长任务
- 分段处理:Map-Reduce、分层索引或多阶段抽取,避免一次塞满窗口
4. 常见模型对比
旧式"一个旗舰模型包打天下"的表述已经过时。模型选择应基于自己的评测集,并按能力层级路由:
| 模型层级 | 优点 | 风险/成本 | 适用场景 |
|---|---|---|---|
| 快速/轻量模型 | 低延迟、高吞吐 | 复杂推理和长程 Agent 稳定性通常较弱 | 分类、抽取、改写、简单 RAG |
| 通用旗舰模型 | 综合能力与工具调用较强 | 成本和延迟更高 | 复杂生成、多模态、重要交互 |
| Reasoning 模型/高 reasoning effort | 更愿意分解、验证和使用工具 | 推理 token、延迟和费用增加;仍会推错 | 数学、代码、规划、难例兜底 |
| 开放权重模型 | 可私有化、可定制、数据边界清晰 | 运维、量化、并发和安全责任自担 | 合规场景、稳定大流量、领域适配 |
Reasoning 模型的能力边界
- 给出目标、约束、完成条件和输出契约,通常比强制输出"逐步思考"更稳;OpenAI 官方也建议 reasoning 模型优先使用高层清晰指令。
reasoning_effort是质量/延迟/成本旋钮,不是修复坏数据、坏工具或坏任务定义的万能键。- 不应把模型自报的"置信度"当校准概率。代码用测试验证,计算用执行器验证,事实用来源验证,高风险动作走人工审批。
- 不要求或记录隐藏思维链;生产可保留简洁的结论依据、工具轨迹和可审计证据。
5. 幻觉(Hallucination)
定义: 模型编造不存在的信息。
减少幻觉的方法
- RAG/工具 grounding:提供可验证证据,但检索错误和证据冲突仍会产生幻觉
- 可回答性判断:证据不足时拒答或追问,而不是强行生成
- 引用校验:引用必须能定位到原文,并验证"引文确实支持该断言"
- 生成后验证:把答案拆成原子事实,做 entailment、规则或二次检索
- 人工审核:医疗、法律、财务和不可逆动作保留人工责任
降低 Temperature 主要减少采样随机性,不能保证事实正确;"RAG 消除幻觉"也是错误的绝对化结论。
📝 面试题
Q: LLM 的 Token 是什么?中文和英文有什么区别?
💡 参考答案
- Token 是 LLM 处理文本的基本单位
- 英文:1 token ≈ 4 个字符 ≈ 0.75 个单词
- 中文:1 个汉字 ≈ 1-2 个 tokens
- 影响:计费、上下文限制、生成长度都按 token 算
6. 什么是涌现能力(Emergent Abilities)?
"涌现能力"指某些能力在模型规模、数据或训练算力增长后,在特定指标上表现出突增。但"突然出现"可能同时受离散评分、任务阈值和评测分辨率影响,不能简单归因于某个参数量门槛。
典型的涌现能力
💡 答案要点
| 观察到的能力 | 更严谨的解释 |
|---|---|
| 上下文学习 | 受规模、训练分布、上下文格式和任务相似性共同影响 |
| 复杂推理 | 受后训练、推理时计算、工具使用和验证机制影响,不只取决于参数量 |
| 指令遵循 | 主要与指令微调、偏好优化和指令层级训练有关 |
| 代码生成 | 还取决于代码数据质量、执行反馈和仓库级上下文 |
例子:
text
小模型(7B): "写一个排序算法" → 代码错误多
较强模型: "写一个排序算法" → 更可能给出实现和测试,但仍需执行验证
核心特征:
- 指标依赖:离散 exact-match 可能把平滑变化显示成突变
- 不完全可预测:scaling law 能预测损失趋势,但具体下游能力仍需评测
- 多因素共同决定:参数、数据、训练目标、后训练和推理时计算都重要
面试话术:
"涌现是对某些下游指标非线性变化的描述,不存在通用的 10B 或 100B 门槛。回答时我会区分真实能力增长与离散指标造成的视觉突变,并关注后训练、推理时计算和工具反馈。"
7. 什么是灾难性遗忘(Catastrophic Forgetting)?
灾难性遗忘 = 模型在学习新任务时,遗忘之前学过的知识
典型场景
💡 答案要点
问题表现:
text
原模型: 擅长中文问答
微调后: 擅长代码生成,但中文问答能力大幅下降 ❌
解决方案:
| 方法 | 原理 | 效果 |
|---|---|---|
| 混合训练 | 新旧数据混合训练 | 效果好,成本高 |
| 正则化 | 限制参数变化(EWC算法) | 效果一般 |
| LoRA微调 | 只训练少量参数 | 效果好,推荐 ⭐ |
| 持续学习 | 渐进式学习架构 | 复杂度高 |
LoRA优势:
- 冻结基座参数,只训练少量低秩参数,通常能降低训练显存与存储成本
- 可以同时保留多个LoRA适配器
- 可在推理时切换适配器,但仍可能出现能力干扰、领域过拟合或路由错误
面试话术:
"灾难性遗忘是微调的核心挑战。LoRA 冻结基座参数,通常比全量微调更容易保留通用能力,也便于多适配器管理,但不等于天然没有遗忘或能力干扰。我会混入通用样本,并在微调前后用领域集和通用能力回归集共同评估。"
8. LLM的幻觉(Hallucination)与偏见(Bias)
幻觉问题
💡 答案要点
什么是幻觉?
模型生成看起来流畅,但事实错误或编造的内容
典型例子:
text
用户: "介绍一下诺贝尔物理学奖得主张三"
模型: "张三是2015年诺贝尔物理学奖得主,主要研究量子力学..."  ❌
(实际: 张三是编造的人物)
幻觉类型:
| 类型 | 示例 | 严重程度 |
|---|---|---|
| 事实错误 | 错误的日期、人名 | 🔥🔥🔥 |
| 逻辑错误 | 前后矛盾 | 🔥🔥 |
| 无中生有 | 编造不存在的信息 | 🔥🔥🔥🔥🔥 |
缓解方法:
- RAG(检索增强生成) - 基于检索证据回答,但要同时评估检索正确性
- 指令约束 - "只根据上下文回答,不确定就说不知道"
- 降低温度 - 减少随机性,但不能替代事实核验
- 人工审核 - 关键场景人工复核
偏见问题
💡 答案要点
什么是偏见?
模型在性别、种族、地域等方面的不公平输出
典型例子:
text
输入: "The nurse said ... he/she"
偏见模型: 倾向用 "she" (性别刻板印象)

输入: "程序员通常是..."
偏见模型: "男性" (职业性别偏见)
偏见来源:
- 训练数据中的社会偏见
- 标注人员的主观偏好
- 采样策略导致的分布偏移
缓解方法:
| 方法 | 效果 | 成本 |
|---|---|---|
| 数据平衡 | 增加少数群体样本 | 高 |
| RLHF对齐 | 人类反馈强化学习 | 高 |
| 提示词工程 | 明确要求公平性 | 低⭐ |
| 后处理过滤 | 检测并修正偏见输出 | 中 |
面试话术:
"幻觉和偏见不能只靠 Prompt 解决。幻觉治理要覆盖检索、生成、引用验证和拒答;公平性要用分群评测、数据治理和人工政策审查。除非团队实际参与模型训练,不应声称自己在 RLHF 阶段做了对齐。"
9. 如何评估LLM的输出质量?
图解:LLM 输出质量评估四象限
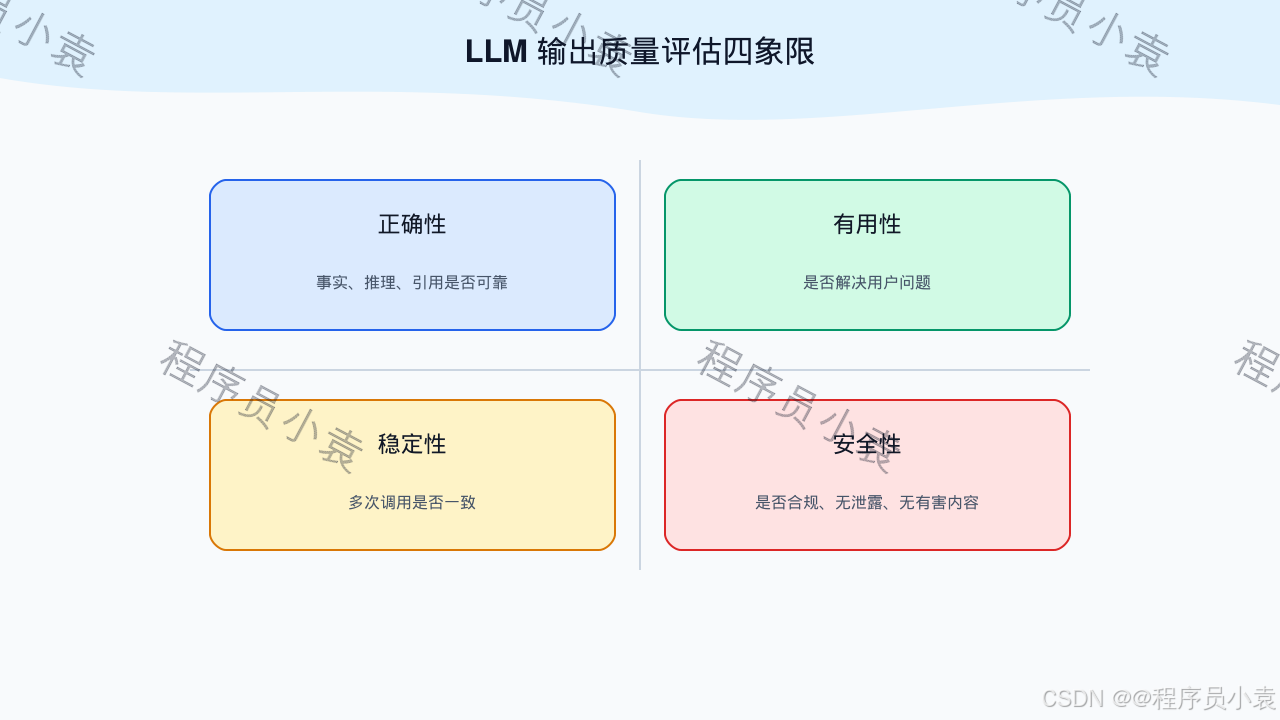
核心指标
💡 答案要点
自动评估指标
| 指标 | 适用场景 | 优缺点 |
|---|---|---|
| BLEU | 机器翻译 | 快速,但对创意文本不准 |
| ROUGE | 摘要生成 | 关注召回率 |
| BERTScore | 语义相似度 | 考虑语义,更智能 ⭐ |
| Perplexity | 基座模型语言建模 | 只能同 tokenizer/数据口径比较,低困惑度不等于事实正确 |
人工评估维度
| 维度 | 说明 | 示例问题 |
|---|---|---|
| 相关性 | 是否回答了问题 | 5分制评分 |
| 准确性 | 事实是否正确 | 有无幻觉 |
| 流畅性 | 语言是否通顺 | 是否自然 |
| 完整性 | 信息是否充分 | 有无遗漏 |
RAG系统专用指标
python
# 使用 RAGAS 框架
from ragas import evaluate
from ragas.metrics import (
    faithfulness,        # 忠实度: 回答是否基于检索内容
    answer_relevancy,    # 相关性: 是否回答了问题
    context_recall,      # 召回率: 检索到了关键信息吗
    context_precision    # 精确率: 检索内容是否都有用
)

results = evaluate(
    dataset=test_data,
    metrics=[faithfulness, answer_relevancy, context_recall, context_precision]
)
面试话术:
"我会做分层评估:离线 golden set 看任务成功率、检索 Recall/nDCG、答案忠实度与引用正确性;高风险样本人工复核;线上看用户纠错、拒答率、延迟和成本。LLM-as-a-judge 也要用人工样本校准,并防止同源模型偏差。"
10. Tokenization分词算法:BPE vs SentencePiece
Tokenization = 将文本切分成模型能理解的最小单位(Token)
BPE(Byte Pair Encoding)算法
💡 答案要点
BPE = 基于频率的子词分词算法
工作原理:
text
1. 初始化:每个字符是一个token
   "low" → ["l", "o", "w"]
   "lower" → ["l", "o", "w", "e", "r"]
   "lowest" → ["l", "o", "w", "e", "s", "t"]

2. 统计相邻字符对频率
   "lo": 3次 (最高)
   "ow": 3次
   "we": 2次
   ...

3. 合并最高频对
   "lo" → "lo"(一个token)
   "low" → ["lo", "w"]
   "lower" → ["lo", "w", "e", "r"]

4. 重复统计合并,直到词汇表达到目标大小
   "low" → ["low"]
   "lower" → ["low", "er"]
   "lowest" → ["low", "est"]
优点:
- ✅ 处理未知词:罕见词拆成已知子词
- ✅ 词汇表可控:可设定大小(如50k)
- ✅ 平衡粒度:介于字符和单词之间
缺点:
- ❌ 依赖预分词(需要先按空格分)
- ❌ 语言相关(中文日文处理困难)
代码示例:
python
from tokenizers import Tokenizer, models, pre_tokenizers, trainers

# 创建BPE tokenizer
tokenizer = Tokenizer(models.BPE())
tokenizer.pre_tokenizer = pre_tokenizers.Whitespace()

# 训练
trainer = trainers.BpeTrainer(vocab_size=50000, special_tokens=["[PAD]", "[UNK]"])
tokenizer.train(files=["train.txt"], trainer=trainer)

# 使用
output = tokenizer.encode("GPT使用BPE分词")
print(output.tokens)  # ['GPT', '使', '用', 'BP', 'E', '分', '词']
SentencePiece算法
💡 答案要点
SentencePiece = 语言无关的分词算法
核心特性:
- 无需预分词
text
BPE: "你好世界" → 需要先分词 → ["你好", "世界"]
SentencePiece: "你好世界" → 直接处理原始文本- 空格也是token
text
"Hello World"
→ ["▁Hello", "▁World"]  # ▁ 代表空格
→ 可逆解码: "Hello World"- 支持两种算法
- BPE模式:类似标准BPE
- Unigram模式:概率分词,从大到小删减
Unigram vs BPE:
| 维度 | BPE | Unigram |
|---|---|---|
| 方向 | 从小到大合并 | 从大到小删减 |
| 确定性 | 确定 | 概率(多种分词) |
| 训练速度 | 慢 | 快 |
代码示例:
python
import sentencepiece as spm

# 训练
spm.SentencePieceTrainer.train(
    input='train.txt',
    model_prefix='m',
    vocab_size=50000,
    model_type='unigram',  # 或'bpe'
    character_coverage=0.9995  # 字符覆盖率
)

# 使用
sp = spm.SentencePieceProcessor(model_file='m.model')
tokens = sp.encode('GPT使用SentencePiece分词', out_type=str)
print(tokens)  # ['▁GPT', '使用', 'Sen', 'tence', 'Piece', '分词']

# 解码
text = sp.decode(tokens)
print(text)  # 'GPT使用SentencePiece分词'
优势:
- ✅ 语言无关(中英日韩都OK)
- ✅ 无损可逆(空格也编码)
- ✅ 无需预分词
- ✅ LLaMA、T5 等模型使用;GPT 系列通常采用 byte-level BPE / tiktoken,而不是 SentencePiece
BPE 与 SentencePiece 的关系
💡 答案要点
严格来说二者不在同一层级:BPE 是子词切分算法 ;SentencePiece 是直接在原始文本上训练 tokenizer 的工具/实现框架,可选择 BPE 或 Unigram 算法。
| 维度 | BPE | SentencePiece |
|---|---|---|
| 类型 | 子词合并算法 | tokenizer 工具,支持 BPE / Unigram |
| 预分词 | 取决于具体实现;byte-level BPE 可不依赖词级预切分 | 直接处理原始文本 |
| 空格处理 | 取决于实现,byte-level BPE 可保留 | 常用 ▁ 显式表示词首空格 |
| 多语言 | 取决于词表与训练语料 | 对无空格语言和多语言语料友好 |
| 主流应用 | GPT-2/3/4 系的 byte-level BPE 思路 | LLaMA、T5 等 |
实际案例:
python
# 同一个文本的分词对比
text = "2024年AI发展很快"

# BPE (GPT-2)
['2024', '年', 'AI', '发', '展', '很', '快']  # 中文粒度太细

# SentencePiece (LLaMA)
['▁2024', '年', 'AI', '发展', '很快']  # 更合理的子词
为什么LLM数学差?
- Token化不一致
text
"1234" → ["12", "34"]
"1235" → ["123", "5"] # 不一致!- 模型难以学习数字规律
面试话术:
"BPE 是子词合并算法,SentencePiece 是可以运行 BPE 或 Unigram 的 tokenizer 框架,二者不能简单理解成前后两代。GPT 系常见 byte-level BPE/tiktoken,LLaMA、T5 等常见 SentencePiece。选型要看语言覆盖、词表大小、压缩率、特殊 token 和目标领域语料,并用真实数据比较 token 数和下游效果。"
11. 长文本处理:超出Context Window怎么办?
图解:超出 Context Window 的处理决策
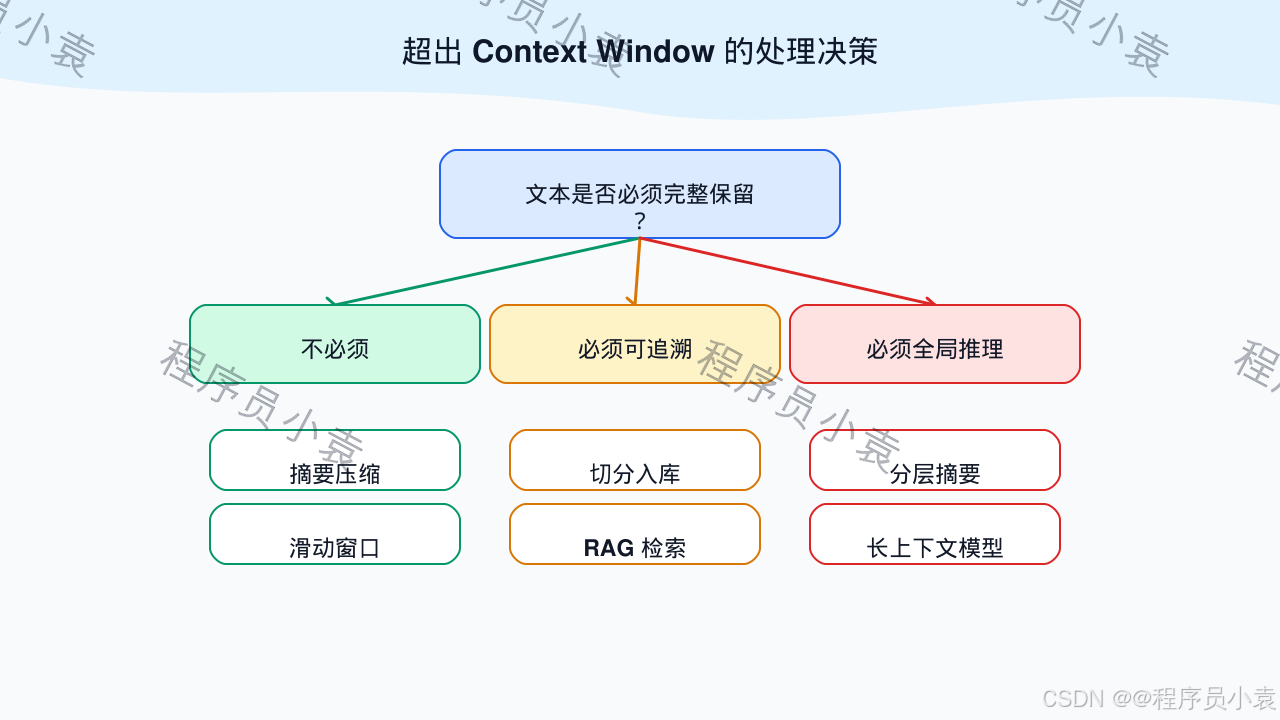
💡 答案要点
问题背景:
text
用户上传100页PDF(约50K tokens)
目标模型的可用上下文不足,或直接塞入全文的成本/效果不可接受
怎么处理?
解决方案对比
| 方案 | 原理 | 优缺点 | 适用场景 |
|---|---|---|---|
| 截断 | 丢弃超出部分 | 可能丢失信息 | 明确知道可丢内容时 |
| 滑动窗口 | 保留最近N个token | ❌丢失早期信息 | 实时对话 |
| 摘要压缩 | LLM递归摘要 | ⚠️可能失真 | 文档概览 |
| RAG分块 | 切分+检索 | 可扩展且可引用,但可能漏召回 | 定向问答/检索 |
| 长上下文模型 | 直接处理较完整材料 | 简化流程,但仍有成本、位置偏差和权限问题 | 全局总结/跨文档综合 |
| 服务端压缩 | 保留高价值状态后继续 | 可能产生压缩损失 | 长时间 Agent/对话 |
方案1: 滑动窗口(Sliding Window)
原理:
python
# 维护一个固定大小的窗口
max_tokens = 4000
history = []

while True:
    user_input = get_user_input()
    history.append(user_input)

    # 计算总token数
    total_tokens = count_tokens(history)

    # 超出窗口,删除最早的消息
    while total_tokens > max_tokens:
        history.pop(0)  # 删除第一条
        total_tokens = count_tokens(history)

    # 用窗口内容生成回复
    response = llm.generate(history)
    history.append(response)
优化: 分层管理
python
class ConversationManager:
    def __init__(self, max_recent=3, summary_every=10):
        self.recent_messages = []  # 最近3轮完整保留
        self.summary = ""           # 历史摘要
        self.message_count = 0

    def add_message(self, role, content):
        self.recent_messages.append({"role": role, "content": content})
        self.message_count += 1

        # 保留最近3轮
        if len(self.recent_messages) > 6:  # 3轮=6条消息
            # 把旧消息做摘要
            old = self.recent_messages.pop(0)
            old_pair = self.recent_messages.pop(0)

            self.summary += llm.summarize([old, old_pair])

        return self.get_context()

    def get_context(self):
        # 上下文 = 历史摘要 + 最近3轮原文
        context = []
        if self.summary:
            context.append({
                "role": "system",
                "content": f"历史对话摘要: {self.summary}"
            })
        context.extend(self.recent_messages)
        return context

# 使用
manager = ConversationManager()
manager.add_message("user", "你好")
manager.add_message("assistant", "你好,有什么可以帮你?")
...
context = manager.get_context()  # 自动管理上下文
效果:
- Token消耗: 稳定在4K以内
- 信息保留: 最近3轮完整+历史摘要
- 成本: 每10轮多1次摘要API调用
方案2: RAG分块检索(推荐⭐)
完整流程:
python
# 步骤1: 文档预处理
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,       # 每块1000字符
    chunk_overlap=200,     # 200字符重叠
    separators=["\n\n", "\n", "。", ". "]
)

chunks = splitter.split_text(long_document)
# 100页PDF → 约150个chunks

# 步骤2: 向量化存储
from langchain.vectorstores import Qdrant
from langchain.embeddings import OpenAIEmbeddings

embeddings = OpenAIEmbeddings()
vector_store = Qdrant.from_texts(
    texts=chunks,
    embedding=embeddings,
    collection_name="my_documents"
)

# 步骤3: 用户提问时检索
def answer_question(question):
    # 检索top-5相关chunks
    relevant_chunks = vector_store.similarity_search(
        question, k=5
    )

    # 拼接成上下文
    context = "\n\n".join([chunk.page_content for chunk in relevant_chunks])

    # LLM生成答案
    prompt = f"""
    基于以下内容回答问题:

    {context}

    问题: {question}
    答案:
    """

    answer = llm.generate(prompt)
    return answer

# 使用
question = "文档中提到的主要结论是什么?"
answer = answer_question(question)
优势:
- ✅ 索引规模不受单次模型窗口直接限制
- ✅ 只检索相关部分,节省token
- ✅ 可追溯来源(返回chunk ID)
方案3: 递归摘要
Map-Reduce摘要:
python
def recursive_summarize(long_text, max_chunk_size=4000):
    # 如果短于限制,直接摘要
    if len(long_text) < max_chunk_size:
        return llm.summarize(long_text)

    # 切分
    chunks = split_text(long_text, max_chunk_size)

    # Map: 每个chunk单独摘要
    summaries = [llm.summarize(chunk) for chunk in chunks]

    # Reduce: 合并摘要
    combined = "\n\n".join(summaries)

    # 递归(如果合并后还是太长)
    return recursive_summarize(combined, max_chunk_size)

# 示例
long_doc = load_100_page_pdf()
summary = recursive_summarize(long_doc)
print(summary)  # 最终浓缩版
适用场景:
- 只需要概览,不需要细节
- 没有特定问题,想了解大意
方案4: 长上下文模型
型号和价格变化很快,参见本文件第 3 节的截至 2026-10官方表。选型不要只看最大窗口,还要测:
| 维度 | 需要验证的问题 |
|---|---|
| 有效召回 | 证据位于首/中/尾时,准确率是否稳定? |
| 综合能力 | 是否能跨章节比较、处理冲突并给出可定位引用? |
| 总成本 | 长上下文费率、缓存命中、输出与推理 token 如何计费? |
| 延迟 | 首 token、完整响应和并发下 P95/P99 是否达标? |
| 数据治理 | 提交到第三方 API 的数据是否符合地域、留存和权限要求? |
选择策略:
python
def choose_strategy(task, token_count, requires_global_view):
    if requires_global_view and fits_verified_window(token_count):
        return "long_context_with_citations"
    if task == "targeted_qa":
        return "hybrid_rag_with_rerank"
    return "hierarchical_chunking_and_synthesis"
Lost in the Middle问题
现象:
text
给LLM一个20K的文档,关键信息在中间
→ LLM往往只关注开头和结尾
→ "大海捞针"失败
解决:
python
# 方法1: 把关键内容放开头/结尾
prompt = f"""
关键信息: {key_info}

背景资料:
{long_context}

问题: {question}
"""

# 方法2: 分段+多次查询
def multi_pass_qa(long_text, question):
    # Pass 1: 快速扫描找相关段落
    relevant_sections = quick_scan(long_text, question)

    # Pass 2: 深入分析相关段落
    answers = []
    for section in relevant_sections:
        answer = llm.generate(f"{section}\n\n{question}")
        answers.append(answer)

    # Pass 3: 综合答案
    final = llm.generate(f"综合以下答案: {answers}")
    return final
面试话术:
"长文本没有单一最优解。定向问答通常用混合检索+Rerank+引用;需要全局综合时优先评测长上下文或分层 Map-Reduce;长时间 Agent 则结合工作记忆、持久状态和服务端 compaction。所有方案都要测中间位置召回、引用正确率、延迟和总成本。"
📝 速记卡片
LLM基础概念
| 概念 | 一句话解释 |
|---|---|
| Token | 模型处理文本的离散单位,数量必须按具体 tokenizer 计算 |
| Temperature | 调整采样分布;低温通常更稳定,但 0 不保证逐字确定 |
| Context Window | 单次推理可用的总 token 预算,标称长度不等于有效理解长度 |
| 长文本处理 | 长上下文、RAG、分层摘要、状态压缩按任务组合 |
| Lost in the Middle | 长文本中间信息丢失,解决:关键信息放开头 |
| 涌现能力 | 特定指标上的非线性能力变化;可能受评测阈值影响 |
| 灾难性遗忘 | 学新任务干扰旧能力;LoRA可降低改动范围但不能保证消除 |
| 幻觉 | 无依据或错误生成;用 grounding、验证、拒答和人工复核治理 |
| 偏见 | 对性别/种族的不公平输出,RLHF对齐 |
| RAGAS | RAG系统评估框架(忠实度、召回率、精确率) |
分词算法
| 算法 | 原理 | 优缺点 |
|---|---|---|
| BPE | 高频符号对合并 | 是否预分词、是否保留空格取决于具体实现 |
| SentencePiece | 直接在原始文本上训练 tokenizer 的框架 | 可运行 BPE 或 Unigram |
| Unigram | 从候选子词词表中做概率选择与剪枝 | 是算法,不应与具体模型系列强绑定 |
官方与论文来源(截至 2026-10)参考
- OpenAI:GPT-6 Sol and Luna
- OpenAI:Responses API 的原生 compaction
- OpenAI:Reasoning models 指南
- Anthropic:Models overview
- Anthropic:Context windows
- Google:Gemini 3.8 Flash 模型页
- DeepSeek:Models & Pricing
- Qwen:Qwen3.8 官方仓库
- Meta:Llama 4 官方发布
- Emergent Abilities of Large Language Models
- Are Emergent Abilities of Large Language Models a Mirage?