RNN介绍
词嵌入层
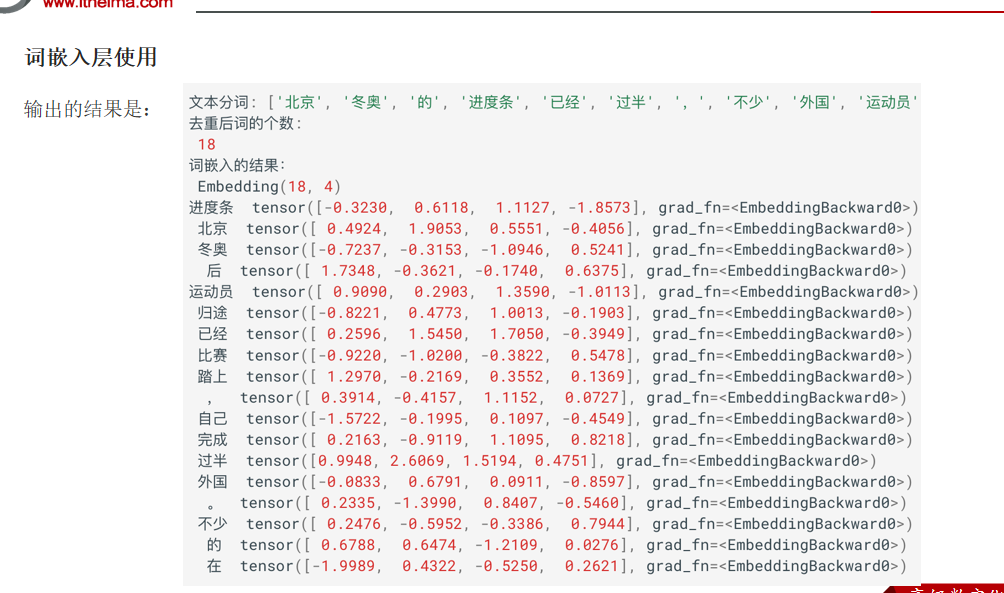
python
"""
案例:
    演示词嵌入层的API应用.

RNN介绍:
    全称叫Recurrent neural network, 循环神经网络, 主要处理 序列数据的.
    序列数据: 后边数据对前边的数据有依赖, 例如: 天气预测, 股市分析, 文本生成...

    组成:
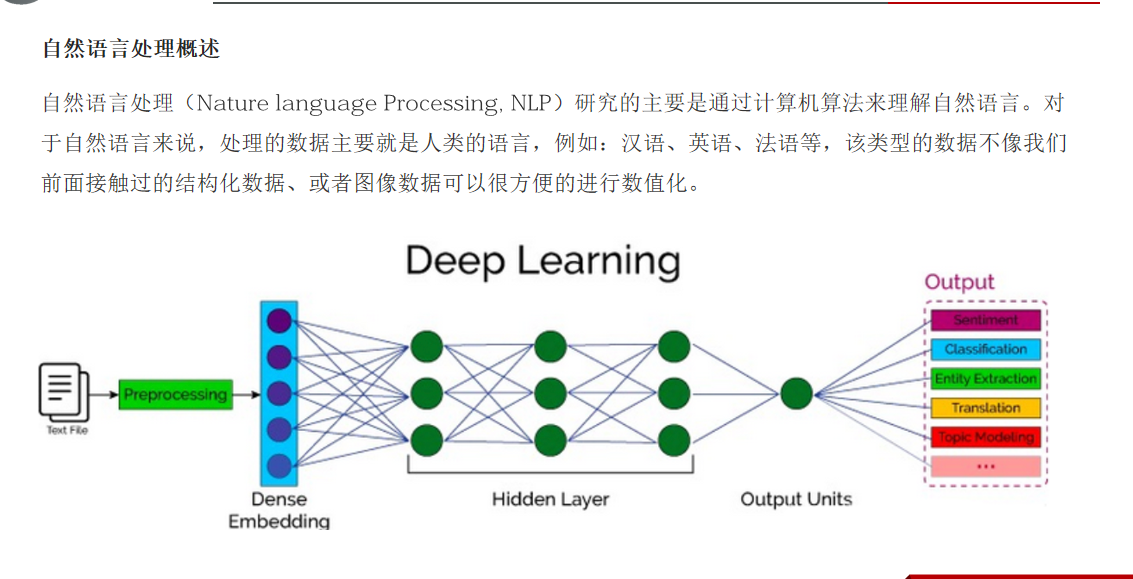
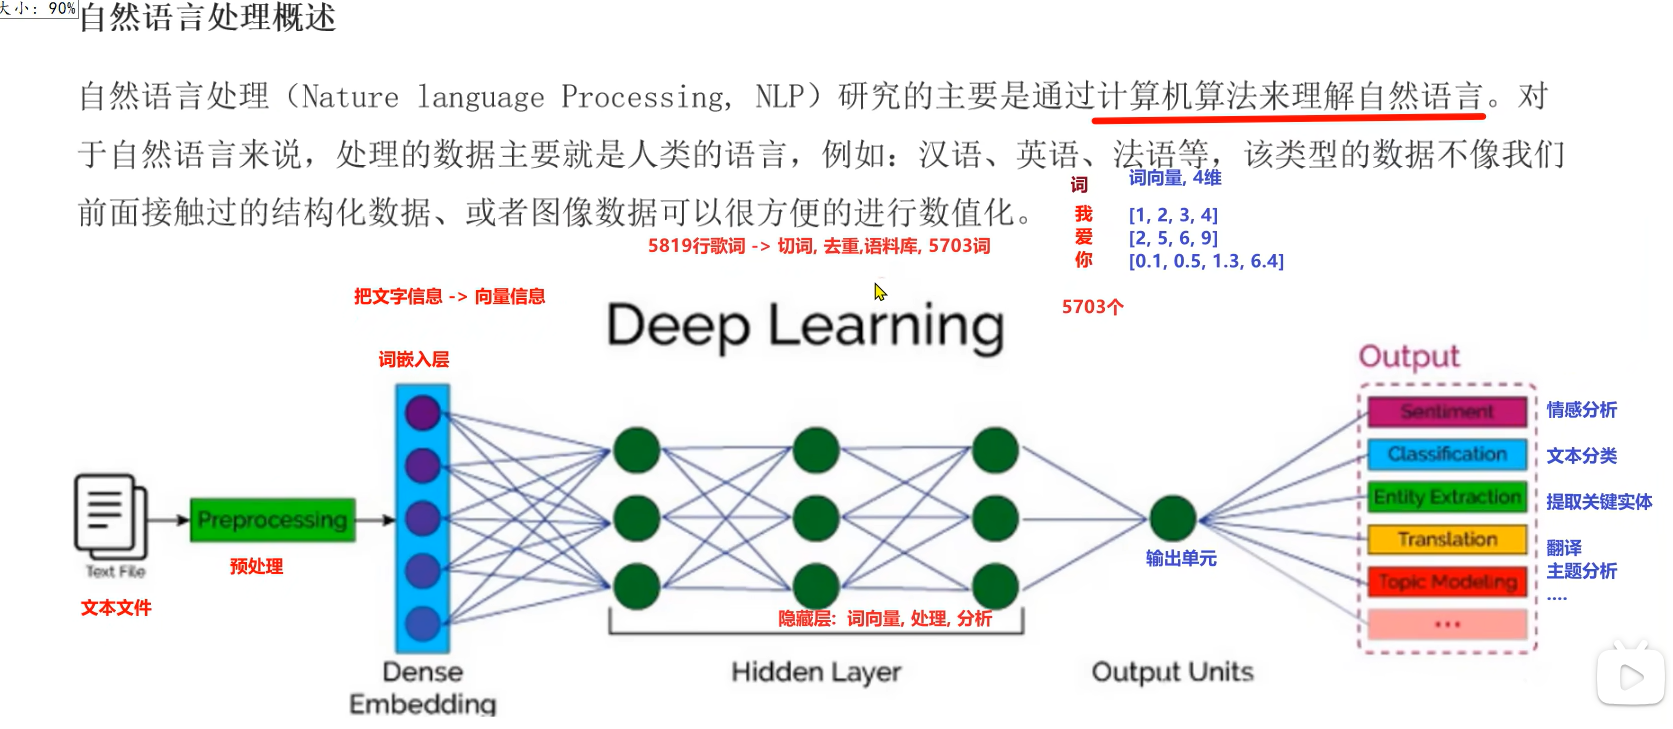
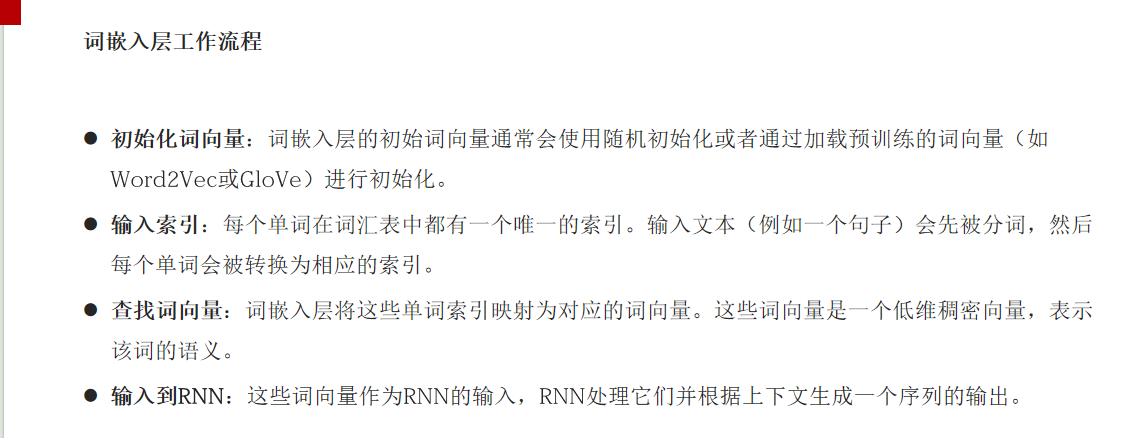
        词嵌入层
        循环网络层
        输出层

词嵌入层介绍(作用):
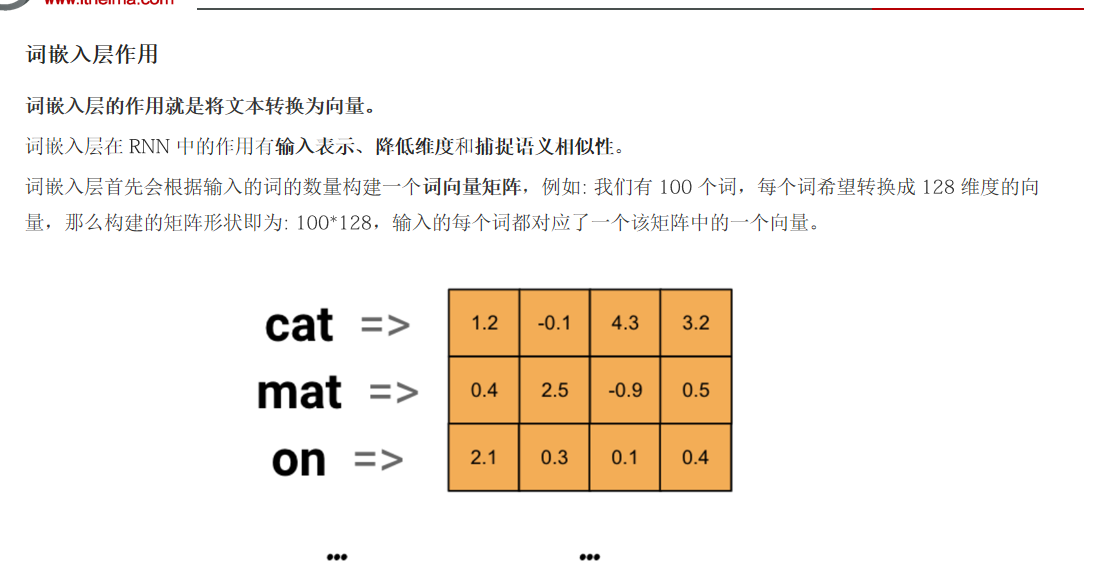
    把词 (或者 词对应的索引) 转成 词向量.
"""

# 导包
import torch
import jieba            # jieba分词器, 需要安装一下, pip install jieba
import torch.nn as nn

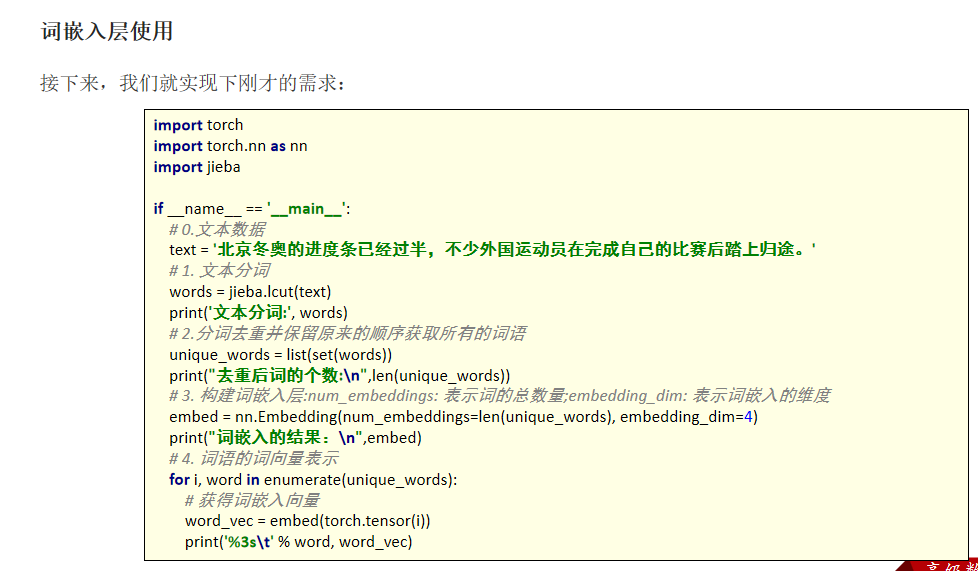
# 1.定义函数, 用于演示 词嵌入层的API, 如何把 词(词的索引) -> 词向量
def dm01():
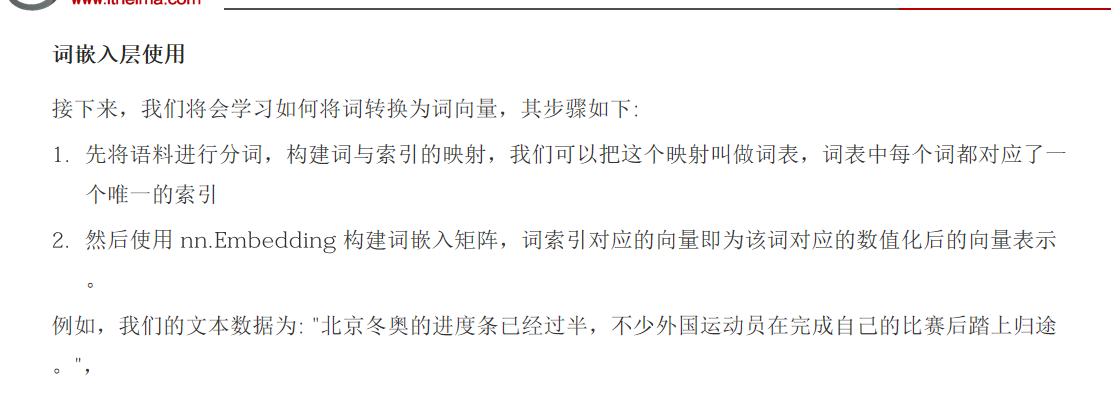
    # 1. 定义一句话
    text = '北京冬奥的进度条已经过半,不少外国运动员在完成自己的比赛后踏上归途。'
    # 2. 使用jiema模块进行分词.
    words = jieba.lcut(text)
    print(f'分词结果: {words}')     # ['北京', '冬奥', '的', '进度条', ...]

    # 3. 创建词嵌入层.
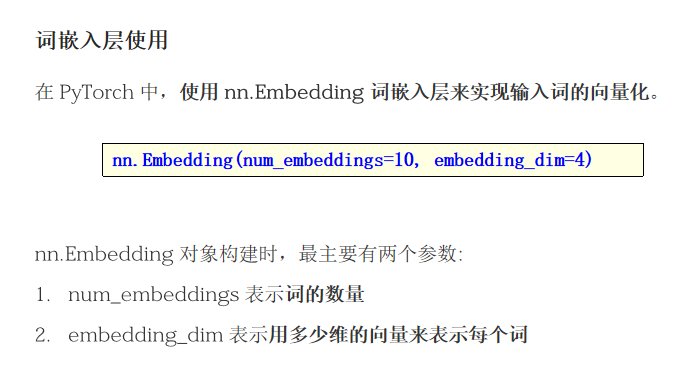
    # 参1: 词表大小(词的个数), 参2: 词向量的维度
    embed = nn.Embedding(len(words), 4)

    # 4. 获取每个词对象的下标索引.
    # i = 0
    # for word in words:
    #     print(i, word)
    #     i += 1

    # enumerate(): 返回列表中每个值 及其对应的 索引.
    for i, word in enumerate(words):    # 效果同上.
        # print(i, word)

        # 5. 把词索引(张量形式) 转成 词向量.
        word_vector = embed(torch.tensor(i))    # 随机的, 每次都不一样, 无所谓.
        print(f'词: {word}, \t\t词向量: {word_vector}')

# 2. 测试
if __name__ == '__main__':
    dm01()
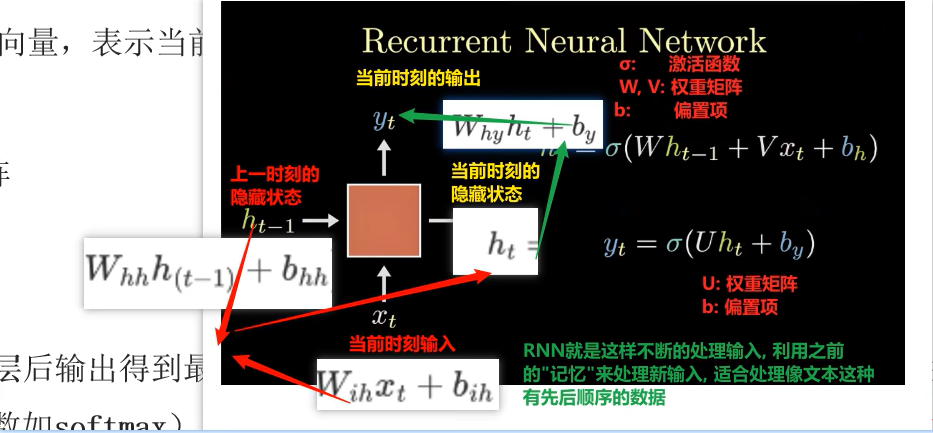
循环网络层
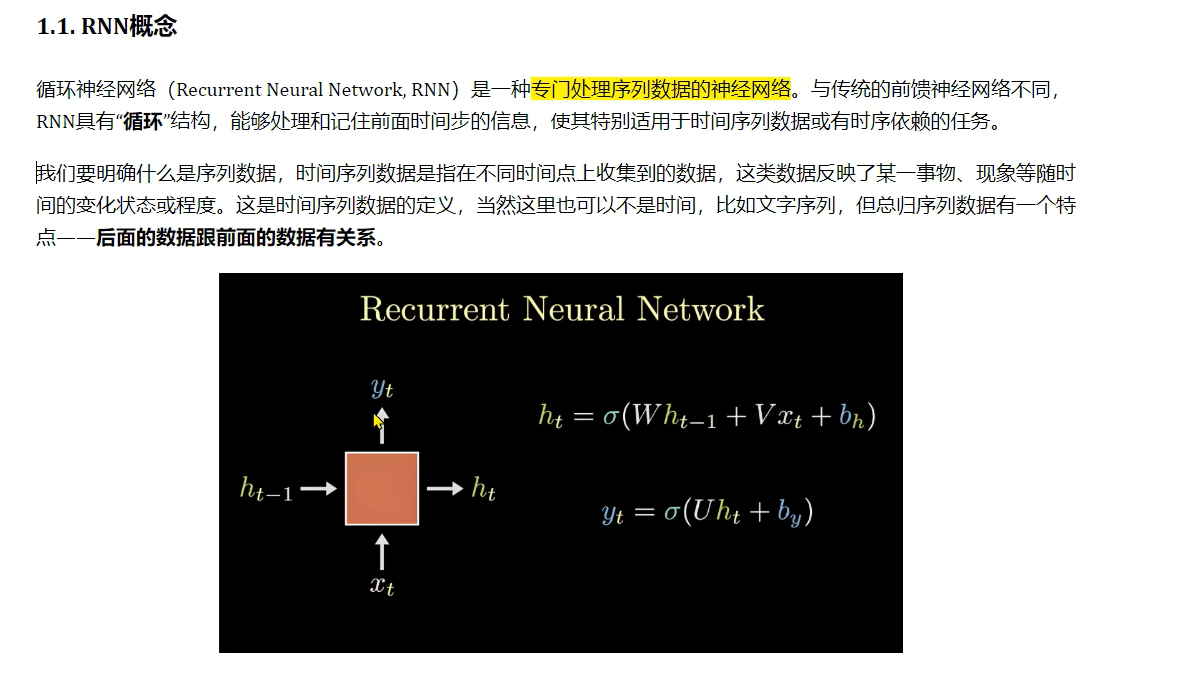
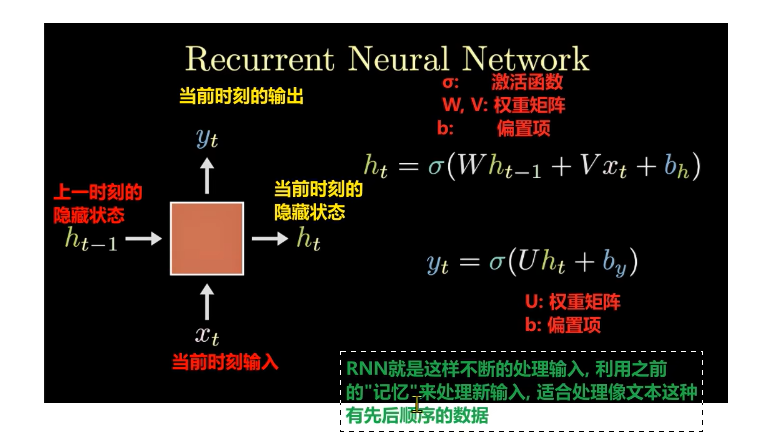
做了2次加权求和
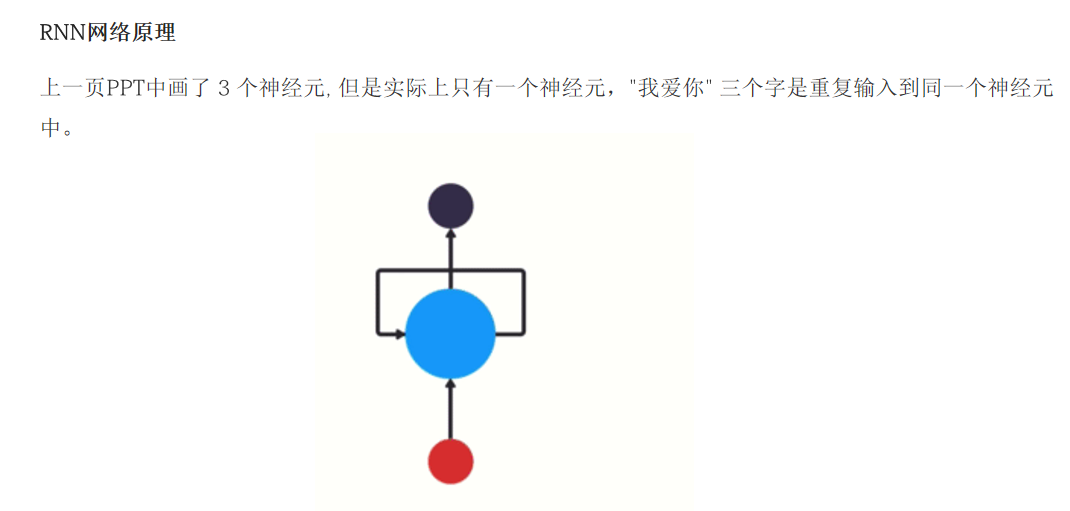
只有一个神经元
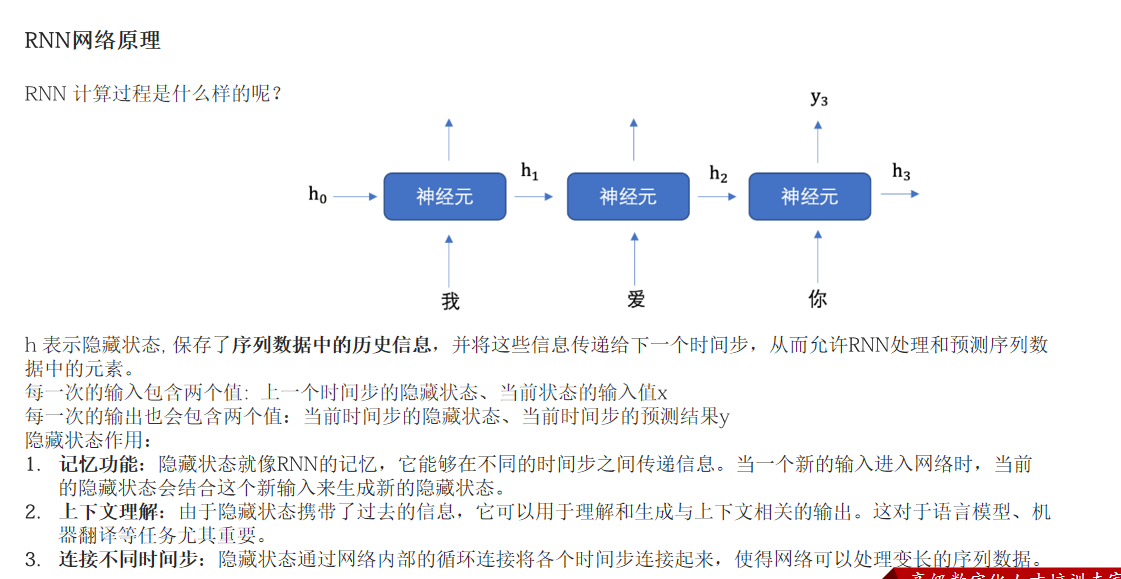
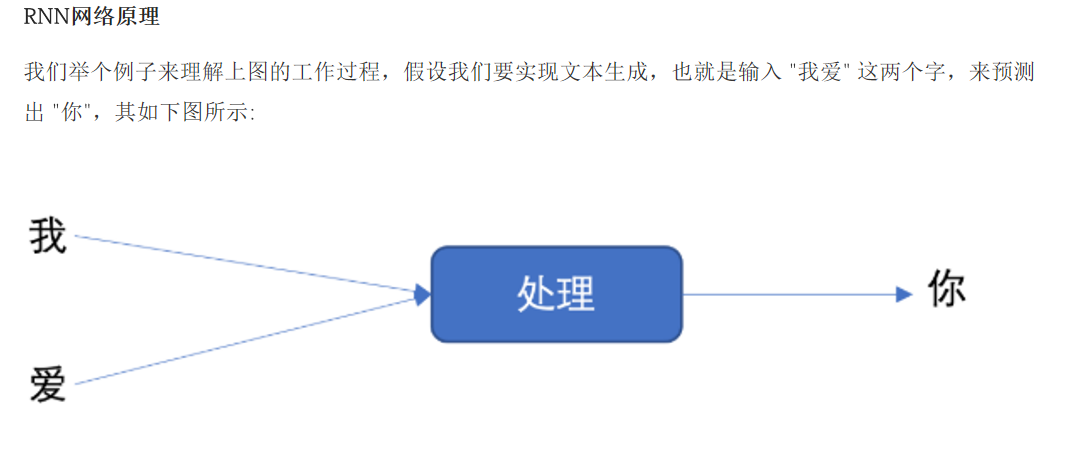
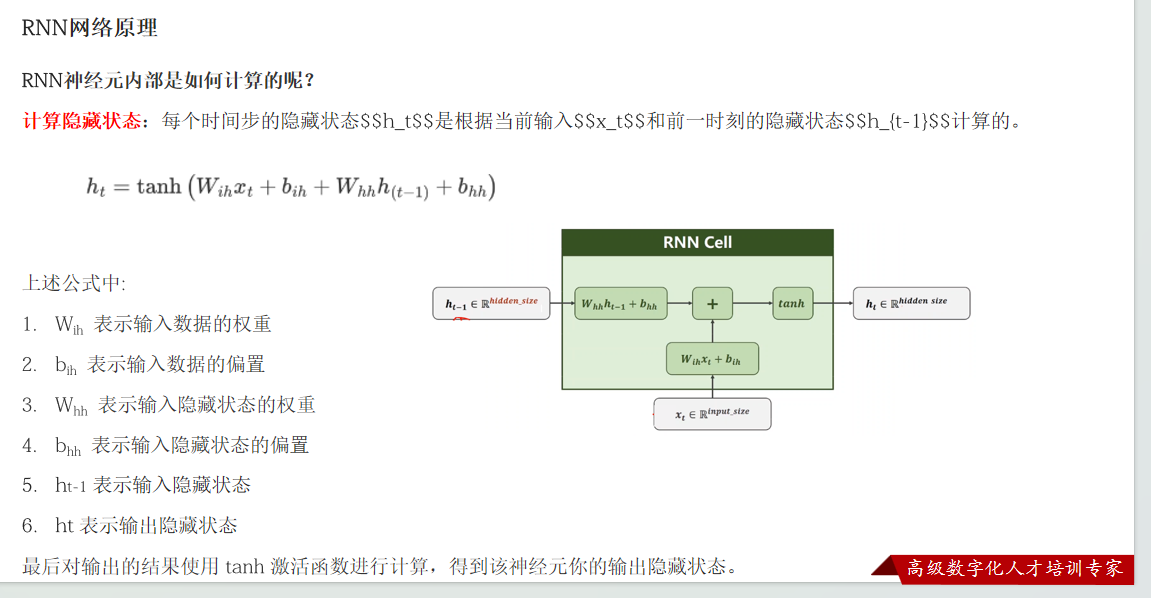
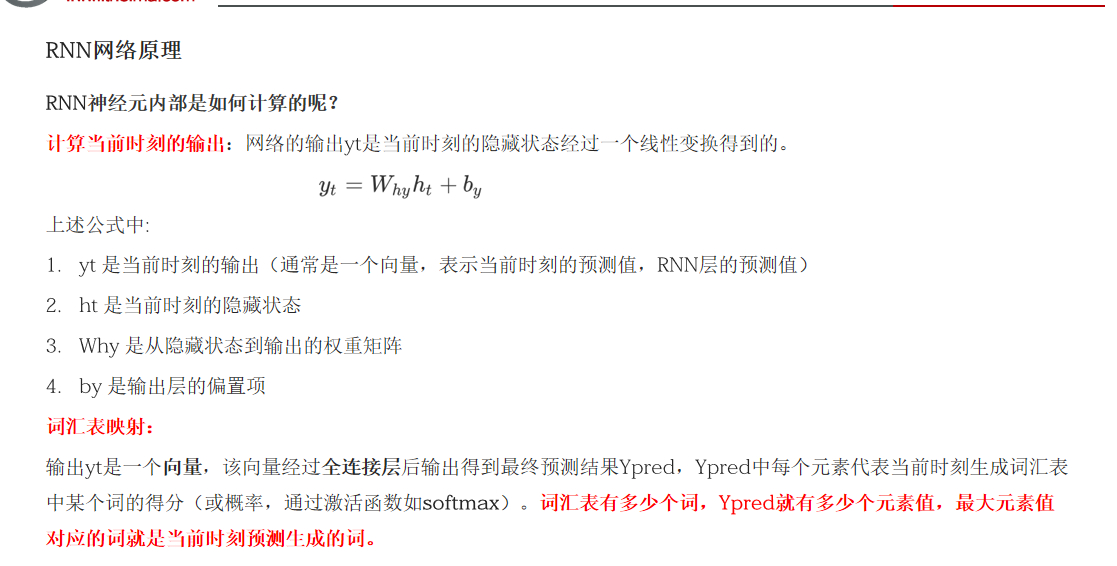
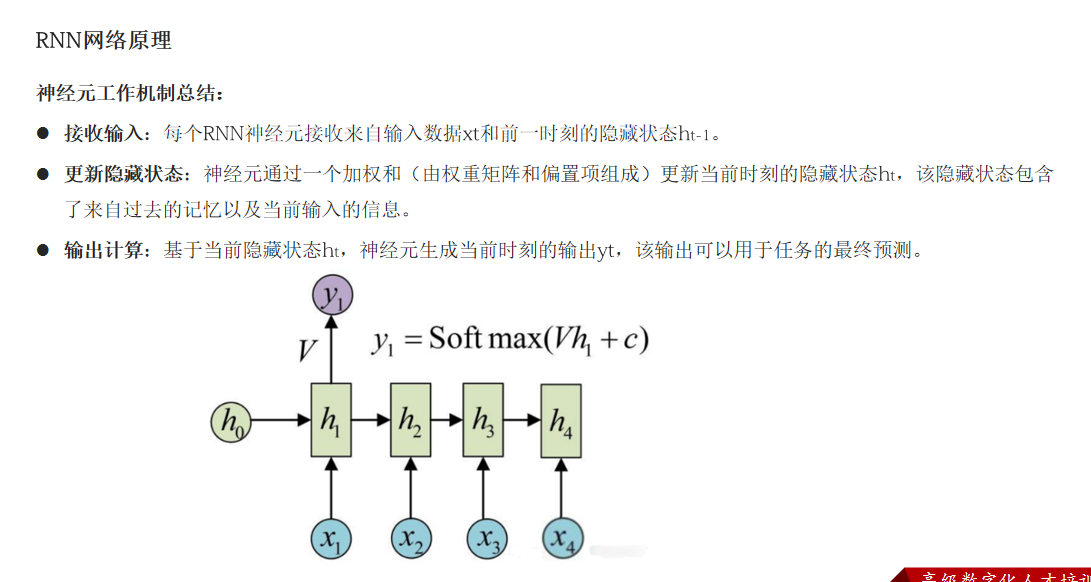
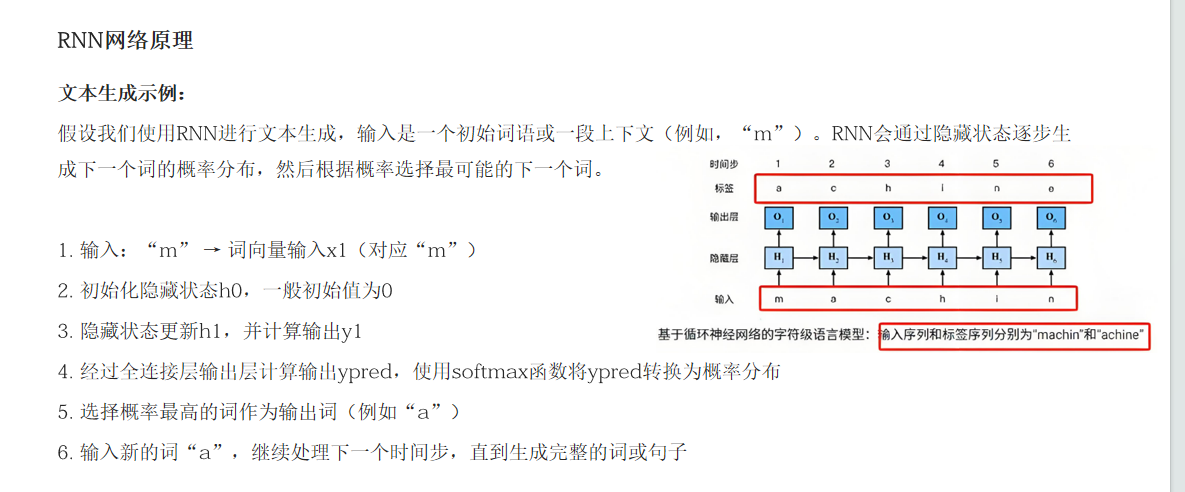
这个 32 代表的是 batch_size(批次大小),也就是一次性并行输入给模型处理的样本(句子)数量。
python
"""
案例:
    演示RNN层(循环网络层)的API.

循环网络层作用:
    基于 上一次的隐藏状态 + 本次的输入 -> 本次的隐藏状态, 本次的输出.

    公式:
        本次的隐藏状态 = tanh(上次的隐藏状态加权求和 + 本次的输入 加权求和)
        本次的输出 = 本次的隐藏状态加权求和, 有词汇表中所有词的概率, 选概率最大的哪个词作为 最终预测结果.

简单总结下RNN:
    词嵌入层:
        将词(词的索引) 转换为 词向量表示.
    RNN层(循环网络层):
        逐步处理词向量, 生成 每个时间步的 隐藏状态.
    全连接层(输出映射):
        通过线性变换将隐藏状态映射到输出, 通常是1个词汇表中词的概率分布.
"""

# 导包
import torch
import torch.nn as nn

# 大白话: RNN就像是你的大脑, 在看电影的过程中 记住剧情.

# 1. 创建 循环网络层.
# 参1: 词向量的维度, 就像电影里每一帧画面有128个细节(比如: 颜色, 动作, 表情等), RNN(你的大脑)每次看到的就是这128个细节.
# 参2: 隐藏状态向量维度, 你的大脑能记住的剧情信息量有多大, 比如说: 记住角色关系, 前景提要, 值越大, 能存储的剧情记忆就越多.
# 参3: 隐藏层数量, 默认是1, 你的大脑只有1层来处理它, 如果是1, 说明2层大脑接力理解剧情, 第1层处理, 第2层深加工.
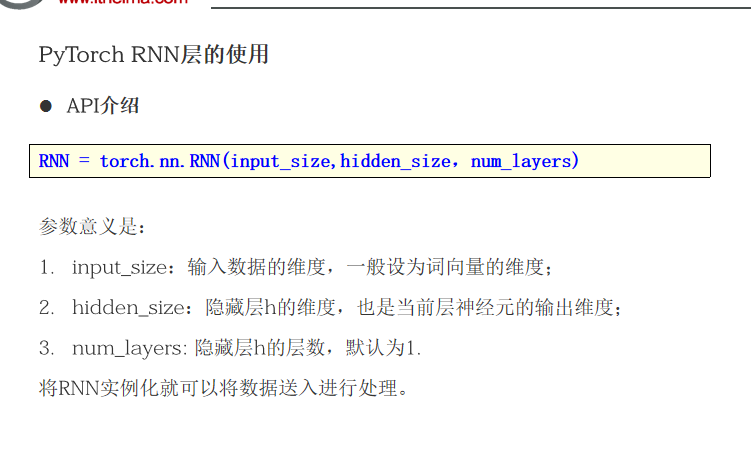
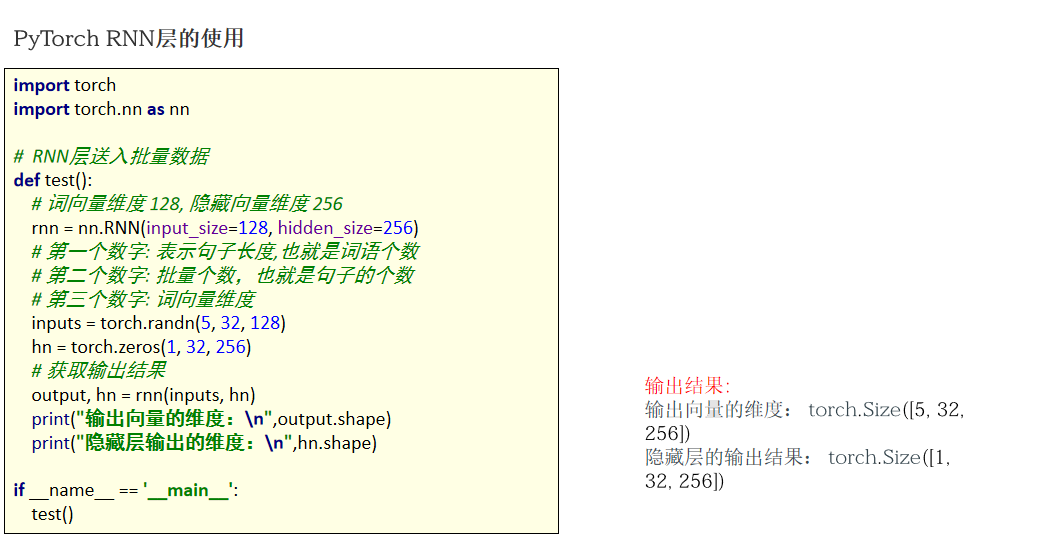
rnn = nn.RNN(input_size=128, hidden_size=256, num_layers=1)

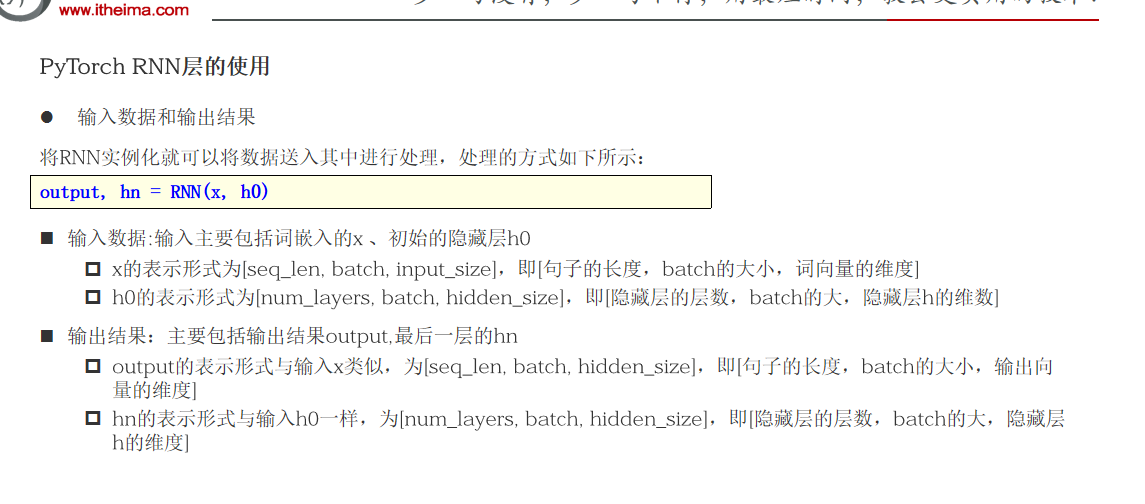
# 2. 定义变量, 表示输入的 x
# 参1: 每个句子的词的个数(长度),  假设电影总共有 5帧画面.
# 参2: 句子的数量,              同时有32个人在看这 5帧画面.
# 参3: 词向量的维度.            每一帧画面的细节是128个.
x = torch.randn(size=(5, 32, 128))

# 3. 定义变量, 记录: 上一时刻的隐藏状态.
# 参1: 隐藏层的层数,   RNN的层数, 和num_layers一样, 1层大脑.
# 参2: 句子的数量,     批量大小, 和上述的 x一样, 32个人...
# 参3: 隐藏状态向量维度,  和上述的 hidden_size一样, 256维.
h0 = torch.randn(size=(1, 32, 256))

# 4. 调用RNN处理, 获取到当前时刻的预测值 和 当前的隐藏状态.
# 参1: x, 本次的输入,  参2: h0, 上一次的隐藏状态.

# 返回值1 output: 每个时间步的输出, 包含了所有时间步的隐藏状态.  每看1帧画面, 大脑能记住的剧情 -> 共5帧, 32个人, 256维.
# 返回值2 h1: 最后1个时间步的隐藏状态.                       看完最后1帧画面后, 大脑里的最新剧情记忆 -> 只关注最后1帧.
output, h1 = rnn(x, h0)
print(f'output: {output.shape}')    # [5, 32, 256]
print(f'h1: {h1.shape}')           # [1, 32, 256]
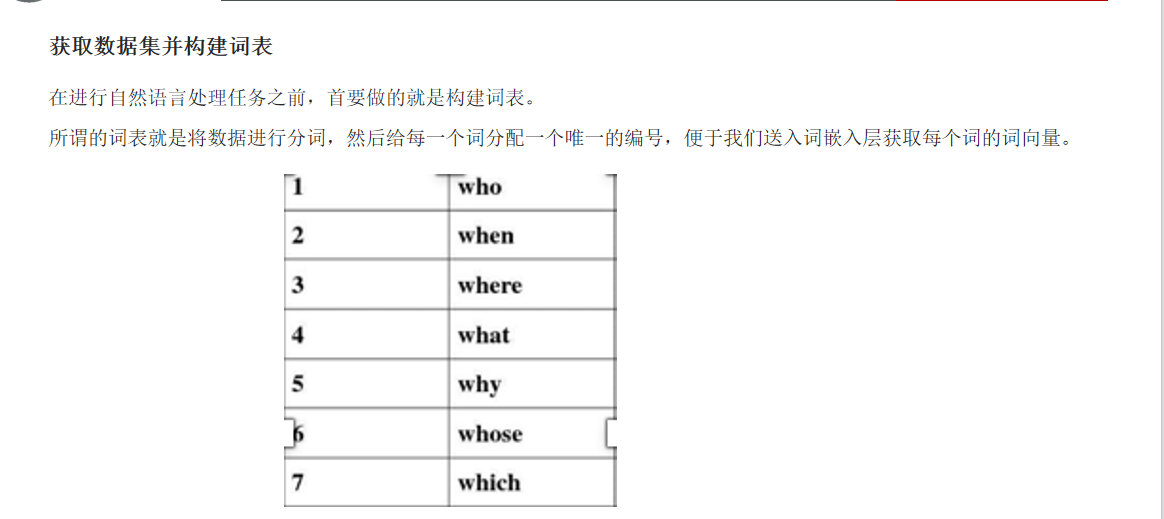
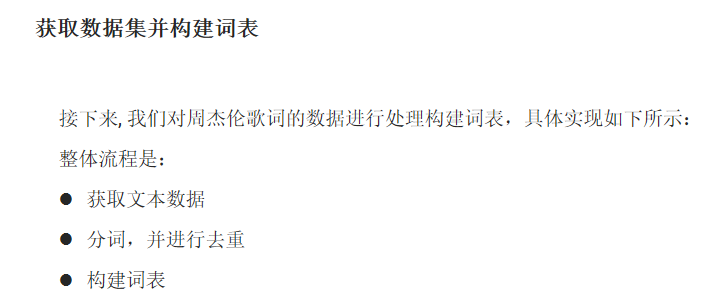
文本生成案例
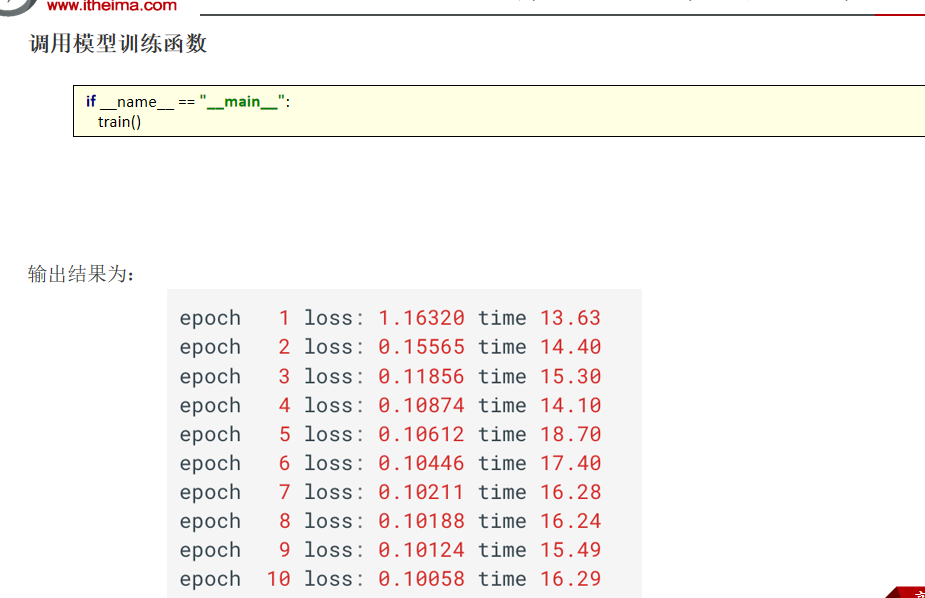
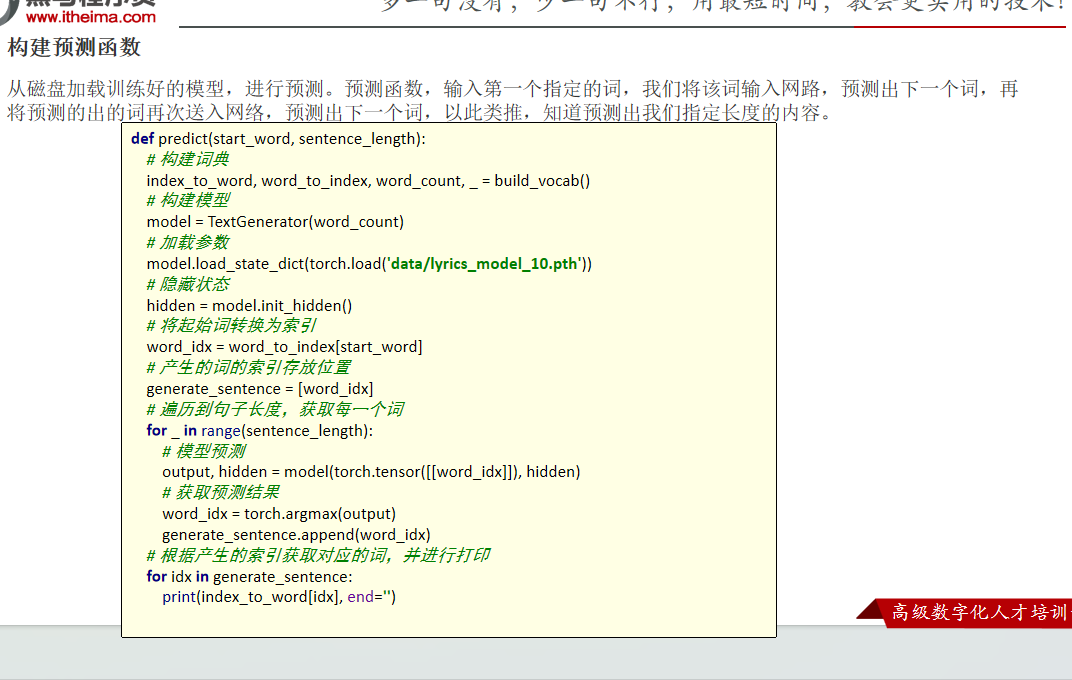
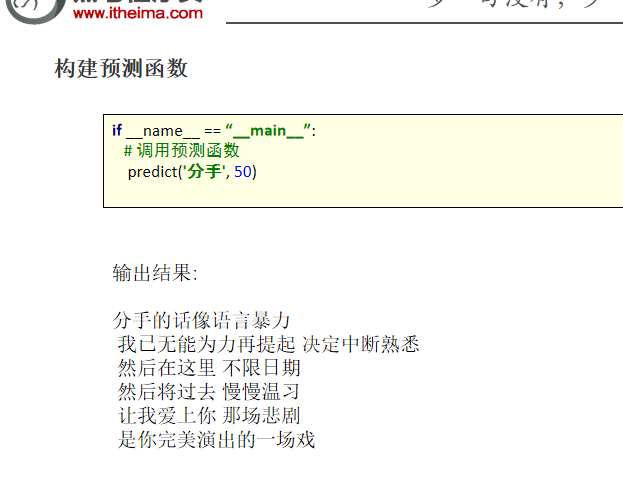
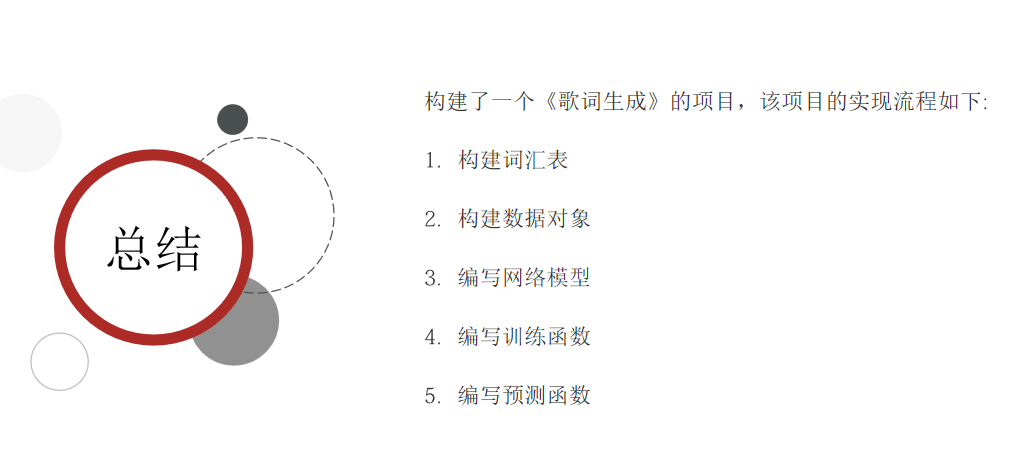
python
# 1. 获取数据, 进行分词, 获取词表.
def build_vocab():
    #定义变量记录去重的词和每行的结果
    #读取数据
        # 使用jieba分词器进行分词
    #开始映射,创建字典
    #将所有的索引也存入一个变量中
    #返回结果
# 2. 数据预处理, 构建数据集.
class LyricsDataset(torch.utils.data.Dataset):
    #初始化函数:词索引,句子数量,句子长度,每个句子词的个数
    #返回句子数量的函数
    #定义类似窗口的函数:给你索引,计算开始和结束的窗口位置,再分别+1就是y的窗口范围
# 3. 搭建RNN神经网络.
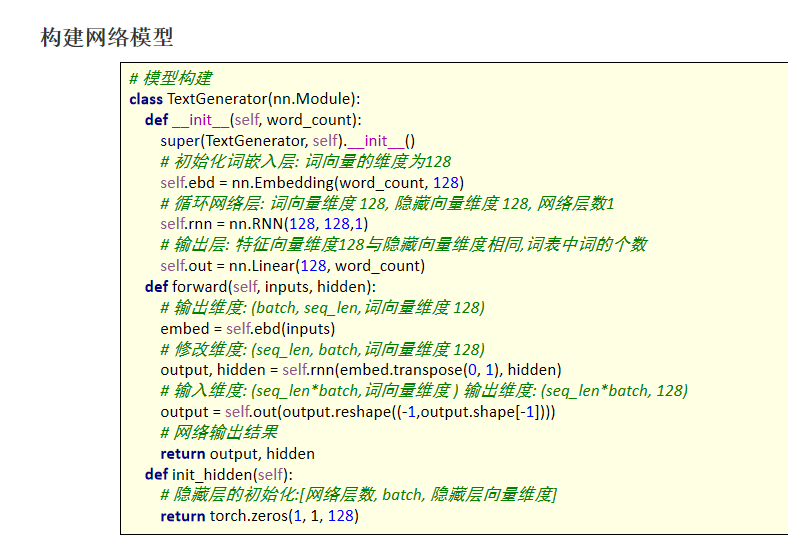
class TextGenerator(nn.Module):
    #1.定义初始化的方法:初始化父类成员,embedding,RNN,全连接层,
    #2.定义前向传播方法:进行词嵌入层的处理,RNN处理,全连接处理,返回结果
    #3.定义隐藏层的初始化方法
# 4. 训练模型.
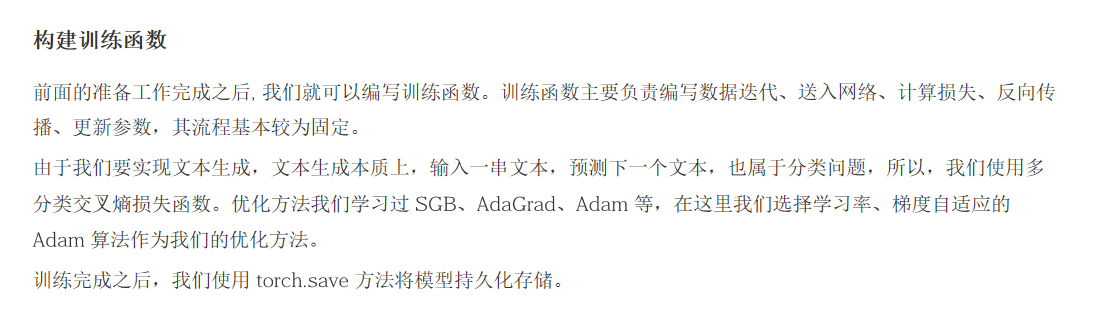
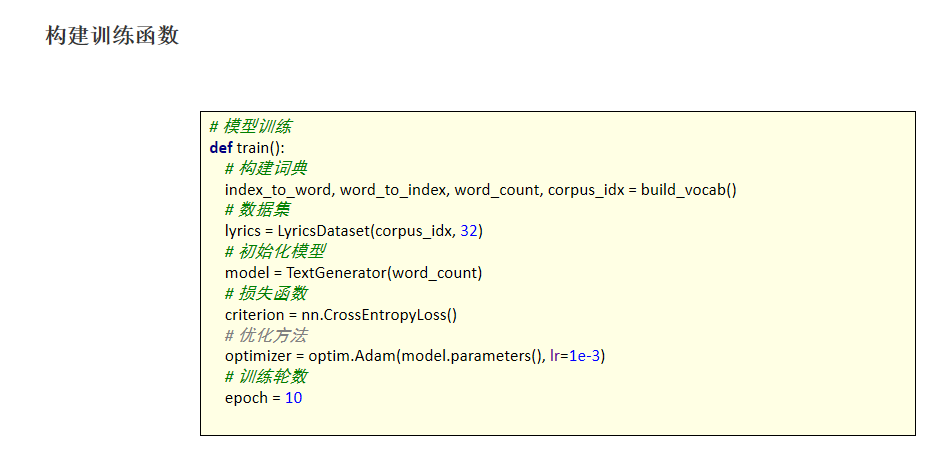
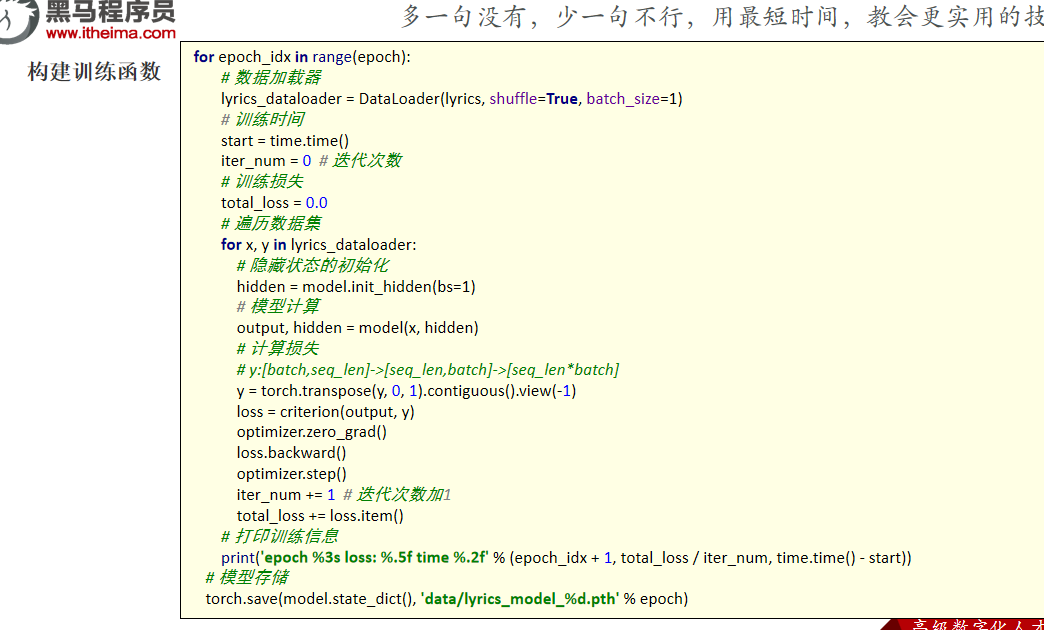
def train():
    #构建词典,获取数据集,初始化模型对象
    #创建数据加载器对象
    #定义损失函数,优化器
    #开始模型训练
        #定义变量记录:本轮的开始训练时间,迭代次数,训练总损失
        #具体每轮的各批次训练动作
           #获取隐藏层初始值,模型计算
           #计算损失
           #梯度清零,反向传播,更新参数
           #更新训练总损失
           #更新迭代次数
        # 7.10 走到这里, 说明 本轮训练结束, 打印本轮的训练信息.

    # 8. 走到这里, 说明多轮训练结束(模型训练结束), 保存即可.
# 5. 模型预测.
def evaluate(start_words,sentence_length):
    #构建词典,获取模型,加载模型参数
    #获取隐藏层初始值
    #将输入的开始词转换成索引,定义列表存放产生的词的索引
    #遍历句子长度,获取到每一个词
        #模型预测,获取预测结果,把预测结果的索引添加到列表中
    #将索引转换成词,并打印
python
"""
案例:
    RNN案例, 基于杰伦歌词来训练模型, 用给定的起始词, 结合长度, 来进行 AI歌词生成.

实现步骤:
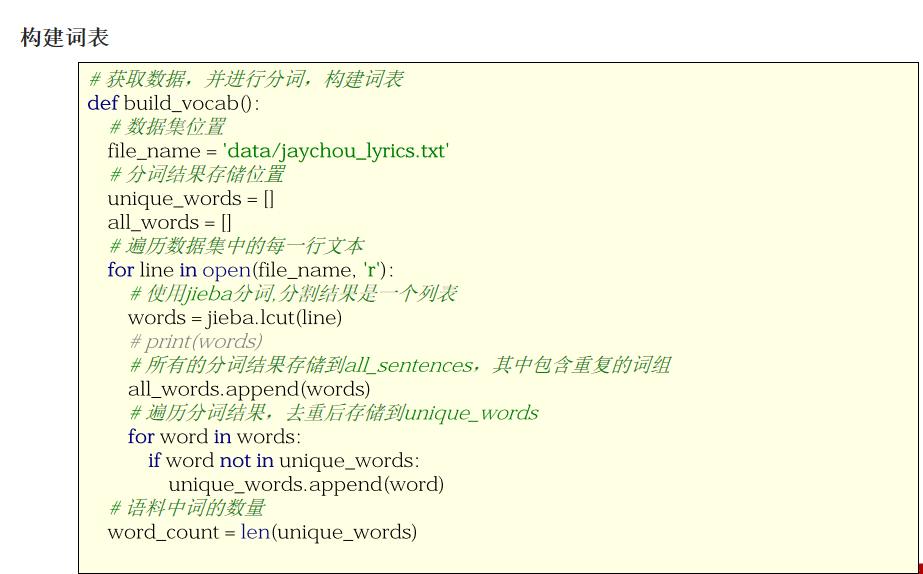
    1. 获取数据, 进行分词, 获取词表.
    2. 数据预处理, 构建数据集.
    3. 搭建RNN神经网络.
    4. 训练模型.
    5. 模型预测.
"""

# 导包
import torch
import jieba
from torch.utils.data import DataLoader
import torch.nn as nn
import torch.optim as optim
import time


# 1. 获取数据, 进行分词, 获取词表.
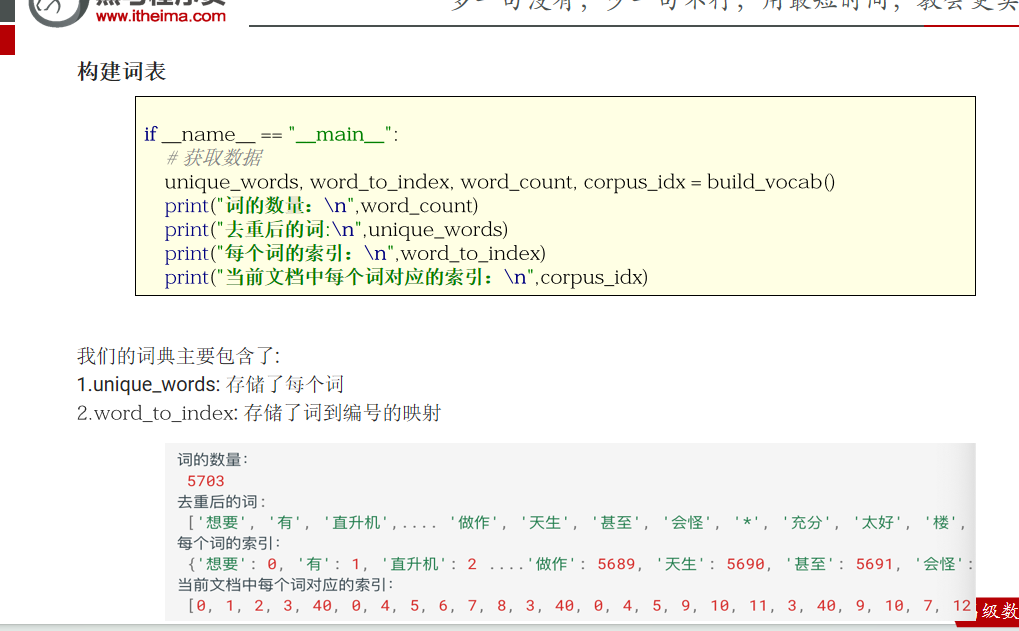
def build_vocab():
    # 1. 定义变量, 记录: 去重后所有的词, 每行文本分词结果.
    unique_words, all_words = [], []
    # 2. 遍历数据集, 获取到每行文本.
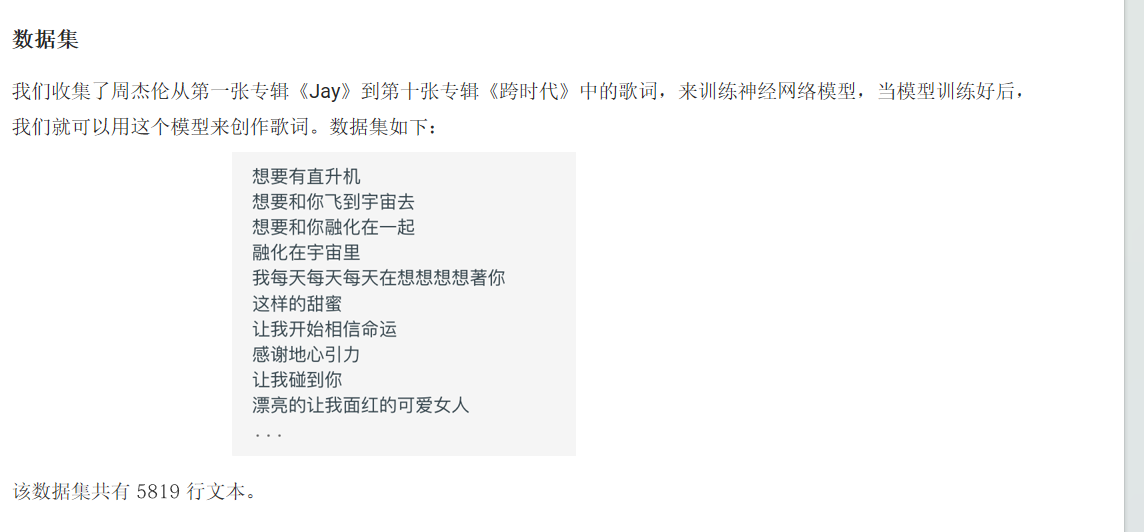
    for line in open('./data/jaychou_lyrics.txt', 'r', encoding='utf-8'):
        # 2.1 获取到每行歌词, 进行分词.
        words = jieba.lcut(line)  # ['想要', '有', '直升机', '\n']
        # 2.2 所有分词结果记录到  all_words 中.
        all_words.append(words)  # [['想要', '有', '直升机', '\n'], [第2句歌词切词], ......]
        # 2.3 遍历分词结果, 去重后, 添加到unique_words中.
        for word in words:
            if word not in unique_words:
                unique_words.append(word)
    # 3. 统计语料中(去重后)词的数量.
    word_count = len(unique_words)  # 5703个词
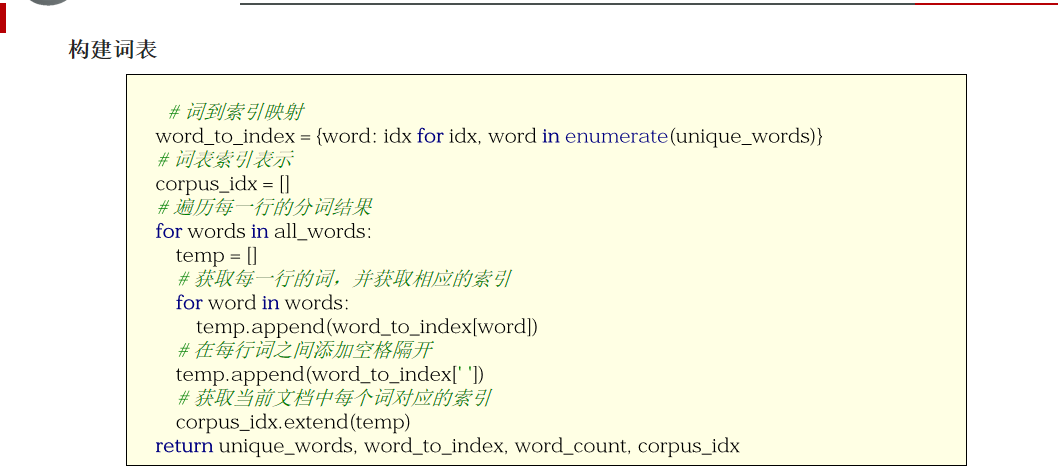
    # 4. 构建词表, 字典形式, key是词, value是词的索引.
    # 例如:  {'想要': 0, '有': 1, '直升机': 2, '\n': 3, ...'冠军': 5701, '要大卖': 5702}
    word_to_index = {word: i for i, word in enumerate(unique_words)}
    # 5. 歌词文本用词表索引表示.
    corpus_idx = []
    # 6. 遍历每一行的分词结果.
    for words in all_words:
        # 6.1 定义变量, 记录: 词索引列表.
        tmp = []
        # 6.2 获取每一行的词, 并获取相应的索引.
        for word in words:
            tmp.append(word_to_index[word])
        # 6.3 在每行词之间, 添加空格隔开.
        tmp.append(word_to_index[' '])
        # 6.4 获取文档中每个词的索引, 添加到corpus_idx中.
        corpus_idx.extend(tmp)
    # 7. 返回结果: 唯一词列表(5703个词), 词表 {'想要': 0, '有': 1, ... '要大卖': 5702},  (去重后)词的数量, 歌词文本用词表索引表示.
    return unique_words, word_to_index, word_count, corpus_idx


# 2. 数据预处理, 构建数据集.
# 定义数据集类, 继承 torch.utils.data.Dataset
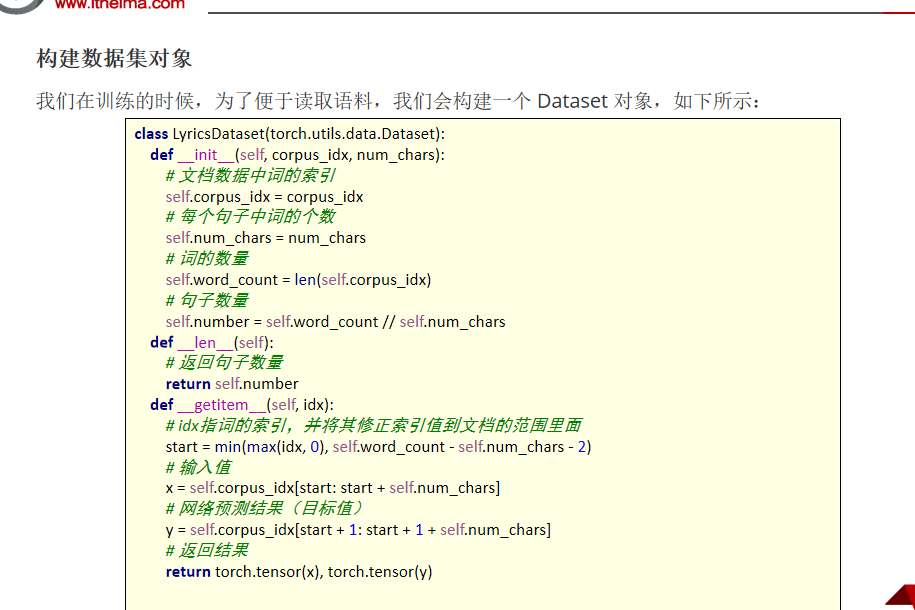
class LyricsDataset(torch.utils.data.Dataset):
    # 1. 初始化词索引, 词个数等...
    def __init__(self, corpus_idx, num_chars):
        # 1.1 文档数据中词的索引
        self.corpus_idx = corpus_idx
        # 1.2 每个句子中词的个数.
        self.num_chars = num_chars
        # 1.3 文档数据中词的数量, 不去重.
        self.word_count = len(self.corpus_idx)
        # 1.4 句子数量
        self.number = self.word_count // self.num_chars

    # 2. 当使用 len(obj)时, 自动调用此方法.
    def __len__(self):
        # 返回句子数量
        return self.number

    # 3. 当使用 obj[index]时, 自动调用此方法.
    def __getitem__(self, idx):
        # idx: 指的是词的索引, 并将其修正索引值 到 文档的范围里边.
        # 3.1 确保索引start在合法范围内, 避免越界, start: 当前样本的起始索引.
        start = min(max(idx, 0), self.word_count - self.num_chars - 1)
        # 3.2 计算当前样本的结束索引.
        end = start + self.num_chars
        # 3.3 输入值, 从文档中取出 start ~  end 的索引的词 -> 作为 x
        x = self.corpus_idx[start:end]
        # 3.4 输出值, 网络预测结果.
        y = self.corpus_idx[start + 1:end + 1]
        # 3.5 返回输入值和输出值 -> 张量形式.
        return torch.tensor(x), torch.tensor(y)


# 3. 搭建RNN神经网络.
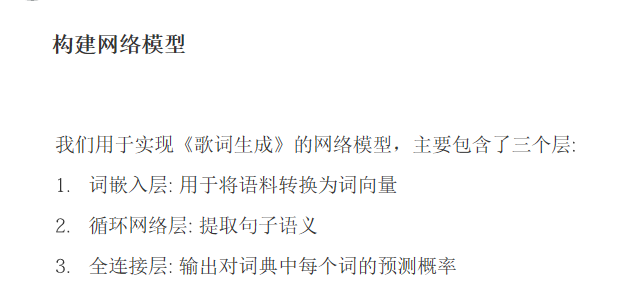
class TextGenerator(nn.Module):
    # 1. 初始化方法
    def __init__(self, unique_word_count):      # unique_word_count: 去重的词的数量(5703)
        # 1.1 初始化父类的成员.
        super().__init__()
        # 1.2 初始化词嵌入层: 语料中词的数量, 词向量的维度.
        self.ebd = nn.Embedding(unique_word_count, 128)
        # 1.3 循环网络层: 词向量维度, 隐藏层维度: 256, 网络层数: 1
        self.rnn = nn.RNN(128, 256, 1)
        # 1.4 输出层(全连接层):  特征向量维度(和隐藏向量维度一致), 词表中词的个数.
        self.out = nn.Linear(256, unique_word_count)    # 词表中每个词的概率 -> 选概率最大的哪个词作为 预测结果.

    # 2. 前向传播方法
    def forward(self, inputs, hidden):
        # 2.1 初始化 词嵌入层处理.
        # embd格式: (batch句子的数量, 句子的长度, 词向量维度)
        embd = self.ebd(inputs)
        # print(f'embd.shape: {embd.shape}')

        # 2.2 rnn处理
        # rnn格式: (句子的长度, batch句子的数量, 隐藏层维度)
        output, hidden = self.rnn(embd.transpose(0, 1), hidden)

        # 2.3 全连接, 输入内容必须是二维数据, 即: 词的数量 * 词的维度
        # 输入维度: (seq_len句子数量 * batch, 词向量维度256)
        # 输出维度: (seq_len句子数量 * batch, 词表中词的个数)
        output = self.out(output.reshape(shape=(-1, output.shape[-1])))
        # 2.4 返回结果, 预测结果, 隐藏层.
        return output, hidden

    # 3. 隐藏层的初始化方法.
    def init_hidden(self, bs):      # batch_size
        # 隐藏层初始化: [网络层数, batch, 隐藏层向量维度]
        return torch.zeros(1, bs, 256)


# 4. 训练模型.
def train():
    # 1. 构建词典.
    unique_words, word_to_index, unique_word_count, corpus_idx = build_vocab()
    # 2. 获取数据集.
    lyrics = LyricsDataset(corpus_idx, 32)
    # 3. 初始化(神经网络)模型
    model = TextGenerator(unique_word_count)        # 预测5703个词, 每个词的概率.
    # 4. 创建数据加载器对象.
    # 参1: 数据集对象.  参2: 批次大小(每批5个句子, 每个句子32个词)  参3: 是否打乱数据.
    lyrics_dataloader = DataLoader(lyrics, batch_size=5, shuffle=True)
    # 5. 定义损失函数
    criterion = nn.CrossEntropyLoss()
    # 6. 定义优化器.
    optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
    # 7. 模型训练.
    # 7.1 定义变量, 记录训练的轮数.
    epochs = 20
    # 7.2 具体的每轮训练动作.
    for epoch in range(epochs):     # epoch: 0, 1, 2, 3...9, 分别表示: 第1轮, 第2轮, ... 第10轮.
        # 7.3 定义变量记录: 本轮开始训练时间, 迭代(批次)次数, 训练总损失.
        start, iter_num, total_loss = time.time(), 0, 0.0
        # 7.4 具体的 本轮 各批次 训练动作.
        # 遍历数据集, 后台会调用 LyricsDataset#__getitem__()方法, 获取到每个样本的数据和标签,
        for x, y in lyrics_dataloader:
            # 7.5 获取隐藏层初始值.
            hidden = model.init_hidden(x.shape[0])
            # 7.6 模型计算.
            output, hidden = model(x, hidden)
            # 7.7 计算损失.
            # y的形状: (batch 批次数, seq_len 句子长度, 词向量维度) -> 转成一维向量 -> 每个词的下标索引.
            # output形状为: (seq_len, batch, 词向量维度)
            y = torch.transpose(y, 0, 1).reshape(shape=(-1, ))
            loss = criterion(output, y)
            # 7.8 梯度清零 + 反向传播 + 更新参数.
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            # 7.9 累计损失 和 迭代次数.
            total_loss += loss.item()
            iter_num += 1

        # 7.10 走到这里, 说明 本轮训练结束, 打印本轮的训练信息.
        print(f'epoch: {epoch + 1}, time: {time.time() - start:.2f}s, loss: {total_loss / iter_num:.4f}')

    # 8. 走到这里, 说明多轮训练结束(模型训练结束), 保存即可.
    torch.save(model.state_dict(), './model/text_generator.pth')


# 5. 模型预测.
def evaluate(start_word, sentence_length):
    # 1. 构建词典.
    unique_words, word_to_index, unique_word_count, corpus_idx = build_vocab()
    # 2. 获取模型.
    model = TextGenerator(unique_word_count)
    # 3. 加载模型参数.
    model.load_state_dict(torch.load('./model/text_generator.pth'))
    # 4. 获取隐藏层初始值.
    hidden = model.init_hidden(1)
    # 5. 将输入的 开始词 转换成 索引.
    word_idx = word_to_index[start_word]
    # 6. 定义列表, 存放: 产生的词的索引.
    generate_sentence = [word_idx]  # 开始词的索引, 是列表的: 第1个值.
    # 7. 遍历句子长度, 获取到每一个词.
    for i in range(sentence_length):
        # 7.1 模型预测.
        output, hidden = model(torch.tensor([[word_idx]]), hidden)
        # 7.2 获取预测结果.   argmax() 从所有结果(5703个词的概率)中, 找最大值对应的索引.
        word_idx = torch.argmax(output)
        # 7.3 把预测结果添加到列表中.
        generate_sentence.append(word_idx)

    # 8. 将索引转成词, 并打印.
    for idx in generate_sentence:
        print(unique_words[idx], end='')


# 6. 测试
if __name__ == '__main__':
    # 1. 获取数据, 进行分词, 获取词表.
    # unique_words, word_to_index, word_count, corpus_idx = build_vocab()
    # print(f'词的数量: {word_count}')         # 去重后, 5703个词
    # print(f'去重后的词: {unique_words}')     # ['想要', '有', '直升机', '\n', '和', '你'...'冠军', '要大卖']
    # print(f'每个词的索引: {word_to_index}')  # 词表: {'想要': 0, '有': 1, '直升机': 2, '\n': 3, '和': 4, '你': 5, ... '冠军': 5701, '要大卖': 5702}
    # print(f'文档中每个词对应的索引: {corpus_idx}')  # [0, 1, 2, 1 3, 40, 0, 4, 5, 6, 7, 8, 3, 40, 0, 4, 5, 9, 10, 11, 3, 40,......]

    # 2. 构建数据集
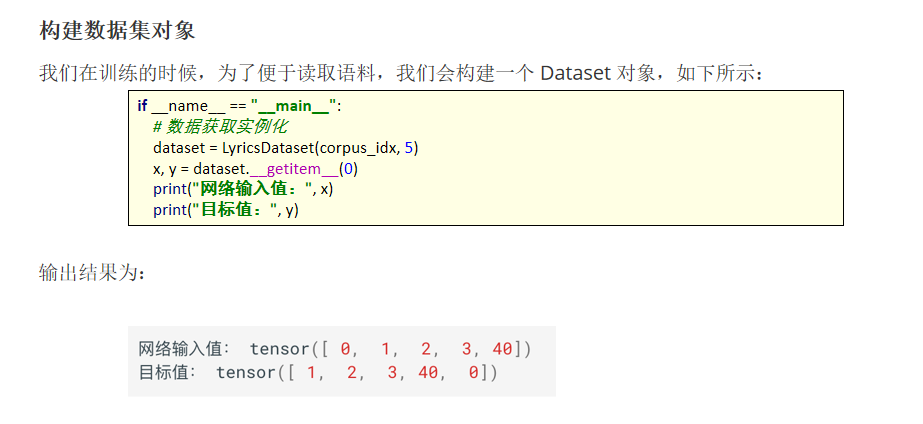
    # dataset = LyricsDataset(corpus_idx, 5)
    # print(f'句子数量: {len(dataset)}')
    # # 查看下 输入值 和 目标值.
    # x, y = dataset[1]
    # print(f'输入值: {x}')  # [0, 1, 2, 3, 40]    [1, 2, 3, 40, 0]
    # print(f'目标值: {y}')  # [1, 2, 3, 40, 0]    [2, 3, 40, 0, 4]

    # 3. 创建模型对象.
    # model = TextGenerator(word_count)
    # # 查看参数.
    # for name, parameter in model.named_parameters():
    #     print(f'参数名称: {name}, 参数维度: {parameter.shape}')

    # 4. 训练(并保存)模型.
    train()

    # 5. 测试模型.
    evaluate('星星', 50)