作者:来自 Elastic Jeffrey Rengifo
所有容器组都处于运行状态,但店面服务中响应时间低于500毫秒的请求占比仍从99.6%降至59%。通过 ES|QL 分析 kubelet 指标,发现一个批处理任务占用了节点 2 个核心中的 1.7 个核心。将其处理器用量上限设为500毫核后,店面服务的这一比例恢复到 99% 以上。
一个 Kubernetes 吵闹邻居导致店面服务中响应时间低于500毫秒的请求占比从99.6%降至59%。节点上的所有容器组始终保持运行,没有重启,也没有告警。一个批处理工作负载占用了工作节点两个核心中的1.7个核心,使店面服务只能获得所需处理器资源的60%。使用 Elasticsearch 查询语言(ES|QL)查询由 Elastic 版开放遥测采集器(EDOT)采集的 kubelet 指标,可以找出该工作负载并追溯到其部署。将该部署的处理器用量上限设为500毫核后,99.8%的请求恢复到500毫秒以内。资源配额将命名空间的资源用量限制在这一预算内,此后通过延迟服务等级目标(SLO)持续跟踪店面服务的表现。
前提条件
- Elasticsearch 和 Kibana 9.4及以上版本,以及 TS 命令。
- 一个通过 Kubernetes 快速入门指南安装了 EDOT 采集器的 Kubernetes 集群,以及 kubectl 和 Helm。
- 受影响服务的延迟指标。本示例使用 k6 探针,通过开放遥测(OTel)导出 k6_http_req_duration 指标。
- 一个具有服务等级目标写入权限的 Kibana 应用程序编程接口密钥,用于最后一节。
你可以在这里找到配套笔记本。它可以复现本文中的整个实验,包括租户标签和服务等级目标,并在结束时清理实验资源。
场景:多租户集群中的批量导出任务和店面服务
两个租户共享一个双节点 kind 集群的工作节点。该工作节点被限制为只能使用两个处理器核心。
- team-storefront 运行一个 NGINX 部署,使用 gzip 压缩8兆二进制字节的响应。它请求10毫核的处理器资源,未设置处理器用量上限。
- team-batch 运行 batch-export,这是一个压力测试容器,包含四个处理器工作线程,并分配了384兆二进制字节的内存。它请求一个处理器核心,用量上限为两个核心。
- 工作节点之外的 k6 探针每次发送一个请求,间隔200毫秒。合格请求需在500毫秒内返回 HTTP 200状态码。单独运行时,店面服务有99.6%的探针请求能在这一阈值内得到响应。
工作节点的内存压力状态在整个运行过程中始终为假,因此这是一个处理器资源争用案例。 Docker 的限制采用 kubelet 无法感知的完全公平调度器配额,因此 Kubernetes 仍将 Docker 虚拟机的六个处理器核心报告为节点容量。查询因此比较实际消耗的处理器核心数,而非占节点容量的百分比。
第1步:为 Kubernetes 指标添加租户标签
将归属标签添加到每个部署的容器组模板中,以便采集器从容器组中读取这些标签:
markdown
`

1.  spec:
2.    template:
3.      metadata:
4.        labels:
5.          tenant: batch
6.          app.kubernetes.io/name: batch-export

`AI代码解释使用稳定、低基数的值,例如团队或应用程序名称。然后将以下覆盖配置添加到快速入门指南的 Helm 配置值中:
yaml
`
1. collectors:
2. daemon:
3. config:
4. processors:
5. k8s_attributes:
6. extract:
7. labels:
8. - tag_name: tenant
9. key: tenant
10. from: pod
11. - tag_name: app
12. key: app.kubernetes.io/name
13. from: pod
`AI代码解释Kubernetes 属性处理器将这两个容器组标签复制到每个指标文档中,分别保存为 resource.attributes.tenant 和 resource.attributes.app。将该配置块与你现有安装中的标签提取规则合并。
第2步:通过 ES|QL 查询确认延迟问题
从响应缓慢的服务入手。此查询绘制探针每分钟的第95百分位延迟:
ini
`

1.  FROM metrics-generic.otel-*
2.  | WHERE @timestamp >= NOW() - 30 minutes
3.      AND service.name == "noisy-neighbor-probe"
4.      AND attributes.tenant == "storefront"
5.  | STATS p95_ms = PERCENTILE(k6_http_req_duration, 95)
6.      BY minute = BUCKET(@timestamp, 1 minute), tenant = attributes.tenant
7.  | EVAL p95_ms = ROUND(p95_ms, 1)
8.  | SORT minute
9.  | LIMIT 100

`AI代码解释托管开放遥测协议(mOTLP)端点将 k6 的耗时直方图存储为指数直方图字段,PERCENTILE 可以直接读取该字段。如果你的流水线通过 Elasticsearch 导出器写入旧版直方图类型,请先将字段转换为 tdigest,再调用 PERCENTILE。k6 使用固定桶边界导出耗时,每个桶都存储为一个代表值,因此百分位数会重复出现少数几个数值。175毫秒代表100--250毫秒的桶,625毫秒代表500--750毫秒的桶,因此应将这些百分位数理解为范围。
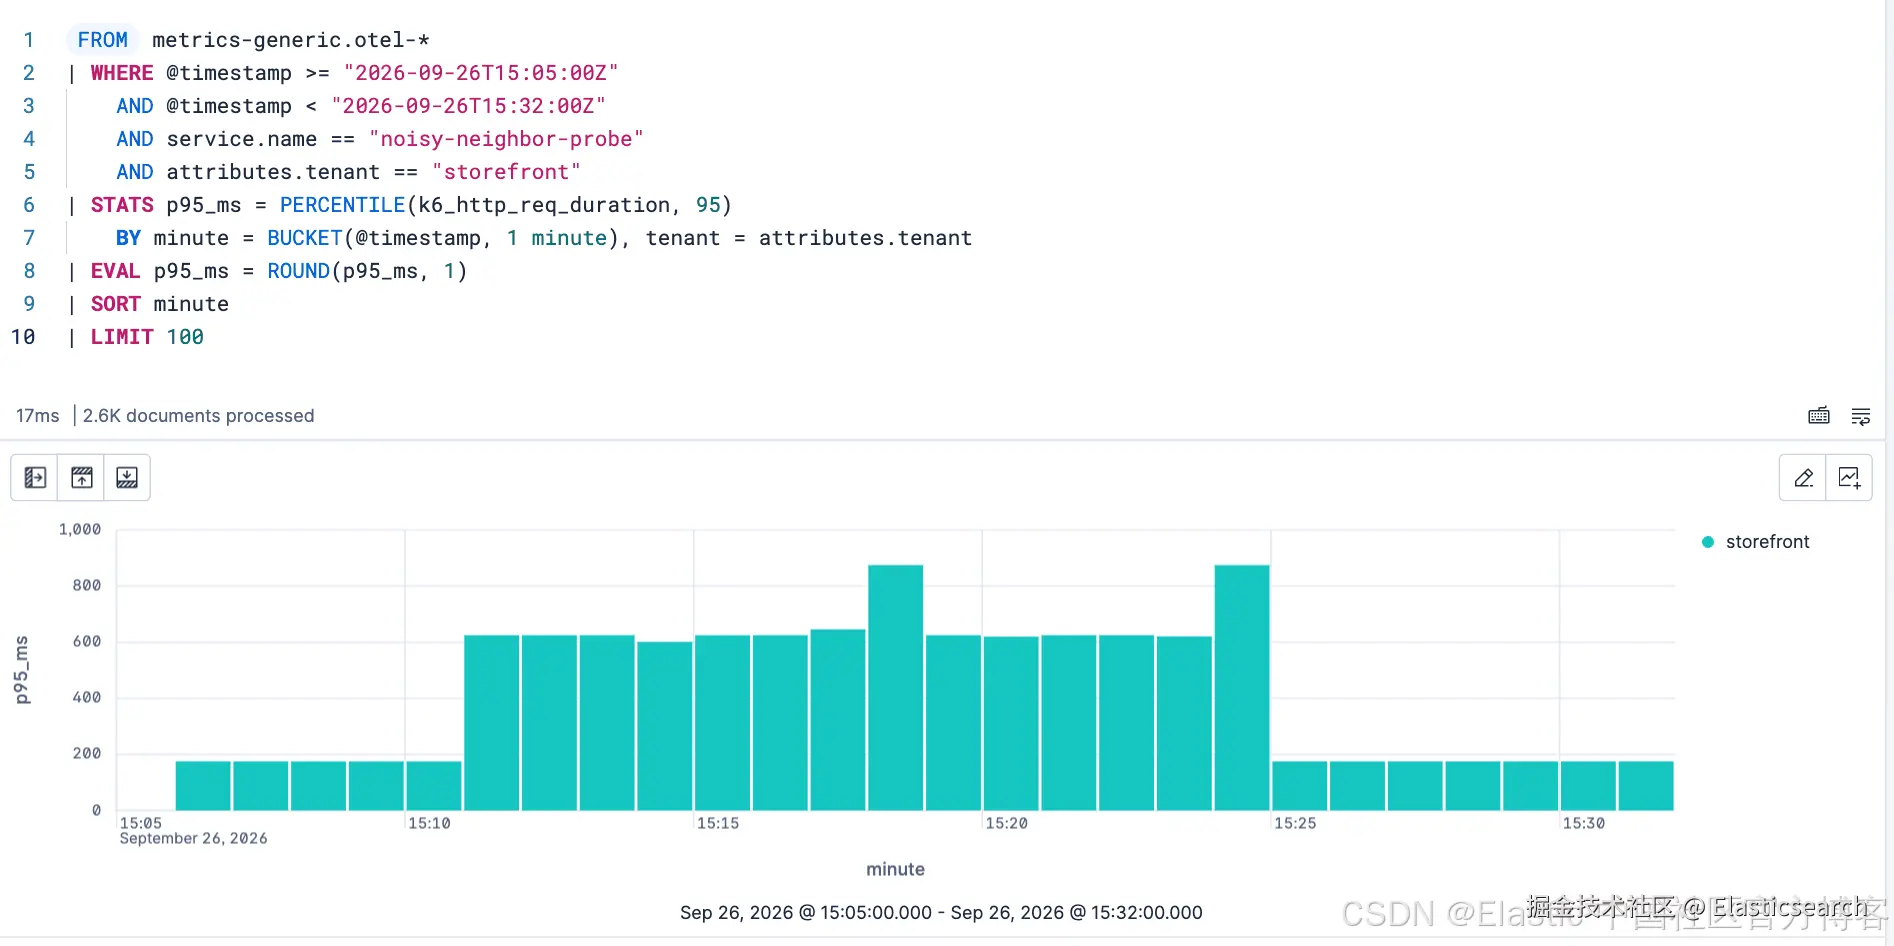
在此场景中,批量导出任务启动前,p95_ms 为175;在任务运行的13分钟内,该值介于601和875之间。同一时段内,店面服务容器组报告的 k8s.container.restarts 为0,k8s.pod.phase 为2,表示运行中。这两个指标均来自 k8s_cluster 接收器,存储在 metrics-k8sclusterreceiver.otel-* 中。
第3步:对受影响的 Kubernetes 节点上各租户的处理器用量进行排名
店面服务容器组运行在 noisy-neighbor-worker 上。你可以从其任意指标文档的 k8s.node.name 字段中读取该信息。此查询对该节点上的所有工作负载进行排名,不预先假定哪个租户是问题来源:
ini
`
1. TS metrics-kubeletstatsreceiver.otel-*
2. | WHERE @timestamp >= NOW() - 2 minutes
3. AND k8s.cluster.name == "noisy-neighbor"
4. AND k8s.node.name == "noisy-neighbor-worker"
5. | STATS cpu_cores = SUM(AVG_OVER_TIME(k8s.pod.cpu.usage)),
6. memory_bytes = SUM(AVG_OVER_TIME(k8s.pod.memory.working_set)),
7. cpu_limit_used = MAX(AVG_OVER_TIME(k8s.pod.cpu_limit_utilization))
8. BY k8s.node.name, k8s.namespace.name, resource.attributes.tenant
9. | EVAL cpu_cores = ROUND(cpu_cores, 3),
10. memory_mib = ROUND(memory_bytes / 1048576.0, 1),
11. cpu_limit_used_pct = ROUND(cpu_limit_used * 100, 0)
12. | DROP memory_bytes, cpu_limit_used
13. | SORT cpu_cores DESC
14. | RENAME k8s.node.name AS node, k8s.namespace.name AS namespace,
15. resource.attributes.tenant AS tenant
16. | LIMIT 5
`AI代码解释AVG_OVER_TIME 计算时间窗口内每个容器组时间序列的平均值,外层 SUM 再按命名空间和租户汇总这些平均值。直接对原始样本求和会在每个采样点重复计算同一个容器组。进行事件复盘时,请将 NOW() 替换为固定的开始和结束时间戳。
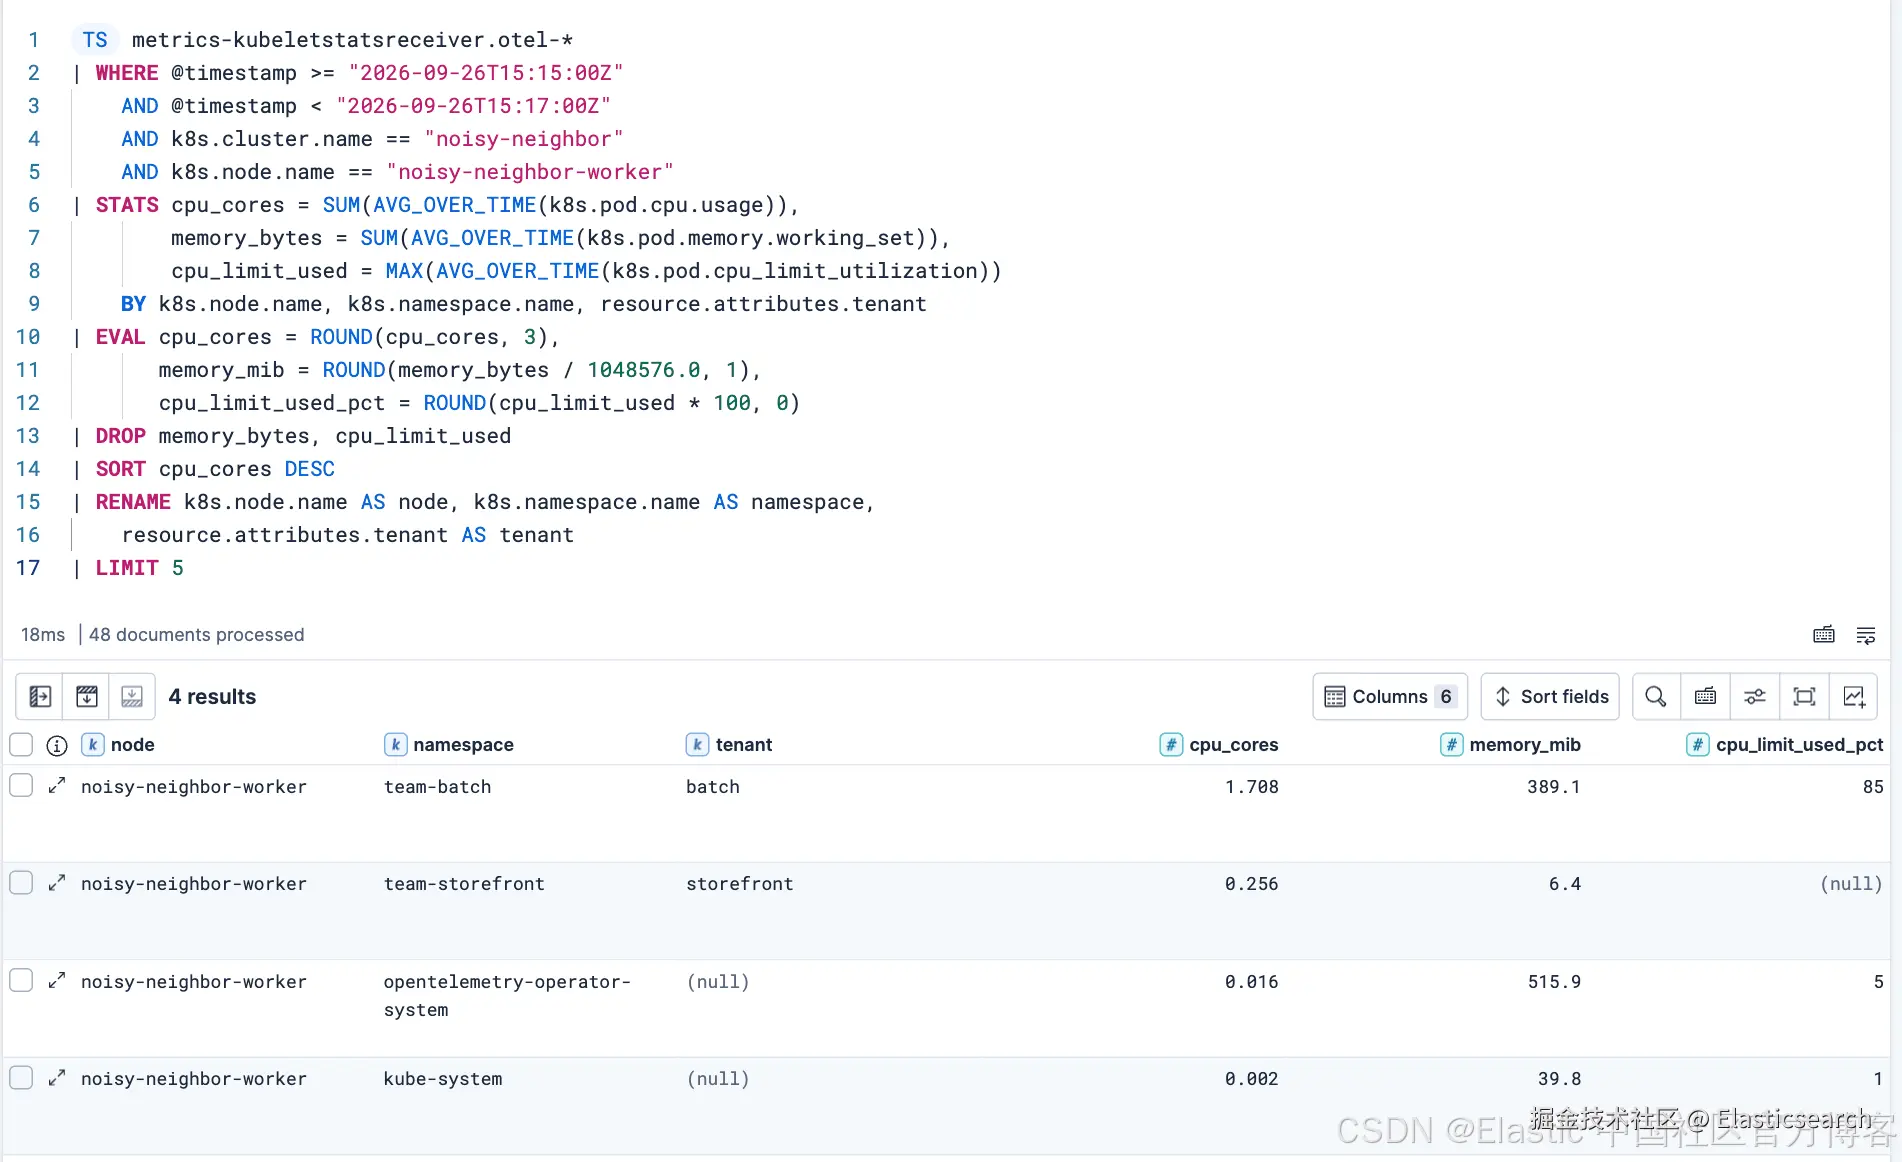
三个数值说明了资源争用情况:
- team-batch 消耗1.708个核心,达到其处理器用量上限的85%。它之所以未达到两个核心的上限,只是因为工作节点已无更多处理器资源可供分配。
- team-storefront 消耗0.256个核心。在基准时段运行同一查询,得到的结果为0.418,因此店面服务只获得了所需处理器资源的约60%。等待处理器资源的容器组只会报告实际获得的处理器用量。
- 在同一时间窗口内,工作节点的 k8s.node.cpu.usage 平均为2.0个核心,即该工作节点的全部处理器资源。在同一 TS 查询中使用
STATS MAX(AVG_OVER_TIME(k8s.node.cpu.usage)) BY k8s.node.name即可得到该值。
租户字段为空的行代表未添加标签的工作负载。在将其资源消耗归因于某个团队之前,请先找到其所有者。
第4步:追溯租户对应的 Kubernetes 部署
将查询范围缩小到排名第一的命名空间,并按应用程序标签和所属部署分组:
ini
`
1. TS metrics-kubeletstatsreceiver.otel-*
2. | WHERE @timestamp >= NOW() - 2 minutes
3. AND k8s.cluster.name == "noisy-neighbor"
4. AND k8s.namespace.name == "team-batch"
5. | STATS cpu_cores = SUM(AVG_OVER_TIME(k8s.pod.cpu.usage)),
6. memory_bytes = SUM(AVG_OVER_TIME(k8s.pod.memory.working_set))
7. BY resource.attributes.app, k8s.deployment.name, k8s.node.name
8. | EVAL cpu_cores = ROUND(cpu_cores, 3),
9. memory_mib = ROUND(memory_bytes / 1048576.0, 1)
10. | DROP memory_bytes
11. | SORT cpu_cores DESC
12. | RENAME resource.attributes.app AS app,
13. k8s.deployment.name AS deployment, k8s.node.name AS node
14. | LIMIT 10
`AI代码解释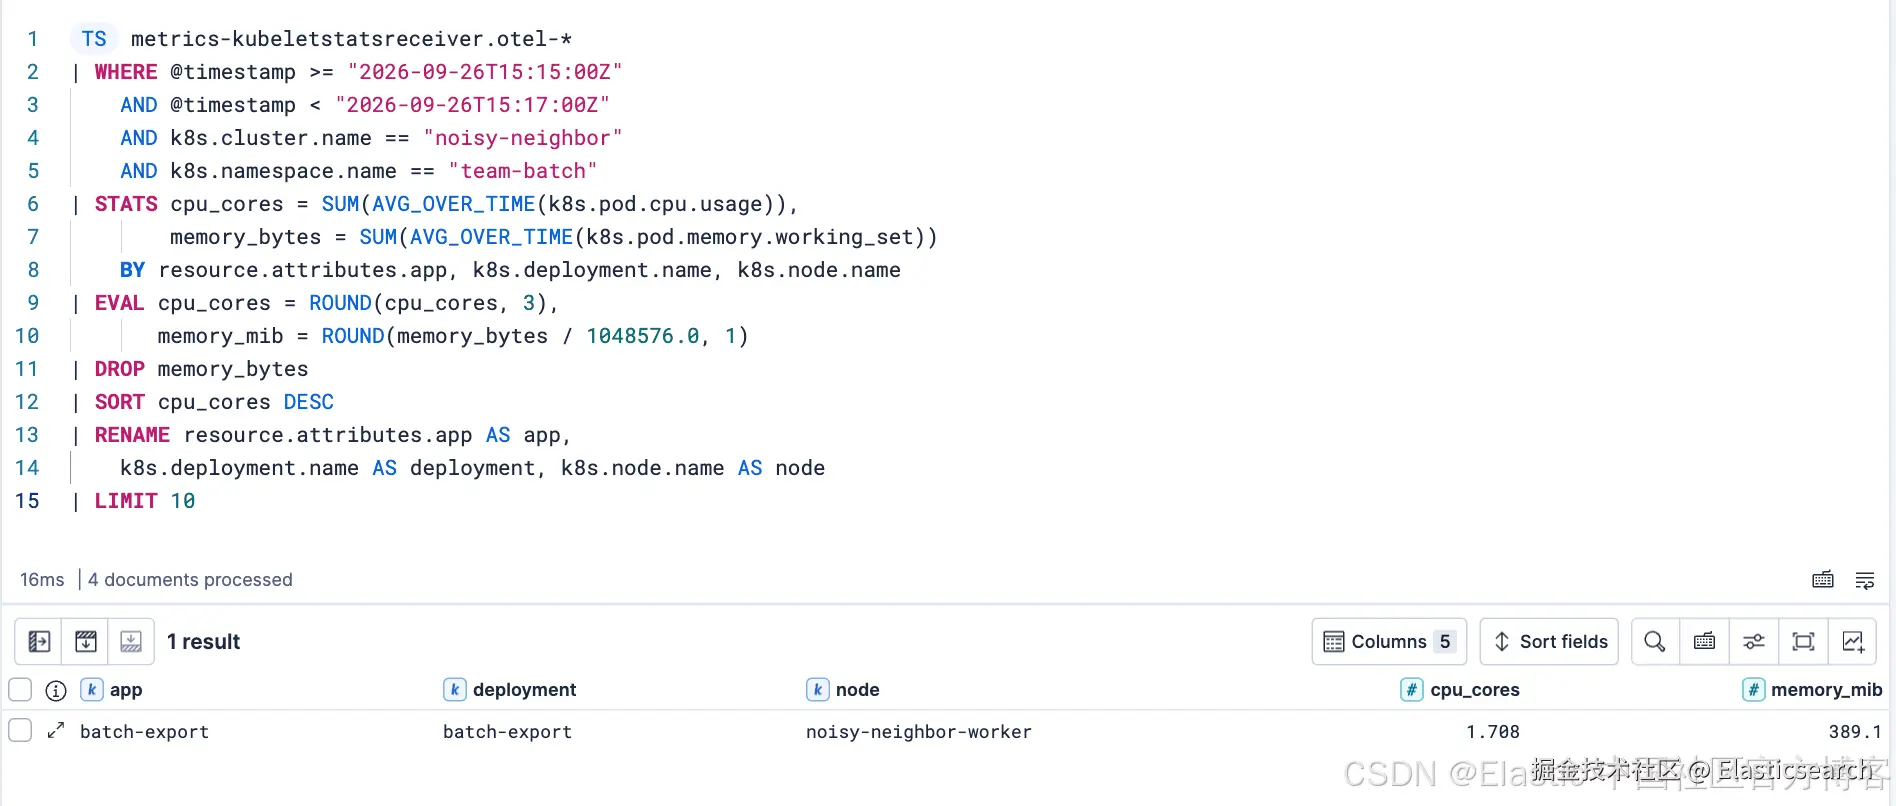
标签和部署元数据均指向 batch-export。对于由任务或有状态副本集管理的工作负载,请按 k8s.job.name 或 k8s.statefulset.name 分组。
接下来,将每个容器的处理器用量与其请求量进行比较:
ini
`
1. TS metrics-kubeletstatsreceiver.otel-*
2. | WHERE @timestamp >= NOW() - 2 minutes
3. AND k8s.cluster.name == "noisy-neighbor"
4. AND k8s.node.name == "noisy-neighbor-worker"
5. AND k8s.namespace.name IN ("team-storefront", "team-batch")
6. | STATS cpu_request_used = MAX(AVG_OVER_TIME(k8s.container.cpu_request_utilization))
7. BY k8s.namespace.name, k8s.deployment.name, k8s.container.name
8. | EVAL cpu_request_used_pct = ROUND(cpu_request_used * 100, 0)
9. | DROP cpu_request_used
10. | SORT cpu_request_used_pct DESC
11. | LIMIT 10
`AI代码解释店面服务的 nginx 容器用量达到其请求量的2,546%, stress 容器则达到170%。两者的用量都超过了各自的请求量。
在资源饱和的节点上,请求量决定每个容器的处理器权重,批处理任务的1000毫核比店面服务的10毫核具有更高权重。第3步中的资源分配比例并非100比1,因为店面服务只在压缩响应时需要处理器资源。但权重仍然决定谁需要等待,而等待的正是店面服务。
EDOT 的 kube-stack 配置值启用了 k8s.container.cpu_request_utilization 和 k8s.pod.cpu_limit_utilization。在普通的 kubeletstats 接收器中,两者默认均未启用,因此如果你使用自己的采集器,请在接收器的指标配置块中启用它们。
第5步:通过处理器用量上限和资源配额限制 Kubernetes 吵闹邻居
降低批处理任务的用量上限,并提高店面服务的请求量:
ini
`

1.  kubectl set resources deployment/batch-export -n team-batch \
2.    --requests=cpu=500m,memory=512Mi \
3.    --limits=cpu=500m,memory=768Mi

5.  kubectl set resources deployment/storefront -n team-storefront \
6.    --requests=cpu=500m,memory=32Mi \
7.    --limits=memory=128Mi

`AI代码解释
批处理任务现在最多只能使用半个处理器核心。店面服务的处理器请求量与批处理任务相同,且仍未设置处理器用量上限,因此可以使用空闲的处理器资源。在你的清单文件或 GitOps 仓库中应用相同的更改,以便下一次发布时保留这些配置。Kubernetes 的请求量和用量上限控制调度、处理器权重和用量上限。延迟仍取决于工作负载的需求,因此生产环境中的配置值应以测量结果为依据。
两个部署的滚动更新完成后,添加命名空间资源预算,使新增批处理副本需要经过审核:
markdown
`
1. apiVersion: v1
2. kind: ResourceQuota
3. metadata:
4. name: batch-budget
5. namespace: team-batch
6. spec:
7. hard:
8. requests.cpu: "1"
9. limits.cpu: "1"
10. requests.memory: 1Gi
11. limits.memory: 1536Mi
12. pods: "2"
`AI代码解释按新配置,这一预算可容纳两个副本,也能覆盖滚动更新期间临时出现的第二个容器组。如果提前创建配额,旧的批处理容器组仍会以两个处理器核心的用量上限占用配额,导致配额拒绝滚动更新所需的新容器组。请求两个处理器核心的容器组会在准入阶段被拒绝,并提示超出配额:batch-budget。资源配额适用于整个命名空间中的新容器组。它不会影响正在运行的容器组,也不会在特定节点上预留资源。
第6步:使用相同的 ES|QL 查询验证修复效果
等待滚动更新完成,然后再次运行第3步中的租户排名查询:
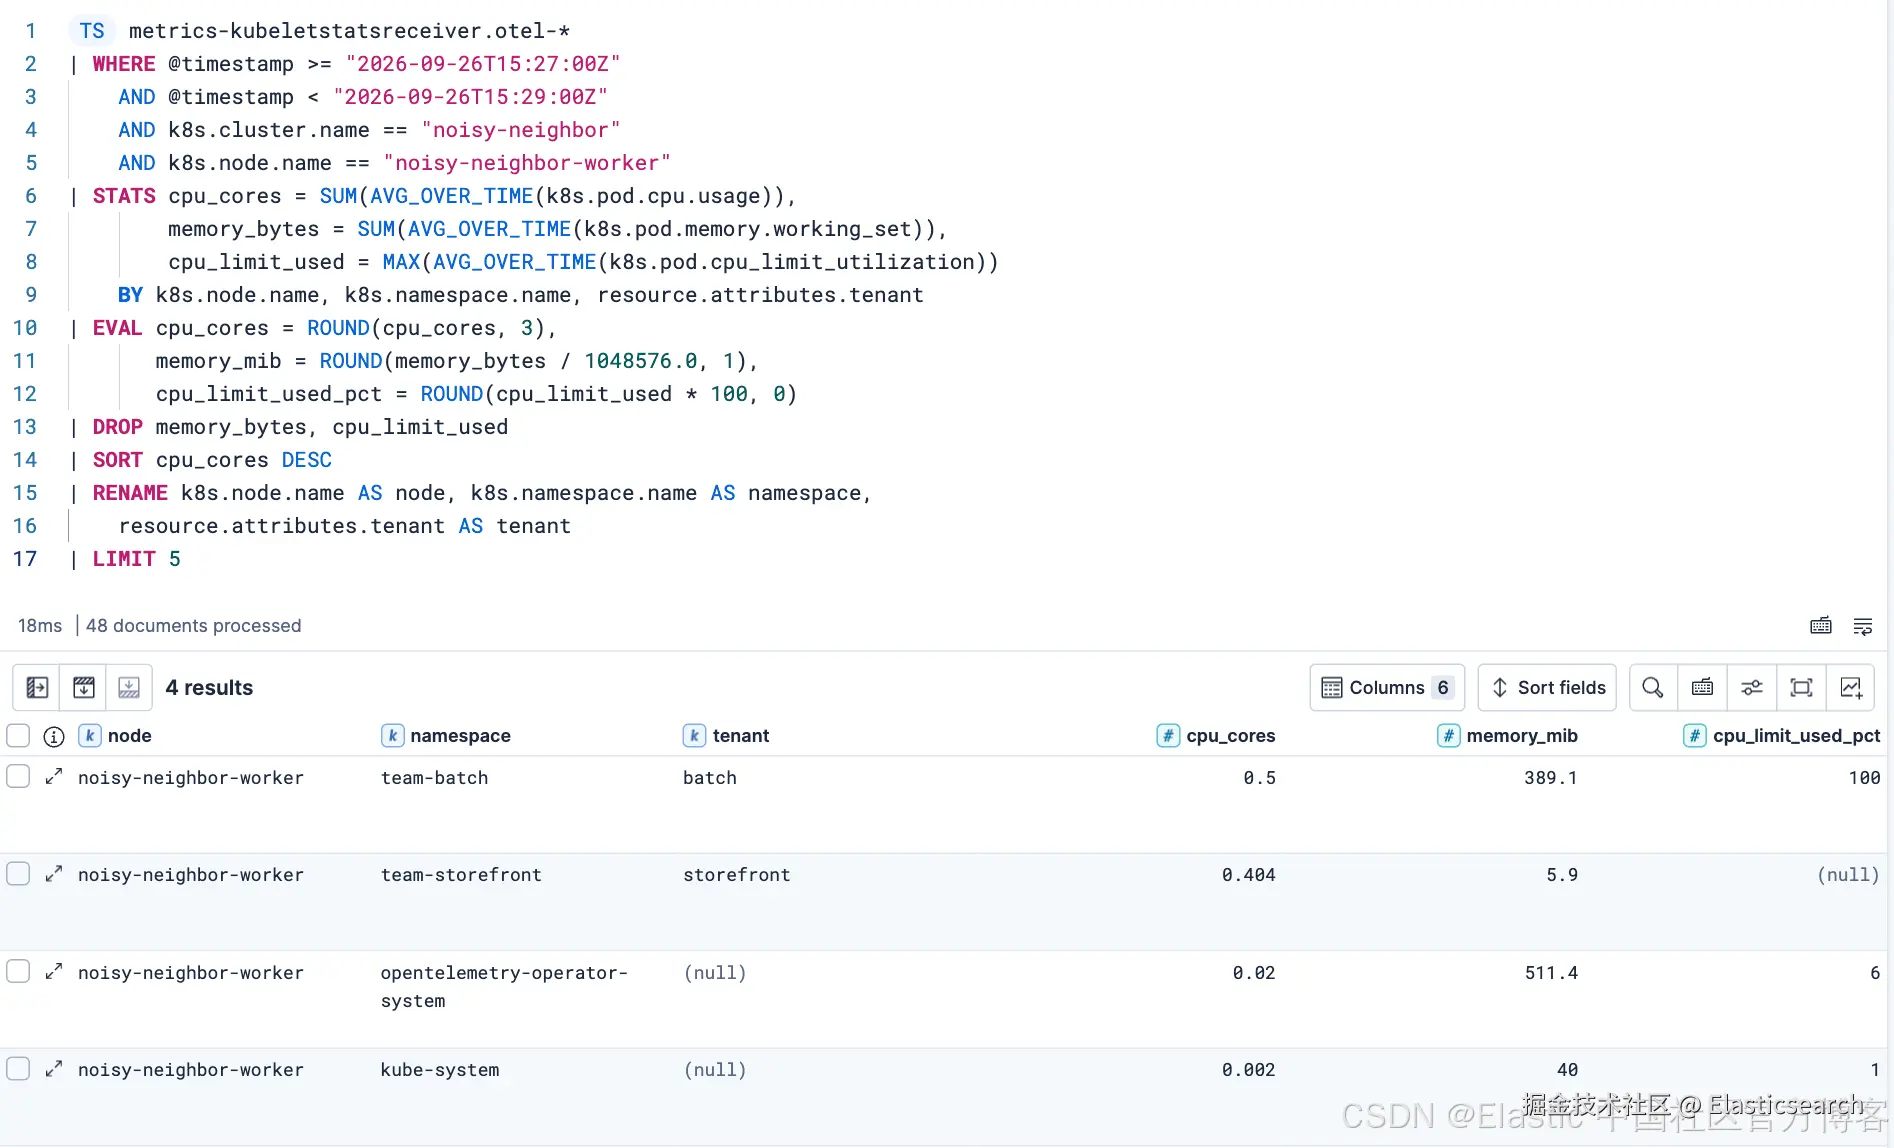
同一查询现在显示,该节点已有空闲的处理器资源:
| 租户 | 基准状态 | 资源争用期间 | 修复后 |
|---|---|---|---|
| team-batch | 未运行 | 1.708个核心,达到两个核心用量上限的85% | 0.5个核心,达到新的500毫核用量上限的100% |
| team-storefront | 0.418个核心 | 0.256个核心 | 0.404个核心,达到新请求量的81% |
| 工作节点总用量 | --- | 2.0个核心,资源饱和 | 约1.0个核心 |
容器组达到处理器用量上限时会受到限流。kubeletstats 接收器不提供完全公平调度器的限流计数器,因此 k8s.pod.cpu_limit_utilization 是此数据流中最接近的信号。
探针在三个阶段持续运行。中位数和第95百分位数来自第2步的查询,应按桶范围解读;请求数和响应时间低于500毫秒的请求占比则来自下一节的服务等级目标(SLO)。表格和 Kibana 截图中的时间均为协调世界时:
| 阶段 | 时间区间 | 请求数 | 中位数 | 第95百分位数 |
|---|---|---|---|---|
| 基准状态 | 15:06--15:10 | 828 | 100--250毫秒 | 100--250毫秒 |
| 资源争用期间 | 15:11--15:23 | 1,144 | 250--500毫秒 | 500--750毫秒 |
| 修复后 | 15:25--15:31 | 1,224 | 100--250毫秒 | 100--250毫秒 |
表格省略了实施修复的15:24这一分钟。kubectl set resources 会替换两个容器组,探针在店面服务容器组重启期间记录到了本次运行中仅有的失败请求。修复后,工作节点不再处于资源饱和状态,因此仅批处理任务的用量上限就足以解释这次恢复。店面服务提高后的请求量会在节点下次资源饱和时发挥作用。批处理任务现在受到限流,以牺牲导出速度换取更低的店面服务延迟。如果导出任务有截止时间,请为其分配独立节点或增加容量。
如何确认 Kubernetes 吵闹邻居问题持续得到解决?
请求量、用量上限和配额强制执行资源分配。服务等级目标衡量这种分配是否足以满足服务需求。此目标将500毫秒内返回 HTTP 200状态码的探针请求计为合格请求,要求在滚动30天内合格请求占比达到99%。这一阈值来自基准测量。单独运行时,店面服务有99.6%的探针请求能在500毫秒内得到响应;资源争用期间,这一比例仅为59%。500毫秒也是 k6 的桶边界之一,因此服务等级目标按完整的桶计数,不会拆分任何桶。
运行 k6 探针时,在其环境中设置 OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=DELTA。k6 的文档未说明此变量,但其开放遥测输出基于开放遥测的 Go 软件开发工具包,该工具包的 OTLP 导出器会读取此变量。采用增量时态后,每个导出的直方图仅包含新增请求,因此服务等级目标只会对每个请求计数一次。在 k6 2.x 版本中,还需设置 K6_OTEL_METRIC_PREFIX=k6_,因为该版本会以不带前缀的 http_req_duration 名称导出指标。通过 Kibana 服务等级目标应用程序编程接口创建此服务等级目标,该接口可以直接接受 exponential_histogram 字段。9.5.4版本的服务等级目标表单尚未列出该字段。将请求正文保存为 storefront-slo.json:
swift
`
1. {
2. "id": "noisy-neighbor-storefront",
3. "name": "Storefront fairness: 99% successful probes under 500 ms",
4. "description": "Track storefront HTTP probes while batch work shares its node.",
5. "indicator": {
6. "type": "sli.histogram.custom",
7. "params": {
8. "index": "metrics-generic.otel-*",
9. "timestampField": "@timestamp",
10. "filter": "service.name: \"noisy-neighbor-probe\" and attributes.test-id: \"noisy-neighbor-final\"",
11. "good": {
12. "field": "k6_http_req_duration",
13. "aggregation": "range",
14. "from": 0,
15. "to": 500,
16. "filter": "attributes.status: \"200\""
17. },
18. "total": {
19. "field": "k6_http_req_duration",
20. "aggregation": "value_count"
21. }
22. }
23. },
24. "budgetingMethod": "occurrences",
25. "timeWindow": {"duration": "30d", "type": "rolling"},
26. "objective": {"target": 0.99},
27. "groupBy": ["attributes.tenant"],
28. "settings": {"syncDelay": "1m", "frequency": "1m"}
29. }
`AI代码解释请求正文中的三个部分定义了计算方式:
- good 统计状态码为200的响应中耗时介于0到500毫秒的请求。
- total 统计所有请求耗时,因此失败请求仍计入分母。
- occurrences 按请求分配预算。请求较少的缓慢分钟比请求较多的缓慢分钟消耗更少的预算。
attributes.test-id 筛选条件用于单独筛选一次探针运行。对于长期使用的服务等级目标,请按稳定的服务和环境进行筛选。将文件提交到你的 Kibana 端点:
kotlin
`

1.  curl --request POST "$KIBANA_URL/api/observability/slos" \
2.    --header "Authorization: ApiKey $KIBANA_API_KEY" \
3.    --header 'Content-Type: application/json' \
4.    --header 'kbn-xsrf: true' \
5.    --data-binary @storefront-slo.json

`AI代码解释打开服务等级目标 ,选择店面服务实例,然后查看定义。新数据会在一分钟的同步延迟及下一次转换任务运行后显示:
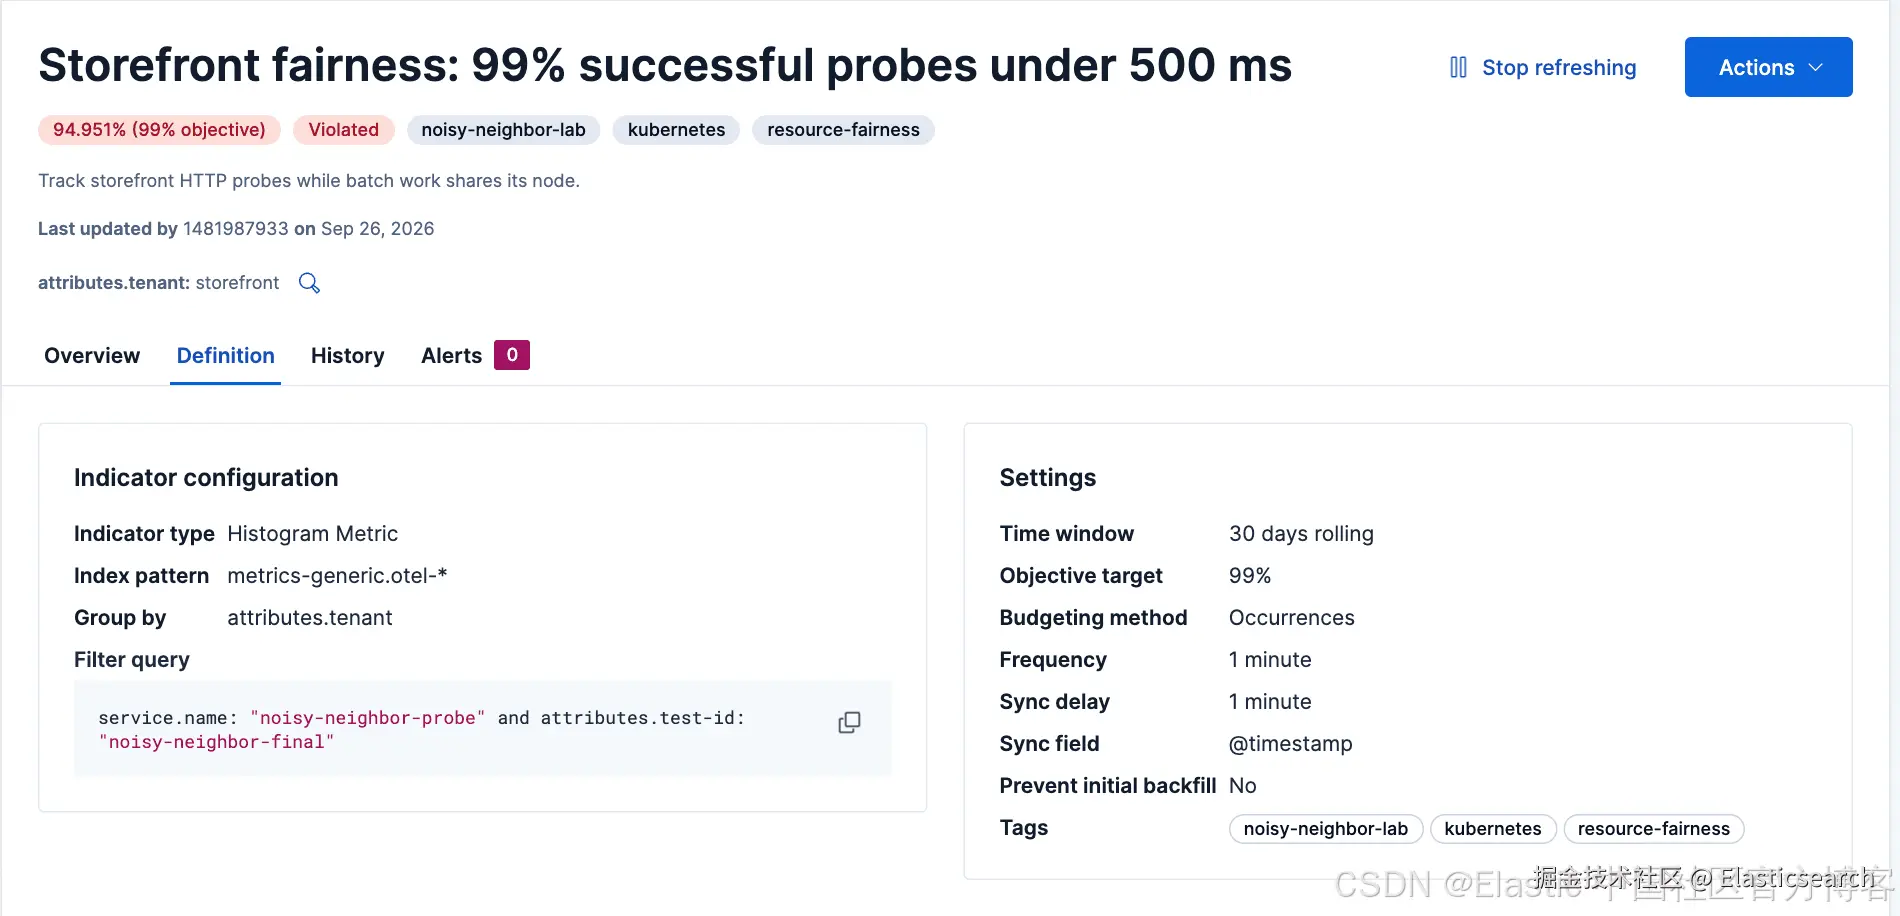
修复约55分钟后,消耗速率面板的六小时视图将此次事件显示为一个峰值,并报告数值可接受。六小时消耗速率为5.36倍,低于6倍的阈值,30分钟消耗速率则为0.45倍。历史服务等级指标为94.95%,低于99%的目标。此时,服务等级目标仅包含一个多小时的数据,因此此次事件仍对其产生影响;随着合格请求不断累积,该数值会逐渐上升。
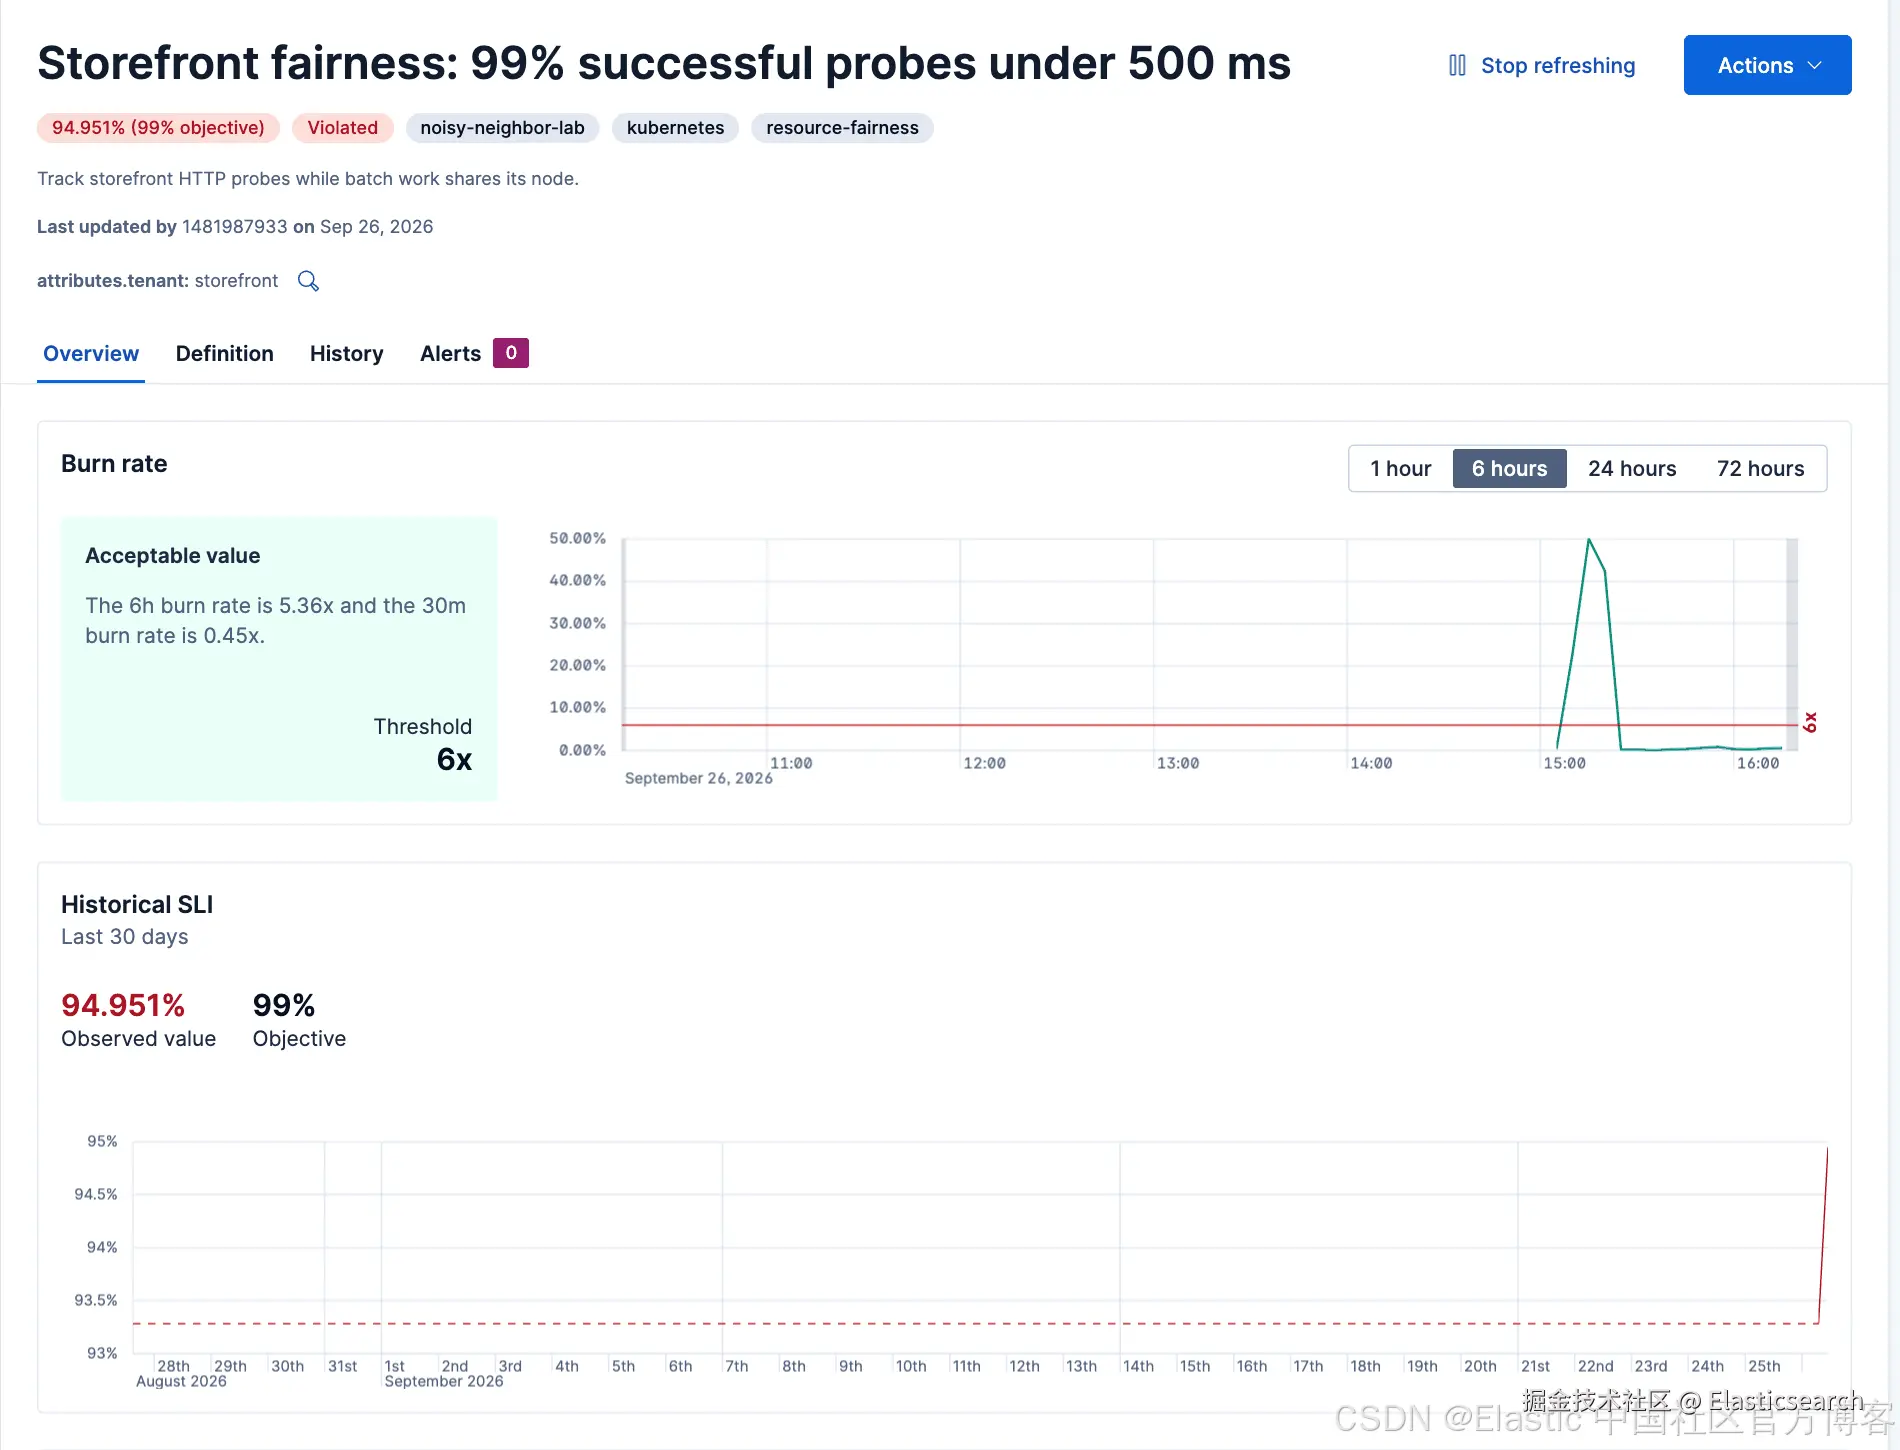
修复后,请保留这段历史记录。它记录了此次事件造成的服务质量损失。添加服务等级目标消耗速率规则,以便在预算再次消耗时收到通知。没有新数据传入的服务等级目标不会触发告警,因此还应针对探针停止上报的情况设置告警。
限制吵闹邻居带来了哪些变化
本教程从店面服务的延迟问题入手:所有容器组均处于运行状态,但第95百分位延迟从100--250毫秒升至500毫秒以上。一个 ES|QL 查询对其所在节点上的租户进行排名,发现批量导出任务占用了工作节点两个核心中的1.7个核心。第二个查询将其追溯到 batch-export 部署,第三个查询则显示,店面服务的处理器用量达到其10毫核请求量的2,546%。将批处理任务的用量上限设为500毫核后,99.8%的请求恢复到500毫秒以内,资源配额则为命名空间设置了用量上限。服务等级目标记录了此次事件,并持续衡量服务表现。
更多 Kubernetes 监控查询和服务等级目标模板
- 用于 Kubernetes 监控的常见 ES|QL 查询,涵盖重启次数、容器组阶段和内存利用率
- Kubernetes 可观测性:将告警转化为错误预算的服务等级目标模板
- TS 命令参考
- Kubernetes 文档中的容器组和容器的资源管理
- 创建服务等级目标消耗速率规则
原文:Kubernetes noisy neighbor: Find and fix it with ES|QL | Elastic Observability Labs