| 项目 | 内容 |
|---|---|
| 标题 | YOLO-World: Real-Time Open-Vocabulary Object Detection |
| 作者 | Tianheng Cheng、Lin Song(共同一作)、Yixiao Ge(项目负责人)、Wenyu Liu、Xinggang Wang、Ying Shan;腾讯 AI Lab、腾讯 PCG ARC Lab、华中科技大学电子信息与通信学院 |
| 来源 | arXiv:2401.17270 cs.CV,本笔记依据 v3(2024-02-22);首版 2024-01-30;CVPR 2024 |
| 代码 | github.com/AILab-CVC/Y... MMYOLO / MMDetection,GPL-3.0);本笔记的实验固定在提交 b1b09f2(2025-02-06),原因见 9.1 节 |
| 权重 | HF wondervictor/YOLO-World:论文版(官方叫 v1)的 S / M / L(O365+GoldG)与 L(+CC3M-Lite),以及之后的 v2、v2.1 和 X、XL。代码仓库的 LICENSE 和 HF 模型卡都是 GPL-3.0(pyproject.toml 里写的 Apache 2.0 与之不一致) |
| 关键词 | 开放词表检测、YOLOv8、CLIP 文本编码器、区域-文本对比学习、RepVL-PAN、T-CSPLayer、max-sigmoid 注意力、I-Pooling Attention、重参数化、prompt-then-detect、伪标注、LVIS Fixed AP |
1. 一句话总结
YOLO-World 把 YOLOv8 改成了开放词表检测器:分类不再是固定的 80 个输出通道,而是用 CLIP 文本编码器把类名或名词短语编码成文本嵌入,检测头在每个位置输出一个"物体嵌入",两者的余弦相似度经过缩放、平移就是分类分数(Eq. 1)。neck 换成 RepVL-PAN:在 YOLOv8 的 C2f 里加一个按文本做的 max-sigmoid 门控(T-CSPLayer),再用 I-Pooling Attention 把图像信息写回文本嵌入。在 Objects365、GQA、Flickr30k 和伪标注的 CC3M 子集上做区域-文本对比预训练后,YOLO-World-L 在 LVIS minival 上零样本 35.4 AP、V100 上 52.0 FPS,比同期的 GLIP、Grounding DINO、DetCLIP 快 20 倍以上。推理采用 prompt-then-detect:用户的词表事先编码好,文本编码器可以不再参与推理,文本嵌入还能直接折进卷积权重。
(后话:YOLO-World 后来成为工业界最常用的开放词表检测器之一,Ultralytics 也集成了它。官方仓库 2024-02 的 v2 去掉了 I-Pooling Attention、把对比头的 L2 归一化换成 BN,2025-02 的 v2.1 又重做了伪标注数据、加入图像提示;见第 7 节。)
2. 研究背景与动机
2.1 固定词表与开放词表
- 传统检测器(Faster R-CNN、YOLO 系列等)只认训练集里定义好的类别,比如 COCO 的 80 类;要加一个类就得重新标注、重新训练。
- 开放词表检测(OVD)想让检测器认出训练类别以外的东西。早期做法按"基类 / 新类"划分(如 OV-COCO 只有 48 个基类),从 CLIP、BERT 这类语言或视觉-语言模型里蒸馏词表知识;训练数据和词表都太少,换个领域就不行。
- GLIP、Grounding DINO、DetCLIP 等把检测重新表述成区域级的视觉-语言预训练,在检测、grounding、图文数据上大规模训练,零样本效果好。但它们有两个问题:计算量大 (ATSS、DINO 这类检测器配 Swin 骨干)、部署难(每张图都要同时编码图像和整套文本)。
- 此前没人认真试过:小检测器(YOLO 这种)做视觉-语言预训练,能不能也获得开放词表能力。
2.2 三种检测范式(Fig. 2)
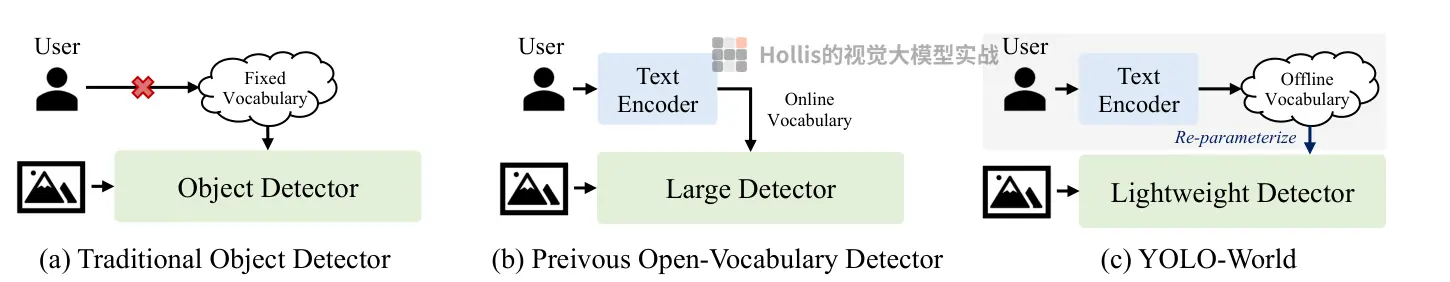
- (b) 的"在线词表":图像和文本一起作为输入,每张图都要过一遍文本编码器。GLIP 这类图文深度融合的模型,一次输入的文本长度有限,LVIS 的 1203 个类名要切成很多段、每段各跑一次完整前向;Table 2 里 GLIP-T 只有 0.12 FPS,个人推测主要是这个原因(论文没有说明 FPS 怎么测的)。
- (c) 的 prompt-then-detect:用户先给出要检测的东西(类名、带属性的描述都行),一次性编码成离线词表;之后检测器每张图只跑图像部分,词表可以随时换。
3. 主要贡献
- YOLO-World:基于 YOLOv8 的开放词表检测器,S / M / L 三档,面向实时应用。
- RepVL-PAN 与区域-文本对比预训练:T-CSPLayer(文本→图像)和 I-Pooling Attention(图像→文本)两个融合模块;推理时文本嵌入可以重参数化进卷积或线性层。
- 统一的预训练数据格式与伪标注:检测、grounding、图文数据统一成区域-文本对;对图文数据提出自动标注流程(n-gram 抽名词 → GLIP 打框 → CLIP 重打分过滤),标了 CC3M 的 246k 张图、821k 个框。
- 结果:LVIS minival 零样本 35.4 AP、52.0 FPS(V100);微调后在 COCO、LVIS 检测和开放词表实例分割上都有收益;小模型(S,13M 参数)也能学到可用的开放词表能力。
4. 方法(Sec. 3)
4.1 把检测标注改写成区域-文本对(Sec. 3.1)
- 传统标注是 Ω={Bi,ci}i=1N(框 + 类别下标),这里改写成 Ω={Bi,ti}i=1N, ti 是框对应的文本:类名、名词短语或对物体的描述都可以。
- 模型输入是图像 I 和一组名词 T,输出预测框 {B^k} 和对应的物体嵌入 {ek}( ek∈RD)。类别这件事完全由"物体嵌入和哪个词最像"来决定,所以检测类别不再写死在网络结构里。
4.2 整体结构(Sec. 3.2)
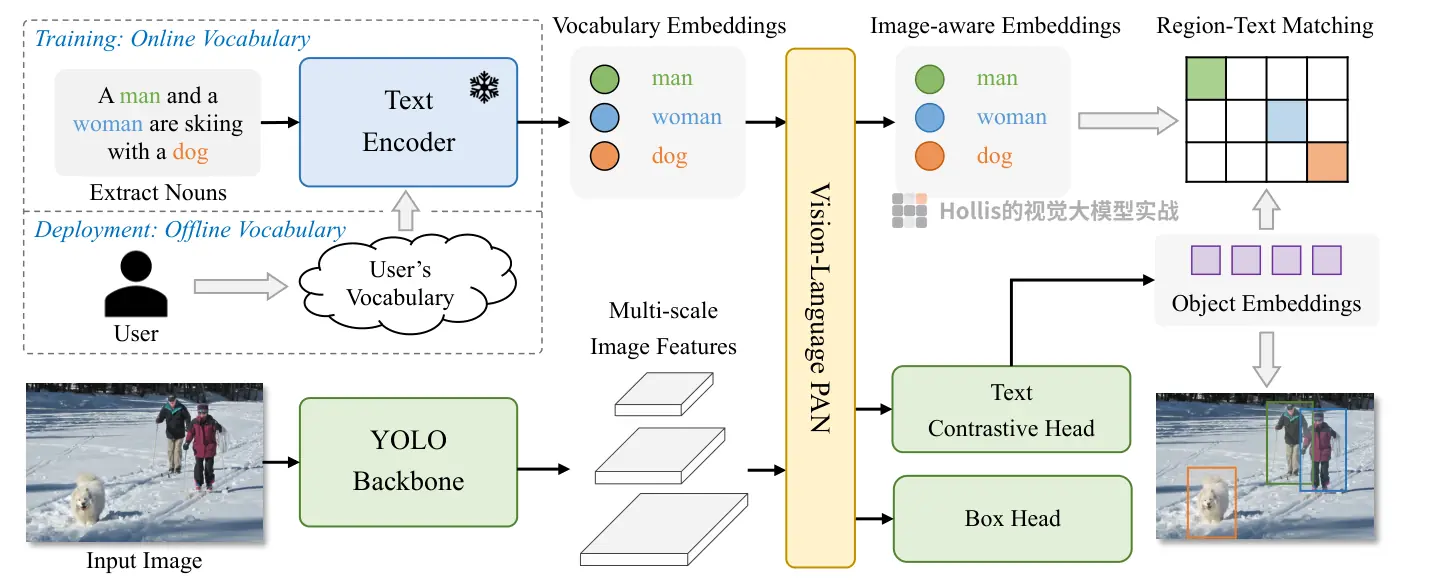
三部分:YOLO 检测器、文本编码器、RepVL-PAN。
- YOLO 检测器:YOLOv8 的 Darknet 骨干 + PAN + 解耦检测头。
- 文本编码器 :CLIP 的 Transformer 文本编码器,输出 W=TextEncoder(T)∈RC×D, C 是名词个数, D 是嵌入维度。作者认为 CLIP 的文本嵌入经过图文对齐,比纯文本的 BERT 更适合连接视觉物体(Table 5 验证)。输入是长描述或指代表达时,先用简单的 n-gram 算法抽名词短语。代码里用的是
openai/clip-vit-base-patch32的文本塔(63.4M 参数),取投影后的 512 维text_embeds再做 L2 归一化,预训练时整体冻结。 - 文本对比头 :沿用 YOLOv8 的解耦头,两个 3×3 卷积分别回归框 {bk} 和物体嵌入 {ek}。物体与第 j 个词的相似度:
sk,j=α⋅L2-Norm(ek)⋅L2-Norm(wj)⊤+β(1)
α、 β 是可学习的缩放和平移。作者说 L2 归一化和这个仿射变换对稳定区域-文本训练都很重要。代码里每个尺度各有一套: α=exp(logit_scale),按 CLIP 初始化为 1/0.07; β 初始化为 log(5/C/(640/stride)2),即先验概率很小。
- 训练用在线词表 :每个 mosaic 样本(4 张图拼成)单独组一个词表:这 4 张图里出现的所有正名词,再从数据集里随机采一些负名词,总数最多 M=80。代码(
RandomLoadText)里不足 80 个用空字符串补齐,补齐项也会被文本编码器编码、当作负样本参与计算。 - 推理用离线词表:用户定义一组提示词(类名或描述),用文本编码器编码一次得到离线词表嵌入,之后每张图都直接用,词表也可以按需替换。
4.3 RepVL-PAN(Sec. 3.3)
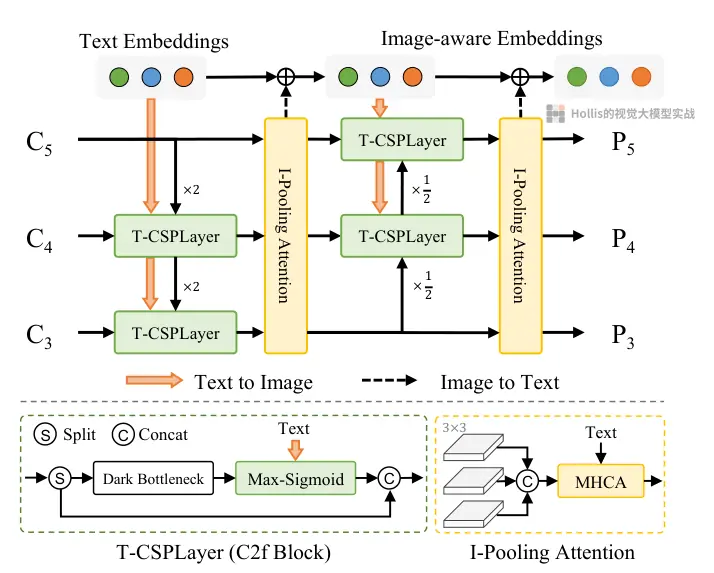
结构上沿用 YOLOv8 PAN 的自顶向下、自底向上路径,由 {C3,C4,C5} 得到 {P3,P4,P5},加了两个模块:
- T-CSPLayer(文本引导的 CSPLayer):在 C2f 最后一个 dark bottleneck 之后加 max-sigmoid 注意力:
Xl′=Xl⋅δ(j∈{1..C}max(XlWj⊤))⊤(2)
意思是:特征图每个位置都和词表里的所有词算相似度,取最大的那个,过 sigmoid 后作为这个位置的权重。和词表里任何一个词都不像的位置被压下去,像某个词的位置被保留。 Xl′ 再与 C2f 的跨阶段特征拼接输出。
- I-Pooling Attention(图像池化注意力) :不直接在整张特征图上做交叉注意力(太贵),而是把三层特征各 max-pool 成 3×3,一共 27 个 patch token X~∈R27×D,文本嵌入作为 query:
W′=W+MultiHead-Attention(W,X~,X~)(3)
得到"图像感知"的文本嵌入。
论文写法与代码写法的出入 (读 yolo_world/models/layers/yolo_bricks.py、necks/yolo_world_pafpn.py,并在 8.5 节逐元素对拍过):
| 论文 | 代码(v1:MaxSigmoidCSPLayerWithTwoConv、ImagePoolingAttentionModule、YOLOWorldDualPAFPN) |
|
|---|---|---|
| max-sigmoid 注意力 | 单头,直接 XW⊤ | 多头(每头 32 维);图像先过 1×1 卷积 + BN 投到 embed 维,文本先过一层 Linear;相似度除以 32 ,再加每个头一个可学习偏置 |
| 被加权的特征 | X 本身 | X 先过一个 3×3 卷积 + BN,再乘权重 |
| 输出方式 | 与跨阶段特征拼接 | 作为 C2f 的额外一支拼进去:最后的 1×1 卷积输入从 (2+n)c 变成 (3+n)c |
| I-Pooling 的计算 | Eq. 3;附录 Eq. 6 写成 W+Softmax(W⊙X~)⊙W(最后一项应是 X~,像是笔误) | 标准多头注意力:三层特征先各自 1×1 卷积到 256 维再池化;query 是 LayerNorm + Linear(512→256),key、value 各自 LayerNorm + Linear,8 头,输出 Linear(256→512) 后加回 W |
| I-Pooling 的个数与去向 | Fig. 4 画了两个,第二个输出的"图像感知嵌入"送进检测头(Fig. 3 也这么画) | 只有一个,放在自顶向下路径之后; W′ 只给自底向上的两个 T-CSPLayer 用,检测头算相似度用的仍是原始 W |
最后一行的影响最大:检测头不依赖图像感知的 W′,所以检测头整个可以重参数化掉(8.4 节)。
4.4 预训练方案(Sec. 3.4)
区域-文本对比损失 :对 mosaic 样本 I 和词表 T,模型给出 K 个预测 {Bk,sk}。沿用 YOLOv8 的 task-aligned label assignment(TAL)把预测和标注匹配,每个正样本的分类标签是它对应文本在词表里的下标, Lcon 是相似度与分配结果之间的交叉熵。总损失:
L(I)=Lcon+λI⋅(Liou+Ldfl)
图像来自检测或 grounding 数据时 λI=1;来自图文数据时框不可靠, λI=0,只算分类。
代码里"交叉熵"其实是 YOLOv8 的 sigmoid 二分类交叉熵(CrossEntropyLoss(use_sigmoid=True)):每个词独立做二分类,目标是 TAL 给出的软分数(与 IoU 挂钩),再除以所有软分数之和;不是在词表上做 softmax。三项权重沿用 YOLOv8:分类 0.5、CIoU 7.5、DFL 0.375(1.5 / 4)。也就是说,所谓"区域-文本对比学习"就是把 YOLOv8 的分类分支换成了"与文本嵌入的缩放余弦相似度",其余训练逻辑没变。
图文数据的伪标注(Sec. 3.4、附录 B):
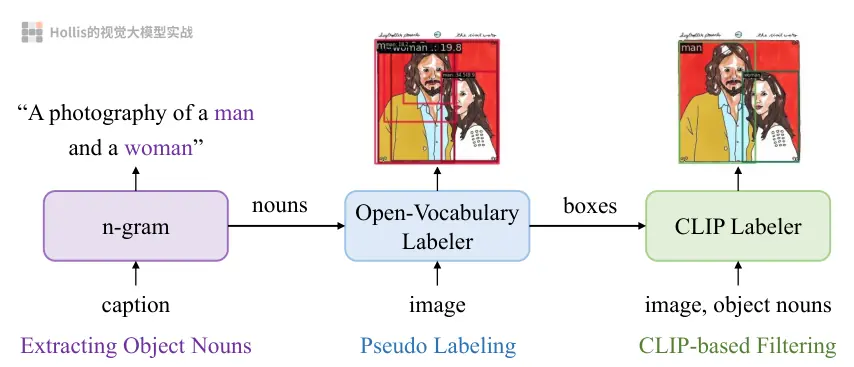
- 抽名词 :n-gram 从描述里抽名词短语 T={tk}。
- 伪框 :GLIP-L 按这些名词给图打框,得到粗的区域-文本对 {Bi,ti,ci}( ci 是置信度)。
- CLIP 重打分与过滤 :
- 图文分数 simg:整图与描述的 CLIP 相似度;区域-文本分数 sir:裁出框内区域与对应名词的 CLIP 相似度;
- (可选)重标注:每个裁出的区域与所有名词比,换成最像的那个,纠正 GLIP 标错的;
- 重打分: c~i=ci⋅sir ;
- 区域级过滤:按名词分组做 NMS(阈值 0.5),去掉 c~i<0.3 的;
- 图像级过滤:保留下来的框的平均区域-文本分数为 sregion, s=simg⋅sregion >0.3 的图才留下。
阈值都是看一部分结果凭经验定的,全流程无人工核对。最终从 CC3M 里采样标注了 246k 张图、821k 个伪框(约为 CC3M 的 8%)。
4.5 推理:离线词表与重参数化(附录 A.1)
- 先用文本编码器算好 W∈RC×D。
- T-CSPLayer :把 W reshape 成 C 个 1×1 卷积核,Eq. 2 变成 X′=X⊙Sigmoid(max(Conv(X,W),dim=1))(Eq. 4),全是卷积和逐元素运算,部署友好。
- I-Pooling Attention : X~=cat(MP(X3,3),MP(X4,3),MP(X5,3))(Eq. 5),再按 Eq. 6 更新 W。
- 检测头:微调到 COCO 后,把 80 个类名的文本嵌入存进分类层的权重(附录 A.2)。
论文没有明说的一点:I-Pooling 的输出 W′ 随图像变化,用 W′ 的自底向上 T-CSPLayer 折不进固定权重,v1 模型"重参数化"之后这几处仍要把 W 当输入算;能完全折掉的是自顶向下的两个 T-CSPLayer 和检测头(8.4 节)。
5. 实验(Sec. 4)
5.1 实现与预训练设置(Sec. 4.1--4.2)
- 基于 MMYOLO 和 MMDetection,S / M / L 三档与 YOLOv8 对应;CLIP 文本编码器预训练时冻结。
- 速度都在一张 V100 上测,不用 FP16、TensorRT 等加速(Table 6 例外,用了 TensorRT)。
- 预训练:AdamW,初始学习率 0.002,weight decay 0.05;32 张 V100、总 batch 512,训练 100 epoch;数据增强有颜色、随机仿射、翻转、4 图 mosaic(配置里最后 2 个 epoch 关掉 mosaic)。
- weight decay 与代码对不上:v1 配置写的是
weight_decay = 0.05 / 2,而优化器构造器(YOLOWv5OptimizerConstructor,照搬 YOLOv5 的做法)还会按"总 batch ÷ 64"放大,32 卡 × 16 = 512 时放大 8 倍,按代码推算实际是 0.2。单卡 batch 16 微调时放大倍数是 1。
| 数据 | 类型 | 词表 | 图像 | 标注 |
|---|---|---|---|---|
| Objects365V1 | 检测 | 365 | 609k | 9,621k |
| GQA | Grounding | -- | 621k | 3,681k |
| Flickr30k | Grounding | -- | 149k | 641k |
| CC3M† | 图文(伪标注) | -- | 246k | 821k |
(来源:论文 Table 1。按 GLIP 的做法,GoldG(GQA + Flickr30k)里去掉了 COCO 的图。)
- 零样本评测:预训练完直接在 LVIS 上测,LVIS 有 1203 类,远多于预训练检测数据的类别数。和前人一样主要用 LVIS minival(MDETR 划出的子集;实测 4809 张图、50,672 个框,全部来自 COCO val2017),报 Fixed AP(Dave et al. 2021),每张图最多 1000 个预测。
5.2 LVIS 零样本(Table 2)
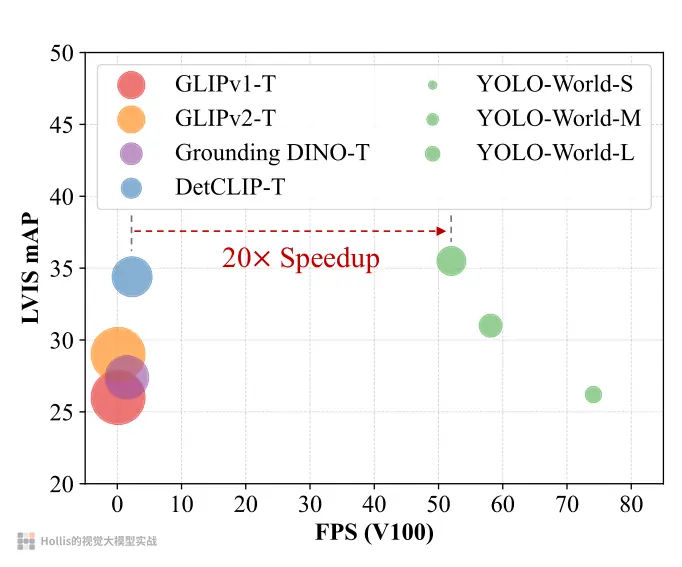
| 方法 | 骨干 | 参数量 | 预训练数据 | FPS | AP | APr | APc | APf |
|---|---|---|---|---|---|---|---|---|
| MDETR | R-101 | 169M | GoldG | -- | 24.2 | 20.9 | 24.3 | 24.2 |
| GLIP-T | Swin-T | 232M | O365, GoldG | 0.12 | 24.9 | 17.7 | 19.5 | 31.0 |
| GLIP-T | Swin-T | 232M | O365, GoldG, Cap4M | 0.12 | 26.0 | 20.8 | 21.4 | 31.0 |
| GLIPv2-T | Swin-T | 232M | O365, GoldG | 0.12 | 26.9 | -- | -- | -- |
| GLIPv2-T | Swin-T | 232M | O365, GoldG, Cap4M | 0.12 | 29.0 | -- | -- | -- |
| Grounding DINO-T | Swin-T | 172M | O365, GoldG | 1.5 | 25.6 | 14.4 | 19.6 | 32.2 |
| Grounding DINO-T | Swin-T | 172M | O365, GoldG, Cap4M | 1.5 | 27.4 | 18.1 | 23.3 | 32.7 |
| DetCLIP-T | Swin-T | 155M | O365, GoldG | 2.3 | 34.4 | 26.9 | 33.9 | 36.3 |
| YOLO-World-S | YOLOv8-S | 13M (77M) | O365, GoldG | 74.1 (19.9) | 26.2 | 19.1 | 23.6 | 29.8 |
| YOLO-World-M | YOLOv8-M | 29M (92M) | O365, GoldG | 58.1 (18.5) | 31.0 | 23.8 | 29.2 | 33.9 |
| YOLO-World-L | YOLOv8-L | 48M (110M) | O365, GoldG | 52.0 (17.6) | 35.0 | 27.1 | 32.8 | 38.3 |
| YOLO-World-L | YOLOv8-L | 48M (110M) | O365, GoldG, CC3M† | 52.0 (17.6) | 35.4 | 27.6 | 34.1 | 38.0 |
(来源:论文 Table 2,LVIS minival、Fixed AP。括号外是重参数化后的参数量和 FPS,括号内是带文本编码器的原始版本;FPS 在 V100 上测,不用 TensorRT。)
- 同样只用 O365 + GoldG,YOLO-World-L(35.0)比 GLIP-T(24.9)、Grounding DINO-T(25.6)高约 10 AP;去掉文本编码器后的参数量(48M)只有它们的 1/5 到 1/3.6。
- 和最强的 DetCLIP-T 比:35.4 对 34.4,速度 52.0 对 2.3 FPS(约 22.6 倍,论文说"20×")。
- 13M 参数的 YOLO-World-S 也有 26.2 AP,与 GLIP-T 相当:小模型也能做视觉-语言预训练。
- 括号里的数字说明了离线词表的意义:带文本编码器每张图都编码 1203 个类名时,三档模型只有 17.6--19.9 FPS,瓶颈在文本编码器,与检测器大小几乎无关(9.4 节实测)。
- 这张表和 Table 3 的同一个模型数字对不上(35.0 对 32.5),原因在评测口径,见 9.3 节。
5.3 消融(Sec. 4.3,Table 3--5)
消融都用 YOLO-World-L,只在 Objects365 上预训练(除非另说明),在 LVIS minival 上零样本评测。
预训练数据(Table 3):
| 预训练数据 | AP | APr | APc | APf |
|---|---|---|---|---|
| O365 | 23.5 | 16.2 | 21.1 | 27.0 |
| O365, GQA | 31.9 | 22.5 | 29.9 | 35.4 |
| O365, GoldG | 32.5 | 22.3 | 30.6 | 36.0 |
| O365, GoldG, CC3M† | 33.0 | 23.6 | 32.0 | 35.5 |
- 加 GQA 涨 8.4 AP:GQA 的名词短语比 O365 的 365 个类名丰富得多,对大词表检测帮助最大。
- 再加约 8% 的 CC3M 伪标注数据:+0.5 AP、+1.3 APr。
- 注意:O365, GoldG 这一行(32.5)和加 CC3M 的一行(33.0)与 Table 2 的同配置模型(35.0、35.4)差了约 2.5 AP,论文没有解释;官方模型库给这两个权重标的也是 32.5、33.0。见 9.3 节。
RepVL-PAN(Table 4):
| GQA | T→I | I→T | AP | APr | APc | APf |
|---|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | 22.4 | 14.5 | 20.1 | 26.0 |
| ✗ | ✓ | ✗ | 23.2 | 15.2 | 20.6 | 27.0 |
| ✗ | ✓ | ✓ | 23.5 | 16.2 | 21.1 | 27.0 |
| ✓ | ✗ | ✗ | 29.7 | 21.0 | 27.1 | 33.6 |
| ✓ | ✓ | ✓ | 31.9 | 22.5 | 29.9 | 35.4 |
(T→I 是 T-CSPLayer,I→T 是 I-Pooling Attention;两者都不加就是 YOLOv8 原来的 PAN。)
- 只用 O365 时 RepVL-PAN 带来 +1.1 AP(22.4 → 23.5),主要涨在稀有类(APr +1.7);加了 GQA 后收益变成 +2.2 AP。作者的解释:GQA 有丰富的名词短语,RepVL-PAN 在文本信息多时更有用。
- 两个模块的单独贡献只在 O365 设置下拆开过:T→I +0.8、I→T +0.3。有 GQA 时没有拆。
- 表格之间的对应:Table 4 最后一行就是 Table 3 的 "O365, GQA";Table 4 第一行(22.4 / 14.5 / 20.1 / 26.0)与 Table 5 的 "CLIP-base 冻结" 完全相同,说明 Table 5 的文本编码器消融是在不带 RepVL-PAN 的基线上做的。
文本编码器(Table 5):
| 文本编码器 | 训练方式 | AP | APr | APc | APf |
|---|---|---|---|---|---|
| BERT-base | 冻结 | 14.6 | 3.4 | 10.7 | 20.0 |
| BERT-base | 微调 | 18.3 | 6.6 | 14.6 | 23.6 |
| CLIP-base | 冻结 | 22.4 | 14.5 | 20.1 | 26.0 |
| CLIP-base | 微调 | 19.3 | 8.6 | 15.7 | 24.8 |
(微调时文本编码器的学习率是基础学习率的 0.01 倍。)
- CLIP 明显好于 BERT,稀有类差得最多:冻结时 APr 14.5 对 3.4。正文写"+10.1 AP for rare categories",但表里 14.5 − 3.4 = 11.1,任何一对组合都算不出 10.1,应是笔误。
- 微调 BERT 有用(+3.7 AP),微调 CLIP 反而掉 3.1 AP、APr 掉 5.9:O365 只有 365 个类,文本太单一,微调会破坏 CLIP 原有的泛化能力。工程上的含义:数据词表不丰富时,文本编码器别动。
5.4 微调(Sec. 4.4)
设置:用预训练权重初始化,80 epoch,AdamW,初始学习率 0.0002,CLIP 文本编码器的学习率乘 0.01。
COCO(Table 6):
| 方法 | 预训练 | AP | AP50 | AP75 | FPS |
|---|---|---|---|---|---|
| YOLOv6-S / M / L | ✗ | 43.7 / 48.4 / 50.7 | 60.8 / 65.7 / 68.1 | 47.0 / 52.7 / 54.8 | 442 / 277 / 166 |
| YOLOv7-T / L / X | ✗ | 37.5 / 50.9 / 52.6 | 55.8 / 69.3 / 70.6 | 40.2 / 55.3 / 57.3 | 404 / 182 / 131 |
| YOLOv8-S / M / L | ✗ | 44.4 / 50.5 / 52.9 | 61.2 / 67.3 / 69.9 | 48.1 / 55.0 / 57.7 | 386 / 238 / 159 |
| YOLO-World-S(零样本) | O+G | 37.6 | 52.3 | 40.7 | -- |
| YOLO-World-M(零样本) | O+G | 42.8 | 58.3 | 46.4 | -- |
| YOLO-World-L(零样本) | O+G | 44.4 | 59.8 | 48.3 | -- |
| YOLO-World-L(零样本) | O+G+C | 45.1 | 60.7 | 48.9 | -- |
| YOLO-World-S(微调,带 RepVL-PAN) | O+G | 45.9 | 62.3 | 50.1 | -- |
| YOLO-World-M(微调,带 RepVL-PAN) | O+G | 51.2 | 68.1 | 55.9 | -- |
| YOLO-World-L(微调,带 RepVL-PAN) | O+G+C | 53.3 | 70.1 | 58.2 | -- |
| YOLO-World-S(微调,去掉 RepVL-PAN) | O+G | 45.7 | 62.3 | 49.9 | 373 |
| YOLO-World-M(微调,去掉 RepVL-PAN) | O+G | 50.7 | 67.2 | 55.1 | 231 |
| YOLO-World-L(微调,去掉 RepVL-PAN) | O+G+C | 53.3 | 70.3 | 58.1 | 156 |
(来源:论文 Table 6。O、G、C 分别是 Objects365、GoldG、CC3M†;YOLOv7、YOLOv8 的数字取自 MMYOLO;FPS 在 V100 上用 TensorRT 测,与 Table 2 口径不同。)
- 零样本:没见过 COCO 标注的 YOLO-World-L 有 44.4--45.1 AP,与从头训练 500 epoch 的 YOLOv8-S(44.4)相当。
- 微调:去掉 RepVL-PAN 后(附录 A.2:COCO 只有 80 类,对图文交互依赖小),结构基本就是 YOLOv8 加一个由文本嵌入初始化的分类层,比 YOLOv8 高 +1.3 / +0.2 / +0.4 AP(S / M / L)。也就是说,在 COCO 这种数据充足的场景,138 万到 163 万张图的视觉-语言预训练只换来很小的提升,S 最明显。
- 带不带 RepVL-PAN 对 COCO 微调结果影响很小(S 45.9 对 45.7、L 53.3 对 53.3)。
LVIS(Table 7):只在 LVIS-base(common + frequent)上微调,在全部 1203 类上评测,稀有类(APr)相当于零样本:
| 方法 | AP | APr | APc | APf |
|---|---|---|---|---|
| ViLD | 27.8 | 16.7 | 26.5 | 34.2 |
| RegionCLIP | 28.2 | 17.1 | -- | -- |
| Detic | 26.8 | 17.8 | -- | -- |
| FVLM | 24.2 | 18.6 | -- | -- |
| DetPro | 28.4 | 20.8 | 27.8 | 32.4 |
| BARON | 29.5 | 23.2 | 29.3 | 32.5 |
| YOLOv8-S / M / L | 19.4 / 23.1 / 26.9 | 7.4 / 8.4 / 10.2 | 17.4 / 21.3 / 25.4 | 27.0 / 31.5 / 35.8 |
| YOLO-World-S / M / L | 23.9 / 28.8 / 34.1 | 12.8 / 15.9 / 20.4 | 20.4 / 24.6 / 31.1 | 32.7 / 39.0 / 43.5 |
(来源:论文 Table 7。YOLOv8 在完整 LVIS(含稀有类)上训练,并用了类别均衡采样。)
- YOLO-World-L 比 YOLOv8-L 高 7.2 AP、10.2 APr:YOLOv8 见过稀有类的标注,YOLO-World 没见过,稀有类反而高一倍。大词表、长尾的场景是预训练收益最大的地方。
- 与两阶段的 OVD 方法比,YOLO-World-L 的总 AP(34.1)最高;但稀有类 20.4 低于 BARON(23.2)和 DetPro(20.8)。论文说"整体性能超过两阶段方法",指的是总 AP。
5.5 开放词表实例分割(Sec. 4.5,Table 8)
在 YOLO-World 上加分割头,两种设定:COCO → LVIS(在 COCO 80 类的 mask 上微调,迁移到 1203 类)、LVIS-base → LVIS(在 866 个 common + frequent 类上微调);两种策略:只训分割头、全部微调。评测在 LVIS val 上做,337 个稀有类没见过。
| 模型 | 微调数据 | 微调模块 | AP | APr | APc | APf | 框 AP | 框 APr |
|---|---|---|---|---|---|---|---|---|
| YOLO-World-M | COCO | 分割头 | 12.3 | 9.1 | 10.9 | 14.6 | 22.3 | 16.2 |
| YOLO-World-L | COCO | 分割头 | 16.2 | 12.4 | 15.0 | 19.2 | 25.3 | 18.0 |
| YOLO-World-M | LVIS-base | 分割头 | 16.7 | 12.6 | 14.6 | 20.8 | 22.3 | 16.2 |
| YOLO-World-L | LVIS-base | 分割头 | 19.1 | 14.2 | 17.2 | 23.5 | 25.3 | 18.0 |
| YOLO-World-M | LVIS-base | 全部 | 25.9 | 13.4 | 24.9 | 32.6 | 32.6 | 15.8 |
| YOLO-World-L | LVIS-base | 全部 | 28.7 | 15.0 | 28.3 | 35.2 | 36.2 | 17.4 |
(来源:论文 Table 8,AP 是 mask AP。)
- 只训分割头时检测器冻结,零样本能力完全保留;COCO 和 LVIS-base 的 APr / AP 比例几乎一样(L:76.5% 对 74.3%),差距来自 LVIS 的 mask 标注更细更密。
- 全部微调:L 的 mask AP +9.6,但框的 APr 从 18.0 掉到 17.4,开放词表能力有所退化。
- 只训分割头那几行的框 AP(M 22.3 / 16.2,L 25.3 / 18.0)与官方模型库里 v1 权重(M 是 O365+GoldG,L 是 +CC3M-Lite 的那个)在 LVIS val 上的零样本 AP 一字不差,可见这几行的框结果就是预训练检测器本身。
5.6 可视化(Sec. 4.6)
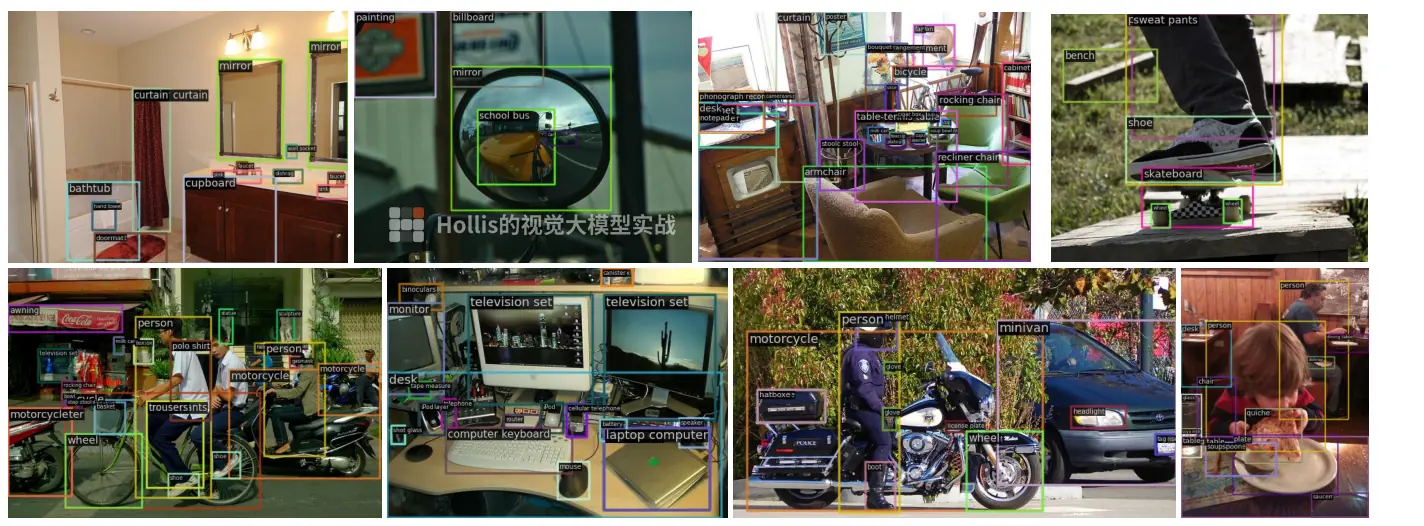
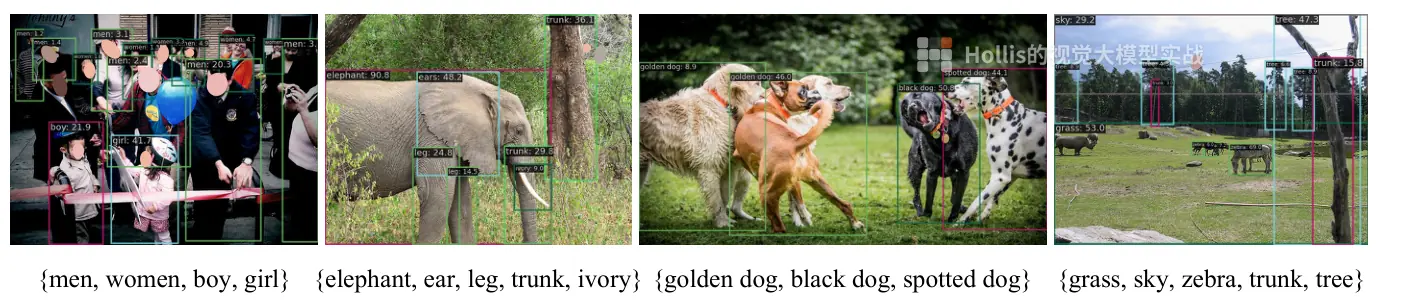
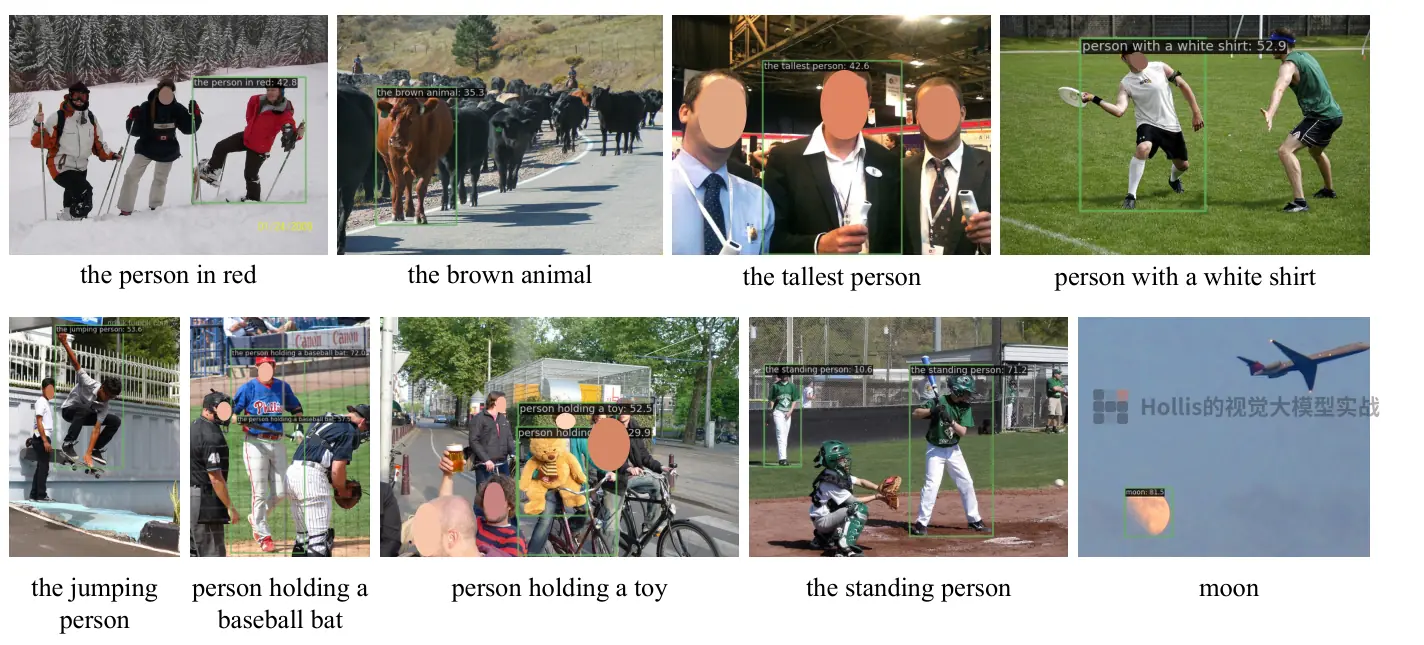
作者认为指代能力来自含大量名词短语的预训练数据(GQA、Flickr30k)。注意这些都是挑出来的例子,论文没有在指代检测基准(RefCOCO 等)上报数字。
5.7 附录 C:小模型要多少数据(Table 9)
| 模型 | 预训练数据 | 样本数 | AP | APr | APc | APf |
|---|---|---|---|---|---|---|
| YOLO-World-S | O365 | 0.61M | 16.3 | 9.2 | 14.1 | 20.1 |
| YOLO-World-S | O365 + GoldG | 1.38M | 24.2 | 16.4 | 21.7 | 27.8 |
| YOLO-World-S | O365 + CC3M-245k | 0.85M | 16.5 | 10.8 | 14.8 | 19.1 |
| YOLO-World-S | O365 + CC3M-520k | 1.13M | 19.2 | 10.7 | 17.4 | 22.4 |
| YOLO-World-S | O365 + CC3M-750k | 1.36M | 18.2 | 11.2 | 16.0 | 21.1 |
(来源:论文 Table 9,LVIS minival 零样本。)
- 同样约 1.37M 个样本,人工标注的 GoldG(24.2)比伪标注的 CC3M-750k(18.2)高 6 AP:对小模型来说,标注质量远比数量重要。
- 伪标注数据加到 750k 反而比 520k 低 1.0 AP(APr 仍在涨):噪声多了,小模型的容量吃不下。
- 这张表里 S 的 O365 + GoldG 是 24.2,与官方模型库的 24.3 相近,而 Table 2 写的是 26.2,同样是口径问题(9.3 节)。
6. 相关工作的位置
| 路线 | 代表 | 做法 | 与 YOLO-World 的区别 |
|---|---|---|---|
| 基类训练 + 蒸馏 | OVR-CNN、ViLD、RegionCLIP、DetPro、BARON | 在基类上训练,从 CLIP 蒸馏或对齐区域特征,评新类 | 词表和数据都小,两阶段检测器 |
| 简单 ViT 检测器 | OWL-ViT、OWLv2 | CLIP 的 ViT 直接接检测头,在检测、grounding 数据上微调 | 骨干是大 ViT,慢 |
| grounding 预训练 | GLIP、GLIPv2、Grounding DINO | 检测当作短语定位,图文深度融合(每层交叉注意力) | 在线词表,图文每次都要一起编码,重 |
| 区域-词对齐预训练 | DetCLIP、DetCLIPv2 | 用词典丰富概念,大规模图文数据 | 精度接近,但慢 20 倍以上 |
| YOLO 上的零样本 | ZSD-YOLO | 把 YOLO 与语言模型对齐(蒸馏) | 没有大规模预训练,按基类 / 新类设定评 |
YOLO-World 的位置:结构上只在 YOLOv8 上做轻量改动(文本对比头 + 两个融合模块),把性能主要交给大规模区域-文本预训练;部署上用离线词表绕开文本编码器。
7. 论文之后:官方仓库的 v2 和 v2.1
论文对应官方仓库里的"v1"(configs/pretrain_v1/,README 标注"几乎已弃用")。之后的主要改动:
- v2(2024-02-29) :
- 去掉 I-Pooling Attention:它对 LVIS 零样本有帮助,但导出 ONNX、TensorRT 后拖慢推理;
- 对比头里的 L2 归一化换成 BatchNorm:L2 归一化含 reduce 操作,部署慢,BN 可以融进卷积,零样本精度还更高;
- 支持"重参数化微调":把词表嵌入折进检测头的 1×1 卷积(
RepBNContrastiveHead)和 neck 的 1×1 卷积(RepConvMaxSigmoidAttnBlock)后再微调,官方说 COCO 上 46.3 对普通微调的 46.1 AP。
- v2.1(2025-02) :
- 补齐词:此前训练时词表不足 80 个就用空字符串补齐,且不加掩码;官方发现这样做 LVIS 能高 2--3 AP,补齐词起了"背景嵌入"的作用,但副作用是推理时通常要额外加一个补齐词才有合理结果。v2.1 在分类损失里给补齐词加了掩码,T-CSPLayer 里仍保留;
- 伪标注数据重做:用 RAM++ 打标签、YOLO-World-X-v2 打框,重标了 250k 张 CC3M(CC-LiteV2);
- 图像提示:用 CLIP 图像编码器 + 一个 MLP 适配器把"示例框"编码成嵌入,替换文本嵌入。
- 官方模型库各版本的 LVIS minival 数字(L,640):v1 32.5 / 33.0(O365+GoldG / +CC3M-Lite)、v2 33.0 / 33.4、v2.1 33.8。这些都比论文 Table 2 的 35.0 / 35.4 低,口径的差别见 9.3 节。
8. 核心代码(个人实现,已对拍)
完整脚本在本库 Detection_Notes/repro/yoloworld/:yoloworld_core.py 是实现,parity_core.py 是对拍。只实现论文新增的计算;卷积 + BN、Linear 这类标准层直接借用官方模块里的参数。
8.1 文本对比头(Eq. 1)
python
def contrastive_logits(e, w, logit_scale, bias):
    """e: B×D×H×W(分类分支输出的区域嵌入),w: B×C×D(词表的文本嵌入)→ B×C×H×W"""
    e = F.normalize(e, dim=1)
    w = F.normalize(w, dim=-1)
return torch.einsum("bdhw,bcd->bchw", e, w) * logit_scale.exp() + bias- 每个位置对每个词的分数,就是区域嵌入与词嵌入的余弦相似度乘 α(初值 1/0.07≈14.3)再加 β;训练时过 sigmoid,每个词独立做二分类。
- 换词表不用改网络, w 换成新的 C×512 矩阵就行, C 可以是 1,也可以是几千。
8.2 T-CSPLayer 的 max-sigmoid 注意力(Eq. 2)
python
def max_sigmoid_attn(x, w, blk):
    B, _, H, W = x.shape
    m, d = blk.num_heads, blk.head_channels                         # 每头 d = 32 维
    g = blk.guide_fc(w).view(B, -1, m, d)                            # 文本:Linear → B×C×m×d
    e = blk.embed_conv(x).view(B, m, d, H, W)                        # 图像:1×1 卷积 + BN
    a = torch.einsum("bmdhw,bcmd->bmhwc", e, g).amax(-1)             # 每个位置对 C 个词取最大
    a = (a / d ** 0.5 + blk.bias.view(1, m, 1, 1)).sigmoid()
    y = blk.project_conv(x).view(B, m, -1, H, W) * a.unsqueeze(2)    # 被门控的是 3×3 卷积后的特征
return y.view(B, -1, H, W)- 计算量与词表大小 C 成正比:每个位置、每个头都要和 C 个词算点积再取最大。 C=1203 时,P3 层(80×80)的一个头就要算 6,400 × 1,203 个点积。
- 用的是 max 而不是 softmax:只问"这个位置像不像词表里的某个东西",不管像哪个。所以往词表里加词只会让门控更宽松,不会让某个词的分数变低(9.5 节)。
8.3 I-Pooling Attention(Eq. 3)
python
def image_pooling_attn(w, feats, ipa):
    B = feats[0].shape[0]
    toks = torch.cat([F.adaptive_max_pool2d(p(f), 3).flatten(2)        # 每层 1×1 卷积到 256 维,再池化成 3×3
                      for f, p in zip(feats, ipa.projections)], 2).transpose(1, 2)   # B×27×256
    h, d = ipa.num_heads, ipa.head_channels                             # 8 头 × 32 维
    q = ipa.query(w).view(B, -1, h, d).transpose(1, 2)                  # LayerNorm + Linear(512→256)
    k = ipa.key(toks).view(B, -1, h, d).transpose(1, 2)
    v = ipa.value(toks).view(B, -1, h, d).transpose(1, 2)
    o = F.softmax(q @ k.transpose(-1, -2) / d ** 0.5, dim=-1) @ v       # 每个词在 27 个图像 token 上做注意力
return w + ipa.proj(o.transpose(1, 2).reshape(B, -1, h * d)) * ipa.scale- 只有 27 个 key,比在整张特征图(640 输入时三层共 8,400 个位置)上做交叉注意力便宜得多。
- softmax 在 27 个图像 token 上做,不在词之间做,所以各个词的更新互不影响。
8.4 重参数化:把离线词表折进卷积
python
class RepContrastHead(nn.Module):
    """检测头折叠后:L2 归一化 + 1×1 卷积(权重 = α·w/|w|,偏置 = β),forward 不再需要文本"""
    def __init__(self, contrast, w):
        super().__init__()
        wn = F.normalize(w, dim=-1)                                     # C×D
        self.conv = nn.Conv2d(wn.shape[1], wn.shape[0], 1)
        with torch.no_grad():
            self.conv.weight.copy_((wn * contrast.logit_scale.exp())[:, :, None, None])
            self.conv.bias.fill_(float(contrast.bias))

    def forward(self, x, w=None):
        return self.conv(F.normalize(x, dim=1))

class RepMaxSigmoidAttn(nn.Module):
    """自顶向下的 T-CSPLayer 用原始 W:guide_fc(W) 只算一次,按头拆成 m 个 1×1 卷积(各 C 个输出)"""
    def __init__(self, blk, w):
        super().__init__()
        self.m, self.d = blk.num_heads, blk.head_channels
        self.embed_conv, self.project_conv, self.bias = blk.embed_conv, blk.project_conv, blk.bias
        with torch.no_grad():
            g = blk.guide_fc(w)                                         # C×(m·d)
        self.convs = nn.ModuleList()
        for i in range(self.m):
            conv = nn.Conv2d(self.d, g.shape[0], 1, bias=False)
            with torch.no_grad():
                conv.weight.copy_(g[:, i * self.d:(i + 1) * self.d, None, None])
            self.convs.append(conv)

    def forward(self, x, w=None):
        B, _, H, W = x.shape
        e = self.embed_conv(x)
        a = torch.stack([c(t) for c, t in zip(self.convs, e.split(self.d, 1))], 1).amax(2)   # B×m×H×W
        a = (a / self.d ** 0.5 + self.bias.view(1, -1, 1, 1)).sigmoid()
        y = self.project_conv(x).view(B, self.m, -1, H, W) * a.unsqueeze(2)
        return y.view(B, -1, H, W)
reparameterize_v1(model, w) 把检测头三层的对比头换成 RepContrastHead,把自顶向下两个 T-CSPLayer 的注意力换成 RepMaxSigmoidAttn:
- 折得掉的 :检测头和自顶向下的两个 T-CSPLayer,它们用的是原始 W。
- 折不掉的 :I-Pooling Attention 和自底向上的两个 T-CSPLayer,它们用的 W′ 随图像而变, W 仍要作为常量输入。附录 A.1 的 Eq. 5--6 只是 I-Pooling 的简化写法,没有说它能折成固定权重。
- 检测头里的 L2 归一化折不掉,要逐位置做 reduce,这是 v2 把它换成 BN 的原因之一(BN 能融进前面的卷积)。
8.5 与官方实现对拍
parity_core.py:在官方 v1 模型上挂 hook,取 4 张 COCO val2017 图(id 139、285、632、724),词表是 LVIS 的 1203 类,严格 FP32(关掉 TF32)。
| 对拍项 | S | M | L | L(+CC3M) |
|---|---|---|---|---|
| max-sigmoid(4 处)、I-Pooling、对比头(3 层)与官方模块的最大绝对差 | 0 | 0 | 0 | 0 |
| 重参数化前后分类 logits 的最大差 | 4.5e-4 | 8.1e-3 | 2.0e-4 | 4.5e-3 |
| 重参数化前后框回归的最大差 | 1.3e-4 | 9.4e-5 | 2.1e-4 | 3.7e-4 |
| 最终检测(NMS 后每图 300 个)按集合比较,对不上的框 | 0 | 0 | 0 | 0 |
- 前三处新计算逐元素相同,说明 8.1--8.3 的理解与官方实现一致(包括多头、√d 缩放、偏置、门控 3×3 卷积后的特征这些论文没写的细节)。
- 重参数化前后的差别来自卷积与 einsum 的累加顺序不同(logits 的取值范围约 −40 到 2.5),属于浮点误差。S 有一张图里两个分数几乎相同的框(差 < 4e-6)换了先后顺序,按集合比较完全一致。
- 能用原始 W 把检测头折掉并得到同样的输出,也直接证明了 4.3 节表格最后一行:代码里检测头用的是原始 W,不是 I-Pooling 之后的 W′。
9. 动手验证(个人实验)
全部在 AutoDL 的一张 RTX 4080 SUPER(32GB)上完成:Python 3.10,PyTorch 2.0.1 + CUDA 11.8,mmcv 2.0.1、mmdet 3.0.0、mmengine 0.10.3、mmyolo 0.6.0(官方仓库的子模块),transformers 4.36.2,版本照官方 requirements/basic_requirements.txt。脚本、配置和结果(json)都在本库 Detection_Notes/repro/yoloworld/,入口和重跑方法见其中的 README.md。
权重是论文版(v1)的四个预训练模型,从 HF wondervictor/YOLO-World 下载,文件名末尾的 8 位 sha256 前缀都核对过(18bea4d2、2b7bd1be、0e566235、7a5eea3b);文本编码器 openai/clip-vit-base-patch32。LVIS minival 标注用 GLIP 在 HF 上发布的 lvis_v1_minival_inserted_image_name.json(官方评测用的同一份),COCO val2017 用 AutoDL 公共数据盘上的官方压缩包。没有训练的实验都不涉及随机性;DeepPCB 微调每组用随机种子 0--3 各跑一次(9.7 节)。
9.1 环境与官方代码的几个坑
- master 分支 import 不了 :最新提交
1f12bca("add mask",2025-02-26)在yolo_world/models/detectors/yolo_world.py里写了self.text_feats, None = self.backbone.forward_text(texts),Python 直接报 SyntaxError,import yolo_world都过不去;同一个提交里检测头loss()传给loss_by_feat的参数也错位了,训练也跑不了。本笔记固定在它前一个提交b1b09f2(2025-02-06),子模块 mmyolo 跟着这个提交走。 - LVIS 评测在最后一步崩 :PyPI 上的
lvis0.5.3 在LVISEval.accumulate()里用了np.float,numpy 1.24 以后删掉了这个别名。报错发生在所有匹配都算完之后:官方tools/test.py在 LVIS minival 上推理了 73 分钟,最后一步崩掉,什么也没留下。改法是把那两行的np.float换成np.float64(setup_env.sh里用 sed 改)。 - 装包 :新版 setuptools 去掉了
pkg_resources,PyTorch 2.0.1 的torch.utils.cpp_extension还要 import 它,装 mmyolo 时失败,要固定setuptools==69.5.1;YOLO-World 的pyproject.toml依赖mmcv-lite,会和带算子的mmcv冲突,要--no-deps;两个包的 setup 都要 import torch,要--no-build-isolation。 - 评测的后处理比模型慢几十倍 :官方 LVIS 评测设置是
score_thr=0.001、nms_pre=30000、多标签。1203 个类时候选框远超 mmcvbatched_nms的split_thr(默认 1 万),NMS 就按类别逐个循环,单独占用 GPU 时每张图也要 0.35--0.41 秒(9.4 节),是模型前向的 35--44 倍。四个模型并行在一张卡上评 LVIS minival,每个跑了 1 小时左右。
9.2 参数量复算(Table 2)
| 模型 | 总参数 | 其中 CLIP 文本编码器 | 去掉文本编码器 | Table 2 | 再折进 1203 类词表 | 同规模 YOLOv8 |
|---|---|---|---|---|---|---|
| S | 76,811,576 | 63,428,096 | 13,383,480 | 13M (77M) | 15,367,371 | 11,166,544 |
| M | 92,493,390 | 63,428,096 | 29,065,294 | 29M (92M) | 31,115,425 | 25,902,624 |
| L | 110,982,050 | 63,428,096 | 47,553,954 | 48M (110M) | 49,670,325 | 43,691,504 |
- 括号内外都对上了:括号里是含文本编码器的总参数,括号外是去掉文本编码器之后。
- 相比同规模 YOLOv8,YOLO-World 多了 2.2M(S)、3.2M(M)、3.9M(L)。其中 neck 里与文本直接相关的参数(
guide_fc、I-Pooling、注意力偏置)是 0.92M、1.09M、1.18M,其余来自 T-CSPLayer 多出的那一支卷积,以及分类分支最后输出 512 维嵌入(YOLOv8 只输出 80 个通道)。 - L 的构成:图像骨干 19.81M、neck 21.77M、检测头 5.98M。
- 把 1203 类的词表折进卷积后多出约 2M 参数,主要是检测头三层各一个 1203×512 的 1×1 卷积。
9.3 同一个模型,35.0 还是 32.5:LVIS 的两种 AP 口径(GPU)
论文 Table 2 的 YOLO-World-L(O365+GoldG)是 35.0 AP,同一配置在 Table 3 里是 32.5,官方模型库给同一个权重标的也是 32.5;S、M 在 Table 2 里是 26.2、31.0,模型库是 24.3、28.6。论文 4.2 节说 Table 2 报的是 Fixed AP(Dave et al. 2021)、每图最多 1000 个预测,而官方配置用的是 mmdet.LVISMetric,后者调用 LVIS API 的默认设置:每张图只保留分数最高的 300 个框。猜测两组数字的差别就在这里。
做法:四个模型都按官方配置推理 LVIS minival(4,809 张图),只把每图最多保留的框数从 300 改成 1000,存下全部检测结果(每个模型约 475 万个框),再用同一份结果按三种口径打分(infer_lvis.py、lvis_ap.py):
- 标准 AP:每图保留分数最高的 300 个,LVIS API 默认(官方配置就是这样);
- Fixed AP :照 Dave et al. 的
evaluate_ap_fixed.py,不限每图的个数,每个类别在整个数据集上最多 1 万个; - fixed300:每图先截到 300 个,再按 Fixed AP 的规则算,用来分开"每图上限"和"每类上限"两处差别。
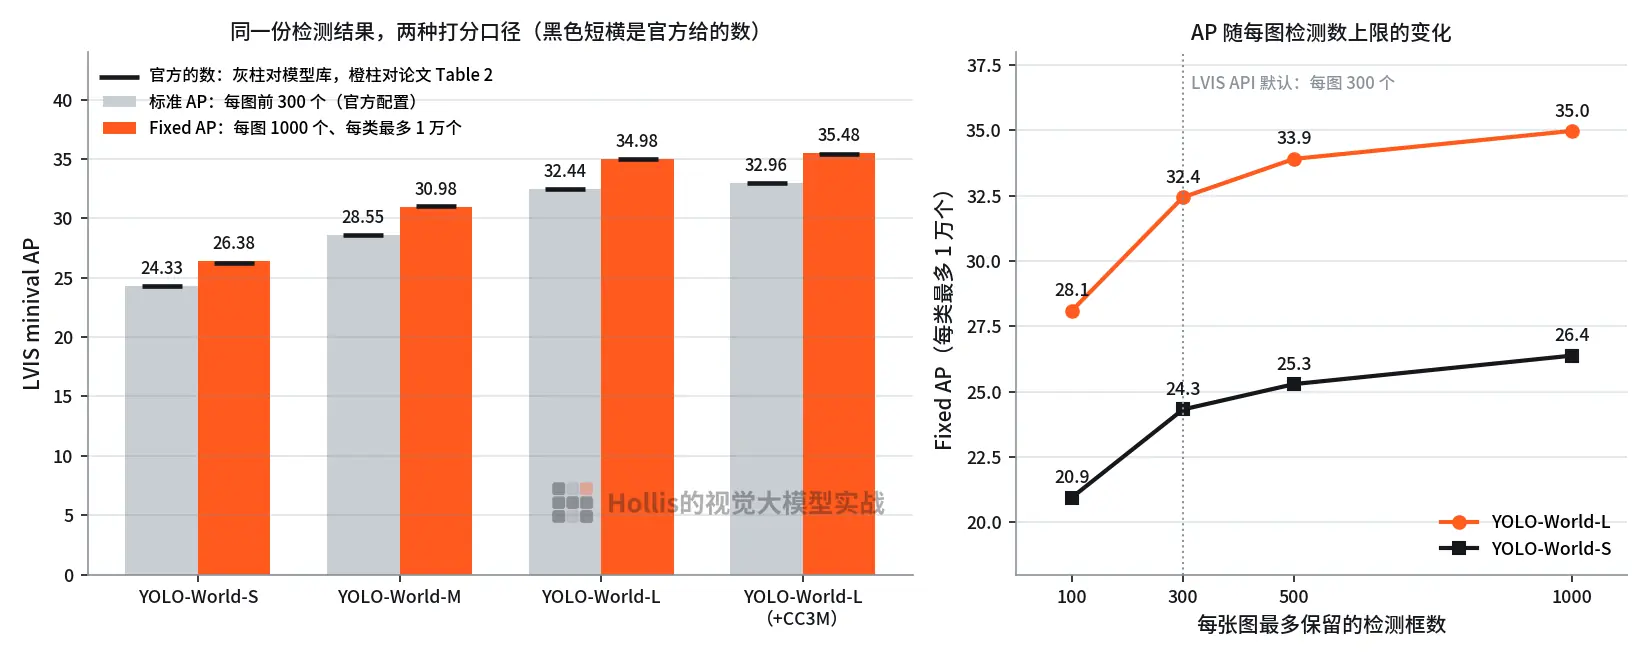
| 模型 | 标准 AP(每图 300) | 官方模型库 | fixed300 | Fixed AP(每图 1000) | 论文 Table 2 |
|---|---|---|---|---|---|
| S | 24.33 / 16.56 / 22.12 / 27.69 | 24.3 / 16.6 / 22.1 / 27.7 | 24.32 | 26.38 / 19.06 / 24.12 / 29.70 | 26.2 / 19.1 / 23.6 / 29.8 |
| M | 28.55 / 19.75 / 26.57 / 31.90 | 28.6 / 19.7 / 26.6 / 31.9 | 28.55 | 30.98 / 23.85 / 29.15 / 33.89 | 31.0 / 23.8 / 29.2 / 33.9 |
| L | 32.44 / 22.35 / 30.39 / 36.08 | 32.5 / 22.3 / 30.6 / 36.1 | 32.44 | 34.98 / 27.13 / 32.83 / 38.29 | 35.0 / 27.1 / 32.8 / 38.3 |
| L(+CC3M) | 32.96 / 23.59 / 32.01 / 35.48 | 33.0 / 23.6 / 32.0 / 35.5 | 32.96 | 35.48 / 27.64 / 34.21 / 38.02 | 35.4 / 27.6 / 34.1 / 38.0 |
(四个数依次是 AP / APr / APc / APf。官方模型库的数来自 configs/pretrain_v1/README.md。)
- 猜测成立 :同一份检测结果,按标准 AP 算就是模型库的数,按 Fixed AP 算就是 Table 2 的数。Fixed AP 与 Table 2 比:L 四项四舍五入后完全相同,M 每项差 0.05 以内,L(+CC3M)差 0.1 左右,S 的 AP、APc 高了 0.2、0.5(可能是论文用的权重或推理细节与公开版略有不同)。标准 AP 与模型库比:S、L(+CC3M)四项相同,M 差 0.05 以内,L 的 APc 低 0.2。为了确认这不是我的评测流程的问题,又用官方
tools/test.py和官方配置(每图 300 个、mmdet.LVISMetric)把 L 完整跑了一遍:32.4 / 22.3 / 30.4 / 36.1,与我的标准 AP 在官方输出的精度上完全一致,模型库的 30.6 应该来自别的评测环境。 - 差别全部来自"每图 300 个还是 1000 个":fixed300 与标准 AP 几乎相同,"每类最多 1 万个"这条在这里不起作用。右图是 Fixed AP 随每图上限的变化:L 从 100 个时的 28.1 涨到 1000 个时的 35.0,到 1000 还没饱和。
- 涨的主要是稀有类:从 300 到 1000,AP 涨 2.0--2.5,APr 涨 2.5--4.8(L:22.35 → 27.13)。1203 个类同时抢每张图 300 个名额,稀有类的正确检测分数偏低,最先被挤掉。这正是 Dave et al. 提出 Fixed AP 的理由:大词表下每图 300 个的上限会系统性地压低稀有类。
- 影响 :
- Table 2 与 Table 3、4、5、9 不是同一个口径,同一个模型差了约 2.5 AP,论文没有交代。消融表内部的相对比较不受影响,但不能拿 Table 2 的数和消融表比。
- 照官方配置复现得到 32.5 而不是 35.0,并不是复现失败。
- Table 2 里其他方法的数取自各自的论文,作者说是按前人的做法报 Fixed AP,但每图上限是否都是 1000 无从核对。
- 实际部署不会每张图留 1000 个框;Fixed AP 奖励的是低分的长尾检测,做应用时要看自己实际使用的阈值和每图上限下的结果。
9.4 推理速度:文本编码器、离线词表、重参数化(GPU)
bench_speed.py:batch 1,640×640(一张真实的 COCO 图),只计前向到检测头输出,不含 NMS;FP32 且关掉 TF32(与 V100 的 FP32 一致),每项预热 30 次、取 200 次的中位数,测速时 GPU 上没有别的任务。
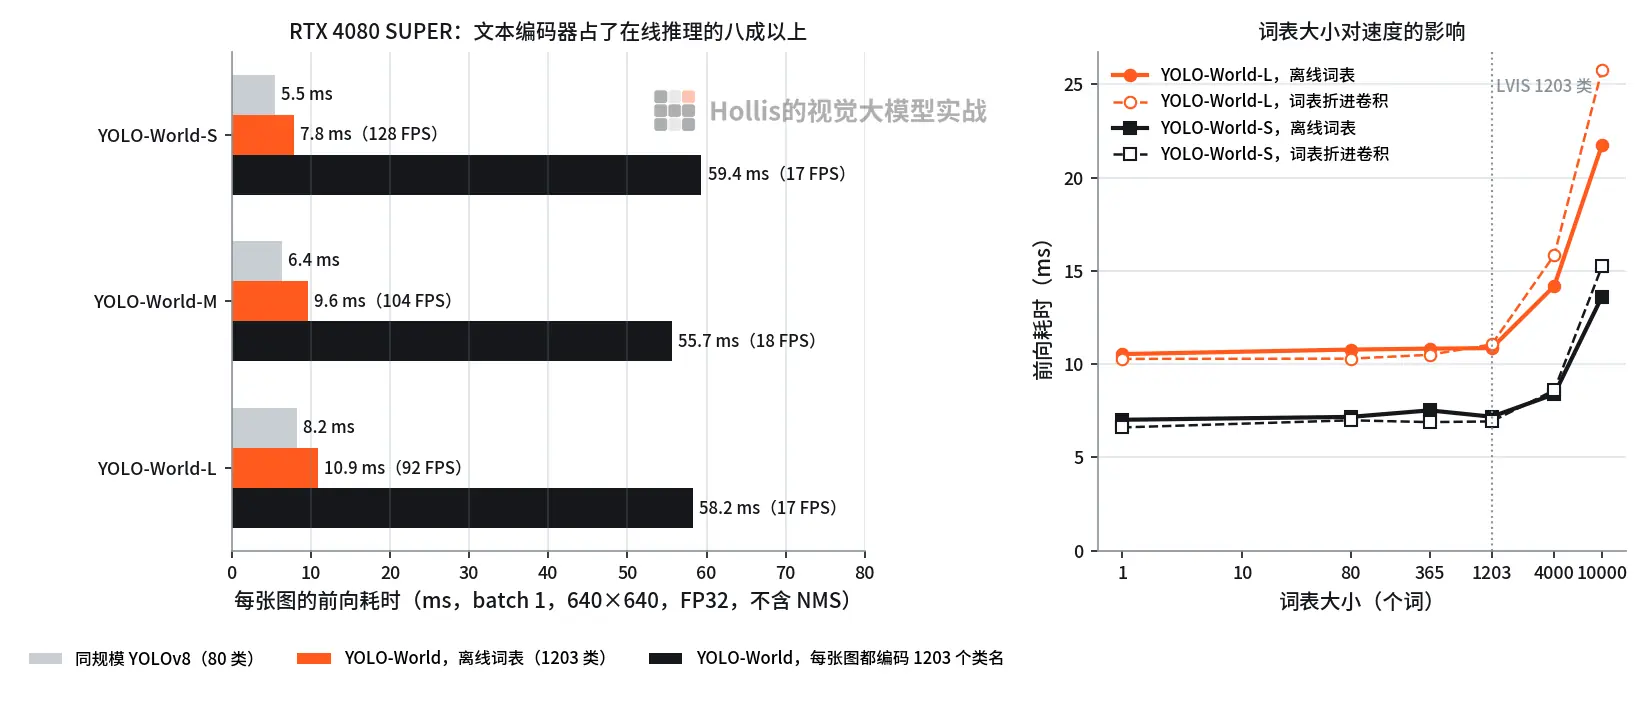
| S | M | L | |
|---|---|---|---|
| 论文(V100):重参数化 / 原始版本 | 74.1 / 19.9 FPS | 58.1 / 18.5 FPS | 52.0 / 17.6 FPS |
| 在线:每张图都编码 1203 个类名 | 59.4 ms(16.8 FPS) | 55.7 ms(18.0 FPS) | 58.2 ms(17.2 FPS) |
| 其中文本编码器(含分词) | 47.4 ms | 48.3 ms | 48.9 ms |
| 离线词表(1203 类) | 7.84 ms(127.6 FPS) | 9.63 ms(103.9 FPS) | 10.88 ms(91.9 FPS) |
| 再把词表折进卷积 | 7.52 ms(133.0 FPS) | 9.35 ms(107.0 FPS) | 10.91 ms(91.7 FPS) |
| 同规模 YOLOv8(80 类) | 5.48 ms(182.5 FPS) | 6.37 ms(157.0 FPS) | 8.24 ms(121.4 FPS) |
| 离线词表,FP16(autocast) | 10.71 ms | 12.68 ms | 14.10 ms |
| 后处理:官方 LVIS 评测设置 | 346 ms | 407 ms | 378 ms |
| 后处理:部署设置(score 0.25、NMS 前 1000、每图 100) | 1.43 ms | 1.28 ms | 1.30 ms |
- "原始版本"慢在文本编码器:在线跑法里文本编码器占 80%--87%,三档模型都是 17--18 FPS,与论文括号里的 19.9 / 18.5 / 17.6(V100)几乎一样:瓶颈不在检测器,换更快的 GPU 也没用。
- 离线词表是收益最大的一步:比在线快 5.3(L)到 7.6 倍(S)。4080 SUPER 上 S / M / L 分别 128 / 104 / 92 FPS,比论文 V100 上的 74 / 58 / 52 快。
- "折进卷积"本身在 PyTorch 里几乎不提速:词表 ≤1203 时最多快 4%(S),词表上到 4000、10000 反而更慢(L:15.8 对 14.2 ms、25.8 对 21.8 ms),因为每个头单独一个卷积再 stack,kernel 数变多了。重参数化的价值在部署:导出 ONNX、TensorRT 时网络里只剩卷积和逐元素运算,形状固定,不需要文本编码器。
- 开放词表的代价:同规模下离线词表的 YOLO-World 比 YOLOv8 慢 2.4--3.3 ms,速度是 YOLOv8 的 66%--76%。
- 词表大小:到 1203 个词,耗时几乎不变(L 10.5 → 10.9 ms,S 7.0 → 7.2 ms):batch 1 时这几个模型受 kernel 启动开销限制,算力没用满;4000 个词 14.2 ms、1 万个 21.8 ms(L)。
- FP16 在 batch 1 时更慢:autocast 要插入大量类型转换 kernel,YOLOv8 也一样(L:10.2 对 8.2 ms)。小模型在消费级卡上要靠 TensorRT 或 CUDA Graph 才能把 FP16 的好处拿出来。
- 后处理:官方评测设置下 1203 类的后处理每张图 0.35--0.41 秒,是前向的 35--44 倍;部署常用设置只要 1.3--1.4 ms。论文没有说 FPS 是否含后处理,从数字看应该不含。
9.5 COCO 零样本,以及离线词表怎么定(GPU)
eval_coco_vocab.py:COCO val2017 全部 5,000 张,后处理用官方 YOLOv8 的 COCO 设置(score_thr 0.001、nms_pre 30000、IoU 0.7、每图 300 个),pycocotools 打分。为了让 1000 多个词的跑法不至于每张图 1 秒,所有跑法统一调大了 mmcv NMS 的 split_thr(按类别加坐标偏移、一次做完,结果等价);用默认 NMS 重跑 L(+CC3M)的 80 类词表,AP 同样是 45.13,两种做法没有差别。
先看能否复现 Table 6 的零样本一栏:
| 模型 | 实测 AP / AP50 / AP75 | 论文 Table 6 |
|---|---|---|
| S | 37.28 / 51.90 / 40.54 | 37.6 / 52.3 / 40.7 |
| M | 41.88 / 56.98 / 45.51 | 42.8 / 58.3 / 46.4 |
| L | 45.21 / 60.91 / 49.23 | 44.4 / 59.8 / 48.3 |
| L(+CC3M) | 45.13 / 60.75 / 48.95 | 45.1 / 60.7 / 48.9 |
L(+CC3M)完全复现;S、M 低 0.3、0.9,L(O365+GoldG)反而高 0.8,与 L(+CC3M)几乎一样。同一批权重在 LVIS 上与论文吻合(9.3 节),在 COCO 上有 ±1 AP 的出入,原因不明,可能 Table 6 的零样本一栏用的权重或设置与公开版不同。COCO 的打分(pycocotools,每图每类最多 100 个)没有 LVIS 那样的口径问题。
同一个模型(L + CC3M),只改离线词表:
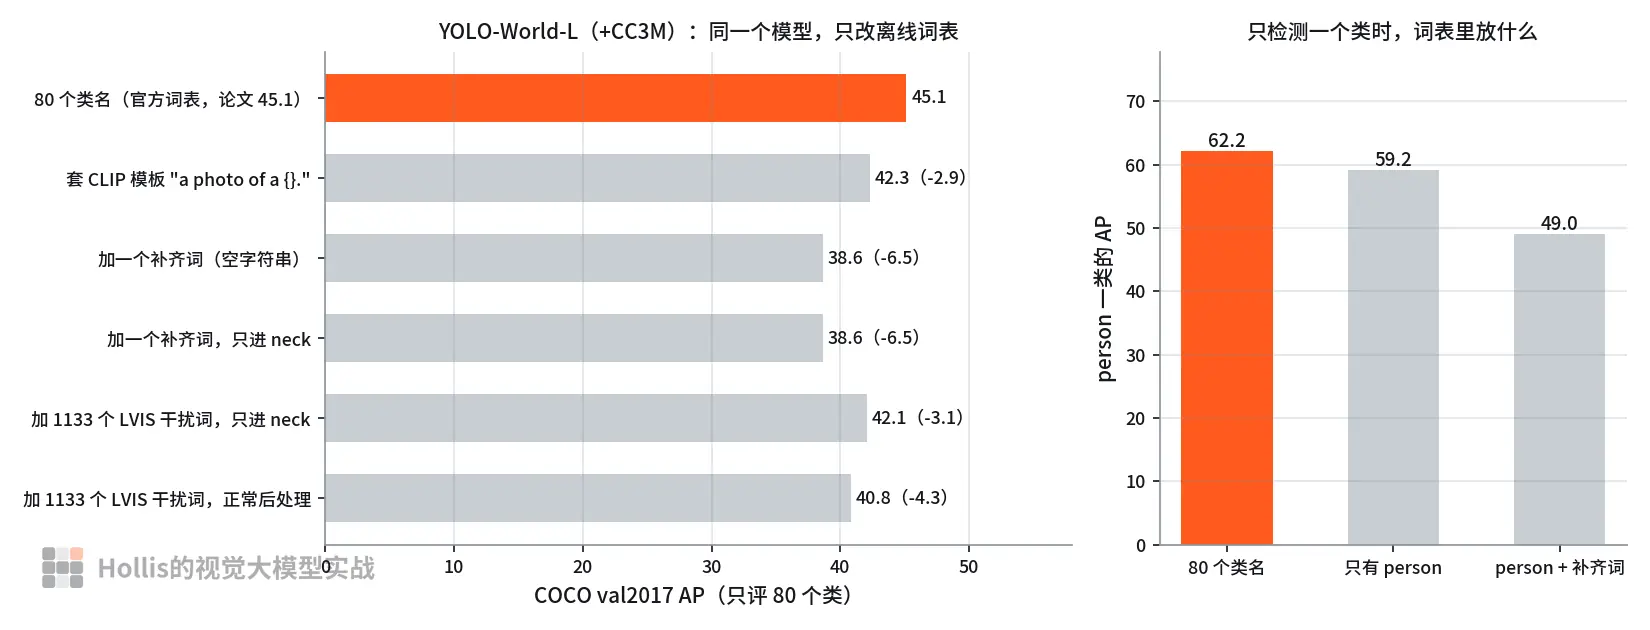
| 离线词表 | COCO AP | 变化 |
|---|---|---|
80 个类名(官方 coco_class_texts.json) |
45.13 | -- |
| 套 CLIP 常用模板 "a photo of a {}." | 42.28 | −2.85 |
| 末尾加一个补齐词('' 或 ' ':CLIP 分词器会去掉空格,两者是同一个嵌入) | 38.64 | −6.49 |
| 同上,但补齐词只进 neck,检测头只给 80 个类打分 | 38.64 | −6.49 |
| 加 1133 个与 COCO 不同名的 LVIS 类名作干扰词,只进 neck | 42.06 | −3.07 |
| 同上,正常后处理(干扰词也参与每图 300 个名额的竞争) | 40.82 | −4.31 |
(干扰词:LVIS 1203 类里,同义词与任何一个 COCO 类名都不相同的 1133 个;评测只算 80 个 COCO 类上的检测。)
| 只检测 person 时的词表 | person 的 AP |
|---|---|
| 80 个类名(照常检测,只看 person 一类) | 62.21 |
| 只有 "person" | 59.20 |
| "person" + 补齐词 | 49.05 |
- 词与词并不独立:检测头对每个词单独做 sigmoid,看起来词表里多一个词、少一个词互不影响;但 neck 里的 max-sigmoid 对整个词表取最大,词表一变,所有位置的特征都跟着变。"只进 neck"的两行把这部分单独拿了出来:干扰词的 −4.3 AP 里有 −3.1 来自 neck,剩下 −1.2 才是抢名额;补齐词的 −6.5 则全部来自 neck。
- 补齐词:v1 的 L(+CC3M)加一个补齐词掉 6.5 AP,80 类里 75 类变差(donut −24.9、sheep −20.4);L(O365+GoldG)从 45.21 掉到 38.51,S 从 37.28 掉到 31.54。官方 V2.1 博客说之前的版本推理时"通常要加一个补齐词",至少对论文版 v1 权重、在 COCO 上,加了明显更差。补齐词在训练中只当负样本、出现在 grounding 数据补齐的位置,推理时加进去相当于把 neck 的门控整体打开(9.7 节 DeepPCB 上,加补齐词后每张图分数高于 0.001 的框从几个到几十个变成两百多个)。
- 干扰词(大词表):把词表开到 1213 个,COCO 80 类的 AP 掉 4.3,69 类变差(bear −16.8、donut −13.2)。"词表开大一点、什么都检"是有代价的。
- 只放一个词也不是最好:只检测 person 时,单独一个 "person" 的 AP(59.2)比放着 80 个类名时 person 一类的 AP(62.2)低 3.0。其他类名在 neck 里起了负样本的作用,帮模型把狗、熊这些不是人的东西排除掉。实际用的时候,词表 = 要检测的类别 + 场景里常见、容易混淆的其他物体(这些类别的检测结果丢掉)。
- 模板 :训练时类名不加任何模板(
prompt_format='{}'),推理时套 CLIP 的 "a photo of a {}." 掉 2.9 AP。提示词的写法要和训练时一致。
9.6 I-Pooling Attention 把文本嵌入改了多少
parity_core.py 对拍时顺带统计了 I-Pooling 前后的文本嵌入(4 张 COCO 图,LVIS 1203 类):
| S | M | L | L(+CC3M) | |
|---|---|---|---|---|
| W′ 与 W 的余弦相似度:平均 / 最小 | 0.15 / 0.01 | 0.13 / −0.00 | 0.18 / 0.04 | 0.12 / −0.08 |
| 更新量的范数 ÷ W 的范数 | 3.9 | 4.5 | 4.7 | 3.9 |
| 词表里两两之间的平均余弦相似度: W | 0.738 | 0.738 | 0.738 | 0.738 |
| 同上: W′(4 张图) | 0.54--0.56 | 0.52--0.55 | 0.84--0.91 | 0.68--0.77 |
| 同一个词在两张图上的 W′ 的余弦相似度 | 0.50--0.92 | 0.61--0.96 | 0.61--0.97 | 0.54--0.97 |
- I-Pooling 不是在原嵌入上做小修正:加上去的量是原嵌入的 4--5 倍, W′ 与 W 几乎正交,主要由图像决定,同一个词换一张图, W′ 的相似度可以低到 0.5。
- L 的 1203 个 W′ 彼此更像了(0.84--0.91,原来 0.738):送进自底向上 T-CSPLayer 的"文本"已经不太区分是哪个词,更像一个按图像生成的门控信号。S、M 则相反,变得更分散。
- 个人推测:这能解释 Table 4 里 I-Pooling 只贡献 0.3 AP,以及 v2 去掉它之后精度没掉(v2 同时把 L2 归一化换成了 BN,模型库里 v2-L 比 v1-L 还高 0.5 AP)。需要训练层面的消融才能确认,这里只是现象。
- 检测头用的是原始 W(8.5 节),所以 Fig. 3 画的"图像感知嵌入送进检测头"在 v1 代码里并不存在。
9.7 工业缺陷:DeepPCB 上的零样本与微调(GPU)
论文说预训练好的 YOLO-World 能"很容易地迁移到下游任务",Table 6、7 也显示预训练对 COCO、LVIS 的微调有帮助。做工业质检更关心两件事:缺陷能不能零样本检出来;用 YOLO-World 的预训练权重做起点,微调是否比常用的 YOLOv8(COCO 预训练)更好、更省数据。
数据:DeepPCB(github.com/tangsanli5201/DeepPCB,README 写明仅限研究用途)。线扫 CCD 拍的 PCB,二值化后裁成 640×640,每张 3--12 个缺陷(大多是按缺陷样式人工加上去的),6 类:open(断路)、short(短路)、mousebite(鼠咬)、spur(毛刺)、spurious copper(多余铜)、pin-hole(针孔)。官方划分训练 1,000 张(6,873 个框)、测试 500 张(3,140 个框);另从训练集按固定种子抽 100 张(709 个框)作小数据设定。只用待测图,不用模板图。
做法:
- 零样本 (
eval_deeppcb_zeroshot.py):四个预训练模型,三套词表:官方简写(open、short、mousebite、spur、copper、pin-hole),描述性写法(open circuit、short circuit、mouse bite、spur、spurious copper、pin hole),描述性写法 + 补齐词。 - 微调 (
run_deeppcb.sh,两个配置在configs/):- YOLO-World-L(+CC3M)照官方 COCO 微调配置:保留 RepVL-PAN,AdamW 2e-4、wd 0.05,文本编码器冻结,词表用描述性写法;
- 对照组 YOLOv8-L 用 mmyolo 的 COCO 预训练权重(52.1 AP),分类层换成 6 类、随机初始化;
- 两边的数据增强(mosaic、mixup、仿射、albu、HSV、翻转)、batch 16、优化器、EMA、轮数都相同:全量 40 轮,10% 子集 200 轮,最后 1/8 的轮数关掉 mosaic;都开 AMP;
- 测试集上用 COCO 的 AP 评测(DeepPCB 官方脚本是 IoU 0.33 下的 mAP,这里另报 AP50 作参考);每组用随机种子 0、1、2、3 各跑一次。
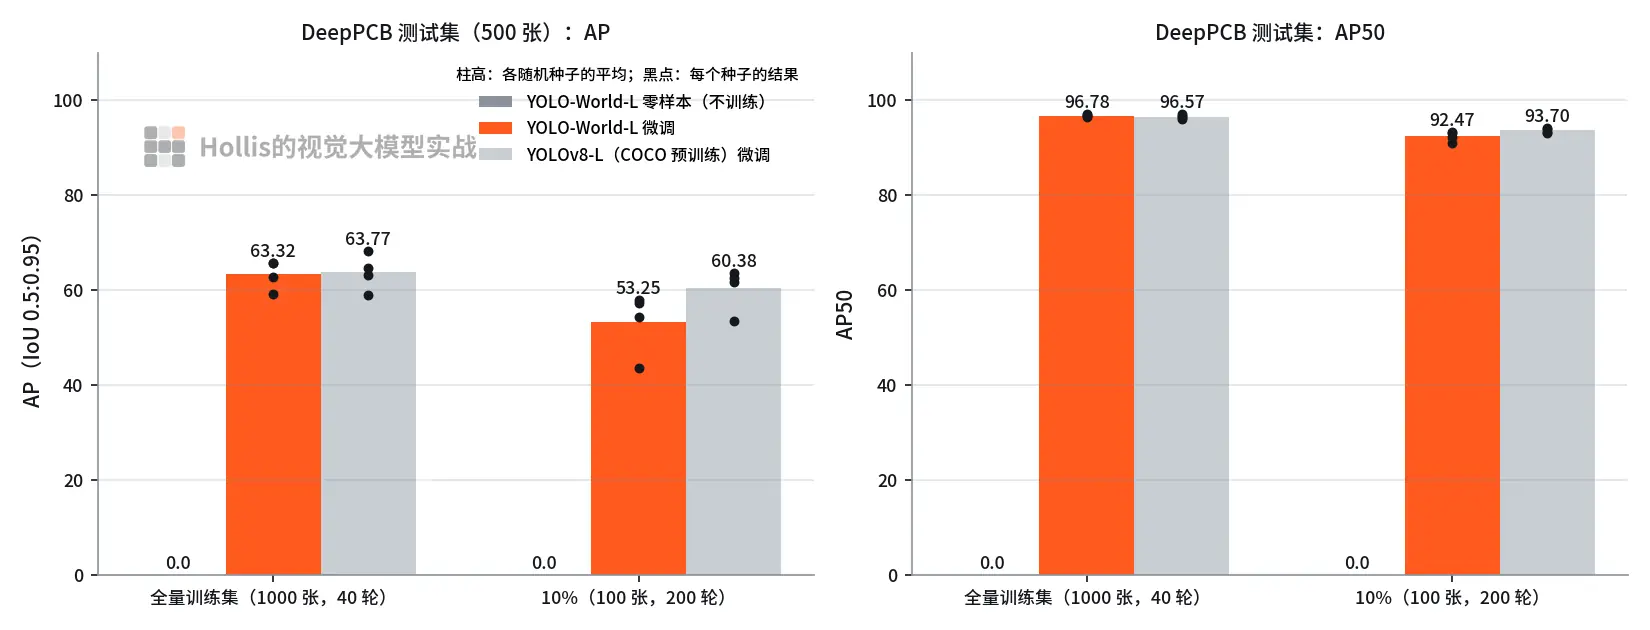
| 全量(1000 张,40 轮) | 10%(100 张,200 轮) | |
|---|---|---|
| YOLO-World-L 零样本(四个模型、三套词表里最好的) | AP 0.19,AP50 0.39 | 同左 |
| YOLO-World-L 微调:AP | 63.32 ± 3.16(65.8 / 65.7 / 62.7 / 59.1) | 53.25 ± 6.69(57.2 / 54.3 / 58.0 / 43.5) |
| YOLOv8-L 微调:AP | 63.77 ± 3.88(68.3 / 64.6 / 63.3 / 58.9) | 60.38 ± 4.65(62.5 / 63.7 / 61.8 / 53.5) |
| YOLO-World-L 微调:AP50 / AP75 | 96.78 / 75.30 | 92.47 / 52.88 |
| YOLOv8-L 微调:AP50 / AP75 | 96.57 / 76.28 | 93.70 / 69.12 |
(± 后是 4 个种子的样本标准差,括号里依次是种子 0--3;AP50、AP75 是 4 个种子的平均。)
各类别的 AP(4 个种子的平均):
| 类别 | YOLO-World-L 全量 | YOLOv8-L 全量 | YOLO-World-L 10% | YOLOv8-L 10% |
|---|---|---|---|---|
| open | 58.6 | 58.5 | 47.5 | 53.8 |
| short | 56.1 | 55.9 | 44.2 | 49.3 |
| mousebite | 62.6 | 63.1 | 50.2 | 58.2 |
| spur | 62.1 | 63.1 | 49.6 | 57.4 |
| spurious copper | 74.1 | 75.2 | 70.1 | 75.0 |
| pin-hole | 66.4 | 66.9 | 57.9 | 68.7 |
- 零样本完全不行:四个模型、三套词表,AP 都在 0.2 以下,AP50 不到 0.4。断路、毛刺、铜渣这些二值图上的局部图案不是自然图像里的"物体",CLIP 的文本空间里也没有对应的视觉概念;不加补齐词时,每张图分数高于 0.001 的框只有 3--66 个,加了补齐词变成 200 多个,但几乎都是错的。
- 全量数据时打平:4 个种子的平均 63.3 对 63.8;按同一个种子配对,YOLO-World 减 YOLOv8 是 −2.5、+1.1、−0.6、+0.2,有正有负;各类别的平均差都在 1.1 AP 以内。开放词表预训练在这里既没有帮上忙,也没有拖后腿。
- 10% 数据时 YOLOv8 更好 :平均 60.4 对 53.3,4 个种子上 YOLOv8 都领先(3.8--10.0 AP),6 个类别也全部领先,差得最多的是 pin-hole(+10.8)、mousebite(+8.0)、spur(+7.8)。与"预训练让微调更省数据"的直觉相反。个人推测:
- YOLO-World 多出来的 RepVL-PAN 要适应一个与预训练完全不同的领域(二值化的 PCB 图),小数据下更难;
- 分类由 "mouse bite"、"spur" 这类词的文本嵌入决定,这些嵌入与缺陷的外观毫无关系,相当于一个没有意义、却又固定住的分类方向,YOLOv8 随机初始化的分类层反而没有这个包袱;
- 微调配方是 YOLO-World 官方的(AdamW 2e-4),对两边都没调参,结论限于这个配方。
- 差别都在定位:AP50 两者接近(全量 96.8 对 96.6,10% 92.5 对 93.7),模型之间的差距、种子之间的波动都集中在 AP75(10%:52.9 对 69.1)。缺陷这类小目标要求框很准。
- 随机种子的影响比模型还大:同一个配方只换种子,全量时 YOLO-World 在 59.1--65.8、YOLOv8 在 58.9--68.3 之间,10% 时 YOLO-World 在 43.5--58.0、YOLOv8 在 53.5--63.7 之间;种子 3 对两个模型都是最差的(种子决定数据顺序和随机增强),说明波动来自训练过程本身。只跑一次就比较两个模型,很容易得出相反的结论:只看种子 0,全量时 YOLOv8 高 2.5 AP;只看种子 1,YOLO-World 高 1.1 AP。本节最初只跑了种子 0,得出过"YOLOv8 全量高 2.5 AP"的错误结论,补到 4 个种子才看清。
- 训练更慢:同样两组一起占一张卡时(种子 2、3),YOLO-World-L 的训练时间是 YOLOv8-L 的 1.2--1.4 倍(多了文本编码器和 RepVL-PAN)。
结论:工业缺陷检测不要指望 YOLO-World 的零样本;数据充足时它和 YOLOv8 打平,数据很少时反而更差,训练还更慢,不是比 YOLOv8 更好的微调起点。它的用处在别处:工厂里通用物体(人、车、工具、托盘、安全帽......)的零样本检测与预标注。另外,在小数据集上比较两个模型,至少要跑几个随机种子。
10. 讨论与个人思考
10.1 亮点
- 改动小、思路干净:分类层换成"物体嵌入与文本嵌入的缩放余弦相似度",neck 里加两个轻量的融合模块,标签分配和损失全部沿用 YOLOv8。开放词表的能力主要来自大规模区域-文本预训练,而不是复杂的结构,YOLOv8 的训练、部署工具链几乎都能复用。
- prompt-then-detect 抓住了真正的瓶颈:在线编码 1203 个类名时,文本编码器占推理时间的 80%--87%;词表离线编码后,S / M / L 回到同规模 YOLOv8 速度的 66%--76%(9.4 节)。这一点对工程的意义比结构创新更大。
- 小模型也能做视觉-语言预训练:13M 参数的 S 在 LVIS 上有 26.2 Fixed AP,与 232M 参数的 GLIP-T 相当;附录 C 还给出了"小模型重标注质量、伪标注加多了反而掉点"的数据。
- 伪标注流程实用:GLIP 打框 + CLIP 复核 + 阈值过滤,全自动,可以直接拿来给自己的数据做预标注。
- 开源完整,主要结果能复现:训练、评测、ONNX 导出、重参数化微调、图像提示都有代码和权重;按官方配置实测,L(+CC3M)的 COCO 零样本 45.13(论文 45.1),L 的 LVIS Fixed AP 34.98(论文 35.0)。
10.2 局限与疑问
- 评测口径没交代:Table 2 用 Fixed AP(每图 1000 个),消融表和官方模型库用 LVIS API 默认的每图 300 个,同一个模型差约 2.5 AP,论文只字未提(9.3 节)。
- 论文与代码多处对不上:Eq. 2 省略了多头、投影、缩放、偏置和门控前的 3×3 卷积;Fig. 3、4 画的第二个 I-Pooling 和"图像感知嵌入进检测头"在 v1 代码里都没有;附录 Eq. 6 写错;正文"稀有类 +10.1 AP"与 Table 5 算出来的 11.1 不符;weight decay 论文写 0.05,按代码推算是 0.2(4.3、5.1、5.3 节)。
- 消融不完整:T→I、I→T 只在 O365 设置下拆开(+0.8 / +0.3 AP);I-Pooling 在 v2 里被去掉,实测它几乎把文本嵌入换成了图像信息(9.6 节)。
- 离线词表的行为没有讲:训练时用空字符串补齐词表、不加掩码;推理时词与词并不独立(max-sigmoid 对整个词表取最大),加一个补齐词、加一堆干扰词、只留一个词都会明显掉点(9.5 节)。论文对"词表怎么定"没有任何指导。
- 离开自然图像就不行:DeepPCB 这种二值化的工业图像上零样本 AP 接近 0(9.7 节)。论文的零样本只在 LVIS 和 COCO 上测(两者是同一批 COCO 图),没有 ODinW 这类跨领域的基准。
- FPS 的测法没说清:是否含后处理、预处理,batch 多大;Table 6 又换成 TensorRT,与 Table 2 不可比。
- 指代检测只有可视化:Fig. 7 的例子没有 RefCOCO 之类的定量结果。
- 复现上的小出入:COCO 零样本 S、M 比 Table 6 低 0.3、0.9,L(O365+GoldG)高 0.8(9.5 节);同一批权重在 LVIS 上却与论文吻合,原因不明。
10.3 后续演进
- 官方 v2 / v2.1(第 7 节):去掉 I-Pooling,L2 归一化换 BN,重参数化微调,补齐词在损失里加掩码,重做伪标注,图像提示。
- YOLOE(2025):同样基于 YOLO,文本提示做成可重参数化的轻量适配,另加视觉提示和无提示模式,推理时可以折回普通 YOLO 的结构。
- Grounding DINO 1.5 Edge(2024):Grounding DINO 一系面向边缘设备的轻量版,路线仍是图文深度融合。
- Ultralytics 集成了 YOLO-World(
yolov8s-world、yolov8s-worldv2等),用set_classes设好离线词表再导出,就是 prompt-then-detect 的用法。
10.4 可借鉴之处
- 给检测器加开放词表的最小改动:分类层换成与文本嵌入的相似度,或者用类名的文本嵌入初始化分类层。
- "配置一次、推理很多次"的输入都可以预计算:离线词表、重参数化的思路适用于任何条件输入(提示词、模板、参考图)。
- 评测要写明口径:大词表下 AP 对"每图保留多少个框"非常敏感(同一份结果,每图 100 个和 1000 个差约 7 AP),对比别人的数字之前先查清 AP 的定义和 maxDets。
- 伪标注流程:开放词表检测器打框 + CLIP 复核 + 阈值,可以给工业数据做预标注,再人工核对。
- 对视觉方向:开放词表检测器最适合做"通用物体"的零样本预标注和数据检索(在大量无标注图片里找出含某种物体的图),缺陷这类领域专属的目标还是要靠标注数据(9.7 节)。
11. 落地视角
11.1 选型与速度
- 词表固定、类别不多:按论文附录 A.2 的做法,去掉 RepVL-PAN、把类名的文本嵌入存进分类层,再在自己的数据上微调,结构就是一个 YOLOv8,速度与 YOLOv8 相同;或者保留 RepVL-PAN,用离线词表。
- 运行时要随时换词(开放检索、交互式标注):离线词表 + 换词时重新编码一次(1203 个词约 48 ms,几十个词更快),不要每张图都跑文本编码器。
- 速度参考:4080 SUPER 上离线词表的 S / M / L 分别 128 / 104 / 92 FPS(FP32、batch 1、不含 NMS),是同规模 YOLOv8 的 66%--76%(9.4 节)。
- 后处理 :评测用的设置(
score_thr0.001、nms_pre30000)不能拿去部署,1203 类时每张图 0.35--0.41 秒;换成正常的阈值和每图上限只要 1.3 ms 左右。
11.2 离线词表怎么定(9.5 节)
- 写法与训练一致:裸类名,不套 "a photo of a {}." 这类模板(−2.9 AP)。
- v1 权重不要随手加补齐词(COCO 上 −6.5 AP)。官方对 v2、v2.1 的建议不同,换版本要重新验证。
- 词表不要开得过大:多出 1133 个干扰词,COCO 80 类掉 4.3 AP。
- 也不要只放一个词:把场景里常见、容易混淆的物体也写进词表,当作负类、结果丢掉;只检测 person 时这样做能多 3 AP。
- 换词表要回归测试:词与词通过 neck 相互影响,加减一个词可能让别的类别变好或变坏十几甚至二十几个点(加补齐词时 donut −24.9、oven +19.0)。
11.3 部署
- 优先用官方 v2 的权重导出:v2 去掉了随图像变化的 I-Pooling,对比头的 L2 归一化换成了 BN,词表能完全折进卷积,导出 ONNX、TensorRT 都更顺。v1 的 I-Pooling 和自底向上的 T-CSPLayer 折不掉(8.4 节)。
- 在 PyTorch 里"折进卷积"本身几乎不提速,词表很大时还更慢(9.4 节);它的价值在导出后的静态图。
- batch 1 时 FP16 用 autocast 反而更慢(9.4 节);FP16、INT8 的收益要靠 TensorRT 之类的推理引擎。
- 词表到 1203 个对速度几乎没影响,到几千才明显变慢。
11.4 工业质检能不能用(9.7 节)
- 零样本检缺陷不行:DeepPCB 上四个模型、三套词表的 AP 都在 0.2 以下。缺陷名字当词表,模型根本不认识这些"东西"。
- 微调也不占优:1000 张时与 YOLOv8-L 打平(4 个种子平均 63.3 对 63.8),100 张时反而低 7 AP,训练还慢 1.2--1.4 倍。缺陷检测直接用 YOLOv8 这类闭集检测器更划算。
- 小数据上比较模型要多跑几个种子:同一个模型、同一个配方只换随机种子,1000 张时 AP 最多差 9.4 个点(YOLOv8),100 张时最多差 14.5 个点(YOLO-World),只跑一次的对比结论可能完全反过来(9.7 节)。
- 更合适的用法 :
- 工厂里通用物体(人、车辆、叉车、托盘、工具、安全帽、手套......)的零样本检测,用来做安全巡检、物料清点的原型;
- 在大量没标注的图片里按文字找图("有叉车的图"),挑数据;
- 给闭集模型做预标注:先用 YOLO-World 出框,人工核对后再训练,思路和论文的伪标注流程一样。
- 词表:照 11.2 节,写场景里实际会出现的物体,同时把容易混淆的物体也写进去当负类。
11.5 许可
- 官方代码和 HF 上的权重都是 GPL-3.0(
pyproject.toml写的 Apache 2.0 与 LICENSE 文件不一致,以 LICENSE 和模型卡为准)。GPL 要求分发的衍生作品同样开源,闭源商用前要评估清楚。Ultralytics 的实现是 AGPL-3.0,另有商业授权。以上是个人理解,不是法律意见。
12. 面试高频问题
- YOLO-World 相对 YOLOv8 改了什么? 分类分支不再输出固定的 80 个通道,而是输出 512 维物体嵌入,与 CLIP 文本嵌入算缩放余弦相似度(Eq. 1);neck 换成 RepVL-PAN(T-CSPLayer 做文本→图像、I-Pooling Attention 做图像→文本);预训练数据从检测扩展到 grounding 和伪标注的图文数据。标签分配(TAL)和损失(sigmoid BCE + CIoU + DFL)都是 YOLOv8 原样(4.2--4.4 节)。
- 什么是 prompt-then-detect?为什么快? 用户的词表事先用文本编码器编码一次,推理时只跑图像部分。实测在线编码 1203 个类名时,文本编码器占推理时间的 80%--87%,三档模型都只有 17--18 FPS;离线词表后 S / M / L 是 128 / 104 / 92 FPS(RTX 4080 SUPER,9.4 节)。
- 重参数化具体怎么做?哪些能折、哪些折不掉? 检测头: α⋅w/∣w∣ 作为 1×1 卷积的权重、 β 作为偏置,前面保留对物体嵌入的 L2 归一化;自顶向下的 T-CSPLayer: guide_fc(W) 按头拆成 1×1 卷积。I-Pooling 和用 W′ 的自底向上 T-CSPLayer 随图像变,折不掉(8.4 节)。在 PyTorch 里折叠本身几乎不提速,价值在导出部署。
- max-sigmoid 注意力是什么?为什么用 max? 每个位置与词表里所有词的相似度取最大,过 sigmoid 后当空间门控,乘到 3×3 卷积后的特征上。用 max 只关心"像不像词表里的某个东西",计算量随词表大小线性增长(8.2 节)。
- 训练时的词表怎么构造? 每个 mosaic 样本:其中出现的所有正名词,加上随机采的负名词,最多 80 个;不足的用空字符串补齐。官方 v2.1 博客说补齐项不加掩码反而高 2--3 LVIS AP,副作用是推理时通常要加一个补齐词(7 节)。
- "区域-文本对比损失"是在词表上做 softmax 吗? 不是。代码里是每个词独立的 sigmoid 二分类交叉熵,目标是 TAL 给的软分数,和 YOLOv8 的分类损失完全一样,只是 logits 换成了与文本嵌入的相似度(4.4 节)。
- 为什么冻结文本编码器? Table 5:在只有 365 类的 O365 上微调 CLIP,AP 掉 3.1、APr 掉 5.9,单一的词表会破坏 CLIP 的泛化;BERT 本身不对齐视觉,微调反而有用(+3.7 AP),但远不如冻结的 CLIP。
- 图文数据(CC3M)怎么用? n-gram 抽名词 → GLIP-L 打伪框 → CLIP 重打分、按名词 NMS、阈值过滤,得到 246k 张图、821k 个框;图文样本只算分类损失( λI=0)。附录 C:对小模型,伪标注加多了反而掉点,人工标注的 GoldG 更有用(5.7 节)。
- 论文 Table 2 的 35.0 和 Table 3、官方模型库的 32.5 为什么不一样? 评测口径不同:Table 2 是 Fixed AP(每图 1000 个、每类最多 1 万个),消融表和模型库是 LVIS API 默认的每图 300 个。同一份检测结果两种算法差约 2.5 AP,差别几乎全在稀有类:1203 个类抢 300 个名额,分数低的稀有类先被挤掉(9.3 节)。
- LVIS 的 APr / APc / APf、federated 标注是什么? 按类别在训练集里出现的图片数分:稀有 1--10 张、常见 11--100 张、频繁 100 张以上。LVIS 每张图只确认了部分类别"有"或"没有",没确认过的类别上的检测不算错,这样才能用 1203 个类评测而不要求每张图标全。
- YOLO-World 与 GLIP、Grounding DINO 的区别? 后两者把图像和文本深度融合(每层交叉注意力),文本每次都要和图像一起编码,骨干是 Swin;YOLO-World 只在 neck 里做两处轻量融合,词表离线编码,骨干是 YOLOv8。同为 O365 + GoldG 预训练,YOLO-World-L 的 LVIS minival 高约 10 AP,速度快 20 倍以上(5.2 节)。
- 部署 YOLO-World 要注意什么? 用离线词表,别每张图跑文本编码器;评测用的后处理设置(
score_thr0.001、nms_pre30000、1203 类)每张图要 0.35--0.41 秒,部署要换成正常阈值;batch 1 时 FP16(autocast)反而比 FP32 慢,要靠 TensorRT 之类的工具;官方 v2 去掉 I-Pooling、把 L2 归一化换成 BN 都是为了导出部署(7、9.4 节)。 - 离线词表里多一个词、少一个词,会影响别的类吗? 会。检测头对每个词单独打分,但 neck 里的 max-sigmoid 对整个词表取最大,词表一变所有位置的特征都变。实测 COCO 上加一个空字符串补齐词掉 6.5 AP,加 1133 个干扰词掉 4.3 AP,只检测 person 时只放一个词比放 80 个类名低 3 AP(9.5 节)。
- YOLO-World 能直接用在工业缺陷检测上吗? 零样本不行(DeepPCB 上 AP 接近 0);微调时数据充足与 YOLOv8 打平,数据少时还更差(100 张:53.3 对 60.4,4 个种子平均)。它更适合工厂里通用物体的零样本检测和预标注(9.7、11.4 节)。
13. 关键术语速查
| 术语 | 含义 |
|---|---|
| 开放词表检测(OVD) | 检测类别由文本指定,可以超出训练时的类别 |
| 零样本迁移 | 不在目标数据集上训练,直接评测 |
| 区域-文本对 | 一个框和它对应的文本(类名、名词短语或描述) |
| 在线 / 离线词表 | 每张图都编码一遍文本 / 事先编码一次反复使用 |
| prompt-then-detect | 先把用户的提示编码成离线词表,再做检测 |
| 重参数化 | 把训练时的结构等价变换成推理更快的结构;这里指把文本嵌入折进卷积权重 |
| RepVL-PAN | 可重参数化的视觉-语言路径聚合网络,YOLO-World 的 neck |
| T-CSPLayer | 加了 max-sigmoid 文本门控的 C2f |
| max-sigmoid 注意力 | 每个位置对词表取最大相似度、过 sigmoid 后当空间门控 |
| I-Pooling Attention | 用三层特征池化出的 27 个 token 更新文本嵌入的多头注意力 |
| C2f | YOLOv8 的 CSP 模块(CSPLayerWithTwoConv) |
| TAL | task-aligned label assignment:按分类分数与 IoU 的组合挑正样本 |
| DFL | distribution focal loss:把框的每条边当离散分布来回归 |
| GoldG | GQA + Flickr30k 的 grounding 数据(MDETR 整理,去掉了 COCO 的图) |
| CC3M† / CC3M-Lite | 论文从 Conceptual Captions 3M 里伪标注的 246k 张图 |
| LVIS minival | MDETR 从 LVIS v1 val 划出的子集,4,809 张图,全部来自 COCO val2017 |
| APr / APc / APf | LVIS 稀有 / 常见 / 频繁类别上的 AP |
| Fixed AP | Dave et al. 2021:不限每图检测数、每类最多 1 万个的 AP |
| federated 标注 | LVIS 每张图只确认部分类别的有无,没确认的类别上的检测不算错 |
| 补齐词(padding) | 训练时词表不足 80 个补的空字符串,起到"背景嵌入"的作用 |
| mosaic | 把 4 张图拼成一张的数据增强 |
14. 延伸阅读
- Radford et al. ,Learning Transferable Visual Models From Natural Language Supervision(CLIP),ICML 2021
- Gu et al. ,Open-vocabulary Object Detection via Vision and Language Knowledge Distillation(ViLD),ICLR 2022
- Kamath et al. ,MDETR: Modulated Detection for End-to-End Multi-Modal Understanding,ICCV 2021(GoldG 与 LVIS minival 的来源)
- Li et al. ,Grounded Language-Image Pre-training(GLIP),CVPR 2022
- Liu et al. ,Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection,2023
- Yao et al. ,DetCLIP: Dictionary-Enriched Visual-Concept Paralleled Pre-training for Open-world Detection,NeurIPS 2022
- Minderer et al. ,Simple Open-Vocabulary Object Detection with Vision Transformers (OWL-ViT),ECCV 2022;Scaling Open-Vocabulary Object Detection(OWLv2),NeurIPS 2023
- Gupta et al. ,LVIS: A Dataset for Large Vocabulary Instance Segmentation,CVPR 2019
- Dave et al. ,Evaluating Large-Vocabulary Object Detectors: The Devil is in the Details,2021(Fixed AP)
- Feng et al. ,TOOD: Task-aligned One-stage Object Detection,ICCV 2021(TAL)
- Ding et al. ,RepVGG: Making VGG-style ConvNets Great Again,CVPR 2021(重参数化)
- Wang et al. ,YOLOE: Real-Time Seeing Anything,2025(同样走"可重参数化的文本提示 + YOLO"路线,另加视觉提示和无提示模式)
- Tang et al. ,Online PCB Defect Detector On A New PCB Defect Dataset,2019(DeepPCB 数据集,9.7 节)
关注Hollis的视觉大模型实战:视觉与多模态大模型,读到能复现、跑到能落地。
每篇论文从公式讲到代码,能复现的我先跑一遍;每天还有一份只看一手来源的 AI 早报。
想看哪篇论文、对复现结果有疑问,欢迎在评论区留言。
文中论文图片出自原论文,出处见图注。