一、技术背景:结构化输出的三条路线
让大模型做分类/审核/分流,目前有三条技术路线:
- Prompt 工程:提示词里要求输出 JSON。失败率最高,模型会输出代码块标记、注释、单引号、多余客套话
- Schema 约束解码:OpenAI Structured Outputs、各家 JSON mode。底层用 token 概率遮罩保证格式合法。OpenAI 官方数据:JSON mode 失败率 5-10%,Structured Outputs 压到 0.1% 以下。代价是依然要生成全部输出 token,延迟和成本照付
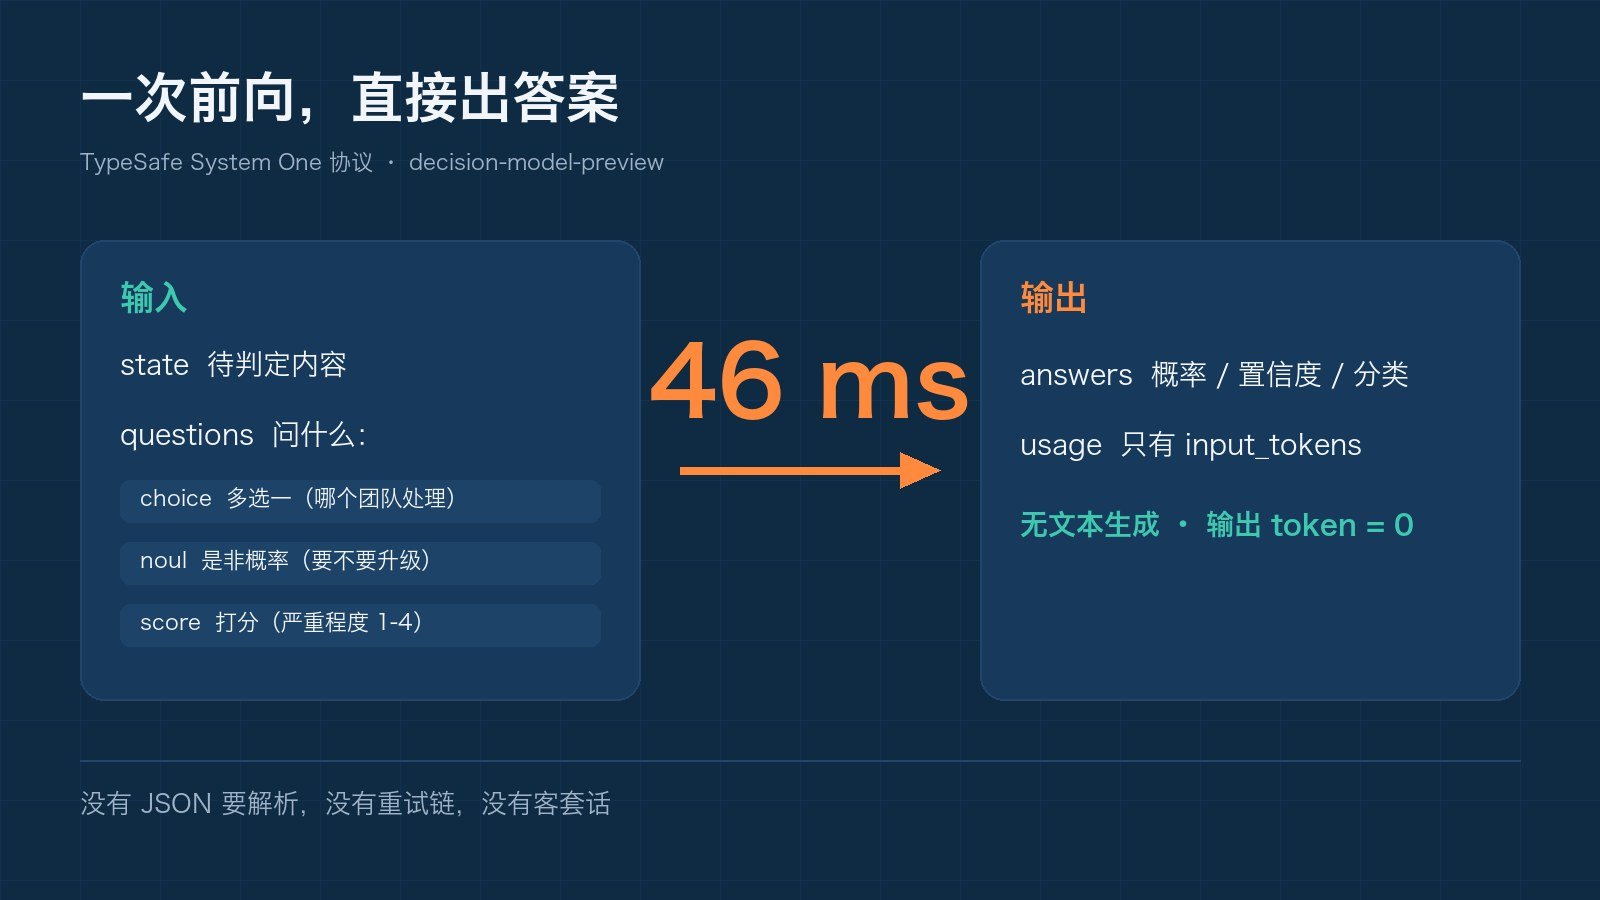
- 砍掉文本生成(本文主题):百炼 2026-09-24 上架的 decision-model-preview,配套 TypeSafe System One 协议。最大输出长度为 0,不生成任何文本,一次前向直接返回概率、置信度、分类的结构化响应
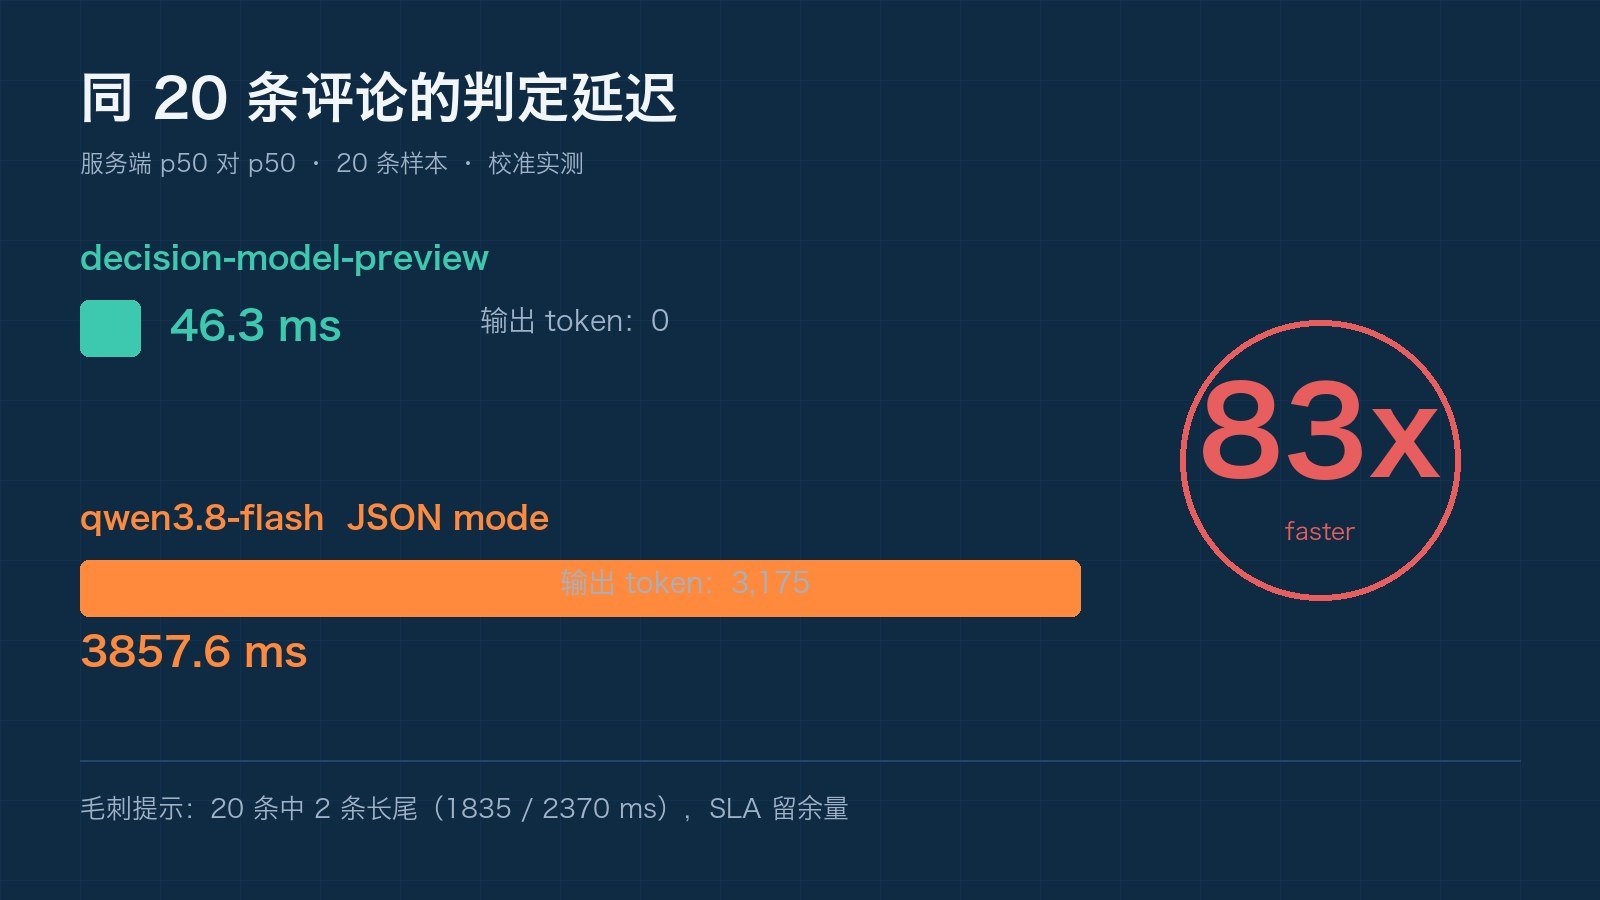
第三条路线的工程意义:无文本可解析(解析失败率结构性归零)、输出 token 为 0(成本形态改变)、服务端 p50 实测 46.3ms(延迟进入实时链路可用的量级)。
二、协议要点
端点:POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/systemone
请求体三部分:
| 字段 | 类型 | 说明 |
|---|---|---|
| model | string | 模型名,本包用 decision-model-preview |
| state | String | Object | Array | 待判定内容 |
| questions | map | 问题集合,建议 ≤16 个 |
三种问型:
- choice:多选一。criteria 为 key→描述 映射。响应含 choice、confidence、probabilities(完整分布)
- noul:是非概率,响应含 noul(0-1)
- score:有序量表打分,criteria 为 2-255 级数组。响应含期望分和各级分布
参数边界:questions 官方建议不超过 16 个;state 上下文窗口 65536 token;最大输出长度 0 写死在模型配置,不是可调参数。响应还带 latency_ms 和 usage.input_tokens(无 output_tokens,印证零生成)。
三、一次前向多任务实测
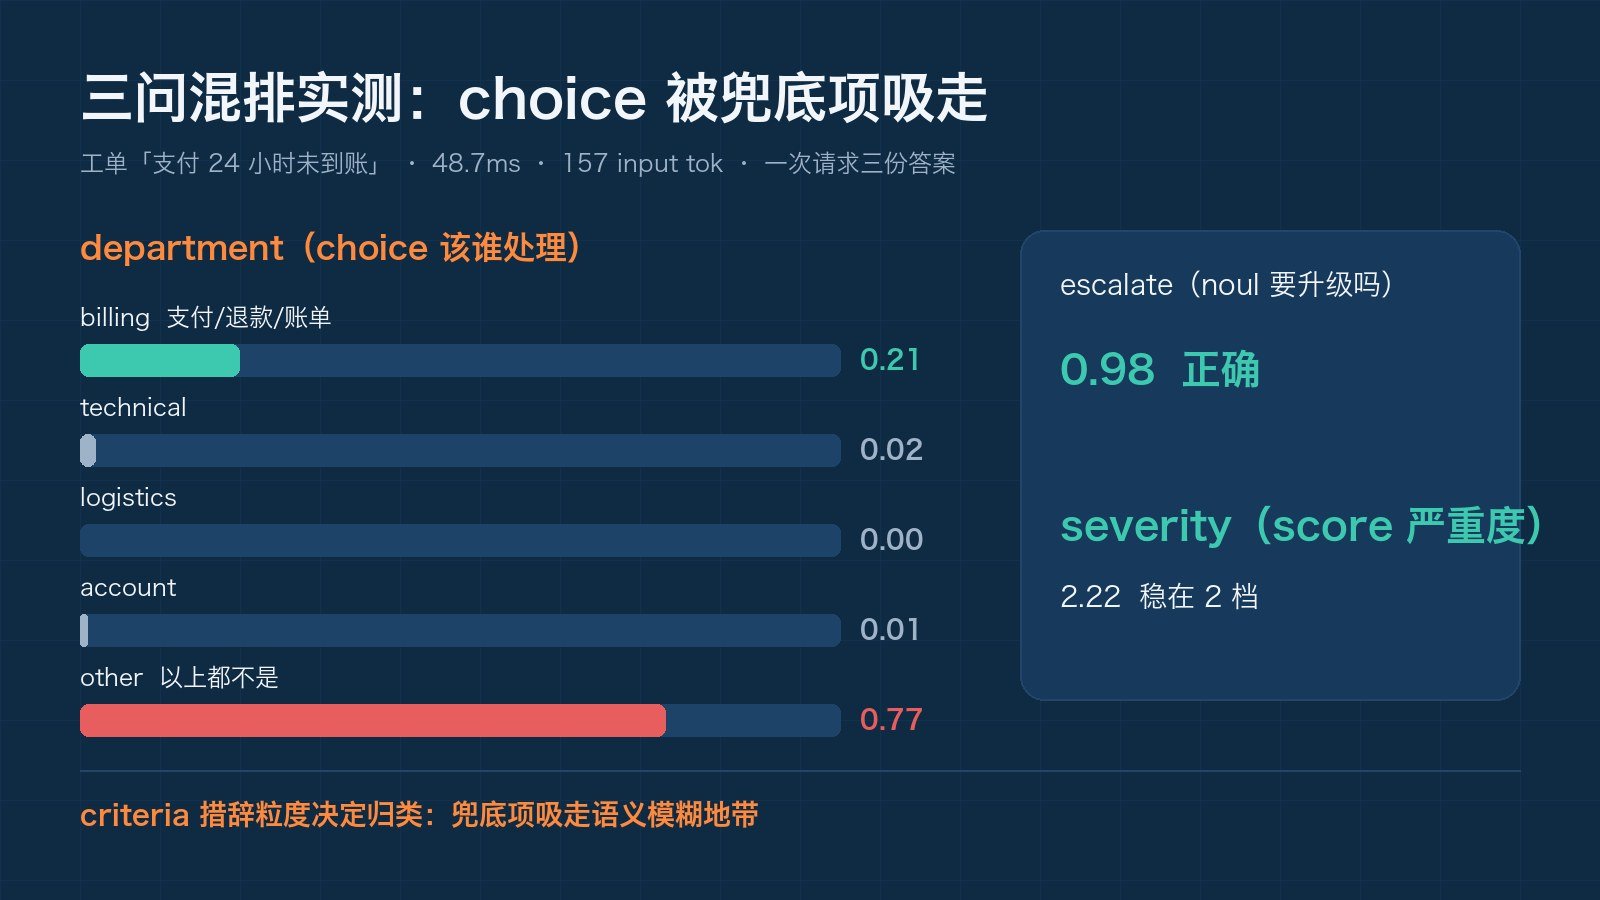
工单分流场景:一次请求混排三问(choice 5 项 + noul + score 4 级),48.7ms 返回 157 input tok:
json
{"department": {"choice": "other", "confidence": 0.71,
  "probabilities": {"billing": 0.21, "technical": 0.02,
                    "logistics": 0.0, "account": 0.01, "other": 0.77}},
 "escalate": {"noul": 0.98},
 "severity": {"score": 2.22, "probabilities": {"2": 0.75, "3": 0.24}}}
escalate 与 severity 正确,department 错判:工单是「支付 24 小时未到账」,criteria 中 billing 明写「支付、退款和账单问题」,却给了 other(0.77 vs 0.21)。
机制分析:五个选项四个描述具体,other 是「以上都不是」兜底。语义横跨支付与账务的样本被兜底项吸收。结论:choice 判定受 criteria 措辞粒度直接影响,各选项描述需等粒度设计,兜底项会吸走模糊地带。
四、校准实测:阈值不能直接搬
5 组 × 4 条 = 20 条评论区样本(明确广告/明确辱骂/擦边/变体字/正常),每条独立调用,双问(violation noul + category choice)。按 0.9/0.6 教科书阈值分流:
| 分流档 | 条数 | 关键样本 |
|---|---|---|
| 自动处置 ≥0.9 | 0 | --- |
| 人工复核 0.6-0.9 | 3 | 0.87(加微信广告)/ 0.82(辱骂)/ 0.79(薇❤变体广告) |
| 放行 <0.6 | 17 | 擦边 4 条全对(0.03-0.18);同组辱骂「滚回你的村里种地去吧」仅 0.32 |
延迟面补两个口径:服务端 p50 46.3ms(18/20 在 41.9-52.5ms 窄带,2 条毛刺 1835/2370ms);客户端端到端 p50 237.9ms(含 HTTP+TLS)。对外承诺用客户端口径,别拿服务端数字直接写 SLA。
五组 violation noul 全分布:
| 组 | 4 条样本 noul |
|---|---|
| 明确广告 | 0.87 / 0.42 / 0.47 / 0.53 |
| 明确辱骂 | 0.82 / 0.50 / 0.50 / 0.32 |
| 擦边阴阳 | 4 条全在 0.03-0.18 |
| 变体字 | 0.79 / 0.38 / 0.05 / 0.34 |
| 正常讨论 | 0.01 / 0.24 / 0.52 / 0.02 |
两个读法:辱骂组两条正好卡在 0.50,模型对它们真的没把握;正常组那条 0.52 就是「请问支持流式输出吗」,无害提问拿了过半违规概率。
保守校准 是核心特征:确凿样本才给高分,带语义空间的样本概率整体下压。广告组内部分化明显:「加微信 xxx888888」0.87 vs「同行价格更低找我」0.42,文字越不像广告分越低。阈值必须用自有样本标定,文档示例阈值直接进生产等于自动化率为 0。
标定流程四步:拉 50-100 条自有真实样本(覆盖所有预期类型,别用公开数据集);每条双问跑完记完整分布,不只记 top1;给错误定价,漏放一条违规和误杀一条正常各是什么代价,把切点放在可接受的位置;人工队列常设,阈值只调自动通道宽度,不决定人工存不存在。一个下午能跑完。
五、下游校验设计要点
- 交叉矛盾:noul 与 choice 以 0.5 为界不一致的比例 6/20(例:noul=0.52 而 choice=normal 的「请问支持流式输出吗」)。0.5 附近信号应路由人工而非自动处置
- 概率量化:probabilities 两位小数,20 条中 9 条和为 0.99 或 1.01。校验必须留容差(如 |sum-1|<0.02),精确等值校验会误杀 45% 正常响应
- 变体字:「薇❤ aaa888 领/取/全/套/资/料」抓到(0.79);「威信 same as 上面,懂的都懂」0.05 高置信放行,中英混排+指代是盲区。高置信放行意味着不会进人工队列,需第二道工序(关键词粗筛/抽样人审)
- state 数组非批量:传 4 条评论的数组会被序列化成单 state 返回聚合判定(noul=0.63),批量走并发单调用
六、对照组与工程备注
qwen3.8-flash JSON mode 同 20 条对照:20/20 解析通过(2026 年 JSON mode 可靠性已可用),p50 3857.6ms / max 6613ms,20 条 3603 in + 3175 out tok,成本 ≈0.0115 元。83 倍延迟差(p50 对 p50)的选型含义:离线批处理 flash 足够;实时链路(聊天意图识别/实时分流/inline 风控)只有 46ms 量级能进。
token 形态的差异比金额有意思:flash 的账单随「话多少」浮动,prompt 变长、输出变啰嗦都会推高成本;决策模型只随调用量线性,单条均值 106.4 个输入 token、0 输出。预算模型从「按字数估价」退化成「按次数估价」,财务上好算得多。
CLI 审计三坑(bl log audit list):
--model过滤对 systemone 流量不生效(totalCount=0),需客户端按originLog.model过滤--max-results超 20 静默返回空(不报错)- 响应无翻页 token 字段,
--next-token不可用,分页用--skip递增
对账:当日 166 条审计记录中 23 条 decision 调用,input_tokens 合计 2408,与实测侧 34+157+2128+89 逐条一致。每条记录带 request_id、start_time、duration、status_code,usage 是嵌在日志行里的 JSON 字符串,需二次 json.loads。另实测确认 state 数组非批量接口。
七、结论
decision-model-preview 把「结构化输出可靠性」从约束解码问题转成了免生成问题:46ms p50、零输出 token、无解析环节。接入前两件事必须做:自有样本标定阈值(保守校准,0.9/0.6 照搬=自动化率 0%)、下游校验按量化概率设计(容差与人工路由)。限免期成本为 0,是验证场景匹配度的窗口期。