CAS(ME)²数据集下载:
https://gitee.com/CodeStoreHub/auw-gcn-casme22
感知图卷积网络算法源码下载:https://gitee.com/CodeStoreHub/auw-gcn-casme22
微表情定位需要在数分钟长的视频中找出仅持续数十帧的极微弱面部运动,而公开数据集的规模极为有限: CAS(ME)² 全库仅含 57 个微表情实例,分布于 22 名受试者。在这一量级下,扩大模型容量会迅速导致过拟合。 AUW-GCN 的做法是不依赖网络自行学习面部区域间的关系,而是依据数据集的 AU 共现统计与面部解剖知识 构造固定的图邻接矩阵,将其作为先验注入图卷积网络,从而在极小样本条件下完成空间特征建模。 配合时序空洞卷积与基于顶点的提案生成策略,该方法在 CAS(ME)² 与 SAMM-LV 上均取得当时的最优结果。
目录
1方法动机与整体思路
宏表情与微表情定位(spotting)的目标,是在未裁剪的长视频中确定每个表情实例的起始帧、顶点帧与结束帧。 该任务面临两个固有困难:其一,微表情幅度极弱、持续时间极短,与面部无关运动难以区分; 其二,可用标注数据极少,CAS(ME)² 全库仅有 357 个实例,其中微表情仅 57 个。
既有方法大致分为两类。手工特征方法依赖光流、光学应变等精心设计的描述子,需要大量参数调优; 深度学习方法以数据驱动方式学习特征,但在上述数据规模下,让网络自行学习面部各区域之间的空间关系 既不充分也容易过拟合。AUW-GCN 的出发点正在于此:将面部区域间的关系作为先验显式给出, 而不交由网络从少量样本中学习。
方法整体由四个模块串联构成,数据自左向右流动(见 Fig. 1):
- AU 先验编码模块:统计数据集中 AU 的共现关系,结合面部解剖知识,构造固定的邻接矩阵;
- 空间特征嵌入模块(SFEM):以该邻接矩阵为结构,用图卷积在 12 个面部区域之间传递信息;
- 时序特征嵌入模块(TFEM):以空洞一维卷积在时间轴上建模,输出逐帧概率图;
- 提案生成模块:以顶点为锚点解析候选区间,再经非极大值抑制得到最终定位结果。
核心思想将面部动作单元的先验知识转化为图结构的邻接矩阵。该矩阵稀疏、不带来显著计算开销, 却把领域知识直接注入了模型的空间建模环节,是小样本条件下引入归纳偏置的一种高效方式。
2算法详解
本节按数据流动顺序展开各模块。整体框架见 Fig. 1:
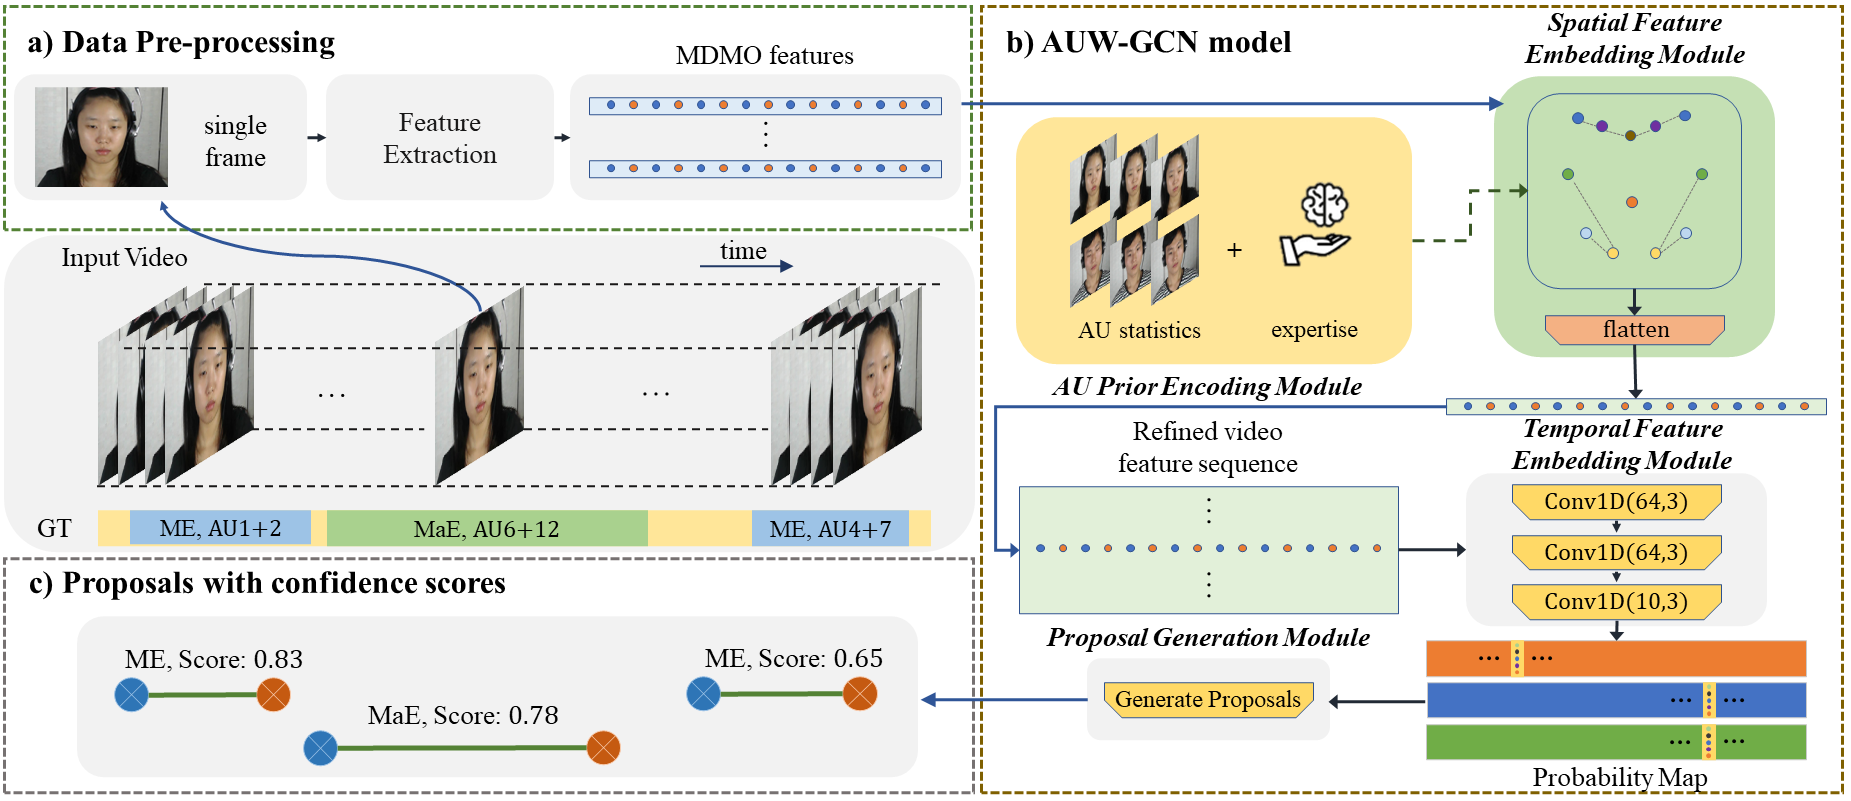
Fig. 1|AUW-GCN 总体框架。 (a) 数据预处理:长视频 → 逐帧特征提取 → MDMO 特征序列; (b) 模型本体:AU 先验编码模块产出邻接矩阵 → 空间特征嵌入模块(图卷积)→ flatten → 时序特征嵌入模块(三层 Conv1D)→ 概率图 → 提案生成模块; (c) 输出的带置信度的 ME / MaE 提案。
2.1 特征提取
该环节沿用 MDMO 特征提取流程,包含人脸对齐、关键点检测、光流计算与特征聚合四步:
- 使用 RetinaFace 定位首帧人脸框,将后续帧对齐至首帧,记对齐后视频为 ,其中 为总帧数;
- 采用 TV-L1 算法计算相邻帧的稠密光流 ;
- 依据 SAN 检测的面部关键点,裁剪出 12 个感兴趣区域(ROI);
- 在各 ROI 上聚合光流,得到模型输入 MDMO 特征 ,其中 为 ROI 数目。
该步骤确定的 是全流程的结构性常数:它同时是图的节点数与邻接矩阵的阶数。
2.2 AU 先验编码模块
本模块为图卷积提供结构信息,即回答「哪些面部区域之间存在关联」。 构造过程结合数据统计与领域知识。首先统计数据集中各 AU 的出现频率:
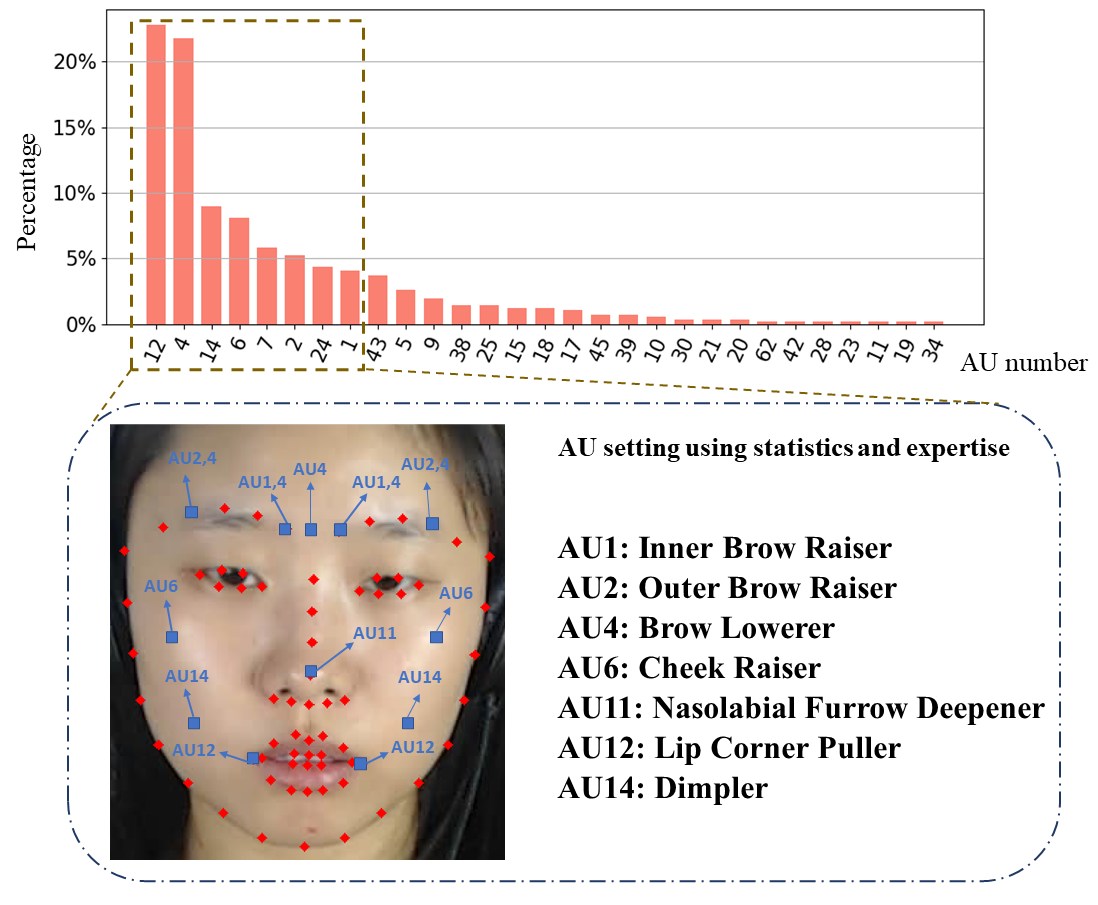
Fig. 2|AU selection 与「AU ↔ ROI」的对应。 上图:各 AU 在数据集中的出现比例,呈典型长尾分布; 下图:所选 AU 在人脸上的位置及其功能含义------ AU1 内侧眉抬升、AU2 外侧眉抬升、AU4 眉下压、AU6 颊部隆起、 AU11 鼻唇沟加深、AU12 唇角上提、AU14 酒窝形成。
AU 的出现比例呈显著长尾分布,少数 AU 占据大部分出现次数。据此选取最具代表性的 AU 集合, 再依据面部解剖学知识将每个 AU 映射到其所覆盖的面部区域,从而定义出 12 个图节点。
随后依据 AU 的共现关系构造邻接矩阵。设标注集合为 , 其中 为标注总数,每个实例 由起始帧 、顶点帧 、 结束帧 以及该实例中出现的 AU 集合 构成。邻接矩阵定义为:
𝟙
其中 为映射函数,将某个 AU 映射到其所覆盖的面部区域集合(即 Fig. 2 下半部分给出的对应关系)。 其含义是:若两个 ROI 所对应的 AU 频繁出现在同一表情实例中,则在二者之间建立连边。 最后对矩阵做归一化得到 ,以保证训练稳定。如此构造的邻接矩阵具有稀疏性, 计算开销小,同时保留了最具代表性的结构信息。
2.3 空间特征嵌入模块(SFEM)
该模块以图卷积为基本单元,用于刻画人脸不同部位之间的空间关系。 输入为特征矩阵 与邻接矩阵 , 其中 为输入特征维度, 为图节点数。理论上可堆叠 层, 第 层的输出为:
其中激活函数 取 ReLU, 为可学习权重矩阵。 需要强调的是, 为 2.2 节构造的先验矩阵,固定且不参与训练。 模块输入为 MDMO 特征 ,输出 为精炼后的空间特征嵌入。
2.4 时序特征嵌入模块(TFEM)
该模块在 SFEM 输出的空间特征上执行时序卷积,输出概率图 , 分别表示每一帧属于起始帧、顶点帧、结束帧与表情帧的概率(表情帧定义为落在标注区间内部的帧)。
模块设计受两个因素约束:时序感受野大小 与参数量 。 目标是在严格的容量预算下获得足以引入上下文信息、从而缓解不确定性的感受野。 为此在最后两层使用空洞卷积(dilation rate = 2),以较少参数扩大感受野、避免过拟合。 逐层配置见下表。
| 阶段 | 层 | kernel | stride | dim | RF | 激活 | 输出尺寸 |
|---|---|---|---|---|---|---|---|
| Backbone | GCN | -- | -- | (12, 16) | -- | ReLU | 16 × 12 × T |
| Backbone | flatten | -- | -- | -- | -- | -- | 192 × T |
| Neck | conv1d1 | 3 | 1 | 64 | 3 | ReLU | 64 × T |
| Neck | conv1d2* | 3 | 1 | 64 | 7 | ReLU | 64 × T |
| Head | conv1d3* | 3 | 1 | 10 | 11 | -- | 10 × T |
| [AUW-GCN 的逐层结构,采用标准的 backbone--neck--head 检测范式。RF 为等效时序感受野。] |
* 后两层为膨胀卷积,dilation rate = 2。GCN 一列记作 ,即 12 个节点、16 维隐层。
输出概率图的 10 个通道对应如下监督信号:
0:3------ 微表情的「起始 / 顶点 / 非以上」三分类;3:6------ 宏表情的同款三分类;6、7------ 微表情 / 宏表情的顶点概率;8、9------ 微表情 / 宏表情的动作概率(该帧是否位于表情区间内)。
2.5 提案生成模块
模型仅输出逐帧概率,区间由后处理解析得到。策略是以顶点为锚点,向左右两侧搜索起始与结束帧 (论文 Algorithm 1):
- 将顶点概率 超过阈值 的帧加入候选顶点集;
- 对每个候选顶点 ,在区间 内取起始概率的 作为起点 ;
- 在区间 内取结束概率的 作为终点 ;
- 提案置信度由三者相乘得到:。
搜索范围 对两类表情分别设定:微表情左右各 ,宏表情左右各 , 以匹配二者在时长上的量级差异(微表情平均 15 帧,宏表情平均 59 帧)。
2.6 后处理
候选提案中存在大量高度重叠的区间,采用**非极大值抑制(NMS)**进行过滤: 与被保留的高分提案重叠度高而自身分数较低的提案被抑制,最终得到提案集合 。
2.7 优化目标
训练将定位任务转化为分类问题,同时构造二分类与三分类任务,并采用 Focal Loss 应对极端的数据不平衡 (微表情帧在全部帧中占比极低):
总损失为六个分项的加权和,权重定义于 train.py:
# 微表情分支(权重更高,因样本更稀少)
loss = ( 1.8 * loss_micro_apex
       + 1.0 * loss_micro_start_end
       + 0.1 * loss_micro_action
       # 宏表情分支,整体再乘平衡系数 macro_ration = 0.5
       + opt['macro_ration'] * (
             1.0 * loss_macro_apex
           + 1.0 * loss_macro_start_end
           + 0.1 * loss_macro_action ) )
顶点与动作两个二分类分支的 focal 参数分别为 、, ;三分类分支使用带 label smoothing 的 focal 变体,。 顶点监督信号并非硬标签,而是以顶点帧为中心、按高斯核 衰减的软标签 (微表情 ±1 帧、宏表情 ±3 帧),以容忍标注在帧级上的抖动。
3模型架构与参数量
模型实现见仓库 model.py,与上表一致。整体结构为单层图卷积加三层一维卷积:
class AUwGCN(nn.Module):
    def __init__(self, opt):
        # 邻接矩阵由 assets/ 读取,按数据集名选择文件
        mat_path = os.path.join('assets', '{}.npy'.format(opt['dataset']))
        #       nfeat=2, nhid=16, nout=16  -> 对应架构表中的 GCN (12,16)
        self.graph_embedding = nn.Sequential(GCN(2, 16, 16, mat_path))
        in_dim = 192                    # = 12 节点 × 16 维,flatten 之后
        self._sequential = nn.Sequential(   # Neck:两层,第二层为膨胀卷积
            nn.Conv1d(in_dim, 64, 1), ...
            nn.Conv1d(64, 64, 3, padding=1), ...
            nn.Conv1d(64, 64, 3, padding=2, dilation=2), ... )
        self._classification = nn.Conv1d(   # Head:3+3+2+2 = 10 个通道
            64, 3+3+2+2, kernel_size=3, padding=2, dilation=2)
模型参数量在百万以内,属于刻意的轻量化设计。消融实验为此提供了直接证据: 将隐层维度由 16 增至 32,F1 由 0.3653 降至 0.1257(见 5.2 节)。 对于仅含 57 个微表情样本的数据集,该结论符合小样本学习的一般规律。
12 × 16
GCN 的节点数与隐层维度
10 × T
Head 输出的概率图通道数
RF = 11
最终等效时序感受野(帧)
L = 1
实际使用的 GCN 层数
4CAS(ME)² 数据集
CAS(ME)² 是本文两个评测集之一,由 Qu 等人于 2017 年发布,用于自发式宏表情与微表情的定位与识别。 需要注意它与另外两个常用数据集在名称上极易混淆:
| 数据集 | 受试者 | 样本量 | 帧率 | 形态 |
|---|---|---|---|---|
| CAS(ME)²(2017, Qu 等) | 22(编号 15--40) | 57 微表情 + 300 宏表情 | 30 fps | 长视频,用于 spotting |
| CASME II(2014) | 26 | 约 247 | 200 fps | 短视频,用于分类 |
| CAS(ME)³ | 100+ | 300+ | 30 fps | 长视频,用于 spotting |
4.1 官方发布内容
官方 2017 年版本包含:
rawvideo.rar------ 原始长视频,共 22 个受试者目录(s15 ... s40);cropped.rar------ 各表情实例的裁剪人脸图像;CAS(ME)^2code_final(Updated).xlsx------ 官方标注表;CAS(ME)^2blink-code.xlsx、readme.pdf。
4.2 文件命名规则
官方标注表提供两张「naming rule」工作表,由此可还原标注条目与磁盘文件的对应关系: 标注中的受试者编号 对应目录 s{14+k}(1→s15,...,22→s40); 表情名 anger1_1 对应视频编号 0401,即文件 15_0401girlcrashing.avi。
该映射可交叉验证:标注中的帧号与裁剪图像文件名一致 (cropped/15/anger1_1/img557.jpg 对应起始帧 557)。 所用特征覆盖 95 个视频、22 名受试者, 与标注文件中的 22 个 subject ID 可双向一一对应。
使用建议在使用任何一份 CAS(ME)² 特征之前,建议先执行一次「形状 + 键名 + 受试者对齐」校验。 仓库提供的 validate_features.py 即用于此目的,可在数秒内完成, 可避免训练阶段出现难以定位的维度错误。
5复现结果
5.1 四组评测结果
在单张 RTX 3090 上完成 22 折 LOSO 实验,全部结果由仓库自带的 calc_final_score.py 聚合。 为便于定位各环节的贡献,共执行四组评测:
| 实验组 | MaE | ME | Overall | 说明 |
|---|---|---|---|---|
| (a) 作者 checkpoint 与输出 | 0.4235 | 0.1538 | 0.3834 | 直接运行评分脚本 |
| (b) 作者权重 / 本机环境 | 0.4109 | 0.1250 | 0.3708 | 仅更换运行环境 |
| (c) 从零训练 · seed 1 | 0.3781 | 0.1000 | 0.3455 | 代码默认 same_seeds(1) |
| (d) 从零训练 · seed 2 | 0.3614 | 0.1556 | 0.3369 | 更换随机种子 |
| [各组均完整覆盖 22 折 LOSO,指标为 F1-score。] |
从零训练两次,总体 F1 分别为 0.3455 与 0.3369; 宏表情 F1 为 0.3781 与 0.3614,微表情 F1 为 0.1000 与 0.1556。 两次训练的总体差距为 0.009,而单折 overall F1 的标准差为 0.178, 22 折对应的标准误为 0.038------单折分数分布于 0.000 至 0.800 之间, 部分折未检出任何实例,部分折可达 0.75 以上。
结论22 折 LOSO 全部完成,四组评测均正常收敛并产出完整的逐 epoch 指标与最终汇总。 在极小样本条件下,微表情分支的指标波动显著大于宏表情分支,符合数据集本身的统计特性。
5.2 消融实验
两组消融实验分别对应模型的两个设计选择:
| 来源 | 设置 | Precision | Recall | F1 |
|---|---|---|---|---|
| 组件消融 | 无 GCN、无先验 | 0.3527 | 0.2885 | 0.3174 |
| 组件消融 | 有 GCN、无先验(邻接矩阵由网络学习) | 0.3804 | 0.2941 | 0.3318 |
| 组件消融 | 有 GCN、有 AU 先验 | 0.4000 | 0.3361 | 0.3653 |
| 容量消融 | a: NL=1, ND=16 ← 代码采用配置 | 0.4000 | 0.3361 | 0.3653 |
| 容量消融 | b: NL=1, ND=32 | 0.1025 | 0.1625 | 0.1257 |
| 容量消融 | c: NL=2, ND=16 | 0.3869 | 0.2969 | 0.3360 |
| 容量消融 | d: NL=2, ND=32 | 0.0850 | 0.1092 | 0.0956 |
两组消融分别验证了该方法的两个核心判断:
- **AU 先验是有效的。**引入 GCN 本身带来 0.3174 → 0.3318 的提升; 在此基础上注入 AU 先验编码进一步提升至 0.3653,且 recall 的改善最为明显。 其解释是:在极小数据集上让网络自行学习节点间的邻接关系较为困难,且易陷入过拟合; 直接注入具体知识可使网络更高效地学到节点间相关性。
- **模型容量需保持较小。**隐层维度由 16 增至 32 后,F1 降至 0.1257; 层数与维度同时增大更降至 0.0956。仅增加层数(NL=2, ND=16)时退化相对轻微(0.3360)。 这与「小数据集配小模型」的设计取向一致。
6代码环境安装
仓库依赖 torch==1.13.1;实测 1.13.0+cu116 与该代码 ABI 兼容。 以下为在 2× RTX 3090 主机(仅使用 GPU 0)上验证通过的完整流程。
6.1 创建 conda 环境
# 创建环境
conda create -n auwgcn python=3.8 -y
conda activate auwgcn

# 安装依赖(requirements.txt 中的 nvidia-* / tensorboard-* 为传递依赖,可省略)
pip install torch==1.13.0+cu116 torchvision==0.14.0+cu116 \
    --extra-index-url https://download.pytorch.org/whl/cu116
pip install numpy==1.23.5 pandas scipy PyYAML tensorboard tqdm
cuDNN 找不到 libcuda.so 时设置环境变量即可:export LD_LIBRARY_PATH=/home/ubuntu/cudalib (该目录内含指向系统 libcuda.so.1 与 libcudart.so 的软链接)。
6.2 获取代码与数据
git clone https://github.com/xjtupanda/AUW-GCN.git
cd AUW-GCN

# 特征与人脸检测权重发布于百度网盘(需要账号):
#   features.tar.gz  https://pan.baidu.com/s/1Pj_CnnypSfNOTaSO1BFKdg?pwd=mpie
#   ckpt.tar.gz      https://pan.baidu.com/s/1U-LEYH_fGOwgeToJ2Abhlw?pwd=5kan
#   checkpoint.zip   https://pan.baidu.com/s/1Xx-RjN0-OlwzGoX1n5MXnw?pwd=3akj  (仅重新提取特征时需要)

# features.tar.gz 为未压缩的 tar 归档,使用 tar -xf 解压
tar -xf features.tar.gz

# ckpt.tar.gz 解压后即为完整的 output/ 目录(22 折 × 100 个 checkpoint)
tar -xzf ckpt.tar.gz output/casme
解压后的特征目录结构如下:
features/cas(me)^2/feature_segment/
├── train/<subject>/*.npz     # 22 个受试者目录
└── test/<subject>/*.npz      # 内容与 train 相同,LOSO 切分在加载时执行

# 每个 npz 包含三个数组:
#   feature      (270, 12, 2)  float32
#   label        (270, 8)      int64
#   video_name   ()            <U14
6.3 配置修改
仅需修改一处:将 config.yaml 中 cas(me)^2 段的 segment_feat_root 指向解压得到的 feature_segment 目录。 其余关键配置项保持默认即可:
| 配置项 | 值 | 含义 |
|---|---|---|
SEGMENT_LENTH |
256 | 每段的时间长度(帧) |
RECEPTIVE_FILED |
15 | 时序感受野,取奇数(STEP = 7) |
epochs / batch_size |
100 / 128 | 训练轮数与批大小 |
abfcm_training_lr |
0.01 | Adam 学习率 |
abfcm_lr_scheduler |
0.96 | ExponentialLR 的 γ |
micro/macro_apex_score_threshold |
0.5 / 0.5 | 顶点概率阈值 |
macro_ration |
0.5 | 宏/微表情损失的平衡系数 |
epoch_begin |
15 | 开始产出评测结果的轮次 |
7运行方法
7.1 标准流程
仓库自带 pipeline.sh,其中 CAS(ME)² 段已写好(默认启用的是 SAMM 段)。 核心流程为三步:
for i in ${SUB_LIST[@]}; do
    python train.py --dataset "cas(me)^2" --output $OUTPUT --subject ${i}   # 训练
    python eval.py  --dataset "cas(me)^2" --output $OUTPUT --subject ${i}   # 评测
done
python calc_final_score.py --output $OUTPUT                                  # 汇总 22 折
其中 SUB_LIST 为 22 个受试者(casme_015 ... casme_040), $OUTPUT 为结果输出目录。每个受试者目录下将生成:
$OUTPUT/casme_015/
├── models/checkpoint_epoch_XXX.pth.tar   # 每个 epoch 一个 checkpoint
├── output_csv/proposals_epoch_XXX.csv    # 原始提案
├── nms_csv/final_proposals_epoch_XXX.csv # NMS 之后的提案
├── epoch_metrics.csv                     # 逐 epoch 全部指标
└── best_res.csv                          # 该折最佳 epoch 的计数(汇总依据)
关于「最佳 epoch」eval.py 会对 epoch_begin(CAS(ME)² 为 15)至第 99 个 epoch 逐一评测, 随后按 F1 选取最优轮次写入 best_res.csv。 这是作者定义并采用的评测协议,复现时应保持一致。
7.2 并行执行
单折显存占用约 2 GB ,训练速度约 2.4 秒/epoch , 因此单张 24 GB 显卡可安全并行多折。提供的 run_all_parallel.sh 以 5 折并发执行, 22 折总耗时约 25 分钟:
# 从零训练 + 评测 + 汇总
JOBS=5 OUTPUT=./output/casme_run bash run_all_parallel.sh

# 仅使用作者 checkpoint 评测(零训练核验)
SKIP_TRAIN=1 JOBS=5 OUTPUT=./output/casme_eval bash run_all_parallel.sh

# 更换随机种子重新训练
AUWGCN_SEED=2 JOBS=5 OUTPUT=./output/casme_seed2 bash run_all_parallel.sh
7.3 复现第 5 节各实验组
| 实验组 | 命令 |
|---|---|
| (a) 作者 checkpoint 与输出 | tar -xzf ckpt.tar.gz output/casme && python calc_final_score.py --output ./output/casme |
| (b) 作者权重 / 本机环境 | bash eval_authors_weights.sh(脚本仅复制作者的 models/,确保评测目录干净) |
| (c) 从零训练 seed 1 | JOBS=5 OUTPUT=./output/casme_run bash run_all_parallel.sh |
| (d) 从零训练 seed 2 | AUWGCN_SEED=2 JOBS=5 OUTPUT=./output/casme_seed2 bash run_all_parallel.sh |
若仅需核验单折,可直接执行 python eval.py --dataset "cas(me)^2" --output <dir> --subject casme_015, 单折耗时约 5--6 分钟。