一、为什么值得研究 REA?
假设你看到一个软件的搜索体验做得不错:输入关键字,结果即时过滤,而且速度很快。你希望在自己的产品中实现类似效果。
如果只有产品截图,AI 可以猜一种实现。真正的工程问题却没有被解决:它是否在本地搜索?是否经由 Electron IPC?是否使用索引?是否经过缓存?不同窗口之间有没有共享状态?
传统逆向路径通常是人工检查安装包、定位代码、确认调用、记录结论、再自己编写功能。REA 提供了另一种组织方式:AI 提问和规划,工具检查真实工件,Evidence 记录依据,人再根据证据判断是否值得复现。
它尤其适合以下几类开发工作:
- 分析自有或已获授权的 Electron / JavaScript 桌面程序,追踪从界面到主进程的调用链。
- 调查已发布版本和新版本之间的行为差异,定位打包产物中的变更。
- 对自研 C/C++ 程序做函数定位、反汇编、交叉引用、伪代码分析。
- 借助浏览器观察界面结构与请求行为,把静态猜测与实际执行区分开。
- 对不再有源码的历史内部组件做兼容性研究,逐项恢复可验证的业务逻辑。
**不值得滥用的场景也很明确:**如果完整源码已经在手,正常的仓库阅读、调试、测试通常比逆向更高效。
二、从架构看:REA 实际由什么组成?
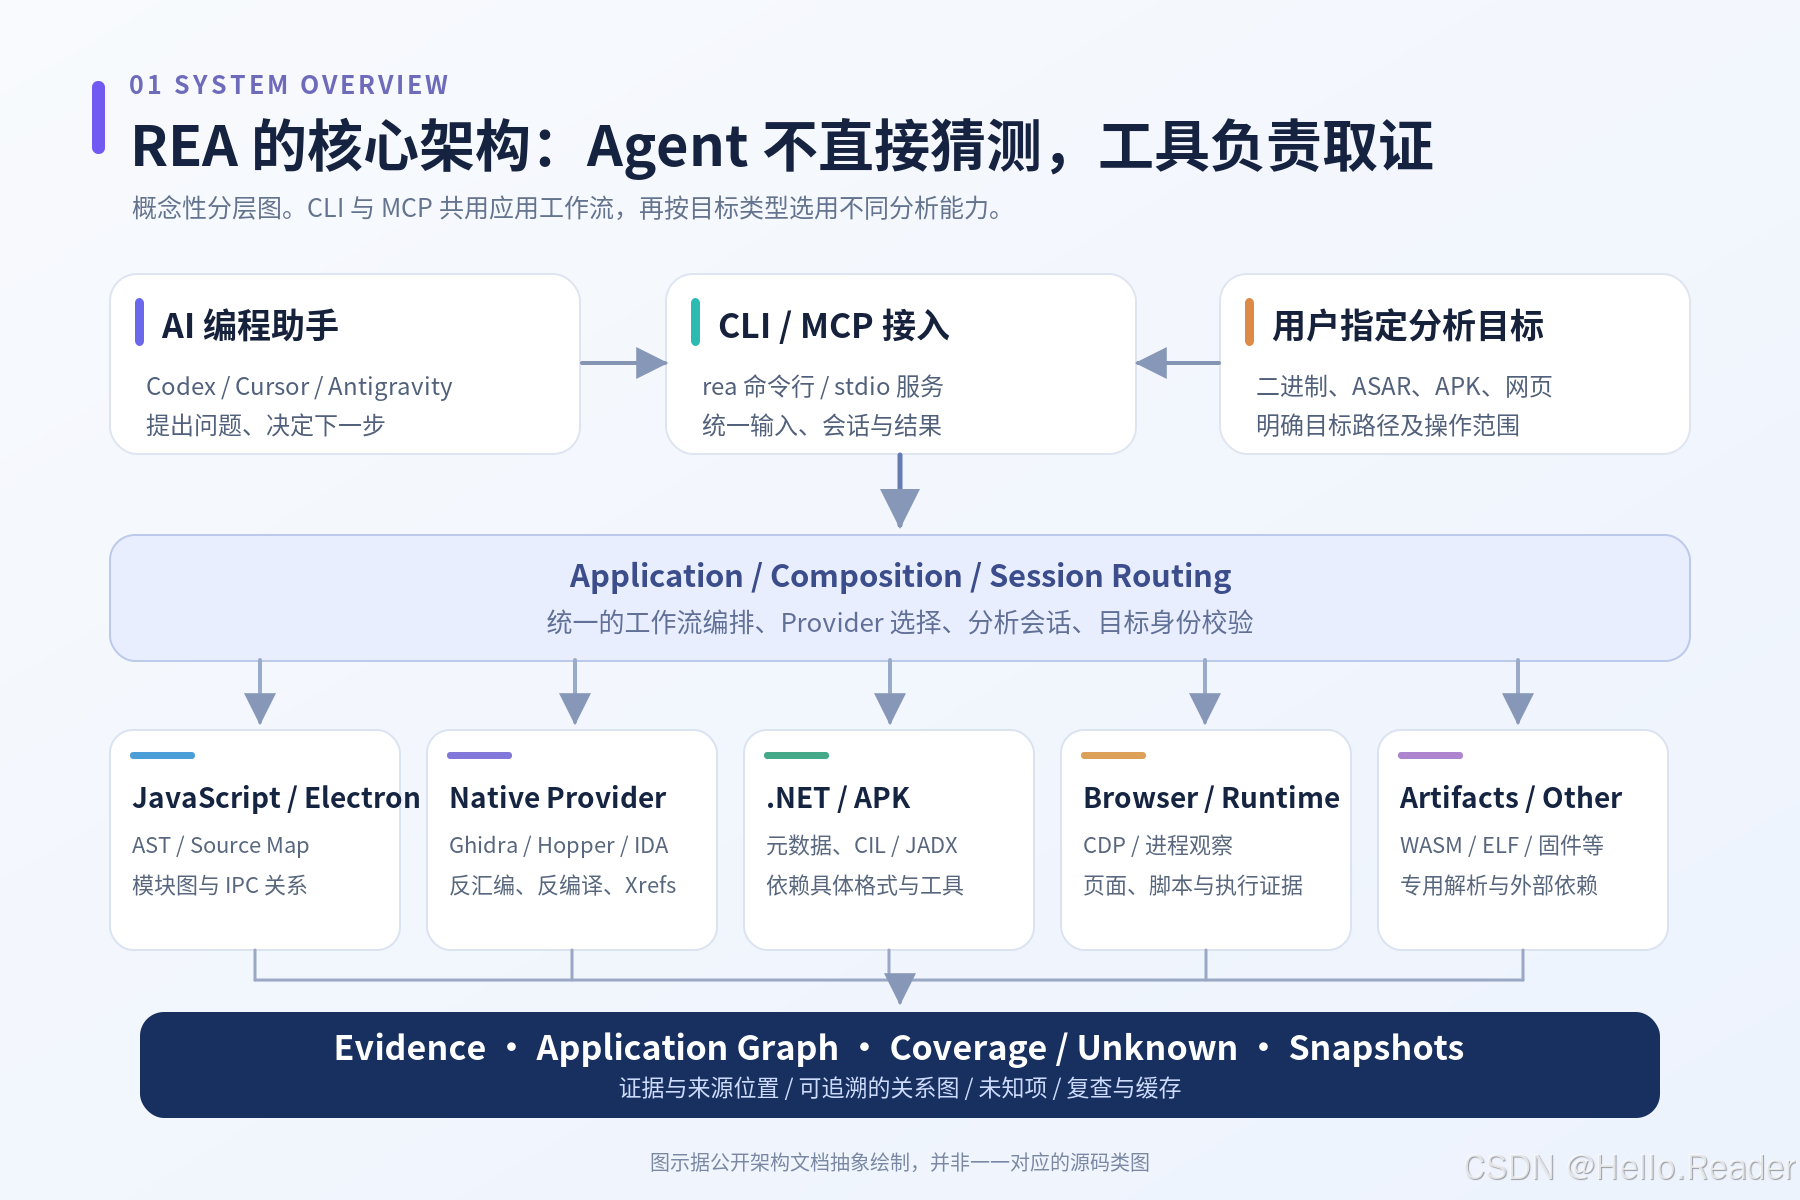
2.1 AI Agent 是决策者,REA 是取证工具层
REA 的接入点主要有两条:
- CLI :直接使用
rea命令执行分析,适合批处理、脚本和持续回归。 - MCP:通过本地 MCP 服务暴露分析工具,让 Codex、Antigravity、Cursor、Claude Code 等智能体按需调用。
CLI 和 MCP 背后共用分析工作流。以仓库中的源码组织为例,scripts/rea.mjs 负责命令分派;src/cli.ts 与 src/main.ts 分别属于命令行和 MCP 入口;src/application/ 编排应用工作流;src/composition/ 负责相关组件的组合与运行时绑定;src/domain/ 存放纯领域模型;src/contracts/ 定义对外的数据契约。
不同输入由不同分析器处理,而不是用一个大模型直接解读原始字节:
| 目标 | 典型分析结果 | 额外依赖或限制 |
|---|---|---|
| JavaScript / Electron | 模块、导入、打包关系、IPC、Source Map 线索 | 静态分析可直接读取目录或 ASAR |
| 原生 ELF / PE / Mach-O | 汇编、伪代码、字符串、函数、Xrefs | 需要受支持的 Hopper、Ghidra 或 IDA Provider |
| .NET 程序集 | 元数据、类型、方法和 CIL | 静态检查,不等同于恢复完整 C# 原始源码 |
| 网站 / 浏览器 | DOM、脚本、网络及浏览器观察 | Chrome 系浏览器及相应 CDP 接入;观察有边界 |
| Android APK | Manifest、类、方法及引用关系 | 通常需要对应 JDK 与 JADX 等外部依赖 |
| WASM、ELF 布局、固件等 | 对应格式与专用检查结果 | 取决于具体分析能力、宿主环境及额外工具 |
2.2 一个关键设计:Provider 不等于 AI 模型
Ghidra、Hopper、IDA 负责二进制分析;JavaScript 分析器负责静态解析;CDP 等组件负责浏览器观察。它们给 AI 的是可引用的结果,而不是由模型临场编造的逆向事实。
举例来说,针对一个原生程序,工具能够找到某个函数的地址、反编译伪代码和交叉引用;AI 再根据这些事实追问"是谁调用它""这个参数从哪来"。工具暂时无法确认的间接调用,不应该被描述成已经确认的调用边。
2.3 Evidence 与关系图为什么重要?
REA 不只返回一句"搜索由某函数处理",还会尽量保留目标工件身份、观察结果、来源位置、关系和限制条件。当前 MCP 契约明确包括 normalized_result、evidence_id、可选的 raw_result 与 analysis_profile 等字段。
对 Electron,项目使用 Application Graph / 语义关系图来表示模块、边界和已证实或推断的关系。这里的 coverage 可能是完整、部分、未知或不可用;不能因为图上没有某条边,就直接断言该边一定不存在。
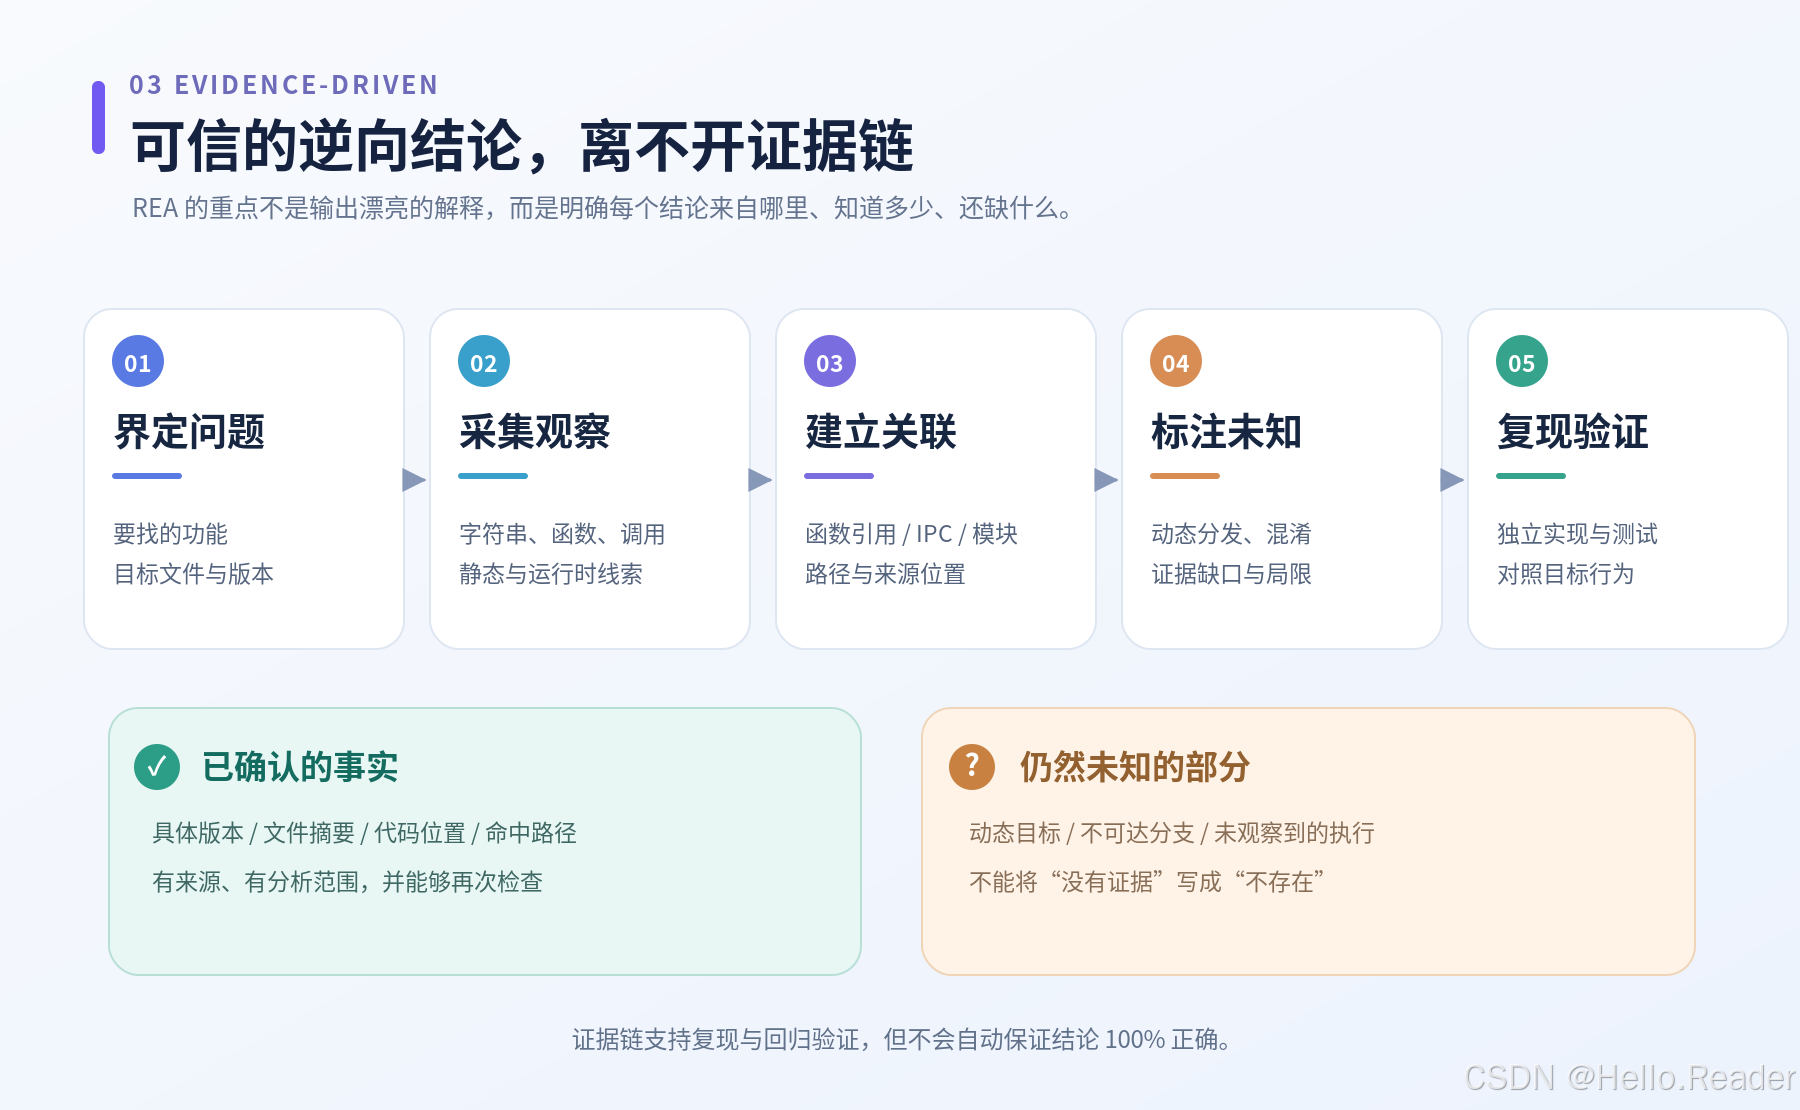
这也是我认为 REA 最有工程价值的一点:它尝试把证据、推断、未知项和复现验证分开,而不是把 AI 的解释当作最终真相。
三、安装 REA:优先使用官方 Setup
3.1 环境要求
根据当前 README,Node.js 需要满足下列版本区间之一:
- Node.js 22.19.0 及以上的 22.x;
- Node.js 24.11.0 及以上的 24.x;
- 或 Node.js 26.x 及以上。
先执行:
bash
node --version
npm --version
Node 22.16 这样的旧 22.x 版本不符合上述要求。不要看到"Node 22"就默认兼容。
3.2 让 Setup 自动配置 MCP 与 Skill
bash
npx rea-agents@latest setupSetup 会让你选择目标编程助手、预览配置修改,并在你同意后写入 MCP 注册信息和配套技能说明。安装后应重启编程助手,再检查其工具列表。它不会因为安装了 Skill 就自动拥有 MCP 分析工具,也不会无授权替你安装或激活商业逆向软件。
更适合命令行用户的方式:
bash
npm install --global rea-agents
rea --help
rea doctor --json
rea providers --json
rea capabilities --json
如果你已经有 Codex 与 Antigravity,Setup 的可选客户端包括 codex 和 antigravity。你可以在交互界面中选择两者,随后分别检查:
bash
rea doctor --client codex --json
rea doctor --client antigravity --json
如果要分析原生二进制,先配置一个受支持的分析器。以 Ghidra 为例:
bash
rea doctor --provider ghidra --json请留意不同操作系统的支持边界:Linux、macOS 与 Windows 的 Provider 支持并不完全相同;Windows Ghidra 的相关能力在项目文档中仍有实验性范围限定。JavaScript 静态分析无需先安装 Ghidra。
3.3 不安装全局命令也能直接运行
bash
npx -y rea-agents@latest analyze-javascript-application "/absolute/path/to/app" --json该参数接受应用目录或 ASAR。Windows 可以换成类似 "D:/apps/example/resources/app.asar" 的真实路径。
四、实战一:追踪 Electron 搜索功能的跨进程调用
为了避免拿未经授权的软件做演示,我们自己编写一个最小 Electron 项目。它有一个搜索框,界面代码通过安全桥接层向主进程请求结果。
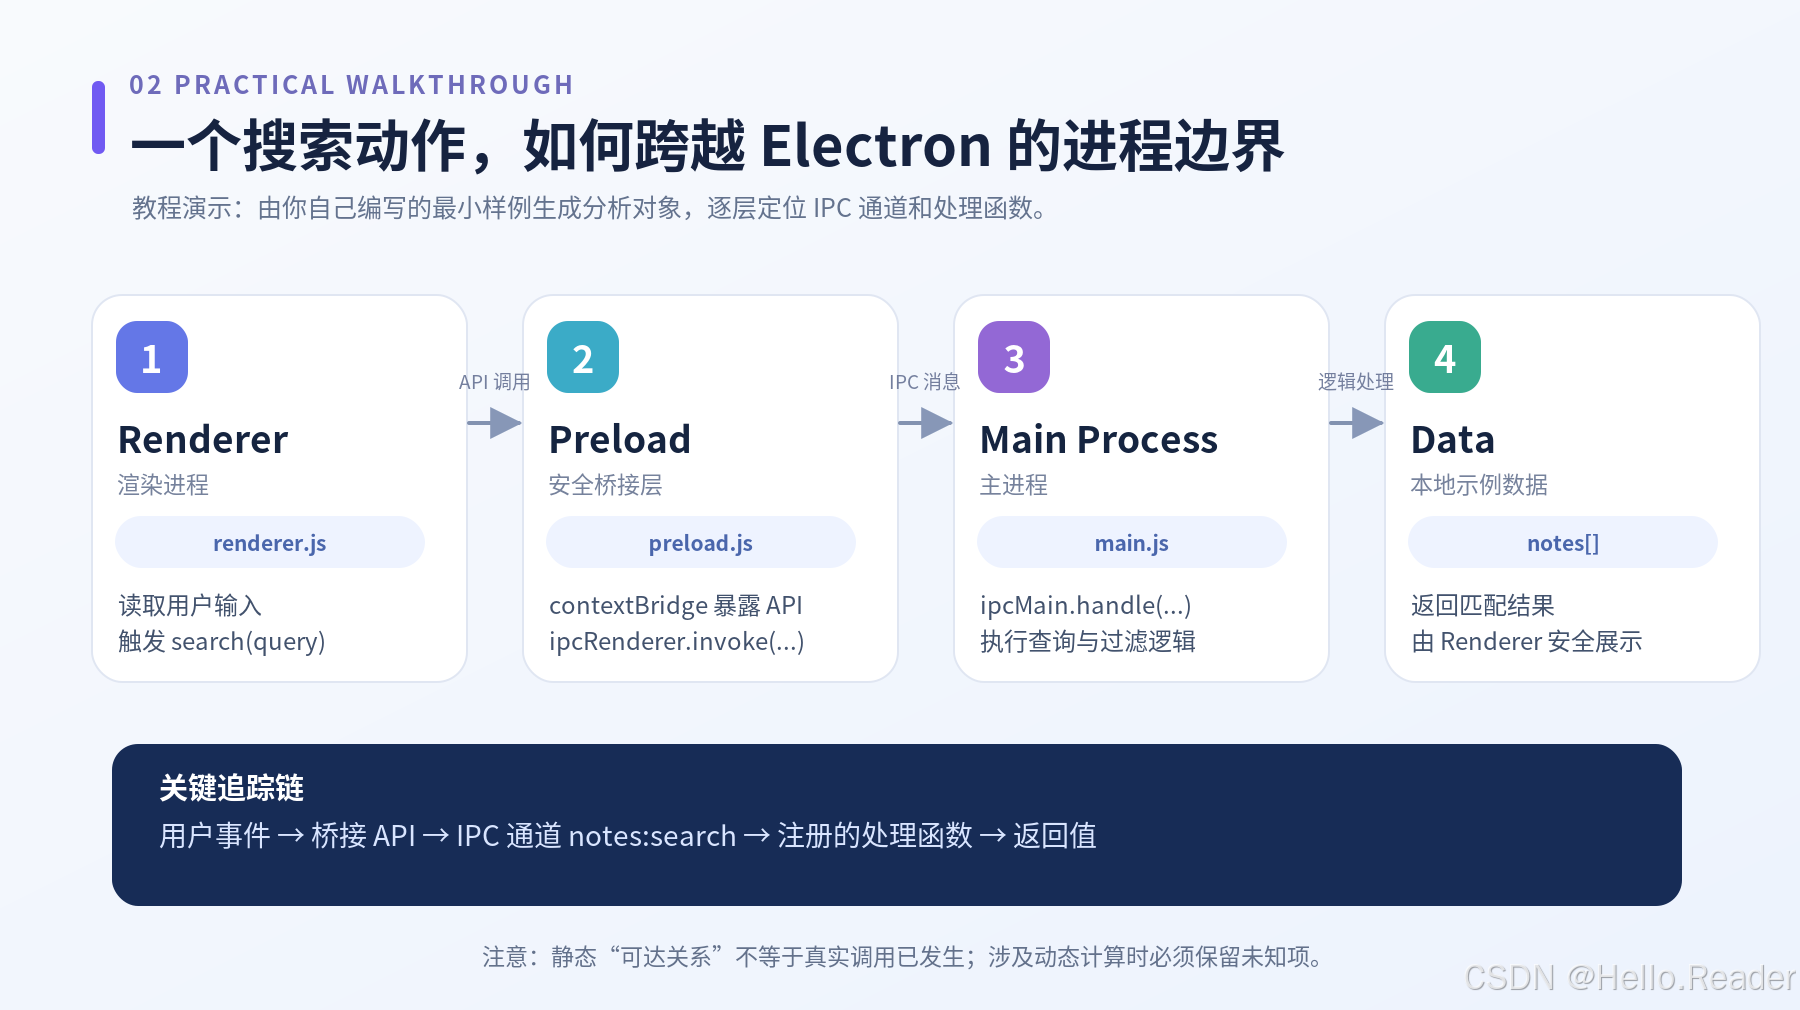
4.1 先看三个核心文件
主进程 main.js:负责注册 IPC 查询处理器。
javascript
const { app, BrowserWindow, ipcMain } = require('electron');
const path = require('node:path');

const notes = [
  'REA 可以追踪模块间关系',
  'Electron 使用 IPC 进行跨进程通信',
  'Evidence 记录分析来源和未知项',
];

ipcMain.handle('notes:search', async (_event, keyword) => {
  const value = String(keyword ?? '').trim().toLowerCase();
  return notes.filter((note) => note.toLowerCase().includes(value));
});

app.whenReady().then(() => {
  const win = new BrowserWindow({
    webPreferences: {
      preload: path.join(__dirname, 'preload.js'),
      contextIsolation: true,
      nodeIntegration: false,
      sandbox: true,
    },
  });
  win.loadFile('index.html');
});
桥接层 preload.js :只暴露需要的功能,而不是将整个 ipcRenderer 暴露给页面。
javascript
const { contextBridge, ipcRenderer } = require('electron');

contextBridge.exposeInMainWorld('notesApi', {
  search: (keyword) => ipcRenderer.invoke('notes:search', keyword),
});
渲染进程 renderer.js:以用户输入为起点。
javascript
const queryInput = document.querySelector('#query');
const resultList = document.querySelector('#results');

queryInput.addEventListener('input', async () => {
  const results = await window.notesApi.search(queryInput.value);
  resultList.replaceChildren(...results.map((value) => {
    const li = document.createElement('li');
    li.textContent = value;
    return li;
  }));
});
以上代码是精简展示。压缩包内提供更完整的样例,包括 index.html、请求先后顺序处理和错误处理。
4.2 对目录做静态分析
准备好示例工程后,在 demo 目录执行:
bash
rea analyze-javascript-application ./electron-lab --json > application-evidence.json这一操作读取目录中的应用文件并做静态分析,不需要先启动 Electron,也不需要先安装 Ghidra 。分析文档中可以关注模块、导入、Electron 角色、IPC 通道、结构图,以及 limitations 或 coverage。
4.3 围绕 notes:search 继续追踪
REA 的跨层工作流支持通过字符串、IPC 通道、模块等线索追踪已生成的应用证据。CLI 不会自动保存前一次进程的内存状态,因此需要将完整 Evidence 传给后续命令。
新建 trace-feature.mjs:
javascript
import { readFileSync, writeFileSync } from 'node:fs';

const application = JSON.parse(
  readFileSync('application-evidence.json', 'utf8')
);

writeFileSync('trace-input.json', JSON.stringify({
  application,
  seed: { kind: 'string', value: 'notes:search' },
  direction: 'both',
}));
依次运行:
bash
node trace-feature.mjs
rea trace-application-feature ./trace-input.json --json > feature-evidence.json
重点不是得到一个漂亮的 JSON,而是检查分析结果是否足以支持这几个问题:
- 哪些文件含有
notes:search,该字符串出现在哪里? Renderer是否通过Preload暴露的 API 发起调用?Main Process是否注册了匹配的通道处理器?- 静态关系中哪些路径明确、哪些只是候选、哪些仍然未知?
- 如果重新实现功能,哪些输入、结果和异常行为需要通过测试确认?
实际输出的图规模、节点和关系取决于 REA 版本及识别覆盖,不要把本文的逻辑示意图当成工具实际运行截图。
4.4 在 Codex / Antigravity 里怎么提问?
在成功安装并确认 REA MCP 工具可用后,可以这样提问:
请检查我本地的
electron-lab,只进行静态分析。先定位搜索输入所在的 Renderer,沿 Preload API 追踪到 IPC 通道和 Main Process 的处理函数。每一项结论请给出文件位置或 Evidence,严格区分已确认关系、推断关系和未知项。最后给出在我自己项目中实现同等功能的设计与测试用例,不执行或修改分析目标。
这比单独问"帮我逆向这个软件"好得多:限定目标、限定工具范围、限定证据标准,并说明最终交付物,Agent 才更容易做出有工程价值的结果。
五、实战二:用 Ghidra 分析自己的 C 程序
Electron 展示的是模块及 IPC 关系。对于本地编译的程序,我们更关心函数、符号、反汇编、伪代码和交叉引用。
准备 discount.c:
c
#include <stdio.h>

int discount_price(int price, int percent) {
    if (price < 0 || percent < 0 || percent > 100) {
        return -1;
    }
    return (price * (100 - percent)) / 100;
}

int main(void) {
    printf("result=%d\n", discount_price(200, 10));
    return 0;
}
在 Linux 上编译并先验证程序行为:
bash
gcc -O0 -g discount.c -o discount-demo
./discount-demo
预期程序结果为 result=180。然后在本地已正确安装并配置 Ghidra 的前提下,运行:
bash
rea doctor --provider ghidra --json
rea analyze ./discount-demo --provider ghidra --json > discount-overview.json
rea function ./discount-demo discount_price --provider ghidra --json > discount-function.json
进一步的 decompile、xrefs 等 CLI 操作需要使用分析器找到的实际函数地址,不能直接复制别人的地址。这一步用于了解编译器如何把高级语言转换为控制流、比较、乘除和返回值逻辑。
这里还要特别区分:反编译得到的是可读伪代码,并非编译前的完整原始 C 文件。 优化级别、符号剥离、内联、架构等都可能改变可恢复的形态。
六、深入原理:REA 为什么能辅助跨层推理?
6.1 从"查找文件"升级为"关系追踪"
普通文本搜索只能告诉你某个字符串出现过。REA 对 JavaScript / Electron 的分析更关注模块关系和数据流,包括静态可识别的 API、IPC、函数引用、参数传递、Promise 流向及相关候选关系。
例如,搜索字符串在 main.js 和 preload.js 都出现,只能说明这两处存在相同文本;只有进一步建立桥接 API、IPC 发送、IPC 处理器等关系,才有理由构建完整调用链。动态生成的通道名、反射调用、混淆代码可能导致关系无法确定,这时应保留为未知项。
6.2 静态结论与运行时事实必须分离
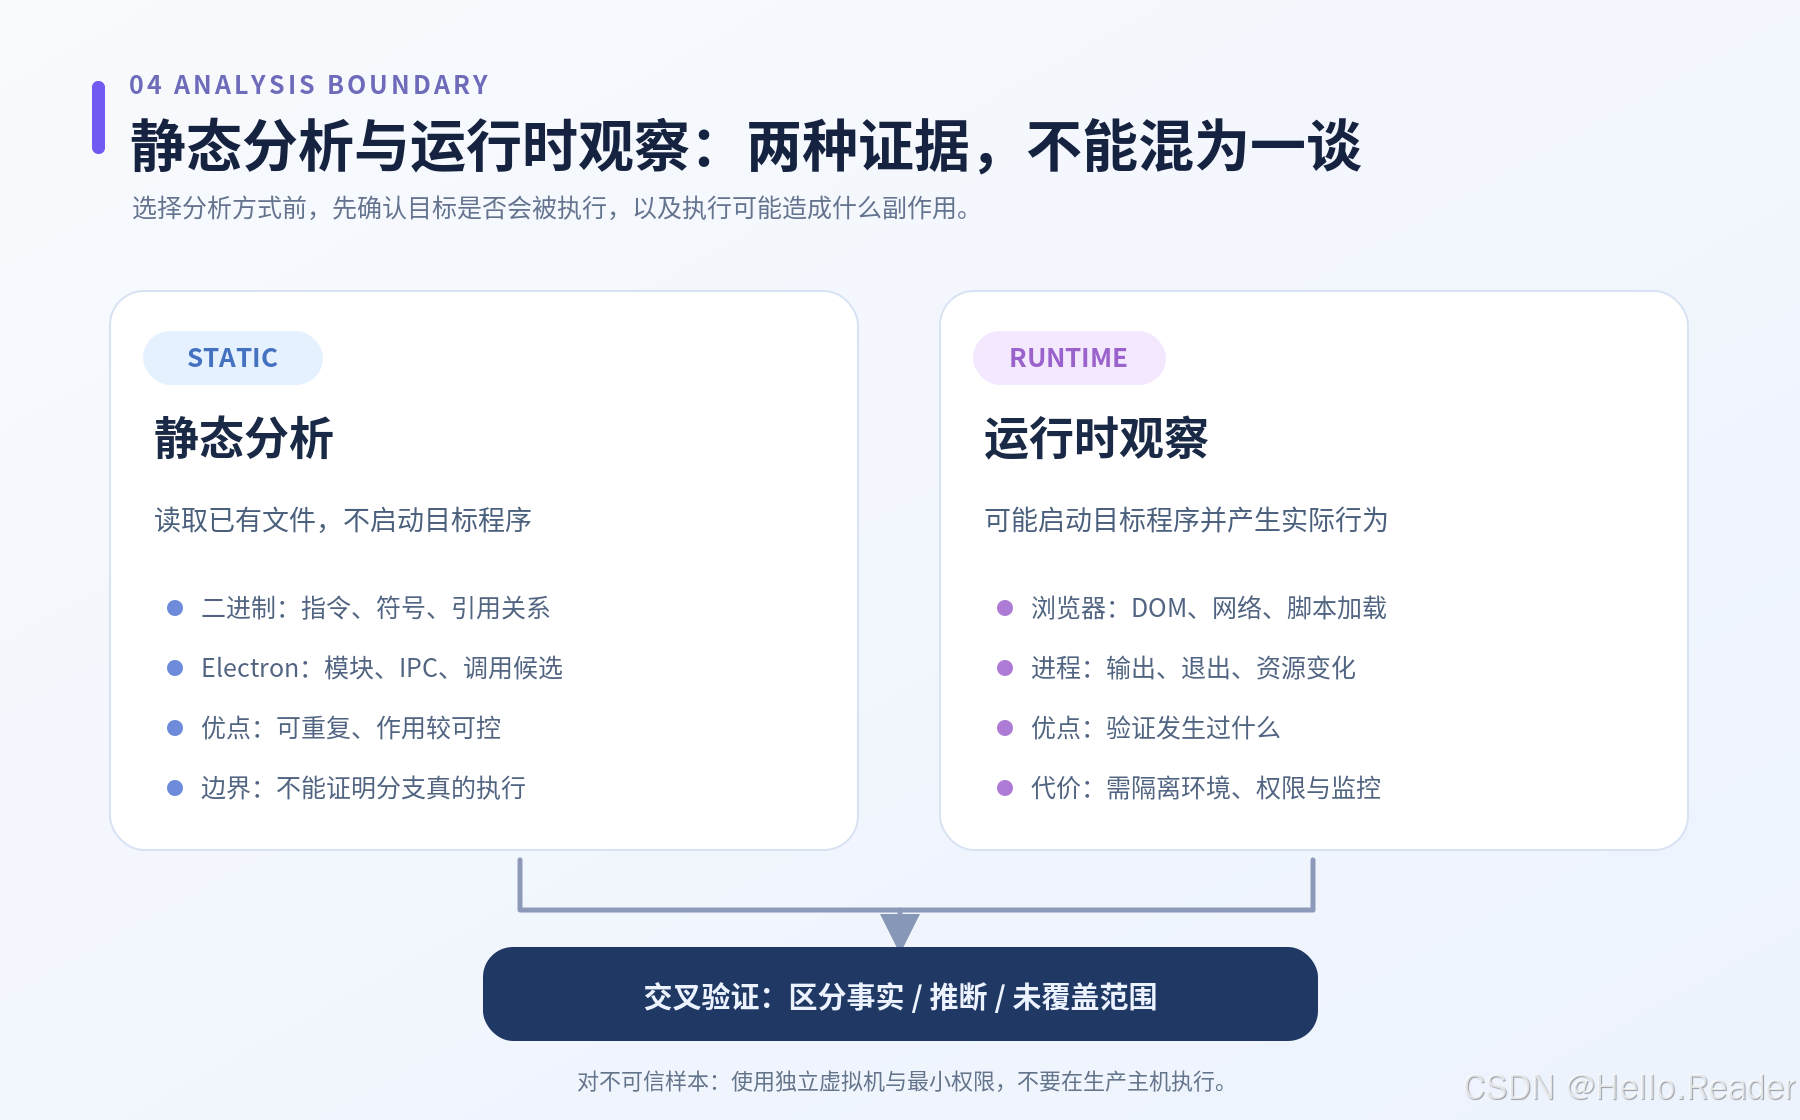
静态分析可以证明某段代码存在、一个字面量在哪里、某些静态引用是否能被定位;它不能单凭代码存在就证明一条路径真实执行过。
运行时观察可以记录已发生的交互、脚本加载或进程行为,但运行观察也有覆盖范围,不代表所有分支都执行过。REA 提供多种静态和运行时能力,适当结合两者才能提高结论可信度。
尤其要注意:JavaScript/Electron 的静态文件分析本身不会运行目标程序;浏览器、进程和某些原生运行时观察工作流可能启动或驱动目标,存在副作用,不应该在未隔离的生产主机上试运行不可信程序。
6.3 Snapshot 缓存解决重复分析,不保证全能缓存
同一个原生二进制可能被反复分析。REA 支持 --snapshot 保存可复用的结果,例如:
bash
rea analyze ./discount-demo --provider ghidra --snapshot ./discount-snapshot.json缓存命中依赖目标文件内容、操作参数、Provider 及设置等条件。它保存的是符合要求的分析结果记录,而不是完整的外部反编译器数据库;新查询仍可能需要启动 Provider。这有助于减少重复工作,但不能直接理解为"第二次分析一定零耗时"。
6.4 什么叫可验证的"功能复现"?
工程交付至少应包括五类内容:输入输出契约、已确认的调用关系、不能确定的行为、独立实现的源代码、可重复执行的测试。实际复现可以选择你自己的技术栈,并不要求照搬反编译出来的每一个函数。
例如 Electron 搜索功能最少需要测试:空关键字、大小写变化、特殊字符、快速连续输入、结果顺序、异常兜底和窗口关闭等。样例代码刻意处理了异步请求乱序问题,这就是"看懂功能以后做工程实现"和"只复制表面效果"的区别。
七、适合哪些项目,不适合哪些场景?
| 具体工作 | 是否推荐 REA | 理由 |
|---|---|---|
| 自研 Electron 应用丢失部分源码 | 推荐 | 可以从打包文件与 IPC 线索入手 |
| 自有 C/C++ 程序的兼容性研究 | 推荐 | 可以借助原生 Provider 找函数与引用 |
| 调查历史版本差异 | 推荐 | 可比较工件与 Evidence,但要核对语义变化 |
| 普通 Java / Rust 源码仓库阅读 | 通常不必 | 有完整源码时,应优先使用正常代码工具 |
| 想自动恢复 100% 原始源码 | 不推荐这样期待 | 逆向结果存在不可恢复信息与不确定性 |
| 未获授权分析第三方敏感软件 | 不适用 | 权限、许可和法律约束不能绕过 |
八、落地建议:如何把 REA 用成一套靠谱的开发流程?
建议从低风险、可验证的目标开始:先用自建 Electron 实验工程验证静态关系,再尝试对自有原生程序做 Ghidra 分析;最后才考虑涉及系统权限、真实用户数据或运行时捕获的复杂目标。
研发团队可以把交付标准定成:每一条逆向结论都包含目标版本、证据位置、分析路径、可信边界、复现代码和测试结果。报告中将"已确认""推断""未覆盖"分开记录;面对动态行为和外部依赖,不做 100% 准确的承诺。
另一个容易忽略的点是隐私:REA 官方说明分析在本机进行,不代表分析结论绝不会被送出本机。当你让云端 AI Agent 阅读 MCP 结果时,结果内容还受该模型服务的数据处理政策约束。 涉及企业敏感文件时,应自行评估脱敏、权限、隔离与本地模型方案。
九、总结
REA 真正值得研究的不是"AI 会逆向"这句口号,而是它背后的工程拆分:
让专业工具负责观察,让关系图负责组织,让 Evidence 负责追溯,让 AI Agent 负责调查与辅助实现,再用测试去验证最终结果。
如果你已经在使用 Codex 或 Antigravity,优先尝试 JavaScript/Electron 的静态示例------接入成本低,容易核对每一步的证据。等这条链路跑通,再使用 Ghidra、Hopper 或 IDA 处理更复杂的原生程序,会更稳妥。
参考资料
- REA 官方仓库:https://github.com/morluto/rea
- 安装与支持客户端:https://github.com/morluto/rea/blob/main/docs/installation.md
- CLI 与 Evidence 使用说明:https://github.com/morluto/rea/blob/main/docs/cli.md
- MCP 返回结果契约:https://github.com/morluto/rea/blob/main/docs/mcp-contracts.md
- JavaScript Application Graph:https://github.com/morluto/rea/blob/main/docs/javascript-application-graph.md
- JavaScript 跨层追踪:https://github.com/morluto/rea/blob/main/docs/javascript-application-workflows.md
- 源码架构图:https://github.com/morluto/rea/blob/main/docs/architecture.mermaid
- 官方 Notion Electron 剪贴板案例:https://rea.tools/showcase/notion/
声明:本文仅讨论自有软件、已获授权的兼容性研究与合法分析。示例源码已完成基础语法/编译检查;未在本次工作环境执行 REA/Ghidra 端到端逆向,因此不展示虚构的真实工具运行结果。