Chapter 1
要训练一个擅长特定领域(如医疗、法律、金融或特定企业业务)的大模型,关键在于"选择合适的落地路径"。
在实际操作中,几乎不需要(也不建议)从零开始训练一个底层基础大模型。业界主流的通用流程可以分为 4 种路径选择 和 5 个核心步骤。
一、 选择适合你的实现路径
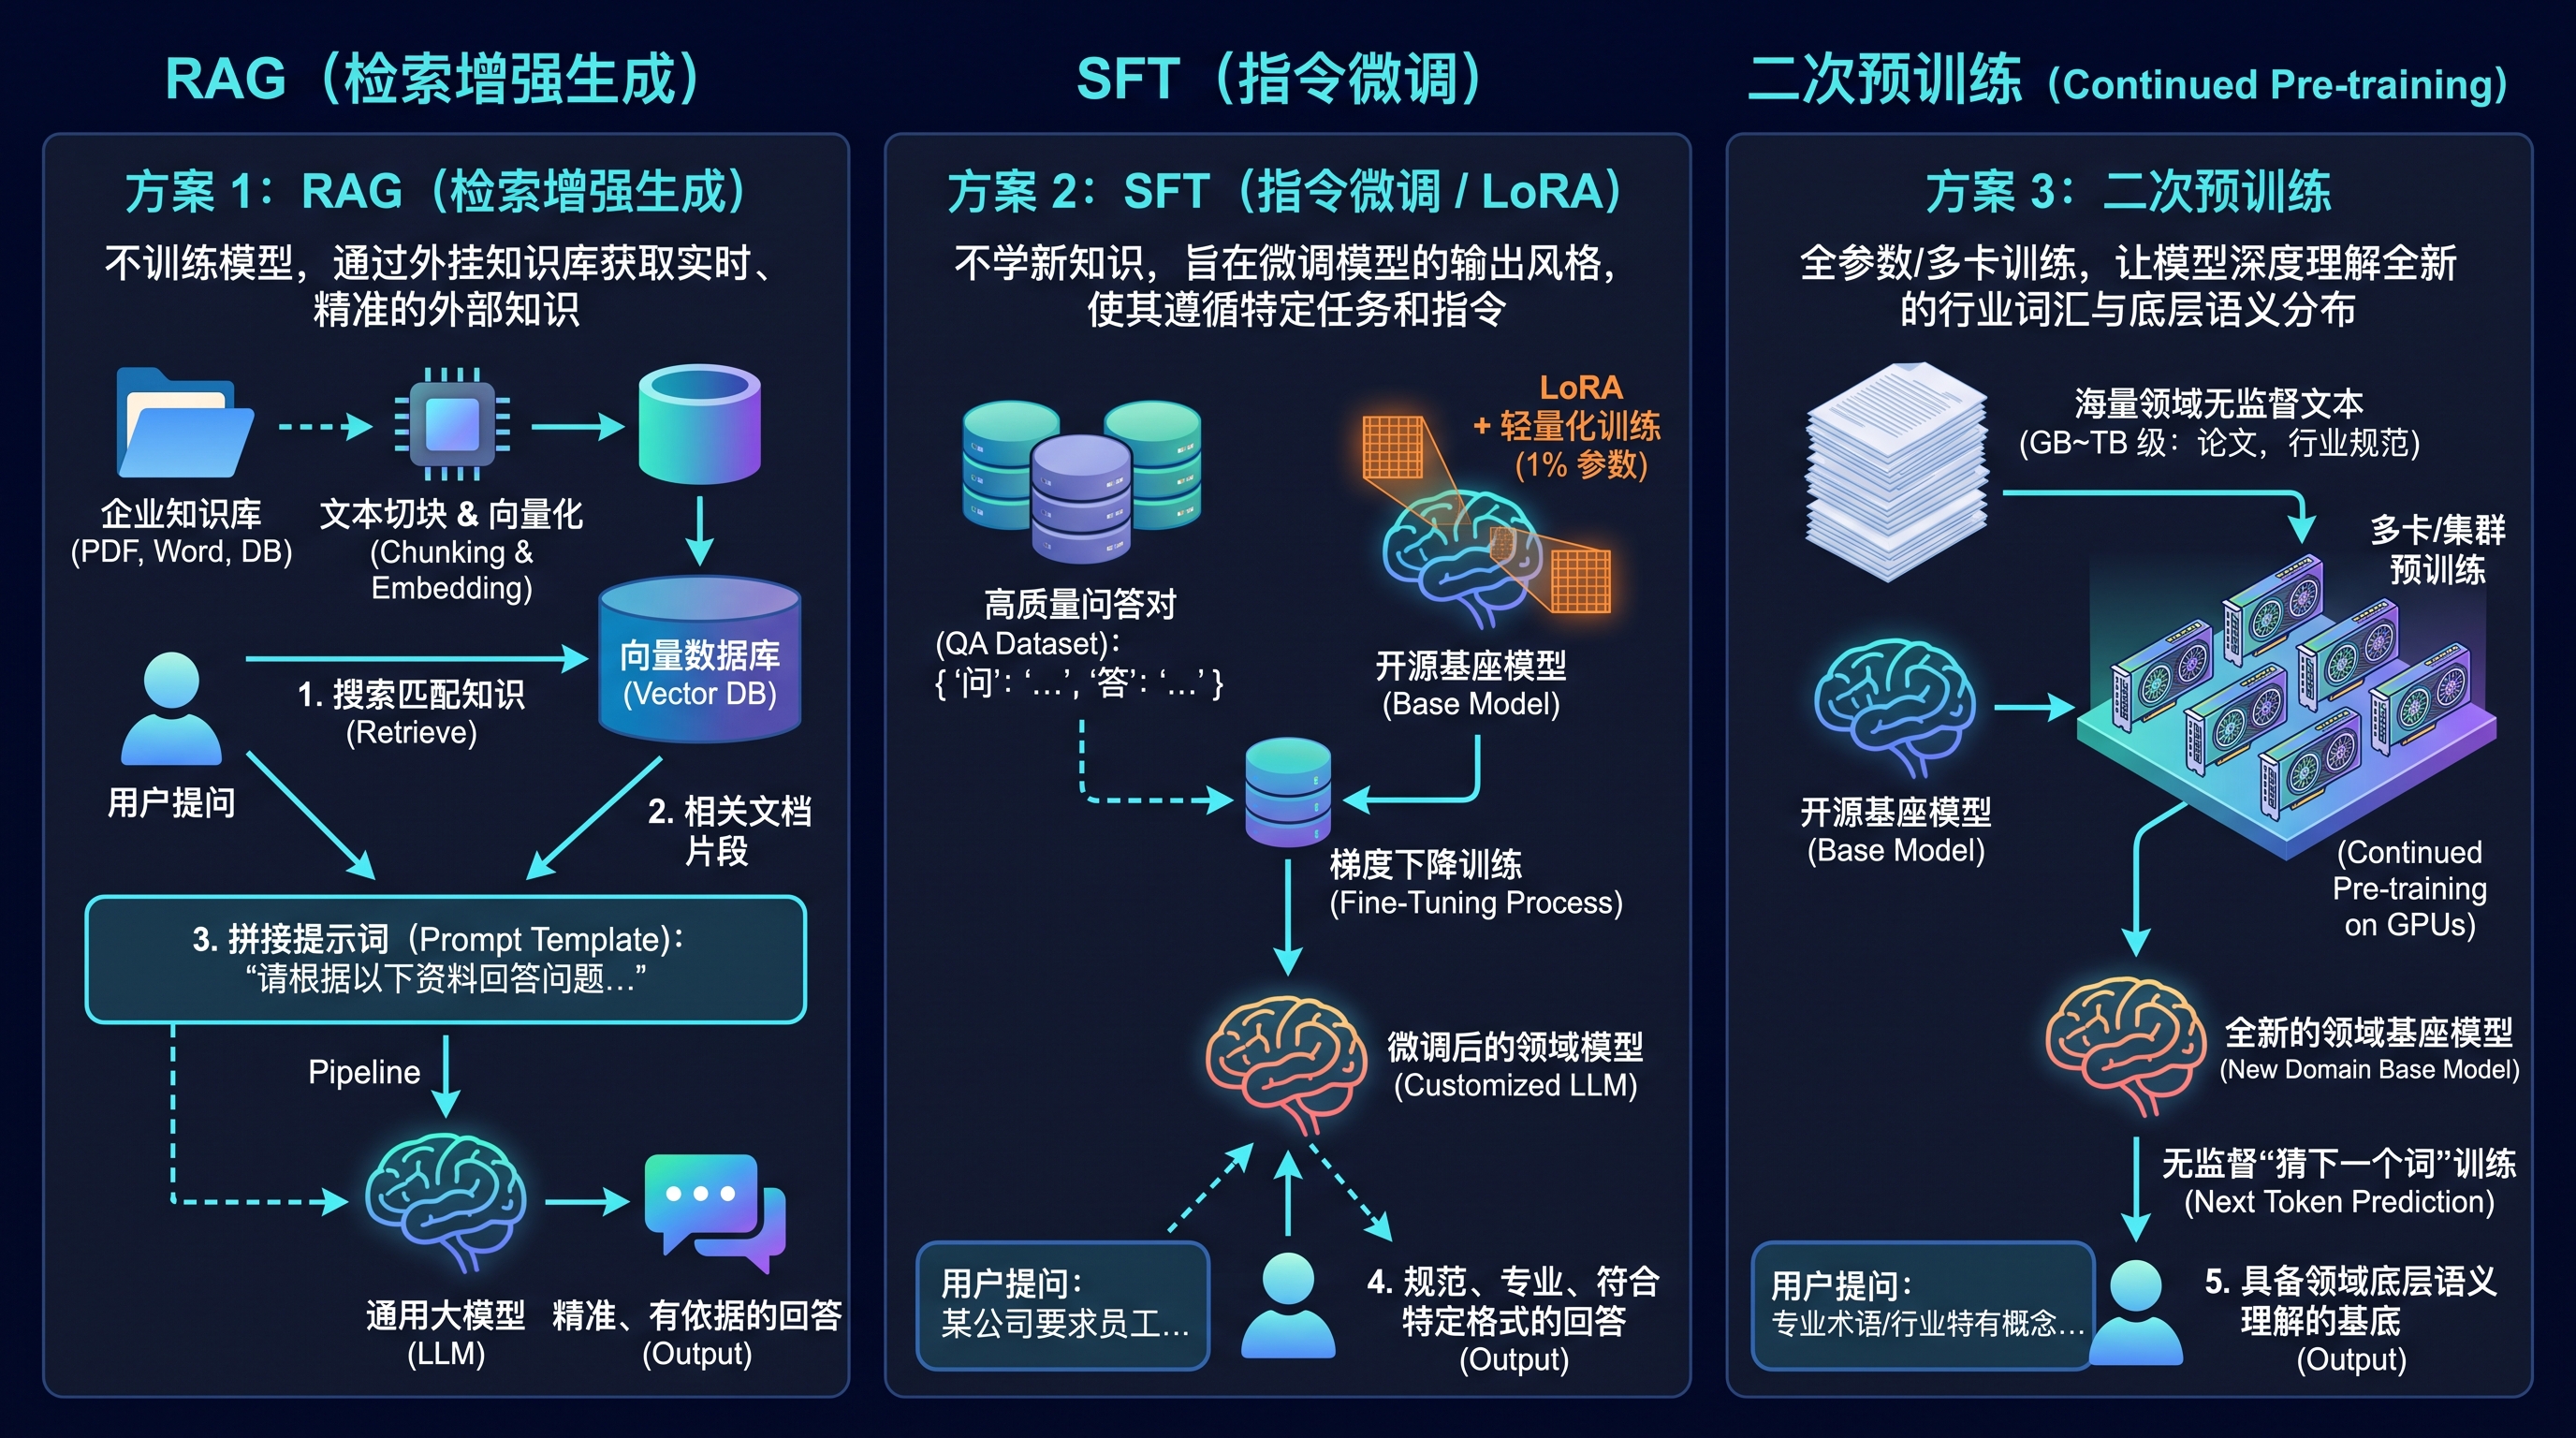
根据领域数据的专业度要求 与预算/算力资源,通常有以下 4 种方案(难度与成本从低到高):
+-----------------------------------------------------------------+
|  1. RAG(检索增强生成):成本最低,即插即用,无幻觉首选            |
+-----------------------------------------------------------------+
                                │
                                ▼
+-----------------------------------------------------------------+
|  2. SFT(指令微调/LoRA):调整输出风格,注入结构化任务能力        |
+-----------------------------------------------------------------+
                                │
                                ▼
+-----------------------------------------------------------------+
|  3. Domain Pre-training(二次预训练):注入海量纯领域私有知识       |
+-----------------------------------------------------------------+
                                │
                                ▼
+-----------------------------------------------------------------+
|  4. Scratch Pre-training(从零预训练):极高成本,仅适合极特殊需求 |
+-----------------------------------------------------------------+- RAG(检索增强生成,最推荐的首选方案)
- 适用场景:领域知识更新快(如政策规章、实时产品文档)、知识库体量大、要求回答有出处且不能有严重"幻觉"。
- 做法:无需修改模型权重,只需将领域文档嵌入向量数据库,每次提问时先检索相关知识,再交给开源基础大模型(如 DeepSeek-R1/V3、Llama 3、Qwen 2.5)结合上下文回答。
- SFT 微调(Supervised Fine-Tuning)
- 适用场景:需要固定特定的输出格式、专业术语风格、特定的推理逻辑(如特定行业的问答 SOP、代码生成、格式化输出)。
- 做法 :基于开源底座,使用少量高性能的领域"问答对"(通常几千到几万条)结合 LoRA / QLoRA 等参数高效微调技术进行训练。
- 二次预训练(Continued Pre-training)
- 适用场景:该领域包含大量通用大模型未曾接触过的非公开专业词汇、语法结构或文档(如特定小语种、未公开的医疗文献或法律卷宗)。
- 做法:将大量领域无标签文本(如成千上万本专业书籍、论文)喂给基础模型继续做自回归预测(Next Token Prediction),让模型在底层理解该领域的语义。
- 从零预训练(Scratch Pre-training)
- 成本极大,需要成百上千卡 GPU 算力及 TB/PB 级别的专业数据,一般仅适合大型科研机构或头部企业。
💡 实操建议 :优先考虑"RAG + SFT"的组合。先用 RAG 提供准确的领域知识支撑,再用 SFT 微调模型语气和推理行为,这能以极低成本达到最高落地性价比。
二、 从零搭建领域大模型的 5 个步骤
如果你决定采用 二次预训练 / SFT 微调 的路线,具体实施分为以下阶段:
步骤 1:准备与清洗领域数据(决定模型上限的核心)
- 无监督文本(用于二次预训练):收集领域的专业书籍、学术论文、行业报告、标准规范等。
- 有监督问答对(用于 SFT) :构建高质量的
{"instruction": "...", "input": "...", "output": "..."}格式数据。 - 数据清洗:
- 去重、去噪声(HTML 标签、乱码)、去除敏感隐私信息。
- 确保回答精准无误------1,000 条人工精心校对的行业高质量数据,效果远胜 100,000 条带有噪声的垃圾数据。
步骤 2:选择合适的基础开源模型(Base Model)
无需从头写网络架构,直接挑选当前表现优秀的开源通用大模型:
- 通用/中文领域:Qwen 2.5(通义千问)、DeepSeek 系列。
- 英文/多语言:Llama 3 系列、Mistral。
- 硬件限制考虑:
- 消费级显卡(如 RTX 3090/4090,24GB 显存):可使用 QLoRA 训练 7B~14B 规模的模型。
- 企业级显卡(如 A100 / H100 / L40S):可进行全参数微调或更大参数规模(32B~72B)的并行训练。
步骤 3:搭建训练框架与配置工具
利用业界成熟的开源轻量化训练框架,无需从零写 PyTorch 代码:
- 推荐框架:
- LLaMA-Factory:目前最流行的开源大模型微调可视化框架,支持绝大多数开源模型及 LoRA/QLoRA/DPO/RLHF 等方法。
- Unsloth:针对 LoRA / QLoRA 训练进行了极极致的显存和速度优化(训练速度可提升 2-5 倍)。
- DeepSpeed / Megatron-LM:适合多卡/多节点分布式大规模型训练。
步骤 4:模型训练与超参数调节
- 轻量化微调(PEFT / LoRA):冻结原模型绝大部分参数,只训练一小部分新增的低秩矩阵(LoRA 模块),大幅降低显存消耗。
- 学习率设置 :微调时的学习率一般比预训练小很多(如 1×10−41\times 10^{-4}1×10⁻⁴ 到 5×10−65\times 10^{-6}5×10⁻⁶),并配合 Warmup 策略。
- 防止过拟合/灾难性遗忘:可以在领域微调数据中混合 10%~20% 的通用能力数据(如通用对话、数学、代码),防止模型训练完后丧失基础的通用语言表达能力。
步骤 5:模型评估、对齐与部署
- 领域评估:构建领域测试集(包含选择题、主观问答题),对比微调前后的准确率、逻辑性与专业度。
- 对齐优化(可选):如果模型回答倾向不符合要求,可用 DPO(直接偏好优化)或 RLHF 进行人类偏好对齐。
- 量化与部署:
- 使用 vLLM 或 Ollama 进行高效推理部署。
- 利用 GGUF 或 AWQ 算法将模型量化(如 4-bit / 8-bit),降至显存可顺畅运行的体积。
三、 落地建议与常见陷阱
- 不要试图用微调解决"事实性知识盲区" :如果模型本身没看过某些最新知识,单纯靠 SFT 强行灌输,极易引发模型"胡说八道"(幻觉)。知识查阅靠 RAG,表达与逻辑靠 SFT。
- 注重领域 Evaluation(评测集)构建:在训练前,先整理出 100~200 个能够代表该领域核心挑战的具体问题和标准答案,作为检验每次迭代效果的锚点。
Chapter 2
为了让整个流程更加直观,我将训练领域大模型的全过程拆解为 4 张核心架构图 、1 个对比表格 以及具体的代码与效果对比,方便你按图索骥。
一、 整体技术路线选型图
在开始前,你需要根据数据类型 和算力预算决定技术方案。请参考下方决策树:
                    ┌────────────────────────┐
                    │    你有领域训练需求    │
                    └───────────┬────────────┘
                                │
                      ┌─────────┴─────────┐
                      │ 知识是否需要实时  │
                      │ 更新或要求零幻觉?│
                      └────┬─────────┬────┘
                        是 │         │ 否
                           ▼         ▼
    ┌───────────────────────┐   ┌───────────────────────────┐
    │  【方案 A】RAG 架构    │   │  你的数据是未整理的纯文本  │
    │  (检索增强,无需训练)  │   │  还是高质量问答对 (QA)?  │
    └───────────────────────┘   └─────┬───────────────┬─────┘
                                      │ 纯文本        │ 问答对
                                      ▼               ▼
                        ┌──────────────────┐ ┌──────────────────┐
                        │【方案 B】二次预训练│ │ 【方案 C】SFT    │
                        │(注入行业新词与知识)│ │(优化问答风格与逻辑)│
                        └──────────────────┘ └──────────────────┘
📌 方案对比一览表
| 维度 | 1. RAG (检索增强生成) | 2. SFT (指令微调 / LoRA) | 3. Continued Pre-training (二次预训练) |
|---|---|---|---|
| 核心目的 | 动态检索新知识,消除幻觉 | 改变模型输出风格、遵循特定指令 | 让模型学习大量全新的领域语言/文本 |
| 显存/算力需求 | 极低(仅需推理显存) | 低(单卡 RTX 3090/4090 即可) | 中到高(需多卡或集群) |
| 数据形式 | PDF、Word、数据库文档 | {"prompt": "...", "response": "..."} 结构化问答 |
成千上万篇纯文本文件 (.txt/.jsonl) |
| 更新成本 | 毫秒级(直接替换文档) | 需重新微调训练 | 需重新预训练 |
二、 最推荐架构:RAG + SFT 联合落地图
在实际工业界落地中,单一技术很难解决所有问题 。最成熟的模式是 "RAG 查知识 + SFT 定风格":
【用户提问】 ──► "解析这份医疗报告..."
                      │
                      ├──────────────────────────────────────────┐
                      ▼                                          ▼
           ┌──────────────────────┐                   ┌──────────────────────┐
           │   1. 向量检索 (RAG)  │                   │  2. 微调模型 (SFT)   │
           └──────────┬───────────┘                   └──────────┬───────────┘
                      │                                          │
                      ▼                                          ▼
            从企业私有知识库中                          已使用 LoRA 训练过
            精准检索出 3 条相关条款                     掌握医疗总结的格式与术语
                      │                                          │
                      └──────────────────┬───────────────────────┘
                                         ▼
                             ┌──────────────────────┐
                             │    拼接 Prompt 提交   │
                             └──────────┬───────────┘
                                        ▼
                             ┌──────────────────────┐
                             │  生成专业、准确的回答  │
                             └──────────────────────┘
三、 SFT 训练数据构造与对比
数据的质量决定了模型的上限。你可以直观感受一下数据格式以及微调前后模型的回答差异:
1. 训练数据格式 (dataset.json)
json
[
  {
    "instruction": "请根据法律法规分析以下行为是否合规:",
    "input": "某公司要求员工每周加班超过 20 小时,且不支付加班费。",
    "output": "【合规判定】违规。\n【法律依据】根据《中华人民共和国劳动法》第三十六条及第四十四条规定,用人单位延长工作时间每日不得超过三小时,每月不得超过三十六小时,且须支付不低于法定标准工资的报酬。"
  }
]
2. 微调前后的效果对比
┌────────────────────────────────────────────────────────────────────────┐
│ 🔴 通用大模型(微调前):                                              │
│ 问:某公司要求员工每周加班超过 20 小时不给加班费,合法吗?            │
│ 答:这听起来不太合理。一般来说劳动法是对加班时间和报酬有要求的,建议你 │
│     找 HR 沟通或者咨询律师看看怎么维权。                               │
├────────────────────────────────────────────────────────────────────────┤
│ 🟢 领域微调模型(SFT 后):                                             │
│ 问:某公司要求员工每周加班超过 20 小时不给加班费,合法吗?            │
│ 答:【法律认定】严重违规。                                             │
│     【具体条款】依据《劳动法》第 36 条及第 44 条:                     │
│     1. 时间超限:每月加班上限为 36 小时,每周 20 小时已超标;          │
│     2. 报酬缺失:延长工作时间须支付不低于 150% 的工资报酬。           │
└────────────────────────────────────────────────────────────────────────┘
四、 从零实操:使用 LLaMA-Factory 进行 LoRA 微调
在实际动手时,无需自己手写 PyTorch 训练循环。利用开源工具 LLaMA-Factory 可以轻松启动训练。
1. 训练数据流与架构
 原始模型 (如 Qwen2.5-7B) ──► [冻结主干权重 ❄️]
                                  │
                                  ├─► 附加小参数矩阵 [LoRA 模块 ⚡] (仅训练 1% 参数)
                                  │
 领域 QA 数据集 ───────────────► [开始 Gradient Descent 训练]
                                  │
                                  ▼
                        输出轻量级 LoRA 权重 (~100MB)
2. 命令行启动训练示例
你可以直接在终端运行以下脚本进行模型微调:
bash
# 运行 LLaMA-Factory 的单卡微调命令
llamafactory-cli train \
    --stage sft \                             # 训练阶段:指令微调
    --model_name_or_path Qwen/Qwen2.5-7B-Instruct \ # 选择基础开源模型
    --do_train true \
    --dataset my_industry_data \              # 指定你的领域数据集名字
    --finetuning_type lora \                  # 使用 LoRA 算法(节省显存)
    --lora_target q_proj,v_proj \             # LoRA 作用的注意力层
    --output_dir ./output/my_domain_model \   # 模型输出路径
    --per_device_train_batch_size 2 \
    --gradient_accumulation_steps 4 \
    --learning_rate 2e-4 \                    # 学习率
    --num_train_epochs 3.0 \                  # 训练轮数
    --quantization_bit 4 \                    # QLoRA 4-bit 量化,24G 显存卡可跑
    --fp16 true
3. 部署与推理 (vLLM 加速)
训练完成后,将 LoRA 权重合并回原模型,使用 vLLM 进行部署,即可提供高并发 API:
python
from vllm import LLM, SamplingParams

# 加载微调后的领域模型
llm = LLM(model="./output/my_domain_model_merged")
sampling_params = SamplingParams(temperature=0.1, max_tokens=512)

# 执行领域推理
prompts = ["请诊断:患者主诉咳嗽 3 天,伴有低烧38°C,胸部 CT 无异常。"]
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(output.outputs[0].text)
💡 总结落地路线图
- 第一周 :收集领域资料,尝试搭建基于 LangChain / LlamaIndex 的 RAG 检索系统(验证知识召回率)。
- 第二周 :清洗 2,000~5,000 条高质量的领域问答数据 (SFT)。
- 第三周 :基于 Qwen2.5 或 DeepSeek ,利用 LLaMA-Factory 进行 QLoRA 微调。
- 第四周 :合并权重,使用 vLLM 或 Ollama 进行打包部署,接入业务端。
Chapter 3
问题 1:RAG 的本质、机制与搭建逻辑
1. RAG 的目的与做了什么?
你的理解非常接近,但不仅是"数据化",更准确地说是"结构化索引 + 动态补充外部记忆"。
大模型的参数(权重)相当于它的"大脑长期记忆"。由于训练成本极高,长期记忆无法频繁更新,且容量有限。RAG(检索增强生成)做的事情,就是给大模型配一个实时可查阅的"外挂图书馆"。
具体做了什么?
- 文档解析与切块(Chunking):把 PDF、Word、数据库里的海量文字按段落(如 500 字一段)切开。
- 向量化(Embedding) :用专门的 Embedding 模型,把这些文字段落转化成一串包含语义信息的数学向量(一串浮点数数值)。
- 存入向量数据库:把向量存入数据库(如 Chroma、Milvus、FAISS)。
- 语义检索 :当用户提问时,把问题也变成向量,在数据库里快速找到语义最相似的 3~5 个文档切块。
2. RAG 与大模型的关系是什么?
大模型在 RAG 里充当的是"具备强大阅读理解和总结能力的顶级研究员"。
- 没有 RAG 的大模型:凭记忆直接回答(容易记错或"瞎编",即幻觉)。
- 有了 RAG 的大模型 :你先去图书馆把相关资料翻出来,摆到它面前说:"请严格根据以下查到的资料,回答用户的提问。如果资料里没写,就回答不知道。"
3. RAG 的输入与输出
- RAG 系统的输入 :用户的问题(例如:"我们公司今年的报销标准是多少?")
- RAG 系统的输出 :基于检索到的参考文档、经由大模型提炼总结后的精准答案(例如:"根据《2026年财务制度》第3条,差旅住宿标准为...")。
4. 如何搭建一个简单的 RAG 系统?
整个流程包含三个核心部分(可以使用 LangChain 或 LlamaIndex 库几行代码搞定):
[原始文档: PDF/Word] ──► 切块 (Chunking) ──► Embedding 模型 ──► 存入向量数据库
                                                                 │
[用户提问] ─────────────► 向量检索 (Find Top-K) ──────────────────┘
                                 │
                                 ▼
                     [拼接 Prompt 提示词]
"已知以下参考资料:
 {检索到的文档片段}
 请回答问题:{用户提问}"
                                 │
                                 ▼
                         [大模型 LLM 生成回答]
问题 2:SFT(指令微调)的本质与深度扩展
1. SFT 的本质是什么?
SFT(Supervised Fine-Tuning,有监督指令微调)的本质是:修改模型的"表达习惯"、"推理行为"和"任务范式",而不是向它灌输大量新知识。
基座模型(Base Model)在预训练后,本质上只是一个"超级接话机"(只学会了根据上文预测下一个词)。如果你问它:"请帮我总结这篇文章 ",它可能会顺着你的话往下接:"这篇文章写得很好..."甚至继续出题,而不是去执行你的命令。
SFT 的本质,就是通过人类示范的"问答对",把这个"接话机"改造为一个"听得懂指令、会按规则办事的 AI 助手"。
2. SFT 具体微调了什么?
- 指令遵循(Instruction Following):学会识别"总结"、"翻译"、"分类"、"抽取"、"格式化"等操作指令。
- 输出结构与风格约束:强行让模型按 JSON、XML 或固定模板(如"【诊断结果】...【建议】...")输出。
- 推理逻辑对齐:通过包含思维链(Chain of Thought)的数据,教模型"先一步步分析,最后再给结论"。
3. SFT 的输入与输出
-
SFT 训练时的输入输出(训练数据格式):
-
Input(输入) :
{"instruction": "指令", "input": "上下文/任务数据"} -
Output(标签/目标) :
{"output": "人类期望的完美标准回答"} -
训练时,损失函数(Loss)只计算 Output 部分的预测误差,以此调整模型的参数。
-
SFT 后的模型在推理时的输入输出:
-
输入:任意符合该指令格式的提示词(Prompt)。
-
输出:高度契合预期风格、遵循特定格式的精准回答。
问题 3:二次预训练(Continued Pre-training)的本质与可行性
1. 二次预训练的本质是什么?
二次预训练的本质是:补充底层无监督的领域词汇量、语义关联与基础知识分布。
基座模型在预训练时看的是全网通用数据(维基百科、新闻、通用网页)。如果你的领域有海量独有的术语(例如医学里的基因序列名称、极冷门的法律条文、企业内部的私有代码库),通用模型对这些词的 Token 化(分词)效率极低,且词与词之间的关联权重是空白的。
二次预训练就是继续让模型做"看文章,猜下一个词"(Next Token Prediction)的无监督学习,让这些行业专业词汇在模型的神经网络深层建立起稳定的权重连接。
2. "基座模型"长什么样子?
从代码和文件层面来看,一个开源的基座模型(如 Qwen2.5-7B-Base、Llama-3-8B)通常是文件夹里的几个文件:
- 模型权重文件(
.safetensors或.bin):包含了百亿级浮点数参数(几十 GB 到上百 GB),这是大模型的"神经元"。 - 分词器(
tokenizer.json/tokenizer.model):负责把输入的文本切分成 Token ID(数字)。 - 架构配置文件(
config.json):定义了这个模型有多少层 Transformer、隐藏层维度是多少等结构信息。
3. 让大模型学习新语言或文本的本质是什么?
本质是调整神经网络中上百亿个矩阵参数的数值 。
当模型阅读成千上万篇行业文本时,它通过对比"自己预测的下一个词"与"实际文章里的下一个词"之间的差距,利用反向传播算法(Backpropagation)微调每一个神经元连接的权重(Weight),使得它对该领域语言的概率分布理解越来越准确。
4. 在自己电脑上能做二次预训练吗?
结论:几乎不可能(或者说极度不划算)。
- 原因一:数据量与算力需求巨大
二次预训练需要处理几 GB 到几 TB 的纯文本 (数十亿到上百亿 Token)。要让模型在这么多数据上更新整个网络的全部权重(全参数训练),单张消费级显卡(如 RTX 4090 24G)的显存和计算速度远远不够。通常需要 8 张以上的 A100/H100 显卡组成的集群训练数天至数周。 - 原因二:灾难性遗忘(Catastrophic Forgetting)
如果你只用少量的领域文本在个人电脑上强行对基座模型做预训练,模型会迅速"学傻"------为了记住你给的新知识,它会彻底破坏原本在通用语料上建立好的逻辑能力和语言表达能力。
💡 总结与建议
| 方案 | 个人/小团队电脑能否完成? | 推荐使用的硬件 | 核心作用 |
|---|---|---|---|
| RAG(检索增强) | 完全可以(普通笔记本电脑即可) | 无需高配 GPU,甚至CPU即可 | 外挂知识库,防幻觉、实时更新 |
| SFT(LoRA微调) | 完全可以(需要单卡 16G-24G 显存,如 RTX 3090/4090) | 单张消费级显卡(QLoRA 算法) | 规范输出格式、定制领域对话风格 |
| 二次预训练 | 无法完成 | 工业级 GPU 集群(8 × A100 及以上) | 注入海量底层行业新词与私有知识 |
最佳策略 :放弃在个人电脑上做"二次预训练"。直接选用目前优秀的通用开源基座(如 Qwen2.5、DeepSeek),在本地显卡上用 LoRA 进行 SFT 微调 来定风格,再配合 RAG 向量数据库 挂载你的行业文档,这是目前性价比最高的方案!
Ok,二次训练对于普通玩家来说确实不太容易搞定,但是,RAG和SFT还是值得玩一玩的,抽空搞搞看具体怎么个回事。