架构设计 相关文档,希望互相学习,**************************** ****************************共同进步
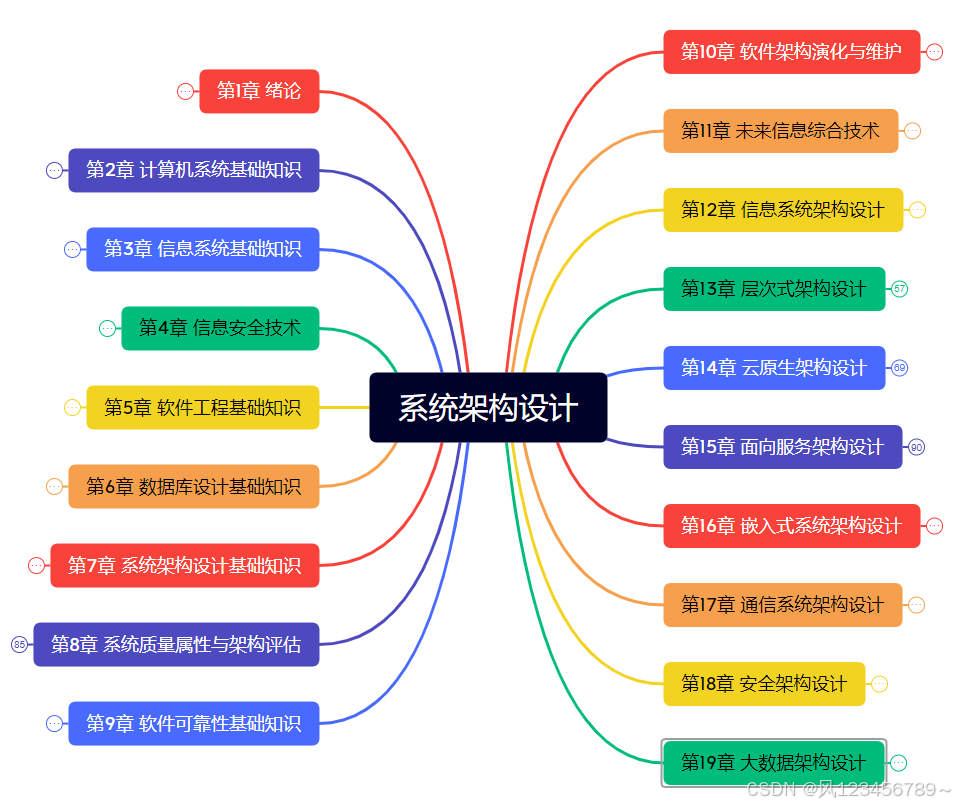
知识总览
每天进步一点点,加油!小伙伴们!💪
目录
[1.10 数据模型的三要素](#1.10 数据模型的三要素)
[1.11 分布式数据库 特性](#1.11 分布式数据库 特性)
[1.12 数据库的完整性规则](#1.12 数据库的完整性规则)
[1.13 结构化方法 软件架构风格](#1.13 结构化方法 软件架构风格)
[1.14 企业战略数据模型](#1.14 企业战略数据模型)
[1.15 软件重构](#1.15 软件重构)
[1.16 数据库事务并发操作](#1.16 数据库事务并发操作)
[1.17 数据库设计核心概念](#1.17 数据库设计核心概念)
习题1 数据库习题知识点
1.1 -1.9 Armstrong公理、数据库设计模式、并发控制等
【架构设计】习题1 数据库题目 1/2 https://blog.csdn.net/weixin_42081167/article/details/167586719
1.10 数据模型的三要素
在数据模型的三要素中,哪一个描述了对象类型的集合,用于表示系统的静态特性( )。
A 数据结构 B 数据操作 C 数据的约束条件 D 数据完整性
解析:
A. 数据结构:正确。数据结构是对象类型的集合,用于描述系统的静态特性。
B. 数据操作:是指对数据库中各种对象实例允许执行的操作集合,不描述静态特性。
C. 数据的约束条件:是指一组完整性规则的集合,不直接描述静态特性。
D. 数据完整性:是数据库的一个特性,不属于数据模型的三要素之一。
知识点:
数据模型是数据特征的抽象,它从抽象层次上描述了系统的静态特征、动态行为和约束条件,为数据库系统的信息表示与操作提供一个抽象的框架。
数据模型的三要素为数据结构、数据操作、完整性约束,其中:
数据结构 :所描述的"对象类型的集合",它定义了系统中所有数据对象的类型、属性以及对象之间的关联关系,是对系统静态特性的完整描述,比如关系模型中的二维表、字段、主外键关联都属于数据结构的范畴 。
数据操作 是对系统动态特性的描述,定义了可对数据执行的增删改查等操作集合;
完整性约束 是一组语义规则集合,用于保障数据的正确性、一致性和有效性,二者都不符合"描述对象类型集合、表示系统静态特性"的要求 。
三个要素是不可拆分的整体:没有数据结构,操作和约束就没有依托;没有数据操作,静态的数据结构完全无法使用;没有完整性约束,数据会快速出现大量逻辑矛盾,彻底失去使用价值 。
1.11 分布式数据库 特性
关于分布式数据库系统的特性,以下描述正确的是( )。
A 数据在物理上集中存储,逻辑上分散管理
B 每个场地都有自治处理能力,但不参与全局应用
C 系统的数据分布存放在网络的不同场地,具有场地透明性
D 只能通过中央服务器执行全局应用,无法进行局部应用
解析:
A. 错误。分布式数据库系统的特性是物理上分散,而非集中存储。
B. 错误。每个场地不仅有自治处理能力,还参与全局应用。
C. 正确。这符合分布式数据库系统的定义,包括物理分布性、场地自治性和场地透明性。
D. 错误。分布式数据库系统允许每个场地完成局部应用,不仅依赖中央服务器。
分布式数据库系统的数据确实分布存放在网络的不同场地,每个场地具有自治处理能力,同时系统具有场地透明性,使用户无需关心数据的具体物理位置。
知识点
分布式数据库是一类物理上分散存储、逻辑上完全统一的数据库系统 ,它将数据拆分存储在多台独立的服务器节点上,通过网络协同对外提供服务,用户使用时完全感知不到数据的分布细节,体验和操作集中式数据库几乎一致,从根源上突破了单机数据库在存储容量、并发性能、可用性上的物理上限 。
基础架构核心特性:物理分布性 、逻辑整体性 、场地自治性
最核心的设计优势,通过多层透明机制彻底屏蔽分布式带来的复杂度,包括:分布透明性、复制透明性、分片透明性
核心本质特征
- 物理分布、逻辑统一 :数据实际分散在不同地理位置的多个独立节点上,所有节点通过网络互联,在用户视角下是一个完整的全局数据库,无需手动处理跨节点数据访问逻辑
- 天然数据分片 :通过水平分片、垂直分片等规则,将全量数据均匀拆分到不同节点,彻底解决单机磁盘容量的物理上限,支持TB甚至PB级海量数据存储 。
- 多副本冗余保障 :每个数据分片默认维护3~5个副本,通过Raft、Paxos等共识算法自动同步数据,任意单个节点故障都不会导致数据丢失,系统可自动完成故障切换,业务几乎无感知 。
核心技术能力
- 透明性屏蔽复杂度 :具备分片透明、位置透明、复制透明、逻辑透明 能力,用户不需要知道数据的物理存储位置、分片规则、副本分布细节,编写应用的逻辑和使用集中式数据库完全一致 。
- 弹性水平扩展 :业务增长时只需新增服务器节点,系统会自动完成数据重平衡,线性提升存储容量和并发处理能力,无需手动修改业务代码、调整分库分表规则 。
- 分布式事务保障 :通过两阶段提交(2PC)、三阶段提交(3PC)等协议,保证跨多个节点的事务依然满足ACID特性,金融、交易类核心场景下也能保证数据一致性 。
运行机制核心特性
- 高可用与高可靠性 :通过多副本冗余设计,当某一个节点发生故障时,系统可以自动切换到其他节点的副本继续提供服务,不会因为单点故障导致整个系统瘫痪,大幅提升系统可用性 。
- 弹性可扩展 :支持透明的水平扩展,通过新增服务器节点就可以线性分担数据存储和处理压力,突破单台服务器的性能上限,轻松适配海量数据和高并发访问场景 。
- 局部应用高性能 :常用的本地数据直接存储在对应场地,本地业务无需跨网络访问远端数据,大幅降低通信代价,局部应用的响应速度远高于远程访问集中式数据库 。
- 全局应用支持 :在支持本地自治的基础上,系统可以通过分布式事务调度,跨多个节点协同完成全局业务操作,实现全库数据的统一共享和全局查询
主流典型产品
目前工业界广泛使用的分布式数据库包括OceanBase、TiDB、CockroachDB、MongoDB分片集群、Google Spanner等,已经大规模落地在电商大促、银行核心交易、全球SaaS服务、物联网时序数据管理等场景,比如OceanBase曾支撑双11峰值6100万TPS的核心交易流量 。
1.12 数据库的完整性规则
第1题 【单选题】
数据库实体的主属性不能取空值,这属于 ( ) 。
A实体完整性
B参照完整性
C用户定义完整性
D数据独立性
解析:
实体完整性是数据模型中约束主键的规则,要求主属性(主键的组成部分)不能为空。
- A正确 :实体完整性的核心定义就是关系的主属性(主键的组成部分)不能取空值 ,主键作为实体的唯一标识,必须保证非空且唯一,才能精准定位表中的每一条记录,完全匹配题干描述 。
- B错误 :参照完整性是针对外键的约束规则,要求外键的取值要么为空,要么必须在其引用的主表主键中存在对应值,维护的是表与表之间的关联逻辑,和主属性非空的要求无关 。
- C错误 :用户定义完整性是用户根据具体业务需求自定义的约束规则,比如限定成绩取值在0~100之间、性别只能为男/女,属于业务层面的自定义校验,并非主属性非空的通用规则 。
- D错误 :数据独立性是指应用程序和数据的逻辑结构、物理存储结构相互解耦的特性,和数据完整性约束完全属于不同的概念范畴,和题干描述无关。
第2题 【单选题】
"软考成绩不能小于0且不能大于75"属于 ( ) 约束条件。
A实体完整性
B参照完整性
C用户定义完整性
D数据一致性
解析:
用户定义完整性是针对具体应用的自定义约束,如成绩范围、年龄限制等。
知识点:
数据库完整性:数据库的完整性是指数据的正确性和相容性
(1)正确性:数据是符合现实世界语义、反映当前实际状况的。如性别只能是男或女
(2)相容性:是指数据库同一对象在不同关系表中的数据是符合逻辑的。如年龄一般都在1-100岁,当然也有超过一百岁的,反正没有两百岁,三百岁成仙的人类
数据库的完整性规则用于确保数据的准确性和一致性,
主要包括三类:实体完整性、参照完整性、用户定义的完整性。
实体完整性要求主键属性非空(如表A的主码a不能为空);
参照完整性约束外键取值必须引用主键或为空(如表B的a需匹配表A的a或为空);
用户定义完整性则由用户自定义业务规则(如价格限定在3000-7000之间)。
自定义业务规则:通过CHECK、UNIQUE等约束实现。例如:
- CHECK约束 :
CHECK (age >= 18)确保年龄符合业务逻辑;- UNIQUE约束 :
UNIQUE (email)避免重复邮箱注册;- DEFAULT约束 :
DEFAULT (0)为数值字段提供缺省值。空值(NULL)的处理差异:
- 实体完整性禁止主键为空,而参照完整性允许外键为空(表示"无关联");
- 用户定义完整性中,空值可能触发约束失效(如
CHECK (price > 0)时NULL会被忽略)。
1.13 结构化方法 软件架构风格
第1题 【单选题】
结构化方法属于(作答此空 )的开发方法。它是目前最成熟、应用较广泛的一种工程化方法。但与此同时,该方法也存在着一定的局限性。 ( )不属于结构化方法的主要不足和局限性。
第一空:A自顶向下 B敏捷 C数据驱动 D自底向上
第二空:
A不适合于数据处理领域的问题
B开发周期长
C很少考虑数据结构
D难以适应需求变化
解析:
结构化方法也称为生命周期法,是一种传统的信息系统开发方法,由结构化分析、结构化设计和结构化程序设计 三部分组成,其精髓是自顶向下、逐步求精和模块化设计.
结构化方法的主要特点是:开发目标清晰化、开发工作阶段化、开发文档规范化和设计方法结构化.
结构化方法特别适合于数据处理领域的问题,但是不适应于规模较大、比较复杂的系统开发。 缺点是开发周期长、难以适应需求的变化、很少考虑数据结构.
第2题 【单选题】
软件架构风格描述某一特定领域中的系统组织方式和惯用模式,反映了领域中众多系统所共有的( )特征。对于语音识别、知识推理等问题复杂、解空间很大、求解过程不确定的这一类软件系统,通常会采用( )架构风格。对于因数据输入某个构件,经过内部处理,产生数据输出的系统,通常会采用( )架构风格。
第一空:
A语法和语义 B结构和语义 C静态和动态 D行为和约束
第二空:
A管道-过滤器 B解释器 C黑板 D过程控制
第三空:
A事件驱动系统 B黑板 C管道-过滤器 D分层系统
解析:
体系结构风格反映了领域中众多系统所共有的结构和语义特性,并指导如何将各个模块和子系统有效地组织成一个完整的系统。对软件体系结构风格的研究和实践促进对设计的重用,一些经过实践证实的解决方案也可以可靠地用于解决新的问题。如某人把系统描述为"客户/服务器"模式,则不必给出设计细节,我们立刻就会明白系统是如何组织和工作的。
语音识别、知识推理这类场景的核心特征是问题复杂、解空间极大、求解路径完全不确定,没有固定的线性算法可以直接得到结果。黑板架构通过多个独立知识源围绕共享的"黑板"数据空间协作,逐步生成、迭代部分解,最终收敛得到最终结果,是这类场景的经典适配架构风格 。
"数据输入某个构件,经过内部处理,产生数据输出"完全匹配管道-过滤器架构的核心特征:每个独立的处理单元就是"过滤器",负责接收输入数据、内部加工后输出结果,不同过滤器之间通过管道传递数据流,非常适合批处理、数据转换类系统 。
知识点:
软件架构风格的核心定义就是描述特定领域的系统组织惯用模式,提炼出该领域所有系统共通的结构和语义特征,直接指导模块和子系统的组织方式,实现成熟架构方案的复用 。
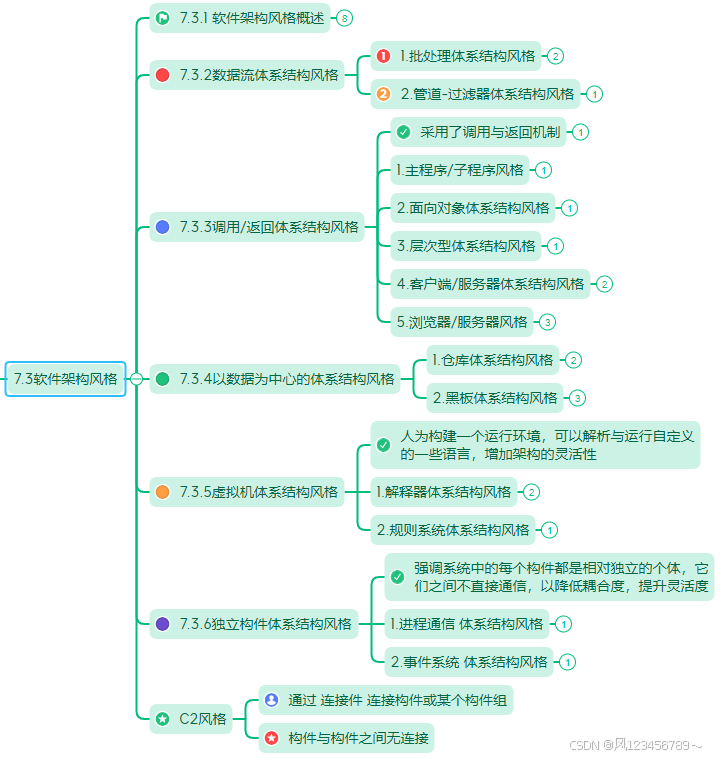
(1) 数据流风格这类风格以数据流转为核心驱动,数据在独立处理单元间单向流动完成业务逻辑:
管道-过滤器 :每个过滤器是独立的数据处理单元,通过管道连接形成处理链,过滤器之间无共享状态,仅通过管道传递数据流,支持并行执行。典型应用场景包括编译器、Linux命令行工具链、ETL数据清洗流程、图像视频处理流水线 。
批处理架构 :数据以整体批量方式输入,处理步骤顺序执行,每个步骤读取上一阶段的全部输出,全程无用户交互,通常在系统空闲时段定时触发。适合PB级海量日志离线分析、银行夜间批量对账等场景,资源利用率可控,事务完整性容易保障 。
(2) 调用/返回风格
这是企业级应用最常用的架构类别,以分层调用为核心组织逻辑:
**主程序/子程序风格:**采用单线程控制,把问题划分为若干处理步骤,构件即为主程序和 子程序。
**面向对象体系结构风格:**构件是对象,即抽象数据类型的实例。
层次型体系结构风格:将系统按职责垂直划分为表现层、业务逻辑层、持久层、数据库层,上层仅依赖下层服务,互不越权调用。结构清晰、耦合度低,不同团队可并行开发各层组件,是金融、政务等合规性要求高的行业系统的标准选型 。
客户端/服务器体系结构风格: 二层 C/S 模式、三层 C/S 模式
浏览器/服务器风格(B/S)
(3) 以数据为中心的体系结构风格
黑板架构 :由共享的"黑板"数据空间和多个独立知识源组成,知识源围绕黑板数据逐步迭代生成部分解,最终收敛得到最终结果。专门适配语音识别、知识推理这类解空间极大、求解路径不确定的复杂问题,没有固定线性算法可以直接得到结果的场景 。
仓库体系结构风格: 存储和维护数据的中心场所,由中央数据结构(说明当前数据状态) 和一组独立构件(对中央数据进行操作)组成。
(4) 虚拟机体系结构风格
解释器体系结构风格: 被用来建立一种虚拟机以弥合程序语义与硬件语义之间的差异。
缺点 是:执行效率较低,典型例子是专家系统。
规则系统体系结构风格:包括知识库、规则解释器、规则/数据选择器及工作内存(程序 运行存储区).
(5)独立构件体系结构风格
进程通信体系结构风格:构件是独立的过程,连接件是消息传递。
事件驱动架构:以事件为核心驱动业务流转,组件通过发布-订阅事件实现通信,无需硬编码依赖。当系统触发指定行为后,自动发布事件,所有订阅该事件的组件异步响应处理。组件解耦彻底、并发性能极强,适合多系统对接、异步业务联动频繁的场景,比如电商订单状态变更后自动触发库存扣减、短信通知等后续流程 。
1.14 企业战略数据模型
企业战略数据模型可分为两种类型:( )描述日常事务处理中的数据及其关系;( )描述企业管理决策者所需信息及其关系。
第一空:
A元数据模型 B数据库模型 C数据仓库模型 D组织架构模型
第二空:
A元数据模型 B数据库模型 C数据仓库模型 D组织架构模型
解析:
第一空选B(数据库模型):数据库模型面向日常事务处理场景,对应OLTP系统,专门存储业务运行过程中产生的实时事务数据,承载日常业务操作的数据交互需求,精准匹配"描述日常事务处理中的数据及其关系"的题干要求 。
第二空选C(数据仓库模型):数据仓库模型是面向主题、集成、相对稳定、反映历史变化的数据集合,整合多源历史业务数据,专门为企业管理决策分析提供所需的信息及关联关系,对应OLAP分析场景,完全匹配"描述企业管理决策者所需信息及其关系"的要求 。
A 元数据模型:描述数据属性、定义数据规范,不直接对应事务处理或决策分析的主体数据需求;
D组织架构模型用于描述企业组织层级、岗位权责等关系,不属于企业战略数据模型的分类范畴 。
知识点:
企业战略数据模型分为:数据库模型、数据仓库模型。
(1)数据库模型:用来描述日常事务处理中的数据及其关系;
(2)数据仓库模型:则描述企业高层管理决策者所需信息及其关系。在企业信息化过程中,数据库模型是基础,一个好的数据库模型应该客观地反映企业生产经营的内在联系。数据库是办公自动化、计算机辅助管理系统、开发与设计自动化、生产过程自动化、Intranet的基础和环境。
1.15 软件重构
Software architecture reconstruction is an interpretive, interactive, and iterative process including many activities. ( )involves analyzing a system's existing design and implementation artifacts to construct a model of it. The result is used in the following activities to construct a view of the system. The database construction activity converts the ( ) contained in the view into a standard format for storage in a database. The ( )activity involves defining and manipulating the information stored in database to reconcile, augment, and establish connections between the elements. Reconstruction consists of two primary activities: ( ) and ( ). The former provides a mechanism for the user to manipulate architectural elements, and the latter provides facilities for architecture reconstruction.
第一空:
A、Reverse engineering B、Information extraction
C、Requirements analysis D、Source code analysis
第二空:
A、actors and use cases B、processes and data
C、elements and relations D、schemas and tables
第三空:
A、database normalization B、schema definition
C、database optimization D、view fusion
第四空:
A、architecture analysis and design B、domain analysis and static modeling
C、visualization and interaction D、user requirements modeling
第五空:
A、pattern definition and recognition B、architecture design and implementation
C、system architecture modeling D、dynamic modeling and reconstruction
解析:
- 第一空:Information extraction(信息提取)
完全匹配题干描述:通过分析系统现有的设计、实现工件(源代码、文档等),从中提取信息并构建出系统的初步模型,输出结果用于后续生成系统视图,是架构重构流程的第一步核心动作 。- 第二空:elements and relations(元素与关联关系)
数据库构建环节的核心任务,就是把系统视图中包含的所有架构元素、以及元素之间的交互关联关系,转换为数据库可存储的标准结构化格式,为后续的架构分析提供数据基础 。- 第三空:view fusion(视图融合)
该环节负责操作数据库中存储的结构化架构信息,完成多源视图的校验、信息补全,梳理并建立不同架构元素之间的完整关联链路,最终形成统一的全局架构视图 。- 第四空:visualization and interaction(可视化与交互)
对应题干中"为用户提供操作架构元素的机制"的描述,通过可视化界面让用户直观查看、编辑、调整架构元素,是面向用户的交互入口 。- 第五空:pattern definition and recognition(模式定义与识别)
对应题干中"为架构重构提供底层支撑设施"的描述,通过预定义的架构模式规则,自动从结构化数据中识别出系统中隐含的经典架构风格、设计模式,完成最终的架构还原
知识点
软件架构重构是一个解释性、交互式和反复迭代的过程,包括了多项活动。信息提取通过分析系统现有设计和实现工件来构造它的模型。其结果用于在后续活动中构造系统的视图。数据库构建活动把模型中包含的元素和关系转换为数据库中的标准存储格式。视图融合活动包括定义和操作数据库中存储的信息,理顺、加强并建立起元素之间的连接。
重构由两个主要活动组成:可视化和交互记及模式定义和识别。前者提供了一种让用户操作架构元素的机制,后者则提供了用于架构重构的设施.
1.16 数据库事务并发操作
习题:
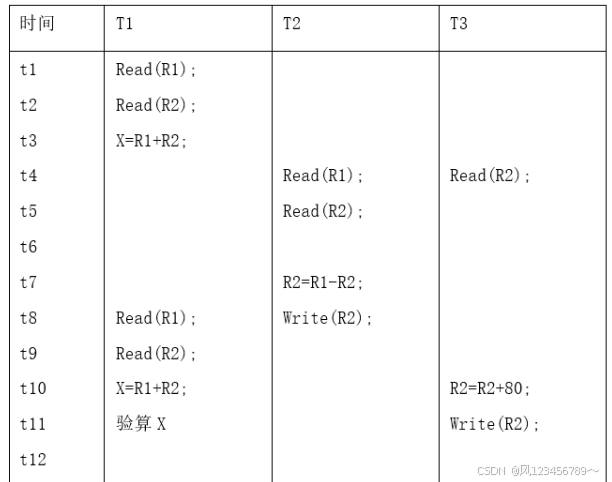
系统中有三个事务T1、T2、T3分别对数据R1和R2进行操作,其中R1和R2的初值R1=120、R2=50。假设事务T1、T2、T3操作的情况如下图所示,图中T1与T2间并发操作( ) 问题,T2与T3间并发操作( ) 问题。
第一空:A、存在T1不能重复读的 B、存在T2读"脏"数据的
C、不存在任何 D、存在T1丢失修改的
第二空:
A、不存在任何 B、存在T2读"脏"数据的
C、存在T2丢失修改的 D、存在T3丢失修改的
解析:
分析T1与T2的并发操作:
T1在t1~t3时刻读取R1=120、R2=50,计算得到X=170;在t8~t9时刻T2已经完成了对R2的修改并写入,此时T1重新读取的R2是T2修改后的新值,两次读取同一数据R2得到了不一致的结果,最终验算X时前后两次R1+R2的结果不相等,这属于不可重复读 问题:同一事务内对同一数据的两次读取过程中,该数据被其他事务修改并提交,导致两次读取结果不一致。
分析T2与T3的并发操作:
T2在t5时刻读取了R2的初值50,在t7时刻计算得到R2=120-50=70,t8时刻将R2=70写入;而T3在t4时刻读取了R2的初值50,在t10时刻计算得到R2=50+80=130,t11时刻将R2=130写入。T3的写入操作覆盖了T2对R2的修改,导致T2对R2的更新操作丢失,这属于**丢失修改(覆盖未提交更新)**问题:两个事务先后读取同一数据并修改,后完成写入的事务的修改覆盖了先完成写入的事务的修改,导致前者的更新丢失。
答案: T1与T2间并发操作存在 不可重复读问题,
T2与T3间并发操作存在 **丢失修改(丢失更新)**问题。
1.17 数据库设计核心概念
During the systems analysis phase, you must decide how data will be organized, stored, and managed. A( )is a framework for organizing, storing, and managing data. Each file or table contains data about people, places, things, or events. One of the potential problems existing in a file processing environment is( ), which means that data common to two or more information systems is stored in several places.
In a DBMS, the linked tables form a unified data structure that greatly improves data quality and access. A(n)( )is a model that shows the logical relationships and interaction among system entities. It provides an overall view of the system and a blueprint for creating the physical data structures.( )is the process of creating table designs by assigning specific fields or attributes to each table in the database. A table design specifies the fields and identifies the primary key in a particular table or file. The three normal forms constitute a progression in which( )represents the best design. Most business-related databases must be designed in that form.
第一空:
A、data entity B、data structure C、file collection D、data definition
第二空:
A、data integrity B、the rigid data structure
C、data redundancy D、the many-to-many relationship
第三空:
A、entity-relationship diagram B、data dictionary
C、database schema D、physical database model
第四空:
A、Normalization B、Replication C、Partitioning D、Optimization
第五空:
A、standard notation form B、first normal form
C、second normal form D、third normal form
解析:在系统分析阶段,需要确定数据如何组织、存储和管理。数据结构是用于组织、存储和管理数据的一个框架。每个文件或表包含了关于人物、地点、事物和事件的数据。文件处理场景中存在的潜在问题之一是数据冗余,意味着两个或多个信息系统中相同数据存储在多个不同位置。
在关系数据库管理系统(DBMS)中,相互链接的表格形成了一个统一的数据结构,可以大大提升数据质量和访问。实体联系图是一个模型,显示了系统实体之间的逻辑关系和交互。它提供了一个系统的全局视图和用于创建物理数据结构的蓝图。
规范化是通过为数据库中的每个表分配特定的字段或属性来创建表设计的过程。表设计是在特定表或文件中确定字段并标识主键。三种范式构成了一个序列,其中第三范式代表了最好的设计,大部分与业务相关的数据库必须设计成这种形式。
A:data entity(数据实体)B:data structure(数据结构)
C:file collection(文件收集)D:data definition(数据定义)
A:data integrity(数据完整性)B:the rigid data structure(刚性数据结构)
C:data redundancy(数据冗余)D:the many-to-many relationship(多对多关系)
A:entity-relationship diagram(实体联系图)
B:data dictionary(数据字典)C:database schema(数据库架构)
D:physical database model(物理数据库模型)
A:Normalization(规范化)B:Replication(复制)
C:Partitioning(分区)D:Optimization(优化)
A:standard notation form(标准表示形式)B:first normal form(第一范式)
C:second normal form(第二范式)D:third normal form(第三范式)
第一空:根据题干描述"是用于组织、存储和管理数据的框架,每个文件或表包含关于人、地点、事物或事件的数据",结合数据库领域的标准定义,此处对应的术语是Data structure(数据库/数据结构,结合上下文准确表述为Database,更贴合系统分析阶段的语境) ,准确来说符合定义的标准术语是
Database。第二空:题干描述"两个或多个信息系统共有的数据在多个不同位置重复存储",这是文件处理环境的典型问题,对应经典术语**Data redundancy(数据冗余)**。
第三空:题干描述"展示系统实体之间的逻辑关系和交互,提供系统全局视图、作为创建物理数据结构蓝图的模型",完全符合**Entity-Relationship Diagram (ERD,实体关系图/ER图)**的标准定义。
第四空:题干描述"通过为数据库中的每个表分配特定字段或属性来创建表设计的过程,指定字段并标识主键",这个数据库设计阶段的流程是**Normalization(规范化/范式化)**。
第五空:题干描述"三个范式构成递进关系,代表最优设计,绝大多数业务数据库都需要遵循该形式",在1NF、2NF、3NF的递进体系中,**Third normal form (3NF,第三范式)**是满足业务数据库通用设计要求的最优范式。
- Database(数据库)
是专门用来组织、存储、管理共享数据的完整框架,它把不同业务对应的实体(人、地点、事物、事件)的数据拆分成独立的文件/二维表统一管理,替代传统零散的独立文件存储模式,是所有数据操作的底层载体。- Data redundancy(数据冗余)
指同一个数据在多个不同位置重复存储的现象。在早期无统一管控的文件处理环境里,不同业务系统各自存储自己需要的同名数据,比如企业的员工信息同时在OA系统、薪资系统、考勤系统里各存一份,就属于典型的非必要冗余,会引发存储空间浪费、多份数据更新不同步导致数据不一致的问题。当然工程里也会有意设计合理冗余,比如分布式系统多副本备份,用来提升可用性和查询性能。- Entity-Relationship Diagram(ER图/实体关系图)
是数据库设计阶段的核心逻辑模型:把现实业务里的所有实体(比如学生、课程、订单)、实体的属性、实体之间的关联关系(比如学生和课程的选课关系)用图形化方式表达出来,相当于整个数据库的设计蓝图,完全不涉及底层用什么数据库、怎么建表的物理实现细节,只定义全局的逻辑数据结构。- Normalization(规范化/范式化)
是数据库设计的核心流程:通过拆分表、合理分配每个表的字段、定义主键和外键,把零散的字段规整到不同的表中,目的是消除不必要的有害数据冗余,避免数据插入、删除、更新时出现异常,保证数据一致性。- Third Normal Form(3NF,第三范式)
关系型数据库的范式是递进的设计规则:第一范式要求字段不可拆分,第二范式要求消除非主键字段对主键的部分依赖,第三范式要求彻底消除非主键字段之间的传递依赖 ,是绝大多数业务数据库通用的最优设计规范,既可以最大程度消除有害冗余,又不会因为过度拆分表导致查询效率过低,几乎所有企业级业务系统的数据库都会遵循第三范式设计。
ok, 今天就到这里吧 🤗
相关系列文章,欢迎点赞、收藏,提供意见!****
计算机系统基础知识 1分:概述、计算机硬件、计算机软件
操作系统 3分:进程管理、存储管理、文件管理、设备管理
数据库技术 3分:数据库设计、关系代数、范式、事务并发、数据库安全、新技术
嵌入式技术 3分:嵌入式硬件、嵌入式操作系统、嵌入式软件开发
计算机网络 3分(超纲较多):OSI七层模型、TCP/IP协议族、网络生命周期、IP地址
其他计算机系统基础知识 1分:计算机语言、多媒体、系统工程
系统性能 1分:性能指标、性能设计
信息系统基础知识 3分:信息系统生命周期、开发方法、五大典型系统
信息安全技术基础 5分:安全属性、信息安全技术、网络安全技术、安全协议
软件工程 12分:概述、需求工程、系统设计、运维、测试、基于构件;
面向对象技术 3分:面向对象基础、分析设计、UML关系、图
项目管理 1分:进度管理、配置管理、质量管理、风险管理
系统架构设计 20分:架构概念、生命周期、ABSD、DSSA、架构风格、
架构复用、质量属性、架构评估
软件可靠性 2分:可靠性建模、软件可靠性设计
软件架构的演化和维护1分:架构演化分类、评估、面向对象架构演化
未来信息综合技术 3分:信息物理系统、人工智能、边缘计算、机器人、数字李生、云计算
数学与经济管理 2分:最小生成树、最短路径、网络与最大流量、线性规划、决策论
知识产权和标准化 2分:知识产权属性、保护期限、产权人确定、侵权判定
专业英语 5分:完形填空,大学英语3级难度,自学
|--------------------------------------------------------------------------------------------------------------------------------------|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 【架构专栏】架构考试介绍 | 【架构专栏】架构知识点 |
| 【架构专栏】第1章 绪论 | 【架构专栏】第11章 未来信息综合技术 |
| 【架构专栏】第2章 计算机基础知识 | 【架构专栏】第12章 信息系统架构设计理论与实践 |
| 【架构专栏】第3章 信息系统基础知识 | 【架构专栏】第13章 层次式架构设计理论与实践 |
| 【架构专栏】第4章 信息安全技术基础知识 | 【架构专栏】第14章 云原生架构设计理论与实践 |
| 【架构专栏】第5章 软件工程基础知识 | 【架构专栏】第15章 面向服务架构设计理论与实践 |
| 【架构专栏】第6章 数据库设计基础知识 | 【架构专栏】第16章 嵌入式系统架构设计理论与实践 |
| 【架构专栏】第7章 系统架构设计基础知识 | 【架构专栏】第17章 通信系统架构设计理论与实践 |
| 【架构专栏】第8章 系统质量属性与架构评估 | 【架构专栏】第18章 安全架构设计理论与实践 |
| 【架构专栏】第9章 软件可靠性基础知识 | 【架构专栏】第19章 大数据架构设计理论与实践 |
| 【架构专栏】第10章 软件架构的演化和维护 | 【架构专栏】补充1 知识产权和标准化 【架构专栏】补充2 数学与经济管理 |
[架构专栏 知识点]
希望有所帮助,互相学习、共同进步,欢迎点赞、收藏!