04 · 分组量化 GEMM 内核
一句话 :一个内核同时服务 decode(M=1)与 prefill(M=32),用「每线程固定几列、沿 K 扫」的映射让权重按 warp 满事务读、激活广播;用 z-split 把小 M 的欠填充网格补满,且只发一次 launch。 前置 :建议先读 第 03 篇 · 权重条带缓存与融合权重。 环境:x86-64 + NVIDIA RTX 5090(sm_120)· 阶段一 2B 稠密(Qwen3-VL-2B q8)。
一、问题与结论
| 问题 | 做法 | 判定 |
|---|---|---|
| 一个内核怎么同时吃 decode 与 prefill? | 同一映射,M 走行、n 走列;decode 时靠 z-split 补并行度 | 实测可行 |
| 权重与激活各怎么访存? | 权重按 warp 满事务读、激活一次读全 warp 广播 | 实测(权重密集、激活广播) |
| 小 M 网格欠填充怎么办? | 沿 group 轴切 z,一次 launch 完成所有 slice | 实测(避免 launch 串行) |
| 小投影该不该 offload? | FLOP 门槛 1e7 自动把太小的留在 CPU |
实测(见下节反直觉表) |
二、背景
要算的东西是逐块点积再乘 scale:
css
out[m][n] = Σ_g a_scale[m][g] · b_scale[n][g] · ( Σ_{k ∈ block g} Aq[m][k] · Wq[n][k] )G:分组宽度(Q8_0/Q4_0 是 32)。prec:0 = int8 权重码[-127,127](Q8_0),1 = int4[-8,7](Q4_0 nibble 已解包)。- 整数点积必须整组完成再乘 scale------这是精确量的划分,不能被拆开。
头文件的 contract 与此一致(include/npu/cuda/vllm_cuda.h):布局与 RK3588 NPU 完全相同,所以同一份 strip-cache artifact 喂两个后端;而内核是「对 K 的普通归约」,天然支持 M==1------这正是它相对 NPU cube(要求 M==0 mod 4、无法服务 decode)的结构性收益。
三、核心机制
3.1 两代内核:int8 激活 → float 激活
| 内核 | 激活输入 | 用在哪 |
|---|---|---|
k_gw_gemm |
int8 Aq + float asc |
早期 prefill offload |
k_gw_gemm_f32act |
float Ax |
full-decode + 现行 prefill |
两者的分块与「沿 K 扫」的结构一致,只有两点不同:一是激活的处理(int8 码 + scale vs float),二是 f32 版本在 M == 1(decode)时把整块线程全映射到 n 方向,避免 m 方向线程空转。第 11 篇会讲为什么最终选了 float 激活(PPL Δ3.0% → 0.19%)。
3.2 线程映射
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(节选) */
#define VC_NT   64   /* threads along n per block */
#define VC_MT   4    /* threads along m per block */
#define VC_VEC  4    /* output columns per thread */
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_gw_gemm / k_gw_gemm_f32act,节选) */
/* 通用形状(prefill / M>1):*/
const int n0 = (blockIdx.x * VC_NT + threadIdx.x) * VC_VEC;  /* 输出列 */
const int m  =  blockIdx.y * VC_MT + threadIdx.y;            /* 输出行 */

/* f32 版本在 M==1(decode)时把线程全压到 n:*/
if (M == 1) {
    n0 = (blockIdx.x * (VC_NT * VC_MT) + threadIdx.y * VC_NT + threadIdx.x) * VC_VEC;
    m  = 0;
}
每个线程负责一行 m 上连续的 4 个输出列 [n0, n0+4)。内层沿 K 扫:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_gw_gemm_f32act 的 float 激活路径,节选) */
for (int g = g_begin; g < g_end; ++g) {
    const int8_t *wt = WT  + (size_t)g * G * Npad + n0;
    const float  *xb = arow + (size_t)g * G;
    float p0 = 0.f, p1 = 0.f, p2 = 0.f, p3 = 0.f;
    for (int kk = 0; kk < G; ++kk) {
        const float xv = xb[kk];              /* 整 warp 广播同一地址 */
        const int8_t *w = wt + (size_t)kk * Npad;
        p0 += (float)w[0] * xv;
        p1 += (float)w[1] * xv;
        p2 += (float)w[2] * xv;
        p3 += (float)w[3] * xv;
    }
    const float4 bs = *reinterpret_cast<const float4 *>(bsT + (size_t)g * Npad + n0);
    acc0 += p0 * bs.x;  acc1 += p1 * bs.y;
    acc2 += p2 * bs.z;  acc3 += p3 * bs.w;
}
(int8 激活版本 k_gw_gemm 的内层取 uchar4 权重码、以 int 累加,最后再乘 a_scale 与 b_scale。)
两个访存特征值得点出:
- 权重 :
VC_NT=64线程 ×VC_VEC=4字节 = warp 一次读 128 字节连续数据------满事务。 - 激活 :
xb[kk]对同一行m的所有线程是同一个地址------一次读、全 warp 广播。
这是「权重密集、激活广播」的取舍,因为 decode 时瓶颈在权重带宽。
3.3 z-split:小 M 时怎么喂饱设备
decode 时 M=1,nblk_y = 1,nblk_x 也不大------(x,y) 网格严重欠填充。解法是沿 group 轴 再切一刀,用 blockIdx.z:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_gw_gemm,节选) */
const int z = blockIdx.z;
const int base = ngroups / nsplit;
const int rem  = ngroups % nsplit;
const int g_begin = z * base + (z < rem ? z : rem);
const int g_end   = g_begin + base + (z < rem ? 1 : 0);
要点:
- 每个 slice 拥有整数个 scale block,所以整数部分和仍是精确的------这是纯划分。
- 一次 launch 完成所有 slice,不是循环 launch。decode 形状下
nsplit可达 64,逐个 launch 的开销会盖过整个 GEMM。 - 结果落在
dPart[z],最后用k_gw_reduce按固定顺序求和------固定顺序是确定性的前提。
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_gw_reduce,节选) */
__global__ void k_gw_reduce(const float *__restrict part,
                            float *__restrict dst,
                            size_t total, int nsplit) {
    const size_t i = (size_t)blockIdx.x * blockDim.x + threadIdx.x;
    if (i >= total) return;
    float s = 0.f;
    for (int z = 0; z < nsplit; ++z) s += part[(size_t)z * total + i];
    dst[i] = s;
}
nsplit 的选择:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vcuda_dev_gemm_gw,节选) */
if (nblk_xy > 0 && nblk_xy < VC_SPLIT_TARGET && ngroups > 1) {
    nsplit = (VC_SPLIT_TARGET + nblk_xy - 1) / nblk_xy;   /* 目标 512 个 block */
    if (nsplit > ngroups) nsplit = ngroups;
}
while (nsplit > 1 && (size_t)nsplit * ou_sz > VC_PART_CAP_BYTES) nsplit--;   /* part 缓冲上限 64 MiB */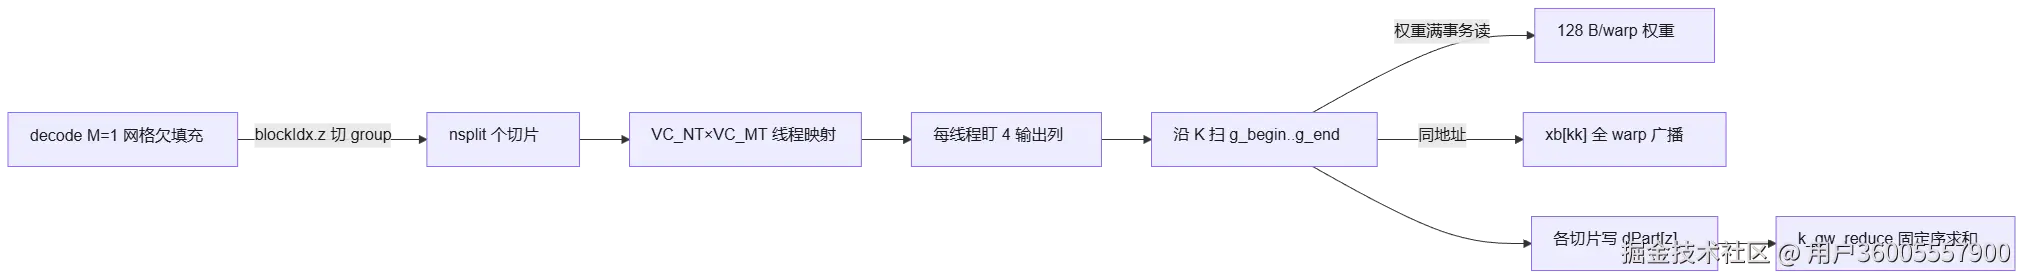
图 1 :解码/预填充共用映射下的数据流。
blockIdx.x/y摊出「列 × 行」网格(VC_NT=64×VC_MT=4),每个线程盯住[n0, n0+4)那 4 个输出列、沿 K 扫过本 slice 的 group 区间;两个访存特征正来自这套映射------权重每 warp 满事务读 128 B,激活xb[kk]对同列线程是同一地址、一次读全 warp 广播。decodeM=1时(x,y)网格欠填充,改由blockIdx.z沿 group 轴切成nsplit片(目标VC_SPLIT_TARGET=512个 block,nsplit受 64 MiB 的VC_PART_CAP_BYTES上限约束),各片写dPart[z],最后由k_gw_reduce按固定顺序求和保确定性。
3.4 调用路径上的传输优化
设备层 vcuda_dev_gemm_gw() 的传输形态是实测调出来的:
- H2D 走 pinned 暂存(pageable 源会串行化);
- 全部
cudaMemcpyAsync发在默认流,只在 D2H 后做一次cudaDeviceSynchronize。
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vcuda_dev_gemm_gw,节选) */
memcpy(s->hAq, Aq, aq_sz);
memcpy(s->hAsc, asc, as_sz);
if (cudaMemcpyAsync(s->dAq, s->hAq, aq_sz, cudaMemcpyHostToDevice) != cudaSuccess ||
    cudaMemcpyAsync(s->dAsc, s->hAsc, as_sz, cudaMemcpyHostToDevice) != cudaSuccess) { ... }
...
/* One async D2H into pinned staging + THE single synchronize of the call. */
cudaMemcpyAsync(s->hOut, s->dOut, ou_sz, cudaMemcpyDeviceToHost);
cudaDeviceSynchronize();
旧形态(阻塞 D2H + 额外一次
cudaDeviceSynchronize)多付了一整个往返。profile 显示:对小投影,传输/同步这对开销,而不是内核本身,才是主导。
3.5 小投影为什么单独 offload 是亏的
2B q8 的 decode 桶实测(ms/token):
| 投影 | 单投影 offload 前 | 单投影 offload 后 | 结论 |
|---|---|---|---|
| QKV / O / K / V | 6.39 / 3.70 / ... | 7.24 / 3.73 / ... | 变慢 |
| gate/up | 16.96 | 7.56 | 大幅变快 |
| down | 10.79 | 3.98 | 大幅变快 |
| lm_head | 6.87 | --- | 变快(最大矩阵) |
原因是每次调用的固定往返 ~100 µs 超过小投影的计算量。所以:
- QKV/K/V 单独 offload 是亏的 → 必须融合(QKV 三合一、gate+up 二合一),把三次往返压成一次;
- 用 FLOP 门槛(
1e7)把「太小不值得」的投影自动留在 CPU:M=1时 Q/O 是 8.4 MFLOP、K/V 4.2 MFLOP(排除),gate/up/down 25 MFLOP 与 lm_head 622 MFLOP(通过)。
这条「小算子别 offload、融合才划算」的结论,直接决定了 第 05 篇 里卸载集合的结构。
四、实测数据
| 口径 | 数值 | 判定 | 标注 |
|---|---|---|---|
| QKV 单投影 offload(2B q8 decode) | 6.39 → 7.24 ms/tok | 变慢 | 实测 |
| gate/up | 16.96 → 7.56 ms/tok | 大幅变快 | 实测 |
| down | 10.79 → 3.98 ms/tok | 大幅变快 | 实测 |
| lm_head | 6.87 → ... | 变快 | 实测 |
| 每次调用固定往返 | ~100 µs | 小投影的主导开销 | 实测 |
| M=1 各投影 FLOPs | Q/O 8.4 M / K/V 4.2 M(排除);gate/up/down 25 M、lm_head 622 M(通过) | 门槛 1e7 干净切开 |
实测 |
五、边界与已知限制
- 这里的实测是 2B q8 的口径;小投影「负收益」的临界由固定往返(~100 µs)决定,换设备/换后端不能照搬这条门槛,需要按自己的往返成本重测。
prec只支持 0/1(int8/int4 码);K % G != 0一律退回 CPU。- z-split 的 part 缓冲有 64 MiB 上限,超限时自动减少
nsplit(并行度换显存)。 - 内核的数值确定性依赖
k_gw_reduce的固定求和顺序,以及块内整数点积整组完成;改变划分方式会改变位级结果。
CPU 对照(迁移前基线)
- CPU 参考 :
kestrel-llm/src/model/vllm_safetensors.c(函数st_q4_row_dot/q4_dense4_x86;dyn_matvec_q8)------ CPU 侧按行(q4 走 4 行组)逐块反量化点积。 - 迁移要点 :CPU 侧逐行/逐 4 行组算 → CUDA 侧用一个映射同时吃 decode(M=1) 与 prefill(M=32):每线程固定 4 列沿 K 扫,权重满事务读、激活广播;小 M 用
blockIdx.z切 group(z-split 一次 launch);固定顺序 reduce 保确定性。 - 真机验证:命中 E2(selftest:int8/int4 × decode/prefill/非整除 N 全过)。
六、小结(可复用结论)
- 一个映射吃两种负载:每线程固定几列、沿 K 扫,让权重满事务读、激活广播------这是 decode 权重带宽受限下的正确取舍。
- 小 M 靠 z-split 补并行度 ,且必须一次 launch :decode 形状下
nsplit可达 64,逐个 launch 会把 GEMM 本身盖过去。 - 精确量要整组完成:整数点积在块内做完再乘 scale,才能做纯划分、用固定顺序 reduce 保确定性。
- 传输/同步才是小投影的主导开销:pinned 暂存 + 单次同步是实测调出来的,不是默认写法。
- 小算子不该单独 offload:FLOP 门槛加融合,才是把「快」变成「更快」的正确方向。
相关篇目:第 03 篇 · 权重条带缓存与融合权重、第 05 篇 · 卸载集合 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...